
लर्निंग पाथ
डेवलपर्स के लिए एसोसिएट AI इंजीनियर
26 घंटा
Mistral Medium 3 कई विकल्पों की तुलना में काफी कम कीमत पर उच्च प्रदर्शन प्रदान करता है। यह वर्तमान में Mistral AI API के माध्यम से उपलब्ध है, जिसकी कीमत केवल $0.40 प्रति मिलियन इनपुट टोकन और $2 प्रति मिलियन आउटपुट टोकन है। यह मूल्य निर्धारण DeepSeek v3 जैसे अग्रणी प्रतिस्पर्धियों को, चाहे API में हो या स्व-तैनात सिस्टम में, पीछे छोड़ता है। संक्षेप में, आप विभिन्न बेंचमार्क पर Claude Sonnet 3.7 के प्रदर्शन का लगभग 90% हासिल कर सकते हैं और लागत में काफी बचत कर सकते हैं।
इस ट्यूटोरियल में, हम Mistral API सेट अप करना और Python क्लाइंट का उपयोग करके मॉडल तक पहुँचना सीखेंगे। इसके बाद, हम LangGraph का उपयोग करके ऐसा एजेंटिक एप्लिकेशन बनाएंगे जो वेब सर्च और Python REPL टूल के जरिए उत्तर उत्पन्न करता है।
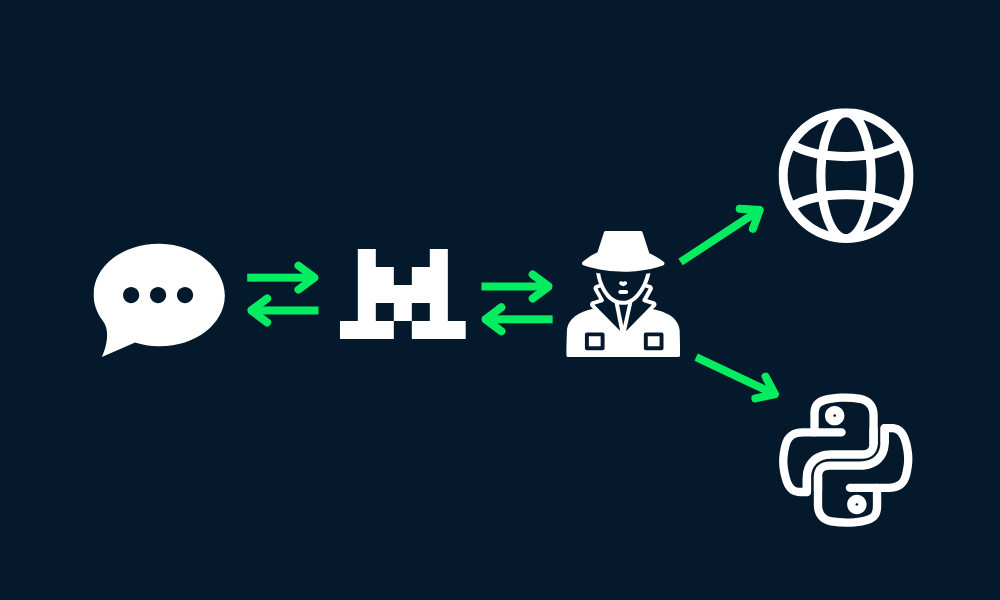
छवि: लेखक द्वारा
इस खंड में, हम सीखेंगे कि API कुंजी कैसे जनरेट करें, उसे environment variable के रूप में कैसे सहेजें, और फिर टेक्स्ट जनरेशन और इमेज अंडरस्टैंडिंग के लिए Python क्लाइंट से Mistral Medium 3 तक कैसे पहुँचें।
La Plateforme के लिए साइन अप करें: Mistral AI और फिर Billing सेक्शन में जाएँ और क्रेडिट/डेबिट कार्ड से $5 का क्रेडिट लोड करें। इस प्रोजेक्ट के लिए आपको केवल कुछ सेंट्स ही चाहिए। उसके बाद, API keys टैब पर जाकर नई API कुंजी जनरेट करें।
DataLab में environment variable सेट करना सीधा-सादा है। बस "Environment" टैब में जाएँ, "Environment Variables" विकल्प चुनें, और "MISTRAL_API_KEY" नाम से एक नया variable अपनी API कुंजी के साथ जोड़ें। बदलाव सहेजने के बाद, उसे कनेक्ट करना न भूलें।
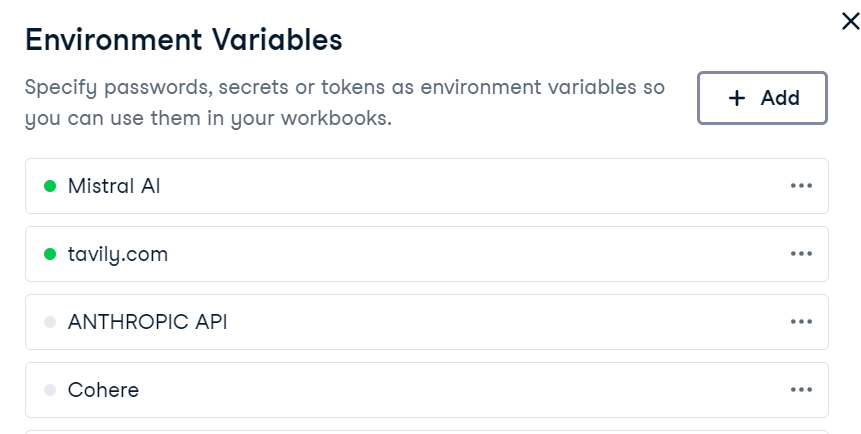
DataLab में एक नया Python सेल बनाएँ और Mistral AI का python पैकेज इंस्टॉल करें।
!pip install -U mistralai कोई भी कोड लिखने से पहले, Models Overview पेज पर जाकर Mistral Medium 3 API कुंजी के एंडपॉइंट नाम ढूँढ़ना ज़रूरी है। डॉक्यूमेंटेशन के अनुसार, एंडपॉइंट का नाम mistral-medium-latest प्रतीत होता है।
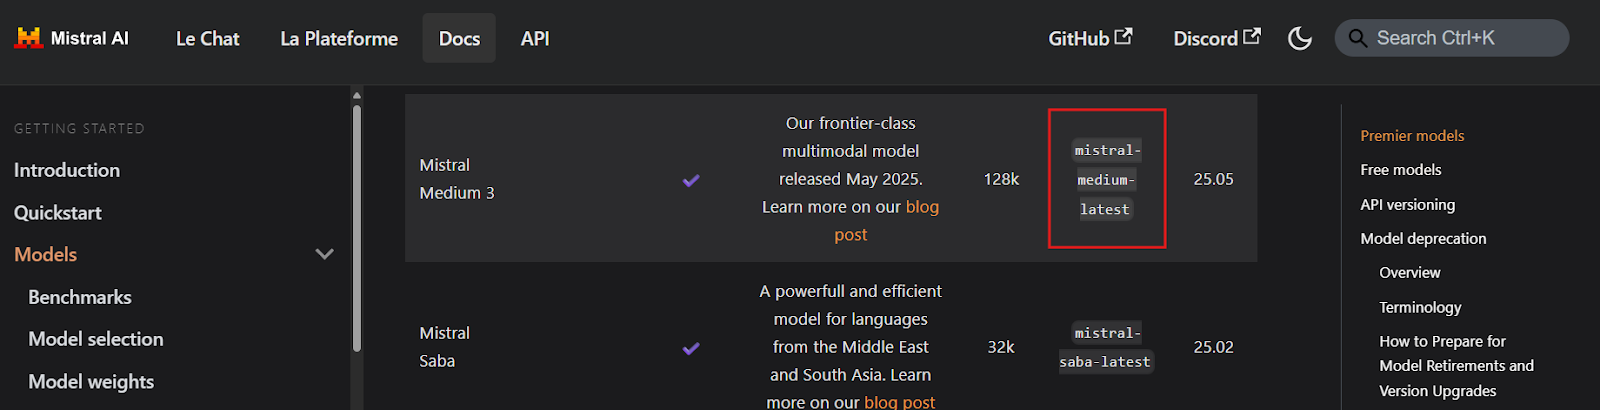
स्रोत: Models Overview | Mistral AI Large Language Modelss
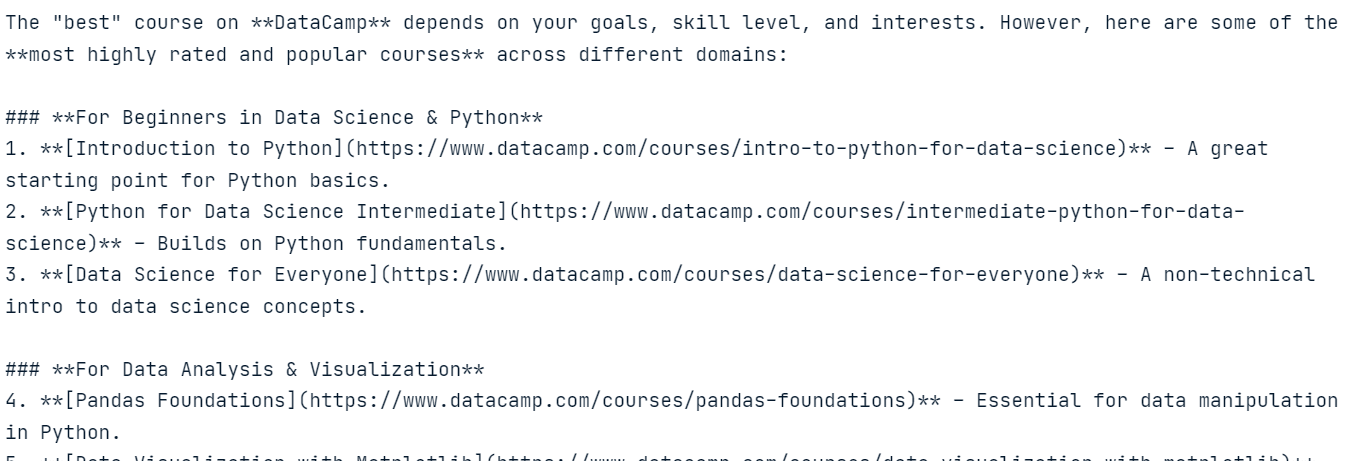
इसके बाद, हम API कुंजी का उपयोग करके Mistral AI क्लाइंट बनाएँगे और किसी उपयोगकर्ता क्वेरी पर स्ट्रीमिंग रिस्पॉन्स जनरेट करेंगे।
import osfrom mistralai import Mistralapi_key = os.environ["MISTRAL_API_KEY"]model = "mistral-medium-latest"client = Mistral(api_key=api_key)stream_response = client.chat.stream( model = model, messages = [ { "role": "user", "content": "What is the best course to take from DataCamp?", }, ])for chunk in stream_response: print(chunk.data.choices[0].delta.content, end="" )रिस्पॉन्स बेहद सटीक है और इसकी लागत लगभग शून्य है।
मॉडल की मल्टीमॉडल क्षमताओं का परीक्षण करने के लिए, हम DataCamp ब्लॉग के फ्रंट पेज का स्क्रीनशॉट लेंगे और उसे उपयोगकर्ता प्रॉम्प्ट के साथ मॉडल को देंगे।
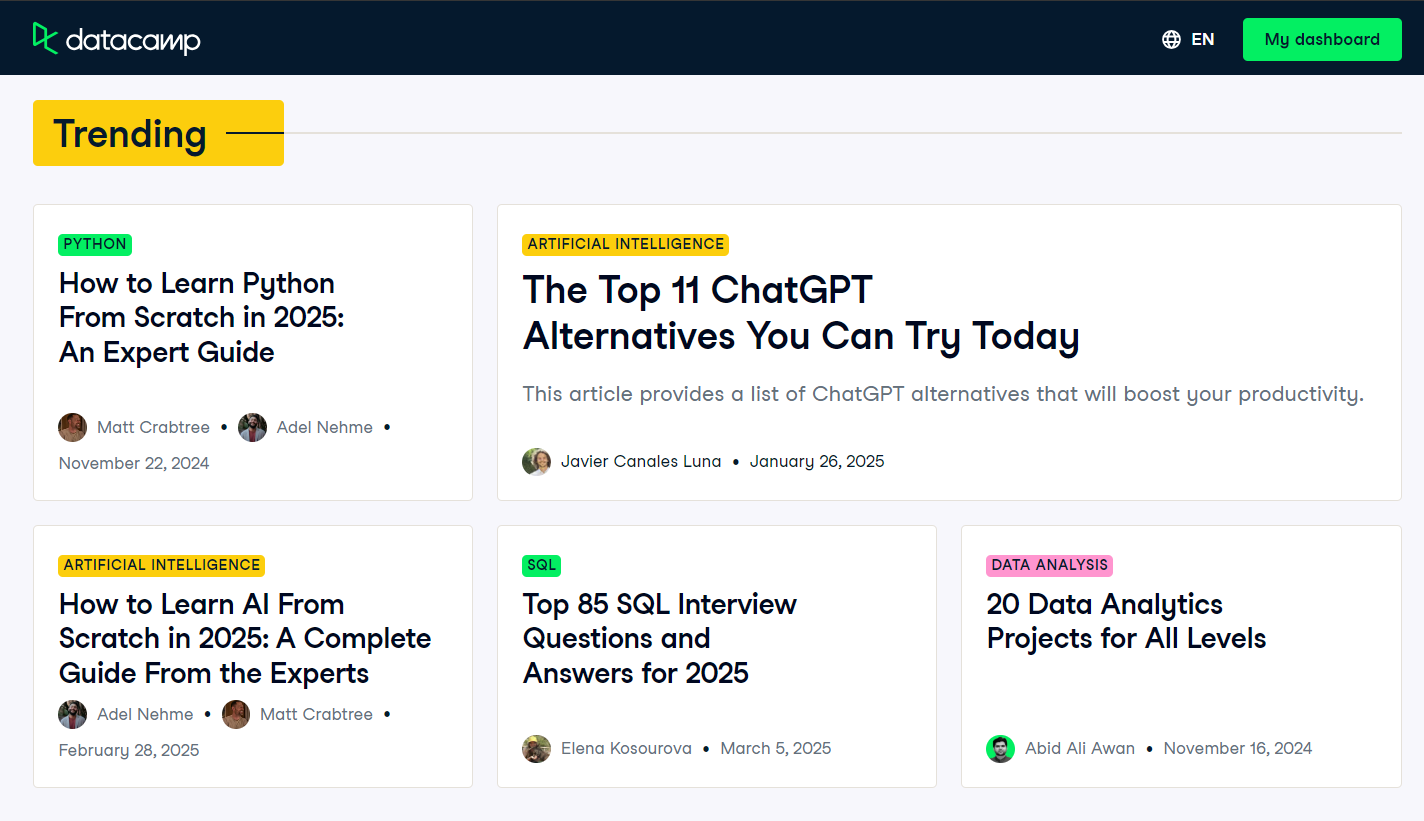
स्रोत: Blog | Data Science Articles | DataCamp
चूँकि मॉडल सीधे इमेज फ़ाइल तक पहुँच नहीं कर सकता, हमें पहले इमेज लोड करके उसे Base64-एन्कोडेड स्ट्रिंग में बदलना होगा।
import base64import requestsdef encode_image(image_path): """Encode the image to base64.""" try: with open(image_path, "rb") as image_file: return base64.b64encode(image_file.read()).decode('utf-8') except FileNotFoundError: print(f"Error: The file {image_path} was not found.") return None except Exception as e: # Added general exception handling print(f"Error: {e}") return None# Path to your imageimage_path = "datacamp_fp.png"# Getting the base64 stringbase64_image = encode_image(image_path)अब हम Base64-एन्कोडेड इमेज को उपयोगकर्ता की क्वेरी के साथ Mistral AI चैट कंप्लीशन क्लाइंट को भेजेंगे।
# Define the messages for the chatmessages = [ { "role": "user", "content": [ { "type": "text", "text": "Explain the image in a Donald Trump style." }, { "type": "image_url", "image_url": f"data:image/png;base64,{base64_image}" } ] }]stream_response = client.chat.stream( model = model, messages = messages)for chunk in stream_response: print(chunk.data.choices[0].delta.content, end="" )मॉडल ने सफलतापूर्वक इमेज की व्याख्या की और Donald Trump की शैली में उत्तर जनरेट किया, जो इसकी मल्टीमॉडल समझ क्षमता दर्शाता है।

इस प्रोजेक्ट में, हम LangGraph के साथ Mistral Medium 3 का उपयोग करके एक एजेंटिक एप्लिकेशन बनाएँगे। यह एप्लिकेशन वेब सर्च के लिए Tavily API और उपयोगकर्ता प्रॉम्प्ट के आधार पर कोड चलाने के लिए Python REPL का उपयोग करेगा।
LangGraph में नए हैं? कोई बात नहीं! हमारा LangGraph ट्यूटोरियल देखें और फ्रेमवर्क के बारे में आवश्यक सभी जानकारी सीखें।
इम्प्लीमेंटेशन शुरू करने से पहले, हमें Tavily AI में अकाउंट बनाकर API कुंजी जनरेट करनी होगी। यह प्रक्रिया सरल है, और आपको भुगतान विवरण या क्रेडिट कार्ड देने की आवश्यकता नहीं है।
API कुंजी मिलने के बाद, उसे TAVILY_API_KEY नाम के environment variable के रूप में लोकल या अपने DataLab सेटअप में सहेजें, जैसा कि पिछले सेक्शन में दिखाया गया है।
अगले चरण में, हम LangChain इकोसिस्टम का उपयोग करके टूल्स और एजेंट बनाने के लिए आवश्यक Python पैकेज इंस्टॉल करेंगे।
%%capture!pip install -U \ mistralai \ langchain langchain-mistralai \ langchain-experimental \ langgraph \ tavily-pythonहम LangChain के ChatMistralAI बड़े भाषा मॉडल (LLM) क्लाइंट को मॉडल नाम, टेम्परेचर निर्दिष्ट करके और स्ट्रीमिंग रिस्पॉन्स सक्षम करके बनाएँगे।
from langchain_mistralai import ChatMistralAIllm = ChatMistralAI( model="mistral-medium-latest", temperature=0.2, streaming=True )अब हम एजेंट के लिए टूल्स सेट करेंगे। मैन्युअली टूल बनाने के बजाय, हम LangChain इकोसिस्टम के प्री-बिल्ट टूल्स जैसे Tavily Search और Python REPL का उपयोग कर सकते हैं।
from langchain_community.tools import TavilySearchResultsfrom langchain_experimental.tools.python.tool import PythonREPLToolsearch_tool = TavilySearchResults(max_results=5, include_answer=True)code_tool = PythonREPLTool()tools = [search_tool, code_tool]LLM क्लाइंट और टूल्स तैयार होने के साथ, अब हम LangGraph का उपयोग करके React Agent बना सकते हैं।
from langgraph.prebuilt import create_react_agentagent = create_react_agent( model=llm, tools=tools, ) LangGraph Studio, LangGraph फ्रेमवर्क के लिए एक विज़ुअल डेवलपमेंट वातावरण है; इसके बारे में अधिक जानने के लिए LangGraph Studio गाइड: इंस्टॉलेशन, सेट अप, उपयोग के मामले का पालन करें।
एजेंट चलाने से पहले, हम एक Python फ़ंक्शन परिभाषित करेंगे जो एजेंट के रिस्पॉन्स जनरेशन के दौरान उपयोग किए गए टूल्स के नाम निकालता है। यह फ़ंक्शन बताएगा कि कौन से टूल्स इनवोक हुए।
def extract_tool_names(conversation: dict) -> list[str]: """ Given a conversation dict with a 'messages' list (where each message may be a dict or a Pydantic model), extract all unique tool names used in any tool call. """ tool_names = set() for msg in conversation.get('messages', []): # 1) Try direct attribute access (for Pydantic models) calls = [] if hasattr(msg, 'tool_calls'): calls = getattr(msg, 'tool_calls') or [] # 2) If that fails, the message might be a dict elif isinstance(msg, dict): calls = msg.get('tool_calls') # also check nested in additional_kwargs if not calls and isinstance(msg.get('additional_kwargs'), dict): calls = msg['additional_kwargs'].get('tool_calls') # 3) Finally, check additional_kwargs on objects else: ak = getattr(msg, 'additional_kwargs', None) if isinstance(ak, dict): calls = ak.get('tool_calls', []) # Normalize to list calls = calls or [] # Extract names for call in calls: # dict-style tool call if isinstance(call, dict): # top-level 'name' if 'name' in call: tool_names.add(call['name']) # nested under 'function' elif 'function' in call and isinstance(call['function'], dict): fn = call['function'] if 'name' in fn: tool_names.add(fn['name']) return sorted(tool_names)LangGraph Studio, LangGraph फ्रेमवर्क के लिए एक विज़ुअल डेवलपमेंट वातावरण है; इसके बारे में अधिक जानने के लिए LangGraph Studio गाइड: इंस्टॉलेशन, सेट अप, उपयोग के मामले का पालन करें।
आइए एजेंट से ब्रेकिंग न्यूज़ के बारे में एक प्रश्न पूछकर परीक्षण करें।
question = "What are the top 5 breaking news stories?"def run_agent(question): result = agent.invoke( { "messages": [ {"role": "user", "content": question} ] } ) tool_name = extract_tool_names(result) # The LLM’s final answer is always in the last message raw_answer = result["messages"][-1].content clean_text = "".join(part for part in raw_answer if isinstance(part, str)) return tool_name, clean_texttool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)एजेंट ने ब्रेकिंग न्यूज़ पर उत्तर जनरेट करने के लिए Tavily Search टूल का उपयोग किया है।

अब Python REPL टूल का परीक्षण करते हैं—एजेंट से Python कोड जनरेट और निष्पादित करने के लिए कहें।
question = "Write a code to display the stars in a triangle. Please execute the code too."tool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)एजेंट ने कोड जनरेशन के लिए Mistral Medium 3 और कोड निष्पादन के लिए Python REPL का उपयोग किया।

अंत में, ऐसा प्रश्न परीक्षण करें जिसमें एजेंट को क्रम से दोनों टूल्स का उपयोग करना पड़े।
question = "Get the latest gold price data for the past 7 days and use it to generate a line plot"tool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)एजेंट Tavily Search से सोने की कीमत का डेटा लाएगा, डेटा विज़ुअलाइज़ेशन के लिए कोड जनरेट करने में Mistral Medium 3 का उपयोग करेगा, और उस कोड को चलाने के लिए Python REPL का उपयोग करेगा। परिणाम में एक अत्यंत सटीक चार्ट और उपयोग किए गए टूल्स का सारांश शामिल होगा।
Tool used ⫸ ['Python_REPL', 'tavily_search_results_json'] The code generates a line plot showing the gold price per gram in USD over the last 7 days, with the x-axis representing dates and the y-axis representing the gold price. The plot includes markers for each data point, a title, labeled axes, a grid, and rotated x-axis labels for better readability.
यदि कोड चलाते समय कोई समस्या आए, तो अतिरिक्त मार्गदर्शन के लिए Mistral Medium 3 — DataLab नोटबुक देखें।
आप Haystack इकोसिस्टम का उपयोग करके और अधिक शक्तिशाली तथा आसानी से इम्प्लीमेंट होने वाला एजेंट एप्लिकेशन बना सकते हैं। अधिक जानने के लिए ये ट्यूटोरियल देखें: Haystack AI ट्यूटोरियल: एजेंटिक वर्कफ़्लोज़ बनाना.
Mistral AI API के साथ प्रयोग करने और विभिन्न एप्लिकेशनों का परीक्षण करने के लिए एजेंट बनाने के बाद, सबसे उल्लेखनीय बात यह है कि 161,075 टोकन उपयोग करने के बाद भी इसकी लागत मुझे एक डॉलर भी नहीं लगी। मॉडल किफायती, तेज़, सटीक है और सेट अप करना बेहद आसान है। यह DeepSeek जैसी महंगी APIs का एक बेहतरीन विकल्प है, जो तुलनीय कार्यक्षमता प्रदान करता है।
AI परिदृश्य स्पष्ट रूप से छोटे, तेज़, अधिक सटीक और किफायती मॉडलों की ओर बढ़ रहा है, जो विशेष रूप से स्टार्टअप्स और छोटे-मध्यम उद्यमों (SMEs) के लिए एक आशाजनक प्रवृत्ति है। ये संगठन अक्सर LLM प्रदाताओं पर काफी निर्भर होते हैं, और जैसे-जैसे ये मॉडल अधिक सस्ते होंगे, वे अधिक लाभांश से अत्यधिक लाभान्वित होंगे।
Developing Large Language Models स्किल ट्रैक लें और PyTorch व Hugging Face के साथ नवीनतम डीप लर्निंग और NLP तकनीकों का उपयोग करते हुए अपने स्वयं के LLMs बनाएं।
शीर्ष DataCamp कोर्स
लर्निंग पाथ
कोर्स
कोर्स