
Lộ trình
Kỹ sư Trợ lý Trí tuệ Nhân tạo (AI) cho Lập trình viên
26 giờ
Mistral Medium 3 mang lại hiệu năng cao với mức giá thấp hơn đáng kể so với nhiều lựa chọn khác. Hiện mẫu này có sẵn qua Mistral AI API, chỉ với $0,40 cho mỗi triệu token đầu vào và $2 cho mỗi triệu token đầu ra. Mức giá này vượt trội so với các đối thủ hàng đầu như DeepSeek v3, dù là API hay hệ thống tự triển khai. Tóm lại, bạn có thể đạt tới 90% hiệu năng của Claude Sonnet 3.7 trên nhiều thước đo, đồng thời tiết kiệm đáng kể chi phí.
Trong hướng dẫn này, chúng ta sẽ học cách thiết lập API của Mistral và dùng client Python để truy cập mô hình. Sau đó, chúng ta sẽ sử dụng LangGraph để xây dựng một ứng dụng agentic dùng tìm kiếm web và công cụ Python REPL để tạo câu trả lời.
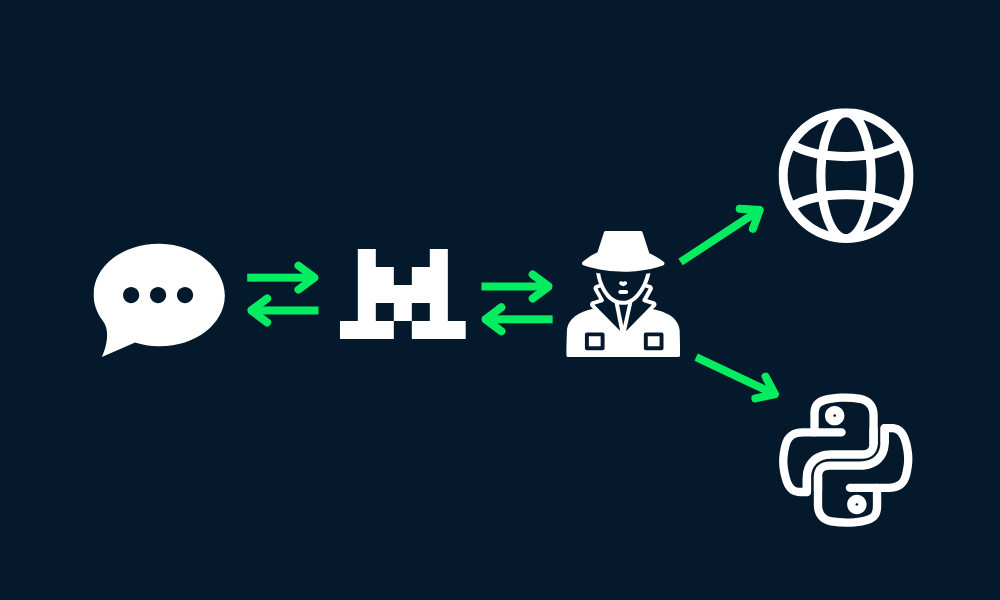
Hình do tác giả thực hiện
Trong phần này, chúng ta sẽ học cách tạo khóa API, lưu khóa dưới dạng biến môi trường, rồi dùng client Python để truy cập Mistral Medium 3 cho tác vụ sinh văn bản và hiểu hình ảnh.
Đăng ký La Plateforme: Mistral AI rồi vào mục Billing và nạp $5 bằng thẻ tín dụng/ghi nợ. Bạn chỉ cần vài xu cho dự án này. Sau đó, chuyển đến thẻ API keys để tạo khóa API mới.
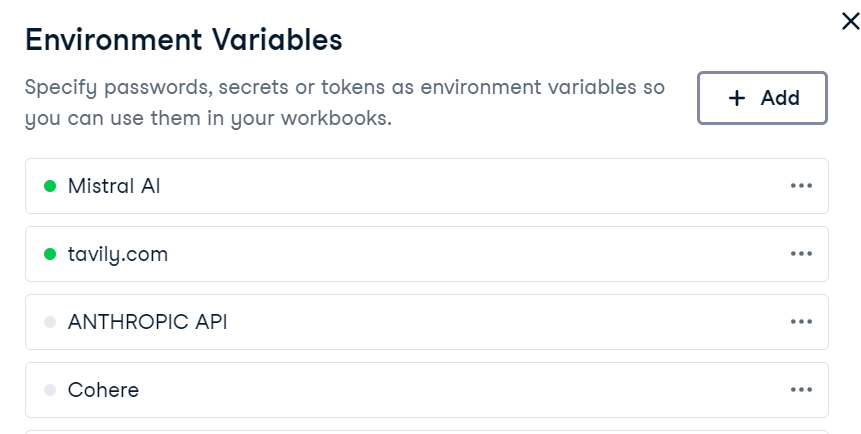
Thiết lập biến môi trường trong DataLab rất đơn giản. Chỉ cần vào tab "Environment", chọn "Environment Variables" và thêm biến mới tên "MISTRAL_API_KEY" cùng với khóa API của bạn. Sau khi lưu thay đổi, nhớ kết nối biến này.
Trong DataLab, tạo cell Python mới và cài gói Python của Mistral AI.
!pip install -U mistralai Trước khi viết mã, cần xác định tên endpoint khóa API của Mistral Medium 3 bằng cách truy cập trang Models Overview. Theo tài liệu, endpoint có tên mistral-medium-latest.
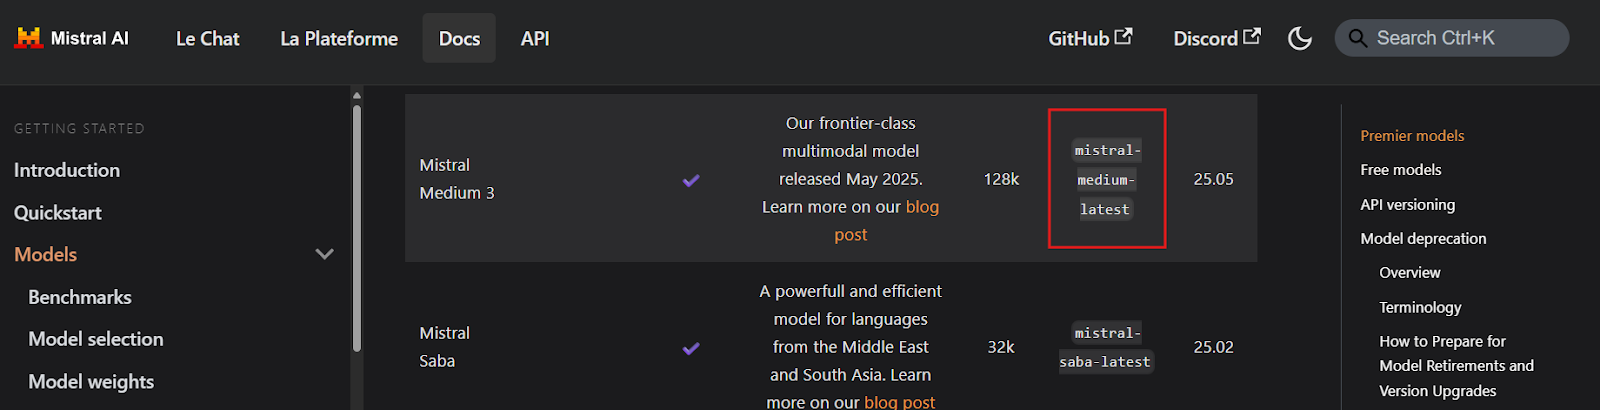
Nguồn: Models Overview | Mistral AI Large Language Models
Tiếp theo, chúng ta sẽ tạo client Mistral AI bằng khóa API và sinh phản hồi dạng streaming cho một truy vấn của người dùng.
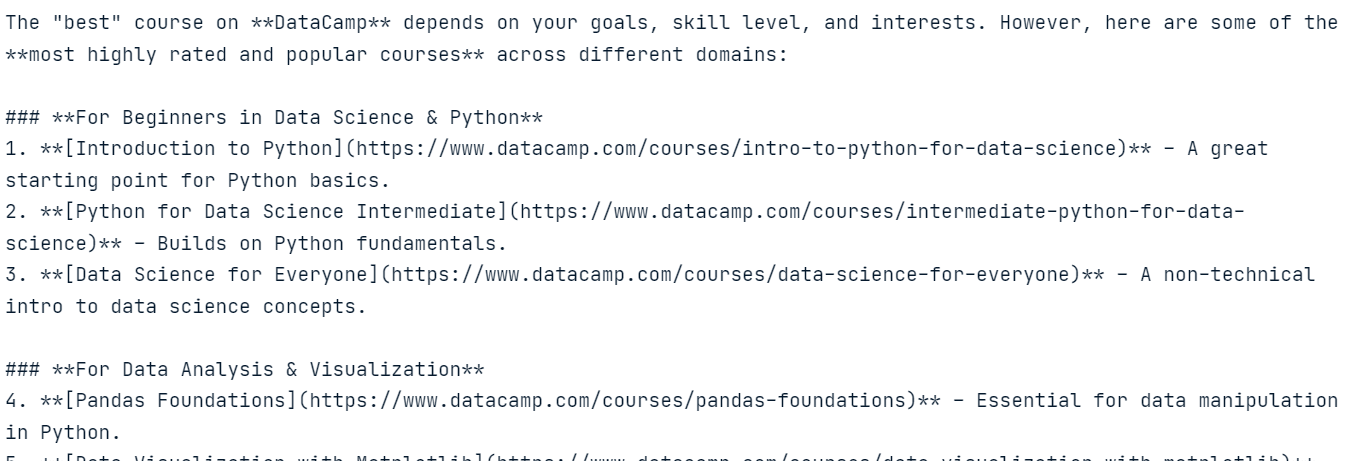
import osfrom mistralai import Mistralapi_key = os.environ["MISTRAL_API_KEY"]model = "mistral-medium-latest"client = Mistral(api_key=api_key)stream_response = client.chat.stream( model = model, messages = [ { "role": "user", "content": "What is the best course to take from DataCamp?", }, ])for chunk in stream_response: print(chunk.data.choices[0].delta.content, end="" )Phản hồi rất chính xác và hầu như không tốn chi phí.
Để kiểm thử khả năng đa phương thức của mô hình, chúng ta sẽ chụp ảnh màn hình trang chủ blog của DataCamp và cung cấp cho mô hình kèm theo lời nhắc của người dùng.
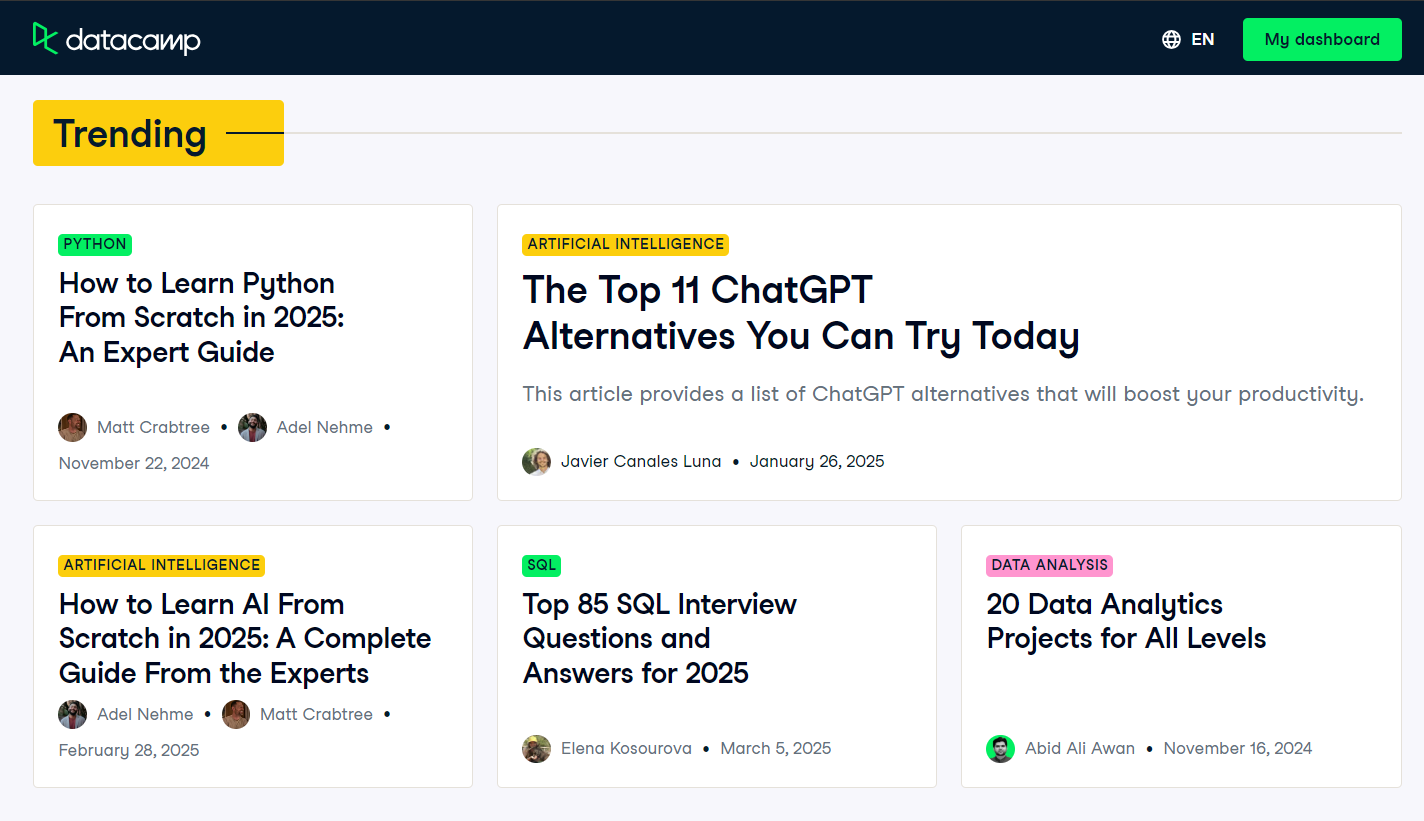
Nguồn: Blog | Data Science Articles | DataCamp
Vì mô hình không thể truy cập trực tiếp tệp ảnh, trước tiên chúng ta cần tải ảnh và chuyển nó thành chuỗi mã hóa Base64.
import base64import requestsdef encode_image(image_path): """Encode the image to base64.""" try: with open(image_path, "rb") as image_file: return base64.b64encode(image_file.read()).decode('utf-8') except FileNotFoundError: print(f"Error: The file {image_path} was not found.") return None except Exception as e: # Added general exception handling print(f"Error: {e}") return None# Path to your imageimage_path = "datacamp_fp.png"# Getting the base64 stringbase64_image = encode_image(image_path)Giờ chúng ta sẽ gửi ảnh đã mã hóa Base64 cùng với truy vấn người dùng tới client chat completion của Mistral AI.
# Define the messages for the chatmessages = [ { "role": "user", "content": [ { "type": "text", "text": "Explain the image in a Donald Trump style." }, { "type": "image_url", "image_url": f"data:image/png;base64,{base64_image}" } ] }]stream_response = client.chat.stream( model = model, messages = messages)for chunk in stream_response: print(chunk.data.choices[0].delta.content, end="" )Mô hình diễn giải thành công hình ảnh và tạo phản hồi theo phong cách của Donald Trump, thể hiện năng lực hiểu đa phương thức.

Trong dự án này, chúng ta sẽ dùng Mistral Medium 3 với LangGraph để xây dựng một ứng dụng agentic. Ứng dụng sẽ sử dụng Tavily API cho tìm kiếm web và Python REPL để thực thi mã dựa trên lời nhắc của người dùng.
Bạn mới làm quen với LangGraph? Không vấn đề gì! Hãy theo dõi Hướng dẫn LangGraph để nắm mọi điều bạn cần biết về framework này.
Trước khi triển khai, chúng ta cần thiết lập Tavily AI bằng cách tạo tài khoản và sinh khóa API. Quy trình rất đơn giản, bạn không cần cung cấp thông tin thanh toán hay thẻ tín dụng.
Khi đã có khóa API, hãy lưu nó dưới dạng biến môi trường tên TAVILY_API_KEY trên máy hoặc trong thiết lập DataLab của bạn như đã minh họa ở phần trước.
Tiếp theo, chúng ta sẽ cài các gói Python cần thiết để tạo công cụ và agent trong hệ sinh thái LangChain.
%%capture!pip install -U \ mistralai \ langchain langchain-mistralai \ langchain-experimental \ langgraph \ tavily-pythonChúng ta sẽ tạo client mô hình ngôn ngữ lớn (LLM) ChatMistralAI của LangChain bằng cách chỉ định tên mô hình, nhiệt độ và bật phản hồi streaming.
from langchain_mistralai import ChatMistralAIllm = ChatMistralAI( model="mistral-medium-latest", temperature=0.2, streaming=True )Giờ chúng ta sẽ thiết lập các công cụ cho agent. Thay vì tự tạo thủ công, ta có thể dùng công cụ dựng sẵn như Tavily Search và Python REPL trong hệ sinh thái LangChain.
from langchain_community.tools import TavilySearchResultsfrom langchain_experimental.tools.python.tool import PythonREPLToolsearch_tool = TavilySearchResults(max_results=5, include_answer=True)code_tool = PythonREPLTool()tools = [search_tool, code_tool]Với client LLM và các công cụ đã sẵn sàng, giờ chúng ta có thể tạo React Agent bằng LangGraph.
from langgraph.prebuilt import create_react_agentagent = create_react_agent( model=llm, tools=tools, ) LangGraph Studio là môi trường phát triển trực quan cho framework LangGraph; hãy làm theo Hướng dẫn LangGraph Studio: Cài đặt, Thiết lập, Tình huống sử dụng để tìm hiểu thêm.
Trước khi chạy agent, chúng ta sẽ định nghĩa một hàm Python để trích xuất tên các công cụ được dùng trong quá trình agent tạo phản hồi. Hàm này giúp xác định những công cụ nào đã được gọi.
def extract_tool_names(conversation: dict) -> list[str]: """ Given a conversation dict with a 'messages' list (where each message may be a dict or a Pydantic model), extract all unique tool names used in any tool call. """ tool_names = set() for msg in conversation.get('messages', []): # 1) Try direct attribute access (for Pydantic models) calls = [] if hasattr(msg, 'tool_calls'): calls = getattr(msg, 'tool_calls') or [] # 2) If that fails, the message might be a dict elif isinstance(msg, dict): calls = msg.get('tool_calls') # also check nested in additional_kwargs if not calls and isinstance(msg.get('additional_kwargs'), dict): calls = msg['additional_kwargs'].get('tool_calls') # 3) Finally, check additional_kwargs on objects else: ak = getattr(msg, 'additional_kwargs', None) if isinstance(ak, dict): calls = ak.get('tool_calls', []) # Normalize to list calls = calls or [] # Extract names for call in calls: # dict-style tool call if isinstance(call, dict): # top-level 'name' if 'name' in call: tool_names.add(call['name']) # nested under 'function' elif 'function' in call and isinstance(call['function'], dict): fn = call['function'] if 'name' in fn: tool_names.add(fn['name']) return sorted(tool_names)LangGraph Studio là môi trường phát triển trực quan cho framework LangGraph; hãy làm theo Hướng dẫn LangGraph Studio: Cài đặt, Thiết lập, Tình huống sử dụng để tìm hiểu thêm.
Hãy kiểm thử agent bằng cách hỏi một câu về tin nóng.
question = "What are the top 5 breaking news stories?"def run_agent(question): result = agent.invoke( { "messages": [ {"role": "user", "content": question} ] } ) tool_name = extract_tool_names(result) # The LLM’s final answer is always in the last message raw_answer = result["messages"][-1].content clean_text = "".join(part for part in raw_answer if isinstance(part, str)) return tool_name, clean_texttool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)Agent đã dùng công cụ Tavily Search để tạo phản hồi về tin nóng.

Tiếp theo, hãy kiểm thử công cụ Python REPL bằng cách yêu cầu agent sinh và thực thi mã Python.
question = "Write a code to display the stars in a triangle. Please execute the code too."tool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)Agent đã dùng Mistral Medium 3 để sinh mã và Python REPL để thực thi mã.

Cuối cùng, hãy kiểm thử một truy vấn yêu cầu agent dùng tuần tự cả hai công cụ.
question = "Get the latest gold price data for the past 7 days and use it to generate a line plot"tool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)Agent sẽ dùng Tavily Search để lấy dữ liệu giá vàng, Mistral Medium 3 để sinh mã trực quan hóa dữ liệu, và Python REPL để thực thi mã đó. Kết quả sẽ bao gồm một biểu đồ chính xác cao cùng phần tóm tắt các công cụ đã dùng.
Tool used ⫸ ['Python_REPL', 'tavily_search_results_json'] The code generates a line plot showing the gold price per gram in USD over the last 7 days, with the x-axis representing dates and the y-axis representing the gold price. The plot includes markers for each data point, a title, labeled axes, a grid, and rotated x-axis labels for better readability.
Nếu bạn gặp vấn đề khi chạy mã, hãy tham khảo thêm Mistral Medium 3 — DataLab Notebook để được hướng dẫn thêm.
Bạn có thể dùng hệ sinh thái Haystack để xây dựng ứng dụng agent mạnh mẽ hơn và dễ triển khai. Hãy theo dõi các hướng dẫn để tìm hiểu thêm: Hướng dẫn Haystack AI: Xây dựng quy trình Agentic.
Sau khi thử nghiệm Mistral AI API và xây dựng các agent để kiểm thử nhiều ứng dụng khác nhau, một điểm đáng chú ý là tôi không tốn dù chỉ một đô la—ngay cả sau khi dùng 161.075 token. Mô hình có chi phí phải chăng, nhanh, chính xác và cực kỳ dễ thiết lập. Đây là lựa chọn thay thế tuyệt vời cho các API đắt đỏ khác như DeepSeek, đồng thời mang lại chức năng tương đương.
Bức tranh AI rõ ràng đang dịch chuyển về phía các mô hình nhỏ hơn, nhanh hơn, chính xác hơn và tiết kiệm chi phí hơn, đây là xu hướng đầy hứa hẹn, đặc biệt với các startup và doanh nghiệp vừa và nhỏ (SME). Các tổ chức này thường phụ thuộc nhiều vào nhà cung cấp LLM, và khi các mô hình trở nên rẻ hơn, họ sẽ được hưởng lợi lớn nhờ biên lợi nhuận cao hơn.
Hãy tham gia Developing Large Language Models để tự xây dựng LLM của bạn bằng PyTorch và Hugging Face cùng các kỹ thuật học sâu và NLP mới nhất.
Các khóa học hàng đầu trên DataCamp
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
