
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
GPT-5 introduceert een nieuwe reasoning-effortparameter waarmee je kunt bepalen hoe diep het model nadenkt voordat het antwoordt. Je kunt kiezen uit minimal, low, medium of high, afhankelijk van je behoeften.
Minimal is ideaal voor snelheidkritische taken zoals snel coderen of eenvoudige instructies opvolgen, terwijl medium en high ruimte geven voor grondiger, stapsgewijs redeneren. Met deze flexibiliteit kun je latency, kosten en nauwkeurigheid balanceren.
Installeer eerst de OpenAI Python SDK en stel je API-sleutel in als omgevingsvariabele:
pip install openaiStel je API-sleutel in (vervang door je eigen sleutel):
export OPENAI_API_KEY="your_api_key_here"setx OPENAI_API_KEY "your_api_key_here"Laten we de Response API gebruiken om tekst te genereren met “minimal” reasoning effort. Dit betekent dat het model direct antwoordt, zonder tokens toe te wijzen aan interne redenering.
import os
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
)

print(resp.output_text)
Output:
Guido van Rossum is known as the father (creator) of Python. He first released Python in 1991.Je kunt ook het overzicht van tokengebruik bekijken om te begrijpen hoe het model je verzoek heeft verwerkt:
print(f"Input tokens: {resp.usage.input_tokens}")
print(f"  - Cached tokens: {resp.usage.input_tokens_details.cached_tokens}")
print(f"Output tokens: {resp.usage.output_tokens}")
print(f"  - Reasoning tokens: {resp.usage.output_tokens_details.reasoning_tokens}")
print(f"Total tokens: {resp.usage.total_tokens}")
Zoals te zien is, zijn er nul tokens gebruikt voor reasoning wanneer effort op minimal staat.
Input tokens: 13
  - Cached tokens: 0
Output tokens: 31
  - Reasoning tokens: 0
Total tokens: 44
Laten we nu de reasoning effort verhogen naar "high" om te zien hoe de interne redenering van het model verandert:
resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "high"},
)

print(resp.output_text)
Output:
Guido van Rossum. He created Python and first released it in 1991.Bekijk het tokengebruik opnieuw:
print(f"Input tokens: {resp.usage.input_tokens}")
print(f"  - Cached tokens: {resp.usage.input_tokens_details.cached_tokens}")
print(f"Output tokens: {resp.usage.output_tokens}")
print(f"  - Reasoning tokens: {resp.usage.output_tokens_details.reasoning_tokens}")
print(f"Total tokens: {resp.usage.total_tokens}")
Zelfs voor een eenvoudige vraag gebruikte het model 192 tokens voor reasoning bij high effort. Dit laat zien hoe je nu de diepte van reasoning kunt sturen om te optimaliseren voor kosten, snelheid of nauwkeurigheid.
Input tokens: 13
  - Cached tokens: 0
Output tokens: 216
  - Reasoning tokens: 192
Total tokens: 229Met GPT-5 kun je nu direct bepalen hoeveel het model zegt via de verbosity-parameter. Zet deze op low voor bondige antwoorden, medium voor gebalanceerde details, of high voor diepgaande uitleg. Dit is vooral handig bij codegeneratie—lage verbosity levert korte, nette code op, terwijl hoge verbosity inline commentaar en uitgebreide toelichting geeft.
Je kunt de verbosity-parameter combineren met reasoning-instellingen om precies het antwoord te krijgen dat je nodig hebt. Of je nu één korte zin wilt, een langer antwoord of een compleet rapport: je hebt volledige flexibiliteit.
De “low”-stand produceert een kort, direct antwoord.
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "low"},
)

print(resp.output_text)
Output:
Guido van Rossum.De “high”-stand genereert een veel gedetailleerder en uitleggerig antwoord.
resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "high"},
)

print(resp.output_text)
Output:
Guido van Rossum is known as the "father of Python." He created Python in the late 1980s and released the first version (Python 0.9.0) in 1991. He also served for many years as Python's "Benevolent Dictator For Life" (BDFL), guiding the language's development.Een van de grootste upgrades van GPT-5 is de mogelijkheid om chain-of-thought (CoT) reasoning door te geven tussen beurten in de Responses API. Het model onthoudt dus zijn interne redenering uit eerdere stappen, waardoor dubbel werk wordt voorkomen en zowel snelheid als nauwkeurigheid verbeteren.
In gesprekken met meerdere beurten, zeker wanneer je tools gebruikt, geef je simpelweg de previous_response_id door om de reasoning-context levend te houden.
De eerste aanvraag vraagt: “Who is the father of Python?”, en de tweede aanvraag, gekoppeld aan de eerste via previous_response_id, vraagt het model om “Write a blog on it” zonder het onderwerp te herhalen. Door de ID van de vorige response mee te geven, behoudt het model de reasoning-context.
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

first = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "low"},
)

followup = client.responses.create(
    model="gpt-5",
    previous_response_id=first.id,
    input="Write a blog on it.",
    reasoning={"effort": "medium"},
    text={"verbosity": "high"},
)

print(followup.output_text)
Het resultaat is een blog over de vader van Python.
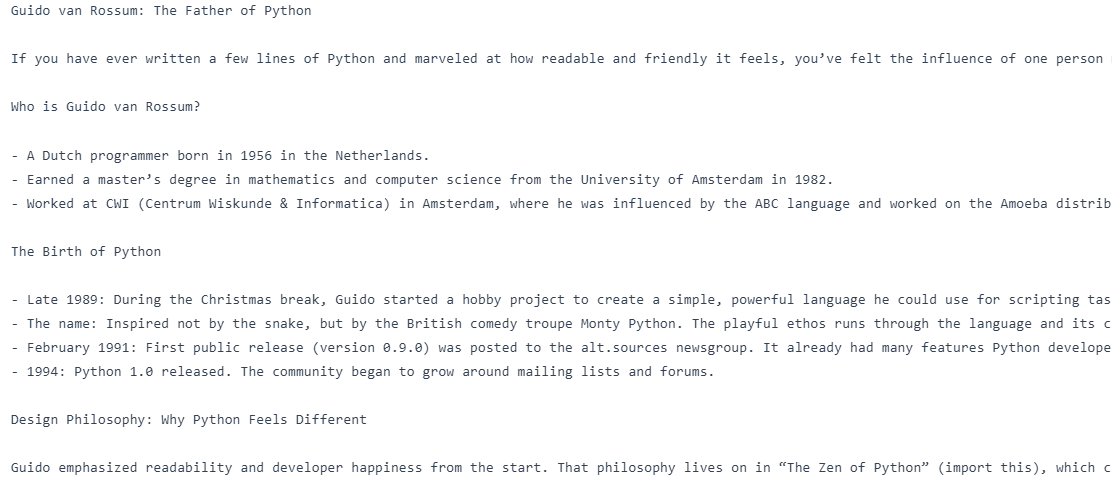
Aangepaste tools in GPT-5 ondersteunen nu vrije invoer, waardoor het model ruwe tekst zoals code, SQL-queries of shell-commando's direct naar je tools kan sturen. Dit is een grote stap vooruit ten opzichte van de oude aanpak met alleen gestructureerde JSON, en geeft je meer flexibiliteit in hoe het model met je systemen interageert. Of je nu een code-executor, een query-engine of een DSL-interpreter bouwt, freeform input maakt GPT-5 veel beter inzetbaar voor echte, ongestructureerde taken.
In de onderstaande code hebben we een nep-SQL-runner gedefinieerd, deze geregistreerd als een custom tool en een eerste verzoek gedaan waarbij het model reageert met een vrije SQL-query. Die query wordt geëxtraheerd, lokaal uitgevoerd en het resultaat wordt teruggestuurd naar het model met dezelfde call_id om de context van de toolcall te behouden. Tot slot zet GPT‑5 de ruwe tooloutput om in een natuurlijk taalantwoord.
from openai import OpenAI
import random

client = OpenAI()

def run_sql_query(sql: str) -> str:
    print("\n[FAKE DB] Executing SQL:\n", sql)
    categories = ["Electronics", "Clothing", "Furniture", "Toys", "Books"]
    result = "category   | total_sales\n" + "-" * 28 + "\n"
    for cat in categories:
        result += f"{cat:<11} | {random.randint(5000, 200000)}\n"
    return result


tools = [
    {
        "type": "custom",
        "name": "sql_query_runner",
        "description": "Runs raw SQL queries on the company sales database.",
    }
]

messages = [
    {
        "role": "user",
        "content": "Show me the total sales for each product category last month.",
    }
]

# 1) First call - model emits a freeform tool call
resp = client.responses.create(model="gpt-5", tools=tools, input=messages)

# IMPORTANT: carry the tool call into the next turn
messages += resp.output  # <-- this preserves the tool_call with its call_id

# Find the tool call from the response output
tool_call = next(
    (
        x
        for x in resp.output
        if getattr(x, "type", "") in ("custom_tool_call", "function_call", "tool_call")
    ),
    None,
)
assert tool_call is not None, "No tool call found."

# Freeform text is in input (fallback to arguments for safety) raw_text = getattr(tool_call, "input", None) or getattr(tool_call, "arguments", "") sql_text = raw_text.strip() # 2) Execute the tool locally fake_result = run_sql_query(sql_text) # 3) Send tool result back, referencing the SAME call_id messages.append( { "type": "function_call_output", "call_id": tool_call.call_id, "output": fake_result, } ) # 4) Final call - model turns tool output into a natural answer final = client.responses.create(model="gpt-5", tools=tools, input=messages) print("\nFinal output text:\n", final.output_text)
Output:
[FAKE DB] Executing SQL:
 SELECT table_schema, table_name
FROM information_schema.tables
WHERE table_schema NOT IN ('information_schema','pg_catalog')
ORDER BY 1,2;

Final output text:
 Here are the total sales by category for last month (July 2025):

- Electronics: 31,766
- Clothing: 90,266
- Furniture: 55,471
- Toys: 124,625
- Books: 74,263

Want this as a CSV or chart?Voor scenario's waar precisie cruciaal is, ondersteunt GPT-5 contextvrije grammatica's (CFG's) om uitvoerformaten strikt te beheersen. Door een grammatica toe te voegen, zoals SQL-syntaxis of een domeinspecifieke taal, zorg je dat de antwoorden van het model altijd aan jouw structuur voldoen. Dit is vooral waardevol voor kritieke of geautomatiseerde workflows, waar zelfs kleine afwijkingen in formaat fouten kunnen veroorzaken.
In het voorbeeld hebben we een tool sql_query_runner gebouwd en de SQL-syntaxis gedefinieerd met een Lark-grammatica, zodat elke SQL die het model genereert altijd geldig is en exact onze structuur volgt.
In de eerste modelaanroep gebruikt GPT‑5 deze tool om een grammatica-conforme SQL-query te produceren voor de verkopen per categorie van afgelopen maand. We voeren die query vervolgens lokaal uit, sturen de resultaten terug naar het model met dezelfde call_id en doen een tweede aanroep waarin GPT‑5 de ruwe data omzet in een helder antwoord in natuurlijke taal.
from openai import OpenAI
import random

client = OpenAI()


def run_sql_query(sql: str) -> str:
    cats = ["Electronics", "Clothing", "Furniture", "Toys", "Books"]
    rows = [f"{c:<11} | {random.randint(5_000, 200_000)}" for c in cats]
    return "category   | total_sales\n" + "-" * 28 + "\n" + "\n".join(rows)


tools = [
    {
        "type": "custom",
        "name": "sql_query_runner",
        "description": "Runs raw SQL on the sales DB.",
        "format": {
            "type": "grammar",
            "syntax": "lark",
            "definition": r"""
start: SELECT CATEGORY COMMA SUM LPAREN SALES RPAREN AS TOTAL_SALES FROM ORDERS WHERE ORDER_MONTH EQ ESCAPED_STRING GROUP BY CATEGORY ORDER BY TOTAL_SALES (DESC|ASC)?

SELECT: "SELECT"
CATEGORY: "category"
COMMA: ","
SUM: "SUM"
LPAREN: "("
SALES: "sales"
RPAREN: ")"
AS: "AS"
TOTAL_SALES: "total_sales"
FROM: "FROM"
ORDERS: "orders"
WHERE: "WHERE"
ORDER_MONTH: "order_month"
EQ: "="
GROUP: "GROUP"
BY: "BY"
ORDER: "ORDER"
DESC: "DESC"
ASC: "ASC"

%import common.ESCAPED_STRING
%ignore /[ \t\r\n]+/
        """,
        },
    }
]

msgs = [
    {
        "role": "user",
        "content": "Show me the total sales for each product category last month.",
    }
]

print("\n=== 1) First Model Call ===")
resp = client.responses.create(
    model="gpt-5", input=msgs, tools=tools, text={"format": {"type": "text"}}
)
print("Raw model output objects:\n", resp.output)

msgs += resp.output
tool_call = next(
    x
    for x in resp.output
    if getattr(x, "type", "") in ("custom_tool_call", "function_call", "tool_call")
)
sql = (getattr(tool_call, "input", None) or getattr(tool_call, "arguments", "")).strip()
print("\nExtracted SQL from tool call:\n", sql)

print("\n=== 2) Local Tool Execution ===")
tool_result = run_sql_query(sql)
print(tool_result)

msgs.append(
    {
        "type": "function_call_output",
        "call_id": getattr(tool_call, "call_id", None) or tool_call["call_id"],
        "output": tool_result,
    }
)

print("\n=== 3) Second Model Call ===")
final = client.responses.create(
    model="gpt-5", input=msgs, tools=tools, text={"format": {"type": "text"}}
)
print("\nFinal natural-language answer:\n", final.output_text)
Zoals we zien, genereerde het model eerst een grammatica-conforme SQL-query, voerde vervolgens de functie uit om verkoopgegevens op te halen en zette tot slot die data om in een heldere, gerangschikte samenvatting in natuurlijke taal van de verkopen per categorie van afgelopen maand.
=== 1) First Model Call ===
Raw model output objects:
 [ResponseReasoningItem(id='rs_6897acee8afc819f9e7ae0f675bfa4ee0d5175a46255063b', summary=[], type='reasoning', content=None, encrypted_content=None, status=None), ResponseCustomToolCall(call_id='call_vzcHPT7EGvb7QbhF2djVIJZA', input='SELECT category, SUM(sales) AS total_sales FROM orders WHERE order_month = "2025-07" GROUP BY category ORDER BY total_sales DESC', name='sql_query_runner', type='custom_tool_call', id='ctc_6897acf67a34819f84a085191e4ca1fb0d5175a46255063b', status='completed')]

Extracted SQL from tool call:
 SELECT category, SUM(sales) AS total_sales FROM orders WHERE order_month = "2025-07" GROUP BY category ORDER BY total_sales DESC

=== 2) Local Tool Execution ===
category   | total_sales
----------------------------
Electronics | 52423
Clothing    | 59976
Furniture   | 172713
Toys        | 69667
Books       | 14633

=== 3) Second Model Call ===

Final natural-language answer:
 Here are the total sales by category for last month (2025-07):

- Furniture: 172,713
- Toys: 69,667
- Clothing: 59,976
- Electronics: 52,423
- Books: 14,633

Want this as a chart or need a different month?De nieuwe parameter allowed_tools laat je een subset van tools definiëren die het model uit je volledige toolset mag gebruiken. Je kunt de modus op auto (model mag kiezen) of required (model moet er één gebruiken) zetten. Dit verbetert de veiligheid, voorspelbaarheid en promptcaching door te voorkomen dat het model ongewenste tools aanroept, terwijl het wel flexibel de beste optie uit de toegestane set kan kiezen.
Een volledige toolset bevat zowel get_weather als send_email, maar we hebben alleen get_weather toegestaan en de modus op "required" gezet, zodat het model die móét gebruiken.
Op de vraag “What’s the weather in Oslo?” reageerde GPT‑5 met een function call naar get_weather en het juiste argument {"city": "Oslo"}.
from openai import OpenAI

client = OpenAI()

# Full toolset (N)

tools = [
    {
        "type": "function",
        "name": "get_weather",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
    {
        "type": "function",
        "name": "send_email",
        "parameters": {
            "type": "object",
            "properties": {"to": {"type": "string"}, "body": {"type": "string"}},
            "required": ["to", "body"],
        },
    },
]

# Allowed subset (M < N), mode=required  → must call get_weather

resp = client.responses.create(
    model="gpt-5",
    input="What's the weather in Oslo?",
    tools=tools,
    tool_choice={
        "type": "allowed_tools",
        "mode": "required",  # use "auto" to let it decide
        "tools": [{"type": "function", "name": "get_weather"}],
    },
)
for item in resp.output:
    if getattr(item, "type", None) in ("function_call", "tool_call", "custom_tool_call"):
        print("Tool name:", getattr(item, "name", None))
        print("Arguments:", getattr(item, "arguments", None))
Output:
Tool name: get_weather
Arguments: {"city":"Oslo"}Preambles zijn korte, voor de gebruiker zichtbare toelichtingen die GPT-5 kan genereren vóórdat het een tool aanroept, waarin het uitlegt waarom die aanroep plaatsvindt. Dit verhoogt transparantie, vertrouwen en het gemak van debuggen, zeker in complexe workflows. Door het model simpelweg te instrueren om “eerst uit te leggen voor je een tool aanroept”, voelen interacties menselijker en doelbewuster aan, zonder noemenswaardige extra latency.
In de code hieronder definieerden we een get_weather-functie-tool en voegden we een systeem-instructie toe die het model vraagt om een korte, zichtbare zin te geven met het voorvoegsel "Preamble:" voordat de toolcall wordt gedaan.
Op de vraag “What’s the weather in Oslo?” gaf GPT‑5 eerst een preamble waarin stond dat het een live weerdienst raadpleegde, en riep daarna de get_weather-tool aan met het juiste argument {"city": "Oslo"}. Na de tool lokaal te hebben uitgevoerd en het resultaat terug te geven, volgde het uiteindelijke antwoord in natuurlijke taal.
from openai import OpenAI
client = OpenAI()


def get_weather(city: str):
    return {"city": city, "temperature_c": 12}

# Tool
tools = [{
    "type": "function",
    "name": "get_weather",
    "description": "Get current temperature for a city.",
    "parameters": {
        "type": "object",
        "properties": {"city": {"type": "string"}},
        "required": ["city"],
        "additionalProperties": False
    },
    "strict": True,
}]

# Messages (enable preamble via system instruction)
msgs = [
    {"role": "system", "content": "Before you call a tool, explain why you are calling it in ONE short sentence prefixed with 'Preamble:'."},
    {"role": "user", "content": "What's the weather in Oslo?"}
]

# 1) Model call → expect a visible preamble + a tool call
resp = client.responses.create(model="gpt-5", input=msgs, tools=tools)
print("=== First response objects ===")
for item in resp.output:
    t = getattr(item, "type", None)
    if t == "message":  # preamble is a normal assistant message
        print("PREAMBLE:", getattr(item, "content", None))
    if t in ("function_call","tool_call","custom_tool_call"):
        print("TOOL:", getattr(item, "name", None))
        print("ARGS:", getattr(item, "arguments", None))
tool_call = next(x for x in resp.output if getattr(x, "type", None) in ("function_call","tool_call","custom_tool_call"))
msgs += resp.output  # keep context

# 2) Execute tool locally (fake)
import json
args = json.loads(getattr(tool_call, "arguments", "{}"))
city = args.get("city", "Unknown")
tool_result = get_weather(city)

# 3) Return tool result
msgs.append({"type": "function_call_output", "call_id": tool_call.call_id, "output": json.dumps(tool_result)})

# 4) Final model call → natural answer
final = client.responses.create(model="gpt-5", input=msgs, tools=tools)
print("\n=== Final answer ===")
print(final.output_text)
Zoals te zien is, gaf het model eerst een korte preamble met zijn intentie, riep daarna correct de get_weather-tool aan met {"city": "Oslo"}, en gaf tot slot de temperatuur terug in natuurlijke taal.
=== First response objects ===
PREAMBLE: [ResponseOutputText(annotations=[], text='Preamble: I'm checking a live weather service to get the current conditions for Oslo.', type='output_text', logprobs=[])]
TOOL: get_weather
ARGS: {"city":"Oslo"}

=== Final answer ===
It's currently about 12°C in Oslo.GPT-5 is ontworpen om uit te blinken met goed geformuleerde prompts, en OpenAI biedt een Prompt Optimizer om je te helpen deze te verfijnen. Deze tool past je prompts automatisch aan op de redeneerstijl van GPT-5, wat nauwkeurigheid en efficiëntie verbetert.
Ga naar de Edit prompt - OpenAI API en schrijf een eenvoudige prompt, zoals "Create a Netflix clone web application." De tool zal je prompt opdelen in een gedetailleerde structuur, geoptimaliseerd voor het GPT-5-model.
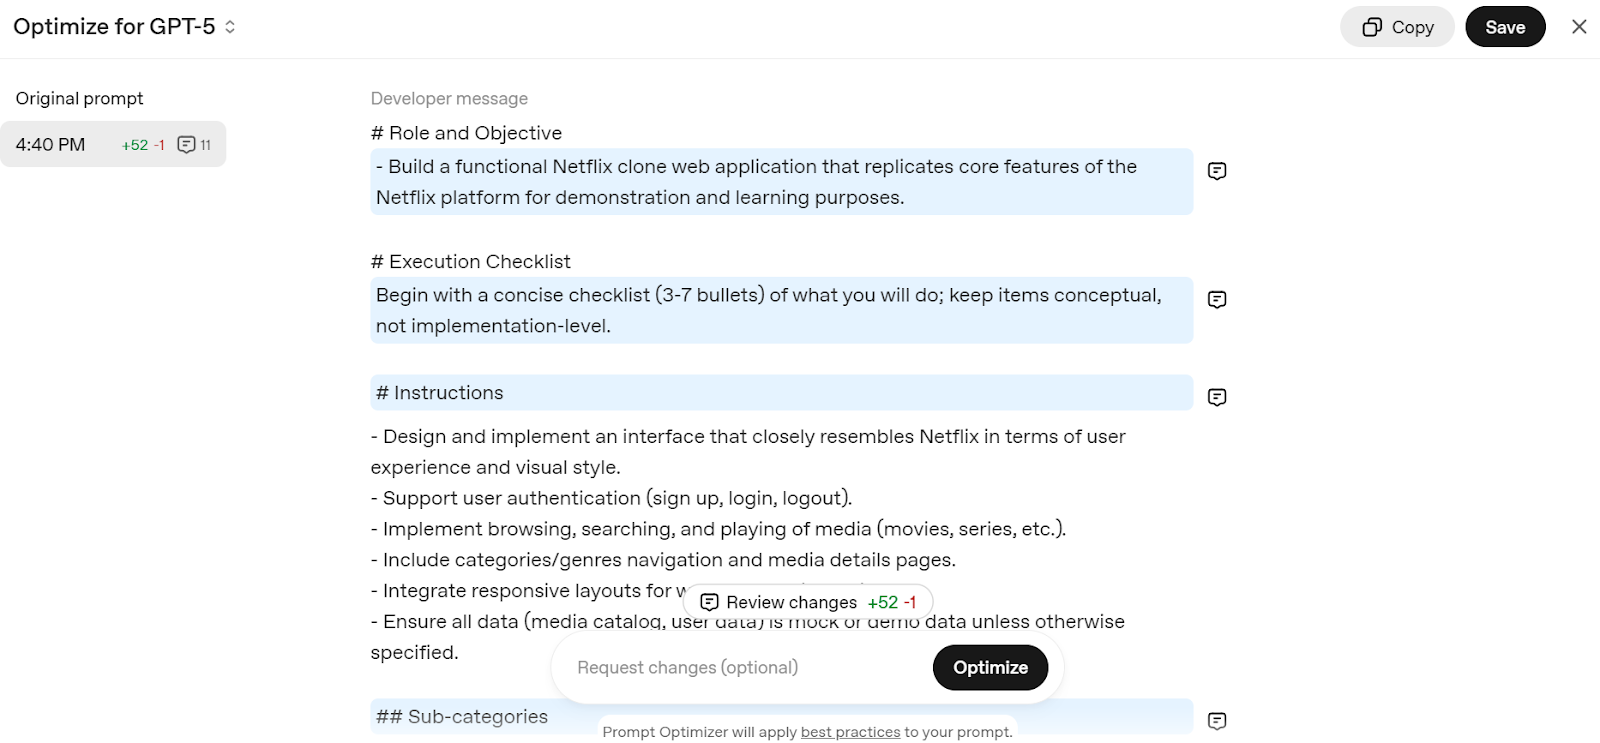
Bron: Prompt Optimizer
Kopieer de prompt en plak hem in de ChatGPT-chat om je eigen Netflix-webdienst te bouwen.
OpenAI raadt ontwikkelaars sterk aan om van oudere modellen te migreren naar de nieuwe GPT‑5-familie om kosten te verlagen, de nauwkeurigheid te verbeteren en de antwoordkwaliteit te verhogen.
Migreren is eenvoudig; volg simpelweg de onderstaande tabel om het juiste GPT‑5-model en redeneerniveau voor jouw use case te kiezen.
|
Huidig model |
Aanbevolen GPT-5-model |
Startniveau reasoning |
Migratienotities |
|
o3 |
GPT-5 |
Medium |
Begin met medium reasoning + prompttuning; verhoog naar high indien nodig. |
|
gpt-4.1 |
GPT-5 |
Minimal |
Begin met minimal reasoning + prompttuning; verhoog naar low voor betere prestaties. |
|
o4-mini |
GPT-5-mini |
Medium |
Gebruik GPT-5-mini met prompttuning. |
|
gpt-4.1-mini |
GPT-5-mini |
Minimal |
Gebruik GPT-5-mini met prompttuning. |
|
gpt-4.1-nano |
GPT-5-nano |
Minimal |
Gebruik GPT-5-nano met prompttuning. |
GPT-5 is meer dan alleen een slimmer model; het is een ontwikkelaarstoolkit voor het bouwen van intelligente, betrouwbare en efficiënte AI-systemen. Met fijnafstemming van reasoning, verbosity, toolgebruik en uitvoerformaten past het zich aan alles aan: van snelle codeertaken tot complexe workflows in meerdere stappen.
Door de nieuwe functies en best practices te benutten, kun je met minimale inspanning productieklare AI-toepassingen ontwikkelen met de OpenAI SDK.
Ben je nieuw met OpenAI? Bekijk dan zeker de onderstaande resources:
Top OpenAI-cursussen
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


