
{count, plural, one {Corso} other {Corsi}}
Lavorare con l'API di OpenAI
{hours} ore
181.3K
GPT-5 introduce un nuovo parametro di sforzo di ragionamento che ti consente di controllare quanto a fondo il modello pensa prima di rispondere. Puoi scegliere tra livelli di sforzo minimal, low, medium o high, a seconda delle tue esigenze.
Minimal è perfetto per attività sensibili alla velocità come coding rapido o semplice esecuzione di istruzioni, mentre medium e high consentono un ragionamento più approfondito, passo dopo passo. Questa flessibilità ti permette di bilanciare latenza, costo e accuratezza.
Per prima cosa, installa l'SDK Python di OpenAI e imposta la tua chiave API come variabile d'ambiente:
pip install openaiImposta la tua chiave API (sostituisci con la tua chiave reale):
export OPENAI_API_KEY="your_api_key_here"setx OPENAI_API_KEY "your_api_key_here"Usiamo la Response API per generare testo con sforzo di ragionamento "minimal". Significa che il modello risponderà direttamente, senza allocare token per il ragionamento interno.
import os
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
)

print(resp.output_text)
Output:
Guido van Rossum is known as the father (creator) of Python. He first released Python in 1991.Puoi anche controllare il riepilogo dell'uso dei token per capire come il modello ha elaborato la tua richiesta:
print(f"Input tokens: {resp.usage.input_tokens}")
print(f"  - Cached tokens: {resp.usage.input_tokens_details.cached_tokens}")
print(f"Output tokens: {resp.usage.output_tokens}")
print(f"  - Reasoning tokens: {resp.usage.output_tokens_details.reasoning_tokens}")
print(f"Total tokens: {resp.usage.total_tokens}")
Come mostrato, a sforzo minimal i token usati per il ragionamento sono zero.
Input tokens: 13
  - Cached tokens: 0
Output tokens: 31
  - Reasoning tokens: 0
Total tokens: 44
Ora aumentiamo lo sforzo di ragionamento a "high" per vedere come cambia il ragionamento interno del modello:
resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "high"},
)

print(resp.output_text)
Output:
Guido van Rossum. He created Python and first released it in 1991.Controlla di nuovo l'uso dei token:
print(f"Input tokens: {resp.usage.input_tokens}")
print(f"  - Cached tokens: {resp.usage.input_tokens_details.cached_tokens}")
print(f"Output tokens: {resp.usage.output_tokens}")
print(f"  - Reasoning tokens: {resp.usage.output_tokens_details.reasoning_tokens}")
print(f"Total tokens: {resp.usage.total_tokens}")
Anche per una domanda semplice, il modello ha usato 192 token per il ragionamento con sforzo high. Questo mostra come ora puoi controllare la profondità del ragionamento per ottimizzare costo, velocità o accuratezza secondo necessità.
Input tokens: 13
  - Cached tokens: 0
Output tokens: 216
  - Reasoning tokens: 192
Total tokens: 229Con GPT-5, ora puoi controllare direttamente quanto il modello dice usando il parametro di verbosità. Impostalo su low per risposte concise, medium per un livello di dettaglio bilanciato o high per spiegazioni approfondite. È particolarmente utile per la generazione di codice: con verbosità bassa ottieni codice breve e pulito, con verbosità alta commenti inline e ragionamenti dettagliati.
Puoi combinare il parametro verbosity con i controlli di reasoning per adattare le risposte esattamente alle tue esigenze. Che tu voglia una frase breve, una risposta più lunga o un report completo, hai piena flessibilità.
La verbosità "low" produce una risposta breve e diretta.
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "low"},
)

print(resp.output_text)
Output:
Guido van Rossum.La verbosità "high" genera una risposta molto più dettagliata ed esplicativa.
resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "high"},
)

print(resp.output_text)
Output:
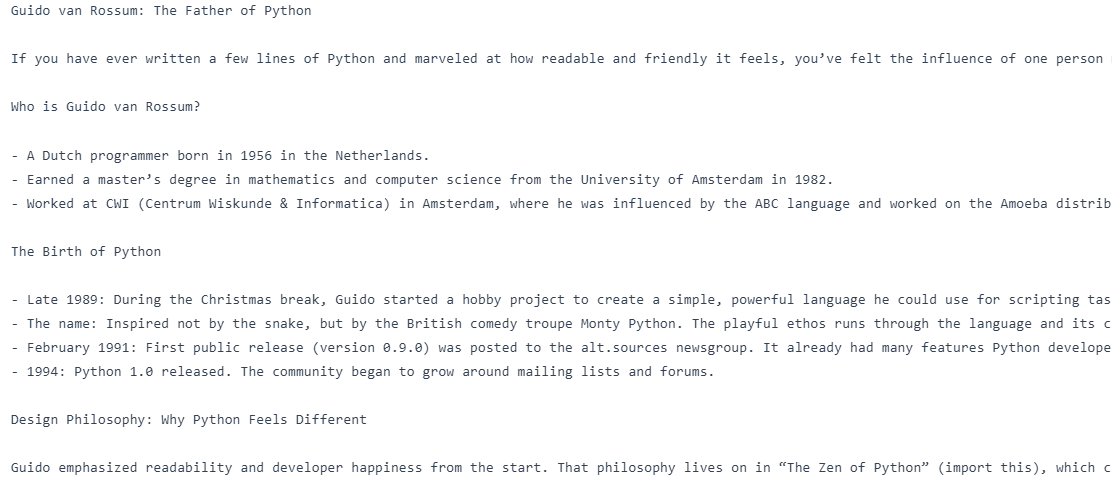
Guido van Rossum is known as the "father of Python." He created Python in the late 1980s and released the first version (Python 0.9.0) in 1991. He also served for many years as Python's "Benevolent Dictator For Life" (BDFL), guiding the language's development.Uno dei maggiori upgrade di GPT-5 è la capacità di passare il chain-of-thought (CoT) tra i turni nella Responses API. Significa che il modello ricorda il proprio ragionamento interno dai passaggi precedenti, evitando di ripensare da zero e migliorando sia velocità che accuratezza.
Nelle conversazioni multi-turn, soprattutto quando usi dei tool, passa semplicemente il previous_response_id per mantenere vivo il contesto di ragionamento.
La prima richiesta chiede “Who is the father of Python?”, e la seconda, collegata alla prima tramite previous_response_id, chiede al modello di “Write a blog on it” senza ripetere l’argomento. Passando l’ID della risposta precedente, il modello conserva il contesto di ragionamento.
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

first = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "low"},
)

followup = client.responses.create(
    model="gpt-5",
    previous_response_id=first.id,
    input="Write a blog on it.",
    reasoning={"effort": "medium"},
    text={"verbosity": "high"},
)

print(followup.output_text)
Il risultato è un post sul “padre di Python”.
Gli strumenti personalizzati in GPT-5 ora supportano input liberi, consentendo al modello di inviare testo grezzo, come codice, query SQL o comandi shell, direttamente ai tuoi tool. È un grande passo avanti rispetto al vecchio approccio solo-JSON strutturato, dandoti più flessibilità su come il modello interagisce con i tuoi sistemi. Che tu stia costruendo un esecutore di codice, un motore di query o un interprete DSL, l'input libero rende GPT-5 molto più adattabile ad attività reali e non strutturate.
Nel codice qui sotto, abbiamo definito un finto runner SQL, registrato come tool personalizzato, e creato una richiesta iniziale in cui il modello risponde con una query SQL libera. Quella query viene estratta, eseguita in locale e il risultato viene rimandato al modello usando lo stesso call_id per mantenere il contesto della chiamata al tool. Infine, GPT‑5 trasforma l'output grezzo del tool in una risposta in linguaggio naturale.
from openai import OpenAI
import random

client = OpenAI()

def run_sql_query(sql: str) -> str:
    print("\n[FAKE DB] Executing SQL:\n", sql)
    categories = ["Electronics", "Clothing", "Furniture", "Toys", "Books"]
    result = "category   | total_sales\n" + "-" * 28 + "\n"
    for cat in categories:
        result += f"{cat:<11} | {random.randint(5000, 200000)}\n"
    return result


tools = [
    {
        "type": "custom",
        "name": "sql_query_runner",
        "description": "Runs raw SQL queries on the company sales database.",
    }
]

messages = [
    {
        "role": "user",
        "content": "Show me the total sales for each product category last month.",
    }
]

# 1) First call - model emits a freeform tool call
resp = client.responses.create(model="gpt-5", tools=tools, input=messages)

# IMPORTANT: carry the tool call into the next turn
messages += resp.output  # <-- this preserves the tool_call with its call_id

# Find the tool call from the response output
tool_call = next(
    (
        x
        for x in resp.output
        if getattr(x, "type", "") in ("custom_tool_call", "function_call", "tool_call")
    ),
    None,
)
assert tool_call is not None, "No tool call found."

# Freeform text is in input (fallback to arguments for safety) raw_text = getattr(tool_call, "input", None) or getattr(tool_call, "arguments", "") sql_text = raw_text.strip() # 2) Execute the tool locally fake_result = run_sql_query(sql_text) # 3) Send tool result back, referencing the SAME call_id messages.append( { "type": "function_call_output", "call_id": tool_call.call_id, "output": fake_result, } ) # 4) Final call - model turns tool output into a natural answer final = client.responses.create(model="gpt-5", tools=tools, input=messages) print("\nFinal output text:\n", final.output_text)
Output:
[FAKE DB] Executing SQL:
 SELECT table_schema, table_name
FROM information_schema.tables
WHERE table_schema NOT IN ('information_schema','pg_catalog')
ORDER BY 1,2;

Final output text:
 Here are the total sales by category for last month (July 2025):

- Electronics: 31,766
- Clothing: 90,266
- Furniture: 55,471
- Toys: 124,625
- Books: 74,263

Want this as a CSV or chart?Per scenari in cui la precisione è critica, GPT-5 supporta le grammatiche context-free (CFG) per controllare rigorosamente i formati di output. Allegando una grammatica come la sintassi SQL o un linguaggio specifico di dominio, puoi garantire che le risposte del modello rispettino sempre la struttura richiesta. È particolarmente utile per workflow ad alto impatto o automatizzati, dove anche piccole deviazioni di formato possono causare errori.
Nel codice di esempio abbiamo creato un tool sql_query_runner e definito la sua sintassi SQL usando una grammatica Lark, assicurando che qualsiasi SQL generato dal modello sia sempre valido e segua esattamente la nostra struttura.
Nella prima chiamata al modello, GPT‑5 usa questo tool per produrre una query SQL conforme alla grammatica per le vendite dello scorso mese per categoria. Eseguiamo poi la query in locale, inviamo i risultati al modello usando lo stesso call_id e facciamo una seconda chiamata in cui GPT‑5 trasforma i dati grezzi in una risposta chiara in linguaggio naturale.
from openai import OpenAI
import random

client = OpenAI()


def run_sql_query(sql: str) -> str:
    cats = ["Electronics", "Clothing", "Furniture", "Toys", "Books"]
    rows = [f"{c:<11} | {random.randint(5_000, 200_000)}" for c in cats]
    return "category   | total_sales\n" + "-" * 28 + "\n" + "\n".join(rows)


tools = [
    {
        "type": "custom",
        "name": "sql_query_runner",
        "description": "Runs raw SQL on the sales DB.",
        "format": {
            "type": "grammar",
            "syntax": "lark",
            "definition": r"""
start: SELECT CATEGORY COMMA SUM LPAREN SALES RPAREN AS TOTAL_SALES FROM ORDERS WHERE ORDER_MONTH EQ ESCAPED_STRING GROUP BY CATEGORY ORDER BY TOTAL_SALES (DESC|ASC)?

SELECT: "SELECT"
CATEGORY: "category"
COMMA: ","
SUM: "SUM"
LPAREN: "("
SALES: "sales"
RPAREN: ")"
AS: "AS"
TOTAL_SALES: "total_sales"
FROM: "FROM"
ORDERS: "orders"
WHERE: "WHERE"
ORDER_MONTH: "order_month"
EQ: "="
GROUP: "GROUP"
BY: "BY"
ORDER: "ORDER"
DESC: "DESC"
ASC: "ASC"

%import common.ESCAPED_STRING
%ignore /[ \t\r\n]+/
        """,
        },
    }
]

msgs = [
    {
        "role": "user",
        "content": "Show me the total sales for each product category last month.",
    }
]

print("\n=== 1) First Model Call ===")
resp = client.responses.create(
    model="gpt-5", input=msgs, tools=tools, text={"format": {"type": "text"}}
)
print("Raw model output objects:\n", resp.output)

msgs += resp.output
tool_call = next(
    x
    for x in resp.output
    if getattr(x, "type", "") in ("custom_tool_call", "function_call", "tool_call")
)
sql = (getattr(tool_call, "input", None) or getattr(tool_call, "arguments", "")).strip()
print("\nExtracted SQL from tool call:\n", sql)

print("\n=== 2) Local Tool Execution ===")
tool_result = run_sql_query(sql)
print(tool_result)

msgs.append(
    {
        "type": "function_call_output",
        "call_id": getattr(tool_call, "call_id", None) or tool_call["call_id"],
        "output": tool_result,
    }
)

print("\n=== 3) Second Model Call ===")
final = client.responses.create(
    model="gpt-5", input=msgs, tools=tools, text={"format": {"type": "text"}}
)
print("\nFinal natural-language answer:\n", final.output_text)
Come si vede, il modello ha prima generato una query SQL conforme alla grammatica, poi ha eseguito la funzione per recuperare i dati di vendita. Infine, GPT-5 ha convertito quei dati in un riassunto chiaro e ordinato in linguaggio naturale delle vendite per categoria dello scorso mese.
=== 1) First Model Call ===
Raw model output objects:
 [ResponseReasoningItem(id='rs_6897acee8afc819f9e7ae0f675bfa4ee0d5175a46255063b', summary=[], type='reasoning', content=None, encrypted_content=None, status=None), ResponseCustomToolCall(call_id='call_vzcHPT7EGvb7QbhF2djVIJZA', input='SELECT category, SUM(sales) AS total_sales FROM orders WHERE order_month = "2025-07" GROUP BY category ORDER BY total_sales DESC', name='sql_query_runner', type='custom_tool_call', id='ctc_6897acf67a34819f84a085191e4ca1fb0d5175a46255063b', status='completed')]

Extracted SQL from tool call:
 SELECT category, SUM(sales) AS total_sales FROM orders WHERE order_month = "2025-07" GROUP BY category ORDER BY total_sales DESC

=== 2) Local Tool Execution ===
category   | total_sales
----------------------------
Electronics | 52423
Clothing    | 59976
Furniture   | 172713
Toys        | 69667
Books       | 14633

=== 3) Second Model Call ===

Final natural-language answer:
 Here are the total sales by category for last month (2025-07):

- Furniture: 172,713
- Toys: 69,667
- Clothing: 59,976
- Electronics: 52,423
- Books: 14,633

Want this as a chart or need a different month?Il nuovo parametro allowed_tools ti consente di definire un sottoinsieme di strumenti che il modello può usare dal tuo toolkit completo. Puoi impostare la modalità su auto (il modello può scegliere) o required (il modello deve usarne uno). Questo migliora sicurezza, prevedibilità e caching del prompt impedendo al modello di chiamare strumenti indesiderati, pur lasciandogli la flessibilità di scegliere la migliore opzione tra quelle consentite.
Un toolkit completo contiene sia get_weather che send_email, ma qui abbiamo consentito solo get_weather e impostato la modalità su "required", obbligando il modello a usarlo.
Alla domanda “What’s the weather in Oslo?”, GPT‑5 ha risposto con una chiamata di funzione a get_weather e l’argomento corretto {"city": "Oslo"}.
from openai import OpenAI

client = OpenAI()

# Full toolset (N)

tools = [
    {
        "type": "function",
        "name": "get_weather",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
    {
        "type": "function",
        "name": "send_email",
        "parameters": {
            "type": "object",
            "properties": {"to": {"type": "string"}, "body": {"type": "string"}},
            "required": ["to", "body"],
        },
    },
]

# Allowed subset (M < N), mode=required  → must call get_weather

resp = client.responses.create(
    model="gpt-5",
    input="What's the weather in Oslo?",
    tools=tools,
    tool_choice={
        "type": "allowed_tools",
        "mode": "required",  # use "auto" to let it decide
        "tools": [{"type": "function", "name": "get_weather"}],
    },
)
for item in resp.output:
    if getattr(item, "type", None) in ("function_call", "tool_call", "custom_tool_call"):
        print("Tool name:", getattr(item, "name", None))
        print("Arguments:", getattr(item, "arguments", None))
Output:
Tool name: get_weather
Arguments: {"city":"Oslo"}I preamble sono brevi spiegazioni visibili all’utente che GPT-5 può generare prima di chiamare un tool, spiegando il perché di quella chiamata. Questo aumenta trasparenza, fiducia e facilità di debug, specialmente in workflow complessi. Istruendo semplicemente il modello a “spiegare prima di chiamare un tool”, puoi rendere le interazioni più umane e intenzionali senza aggiungere latenza significativa.
Nel codice seguente, abbiamo definito un tool funzione get_weather e aggiunto un'istruzione di sistema che dice al modello di produrre una breve frase visibile all’utente con prefisso "Preamble:" prima di effettuare la chiamata al tool.
Alla domanda “What’s the weather in Oslo?”, GPT‑5 ha prima prodotto un preamble spiegando che stava controllando un servizio meteo live, poi ha chiamato il tool get_weather con l’argomento corretto {"city": "Oslo"}. Dopo l’esecuzione locale del tool e il ritorno del risultato, il modello ha fornito la risposta finale in linguaggio naturale.
from openai import OpenAI
client = OpenAI()


def get_weather(city: str):
    return {"city": city, "temperature_c": 12}

# Tool
tools = [{
    "type": "function",
    "name": "get_weather",
    "description": "Get current temperature for a city.",
    "parameters": {
        "type": "object",
        "properties": {"city": {"type": "string"}},
        "required": ["city"],
        "additionalProperties": False
    },
    "strict": True,
}]

# Messages (enable preamble via system instruction)
msgs = [
    {"role": "system", "content": "Before you call a tool, explain why you are calling it in ONE short sentence prefixed with 'Preamble:'."},
    {"role": "user", "content": "What's the weather in Oslo?"}
]

# 1) Model call → expect a visible preamble + a tool call
resp = client.responses.create(model="gpt-5", input=msgs, tools=tools)
print("=== First response objects ===")
for item in resp.output:
    t = getattr(item, "type", None)
    if t == "message":  # preamble is a normal assistant message
        print("PREAMBLE:", getattr(item, "content", None))
    if t in ("function_call","tool_call","custom_tool_call"):
        print("TOOL:", getattr(item, "name", None))
        print("ARGS:", getattr(item, "arguments", None))
tool_call = next(x for x in resp.output if getattr(x, "type", None) in ("function_call","tool_call","custom_tool_call"))
msgs += resp.output  # keep context

# 2) Execute tool locally (fake)
import json
args = json.loads(getattr(tool_call, "arguments", "{}"))
city = args.get("city", "Unknown")
tool_result = get_weather(city)

# 3) Return tool result
msgs.append({"type": "function_call_output", "call_id": tool_call.call_id, "output": json.dumps(tool_result)})

# 4) Final model call → natural answer
final = client.responses.create(model="gpt-5", input=msgs, tools=tools)
print("\n=== Final answer ===")
print(final.output_text)
Come si vede, il modello ha prima fornito un breve preamble che spiega l'intento, poi ha chiamato correttamente il tool get_weather con {"city": "Oslo"}, e infine ha restituito la temperatura in linguaggio naturale.
=== First response objects ===
PREAMBLE: [ResponseOutputText(annotations=[], text='Preamble: I'm checking a live weather service to get the current conditions for Oslo.', type='output_text', logprobs=[])]
TOOL: get_weather
ARGS: {"city":"Oslo"}

=== Final answer ===
It's currently about 12°C in Oslo.GPT-5 è progettato per dare il meglio con prompt ben costruiti, e OpenAI fornisce un Prompt Optimizer per aiutarti a perfezionarli. Questo strumento adatta automaticamente i tuoi prompt allo stile di ragionamento di GPT-5, migliorando accuratezza ed efficienza.
Vai a Edit prompt - OpenAI API e scrivi un prompt semplice, ad esempio "Create a Netflix clone web application." Verrà scomposto in una struttura dettagliata, ottimizzata per il modello GPT-5.
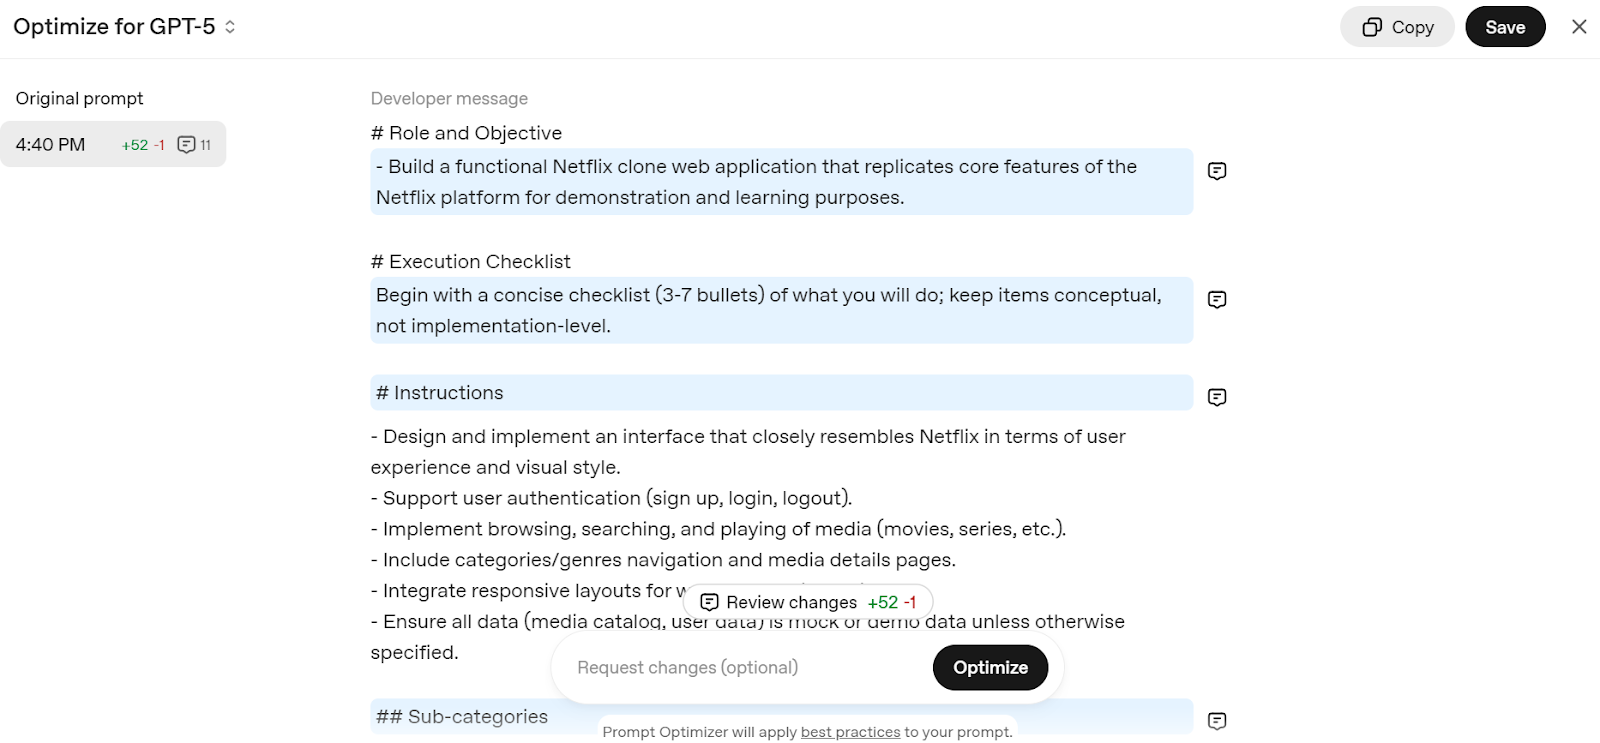
Fonte: Prompt Optimizer
Copia il prompt e incollalo nella chat di ChatGPT per iniziare a costruire il tuo servizio web tipo Netflix.
OpenAI consiglia vivamente agli sviluppatori di migrare dai modelli più vecchi alla nuova famiglia GPT‑5 per ridurre i costi, migliorare l'accuratezza e aumentare la qualità delle risposte.
La migrazione è semplice; segui la tabella qui sotto per scegliere il modello GPT‑5 e il livello di ragionamento più adatti al tuo caso d'uso.
|
Modello attuale |
Modello GPT-5 consigliato |
Livello di ragionamento iniziale |
Note di migrazione |
|
o3 |
GPT-5 |
Medium |
Inizia con reasoning medio + ottimizzazione del prompt; aumenta a high se necessario. |
|
gpt-4.1 |
GPT-5 |
Minimal |
Inizia con reasoning minimal + ottimizzazione del prompt; aumenta a low per prestazioni migliori. |
|
o4-mini |
GPT-5-mini |
Medium |
Usa GPT-5-mini con ottimizzazione del prompt. |
|
gpt-4.1-mini |
GPT-5-mini |
Minimal |
Usa GPT-5-mini con ottimizzazione del prompt. |
|
gpt-4.1-nano |
GPT-5-nano |
Minimal |
Usa GPT-5-nano con ottimizzazione del prompt. |
GPT-5 è più di un modello più intelligente; è un kit di strumenti per sviluppatori per creare sistemi di AI intelligenti, affidabili ed efficienti. Con controlli granulari su ragionamento, verbosità, uso dei tool e formati di output, si adatta a tutto: dal coding rapido a workflow complessi multi-step.
Sfruttando le nuove funzionalità e le best practice, puoi sviluppare applicazioni di AI pronte per la produzione con l'SDK OpenAI con il minimo sforzo.
Se è la tua prima volta con OpenAI, dai un'occhiata alle risorse qui sotto:
I migliori corsi OpenAI
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



