
कोर्स
OpenAI API के साथ काम करना
3 घंटा
179.5K
GPT-5 एक नया reasoning effort पैरामीटर लाता है जो आपको नियंत्रित करने देता है कि उत्तर देने से पहले मॉडल कितनी गहराई से सोचे। आप अपनी जरूरत के अनुसार minimal, low, medium, या high effort स्तर चुन सकते हैं।
Minimal effort तेज़ी‑संवेदी कार्यों जैसे त्वरित कोडिंग या सरल निर्देश पालन के लिए उत्तम है, जबकि medium और high अधिक गहन, क्रमबद्ध तर्क की अनुमति देते हैं। यह लचीलापन आपको latency, लागत, और शुद्धता के बीच संतुलन बैठाने देता है।
सबसे पहले, OpenAI Python SDK इंस्टॉल करें और अपनी API कुंजी को environment variable के रूप में सेट करें:
pip install openaiअपनी API कुंजी सेट करें (अपनी वास्तविक कुंजी से बदलें):
export OPENAI_API_KEY="your_api_key_here"setx OPENAI_API_KEY "your_api_key_here"आइए Response API का उपयोग करके “minimal” reasoning effort के साथ टेक्स्ट जनरेट करें। इसका मतलब है कि मॉडल आंतरिक तर्क के लिए टोकन आवंटित किए बिना सीधे उत्तर देगा।
import os
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
)

print(resp.output_text)
आउटपुट:
Guido van Rossum is known as the father (creator) of Python. He first released Python in 1991.आप यह भी देख सकते हैं कि मॉडल ने आपके अनुरोध को कैसे प्रोसेस किया, इसके लिए टोकन उपयोग सारांश जांचें:
print(f"Input tokens: {resp.usage.input_tokens}")
print(f"  - Cached tokens: {resp.usage.input_tokens_details.cached_tokens}")
print(f"Output tokens: {resp.usage.output_tokens}")
print(f"  - Reasoning tokens: {resp.usage.output_tokens_details.reasoning_tokens}")
print(f"Total tokens: {resp.usage.total_tokens}")
जैसा दिखाया गया है, effort को minimal पर सेट करने पर reasoning के लिए शून्य टोकन उपयोग हुए।
Input tokens: 13
  - Cached tokens: 0
Output tokens: 31
  - Reasoning tokens: 0
Total tokens: 44
अब, reasoning effort को "high" बढ़ाते हैं ताकि देखें कि मॉडल का आंतरिक तर्क कैसे बदलता है:
resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "high"},
)

print(resp.output_text)
आउटपुट:
Guido van Rossum. He created Python and first released it in 1991.टोकन उपयोग फिर से जांचें:
print(f"Input tokens: {resp.usage.input_tokens}")
print(f"  - Cached tokens: {resp.usage.input_tokens_details.cached_tokens}")
print(f"Output tokens: {resp.usage.output_tokens}")
print(f"  - Reasoning tokens: {resp.usage.output_tokens_details.reasoning_tokens}")
print(f"Total tokens: {resp.usage.total_tokens}")
सिर्फ एक सरल प्रश्न के लिए भी, high effort पर मॉडल ने reasoning के लिए 192 टोकन उपयोग किए। यह दिखाता है कि आप अब जरूरत के अनुसार लागत, गति, या शुद्धता के लिए तर्क की गहराई नियंत्रित कर सकते हैं।
Input tokens: 13
  - Cached tokens: 0
Output tokens: 216
  - Reasoning tokens: 192
Total tokens: 229GPT-5 के साथ, आप अब verbosity पैरामीटर का उपयोग करके सीधे नियंत्रित कर सकते हैं कि मॉडल कितना कहे। इसे low पर सेट करें संक्षिप्त उत्तरों के लिए, medium पर संतुलित विवरण के लिए, या high पर गहन व्याख्या के लिए। यह खास तौर पर कोड जेनरेशन में उपयोगी है—low verbosity छोटा, साफ कोड देता है, जबकि high verbosity इनलाइन कमेंट्स और विस्तृत तर्क शामिल करता है।
आप verbosity पैरामीटर को reasoning नियंत्रणों के साथ मिलाकर अपने अनुरूप उत्तर तैयार कर सकते हैं। चाहे आपको एक छोटा वाक्य चाहिए, लंबा उत्तर, या व्यापक रिपोर्ट—आपके पास पूरी लचीलापन है।
“low” verbosity संक्षिप्त, सीधे उत्तर पैदा करती है।
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "low"},
)

print(resp.output_text)
आउटपुट:
Guido van Rossum.“high” verbosity कहीं अधिक विस्तृत और व्याख्यात्मक उत्तर जनरेट करती है।
resp = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "high"},
)

print(resp.output_text)
आउटपुट:
Guido van Rossum is known as the "father of Python." He created Python in the late 1980s and released the first version (Python 0.9.0) in 1991. He also served for many years as Python's "Benevolent Dictator For Life" (BDFL), guiding the language's development.GPT-5 के सबसे बड़े अपग्रेड्स में से एक है इसकी क्षमता कि वह Responses API में टर्न्स के बीच chain-of-thought (CoT) reasoning पास कर सके। इसका मतलब है कि मॉडल पहले चरणों के आंतरिक तर्क को याद रखता है, जिससे अनावश्यक पुनर्विचार से बचाव होता है और गति व शुद्धता दोनों में सुधार होता है।
मल्टी‑टर्न बातचीतों में, खासकर जब आप टूल्स का उपयोग कर रहे हों, तर्क का संदर्भ बनाए रखने के लिए बस previous_response_id पास करें।
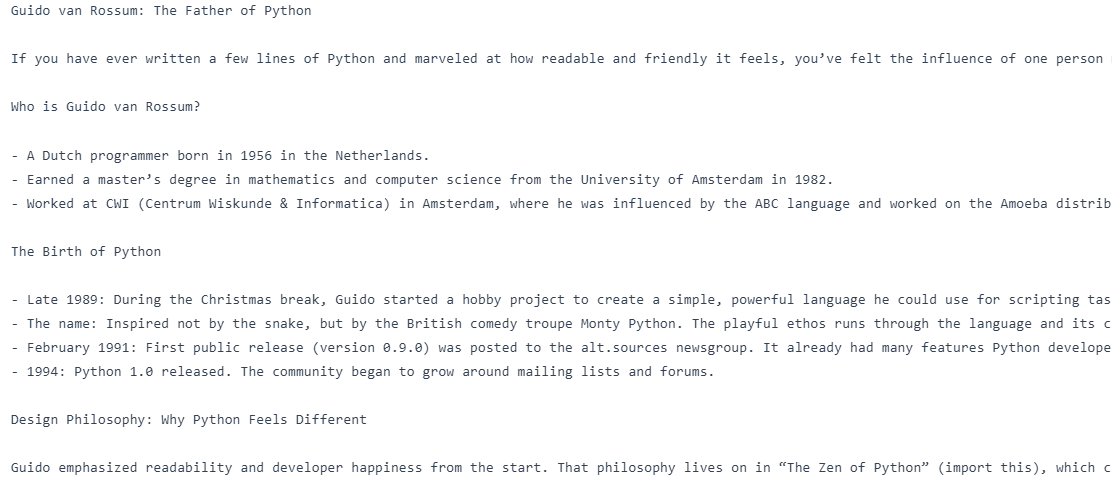
पहला अनुरोध पूछता है, “Who is the father of Python?”, और दूसरा अनुरोध, जिसे previous_response_id के ज़रिए पहले से जोड़ा गया है, मॉडल से “Write a blog on it” कहता है, बिना विषय को दोहराए। पिछले उत्तर का ID पास करके, मॉडल तर्क का संदर्भ बनाए रखता है।
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))

first = client.responses.create(
    model="gpt-5",
    input="Who is the father of Python?",
    reasoning={"effort": "minimal"},
    text={"verbosity": "low"},
)

followup = client.responses.create(
    model="gpt-5",
    previous_response_id=first.id,
    input="Write a blog on it.",
    reasoning={"effort": "medium"},
    text={"verbosity": "high"},
)

print(followup.output_text)
परिणामस्वरूप, हमें Python के जनक पर एक ब्लॉग मिला।
GPT-5 में कस्टम टूल अब फ्रीफॉर्म इनपुट्स को सपोर्ट करते हैं, जिससे मॉडल आपके टूल्स को सीधे कच्चा टेक्स्ट—जैसे कोड, SQL क्वेरीज़, या शेल कमांड—भेज सकता है। यह पुराने केवल structured JSON दृष्टिकोण से बड़ा कदम है, और मॉडल के आपके सिस्टम्स से इंटरेक्ट करने के तरीके में अधिक लचीलापन देता है। चाहे आप कोड एग्जीक्यूटर, क्वेरी इंजन, या DSL इंटरप्रेटर बना रहे हों, फ्रीफॉर्म इनपुट GPT‑5 को वास्तविक‑दुनिया के असंरचित कार्यों के लिए कहीं अधिक अनुकूल बनाता है।
नीचे दिए गए कोड में, हमने एक नकली SQL रनर परिभाषित किया है, उसे कस्टम टूल के रूप में रजिस्टर किया है, और एक शुरुआती अनुरोध किया है जहाँ मॉडल फ्रीफॉर्म SQL क्वेरी के साथ प्रतिक्रिया देता है। उस क्वेरी को निकाला जाता है, लोकली चलाया जाता है, और परिणाम को उसी call_id का उपयोग करके वापस मॉडल को भेजा जाता है ताकि टूल कॉल संदर्भ बना रहे। अंत में, GPT‑5 कच्चे टूल आउटपुट को प्राकृतिक भाषा के उत्तर में बदल देता है।
from openai import OpenAI
import random

client = OpenAI()

def run_sql_query(sql: str) -> str:
    print("\n[FAKE DB] Executing SQL:\n", sql)
    categories = ["Electronics", "Clothing", "Furniture", "Toys", "Books"]
    result = "category   | total_sales\n" + "-" * 28 + "\n"
    for cat in categories:
        result += f"{cat:<11} | {random.randint(5000, 200000)}\n"
    return result


tools = [
    {
        "type": "custom",
        "name": "sql_query_runner",
        "description": "Runs raw SQL queries on the company sales database.",
    }
]

messages = [
    {
        "role": "user",
        "content": "Show me the total sales for each product category last month.",
    }
]

# 1) First call - model emits a freeform tool call
resp = client.responses.create(model="gpt-5", tools=tools, input=messages)

# IMPORTANT: carry the tool call into the next turn
messages += resp.output  # <-- this preserves the tool_call with its call_id

# Find the tool call from the response output
tool_call = next(
    (
        x
        for x in resp.output
        if getattr(x, "type", "") in ("custom_tool_call", "function_call", "tool_call")
    ),
    None,
)
assert tool_call is not None, "No tool call found."

# Freeform text is in input (fallback to arguments for safety) raw_text = getattr(tool_call, "input", None) or getattr(tool_call, "arguments", "") sql_text = raw_text.strip() # 2) Execute the tool locally fake_result = run_sql_query(sql_text) # 3) Send tool result back, referencing the SAME call_id messages.append( { "type": "function_call_output", "call_id": tool_call.call_id, "output": fake_result, } ) # 4) Final call - model turns tool output into a natural answer final = client.responses.create(model="gpt-5", tools=tools, input=messages) print("\nFinal output text:\n", final.output_text)
आउटपुट:
[FAKE DB] Executing SQL:
 SELECT table_schema, table_name
FROM information_schema.tables
WHERE table_schema NOT IN ('information_schema','pg_catalog')
ORDER BY 1,2;

Final output text:
 Here are the total sales by category for last month (July 2025):

- Electronics: 31,766
- Clothing: 90,266
- Furniture: 55,471
- Toys: 124,625
- Books: 74,263

Want this as a CSV or chart?जहाँ सटीकता अत्यंत महत्वपूर्ण है, वहाँ GPT-5 context-free grammars (CFGs) सपोर्ट करता है ताकि आउटपुट फ़ॉर्मैट्स पर सख्त नियंत्रण रखा जा सके। SQL सिंटैक्स या किसी domain‑specific language जैसी ग्रामर जोड़कर, आप सुनिश्चित कर सकते हैं कि मॉडल के उत्तर हमेशा आपके आवश्यक स्ट्रक्चर से मेल खाएँ। यह विशेष रूप से उच्च‑दांव या स्वचालित वर्कफ़्लोज़ के लिए मूल्यवान है, जहाँ फ़ॉर्मैट में छोटे‑मोटे विचलन भी त्रुटियाँ पैदा कर सकते हैं।
उदाहरण कोड में, हमने एक sql_query_runner टूल बनाया और उसकी SQL सिंटैक्स Lark ग्रामर से परिभाषित की, ताकि मॉडल द्वारा जनरेट कोई भी SQL हमेशा वैध हो और हमारे सटीक ढांचे का पालन करे।
पहली मॉडल कॉल में, GPT‑5 इस टूल का उपयोग करके पिछले महीने की श्रेणी‑वार बिक्री के लिए ग्रामर‑अनुपालन SQL क्वेरी बनाता है। फिर हम वह क्वेरी लोकली चलाते हैं, परिणामों को उसी call_id से मॉडल को वापस भेजते हैं, और दूसरी कॉल में GPT‑5 कच्चे डेटा को स्पष्ट, प्राकृतिक भाषा के उत्तर में बदल देता है।
from openai import OpenAI
import random

client = OpenAI()


def run_sql_query(sql: str) -> str:
    cats = ["Electronics", "Clothing", "Furniture", "Toys", "Books"]
    rows = [f"{c:<11} | {random.randint(5_000, 200_000)}" for c in cats]
    return "category   | total_sales\n" + "-" * 28 + "\n" + "\n".join(rows)


tools = [
    {
        "type": "custom",
        "name": "sql_query_runner",
        "description": "Runs raw SQL on the sales DB.",
        "format": {
            "type": "grammar",
            "syntax": "lark",
            "definition": r"""
start: SELECT CATEGORY COMMA SUM LPAREN SALES RPAREN AS TOTAL_SALES FROM ORDERS WHERE ORDER_MONTH EQ ESCAPED_STRING GROUP BY CATEGORY ORDER BY TOTAL_SALES (DESC|ASC)?

SELECT: "SELECT"
CATEGORY: "category"
COMMA: ","
SUM: "SUM"
LPAREN: "("
SALES: "sales"
RPAREN: ")"
AS: "AS"
TOTAL_SALES: "total_sales"
FROM: "FROM"
ORDERS: "orders"
WHERE: "WHERE"
ORDER_MONTH: "order_month"
EQ: "="
GROUP: "GROUP"
BY: "BY"
ORDER: "ORDER"
DESC: "DESC"
ASC: "ASC"

%import common.ESCAPED_STRING
%ignore /[ \t\r\n]+/
        """,
        },
    }
]

msgs = [
    {
        "role": "user",
        "content": "Show me the total sales for each product category last month.",
    }
]

print("\n=== 1) First Model Call ===")
resp = client.responses.create(
    model="gpt-5", input=msgs, tools=tools, text={"format": {"type": "text"}}
)
print("Raw model output objects:\n", resp.output)

msgs += resp.output
tool_call = next(
    x
    for x in resp.output
    if getattr(x, "type", "") in ("custom_tool_call", "function_call", "tool_call")
)
sql = (getattr(tool_call, "input", None) or getattr(tool_call, "arguments", "")).strip()
print("\nExtracted SQL from tool call:\n", sql)

print("\n=== 2) Local Tool Execution ===")
tool_result = run_sql_query(sql)
print(tool_result)

msgs.append(
    {
        "type": "function_call_output",
        "call_id": getattr(tool_call, "call_id", None) or tool_call["call_id"],
        "output": tool_result,
    }
)

print("\n=== 3) Second Model Call ===")
final = client.responses.create(
    model="gpt-5", input=msgs, tools=tools, text={"format": {"type": "text"}}
)
print("\nFinal natural-language answer:\n", final.output_text)
जैसा हम देख सकते हैं, मॉडल ने पहले ग्रामर‑अनुपालन SQL क्वेरी बनाई, फिर फ़ंक्शन चलाकर बिक्री डेटा प्राप्त किया। अंत में, GPT-5 ने उस डेटा को पिछले महीने की श्रेणी‑वार बिक्री का स्पष्ट, रैंक किया हुआ प्राकृतिक‑भाषा सारांश बना दिया।
=== 1) First Model Call ===
Raw model output objects:
 [ResponseReasoningItem(id='rs_6897acee8afc819f9e7ae0f675bfa4ee0d5175a46255063b', summary=[], type='reasoning', content=None, encrypted_content=None, status=None), ResponseCustomToolCall(call_id='call_vzcHPT7EGvb7QbhF2djVIJZA', input='SELECT category, SUM(sales) AS total_sales FROM orders WHERE order_month = "2025-07" GROUP BY category ORDER BY total_sales DESC', name='sql_query_runner', type='custom_tool_call', id='ctc_6897acf67a34819f84a085191e4ca1fb0d5175a46255063b', status='completed')]

Extracted SQL from tool call:
 SELECT category, SUM(sales) AS total_sales FROM orders WHERE order_month = "2025-07" GROUP BY category ORDER BY total_sales DESC

=== 2) Local Tool Execution ===
category   | total_sales
----------------------------
Electronics | 52423
Clothing    | 59976
Furniture   | 172713
Toys        | 69667
Books       | 14633

=== 3) Second Model Call ===

Final natural-language answer:
 Here are the total sales by category for last month (2025-07):

- Furniture: 172,713
- Toys: 69,667
- Clothing: 59,976
- Electronics: 52,423
- Books: 14,633

Want this as a chart or need a different month?नया allowed_tools पैरामीटर आपको अपने पूरे टूलकिट में से मॉडल के लिए उपयोग योग्य टूल्स का उपसमुच्चय परिभाषित करने देता है। आप मोड को auto (मॉडल चुन सकता है) या required (मॉडल को किसी एक का उपयोग करना ही होगा) पर सेट कर सकते हैं। यह सुरक्षा, पूर्वानुमेयता, और प्रॉम्प्ट कैशिंग में सुधार करता है, क्योंकि मॉडल अनचाहे टूल्स को कॉल नहीं कर सकता, जबकि अनुमत सेट में सर्वश्रेष्ठ विकल्प चुनने की लचीलापन बना रहता है।
पूरा टूलकिट get_weather और send_email—दोनों रखता है, पर हमने केवल get_weather की अनुमति दी है और मोड "required" रखा है, जिससे मॉडल को इसका उपयोग करना अनिवार्य हो।
जब पूछा गया, “What’s the weather in Oslo?”, GPT‑5 ने get_weather को फ़ंक्शन कॉल के रूप में सही आर्ग्युमेंट {"city": "Oslo"} के साथ बुलाया।
from openai import OpenAI

client = OpenAI()

# Full toolset (N)

tools = [
    {
        "type": "function",
        "name": "get_weather",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    },
    {
        "type": "function",
        "name": "send_email",
        "parameters": {
            "type": "object",
            "properties": {"to": {"type": "string"}, "body": {"type": "string"}},
            "required": ["to", "body"],
        },
    },
]

# Allowed subset (M < N), mode=required  → must call get_weather

resp = client.responses.create(
    model="gpt-5",
    input="What's the weather in Oslo?",
    tools=tools,
    tool_choice={
        "type": "allowed_tools",
        "mode": "required",  # use "auto" to let it decide
        "tools": [{"type": "function", "name": "get_weather"}],
    },
)
for item in resp.output:
    if getattr(item, "type", None) in ("function_call", "tool_call", "custom_tool_call"):
        print("Tool name:", getattr(item, "name", None))
        print("Arguments:", getattr(item, "arguments", None))
आउटपुट:
Tool name: get_weather
Arguments: {"city":"Oslo"}Preambles छोटे, उपयोगकर्ता‑दिखाई देने वाले स्पष्टीकरण होते हैं जिन्हें GPT-5 किसी टूल को कॉल करने से पहले जेनरेट कर सकता है, यह बताते हुए कि वह यह कॉल क्यों कर रहा है। यह पारदर्शिता, उपयोगकर्ता विश्वास, और डीबगिंग में आसानी बढ़ाता है, खासकर जटिल वर्कफ़्लो में। बस मॉडल को “टूल कॉल से पहले समझाओ” जैसा निर्देश देकर, आप इंटरैक्शन को और अधिक मानवीय और उद्देश्यपूर्ण महसूस करा सकते हैं—वह भी बिना खास विलंब बढ़ाए।
नीचे दिए गए कोड में, हमने एक get_weather फ़ंक्शन टूल परिभाषित किया और सिस्टम निर्देश जोड़ा कि टूल कॉल करने से पहले “Preamble:” उपसर्ग के साथ छोटा, उपयोगकर्ता‑दिखाई वाक्य आउटपुट करें।
जब पूछा गया, “What’s the weather in Oslo?”, GPT‑5 ने पहले एक प्रीएम्बल दिया जिसमें बताया कि वह लाइव मौसम सेवा देख रहा है, फिर सही आर्ग्युमेंट {"city": "Oslo"} के साथ get_weather tool को कॉल किया। टूल को लोकली चलाकर परिणाम लौटाने के बाद, मॉडल ने अंतिम प्राकृतिक‑भाषा उत्तर दिया।
from openai import OpenAI
client = OpenAI()


def get_weather(city: str):
    return {"city": city, "temperature_c": 12}

# Tool
tools = [{
    "type": "function",
    "name": "get_weather",
    "description": "Get current temperature for a city.",
    "parameters": {
        "type": "object",
        "properties": {"city": {"type": "string"}},
        "required": ["city"],
        "additionalProperties": False
    },
    "strict": True,
}]

# Messages (enable preamble via system instruction)
msgs = [
    {"role": "system", "content": "Before you call a tool, explain why you are calling it in ONE short sentence prefixed with 'Preamble:'."},
    {"role": "user", "content": "What's the weather in Oslo?"}
]

# 1) Model call → expect a visible preamble + a tool call
resp = client.responses.create(model="gpt-5", input=msgs, tools=tools)
print("=== First response objects ===")
for item in resp.output:
    t = getattr(item, "type", None)
    if t == "message":  # preamble is a normal assistant message
        print("PREAMBLE:", getattr(item, "content", None))
    if t in ("function_call","tool_call","custom_tool_call"):
        print("TOOL:", getattr(item, "name", None))
        print("ARGS:", getattr(item, "arguments", None))
tool_call = next(x for x in resp.output if getattr(x, "type", None) in ("function_call","tool_call","custom_tool_call"))
msgs += resp.output  # keep context

# 2) Execute tool locally (fake)
import json
args = json.loads(getattr(tool_call, "arguments", "{}"))
city = args.get("city", "Unknown")
tool_result = get_weather(city)

# 3) Return tool result
msgs.append({"type": "function_call_output", "call_id": tool_call.call_id, "output": json.dumps(tool_result)})

# 4) Final model call → natural answer
final = client.responses.create(model="gpt-5", input=msgs, tools=tools)
print("\n=== Final answer ===")
print(final.output_text)
जैसा हम देख सकते हैं, मॉडल ने पहले अपने इरादे का छोटा प्रीएम्बल दिया, फिर get_weather टूल को {"city": "Oslo"} के साथ सही ढंग से कॉल किया, और अंत में तापमान प्राकृतिक भाषा में लौटाया।
=== First response objects ===
PREAMBLE: [ResponseOutputText(annotations=[], text='Preamble: I'm checking a live weather service to get the current conditions for Oslo.', type='output_text', logprobs=[])]
TOOL: get_weather
ARGS: {"city":"Oslo"}

=== Final answer ===
It's currently about 12°C in Oslo.GPT-5 को अच्छी तरह गढ़े गए प्रॉम्प्ट्स के साथ उत्कृष्ट प्रदर्शन हेतु डिज़ाइन किया गया है, और OpenAI आपको इन्हें सुधारने में मदद के लिए Prompt Optimizer प्रदान करता है। यह टूल आपके प्रॉम्प्ट्स को GPT‑5 की reasoning शैली के अनुरूप स्वचालित रूप से अनुकूलित करता है, जिससे सटीकता और दक्षता में सुधार होता है।
यहाँ जाएँ Edit prompt - OpenAI API और एक सरल प्रॉम्प्ट लिखें, जैसे "Create a Netflix clone web application." यह आपके प्रॉम्प्ट को विस्तृत संरचना में तोड़ देगा, जो GPT‑5 मॉडल के लिए अनुकूलित होगी।
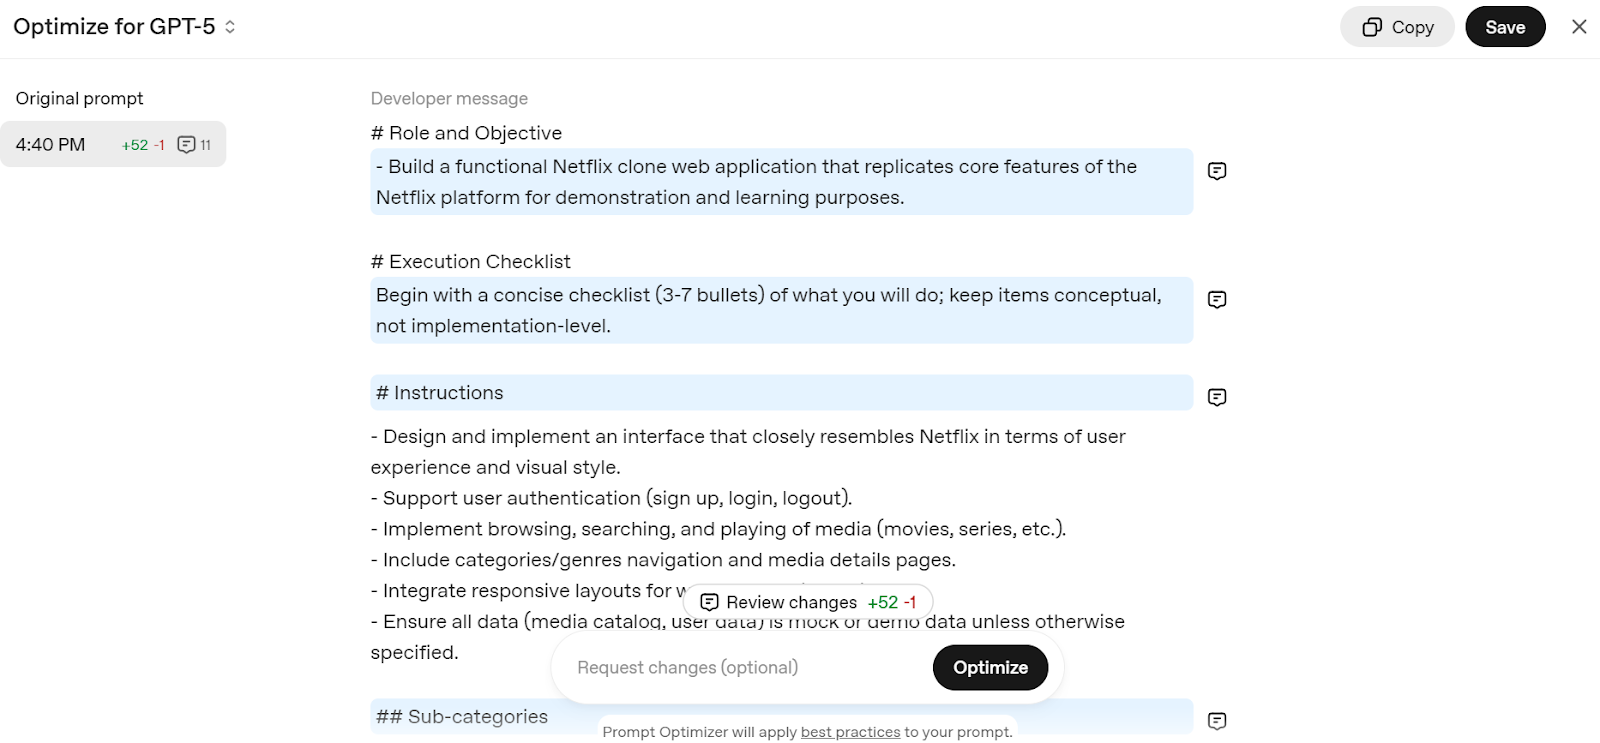
स्रोत: Prompt Optimizer
बस प्रॉम्प्ट कॉपी करें और ChatGPT चैट में जोड़ें, और अपना खुद का Netflix वेब सर्विस बनाना शुरू करें।
OpenAI डेवलपर्स को पुरानी मॉडलों से नए GPT‑5 परिवार में माइग्रेट करने की सख़्त सिफारिश करता है ताकि लागत घटे, सटीकता बढ़े, और उत्तरों की गुणवत्ता बेहतर हो।
माइग्रेशन सरल है; बस नीचे दी गई तालिका का पालन करें और अपने उपयोग‑मामले के लिए सही GPT‑5 मॉडल और reasoning स्तर चुनें।
|
वर्तमान मॉडल |
अनुशंसित GPT-5 मॉडल |
आरंभिक Reasoning स्तर |
माइग्रेशन नोट्स |
|
o3 |
GPT-5 |
Medium |
मीडियम reasoning + प्रॉम्प्ट ट्यूनिंग से शुरुआत करें; आवश्यकता होने पर high पर बढ़ाएँ। |
|
gpt-4.1 |
GPT-5 |
Minimal |
मिनिमल reasoning + प्रॉम्प्ट ट्यूनिंग से शुरुआत करें; बेहतर प्रदर्शन के लिए low पर बढ़ाएँ। |
|
o4-mini |
GPT-5-mini |
Medium |
GPT-5-mini को प्रॉम्प्ट ट्यूनिंग के साथ उपयोग करें। |
|
gpt-4.1-mini |
GPT-5-mini |
Minimal |
GPT-5-mini को प्रॉम्प्ट ट्यूनिंग के साथ उपयोग करें। |
|
gpt-4.1-nano |
GPT-5-nano |
Minimal |
GPT-5-nano को प्रॉम्प्ट ट्यूनिंग के साथ उपयोग करें। |
GPT-5 सिर्फ एक ज्यादा स्मार्ट मॉडल नहीं है; यह इंटेलिजेंट, विश्वसनीय, और कुशल AI सिस्टम बनाने के लिए डेवलपर टूलकिट है। reasoning, verbosity, टूल उपयोग, और आउटपुट फ़ॉर्मैट्स पर सूक्ष्म नियंत्रण के साथ, यह त्वरित कोडिंग कार्यों से लेकर जटिल बहु‑चरणीय वर्कफ़्लो तक हर चीज़ के लिए अनुकूलित है।
इसके नए फीचर्स और श्रेष्ठ प्रथाओं का लाभ उठाकर, आप OpenAI SDK का उपयोग करके न्यूनतम प्रयास में प्रोडक्शन‑रेडी AI एप्लिकेशन विकसित कर सकते हैं।
यदि आप OpenAI के साथ काम करने में नए हैं, तो नीचे दिए गए संसाधन अवश्य देखें:
Top OpenAI Courses
कोर्स
कोर्स
कोर्स