Ga naar hoofdinhoud

5 tips om idiomatische Pandas-code te schrijven

Deze tutorial behandelt 5 manieren waarop je gemakkelijk pandorable of meer idiomatische Pandas-code kunt schrijven.
Bijgewerkt 2 okt 2026  · 14 min lezen

Verken met AI

ChatGPTClaudePerplexity

Pandas is de de facto gereedschapskist voor Python-datascientists om data-analyse makkelijker te maken: je kunt het bijvoorbeeld gebruiken om, voordat je begint met analyseren, de data te verzamelen, verkennen en op te maken. Pandas maakt deze stappen een fluitje van een cent via tal van I/O- en handige datamanipulatiefuncties. Bovendien, zoals je later in deze tutorial zult leren, heeft het ook enkele visualisatiemogelijkheden (via matplotlib).

Hoewel de Pandas-datastructuren erg krachtig en flexibel zijn, brengen ze ook de nodige complexiteit met zich mee. Daardoor kan je analyse soms juist lastiger worden in plaats van makkelijker, zeker als je net begint. In deze tutorial focus je op hoe je jezelf hoofdpijn bespaart en meer idiomatische Pandas-code schrijft. Naast leren hoe je data laadt, verkent en opschoont, ga je dieper in op de volgende vijf onderwerpen:

Natuurlijk is deze tutorial zeker niet uitputtend; Het Pandas-pakket is erg rijk en er zijn ongetwijfeld nog andere manieren waarop je je Pandas-code idiomatischer kunt maken.

Laten we niet langer wachten en aan de slag gaan!

Eerste stap: laad en verken de data

Zoals altijd begint je data-analyse met het laden en verkennen van je data. Deze sectie is een korte warming-up waarin je de functie read_csv() gebruikt om wereldwijde universiteitsrankings te laden. Daarna kun je je data al snel verkennen met de functies head() en describe(). Ben je geïnteresseerd in een volledige introductie tot Pandas, overweeg dan DataCamp’s driedelige Pandas-cursus, beginnend met Pandas Foundations.

Als je dit allemaal al weet, kun je deze sectie overslaan en meteen zien hoe je indexeren met Pandas idiomatischer aanpakt.

Packages importeren

Om te beginnen importeer je de gebruikelijke Python-packages voor data science. Zoals je misschien al had geraden, zit Pandas daar zeker bij.

# If you're working with a notebook, don't forget to use Matplotlib magic! 
%matplotlib inline

# Import pandas under the alias pd import pandas as pd # Import seaborn under the alias sns import seaborn as sns # Set the Seaborn theme if desired sns.set_style('darkgrid')

Daarnaast kun je ook het pakket watermark gebruiken: dit is een handig hulpmiddel dat je notebook beter reproduceerbaar maakt. Reproduceerbaar werken is erg belangrijk als je met collega’s samenwerkt. Je toekomstige zelf zal je daar ook dankbaar voor zijn! Meer over reproduceerbare data science lees je hier.

De data

Om met deze tutorial te starten, heb je ook wat “echte” data nodig. Voor deze tutorial werk je met een dataset van Kaggle. Als je Kaggle niet kent: het is een van de grootste communities voor data science en machine learning. Bovendien is het een goede plek om meer te leren over data science zodra je de basis beheerst.

De dataset die je gebruikt is de World University Rankings.

Zoals hierboven vermeld, heeft Pandas veel handige methodes om data uit verschillende bronnen te lezen (je leert er hier meer over). Omdat de data in CSV-formaat staat, gebruiken we de methode .read_csv. Maar voordat je begint, moet je de data downloaden van Kaggle (of uit de code-repository halen onder de map data als je geen account wilt aanmaken).

Als je de data hebt binnengehaald, zou je een map data moeten hebben die de verschillende csv-bestanden bevat.

Vervolgens werk je met de Times Higher Education World University Rankings (kortweg Times) en de Academic Ranking of World Universities (kortweg Shanghai). Er is ook een derde rankingsysteem in de map data, CWUR, maar dat is veel minder bekend, dus dat kun je nu gerust negeren.

# Import Times Higher Education World University Rankings data
times_df = pd.read_csv('data/timesData.csv', thousands=",")

# Import Academic Ranking of World Universities data
shanghai_df = pd.read_csv('data/shanghaiData.csv')

De data snel inspecteren

Zoals je hebt geleerd in DataCamp’s Exploratory Data Analysis-tutorial, biedt Pandas enkele methodes om DataFrames snel te inspecteren, namelijk .head() om de eerste n rijen te bekijken (n is standaard 5) en .describe() voor een snelle statistische samenvatting.

Haal je kennis van deze functies op door de volgende codelijnen uit te voeren. De data is al voor je ingeladen in de variabelen times_df en shanghai_df:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBSZXR1cm4gdGhlIGZpcnN0IHJvd3Mgb2YgYHRpbWVzX2RmYFxudGltZXNfZGYuX19fXygpXG5cbiMgRGVzY3JpYmUgYHRpbWVzX2RmYFxudGltZXNfZGYuZGVzY3JpYmUoKVxuXG4jIFJldHVybiB0aGUgZmlyc3Qgcm93cyBvZiBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5oZWFkKClcblxuIyBEZXNjcmliZSBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5fX19fX19fXygpIiwic29sdXRpb24iOiIjIFJldHVybiB0aGUgZmlyc3Qgcm93cyBvZiBgdGltZXNfZGZgXG50aW1lc19kZi5oZWFkKClcblxuIyBEZXNjcmliZSBgdGltZXNfZGZgXG50aW1lc19kZi5kZXNjcmliZSgpXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCByb3dzIG9mIGBzaGFuZ2hhaV9kZmBcbnNoYW5naGFpX2RmLmhlYWQoKVxuXG4jIERlc2NyaWJlIGBzaGFuZ2hhaV9kZmBcbnNoYW5naGFpX2RmLmRlc2NyaWJlKCkiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJ0aW1lc19kZi5oZWFkXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJ0aW1lc19kZi5kZXNjcmliZVwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwic2hhbmdoYWlfZGYuaGVhZFwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwic2hhbmdoYWlfZGYuZGVzY3JpYmVcIilcbnN1Y2Nlc3NfbXNnKFwiWW91J3JlIG9mZiB0byBhIGdyZWF0IHN0YXJ0IVwiKSJ9

Nu je de data hebt geladen, kun je gaan nadenken over hoe je de data met Pandas idiomatischer kunt manipuleren!

Onze tips voor idiomatische Pandas-code

1. Indexeren

Meer idiomatische Pandas-code schrijven betekent om te beginnen dat je de kracht van indexeren benut. Indexeren betekent dat je subsets uit je DataFrame selecteert.

Als je net begint met Pandas, heb je misschien even tijd nodig om te wennen aan hoe indexen werken. Als je al met (Python-)lijsten hebt gewerkt, ben je waarschijnlijk bekend met het gebruik van blokhaken [] in combinatie met een dubbelepunt : om elementen te selecteren. Deze methode werkt ook op DataFrames.

Bovendien zijn er nog twee andere, meer idiomatische manieren om een subset van een DataFrame te selecteren: iloc en loc:

  • loc is label-gebaseerd. Dit betekent dat als je loc[2] schrijft, je zoekt naar de waarden in je DataFrame met een index die gelabeld is als 2.
  • iloc is positie-gebaseerd. Dit betekent dat als je iloc[2] schrijft, je zoekt naar de waarden die op positie 2 staan.

Probeer dit uit in het DataCamp Light-blok hieronder door times_df.loc[2] en times_df.iloc[2] in de IPython-console te typen om het verschil te zien. Los daarna de oefening hieronder op met behulp van loc, iloc en de traditionele blokhaken!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBSZXRyaWV2ZSB0aGUgdG90YWwgc2NvcmUgb2YgdGhlIGZpcnN0IHJvd1xucHJpbnQodGltZXNfZGYubG9jWzAsICdfX19fX19fX19fXyddKVxuXG4jIFJldHJpZXZlIHJvd3MgMCBhbmQgMVxucHJpbnQodGltZXNfZGYubG9jWzA6XV0pXG5cbiMgUmV0cmlldmUgdGhlIHZhbHVlcyBhdCBjb2x1bW5zIGFuZCByb3dzIDEtM1xucHJpbnQodGltZXNfZGYuaWxvY1sxOjQsMTo0XSlcblxuIyBSZXRyaWV2ZSB0aGUgY29sdW1uIGB0b3RhbF9zY29yZWAgXG5wcmludCh0aW1lc19kZlsnX19fX19fX19fXyddKSIsInNvbHV0aW9uIjoiIyBSZXRyaWV2ZSB0aGUgdG90YWwgc2NvcmUgb2YgdGhlIGZpcnN0IHJvd1xucHJpbnQodGltZXNfZGYubG9jWzAsICd0b3RhbF9zY29yZSddKVxuXG4jIFJldHJpZXZlIHJvd3MgMCBhbmQgMVxucHJpbnQodGltZXNfZGYbMDozXSlcblxuIyBSZXRyaWV2ZSB0aGUgdmFsdWVzIGF0IGNvbHVtbnMgYW5kIHJvd3MgMS0zXG5wcmludCh0aW1lc19kZi5pbG9jWzE6NCwxOjRdKVxuXG4jIFJldHJpZXZlIHRoZSBjb2x1bW4gYHRvdGFsX3Njb3JlYCBcbnByaW50KHRpbWVzX2RmWyd0b3RhbF9zY29yZSddKSIsInNjdCI6IkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTEpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MylcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTQpXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUhIFlvdSBoYXZlIHN1Y2Nlc3NmdWxseSBzdWJzZXR0ZWQgeW91ciBkYXRhIHdpdGggYGxvY2AgYW5kIGBpbG9jYC5cIikifQ==

Natuurlijk kan je verkenning veel verder gaan dan alleen rijen en kolommen subsetten of selecteren. Het wordt pas echt interessant wanneer je loc en iloc bijvoorbeeld combineert met booleaanse arrays.

Je ziet dat dit wat verder gaat dan selecteren op basis van kolommen of indexeren; Het lijkt meer op het bevragen van je data!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3ZcIikiLCJzYW1wbGUiOiIjIEFyZSB0aGUgbGFzdCBlbnRyaWVzIGFmdGVyIDIwMDY/XG5wcmludChzaGFuZ2hhaV9kZi5sb2NbOi0xMCwgJ3llYXInXSA+IDIwMDYpXG5cbiMgV2FzIHRoZSBhbHVtbmkgY291bnQgaGlnaGVyIHRoYW4gOTAgZm9yIHRoZSBmaXJzdCAgdGVuIHVuaXZlcnNpdGllcz9cbnByaW50KHNoYW5naGFpX2RmLmxvY1swOjExLCAnYWx1bW5pJ10gPiA5MCkiLCJzb2x1dGlvbiI6IiMgQXJlIHRoZSBsYXN0IGVudHJpZXMgYWZ0ZXIgMjAwNj9cbnByaW50KHNoYW5naGFpX2RmLmxvY1s6LTEwLCAneWVhciddID4gMjAwNilcblxuIyBXYXMgdGhlIGFsdW1uaSBjb3VudCBoaWdoZXIgdGhhbiA5MCBmb3IgdGhlIGZpcnN0ICB0ZW4gdW5pdmVyc2l0aWVzP1xucHJpbnQoc2hhbmdoYWlfZGYubG9jWzA6MTEsICdhbHVtbmknXSA+IDkwKSIsInNjdCI6IkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTEpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgcXVlcmllZCB5b3VyIGRhdGEgd2l0aCBgbG9jYCFcIikifQ==

loc en iloc zijn geweldig om je data te indexeren, maar wees voorzichtig als je twee sets blokhaken achter elkaar gebruikt! Pandas kan dan een kopie van een view teruggeven en in zulke gevallen weet je niet meer precies waarmee je werkt! Denk dus twee keer na als je twee sets blokhaken combineert met loc of iloc.

Let op dat Pandas om je data te bevragen ook de functie query() biedt, waarmee je je data snel kunt inspecteren (beschikbaar sinds versie 0.13). Je kunt bijvoorbeeld een query samenstellen om te zien welke universiteiten een total_score net onder de 50 hebben:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmdlX3NjaG9vbHMgPSBzaGFuZ2hhaV9kZi5xdWVyeSgndG90YWxfc2NvcmUgPiBfXyBhbmQgdG90YWxfc2NvcmUgPCBfXycpXG5cbiMgUHJpbnQgdGhlIHJlc3VsdFxucHJpbnQoYXZlcmFnZV9zY2hvb2xzKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmFnZV9zY2hvb2xzID0gc2hhbmdoYWlfZGYucXVlcnkoJ3RvdGFsX3Njb3JlID4gNDAgYW5kIHRvdGFsX3Njb3JlIDwgNTAnKVxuXG4jIFByaW50IHRoZSByZXN1bHRcbnByaW50KGF2ZXJhZ2Vfc2Nob29scykiLCJzY3QiOiJFeCgpLnRlc3Rfb2JqZWN0KFwiYXZlcmFnZV9zY2hvb2xzXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Natuurlijk zijn er nog veel meer mogelijkheden om je data te bevragen! Waarom bedenk je niet een paar queries en test je die in de IPython-console van het bovenstaande DataCamp Light-blok?

Heb je even geen inspiratie, probeer dan queries die de universiteiten met een eerste nationale rang en universiteiten met een eerste wereldrang teruggeven. Daarnaast kun je de alumnicijfers van de universiteiten opvragen.

Weet je niet goed hoe je de queries moet samenstellen? Bekijk dan enkele voorbeelden hieronder:

shanghai_df.query("national_rank == 1 and world_rank == 1")
shanghai_df.query("alumni < 20")

2. Method chaining

Method chaining is iets typisch voor Pandas, maar als je net begint met dit Python-pakket voor datamanipulatie, is het misschien niet meteen duidelijk hoe dit precies werkt. In de kern roep je methodes na elkaar aan op een object.

In deze sectie ga je dieper in op method chaining door datapijplijnen te maken met pipe().

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6IiMgRXh0cmFjdCBpbmZvXG5kZWYgZXh0cmFjdF9pbmZvKGlucHV0X2RmLCBuYW1lKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGluZm9fZGYgPSBwZC5EYXRhRnJhbWUoeyduYl9yb3dzJzogZGYuc2hhcGVbMF0sICduYl9jb2xzJzogZGYuc2hhcGVbMV0sICduYW1lJzogbmFtZX0sIGluZGV4PXJhbmdlKDEpKVxuICAgIHJldHVybiBpbmZvX2RmXG5cbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNvbHV0aW9uIjoiIyBFeHRyYWN0IGluZm9cbmRlZiBleHRyYWN0X2luZm8oaW5wdXRfZGYsIG5hbWUpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgaW5mb19kZiA9IHBkLkRhdGFGcmFtZSh7J25iX3Jvd3MnOiBkZi5zaGFwZVswXSwgJ25iX2NvbHMnOiBkZi5zaGFwZVsxXSwgJ25hbWUnOiBuYW1lfSwgaW5kZXg9cmFuZ2UoMSkpXG4gICAgcmV0dXJuIGluZm9fZGZcbiBcbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNjdCI6ImZ1bl9kZWYgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImV4dHJhY3RfaW5mb1wiKS5tdWx0aShjaGVja19hcmdzKCdpbnB1dF9kZicpLCBjaGVja19hcmdzKCduYW1lJykpXG5mdW5fZGVmLmNoZWNrX2JvZHkoKVxuZnVuX2RlZi5jYWxsKFwiZih0aW1lc19kZiwgJ3RpbWVzJylcIilcbmZ1bl9kZWYuY2FsbChcImYoc2hhbmdoYWlfZGYsICdzaGFuZ2hhaScpXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwiYWxsX2luZm9cIilcbnVjY2Vzc19tc2coXCJBd2Vzb21lIGpvYiFcIikifQ==

Zoals je al gemerkt hebt, verschillen de datasets behoorlijk. Enkele verschillen:

  • De Times-dataset heeft 14 kolommen, terwijl die van Shanghai er 11 heeft
  • De Times-dataset heeft 2603 rijen, terwijl die van Shanghai er 4897 heeft
  • Een belangrijke ontbrekende kolom in de Shanghai-dataset is het land van de universiteit. Deze informatie kun je later indien nodig uit de Times-dataset halen.

Om beide DataFrames te kunnen gebruiken, moeten we dus alleen de gemeenschappelijke kolommen selecteren. Hopelijk hebben deze kolommen vergelijkbare inhoud.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6ImNvbW1vbl9jb2x1bW5zID0gc2V0KHNoYW5naGFpX2RmLmNvbHVtbnMpICYgc2V0KHRpbWVzX2RmLmNvbHVtbnMpXG5cbiMgUmV0dXJuIGBjb21tb25fY29sdW1uc2BcbnByaW50KGNvbW1vbl9jb2x1bW5zKSIsInNvbHV0aW9uIjoiY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcblxuIyBSZXR1cm4gYGNvbW1vbl9jb2x1bW5zYFxucHJpbnQoY29tbW9uX2NvbHVtbnMpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcImNvbW1vbl9jb2x1bW5zXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKSJ9

De gemeenschappelijke kolommen zijn dus:

  • total_score: score die gebruikt wordt om de rang te bepalen. Zoals vermeld op de Kaggle-beschrijvingspagina, bevat dit bereik-rangen (dus tussen twee waarden) en gelijke rangen (er staat een =-teken voor)
  • university_name: naam van de universiteit
  • world_rank: rang van de universiteit
  • year: jaar waarop de ranking betrekking heeft

Om beide datasets te concateneren, moeten we eerst wat opschonen. Pas nu de volledige pipeline toe om de data op te schonen:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucykiLCJzYW1wbGUiOiIjIENsZWFuIHVwIHRoZSBgd29ybGRfcmFua2AgXG5kZWYgY2xlYW5fd29ybGRfcmFuayhpbnB1dF9kZik6XG4gICAgZGYgPSBpbnB1dF9kZi5jb3B5KClcbiAgICBkZi53b3JsZF9yYW5rID0gZGYud29ybGRfcmFuay5zdHIuc3BsaXQoJy0nKS5zdHJbMF0uc3RyLnNwbGl0KCc9Jykuc3RyWzBdXG4gICAgcmV0dXJuIGRmXG4gICAgXG4jIEFzc2lnbiB0aGUgY29tbW9uIHllYXJzIG9mIGBzaGFuZ2hhaV9kZmAgYW5kIGB0aW1lc19kZmAgdG8gYGNvbW1vbl95ZWFyc2AgICAgXG5jb21tb25feWVhcnMgPSBzZXQoc2hhbmdoYWlfZGYueWVhcikgJiBzZXQodGltZXNfZGYueWVhcikgXG5cbiMgUHJpbnQgYGNvbW1vbl95ZWFyc2BcbnByaW50KGNvbW1vbl95ZWFycylcblxuIyBGaWx0ZXIgeWVhcnNcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuXG4jIENsZWFuIGB0aW1lc19kZmAgYW5kIGBzaGFuZ2hhaV9kZmBcbmNsZWFuZWRfdGltZXNfZGYgPSAodGltZXNfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3RpbWVzJykpXG5jbGVhbmVkX3NoYW5naGFpX2RmID0gKHNoYW5naGFpX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmspXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLmFzc2lnbihuYW1lPSdzaGFuZ2hhaScpKSIsInNvbHV0aW9uIjoiIyBDbGVhbiB1cCB0aGUgYHdvcmxkX3JhbmtgIFxuZGVmIGNsZWFuX3dvcmxkX3JhbmsoaW5wdXRfZGYpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgZGYud29ybGRfcmFuayA9IGRmLndvcmxkX3Jhbmsuc3RyLnNwbGl0KCctJykuc3RyWzBdLnN0ci5zcGxpdCgnPScpLnN0clswXVxuICAgIHJldHVybiBkZlxuICAgIFxuIyBBc3NpZ24gdGhlIGNvbW1vbiB5ZWFycyBvZiBgc2hhbmdoYWlfZGZgIGFuZCBgdGltZXNfZGZgIHRvIGBjb21tb25feWVhcnNgICAgIFxuY29tbW9uX3llYXJzID0gc2V0KHNoYW5naGFpX2RmLnllYXIpICYgc2V0KHRpbWVzX2RmLnllYXIpIFxuXG4jIFByaW50IGBjb21tb25feWVhcnNgXG5wcmludChjb21tb25feWVhcnMpXG5cbiMgRmlsdGVyIHllYXJzXG5kZWYgZmlsdGVyX3llYXIoaW5wdXRfZGYsIHllYXJzKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIHJldHVybiBkZi5xdWVyeSgneWVhciBpbiB7fScuZm9ybWF0KGxpc3QoeWVhcnMpKSlcblxuIyBDbGVhbiBgdGltZXNfZGZgIGFuZCBgc2hhbmdoYWlfZGZgXG5jbGVhbmVkX3RpbWVzX2RmID0gKHRpbWVzX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmspXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLmFzc2lnbihuYW1lPSd0aW1lcycpKVxuY2xlYW5lZF9zaGFuZ2hhaV9kZiA9IChzaGFuZ2hhaV9kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0nc2hhbmdoYWknKSkiLCJzY3QiOiJmdW5fZGVmMSA9IEV4KCkuY2hlY2tfZnVuY3Rpb25fZGVmKFwiZmlsdGVyX3llYXJcIikubXVsdGkoY2hlY2tfYXJncygnaW5wdXRfZGYnKSwgY2hlY2tfYXJncygneWVhcnMnKSlcbmZ1bl9kZWYxLmNoZWNrX2JvZHkoKVxuZnVuX2RlZjEuY2FsbChcImYodGltZXNfZGYsIGNvbW1vbl95ZWFycylcIilcbmZ1bl9kZWYxLmNhbGwoXCJmKHNoYW5naGFpX2RmLCBjb21tb25feWVhcnMpXCIpXG5cbkV4KCkudGVzdF9vYmplY3QoXCJjb21tb25feWVhcnNcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIpXG5cbmZ1bl9kZWYgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImNsZWFuX3dvcmxkX3JhbmtcIilcbmZ1bl9kZWYuY2hlY2tfYm9keSgpXG5mdW5fZGVmLmNhbGwoXCJmKHRpbWVzX2RmKVwiKVxuZnVuX2RlZi5jYWxsKFwiZihzaGFuZ2hhaV9kZilcIilcblxuRXgoKS50ZXN0X29iamVjdChcImNsZWFuZWRfdGltZXNfZGZcIilcbkV4KCkudGVzdF9vYmplY3QoXCJjbGVhbmVkX3NoYW5naGFpX2RmXCIpXG5cbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Zoals je waarschijnlijk hebt gemerkt, gebruik ik de methode .pipe vaak in deze tutorial. Als je uit de R-wereld komt, ben je er waarschijnlijk (enigszins) mee vertrouwd.

Het is een handige nieuwe Pandas-methode (sinds versie 0.16.2) die je in staat stelt bewerkingen te chainen en zo de noodzaak voor tussentijdse DataFrames wegneemt. Je code wordt leesbaarder.

Feitelijk zou je zonder deze operator, in plaats van df.pipe(f).pipe(g).pipe(h) te schrijven: h(g(f(df))) schrijven. Dit wordt lastiger te volgen naarmate het aantal geneste functies toeneemt.

Wil je hier meer over leren, lees dan zeker deze blogpost.

Nu beide DataFrames opgeschoond zijn, kunnen we ze concurreren tot één DataFrame. Vergeet ook niet de ontbrekende data op te schonen:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpIiwic2FtcGxlIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNvbHV0aW9uIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNjdCI6IkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwibWlzc2luZ19kYXRhXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwicmFua2luZ19kZlwiKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgaW1wcm92ZWQgeW91ciBkYXRhIHF1YWxpdHkhXCIpIn0=

Aangezien je ongeveer 38% ontbrekende data hebt in de kolom total_score, kun je die kolom beter droppen met de methode .drop.

3. Geheugenoptimalisatie

Een derde manier om je Pandas-code meer “idiomatisch” te maken —wat hier neerkomt op “performant”— is door het geheugengebruik te optimaliseren. Zeker wanneer je datapijplijnen maakt met method chaining, zul je merken dat geheugen een grote rol kan spelen in hoe snel je pipelines draaien. Hier zie je daar meer over.

Dit is waarschijnlijk overkill voor deze kleine dataset, maar het is vaak een goede gewoonte om sommige kolommen naar specifieke types te casten om het geheugengebruik te optimaliseren. Laten we eerst uitzoeken hoeveel geheugen is toegewezen voor ranking_df met behulp van de methode .info.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBQcmludCB0aGUgbWVtb3J5IHVzYWdlIG9mIGByYW5raW5nX2RmYCBcbnJhbmtpbmdfZGYuX19fXygpXG5cbiMgUHJpbnQgdGhlIGRlZXAgbWVtb3J5IHVzYWdlIG9mIGByYW5raW5nX2RmYCBcbnJhbmtpbmdfZGYuaW5mbyhtZW1vcnlfdXNhZ2U9XCJkZWVwXCIpIiwic29sdXRpb24iOiIjIFByaW50IHRoZSBtZW1vcnkgdXNhZ2Ugb2YgYHJhbmtpbmdfZGZgIFxucmFua2luZ19kZi5pbmZvKClcblxuIyBQcmludCB0aGUgZGVlcCBtZW1vcnkgdXNhZ2Ugb2YgYHJhbmtpbmdfZGZgIFxucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT1cImRlZXBcIikiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJyYW5raW5nX2RmLmluZm9cIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJHcmVhdCFcIikifQ==

Het resultaat van de eerste regel code vertelt ons dat de data 144 KB inneemt. Maar als je de argumenten van de methode .info bekijkt, zie je dat er een optioneel argument is, namelijk memory_usage, dat standaard op None staat. Wat gebeurt er als je memory_usage op deep zet?

De nieuwe geheugenvoetafdruk is 6 keer —5,6 om precies te zijn— groter dan je eerste antwoord.

Wat is hier gebeurd?

Het verschil in geheugenschatting komt doordat Pandas zonder de “deep”-vlag het geheugengebruik voor het dtype object niet inschat. Dit (Python-)type data neemt meer ruimte in dan andere geoptimaliseerde numpy-dtypes. Daarom is het aan te bevelen om object-types te casten naar passender types (bijvoorbeeld category bij categorische data).

Dat gaan we doen!

def memory_change(input_df, column, dtype):
    df = input_df.copy()
    old = round(df[column].memory_usage(deep=True) / 1024, 2) # In KB
    new = round(df[column].astype(dtype).memory_usage(deep=True) / 1024, 2)# In KB
    change = round(100 * (old - new) / (old), 2)
    report = ("The inital memory footprint for {column} is: {old}KB.\n" 
              "The casted {column} now takes: {new}KB.\n"
              "A change of {change} %.").format(**locals())
    return report

print(memory_change(ranking_df,'world_rank', 'int16'))
print(memory_change(ranking_df,'university_name', 'category'))
print(memory_change(ranking_df,'name', 'category'))

Nu je weet dat je door bijvoorbeeld world_rank te veranderen naar int16 je geheugen efficiënter gebruikt, is het tijd om deze wijzigingen ook echt toe te passen. Je kunt hiervoor de functie astype() gebruiken. Eindig met een dubbele check van je huidige geheugengebruik:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbi ICAgcmV0dXJuIGRmXG5jb21tb25feWVhcnMgPSBzZXQoc2hhbmdoYWlfZGYueWVhcikgJiBzZXQodGltZXNfZGYueWVhcikgXG5kZWYgZmlsdGVyX3llYXIoaW5wdXRfZGYsIHllYXJzKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIHJldHVybiBkZi5xdWVyeSgneWVhciBpbiB7fScuZm9ybWF0KGxpc3QoeWVhcnMpKSlcblxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBDYXN0IGB3b3JsZF9yYW5rYCBhcyB0eXBlIGBpbnQxNmBcbnJhbmtpbmdfZGYud29ybGRfcmFuayA9IHJhbmtpbmdfZGYud29ybGRfcmFuay5hc3R5cGUoJ2ludDE2JylcblxuIyBDYXN0IGB1bnZlcnNpdHlfbmFtZWAgYXMgdHlwZSBgY2F0ZWdvcnlgXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIENhc3QgYG5hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIERvdWJsZSBjaGVjayB0aGUgbWVtb3J5IHVzYWdlIGFmdGVyIHR5cGUgY2FzdGluZ1xucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT0nZGVlcCcpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcInJhbmtpbmdfZGZcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Dat is al een stuk beter. Je kunt nog verder optimaliseren door de kolom year te casten naar int32.

4. GroupBy

Nu we een goed gevormde dataset hebben (dus in een tidy-staat) met een geoptimaliseerde geheugenvoetafdruk, kan de data-analyse beginnen.

Er zijn nu enkele vragen die je misschien wilt beantwoorden:

  • Wat zijn de top 5 universiteiten volgens elk rankingsysteem door de jaren heen?
  • Hoe verschillen deze rankings per jaar?

Laten we de eerste vraag aanpakken met behulp van de meer idiomatische Pandas-tips die je in de vorige secties hebt gezien!

Voordat je begint: ‘Massachusetts Institute of Technology (MIT)’ en ‘Massachusetts Institute of Technology’ zijn twee verschillende records van dezelfde universiteit. Pas daarom de eerste naam aan naar de tweede.

Merk op dat in dit soort gevallen de functie loc, die je eerder in deze tutorial hebt gezien, bijzonder handig is!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgUXVlcnkgZm9yIHRoZSByb3dzIHdpdGggdW5pdmVyc2l0eSBuYW1lICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1xucHJpbnQocmFua2luZ19kZi5fX19fXyhcInVuaXZlcnNpdHlfbmFtZSA9PSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSAoTUlUKSdcIikpXG5cbiMgTG9jYWxpemUgdGhlIHJvd3Mgd2l0aGUgTUlUIHVuaXZlcnNpdHkgbmFtZSBhbmQgcmVwbGFjZSB2YWx1ZSBcbnJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogZGYudW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJywgJ3VuaXZlcnNpdHlfbmFtZSddID0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3knXG5cbiMgUHJpbnQgYHJhbmtpbmdfZGZgXG5wcmludChfX19fX19fX19fKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBmb3IgdGhlIHJvd3Mgd2l0aCB1bml2ZXJzaXR5IG5hbWUgJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknXG5wcmludChyYW5raW5nX2RmLnF1ZXJ5KFwidW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1wiKSlcblxuIyBMb2NhbGl6ZSB0aGUgcm93cyB3aXRoIHRoZSBNSVQgdW5pdmVyc2l0eSBuYW1lIGFuZCByZXBsYWNlIHZhbHVlIFxucmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi51bml2ZXJzaXR5X25hbWUgPT0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknLCAndW5pdmVyc2l0eV9uYW1lJ10gPSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSdcblxuIyBQcmludCBgcmFua2luZ19kZmBcbnByaW50KHJhbmtpbmdfZGYpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Om de 5 (algemener n) topuniversiteiten over de jaren te vinden, voor elk rankingsysteem, kun je dit in pseudo-code doen:

  • Voor elk jaar (in de kolom year) en voor elk rankingsysteem (in de kolom name):
  • Selecteer de subset van de data voor dit jaar en dit rankingsysteem
  • Selecteer de top 5 universiteiten en sla ze op in een lijst
  • Sla het resultaat op in een dictionary met (year, name) als key en de lijst met universiteiten (in aflopende volgorde) als value

Laten we dit toepassen.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgTG9hZCBpbiBgaXRlcnRvb2xzYFxuaW1wb3J0IGl0ZXJ0b29sc1xuXG4jIEluaXRpYWxpemUgYHJhbmtpbmdgXG5yYW5raW5nID0ge31cblxuZm9yIHllYXIsIG5hbWUgaW4gaXRlcnRvb2xzLnByb2R1Y3QoY29tbW9uX3llYXJzLCBbXCJ0aW1lc1wiLCBcInNoYW5naGFpXCJdKTpcbiAgICBzID0gKHJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogKChkZi55ZWFyID09IHllYXIpICYgKGRmLm5hbWUgPT0gbmFtZSlcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICYgKGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLDYpKSkpLCA6XVxuICAgICAgICAgICAgICAgICAgIC5zb3J0X3ZhbHVlcygnd29ybGRfcmFuaycsIGFzY2VuZGluZz1GYWxzZSlcbiAgICAgICAgICAgICAgICAgICAudW5pdmVyc2l0eV9uYW1lKVxuICAgIHJhbmtpbmdbKHllYXIsIG5hbWUpXSA9IGxpc3QocylcbiAgICBcblxuIyBQcmludCBgcmFua2luZ2BcbnByaW50KHJhbmtpbmcpIn0=

Nu we deze ranking-dictionary hebben, gaan we uitzoeken hoeveel (in procent) beide rankingmethodes door de jaren heen verschillen: de twee zijn 100% set-gelijk als de geselecteerde top 5 universiteiten hetzelfde zijn, ook al zijn ze niet in dezelfde volgorde gerankt.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IGl0ZXJ0b29sc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZyA9IHt9XG5mb3IgeWVhciwgbmFtZSBpbiBpdGVydG9vbHMucHJvZHVjdChjb21tb25feWVhcnMsIFtcInRpbWVzXCIsIFwic2hhbmdoYWlcIl0pOlxuICAgIHMgPSAocmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiAoKGRmLnllYXIgPT0geWVhcikgJiAoZGYubmFtZSA9PSBuYW1lKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgJiAoZGYud29ybGRfcmFuay5pc2luKHJhbmdlKDEsNikpKSksIDpdXG4gICAgICAgICAgICAgICAgICAgLnNvcnRfdmFsdWVzKCd3b3JsZF9yYW5rJywgYXNjZW5kaW5nPUZhbHNlKVxuICAgICAgICAgICAgICAgICAgIC51bml2ZXJzaXR5X25hbWUpXG4gICAgcmFua2luZ1soeWVhciwgbmFtZSldID0gbGlzdChzKSIsInNhbXBsZSI6IiMgSW1wb3J0IGBkZWZhdWx0ZGljdGBcbmZyb20gY29sbGVjdGlvbnMgaW1wb3J0IGRlZmF1bHRkaWN0XG5cbiMgSW5pdGlhbGl6ZSBgY29tcGFyZWBcbmNvbXBhcmUgPSBkZWZhdWx0ZGljdChsaXN0KVxuXG4jIEluaXRpYWxpemUgYGV4YWN0X3NpbWlsYXJpdHlgIGFuZCBgc2V0X3NpbWlsYXJpdHlgXG5leGFjdF9zaW1pbGFyaXR5ID0ge31cbnNldF9zaW1pbGFyaXR5ID0ge31cblxuZm9yICh5ZWFyLCBtZXRob2QpLCB1bml2ZXJzaXRpZXMgaW4gcmFua2luZy5pdGVtcygpOlxuICAgIGNvbXBhcmVbeWVhcl0uYXBwZW5kKHVuaXZlcnNpdGllcylcbiAgICBcbmZvciB5ZWFyLCByYW5rcyBpbiBjb21wYXJlLml0ZW1zKCk6XG4gICAgc2V0X3NpbWlsYXJpdHlbeyBlYXIgOiB5ZWFyIH1dID0gMTAwICogbGVuKHNldChyYW5rc1swXSkpICYgc2V0KHJhbmtzWzFdKSkgLyA1LjBcblxuIyBQcmludCBgc2V0X3NpbWlsYXJpdHlgICBcbnByaW50KHNldF9zaW1pbGFyaXR5KSJ9

Zoals je hebt gemerkt, was dit nogal omslachtig. Kan dit beter en idiomatischer met Pandas?

Natuurlijk! Filter eerst het ranking-DataFrame zodat je alleen de top 5 universiteiten per jaar en rankingmethode overhoudt. Bekijk het resultaat met de functie head():

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgQ29uc3RydWN0IGEgRGF0YUZyYW1lIHdpdGggdGhlIHRvcCA1IHVuaXZlcnNpdGllcyBcbnRvcF81X2RmID0gcmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi53b3JsZF9yYW5rLmlzaW4ocmFuZ2UoMSwgNikpLCA6XVxuXG4jIFByaW50IHRoZSBmaXJzdCByb3dzIG9mIGB0b3BfNV9kZmBcbnRvcF81X2RmLl9fX18oKSIsInNvbHV0aW9uIjoiIyBDb25zdHJ1Y3QgYSBEYXRhRnJhbWUgd2l0aCB0aGUgdG9wIDUgdW5pdmVyc2l0aWVzIFxudG9wXzVfZGYgPSByYW5raW5nX2RmLmxvY1tsYW1iZGEgZGY6IGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLCA2KSksIDpdXG5cbiMgUHJpbnQgdGhlIGZpcnN0IHJvd3Mgb2YgYHRvcF81X2RmYFxudG9wXzVfZGYuaGVhZCgpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcInRvcF81X2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJ0b3BfNV9kZi5oZWFkXCIpXG5zdWNjZXNzX21zZyhcIkdyZWF0IVwiKSJ9

Nu je het juiste DataFrame hebt om mee te werken, gebruik je de methode .groupby om beide rankingmethodes te vergelijken met de hierboven gedefinieerde set-similariteit.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxudG9wXzVfZGYgPSByYW5raW5nX2RmLmxvY1tsYW1iZGEgZGY6IGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLCA2KSksIDpdIiwic2FtcGxlIjoiIyBDb21wdXRlIHRoZSBzaW1pbGFyaXR5XG5kZWYgY29tcHV0ZV9zZXRfc2ltaWxhcml0eShzKTpcbiAgICBwaXZvdGVkID0gcy5waXZvdCh2YWx1ZXM9J3dvcmxkX3JhbmsnLCBjb2x1bW5zPSduYW1lJywgaW5kZXg9J3VuaXZlcnNpdHlfbmFtZScpLmRyb3BuYSgpXG4gICAgc2V0X3NpbWxhcml0eSA9IDEwMCAqIGxlbigoc2V0KHBpdm90ZWRbJ3NoYW5naGFpJ10uaW5kZXgpICYgc2V0KHBpdm90ZWRbJ3RpbWVzJ10uaW5kZXgpKSkgLyA1XG4gICAgcmV0dXJuIHNldF9zaW1sYXJpdHlcblxuIyBHcm91cCBgdG9wXzVfZGZgIGJ5IGB5ZWFyYCAgICBcbmdyb3VwZWRfZGYgPSB0b3BfNV9kZi5fX19fX19fKCd5ZWFyJylcblxuIyBVc2UgYGNvbXB1dGVfc2V0X3NpbWlsYXJpdHlgIHRvIGNvbnN0cnVjdCBhIERhdGFGcmFtZVxuc2V0c2ltaWxhcml0eV9kZiA9IHBkLkRhdGFGcmFtZSh7J3NldF9zaW1pbGFyaXR5JzogZ3JvdXBlZF9kZi5hcHBseShjb21wdXRlX3NldF9zaW1pbGFyaXR5KX0pLnJlc2V0X2luZGV4KClcblxuIyBQcmludCB0aGUgZmlyc3Qgcm93cyBvZiBgc2V0c2ltaWxhcml0eV9kZmBcbnNldHNpbWlsYXJpdHlfZGYuX19fXygpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uX2RlZihcImNvbXB1dGVfc2V0X3NpbWlsYXJpdHlcIilcbkV4KCkudGVzdF9vYmplY3QoXCJncm91cGVkX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwic2V0c2ltaWxhcml0eV9kZlwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwic2V0c2ltaWxhcml0eV9kZi5oZWFkXCIpXG5zdWNjZXNzX21zZyhcIldlbGwgZG9uZSFcIikifQ==

Je krijgt dezelfde resultaten als hierboven, met minder gedoe.

5. Visualisatie

Nu je al wat eerste analyses van je datasets hebt gedaan, is het ook tijd om je data visueel te verkennen. Meer idiomatische Pandas-code betekent ook dat je gebruikmaakt van Pandas’ integratie met het Matplotlib-pakket voor plotten. Daardoor maak je in no-time mooie grafieken!

Voor deze sectie ga je terug naar de datasets times_df en shanghai_df om enkele basisvisualisaties met Matplotlib en Seaborn te maken.
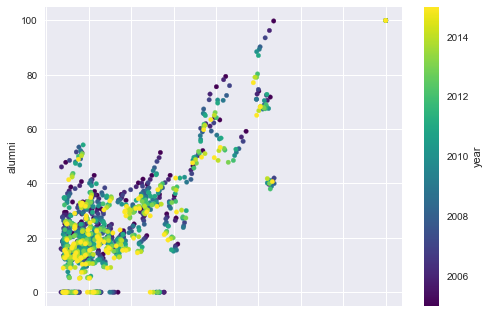
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvc2hhbmdoYWlEYXRhLmNzdicpIiwic2FtcGxlIjoiIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgYWx1bW5pYFxuc2hhbmdoYWlfZGYucGxvdC5zY2F0dGVyKCd0b3RhbF9zY29yZScsICdhbHVtbmknLCBjPSd5ZWFyJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

scatter plot

Bovenstaande plot maakt meteen duidelijk dat er enkele 0-waarden zijn voor de kolom alumni. Dit is iets om zeker rekening mee te houden wanneer je je data verkent: met behulp van data profiling kun je dit soort 0-waarden zien en aanpakken. Wil je hier meer over weten, bekijk dan DataCamp’s Data Profiling Tutorial.

Of, als je waarden hebt die niet in je dataset thuishoren, kun je ze eenvoudig vervangen door NaN en vervolgens alle NaN-waarden uit de kolommen verwijderen die het plotten bemoeilijken. Let op dat dit slechts een snelle manier is om je data aan te passen en dat je waarschijnlijk een uitgebreidere data profiling-stap nodig hebt om je datakwaliteit echt te verbeteren, want je ziet in de plot hieronder nog steeds 0-waarden voor de kolom num_students:
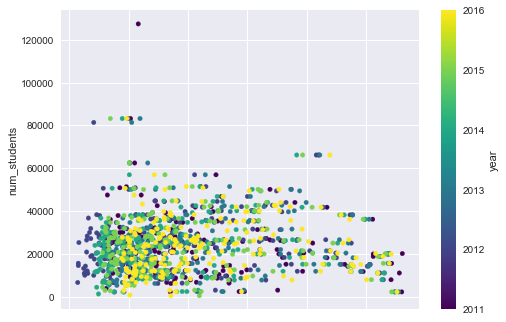
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJlcGxhY2UgYC1gIGVudHJpZXMgd2l0aCBOYU4gdmFsdWVzXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG5cbiMgRHJvcCBhbGwgcm93cyB3aXRoIE5hTiB2YWx1ZXMgZm9yIGBudW1fc3R1ZGVudHNgIFxudGltZXNfZGYgPSB0aW1lc19kZi5kcm9wbmEoc3Vic2V0PVsnbnVtX3N0dWRlbnRzJ10sIGhvdz0nYWxsJylcblxuIyBDYXN0IHRoZSByZW1haW5pbmcgcm93cyB3aXRoIGBudW1fc3R1ZGVudHNgIGFzIGludFxudGltZXNfZGYbJ251bV9zdHVkZW50cyddID0gdGltZXNfZGZbJ251bV9zdHVkZW50cyddLmFzdHlwZSgnaW50JylcblxuIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgbnVtX3N0dWRlbnRzYFxudGltZXNfZGYucGxvdC5zY2F0dGVyKCd0b3RhbF9zY29yZScsICdudW1fc3R1ZGVudHMnLCBjPSd5ZWFyJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

Natuurlijk hoef je je niet te beperken tot Matplotlib om je data te visualiseren. Er zijn ook andere libraries waarmee je snel visualisaties kunt maken, zoals Seaborn.

De plotting-tool Seaborn wordt vooral gebruikt om statistische plots te maken die er visueel aantrekkelijk uitzien (zoals op de officiële website staat). Voor versie 2.0 van Matplotlib was het namelijk best een gedoe (hoewel mogelijk) om mooie plots te maken.

De combinatie van Pandas met Seaborn stelt je ook in staat snel over je data te itereren via visualisaties.

Laten we wat voorbeelden bekijken!

Bekijk de volgende plot, waarin je telt hoe vaak een specifiek land in je data voorkomt. Je neemt de eerste tien observaties en zorgt ervoor dat je de tellingen van hoog naar laag sorteert wanneer je de barplot maakt:
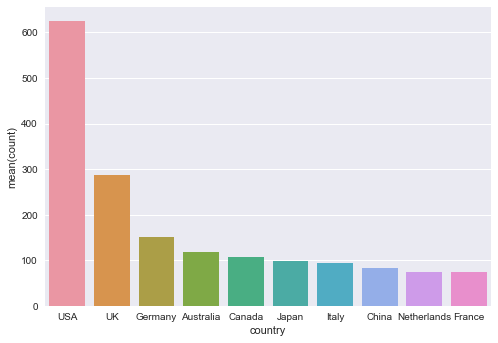
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbWF0cGxvdGxpYi5weXBsb3QgYXMgcGx0XG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpIiwic2FtcGxlIjoiIyBBYmJyZXZpYXRlIGNvdW50cnkgbmFtZXMgb2YgVW5pdGVkIFN0YXRlcyBhbmQgVW5pdGVkIEtpbmdkb21cbnRpbWVzX2RmWydjb3VudHJ5J10gPSB0aW1lc19kZlsnY291bnRyeSddLnJlcGxhY2UoXCJVbml0ZWQgU3RhdGVzIG9mIEFtZXJpY2FcIiwgXCJVU0FcIikucmVwbGFjZShcIlVuaXRlZCBLaW5nZG9tXCIsIFwiVUtfIilcblxuIyBDb3VudCB0aGUgZnJlcXVlbmN5IG9mIGNvdW50cmllcyBcbmNvdW50ID0gdGltZXNfZGZbJ2NvdW50cnknXS52YWx1ZV9jb3VudHMoKVs6MTBdXG5cbiMgQ29udmVydCB0aGUgdG9wIDEwIGNvdW50cmllcyB0byBhIERhdGFGcmFtZSBcbmRmID0gY291bnQudG9fZnJhbWUoKVxuXG4jIFJlc2V0IHRoZSBpbmRleCBcbmRmLnJlc2V0X2luZGV4KGxldmVsPTAsIGlucGxhY2U9VHJ1ZSlcblxuIyBSZW5hbWUgdGhlIGNvbHVtbnNcbmRmLmNvbHVtbnMgPSBbJ2NvdW50cnknLCAnY291bnQnXVxuXG4jIFBsb3QgYSBiYXJwbG90IHdpdGggYGNvdW50cnlgIGFuZCBgY291bnRgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0nY291bnQnLCBkYXRhPWRmKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

bar plot

Vervolgens kun je deze landen en hun gemiddelde scores plotten:
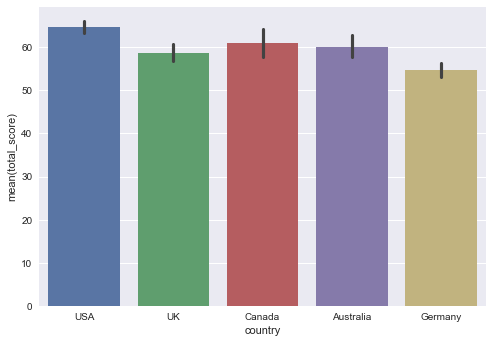
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdCBcbmltcG9ydCBzZWFib3JuIGFzIHNuc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3ZcIiwgdGhvdXNhbmRzPVwiLFwiKVxudGltZXNfZGZbJ2NvdW50cnknXSA9IHRpbWVzX2RmWydjb3VudHJ5J10ucmVwbGFjZShcIlVuaXRlZCBTdGF0ZXMgb2YgQW1lcmljYVwiLCBcIlVTQVwiKS5yZXBsYWNlKFwiVW5pdGVkIEtpbmdkb21cIiwgXCJVS1wiKVxudGltZXNfZGZbJ3RvdGFsX3Njb3JlJ109IHRpbWVzX2RmWyd0b3RhbF9zY29yZSddLnJlcGxhY2UoXCItXCIsIFwiTmFOXCIpLmFzdHlwZSgnZmxvYXQnKVxudGltZXNfZGZfZmlsdGVyZWQ9IHRpbWVzX2RmLnF1ZXJ5KCdjb3VudHJ5ID09XCJVU0FcIiBvciBjb3VudHJ5PT1cIkNhbmFkYVwiIG9yIGNvdW50cnkgPT1cIlVLXCIgb3IgY291bnRyeT09XCJHZXJtYW55XCIgb3IgY291bnRyeT09XCJBdXN0cmFsaWFcIicpIiwic2FtcGxlIjoiIyBCYXJwbG90IHdpdGggYGNvdW50cnkgYW5kIGB0b3RhbF9zY29yZWAgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0ndG90YWxfc2NvcmUnLCBkYXRhPXRpbWVzX2RmX2ZpbHRlcmVkKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

plot

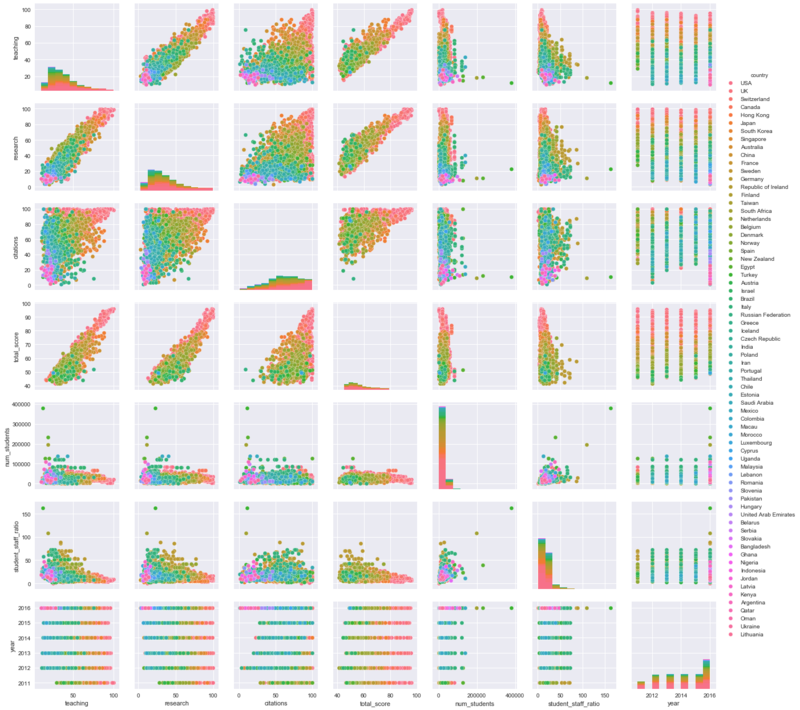
Je plots kunnen ook vrij complex worden. Bekijk de volgende pairplot, die is bedoeld om de pairwise-relaties in een dataset duidelijker te laten zien:

import numpy as np

np.seterr(invalid='ignore')

sns.pairplot(times_df, hue='country')

plt.show()
plots

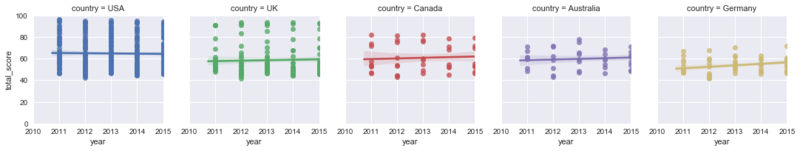
Op dezelfde manier kun je deze combinatie van FacetGrid en regplot bekijken, die je inzicht geeft in de evolutie van de total_score door de jaren heen voor de top 5 landen:
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgcGFuZGFzIGFzIHBkXG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsnY291bnRyeSddID0gdGltZXNfZGZbJ2NvdW50cnknXS5yZXBsYWNlKFwiVW5pdGVkIFN0YXRlcyBvZiBBbWVyaWNhXCIsIFwiVVNBXCIpLnJlcGxhY2UoXCJVbml0ZWQgS2luZ2RvbVwiLCBcIlVLXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG50aW1lc19kZl9maWx0ZXJlZD0gdGltZXNfZGYucXVlcnkoJ2NvdW50cnkgPT1cIlVTQVwiIG9yIGNvdW50cnk9PVwiQ2FuYWRhXCIgb3IgY291bnRyeSA9PVwiVUtcIiBvciBjb3VudHJ5PT1cIkdlcm1hbnlcIiBvciBjb3VudHJ5PT1cIkF1c3RyYWxpYVwiJykiLCJzYW1wbGUiOiIjIEZpbHRlciBvdXQgcm93cyB3aXRoIE5hTiBlbnRyeSBmb3IgYHRvdGFsX3Njb3JlYFxudGltZXNfZGZfZmlsdGVyZWQgPSB0aW1lc19kZl9maWx0ZXJlZC5kcm9wbmEoc3Vic2V0PVsndG90YWxfc2NvcmUnXSwgaG93PSdhbGwnKVxuXG5nID0gc25zLkZhY2V0R3JpZCh0aW1lc19kZl9maWx0ZXJlZCwgY29sPSdjb3VudHJ5JywgaHVlPSdjb3VudHJ5JylcbmcubWFwKHNucy5yZWdwbG90LCAneWVhcicsICd0b3RhbF9zY29yZScpLnNldCh4bGltPSgyMDEwLCAyMDE1KSwgeWxpbT0oMCwxMDApKVxuZy5maWcuc3VicGxvdHNfYWRqdXN0KHdzcGFjZT0uMikifQ==

idiomatische pandas-tutorial

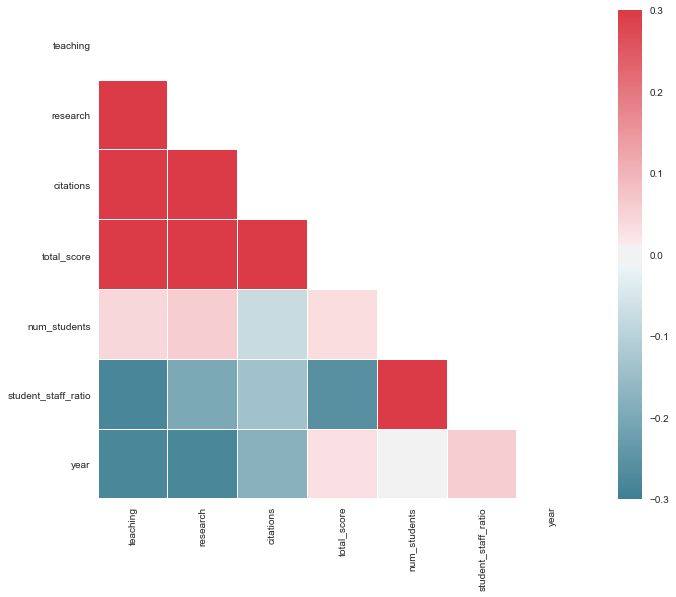
Tot slot kan ook een correlatieplot handig zijn als je je data verkent. Je kunt hiervoor de functie heatmap() uit Seaborn gebruiken:
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbnVtcHkgYXMgbnBcbmltcG9ydCBwYW5kYXMgYXMgcGRcbnRpbWVzX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3YnLCB0aG91c2FuZHM9XCIsXCIpIiwic2FtcGxlIjoiaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuXG5zbnMuc2V0KHN0eWxlPVwid2hpdGVcIilcblxuIyBDb21wdXRlIHRoZSBjb3JyZWxhdGlvbiBtYXRyaXhcbmNvcnIgPSB0aW1lc19kZi5jb3JyKClcblxuIyBHZW5lcmF0ZSBhIG1hc2sgZm9yIHRoZSB1cHBlciB0cmlhbmdsZVxubWFzayA9IG5wLnplcm9zX2xpa2UoY29yciwgZHR5cGU9bnAuYm9vbClcbm1hc2tbbnAudHJpdV9pbmRpY2VzX2Zyb20obWFzayldID0gVHJ1ZVxuXG4jIFNldCB1cCB0aGUgbWF0cGxvdGxpYiBmaWd1cmVcbmYsIGF4ID0gcGx0LnN1YnBsb3RzKGZpZ3NpemU9KDExLCA5KSlcblxuIyBHZW5lcmF0ZSBhIGN1c3RvbSBkaXZlcmdpbmcgY29sb3JtYXBcbmNtYXAgPSBzbnMuZGl2ZXJnaW5nX3BhbGV0dGUoMjIwLCAxMCwgYXNfY21hcD1UcnVlKVxuXG4jIERyYXcgdGhlIGhlYXRtYXAgd2l0aCB0aGUgbWFzayBhbmQgY29ycmVjdCBhc3BlY3QgcmF0aW9cbnNucy5oZWF0bWFwKGNvcnIsIG1hc2s9bWFzaywgY21hcD1jbWFwLCB2bWF4PS4zLFxuICAgICAgICAgICAgc3F1YXJlPVRydWUsIGxpbmV3aWR0aHM9LjUsIGF4PWF4KVxuICAgICAgICAgICAgXG5wbHQuc2hvdygpIn0=

chart

Je kunt eindeloos doorgaan met deze visualisaties, dus misschien is het goed om hier even te stoppen :)

Volgende stappen

Dat was het voor nu. Hopelijk vond je het leuk om wat intermediate technieken met Pandas te leren en vooral hoe je meer idiomatische Pandas-code schrijft.

Als je deze blogpost interessant vond en dieper wilt duiken in performance in Pandas, raad ik de volgende extra materialen aan:

Onderwerpen
Python
Data Science

Pandas-cursussen

{count, plural, one {Cursus} other {Cursussen}}

Python voor gemiddeld niveau

{hours} uur
1.4M
Maak je data science skills sterker: creëer visualisaties met Matplotlib en bewerk DataFrames met pandas.
Bekijk detailsRight Arrow
Start Cursus
Meer bekijkenRight Arrow
Gerelateerd

{count, plural, one {blog} other {blogs}}

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer BekijkenMeer Bekijken

