Accéder au contenu principal

5 Tips to Write Idiomatic Pandas Code

This tutorial covers 5 ways in which you can easily write pandorable or more idiomatic Pandas code.
Actualisé 19 sept. 2026  · 14 min lire

Explorer avec l’IA

ChatGPTClaudePerplexity

Pandas est la boîte à outils de facto des data scientists Python pour faciliter l’analyse de données : vous pouvez, par exemple, l’utiliser en amont de l’analyse pour collecter, explorer et mettre en forme les données. Pandas simplifie ces étapes grâce à ses nombreuses fonctions d’E/S et de manipulation de données. En outre, comme vous l’apprendrez plus loin dans ce tutoriel, il propose aussi des capacités de visualisation (via matplotlib).

Bien que les structures de données de Pandas soient très puissantes et flexibles, elles comportent aussi des subtilités qui peuvent compliquer l’analyse, surtout pour les débutants. Dans ce tutoriel, vous allez voir comment vous épargner des maux de tête et écrire un code Pandas plus idiomatique. Au-delà du chargement, de l’exploration et du nettoyage des données, vous approfondirez les cinq thèmes suivants :

Bien sûr, ce tutoriel n’est pas exhaustif ; le package Pandas est très riche et il existe sans doute bien d’autres façons de rendre votre code plus idiomatique.

Allons droit au but et commençons !

Première étape : charger et explorer les données

Comme toujours, l’analyse débute par le chargement et l’exploration des données. Cette section sert d’échauffement : vous utiliserez la fonction read_csv() pour charger des classements d’universités mondiales, puis vous explorerez rapidement les données avec head() et describe(). Si vous souhaitez une introduction complète à Pandas, commencez par le cours Pandas Foundations de DataCamp (premier volet d’une série en trois parties).

Si vous savez déjà tout cela, vous pouvez passer directement à l’indexation idiomatique avec Pandas.

Importer les packages

Pour commencer, importez les packages Python habituels pour la data science. Comme vous vous en doutez, Pandas en fait partie.

# If you're working with a notebook, don't forget to use Matplotlib magic! 
%matplotlib inline

# Import pandas under the alias pd import pandas as pd # Import seaborn under the alias sns import seaborn as sns # Set the Seaborn theme if desired sns.set_style('darkgrid')

Vous pouvez également utiliser le package watermark : un outil pratique pour rendre vos notebooks plus reproductibles. La reproductibilité est essentielle en collaboration, et votre « vous » futur vous en remerciera aussi ! Pour en savoir plus sur la science des données reproductible, cliquez ici.

Les données

Pour suivre ce tutoriel, il vous faut des données « réelles ». Vous utiliserez un jeu de données provenant de Kaggle. Si vous ne connaissez pas Kaggle, c’est l’une des plus grandes communautés de data science et de machine learning — un excellent endroit pour progresser une fois les bases acquises.

Le jeu de données utilisé est World University Rankings.

Comme indiqué plus haut, Pandas propose de nombreuses méthodes pratiques pour lire des données depuis diverses sources (plus d’infos ici). Les données étant au format CSV, nous utiliserons la méthode .read_csv. Avant de commencer, téléchargez les données depuis Kaggle (ou récupérez-les dans le dépôt de code, dossier data, si vous ne souhaitez pas créer de compte).

Une fois les données récupérées, vous devez avoir un dossier data contenant les différents fichiers CSV.

Vous travaillerez ensuite avec les données de classement Times Higher Education World University Rankings (Times) et Academic Ranking of World Universities (Shanghai). Un troisième système de classement, CWUR, est présent dans le dossier data, mais il est bien moins connu ; vous pouvez l’ignorer pour l’instant.

# Import Times Higher Education World University Rankings data
times_df = pd.read_csv('data/timesData.csv', thousands=",")

# Import Academic Ranking of World Universities data
shanghai_df = pd.read_csv('data/shanghaiData.csv')

Inspection rapide des données

Comme vous l’avez vu dans le tutoriel d’analyse exploratoire de DataCamp, Pandas fournit des méthodes pour inspecter rapidement des DataFrames : .head() pour voir les n premières lignes (n vaut 5 par défaut) et .describe() pour un résumé statistique.

Rafraîchissez ces fonctions en exécutant les lignes ci-dessous. Les données sont déjà chargées dans les variables times_df et shanghai_df :

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBSZXR1cm4gdGhlIGZpcnN0IHJvd3Mgb2YgYHRpbWVzX2RmYFxudGltZXNfZGYuX19fXygpXG5cbiMgRGVzY3JpYmUgYHRpbWVzX2RmYFxudGltZXNfZGYuZGVzY3JpYmUoKVxuXG4jIFJldHVybiB0aGUgZmlyc3Qgcm93cyBvZiBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5oZWFkKClcblxuIyBEZXNjcmliZSBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5fX19fX19fXygpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uKFwidGltZXNfZGYuaGVhZFwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwidGltZXNfZGYuZGVzY3JpYmVcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInNoYW5naGFpX2RmLmhlYWRcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInNoYW5naGFpX2RmLmRlc2NyaWJlXCIpXG5zdWNjZXNzX21zZyhcIllvdSdyZSBvZmYgdG8gYSBncmVhdCBzdGFydCEgXCIpIn0=

Maintenant que les données sont chargées, passons à une manipulation plus idiomatique avec Pandas !

Nos conseils pour un code Pandas idiomatique

1. Indexation

Écrire du code Pandas idiomatique, c’est d’abord exploiter la puissance de l’indexation, c’est‑à‑dire sélectionner des sous‑ensembles de votre DataFrame.

Au début, il faut un temps d’adaptation. Si vous avez déjà travaillé avec des listes Python, vous connaissez sans doute les crochets [] combinés aux deux‑points : pour sélectionner des éléments. Cette méthode fonctionne aussi sur les DataFrames.

Deux approches plus idiomatiques existent pour sélectionner un sous‑DataFrame : iloc et loc :

  • loc est basé sur les étiquettes : si vous écrivez loc[2], vous cherchez les valeurs dont l’index est étiqueté 2.
  • iloc est basé sur la position : si vous écrivez iloc[2], vous récupérez les valeurs situées à la position 2.

Testez ci‑dessous en saisissant times_df.loc[2] et times_df.iloc[2] dans la console IPython pour constater la différence. Ensuite, résolvez l’exercice à l’aide de loc, iloc et des crochets traditionnels !

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJldHJpZXZlIHRoZSB0b3RhbCBzY29yZSBvZiB0aGUgZmlyc3Qgcm93XG5wcmludCh0aW1lc19kZi5sb2NbMCwgJ19fX19fX19fX19fJ10pXG5cbiMgUmV0cmlldmUgcm93cyAwIGFuZCAxXG5wcmludCh0aW1lc19kZltfOl9dKVxuXG4jIFJldHJpZXZlIHRoZSB2YWx1ZXMgYXQgY29sdW1ucyBhbmQgcm93cyAxLTNcbnByaW50KHRpbWVzX2RmLmlsb2NbMTo0LDE6NF0pXG5cbiMgUmV0cmlldmUgdGhlIGNvbHVtbiBgdG90YWxfc2NvcmVgIFxucHJpbnQodGltZXNfZGZbJ19fX19fX19fX18nXSkiLCJzb2x1dGlvbiI6IiMgUmV0cmlldmUgdGhlIHRvdGFsIHNjb3JlIG9mIHRoZSBmaXJzdCByb3dcbnByaW50KHRpbWVzX2RmLmxvY1swLCAndG90YWxfc2NvcmUnXSlcblxuIyBSZXRyaWV2ZSByb3dzIDAgYW5kIDFcbnByaW50KHRpbWVzX2RmWzA6Ml0pXG5cbiMgUmV0cmlldmUgdGhlIHZhbHVlcyBhdCBjb2x1bW5zIGFuZCByb3dzIDEtM1xucHJpbnQodGltZXNfZGYuaWxvY1sxOjQsMTo0XSlcblxuIyBSZXRyaWV2ZSB0aGUgY29sdW1uIGB0b3RhbF9zY29yZWAgXG5wcmludCh0aW1lc19kZlsndG90YWxfc2NvcmUnXSkiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0xKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTMpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD00KVxuc3VjY2Vzc19tc2coXCJBd2Vzb21lISBZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgc3Vic2V0dGVkIHlvdXIgZGF0YSB3aXRoIGBsb2NgIGFuZCBgaWxvY2AuXCIpIn0=

Bien sûr, l’exploration ne se limite pas à sélectionner des lignes et des colonnes. Les choses deviennent intéressantes quand vous combinez loc et iloc avec, par exemple, des tableaux booléens.

On dépasse alors la simple sélection : c’est presque comme interroger vos données !

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3ZcIikiLCJzYW1wbGUiOiIjIEFyZSB0aGUgbGFzdCBlbnRyaWVzIGFmdGVyIDIwMDY/XG5wcmludChzaGFuZ2hhaV9kZi5sb2NbOi0xMCwgJ3llYXInXSA+IDIwMDYpXG5cbiMgV2FzIHRoZSBhbHVtbmkgY291bnQgaGlnaGVyIHRoYW4gOTAgZm9yIHRoZSBmaXJzdCAgdGVuIHVuaXZlcnNpdGllcz9cbnByaW50KHNoYW5naGFpX2RmLmxvY1swOjExLCAnYWx1bW5pJ10gPiA5MCkiLCJzb2x1dGlvbiI6IiMgQXJlIHRoZSBsYXN0IGVudHJpZXMgYWZ0ZXIgMjAwNj9cbnByaW50KHNoYW5naGFpX2RmLmxvY1s6LTEwLCAneWVhciddID4gMjAwNilcblxuIyBXYXMgdGhlIGFsdW1uaSBjb3VudCBoaWdoZXIgdGhhbiA5MCBmb3IgdGhlIGZpcnN0ICB0ZW4gdW5pdmVyc2l0aWVzP1xucHJpbnQoc2hhbmdoYWlfZGYubG9jWzA6MTEsICdhbHVtbmknXSA+IDkwKSIsInNjdCI6IkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTEpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgcXVlcmllZCB5b3VyIGRhdGEgd2l0aCBgbG9jYCFcIikifQ==

loc et iloc sont excellents pour indexer, mais attention si vous enchaînez deux paires de crochets ! Pandas peut renvoyer une copie d’une vue et vous pourriez ne plus savoir sur quel objet vous travaillez. Réfléchissez à deux fois avant d’utiliser deux crochets avec loc ou iloc.

Remarque : pour interroger vos données, Pandas propose aussi la fonction query() (disponible depuis la version 0.13), utile pour des inspections rapides. Par exemple, composez une requête pour voir quelles universités ont un total_score juste en dessous de 50 :

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmdlX3NjaG9vbHMgPSBzaGFuZ2hhaV9kZi5xdWVyeSgndG90YWxfc2NvcmUgPiBfXyBhbmQgdG90YWxfc2NvcmUgPCBfXycpXG5cbiMgUHJpbnQgdGhlIHJlc3VsdFxucHJpbnQoYXZlcmFnZV9zY2hvb2xzKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmFnZV9zY2hvb2xzID0gc2hhbmdoYWlfZGYucXVlcnkoJ3RvdGFsX3Njb3JlID4gNDAgYW5kIHRvdGFsX3Njb3JlIDwgNTAnKVxuXG4jIFByaW50IHRoZSByZXN1bHRcbnByaW50KGF2ZXJhZ2Vfc2Nob29scykiLCJzY3QiOiJFeCgpLnRlc3Rfb2JqZWN0KFwiYXZlcmFnZV9zY2hvb2xzXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Les possibilités sont nombreuses ! Pourquoi ne pas tester des requêtes qui renvoient les universités classées premières au niveau national, puis mondial ? Vous pouvez aussi interroger les nombres d’alumni.

Besoin d’inspiration pour composer vos requêtes ? Voici quelques exemples :

shanghai_df.query("national_rank == 1 and world_rank == 1")
shanghai_df.query("alumni < 20")

2. Enchaînement de méthodes

L’enchaînement de méthodes est typique de Pandas, mais lorsqu’on débute, ce n’est pas toujours intuitif. Il s’agit simplement d’appeler plusieurs méthodes à la suite sur un même objet.

Dans cette section, vous irez plus loin en créant des pipelines de données avec pipe().

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6IiMgRXh0cmFjdCBpbmZvXG5kZWYgZXh0cmFjdF9pbmZvKGlucHV0X2RmLCBuYW1lKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGluZm9fZGYgPSBwZC5EYXRhRnJhbWUoeyduYl9yb3dzJzogZGYuc2hhcGVbMF0sICduYl9jb2xzJzogZGYuc2hhcGVbMV0sICduYW1lJzogbmFtZX0sIGluZGV4PXJhbmdlKDEpKVxuICAgIHJldHVybiBpbmZvX2RmXG5cbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNvbHV0aW9uIjoiIyBFeHRyYWN0IGluZm9cbmRlZiBleHRyYWN0X2luZm8oaW5wdXRfZGYsIG5hbWUpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgaW5mb19kZiA9IHBkLkRhdGFGcmFtZSh7J25iX3Jvd3MnOiBkZi5zaGFwZVswXSwgJ25iX2NvbHMnOiBkZi5zaGFwZVsxXSwgJ25hbWUnOiBuYW1lfSwgaW5kZXg9cmFuZ2UoMSkpXG4gICAgcmV0dXJuIGluZm9fZGZcbiBcbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNjdCI6ImZ1bl9kZWYgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImV4dHJhY3RfaW5mb1wiKS5tdWx0aShjaGVja19hcmdzKCdpbnB1dF9kZicpLCBjaGVja19hcmdzKCduYW1lJykpXG5mdW5fZGVmLmNoZWNrX2JvZHkoKVxuZnVuX2RlZi5jYWxsKFwiZih0aW1lc19kZiwgJ3RpbWVzJylcIilcbmZ1bl9kZWYuY2FsbChcImYoc2hhbmdoYWlfZGYsICdzaGFuZ2hhaScpXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwiYWxsX2luZm9cIilcbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Vous l’avez remarqué : les jeux de données diffèrent. Par exemple :

  • Times comporte 14 colonnes, Shanghai 11 ;
  • Times contient 2603 lignes, Shanghai 4897 ;
  • La colonne « pays » manque dans Shanghai. Vous pourrez l’extraire depuis Times si besoin.

Pour utiliser les deux DataFrames, ne gardons que les colonnes communes — en espérant qu’elles contiennent des informations similaires.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6ImNvbW1vbl9jb2x1bW5zID0gc2V0KHNoYW5naGFpX2RmLmNvbHVtbnMpICYgc2V0KHRpbWVzX2RmLmNvbHVtbnMpXG5cbiMgUmV0dXJuIGBjb21tb25fY29sdW1uc2BcbnByaW50KGNvbW1vbl9jb2x1bW5zKSIsInNvbHV0aW9uIjoiY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcblxuIyBSZXR1cm4gYGNvbW1vbl9jb2x1bW5zYFxucHJpbnQoY29tbW9uX2NvbHVtbnMpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcImNvbW1vbl9jb2x1bW5zXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKSJ9

Les colonnes communes sont donc :

  • total_score : score utilisé pour déterminer le rang. Comme précisé sur Kaggle, il peut s’agir de plages (entre deux valeurs) ou d’égalités (préfixées par =).
  • university_name : nom de l’université.
  • world_rank : rang mondial de l’université.
  • year : année du classement.

Avant de concaténer les deux jeux, effectuons un peu de nettoyage. Appliquez maintenant le pipeline complet pour nettoyer les données :

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucykiLCJzYW1wbGUiOiIjIENsZWFuIHVwIHRoZSBgd29ybGRfcmFua2AgXG5kZWYgY2xlYW5fd29ybGRfcmFuayhpbnB1dF9kZik6XG4gICAgZGYgPSBpbnB1dF9kZi5jb3B5KClcbiAgICBkZi53b3JsZF9yYW5rID0gZGYud29ybGRfcmFuay5zdHIuc3BsaXQoJy0nKS5zdHJbMF0uc3RyLnNwbGl0KCc9Jykuc3RyWzBdXG4gICAgcmV0dXJuIGRmXG4gICAgXG4jIEFzc2lnbiB0aGUgY29tbW9uIHllYXJzIG9mIGBzaGFuZ2hhaV9kZmAgYW5kIGB0aW1lc19kZmAgdG8gYGNvbW1vbl95ZWFyc2AgICAgXG5jb21tb25feWVhcnMgPSBzZXQoc2hhbmdoYWlfZGYueWVhcikgJiBzZXQodGltZXNfZGYueWVhcikgXG5cbiMgUHJpbnQgYGNvbW1vbl95ZWFyc2BcbnByaW50KGNvbW1vbl95ZWFycylcblxuIyBGaWx0ZXIgeWVhcnNcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuXG4jIENsZWFuIGB0aW1lc19kZmAgYW5kIGBzaGFuZ2hhaV9kZmBcbmNsZWFuZWRfdGltZXNfZGYgPSAodGltZXNfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3RpbWVzJykpXG5jbGVhbmVkX3NoYW5naGFpX2RmID0gKHNoYW5naGFpX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmspXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLmFzc2lnbihuYW1lPSdzaGFuZ2hhaScpKSIsInNvbHV0aW9uIjoiIyBDbGVhbiB1cCB0aGUgYHdvcmxkX3JhbmtgIFxuZGVmIGNsZWFuX3dvcmxkX3JhbmtoaW5wdXRfZGYpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgZGYud29ybGRfcmFuayA9IGRmLndvcmxkX3Jhbmsuc3RyLnNwbGl0KCctJykuc3RyWzBdLnN0ci5zcGxpdCgnPScpLnN0clswXVxuICAgIHJldHVybiBkZlxuICAgIFxuIyBBc3NpZ24gdGhlIGNvbW1vbiB5ZWFycyBvZiBgc2hhbmdoYWlfZGZgIGFuZCBgdGltZXNfZGZgIHRvIGBjb21tb25feWVhcnNgICAgIFxuY29tbW9uX3llYXJzID0gc2V0KHNoYW5naGFpX2RmLnllYXIpICYgc2V0KHRpbWVzX2RmLnllYXIpIFxuXG4jIFByaW50IGBjb21tb25feWVhcnNgXG5wcmludChjb21tb25feWVhcnMpXG5cbiMgRmlsdGVyIHllYXJzXG5kZWYgZmlsdGVyX3llYXIoaW5wdXRfZGYsIHllYXJzKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIHJldHVybiBkZi5xdWVyeSgneWVhciBpbiB7fScuZm9ybWF0KGxpc3QoeWVhcnMpKSlcblxuIyBDbGVhbiBgdGltZXNfZGZgIGFuZCBgc2hhbmdoYWlfZGZgXG5jbGVhbmVkX3RpbWVzX2RmID0gKHRpbWVzX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmspXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLmFzc2lnbihuYW1lPSd0aW1lcycpKVxuY2xlYW5lZF9zaGFuZ2hhaV9kZiA9IChzaGFuZ2hhaV9kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0nc2hhbmdoYWknKSkiLCJzY3QiOiJmdW5fZGVmMSA9IEV4KCkuY2hlY2tfZnVuY3Rpb25fZGVmKFwiZmlsdGVyX3llYXJcIikubXVsdGkoY2hlY2tfYXJncygnaW5wdXRfZGYnKSwgY2hlY2tfYXJncygneWVhcnMnKSlcbmZ1bl9kZWYxLmNoZWNrX2JvZHkoKVxuZnVuX2RlZjEuY2FsbChcImYodGltZXNfZGYsIGNvbW1vbl95ZWFycylcIilcbmZ1bl9kZWYxLmNhbGwoXCJmKHNoYW5naGFpX2RmLCBjb21tb25feWVhcnMpXCIpXG5cbkV4KCkudGVzdF9vYmplY3QoXCJjb21tb25feWVhcnNcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIpXG5cbmZ1bl9kZWYgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImNsZWFuX3dvcmxkX3JhbmtcIilcbmZ1bl9kZWYuY2hlY2tfYm9keSgpXG5mdW5fZGVmLmNhbGwoXCJmKHRpbWVzX2RmKVwiKVxuZnVuX2RlZi5jYWxsKFwiZihzaGFuZ2hhaV9kZilcIilcblxuRXgoKS50ZXN0X29iamVjdChcImNsZWFuZWRfdGltZXNfZGZcIilcbkV4KCkudGVzdF9vYmplY3QoXCJjbGVhbmVkX3NoYW5naGFpX2RmXCIpXG5cbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Vous remarquerez que j’utilise souvent la méthode .pipe dans ce tutoriel. Si vous venez de R, cela vous semblera familier.

C’est une méthode pratique (depuis la version 0.16.2) qui permet d’enchaîner les opérations et d’éviter les DataFrames intermédiaires. Votre code gagne en lisibilité.

Sans cet opérateur, au lieu d’écrire df.pipe(f).pipe(g).pipe(h), vous écririez h(g(f(df))) — vite illisible avec des imbrications profondes.

Pour approfondir, je vous recommande vivement cet article de blog.

Maintenant que les deux DataFrames sont nettoyés, nous pouvons les concaténer en un seul. N’oubliez pas de gérer les valeurs manquantes :

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpIiwic2FtcGxlIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNvbHV0aW9uIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNjdCI6IkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwibWlzc2luZ19kYXRhXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwicmFua2luZ19kZlwiKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgaW1wcm92ZWQgeW91ciBkYXRhIHF1YWxpdHkhXCIpIn0=

Environ 38 % des valeurs de la colonne total_score sont manquantes : mieux vaut supprimer cette colonne avec .drop.

3. Optimisation mémoire

Troisième levier pour rendre votre code Pandas plus « idiomatique » — et surtout plus performant : optimiser l’usage mémoire. Avec des pipelines enchaînés, la mémoire influe fortement sur la vitesse d’exécution. Voyons cela.

Sur un petit jeu comme celui‑ci c’est peut‑être excessif, mais caster certaines colonnes vers des types spécifiques est souvent une bonne pratique. Commencez par mesurer la mémoire allouée à ranking_df avec .info.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBQcmludCB0aGUgbWVtb3J5IHVzYWdlIG9mIGByYW5raW5nX2RmYCBcbnJhbmtpbmdfZGYuX19fXygpXG5cbiMgUHJpbnQgdGhlIGRlZXAgbWVtb3J5IHVzYWdlIG9mIGByYW5raW5nX2RmYCBcbnJhbmtpbmdfZGYuaW5mbyhtZW1vcnlfdXNhZ2U9XCJkZWVwXCIpIiwic29sdXRpb24iOiIjIFByaW50IHRoZSBtZW1vcnkgdXNhZ2Ugb2YgYHJhbmtpbmdfZGZgIFxucmFua2luZ19kZi5pbmZvKClcblxuIyBQcmludCB0aGUgZGVlcCBtZW1vcnkgdXNhZ2Ugb2YgYHJhbmtpbmdfZGZgIFxucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT1cImRlZXBcIikiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJyYW5raW5nX2RmLmluZm9cIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJHcmVhdCFcIikifQ

Le premier appel indique 144 Ko. En regardant les arguments de .info, on découvre memory_usage, optionnel (None par défaut). Que se passe‑t‑il si vous le passez à deep ?

L’empreinte mémoire devient environ 5,6 fois plus grande que l’estimation initiale.

Pourquoi ?

Sans l’option « deep », Pandas n’estime pas la mémoire des colonnes de type object. Or ce type Python occupe plus d’espace que les dtypes optimisés de numpy. Il est donc recommandé de convertir les object vers des types plus adaptés (par exemple category pour des données catégorielles).

Faisons‑le !

def memory_change(input_df, column, dtype):
    df = input_df.copy()
    old = round(df[column].memory_usage(deep=True) / 1024, 2) # In KB
    new = round(df[column].astype(dtype).memory_usage(deep=True) / 1024, 2)# In KB
    change = round(100 * (old - new) / (old), 2)
    report = ("The inital memory footprint for {column} is: {old}KB.\n" 
              "The casted {column} now takes: {new}KB.\n"
              "A change of {change} %.").format(**locals())
    return report

print(memory_change(ranking_df,'world_rank', 'int16'))
print(memory_change(ranking_df,'university_name', 'category'))
print(memory_change(ranking_df,'name', 'category'))

Maintenant que vous savez qu’en passant world_rank en int16, par exemple, vous gagnez en efficacité mémoire, appliquez ces changements avec astype(). Terminez en vérifiant l’usage mémoire :

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBDYXN0IGB3b3JsZF9yYW5rYCBhcyB0eXBlIGBpbnQxNmBcbnJhbmtpbmdfZGYud29ybGRfcmFuayA9IHJhbmtpbmdfZGYud29ybGRfcmFuay5fX19fX19fKCdpbnQxNicpXG5cbiMgQ2FzdCBgdW52ZXJzaXR5X25hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi51bml2ZXJzaXR5X25hbWUgPSByYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZS5hc3R5cGUoJ2NhdGVnb3J5JylcblxuIyBDYXN0IGBuYW1lYCBhcyB0eXBlIGBjYXRlZ29yeWBcbnJhbmtpbmdfZGYubmFtZSA9IHJhbmtpbmdfZGYuX19fXy5hc3R5cGUoJ2NhdGVnb3J5JylcblxuIyBEb3VibGUgY2hlY2sgdGhlIG1lbW9yeSB1c2FnZSBhZnRlciB0eXBlIGNhc3RpbmdcbnJhbmtpbmdfZGYuaW5mbyhtZW1vcnlfdXNhZ2U9J2RlZXAnKSIsInNvbHV0aW9uIjoiIyBDYXN0IGB3b3JsZF9yYW5rYCBhcyB0eXBlIGBpbnQxNmBcbnJhbmtpbmdfZGYud29ybGRfcmFuayA9IHJhbmtpbmdfZGYud29ybGRfcmFuay5hc3R5cGUoJ2ludDE2JylcblxuIyBDYXN0IGB1bnZlcnNpdHlfbmFtZWAgYXMgdHlwZSBgY2F0ZWdvcnlgXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIENhc3QgYG5hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIERvdWJsZSBjaGVjayB0aGUgbWVtb3J5IHVzYWdlIGFmdGVyIHR5cGUgY2FzdGluZ1xucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT0nZGVlcCcpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcInJhbmtpbmdfZGZcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Beaucoup mieux. Vous pouvez aller plus loin en castant aussi la colonne year en int32.

4. GroupBy

Maintenant que le jeu est propre (données ordonnées) et l’empreinte mémoire optimisée, place à l’analyse.

Deux questions intéressantes :

  • Quelles sont les 5 meilleures universités selon chaque système de classement au fil des années ?
  • En quoi ces classements diffèrent‑ils chaque année ?

Répondons à la première, en appliquant les bonnes pratiques idiomatiques vues plus haut.

Avant de commencer, remarquez que « Massachusetts Institute of Technology (MIT) » et « Massachusetts Institute of Technology » désignent la même université avec deux enregistrements différents. Remplacez le premier par le second.

Dans ce type de cas, la fonction loc vue plus haut est particulièrement utile.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgUXVlcnkgZm9yIHRoZSByb3dzIHdpdGggdW5pdmVyc2l0eSBuYW1lICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1xucHJpbnQocmFua2luZ19kZi5fX19fXyhcInVuaXZlcnNpdHlfbmFtZSA9PSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSAoTUlUKSdcIikpXG5cbiMgTG9jYWxpemUgdGhlIHJvd3Mgd2l0aGUgTUlUIHVuaXZlcnNpdHkgbmFtZSBhbmQgcmVwbGFjZSB2YWx1ZSBcbnJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogZGYudW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJywgJ3VuaXZlcnNpdHlfbmFtZSddID0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3knXG5cbiMgUHJpbnQgYHJhbmtpbmdfZGZgXG5wcmludChfX19fX19fX19fKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBmb3IgdGhlIHJvd3Mgd2l0aCB1bml2ZXJzaXR5IG5hbWUgJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknXG5wcmludChyYW5raW5nX2RmLnF1ZXJ5KFwidW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1wiKSlcblxuIyBMb2NhbGl6ZSB0aGUgcm93cyB3aXRoIHRoZSBNSVQgdW5pdmVyc2l0eSBuYW1lIGFuZCByZXBsYWNlIHZhbHVlIFxucmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi51bml2ZXJzaXR5X25hbWUgPT0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknLCAndW5pdmVyc2l0eV9uYW1lJ10gPSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSdcblxuIyBQcmludCBgcmFua2luZ19kZmBcbnByaW50KHJhbmtpbmdfZGYpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Pour trouver les 5 (meilleures) universités chaque année et pour chaque système, voici le pseudo‑code :

  • Pour chaque année (year) et chaque système (name) :
  • Sélectionner le sous‑ensemble correspondant
  • Prendre les 5 premières et les stocker dans une liste
  • Enregistrer le résultat dans un dictionnaire avec (year, name) comme clé et la liste (ordre décroissant) comme valeur

Appliquons‑le.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgTG9hZCBpbiBgaXRlcnRvb2xzYFxuaW1wb3J0IGl0ZXJ0b29sc1xuXG4jIEluaXRpYWxpemUgYHJhbmtpbmdgXG5yYW5raW5nID0ge31cblxuZm9yIHllYXIsIG5hbWUgaW4gaXRlcnRvb2xzLnByb2R1Y3QoY29tbW9uX3llYXJzLCBbXCJ0aW1lc1wiLCBcInNoYW5naGFpXCJdKTpcbiAgICBzID0gKHJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogKChkZi55ZWFyID09IHllYXIpICYgKGRmLm5hbWUgPT0gbmFtZSlcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICYgKGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLDYpKSkpLCA6XVxuICAgICAgICAgICAgICAgICAgIC5zb3J0X3ZhbHVlcygnd29ybGRfcmFuaycsIGFzY2VuZGluZz1GYWxzZSlcbiAgICAgICAgICAgICAgICAgICAudW5pdmVyc2l0eV9uYW1lKVxuICAgIHJhbmtpbmdbKHllYXIsIG5hbWUpXSA9IGxpc3QocylcbiAgICBcblxuIyBQcmludCBgcmFua2luZ2BcbnByaW50KHJhbmtpbmcpIn0=

À partir de ce dictionnaire, mesurons en pourcentage à quel point les deux méthodes diffèrent au fil des ans : elles sont similaires à 100 % si les 5 universités sélectionnées sont les mêmes, quel que soit l’ordre.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IGl0ZXJ0b29sc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZyA9IHt9XG5mb3IgeWVhciwgbmFtZSBpbiBpdGVydG9vbHMucHJvZHVjdChjb21tb25feWVhcnMsIFtcInRpbWVzXCIsIFwic2hhbmdoYWlcIl0pOlxuICAgIHMgPSAocmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiAoKGRmLnllYXIgPT0geWVhcikgJiAoZGYubmFtZSA9PSBuYW1lKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgJiAoZGYud29ybGRfcmFuay5pc2luKHJhbmdlKDEsNikpKSksIDpdXG4gICAgICAgICAgICAgICAgICAgLnNvcnRfdmFsdWVzKCd3b3JsZF9yYW5rJywgYXNjZW5kaW5nPUZhbHNlKVxuICAgICAgICAgICAgICAgICAgIC51bml2ZXJzaXR5X25hbWUpXG4gICAgcmFua2luZ1soeWVhciwgbmFtZSldID0gbGlzdChzKSIsInNhbXBsZSI6IiMgSW1wb3J0IGBkZWZhdWx0ZGljdGBcbmZyb20gY29sbGVjdGlvbnMgaW1wb3J0IGRlZmF1bHRkaWN0XG5cbiMgSW5pdGlhbGl6ZSBgY29tcGFyZWBcbmNvbXBhcmUgPSBkZWZhdWx0ZGljdChsaXN0KVxuXG4jIEluaXRpYWxpemUgYGV4YWN0X3NpbWlsYXJpdHlgIGFuZCBgc2V0X3NpbWlsYXJpdHlgXG5leGFjdF9zaW1pbGFyaXR5ID0ge31cbnNldF9zaW1pbGFyaXR5ID0ge31cblxuZm9yICh5ZWFyLCBtZXRob2QpLCB1bml2ZXJzaXRpZXMgaW4gcmFua2luZy5pdGVtcygpOlxuICAgIGNvbXBhcmVbeWVhcl0uYXBwZW5kKHVuaXZlcnNpdHllcylcbiAgICBcbmZvciB5ZWFyLCByYW5rcyBpbiBjb21wYXJlLml0ZW1zKCk6XG4gICAgc2V0X3NpbWlsYXJpdHlbeWVhcl0gPSAxMDAgKiBsZW4oc2V0KHJhbmtzWzBdKSAmIHNldChyYW5rc1sxXSkpIC8gNS4wXG5cbiMgUHJpbnQgYHNldF9zaW1pbGFyaXR5YCAgXG5wcmludChzZXRfc2ltaWxhcml0eSkifQ

Vous avez vu, c’est fastidieux. Existe‑t‑il une méthode Pandas plus idiomatique ?

Oui ! Commencez par filtrer le DataFrame pour ne garder que les 5 meilleures universités par année et par méthode. Vérifiez le résultat avec head() :

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgQ29uc3RydWN0IGEgRGF0YUZyYW1lIHdpdGggdGhlIHRvcCA1IHVuaXZlcnNpdHllcyBcbnRvcF81X2RmID0gcmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi53b3JsZF9yYW5rLmlzaW4ocmFuZ2UoMSwgNikpLCA6XVxuXG4jIFByaW50IHRoZSBmaXJzdCByb3dzIG9mIGB0b3BfNV9kZmBcbnRvcF81X2RmLl9fX18oKSIsInNvbHV0aW9uIjoiIyBDb25zdHJ1Y3QgYSBEYXRhRnJhbWUgd2l0aCB0aGUgdG9wIDUgdW5pdmVyc2l0aWVzIFxudG9wXzVfZGYgPSByYW5raW5nX2RmLmxvY1tsYW1iZGEgZGY6IGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLCA2KSksIDpdXG5cbiMgUHJpbnQgdGhlIGZpcnN0IHJvd3Mgb2YgYHRvcF81X2RmYFxudG9wXzVfZGYuaGVhZCgpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcInRvcF81X2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJ0b3BfNV9kZi5oZWFkXCIpXG5zdWNjZXNzX21zZyhcIkdyZWF0IVwiKSJ9

Avec ce DataFrame prêt, utilisez .groupby pour comparer les deux méthodes via la similarité d’ensemble définie plus haut.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxudG9wXzVfZGYgPSByYW5raW5nX2RmLmxvY1tsYW1iZGEgZGY6IGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLCA2KSksIDpdIiwic2FtcGxlIjoiIyBDb21wdXRlIHRoZSBzaW1pbGFyaXR5XG5kZWYgY29tcHV0ZV9zZXRfc2ltaWxhcml0eShzKTpcbiAgICBwaXZvdGVkID0gcy5waXZvdCh2YWx1ZXM9J3dvcmxkX3JhbmsuLCBjb2x1bW5zPSduYW1lJywgaW5kZXg9J3VuaXZlcnNpdHlfbmFtZScpLmRyb3BuYSgpXG4gICAgc2V0X3NpbWxhcml0eSA9IDEwMCAqIGxlbigoc2V0KHBpdm90ZWRbJ3NoYW5naGFpJ10uaW5kZXgpICYgc2V0KHBpdm90ZWRbJ3RpbWVzJ10uaW5kZXgpKSkgLyA1XG4gICAgcmV0dXJuIHNldF9zaW1sYXJpdHlcblxuIyBHcm91cCBgdG9wXzVfZGZgIGJ5IGB5ZWFyYCAgICBcbmdyb3VwZWRfZGYgPSB0b3BfNV9kZi5fX19fX19fKCd5ZWFyJylcblxuIyBVc2UgYGNvbXB1dGVfc2V0X3NpbWlsYXJpdHlgIHRvIGNvbnN0cnVjdCBhIERhdGFGcmFtZVxuc2V0c2ltaWxhcml0eV9kZiA9IHBkLkRhdGFGcmFtZSh7J3NldF9zaW1pbGFyaXR5JzogZ3JvdXBlZF9kZi5hcHBseShjb21wdXRlX3NldF9zaW1pbGFyaXR5KX0pLnJlc2V0X2luZGV4KClcblxuIyBQcmludCB0aGUgZmlyc3Qgcm93cyBvZiBgc2V0c2ltaWxhcml0eV9kZmBcbnNldHNpbWlsYXJpdHlfZGYuX19fXygpIiwic29sdXRpb24iOiIjIENvbXB1dGUgdGhlIHNpbWlsYXJpdHlcbmRlZiBjb21wdXRlX3NldF9zaW1pbGFyaXR5KHMpOlxuICAgIHBpdm90ZWQgPSBzLnBpdm90KHZhbHVlcz0nd29ybGRfcmFuaycsIGNvbW1vbnM9J25hbWUnLCBpbmRleD0ndW5pdmVyc2l0eV9uYW1lJykuZHJvcG5hKClcbiAgICBzZXRfc2ltbGFyaXR5ID0gMTAwICogbGVuKChzZXQocGl2b3RlZFsnc2hhbmdoYWknXS5pbmRleCkgJiBzZXQocGl2b3RlZFsndGltZXMnXS5pbmRleCkpKSAvIDVcbiAgICByZXR1cm4gc2V0X3NpbWxhcml0eVxuICAgIFxuIyBHcm91cCBgdG9wXzVfZGZgIGJ5IGB5ZWFyYCAgICBcbmdyb3VwZWRfZGYgPSB0b3BfNV9kZi5ncm91cGJ5KCd5ZWFyJylcblxuIyBVc2UgYGNvbXB1dGVfc2V0X3NpbWlsYXJpdHlgIHRvIGNvbnN0cnVjdCBhIERhdGFGcmFtZVxuc2V0c2ltaWxhcml0eV9kZiA9IHBkLkRhdGFGcmFtZSh7J3NldF9zaW1pbGFyaXR5JzogZ3JvdXBlZF9kZi5hcHBseShjb21wdXRlX3NldF9zaW1pbGFyaXR5KX0pLnJlc2V0X2luZGV4KClcblxuIyBQcmludCB0aGUgZmlyc3Qgcm93cyBvZiBgc2V0c2ltaWxhcml0eV9kZmBcbnNldHNpbWlsYXJpdHlfZGYuaGVhZCgpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uX2RlZihcImNvbXB1dGVfc2V0X3NpbWlsYXJpdHlcIilcbkV4KCkudGVzdF9vYmplY3QoXCJncm91cGVkX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwic2V0c2ltaWxhcml0eV9kZlwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwic2V0c2ltaWxhcml0eV9kZi5oZWFkXCIpXG5zdWNjZXNzX21zZyhcIldlbGwgZG9uZSFcIikifQ

Vous obtenez le même résultat, avec moins d’efforts.

5. Visualisation

Après ces premières analyses, place aussi à l’exploration visuelle. Écrire du code Pandas idiomatique, c’est profiter de son intégration graphique avec Matplotlib pour produire rapidement de beaux graphiques.

Dans cette section, revenez aux jeux times_df et shanghai_df pour réaliser quelques visualisations de base avec Matplotlib et Seaborn.
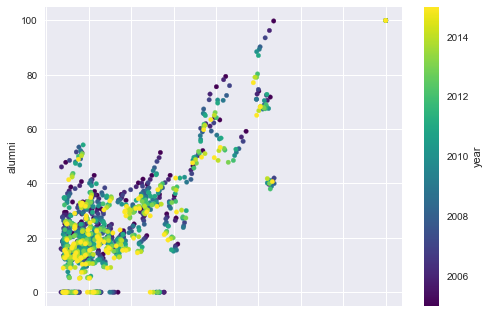
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvc2hhbmdoYWlEYXRhLmNzdlwiLCJzYW1wbGUiOiIjIFBsb3QgYSBzY2F0dGVycGxvdCB3aXRoIGB0b3RhbF9zY29yZWAgYW5kIGBhbHVtbmlgXG5zaGFuZ2hhaV9kZi5wbG90LnNjYXR0ZXIoJ3RvdGFsX3Njb3JlJywgJ2FsdW1uaScsIGM9J3llYXInLCBjb2xvcm1hcD0ndmlyaWRpcycpXG5cbnBsdC5zaG93KCkifQ==

scatter plot

Ce nuage de points montre immédiatement des valeurs 0 dans la colonne alumni. À garder à l’esprit lors de l’exploration : grâce au data profiling, vous identifierez ces 0 et saurez les traiter. Pour en savoir plus, consultez le tutoriel sur le data profiling de DataCamp.

Si certaines valeurs n’ont pas leur place dans le jeu, remplacez‑les par NaN, puis supprimez les lignes NaN des colonnes qui compliquent la visualisation. Notez que c’est une correction rapide ; un profilage plus poussé sera souvent nécessaire. Vous verrez par exemple encore des 0 pour num_students dans le graphique ci‑dessous :
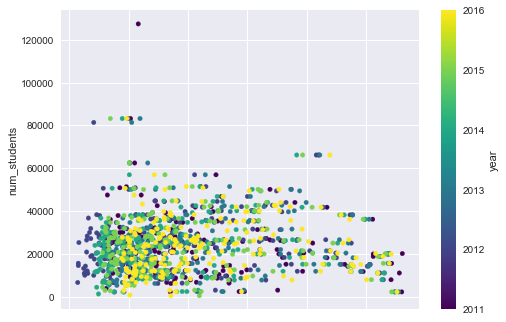
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJlcGxhY2UgYC1gIGVudHJpZXMgd2l0aCBOYU4gdmFsdWVzXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG5cbiMgRHJvcCBhbGwgcm93cyB3aXRoIE5hTiB2YWx1ZXMgZm9yIGBudW1fc3R1ZGVudHNgIFxudGltZXNfZGYgPSB0aW1lc19kZi5kcm9wbmEoc3Vic2V0PVsnbnVtX3N0dWRlbnRzJ10sIGhvdz0nYWxsJylcblxuIyBDYXN0IHRoZSByZW1haW5pbmcgcm93cyB3aXRoIGBudW1fc3R1ZGVudHNgIGFzIGludFxudGltZXNfZGZbJ251bV9zdHVkZW50cyddID0gdGltZXNfZGZbJ251bV9zdHVkZW50cyddLmFzdHlwZSgnaW50JylcblxuIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgbnVtX3N0dWRlbnRzYFxudGltZXNfZGYucGxvdC5zY2F0dGVyKCd0b3RhbF9zY29yZScsICdudW1fc3R1ZGVudHMnLCBjPSd5ZWFyJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

Vous n’êtes pas limité à Matplotlib. D’autres bibliothèques permettent aussi de visualiser rapidement, comme Seaborn.

Seaborn sert surtout à créer des graphiques statistiques esthétiques (comme indiqué sur le site officiel). Avant Matplotlib 2.0, produire de beaux graphiques était plus laborieux.

Combiné à Pandas, Seaborn permet d’itérer rapidement sur vos données via la visualisation.

Voyons quelques exemples !

Observez le graphique suivant : on y compte le nombre d’occurrences par pays, on ne garde que les dix premiers, puis on trace un diagramme en barres trié du plus élevé au plus faible :
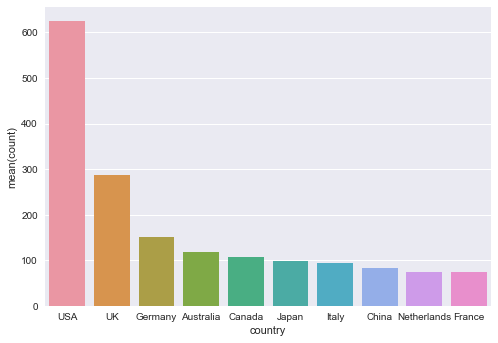
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbWF0cGxvdGxpYi5weXBsb3QgYXMgcGx0XG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpIiwic2FtcGxlIjoiIyBBYmJyZXZpYXRlIGNvdW50cnkgbmFtZXMgb2YgVW5pdGVkIFN0YXRlcyBhbmQgVW5pdGVkIEtpbmdkb21cbnRpbWVzX2RmWydjb3VudHJ5J10gPSB0aW1lc19kZlsnY291bnRyeSddLnJlcGxhY2UoXCJVbml0ZWQgU3RhdGVzIG9mIEFtZXJpY2FcIiwgXCJVU0FcIikucmVwbGFjZShcIlVuaXRlZCBLaW5nZG9tXCIsIFwiVUtcIilcblxuIyBDb3VudCB0aGUgZnJlcXVlbmN5IG9mIGNvdW50cmllcyBcbmNvdW50ID0gdGltZXNfZGZbJ2NvdW50cnknXS52YWx1ZV9jb3VudHMoKVs6MTBdXG5cbiMgQ29udmVydCB0aGUgdG9wIDEwIGNvdW50cmllcyB0byBhIERhdGFGcmFtZSBcbmRmID0gY291bnQudG9fZnJhbWUoKVxuXG4jIFJlc2V0IHRoZSBpbmRleCBcbmRmLnJlc2V0X2luZGV4KGxldmVsPTAsIGluZmxhY2U9VHJ1ZSlcblxuIyBSZW5hbWUgdGhlIGNvbHVtbnNcbmRmLmNvbHVtbnMgPSBbJ2NvdW50cnknLCAnY291bnQnXVxuXG4jIFBsb3QgYSBiYXJwbG90IHdpdGggYGNvdW50cnlgIGFuZCBgY291bnRgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0nY291bnQnLCBkYXRhPWRmKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

bar plot

Puis tracez ces pays avec leur score moyen :
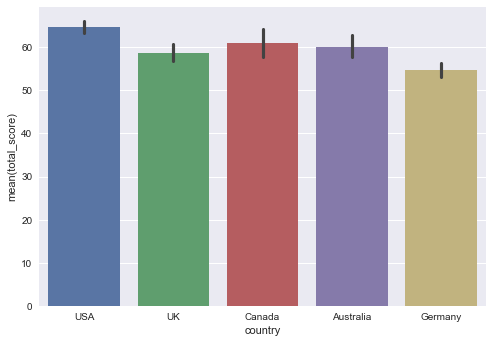
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdCBcbmltcG9ydCBzZWFib3JuIGFzIHNuc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3ZcIiwgdGhvdXNhbmRzPVwiLFwiKVxudGltZXNfZGZbJ2NvdW50cnknXSA9IHRpbWVzX2RmWydjb3VudHJ5J10ucmVwbGFjZShcIlVuaXRlZCBTdGF0ZXMgb2YgQW1lcmljYVwiLCBcIlVTQVwiKS5yZXBsYWNlKFwiVW5pdGVkIEtpbmdkb21cIiwgXCJVS1wiKVxudGltZXNfZGZbJ3RvdGFsX3Njb3JlJ109IHRpbWVzX2RmWyd0b3RhbF9zY29yZSddLnJlcGxhY2UoXCItXCIsIFwiTmFOXCIpLmFzdHlwZSgnZmxvYXQnKVxudGltZXNfZGZfZmlsdGVyZWQ9IHRpbWVzX2RmLnF1ZXJ5KCdjb3VudHJ5ID09XCJVU0FcIiBvciBjb3VudHJ5PT1cIkNhbmFkYVwiIG9yIGNvdW50cnkgPT1cIlVLXCIgb3IgY291bnRyeT09XCJHZXJtYW55XCIgb3IgY291bnRyeT09XCJBdXN0cmFsaWFcIicpIiwic2FtcGxlIjoiIyBCYXJwbG90IHdpdGggYGNvdW50cnlgIGFuZCBgdG90YWxfc2NvcmVgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0ndG90YWxfc2NvcmUnLCBkYXRhPXRpbWVzX2RmX2ZpbHRlcmVkKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

plot

Vos graphiques peuvent aussi devenir plus complexes. Par exemple, ce pairplot met en évidence les relations par paires dans un jeu de données :

import numpy as np

np.seterr(invalid='ignore')

sns.pairplot(times_df, hue='country')

plt.show()
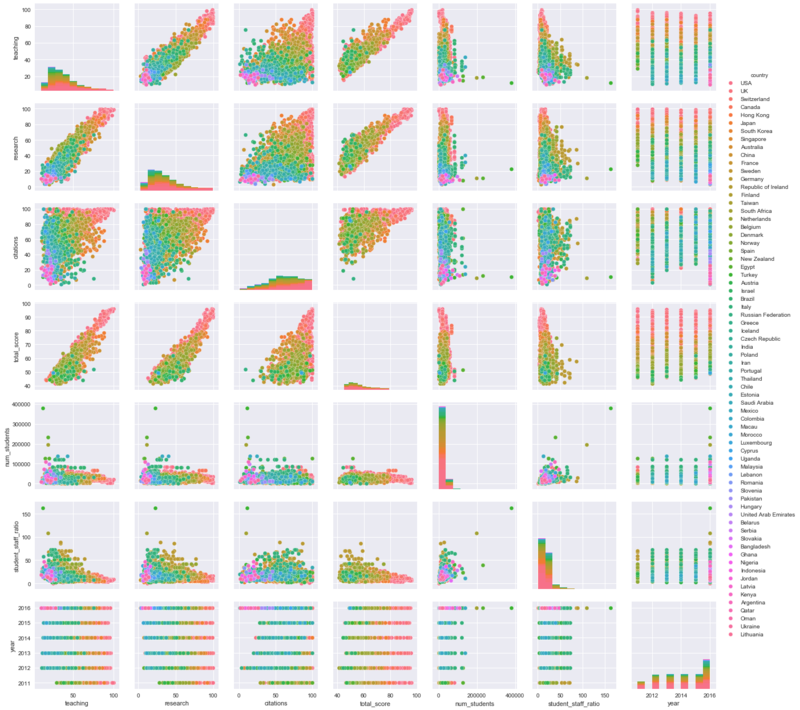
plots

De même, voici une combinaison de FacetGrid et regplot qui illustre l’évolution de total_score au fil des ans pour les 5 pays en tête :
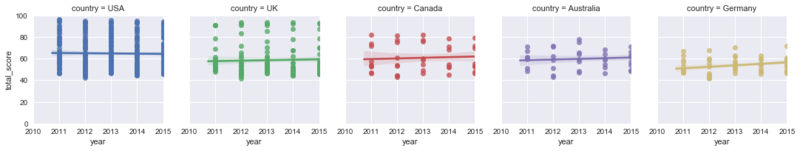
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgcGFuZGFzIGFzIHBkXG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsnY291bnRyeSddID0gdGltZXNfZGZbJ2NvdW50cnknXS5yZXBsYWNlKFwiVW5pdGVkIFN0YXRlcyBvZiBBbWVyaWNhXCIsIFwiVVNBXCIpLnJlcGxhY2UoXCJVbml0ZWQgS2luZ2RvbVwiLCBcIlVLXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG50aW1lc19kZl9maWx0ZXJlZD0gdGltZXNfZGYucXVlcnkoJ2NvdW50cnkgPT1cIlVTQVwiIG9yIGNvdW50cnk9PVwiQ2FuYWRhXCIgb3IgY291bnRyeSA9PVwiVUtcIiBvciBjb3VudHJ5PT1cIkdlcm1hbnlcIiBvciBjb3VudHJ5PT1cIkF1c3RyYWxpYVwiJykiLCJzYW1wbGUiOiIjIEZpbHRlciBvdXQgcm93cyB3aXRoIE5hTiBlbnRyeSBmb3IgYHRvdGFsX3Njb3JlYFxudGltZXNfZGZfZmlsdGVyZWQgPSB0aW1lc19kZl9maWx0ZXJlZC5kcm9wbmEoc3Vic2V0PVsndG90YWxfc2NvcmUnXSwgaG93PSdhbGwnKVxuXG5nID0gc25zLkZhY2V0R3JpZCh0aW1lc19kZl9maWx0ZXJlZCwgY29sPSdjb3VudHJ5JywgaHVlPSdjb3VudHJ5JylcbmcubWFwKHNucy5yZWdwbG90LCAneWVhcicsICd0b3RhbF9zY29yZScpLnNldCh4bGltPSgyMDEwLCAyMDE1KSwgeWxpbT0oMCwxMDApKVxuZy5maWcuc3VicGxvdHNfYWRqdXN0KHdzcGFjZT0uMikifQ==

idiomatic pandas tutorial

Enfin, une carte de corrélations est souvent utile en exploration. Utilisez la fonction heatmap() de Seaborn :
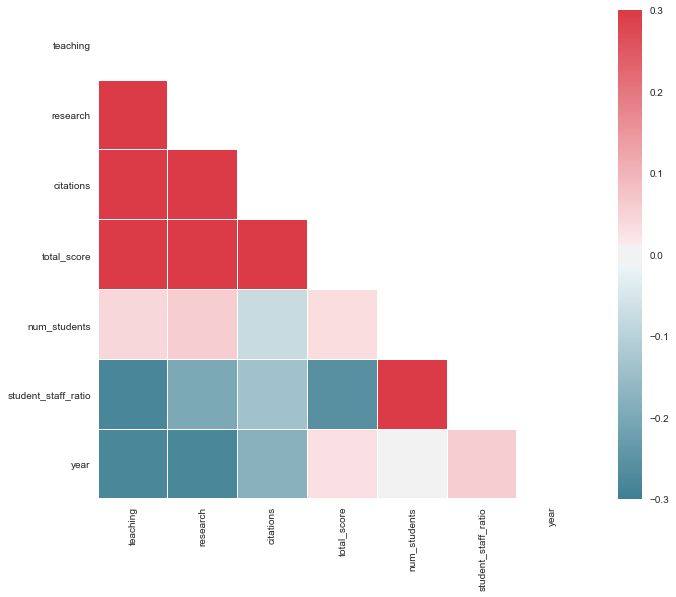
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbnVtcHkgYXMgbnBcbmltcG9ydCBwYW5kYXMgYXMgcGRcbnRpbWVzX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3YnLCB0aG91c2FuZHM9XCIsXCIpIiwic2FtcGxlIjoiaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuXG5zbnMuc2V0KHN0eWxlPVwid2hpdGVcIilcblxuIyBDb21wdXRlIHRoZSBjb3JyZWxhdGlvbiBtYXRyaXhcbmNvcnIgPSB0aW1lc19kZi5jb3JyKClcblxuIyBHZW5lcmF0ZSBhIG1hc2sgZm9yIHRoZSB1cHBlciB0cmlhbmdsZVxubWFzayA9IG5wLnplcm9zX2xpa2UoY29yciwgZHR5cGU9bnAuYm9vbClcbm1hc2tbbnAudHJpdV9pbmRpY2VzX2Zyb20obWFzayldID0gVHJ1ZVxuXG4jIFNldCB1cCB0aGUgbWF0cGxvdGxpYiBmaWd1cmVcbmYsIGF4ID0gcGx0LnN1YnBsb3RzKGZpZ3NpemU9KDExLCA5KSlcblxuIyBHZW5lcmF0ZSBhIGN1c3RvbSBkaXZlcmdpbmcgY29sb3JtYXBcbmNtYXAgPSBzbnMuZGl2ZXJnaW5nX3BhbGV0dGUoMjIwLCAxMCwgYXNfY21hcD1UcnVlKVxuXG4jIERyYXcgdGhlIGhlYXRtYXAgd2l0aCB0aGUgbWFzayBhbmQgY29ycmVjdCBhc3BlY3QgcmF0aW9cbnNucy5oZWF0bWFwKGNvcnIsIG1hc2s9bWFzaywgY21hcD1jbWFwLCB2bWF4PS4zLFxuICAgICAgICAgICAgc3F1YXJlPVRydWUsIGxpbmV3aWR0aHM9LjUsIGF4PWF4KVxuICAgICAgICAgICAgXG5wbHQuc2hvdygpIn0=

chart

Vous pouvez continuer avec ces visualisations, mais il est peut‑être temps de s’arrêter :)

Étapes suivantes

C’est tout pour cette fois. J’espère que vous avez apprécié ces techniques intermédiaires avec Pandas, et plus particulièrement comment écrire un code plus idiomatique.

Si ce tutoriel vous a plu et que vous souhaitez approfondir les performances dans Pandas, je vous recommande vivement les ressources suivantes :

Sujets
Python
Science des données

Cours Pandas

Cours

Python intermédiaire

4 h
1.4M
Mettez à niveau vos compétences en science des données en créant des visualisations à l'aide de Matplotlib et en manipulant des DataFrame avec pandas.
Afficher les détailsRight Arrow
Commencer Le Cours
Voir plusRight Arrow