Vai al contenuto principale

5 consigli per scrivere codice Pandas idiomatico

Questo tutorial copre 5 modi con cui puoi scrivere facilmente codice più pandorable o idiomatico in Pandas.
Aggiornato 29 set 2026  · 14 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Pandas è la toolbox de facto per i data scientist Python per semplificare l’analisi dei dati: puoi usarla, per esempio, prima di iniziare l’analisi, per raccogliere, esplorare e formattare i dati. Pandas rende queste fasi semplicissime grazie alle sue numerose funzioni di I/O e di manipolazione dei dati. Inoltre, come imparerai più avanti in questo tutorial, offre anche alcune capacità di visualizzazione (tramite l’uso di matplotlib).

Anche se le strutture dati di Pandas sono molto potenti e flessibili, presentano anche alcune complessità che possono rendere l’analisi più difficile che facile, soprattutto per chi è alle prime armi. In questo tutorial ti concentrerai su come risparmiarti grattacapi e scrivere codice Pandas più idiomatico. Oltre a imparare a caricare, esplorare e ripulire i dati, approfondirai i seguenti cinque argomenti:

Ovviamente, questo tutorial non è affatto esaustivo; Il pacchetto Pandas è molto ricco e, senza dubbio, esistono altri modi per migliorare il tuo codice Pandas affinché diventi più idiomatico.

Non aspettiamo oltre e iniziamo!

Primo passo: caricare ed esplorare i dati

Come sempre, la tua analisi dei dati inizia con il caricamento e l’esplorazione. Questa sezione è solo un riscaldamento in cui userai la funzione read_csv() per caricare le classifiche universitarie mondiali, dopodiché potrai già esplorare rapidamente i dati con le funzioni head() e describe(). Se ti interessa un’introduzione completa a Pandas, valuta il corso in tre parti di DataCamp su Pandas, a partire da Pandas Foundations.

Se tutto questo lo sai già, puoi semplicemente saltare questa sezione e vedere come eseguire l’indicizzazione con Pandas in modo più idiomatico.

Importare i pacchetti

Per iniziare, importiamo i consueti pacchetti Python per la data science. Come avrai immaginato, tra questi c’è Pandas.

# If you're working with a notebook, don't forget to use Matplotlib magic! 
%matplotlib inline

# Import pandas under the alias pd import pandas as pd # Import seaborn under the alias sns import seaborn as sns # Set the Seaborn theme if desired sns.set_style('darkgrid')

Inoltre, puoi usare anche il pacchetto watermark: è uno strumento utile che rende il tuo notebook più riproducibile. Il lavoro riproducibile è molto importante quando collabori con colleghi. Anche il tuo “io futuro” te ne sarà grato! Puoi leggere di più sulla data science riproducibile qui.

I dati

Per iniziare questo tutorial, ti serviranno anche dei dati “reali”. In questo tutorial lavorerai con un dataset da Kaggle. Se non conosci Kaggle, è una delle più grandi community di data science e machine learning. Inoltre, è un buon posto per approfondire la data science una volta apprese le basi.

Il dataset che userai è il World University Rankings.

Come accennato sopra, Pandas ha molti metodi comodi per leggere dati da diverse fonti (puoi saperne di più qui). Poiché i dati sono in formato CSV, useremo il metodo .read_csv. Ma prima di iniziare, devi scaricare i dati da Kaggle (oppure recuperarli dal repository del codice nella cartella data se non vuoi creare un account).

Una volta scaricati i dati, dovresti avere una cartella data che contiene i diversi file csv.

Successivamente, lavorerai con i dati della classifica Times Higher Education World University Rankings (in breve Times) e della Academic Ranking of World Universities (in breve Shanghai). C’è anche un terzo sistema di ranking nella cartella data, CWUR, ma è molto meno noto, quindi per ora puoi tranquillamente ignorarlo.

# Import Times Higher Education World University Rankings data
times_df = pd.read_csv('data/timesData.csv', thousands=",")

# Import Academic Ranking of World Universities data
shanghai_df = pd.read_csv('data/shanghaiData.csv')

Ispezionare rapidamente i dati

Come hai imparato nel tutorial di DataCamp sull’analisi esplorativa dei dati, Pandas offre alcuni metodi per ispezionare velocemente i DataFrame, nello specifico .head() per vedere le prime n righe (n è 5 per impostazione predefinita) e .describe() per ottenere un rapido riassunto statistico.

Ripassa queste funzioni eseguendo le seguenti righe di codice. I dati sono già stati caricati per te nelle variabili times_df e shanghai_df:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBSZXR1cm4gdGhlIGZpcnN0IHJvd3Mgb2YgYHRpbWVzX2RmYFxudGltZXNfZGYuX19fXygpXG5cbiMgRGVzY3JpYmUgYHRpbWVzX2RmYFxudGltZXNfZGYuZGVzY3JpYmUoKVxuXG4jIFJldHVybiB0aGUgZmlyc3Qgcm93cyBvZiBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5oZWFkKClcblxuIyBEZXNjcmliZSBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5fX19fX19fXygpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uKFwidGltZXNfZGYuaGVhZFwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwidGltZXNfZGYuZGVzY3JpYmVcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInNoYW5naGFpX2RmLmhlYWRcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInNoYW5naGFpX2RmLmRlc2NyaWJlXCIpXG5zdWNjZXNzX21zZyhcIllvdSdyZSBvZmYgdG8gYSBncmVhdCBzdGFydCFcIikifQ==

Ora che hai caricato i dati, puoi iniziare a pensare a come manipolarli con Pandas in modo idiomatico!

I nostri consigli per codice Pandas idiomatico

1. Indicizzazione

Per cominciare, scrivere codice Pandas più idiomatico significa sfruttare la potenza dell’indicizzazione. Indicizzare vuol dire selezionare sottoinsiemi dal tuo DataFrame.

Quando inizi a usare Pandas, potresti aver bisogno di un po’ di tempo per abituarti al funzionamento degli indici. Infatti, se hai già lavorato con le liste (Python), potresti già conoscere l’uso delle parentesi quadre [] in combinazione con i due punti : per selezionare elementi. Questo metodo funziona sui DataFrame.

In aggiunta, ci sono altri due modi, più idiomatici, per selezionare un sottoinsieme di DataFrame: iloc e loc:

  • loc è basato sulle etichette. Significa che se scrivi loc[2], stai cercando i valori del tuo DataFrame con indice etichettato 2.
  • iloc è basato sulla posizione. Significa che se scrivi iloc[2], stai cercando i valori del tuo DataFrame che si trovano alla posizione di indice 2.

Provalo nel blocco DataCamp Light qui sotto digitando times_df.loc[2] e times_df.iloc[2] nella console IPython per vedere la differenza. Poi prova a risolvere l’esercizio qui sotto con l’aiuto di loc, iloc e delle tradizionali parentesi quadre!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJldHJpZXZlIHRoZSB0b3RhbCBzY29yZSBvZiB0aGUgZmlyc3Qgcm93XG5wcmludCh0aW1lc19kZi5sb2NbMCwgJ19fX19fX19fX19fJ10pXG5cbiMgUmV0cmlldmUgcm93cyAwIGFuZCAxXG5wcmludCh0aW1lc19kZltfOl9dKVxuXG4jIFJldHJpZXZlIHRoZSB2YWx1ZXMgYXQgY29sdW1ucyBhbmQgcm93cyAxLTNcbnByaW50KHRpbWVzX2RmLmlsb2NbMTo0LDE6NF0pXG5cbiMgUmV0cmlldmUgdGhlIGNvbHVtbiBgdG90YWxfc2NvcmVgIFxucHJpbnQodGltZXNfZGZbJ19fX19fX19fX18nXSkiLCJzb2x1dGlvbiI6IiMgUmV0cmlldmUgdGhlIHRvdGFsIHNjb3JlIG9mIHRoZSBmaXJzdCByb3dcbnByaW50KHRpbWVzX2RmLmxvY1swLCAndG90YWxfc2NvcmUnXSlcblxuIyBSZXRyaWV2ZSByb3dzIDAgYW5kIDFcbnByaW50KHRpbWVzX2RmWzA6Ml0pXG5cbiMgUmV0cmlldmUgdGhlIHZhbHVlcyBhdCBjb2x1bW5zIGFuZCByb3dzIDEtM1xucHJpbnQodGltZXNfZGYuaWxvY1sxOjQsMTo0XSlcblxuIyBSZXRyaWV2ZSB0aGUgY29sdW1uIGB0b3RhbF9zY29yZWAgXG5wcmludCh0aW1lc19kZlsndG90YWxfc2NvcmUnXSkiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0xKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTMpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD00KVxuc3VjY2Vzc19tc2coXCJBd2Vzb21lISBZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgc3Vic2V0dGVkIHlvdXIgZGF0YSB3aXRoIGBsb2NgIGFuZCBgaWxvY2AuXCIpIn0=

Ovviamente, l’esplorazione può andare ben oltre il semplice sottoinsieme o la selezione di righe e colonne dei dati. Le cose diventano molto interessanti quando combini loc e iloc con, per esempio, array booleani.

Vedi che questo va un po’ oltre la selezione dei dati in base a colonne o indici; È un po’ come interrogare i tuoi dati!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3ZcIikiLCJzYW1wbGUiOiIjIEFyZSB0aGUgbGFzdCBlbnRyaWVzIGFmdGVyIDIwMDY/XG5wcmludChzaGFuZ2hhaV9kZi5sb2NbOi0xMCwgJ3llYXInXSA+IDIwMDYpXG5cbiMgV2FzIHRoZSBhbHVtbmkgY291bnQgaGlnaGVyIHRoYW4gOTAgZm9yIHRoZSBmaXJzdCAgdGVuIHVuaXZlcnNpdGllcz9cbnByaW50KHNoYW5naGFpX2RmLmxvY1swOjExLCAnYWx1bW5pJ10gPiA5MCkiLCJzb2x1dGlvbiI6IiMgQXJlIHRoZSBsYXN0IGVudHJpZXMgYWZ0ZXIgMjAwNj9cbnByaW50KHNoYW5naGFpX2RmLmxvY1s6LTEwLCAneWVhciddID4gMjAwNilcblxuIyBXYXMgdGhlIGFsdW1uaSBjb3VudCBoaWdoZXIgdGhhbiA5MCBmb3IgdGhlIGZpcnN0ICB0ZW4gdW5pdmVyc2l0aWVzP1xucHJpbnQoc2hhbmdoYWlfZGYubG9jWzA6MTEsICdhbHVtbmknXSA+IDkwKSIsInNjdCI6IkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTEpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgcXVlcmllZCB5b3VyIGRhdGEgd2l0aCBgbG9jYCFcIikifQ==

loc e iloc sono ottimi per indicizzare i dati, ma fai attenzione quando inizi a usare due coppie di parentesi quadre una dopo l’altra! Pandas potrebbe restituire una copia di una vista e, in tali casi, non sapresti più con cosa stai lavorando! Quindi pensaci due volte se stai usando due coppie di parentesi quadre in combinazione con loc o iloc.

Nota anche che, per interrogare i dati, Pandas mette a disposizione la funzione query() che puoi usare per ispezionarli rapidamente (disponibile dalla versione 0.13). Per esempio, puoi comporre una query per vedere quali università hanno un total_score leggermente inferiore a 50:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmdlX3NjaG9vbHMgPSBzaGFuZ2hhaV9kZi5xdWVyeSgndG90YWxfc2NvcmUgPiBfXyBhbmQgdG90YWxfc2NvcmUgPCBfXycpXG5cbiMgUHJpbnQgdGhlIHJlc3VsdFxucHJpbnQoYXZlcmFnZV9zY2hvb2xzKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmFnZV9zY2hvb2xzID0gc2hhbmdoYWlfZGYucXVlcnkoJ3RvdGFsX3Njb3JlID4gNDAgYW5kIHRvdGFsX3Njb3JlIDwgNTAnKVxuXG4jIFByaW50IHRoZSByZXN1bHRcbnByaW50KGF2ZXJhZ2Vfc2Nob29scykiLCJzY3QiOiJFeCgpLnRlc3Rfb2JqZWN0KFwiYXZlcmFnZV9zY2hvb2xzXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmEhXCIpIn0=

Ovviamente, ci sono molte altre possibilità quando si tratta di interrogare i tuoi dati! Perché non provare a inventare qualche query e testarle nella console IPython del blocco DataCamp Light qui sopra?

Se ti manca l’ispirazione, prova query che restituiscono le università con primo posto nel ranking nazionale e nel ranking mondiale. Inoltre, puoi interrogare i numeri degli alumni delle università.

Non sai come comporre le query? Dai un’occhiata ad alcuni esempi qui sotto:

shanghai_df.query("national_rank == 1 and world_rank == 1")
shanghai_df.query("alumni < 20")

2. Method chaining

Il method chaining è qualcosa di tipico di Pandas, ma quando inizi a usare il pacchetto Python per la manipolazione dei dati, potrebbe non essere immediato capire come funziona esattamente. In pratica, si tratta di chiamare metodi su un oggetto uno dopo l’altro.

In questa sezione, approfondirai il method chaining creando pipeline di dati con pipe().

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6IiMgRXh0cmFjdCBpbmZvXG5kZWYgZXh0cmFjdF9pbmZvKGlucHV0X2RmLCBuYW1lKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGluZm9fZGYgPSBwZC5EYXRhRnJhbWUoeyduYl9yb3dzJzogZGYuc2hhcGVbMF0sICduYl9jb2xzJzogZGYuc2hhcGVbMV0sICduYW1lJzogbmFtZX0sIGluZGV4PXJhbmdlKDEpKVxuICAgIHJldHVybiBpbmZvX2RmXG5cbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNvbHV0aW9uIjoiIyBFeHRyYWN0IGluZm9cbmRlZiBleHRyYWN0X2luZm8oaW5wdXRfZGYsIG5hbWUpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgaW5mb19kZiA9IHBkLkRhdGFGcmFtZSh7J25iX3Jvd3MnOiBkZi5zaGFwZVswXSwgJ25iX2NvbHMnOiBkZi5zaGFwZVsxXSwgJ25hbWUnOiBuYW1lfSwgaW5kZXg9cmFuZ2UoMSkpXG4gICAgcmV0dXJuIGluZm9fZGZcbiBcbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNjdCI6ImZ1bl9kZWYgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImV4dHJhY3RfaW5mb1wiKS5tdWx0aShjaGVja19hcmdzKCdpbnB1dF9kZicpLCBjaGVja19hcmdzKCduYW1lJykpXG5mdW5fZGVmLmNoZWNrX2JvZHkoKVxuZnVuX2RlZi5jYWxsKFwiZih0aW1lc19kZiwgJ3RpbWVzJylcIilcbmZ1bl9kZWYuY2FsbChcImYoc2hhbmdoYWlfZGYsICdzaGFuZ2hhaScpXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwiYWxsX2luZm9cIilcbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Come avrai già notato, i dataset sono piuttosto diversi. Ecco alcune differenze:

  • Il dataset Times ha 14 colonne mentre quello di Shanghai ne ha 11
  • Il dataset Times ha 2603 righe mentre quello di Shanghai ne ha 4897
  • Una colonna importante mancante nel dataset Shanghai è il paese dell’università. Se necessario, recupererai questa informazione dal dataset Times più avanti.

Quindi, per usare entrambi i DataFrame, dovremo selezionare solo le colonne comuni. Si spera che queste colonne comuni abbiano contenuti simili.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6ImNvbW1vbl9jb2x1bW5zID0gc2V0KHNoYW5naGFpX2RmLmNvbHVtbnMpICYgc2V0KHRpbWVzX2RmLmNvbHVtbnMpXG5cbiMgUmV0dXJuIGBjb21tb25fY29sdW1uc2BcbnByaW50KGNvbW1vbl9jb2x1bW5zKSIsInNvbHV0aW9uIjoiY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcblxuIyBSZXR1cm4gYGNvbW1vbl9jb2x1bW5zYFxucHJpbnQoY29tbW9uX2NvbHVtbnMpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcImNvbW1vbl9jb2x1bW5zXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKSJ9

Le colonne comuni sono quindi:

  • total_score: punteggio usato per determinare il rank. Come indicato nella pagina di descrizione su Kaggle, contiene range di rank (cioè compresi tra due valori) e rank uguali (c’è un segno = davanti)
  • university_name: nome dell’università
  • world_rank: posizionamento dell’università
  • year: anno a cui si riferisce la classifica

Per concatenare entrambi i dati, dobbiamo prima fare un po’ di pulizia. Quindi applica ora l’intera pipeline per ripulire i dati:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucykiLCJzYW1wbGUiOiIjIENsZWFuIHVwIHRoZSBgd29ybGRfcmFua2AgXG5kZWYgY2xlYW5fd29ybGRfcmFuayhpbnB1dF9kZik6XG4gICAgZGYgPSBpbnB1dF9kZi5jb3B5KClcbiAgICBkZi53b3JsZF9yYW5rID0gZGYud29ybGRfcmFuay5zdHIuc3BsaXQoJy0nKS5zdHJbMF0uc3RyLnNwbGl0KCc9Jykuc3RyWzBdXG4gICAgcmV0dXJuIGRmXG4gICAgXG4jIEFzc2lnbiB0aGUgY29tbW9uIHllYXJzIG9mIGBzaGFuZ2hhaV9kZmAgYW5kIGB0aW1lc19kZmAgdG8gYGNvbW1vbl95ZWFyc2AgICAgXG5jb21tb25feWVhcnMgPSBzZXQoc2hhbmdoYWlfZGYueWVhcikgJiBzZXQodGltZXNfZGYueWVhcikgXG5cbiMgUHJpbnQgYGNvbW1vbl95ZWFyc2BcbnByaW50KGNvbW1vbl95ZWFycylcblxuIyBGaWx0ZXIgeWVhcnNcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuXG4jIENsZWFuIGB0aW1lc19kZmAgYW5kIGBzaGFuZ2hhaV9kZmBcbmNsZWFuZWRfdGltZXNfZGYgPSAodGltZXNfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3RpbWVzJykpXG5jbGVhbmVkX3NoYW5naGFpX2RmID0gKHNoYW5naGFpX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmspXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLmFzc2lnbihuYW1lPSdzaGFuZ2hhaScpKSIsInNvbHV0aW9uIjoiIyBDbGVhbiB1cCB0aGUgYHdvcmxkX3JhbmtgIFxuZGVmIGNsZWFuX3dvcmxkX3JhbmsoaW5wdXRfZGYpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgZGYud29ybGRfcmFuayA9IGRmLndvcmxkX3Jhbmsuc3RyLnNwbGl0KCctJykuc3RyWzBdLnN0ci5zcGxpdCgnPScpLnN0clswXVxuICAgIHJldHVybiBkZlxuICAgIFxuIyBBc3NpZ24gdGhlIGNvbW1vbiB5ZWFycyBvZiBgc2hhbmdoYWlfZGZgIGFuZCBgdGltZXNfZGZgIHRvIGBjb21tb25feWVhcnNgICAgIFxuY29tbW9uX3llYXJzID0gc2V0KHNoYW5naGFpX2RmLnllYXIpICYgc2V0KHRpbWVzX2RmLnllYXIpIFxuXG4jIFByaW50IGBjb21tb25feWVhcnNgXG5wcmludChjb21tb25feWVhcnMpXG5cbiMgRmlsdGVyIHllYXJzXG5kZWYgZmlsdGVyX3llYXIoaW5wdXRfZGYsIHllYXJzKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIHJldHVybiBkZi5xdWVyeSgneWVhciBpbiB7fScuZm9ybWF0KGxpc3QoeWVhcnMpKSlcblxuIyBDbGVhbiBgdGltZXNfZGZgIGFuZCBgc2hhbmdoYWlfZGZgXG5jbGVhbmVkX3RpbWVzX2RmID0gKHRpbWVzX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmspXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLmFzc2lnbihuYW1lPSd0aW1lcycpKVxuY2xlYW5lZF9zaGFuZ2hhaV9kZiA9IChzaGFuZ2hhaV9kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0nc2hhbmdoYWknKSkiLCJzY3QiOiJmdW5fZGVmMSA9IEV4KCkuY2hlY2tfZnVuY3Rpb25fZGVmKFwiZmlsdGVyX3llYXJcIikubXVsdGkoY2hlY2tfYXJncygnaW5wdXRfZGYnKSwgY2hlY2tfYXJncygneWVhcnMnKSlcbmZ1bl9kZWYxLmNoZWNrX2JvZHkoKVxuZnVuX2RlZjEuY2FsbChcImYodGltZXNfZGYsIGNvbW1vbl95ZWFycylcIilcbmZ1bl9kZWYxLmNhbGwoXCJmKHNoYW5naGFpX2RmLCBjb21tb25feWVhcnMpXCIpXG5cbkV4KCkudGVzdF9vYmplY3QoXCJjb21tb25feWVhcnNcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIpXG5cbmZ1bl9kZWYgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImNsZWFuX3dvcmxkX3JhbmtcIilcbmZ1bl9kZWYuY2hlY2tfYm9keSgpXG5mdW5fZGVmLmNhbGwoXCJmKHRpbWVzX2RmKVwiKVxuZnVuX2RlZi5jYWxsKFwiZihzaGFuZ2hhaV9kZilcIilcblxuRXgoKS50ZXN0X29iamVjdChcImNsZWFuZWRfdGltZXNfZGZcIilcbkV4KCkudGVzdF9vYmplY3QoXCJjbGVhbmVkX3NoYW5naGFpX2RmXCIpXG5cbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Come avrai probabilmente notato, uso molto il metodo .pipe in questo tutorial. Se provieni dal mondo R, probabilmente ti è (in qualche modo) familiare.

È un comodo metodo nuovo di Pandas (dalla versione 0.16.2) che ti permette di concatenare operazioni eliminando così la necessità di DataFrame intermedi. Il tuo codice diventa più leggibile.

Infatti, senza questo operatore, invece di scrivere df.pipe(f).pipe(g).pipe(h) scriveresti: h(g(f(df))). Questo diventa più difficile da seguire quando il numero di funzioni annidate cresce.

Per saperne di più sull’argomento, consiglio vivamente di leggere questo post del blog.

Ora che entrambi i DataFrame sono puliti, possiamo concatenarli in un unico DataFrame. Inoltre, non dimenticare di ripulire i dati mancanti:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpIiwic2FtcGxlIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNvbHV0aW9uIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNjdCI6IkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwibWlzc2luZ19kYXRhXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwicmFua2luZ19kZlwiKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgaW1wcm92ZWQgeW91ciBkYXRhIHF1YWxpdHkhXCIpIn0=

Poiché hai circa il 38% di dati mancanti nella colonna total_score, è meglio eliminare questa colonna con il metodo .drop.

3. Ottimizzazione della memoria

Un terzo modo per rendere il tuo codice Pandas più “idiomatico” – che in questo caso equivale più a “performante” – è ottimizzando l’uso della memoria. Soprattutto quando inizi a creare pipeline di dati usando il method chaining, vedrai che la memoria può iniziare a giocare un ruolo importante nella velocità di esecuzione. Vedrai di più su tutto questo qui.

Probabilmente è eccessivo per questo piccolo dataset, ma spesso è una buona pratica convertire alcune colonne in tipi specifici per ottimizzare l’uso della memoria. Per iniziare, vediamo quanta memoria è allocata per ranking_df usando il metodo .info.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBQcmludCB0aGUgbWVtb3J5IHVzYWdlIG9mIGByYW5raW5nX2RmYCBcbnJhbmtpbmdfZGYuX19fXygpXG5cbiMgUHJpbnQgdGhlIGRlZXAgbWVtb3J5IHVzYWdlIG9mIGByYW5raW5nX2RmYCBcbnJhbmtpbmdfZGYuaW5mbyhtZW1vcnlfdXNhZ2U9XCJkZWVwXCIpIiwic29sdXRpb24iOiIjIFByaW50IHRoZSBtZW1vcnkgdXNhZ2Ugb2YgYHJhbmtpbmdfZGZgIFxucmFua2luZ19kZi5pbmZvKClcblxuIyBQcmludCB0aGUgZGVlcCBtZW1vcnkgdXNhZ2Ugb2YgYHJhbmtpbmdfZGZgIFxucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT1cImRlZXBcIikiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJyYW5raW5nX2RmLmluZm9cIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJHcmVhdCFcIikifQ==

Il risultato della prima riga di codice ci dice che i dati occupano 144 KB. Tuttavia, ispezionando gli argomenti del metodo .info, si scopre che ne esiste uno opzionale, memory_usage, impostato su None per impostazione predefinita. Cosa succede quando imposti l’argomento memory_usage su deep?

La nuova impronta di memoria è 6 – per la precisione 5,6 – volte più grande della tua risposta iniziale.

Cosa è successo?

La differenza nella stima della memoria deriva dal fatto che, senza il flag “deep” attivato, Pandas non stima il consumo di memoria per il dtype object. Questo tipo (Python) occupa più spazio rispetto ad altri dtypes ottimizzati di numpy. Per questo è consigliato convertire i tipi object in tipi più appropriati (ad esempio category quando si lavora con dati categoriali).

Facciamolo!

def memory_change(input_df, column, dtype):
    df = input_df.copy()
    old = round(df[column].memory_usage(deep=True) / 1024, 2) # In KB
    new = round(df[column].astype(dtype).memory_usage(deep=True) / 1024, 2)# In KB
    change = round(100 * (old - new) / (old), 2)
    report = ("The inital memory footprint for {column} is: {old}KB.\n" 
              "The casted {column} now takes: {new}KB.\n"
              "A change of {change} %.").format(**locals())
    return report

print(memory_change(ranking_df,'world_rank', 'int16'))
print(memory_change(ranking_df,'university_name', 'category'))
print(memory_change(ranking_df,'name', 'category'))

Ora che sai che, cambiando per esempio world_rank in int16, la tua memoria verrà usata in modo più efficiente, è il momento di applicare davvero queste modifiche. Puoi usare la funzione astype() per farlo. Concludi ricontrollando come appare ora l’uso della memoria:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBDYXN0IGB3b3JsZF9yYW5rYCBhcyB0eXBlIGBpbnQxNmBcbnJhbmtpbmdfZGYud29ybGRfcmFuayA9IHJhbmtpbmdfZGYud29ybGRfcmFuay5fX19fX19fKCdpbnQxNicpXG5cbiMgQ2FzdCBgdW52ZXJzaXR5X25hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi51bml2ZXJzaXR5X25hbWUgPSByYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZS5hc3R5cGUoJ2NhdGVnb3J5JylcblxuIyBDYXN0IGBuYW1lYCBhcyB0eXBlIGBjYXRlZ29yeWBcbnJhbmtpbmdfZGYubmFtZSA9IHJhbmtpbmdfZGYuX19fXy5hc3R5cGUoJ2NhdGVnb3J5JylcblxuIyBEb3VibGUgY2hlY2sgdGhlIG1lbW9yeSB1c2FnZSBhZnRlciB0eXBlIGNhc3RpbmdcbnJhbmtpbmdfZGYuaW5mbyhtZW1vcnlfdXNhZ2U9J2RlZXAnKSIsInNvbHV0aW9uIjoiIyBDYXN0IGB3b3JsZF9yYW5rYCBhcyB0eXBlIGBpbnQxNmBcbnJhbmtpbmdfZGYud29ybGRfcmFuayA9IHJhbmtpbmdfZGYud29ybGRfcmFuay5hc3R5cGUoJ2ludDE2JylcblxuIyBDYXN0IGB1bnZlcnNpdHlfbmFtZWAgYXMgdHlwZSBgY2F0ZWdvcnlgXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIENhc3QgYG5hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIERvdWJsZSBjaGVjayB0aGUgbWVtb3J5IHVzYWdlIGFmdGVyIHR5cGUgY2FzdGluZ1xucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT0nZGVlcCcpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcInJhbmtpbmdfZGZcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Molto meglio. Puoi ottimizzare ulteriormente convertendo la colonna year a int32.

4. GroupBy

Ora che abbiamo un dataset ben formato (cioè in uno stato tidy) con un’impronta di memoria ottimizzata, l’analisi dei dati può iniziare.

Ci sono alcune domande a cui potresti voler rispondere:

  • Quali sono le 5 università migliori secondo ciascun sistema di ranking nel corso degli anni?
  • Quanto differiscono queste classifiche per ogni anno?

Scopriamolo affrontando la prima domanda facendo uso dei suggerimenti Pandas più idiomatici che hai già visto nelle sezioni precedenti!

Prima di iniziare, nota che “Massachusetts Institute of Technology (MIT)” e “Massachusetts Institute of Technology” sono due record diversi della stessa università. Quindi, cambia il primo nome con il secondo.

Nota che in casi come questi la funzione loc, che hai visto in precedenza in questo tutorial, torna particolarmente utile!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgUXVlcnkgZm9yIHRoZSByb3dzIHdpdGggdW5pdmVyc2l0eSBuYW1lICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1xucHJpbnQocmFua2luZ19kZi5fX19fXyhcInVuaXZlcnNpdHlfbmFtZSA9PSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSAoTUlUKSdcIikpXG5cbiMgTG9jYWxpemUgdGhlIHJvd3Mgd2l0aCB0aGUgTUlUIHVuaXZlcnNpdHkgbmFtZSBhbmQgcmVwbGFjZSB2YWx1ZSBcbnJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogZGYudW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJywgJ3VuaXZlcnNpdHlfbmFtZSddID0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3knXG5cbiMgUHJpbnQgYHJhbmtpbmdfZGZgXG5wcmludChfX19fX19fX19fKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBmb3IgdGhlIHJvd3Mgd2l0aCB1bml2ZXJzaXR5IG5hbWUgJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknXG5wcmludChyYW5raW5nX2RmLnF1ZXJ5KFwidW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1wiKSlcblxuIyBMb2NhbGl6ZSB0aGUgcm93cyB3aXRoIHRoZSBNSVQgdW5pdmVyc2l0eSBuYW1lIGFuZCByZXBsYWNlIHZhbHVlIFxucmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi51bml2ZXJzaXR5X25hbWUgPT0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknLCAndW5pdmVyc2l0eV9uYW1lJ10gPSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSdcblxuIyBQcmludCBgcmFua2luZ19kZmBcbnByaW50KHJhbmtpbmdfZGYpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Per trovare le 5 (più in generale n) università migliori nel corso degli anni, per ciascun sistema di ranking, ecco come fare in pseudo-codice:

  • Per ogni anno (nella colonna year) e per ogni sistema di ranking (nella colonna name):
  • Seleziona il sottoinsieme di dati per l’anno e il sistema di ranking dati
  • Seleziona le prime 5 università e salvale in una lista
  • Salva il risultato in un dizionario con (year, name) come chiave e la lista delle università (in ordine decrescente) come valore

Applichiamolo.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgTG9hZCBpbiBgaXRlcnRvb2xzYFxuaW1wb3J0IGl0ZXJ0b29sc1xuXG4jIEluaXRpYWxpemUgYHJhbmtpbmdgXG5yYW5raW5nID0ge31cblxuZm9yIHllYXIsIG5hbWUgaW4gaXRlcnRvb2xzLnByb2R1Y3QoY29tbW9uX3llYXJzLCBbXCJ0aW1lc1wiLCBcInNoYW5naGFpXCJdKTpcbiAgICBzID0gKHJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogKChkZi55ZWFyID09IHllYXIpICYgKGRmLm5hbWUgPT0gbmFtZSlcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICYgKGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLDYpKSkpLCA6XVxuICAgICAgICAgICAgICAgICAgIC5zb3J0X3ZhbHVlcygnd29ybGRfcmFuaycsIGFzY2VuZGluZz1GYWxzZSlcbiAgICAgICAgICAgICAgICAgICAudW5pdmVyc2l0eV9uYW1lKVxuICAgIHJhbmtpbmdbKHllYXIsIG5hbWUpXSA9IGxpc3QocylcbiAgICBcblxuIyBQcmludCBgcmFua2luZ2BcbnByaW50KHJhbmtpbmcpIn0=

Ora che abbiamo questo dizionario di ranking, vediamo di quanto (in percentuale) i due metodi di ranking differiscono nel corso degli anni: i due sono simili al 100% come insiemi se le 5 università selezionate sono le stesse, anche se l’ordine non coincide.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IGl0ZXJ0b29sc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZyA9IHt9XG5mb3IgeWVhciwgbmFtZSBpbiBpdGVydG9vbHMucHJvZHVjdChjb21tb25feWVhcnMsIFtcInRpbWVzXCIsIFwic2hhbmdoYWlcIl0pOlxuICAgIHMgPSAocmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiAoKGRmLnllYXIgPT0geWVhcikgJiAoZGYubmFtZSA9PSBuYW1lKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgJiAoZGYud29ybGRfcmFuay5pc2luKHJhbmdlKDEsNikpKSksIDpdXG4gICAgICAgICAgICAgICAgICAgLnNvcnRfdmFsdWVzKCd3b3JsZF9yYW5rJywgYXNjZW5kaW5nPUZhbHNlKVxuICAgICAgICAgICAgICAgICAgIC51bml2ZXJzaXR5X25hbWUpXG4gICAgcmFua2luZ1soeWVhciwgbmFtZSldID0gbGlzdChzKSIsInNhbXBsZSI6IiMgSW1wb3J0IGBkZWZhdWx0ZGljdGBcbmZyb20gY29sbGVjdGlvbnMgaW1wb3J0IGRlZmF1bHRkaWN0XG5cbiMgSW5pdGlhbGl6ZSBgY29tcGFyZWBcbmNvbXBhcmUgPSBkZWZhdWx0ZGljdChsaXN0KVxuXG4jIEluaXRpYWxpemUgYGV4YWN0X3NpbWlsYXJpdHlgIGFuZCBgc2V0X3NpbWlsYXJpdHlgXG5leGFjdF9zaW1pbGFyaXR5ID0ge31cbnNldF9zaW1pbGFyaXR5ID0ge31cblxuZm9yICh5ZWFyLCBtZXRob2QpLCB1bml2ZXJzaXRpZXMgaW4gcmFua2luZy5pdGVtcygpOlxuICAgIGNvbXBhcmVbeWVhcl0uYXBwZW5kKHVuaXZlcnNpdGllcylcbiAgICBcbmZvciB5ZWFyLCByYW5rcyBpbiBjb21wYXJlLml0ZW1zKCk6XG4gICAgc2V0X3NpbWlsYXJpdHlbeWVhcl0gPSAxMDAgKiBsZW4oc2V0KHJhbmtzWzBdKSAmIHNldChyYW5rc1sxXSkpIC8gNS4wXG5cbiMgUHJpbnQgYHNldF9zaW1pbGFyaXR5YCAgXG5wcmludChzZXRfc2ltaWxhcml0eSkifQ==

Come avrai notato, è stato laborioso. Esiste un modo migliore, più idiomatico in Pandas?

Certo! Per prima cosa, filtra il DataFrame di ranking per tenere solo le prime 5 università per ciascun anno e metodo di ranking. Controlla anche il risultato con l’aiuto della funzione head():

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgQ29uc3RydWN0IGEgRGF0YUZyYW1lIHdpdGggdGhlIHRvcCA1IHVuaXZlcnNpdGllcyBcbnRvcF81X2RmID0gcmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi53b3JsZF9yYW5rLmlzaW4ocmFuZ2UoMSwgNikpLCA6XVxuXG4jIFByaW50IHRoZSBmaXJzdCByb3dzIG9mIGB0b3BfNV9kZmBcbnRvcF81X2RmLl9fX18oKSIsInNvbHV0aW9uIjoiIyBDb25zdHJ1Y3QgYSBEYXRhRnJhbWUgd2l0aCB0aGUgdG9wIDUgdW5pdmVyc2l0aWVzIFxudG9wXzVfZGYgPSByYW5raW5nX2RmLmxvY1tsYW1iZGEgZGY6IGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLCA2KSksIDpdXG5cbiMgUHJpbnQgdGhlIGZpcnN0IHJvd3Mgb2YgYHRvcF81X2RmYFxudG9wXzVfZGYuaGVhZCgpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcInRvcF81X2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJ0b3BfNV9kZi5oZWFkXCIpXG5zdWNjZXNzX21zZyhcIkdyZWF0IVwiKSJ9

Ora che hai il DataFrame corretto con cui lavorare, usiamo il metodo .groupby per confrontare entrambi i metodi di ranking usando la similarità di insiemi definita sopra.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxudG9wXzVfZGYgPSByYW5raW5nX2RmLmxvY1tsYW1iZGEgZGY6IGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLCA2KSksIDpdIiwic2FtcGxlIjoiIyBDb21wdXRlIHRoZSBzaW1pbGFyaXR5XG5kZWYgY29tcHV0ZV9zZXRfc2ltaWxhcml0eShzKTpcbiAgICBwaXZvdGVkID0gcy5waXZvdCh2YWx1ZXM9J3dvcmxkX3JhbmsnLCBjb2x1bW5zPSduYW1lJywgaW5kZXg9J3VuaXZlcnNpdHlfbmFtZScpLmRyb3BuYSgpXG4gICAgc2V0X3NpbWxhcml0eSA9IDEwMCAqIGxlbigoc2V0KHBpdm90ZWRbJ3NoYW5naGFpJ10uaW5kZXgpICYgc2V0KHBpdm90ZWRbJ3RpbWVzJ10uaW5kZXgpKSkgLyA1XG4gICAgcmV0dXJuIHNldF9zaW1sYXJpdHlcblxuIyBHcm91cCBgdG9wXzVfZGZgIGJ5IGB5ZWFyYCAgICBcbmdyb3VwZWRfZGYgPSB0b3BfNV9kZi5fX19fX19fKCd5ZWFyJylcblxuIyBVc2UgYGNvbXB1dGVfc2V0X3NpbWlsYXJpdHlgIHRvIGNvbnN0cnVjdCBhIERhdGFGcmFtZVxuc2V0c2ltaWxhcml0eV9kZiA9IHBkLkRhdGFGcmFtZSh7J3NldF9zaW1pbGFyaXR5JzogZ3JvdXBlZF9kZi5hcHBseShjb21wdXRlX3NldF9zaW1pbGFyaXR5KX0pLnJlc2V0X2luZGV4KClcblxuIyBQcmludCB0aGUgZmlyc3Qgcm93cyBvZiBgc2V0c2ltaWxhcml0eV9kZmBcbnNldHNpbWlsYXJpdHlfZGYuX19fXygpIiwic29sdXRpb24iOiIjIENvbXB1dGUgdGhlIHNpbWlsYXJpdHlcbmRlZiBjb21wdXRlX3NldF9zaW1pbGFyaXR5KHMpOlxuICAgIHBpdm90ZWQgPSBzLnBpdm90KHZhbHVlcz0nd29ybGRfcmFuaycsIGNvbHVtbnM9J25hbWUnLCBpbmRleD0ndW5pdmVyc2l0eV9uYW1lJykuZHJvcG5hKClcbiAgICBzZXRfc2ltbGFyaXR5ID0gMTAwICogbGVuKChzZXQocGl2b3RlZFsnc2hhbmdoYWknXS5pbmRleCkgJiBzZXQocGl2b3RlZFsndGltZXMnXS5pbmRleCkpKSAvIDVcbiAgICByZXR1cm4gc2V0X3NpbWxhcml0eVxuICAgIFxuIyBHcm91cCBgdG9wXzVfZGZgIGJ5IGB5ZWFyYCAgICBcbmdyb3VwZWRfZGYgPSB0b3BfNV9kZi5ncm91cGJ5KCd5ZWFyJylcblxuIyBVc2UgYGNvbXB1dGVfc2V0X3NpbWlsYXJpdHlgIHRvIGNvbnN0cnVjdCBhIERhdGFGcmFtZVxuc2V0c2ltaWxhcml0eV9kZiA9IHBkLkRhdGFGcmFtZSh7J3NldF9zaW1pbGFyaXR5JzogZ3JvdXBlZF9kZi5hcHBseShjb21wdXRlX3NldF9zaW1pbGFyaXR5KX0pLnJlc2V0X2luZGV4KClcblxuIyBQcmludCB0aGUgZmlyc3Qgcm93cyBvZiBgc2V0c2ltaWxhcml0eV9kZmBcbnNldHNpbWlsYXJpdHlfZGYuaGVhZCgpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uX2RlZihcImNvbXB1dGVfc2V0X3NpbWlsYXJpdHlcIilcbkV4KCkudGVzdF9vYmplY3QoXCJncm91cGVkX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwic2V0c2ltaWxhcml0eV9kZlwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwic2V0c2ltaWxhcml0eV9kZi5oZWFkXCIpXG5zdWNjZXNzX21zZyhcIldlbGwgZG9uZSFcIikifQ==

Ottieni gli stessi risultati di prima con meno fatica.

5. Visualizzazione

Ora che hai effettuato un’analisi iniziale dei tuoi dataset, è anche il momento di esplorare visivamente i dati. Scrivere codice Pandas più idiomatico significa anche sfruttare l’integrazione di Pandas con il pacchetto Matplotlib per i grafici. Per questo, realizzerai ottimi plot in pochissimo tempo!

Per questa sezione, tornerai ai dataset times_df e shanghai_df per creare alcune visualizzazioni di base con Matplotlib e Seaborn.
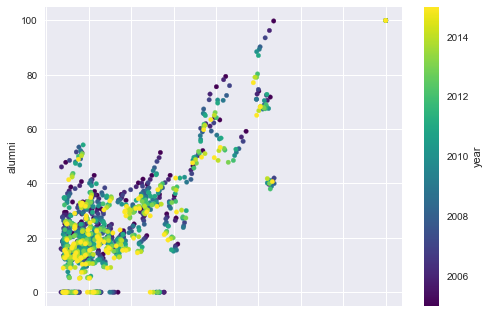
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvc2hhbmdoYWlEYXRhLmNzdicpIiwic2FtcGxlIjoiIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgYWx1bW5pYFxuc2hhbmdoYWlfZGYucGxvdC5zY2F0dGVyKCd0b3RhbF9zY29yZScsICdhbHVtbmknLCBjPSd5ZWFyJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

scatter plot

Il plot sopra mostra subito che ci sono alcuni valori 0 per la colonna alumni. È qualcosa da tenere sicuramente in considerazione quando esplori i dati: con l’aiuto del data profiling, sarai in grado di vedere questi 0 e gestirli. Se vuoi saperne di più, dai un’occhiata al tutorial sul Data Profiling di DataCamp.

Oppure, se hai valori che non hanno posto nel tuo dataset, puoi semplicemente sostituirli con NaN e poi rimuovere tutti i valori NaN delle colonne che renderebbero più difficile la visualizzazione. Nota che è solo un modo rapido per aggiustare i dati e che probabilmente serve un passaggio di data profiling più approfondito per migliorare davvero la qualità, perché nel grafico sotto vedi ancora valori 0 per la colonna num_students:
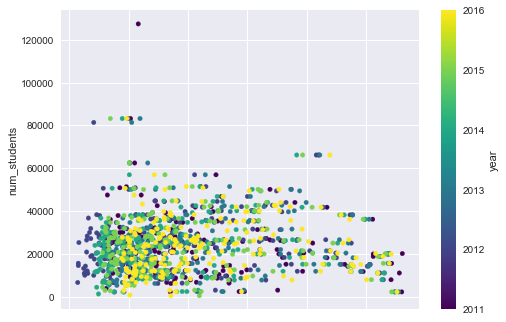
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJlcGxhY2UgYC1gIGVudHJpZXMgd2l0aCBOYU4gdmFsdWVzXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG5cbiMgRHJvcCBhbGwgcm93cyB3aXRoIE5hTiB2YWx1ZXMgZm9yIGBudW1fc3R1ZGVudHNgIFxudGltZXNfZGYgPSB0aW1lc19kZi5kcm9wbmEoc3Vic2V0PVsnbnVtX3N0dWRlbnRzJ10sIGhvdz0nYWxsJylcblxuIyBDYXN0IHRoZSByZW1haW5pbmcgcm93cyB3aXRoIGBudW1fc3R1ZGVudHNgIGFzIGludFxudGltZXNfZGYbJ251bV9zdHVkZW50cyddID0gdGltZXNfZGZbJ251bV9zdHVkZW50cyddLmFzdHlwZSgnaW50JylcblxuIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgbnVtX3N0dWRlbnRzYFxudGltZXNfZGYucGxvdC5zY2F0dGVyKCd0b3RhbF9zY29yZScsICdudW1fc3R1ZGVudHMnLCBjPSd5ZWFyJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

Ovviamente, non devi limitarti a Matplotlib per visualizzare i dati. Ci sono anche altre librerie che ti permettono di visualizzare rapidamente i dati, come Seaborn.

Lo strumento di plotting Seaborn è usato principalmente per creare grafici statistici visivamente gradevoli (come indicato sul sito ufficiale). In effetti, prima della versione 2.0 di Matplotlib, creare grafici belli era laborioso (sebbene possibile).

La combinazione di Pandas con Seaborn ti permette anche di iterare rapidamente sui dati tramite visualizzazioni.

Esploriamo qualche esempio!

Guarda il seguente grafico, in cui conti il numero di volte in cui un determinato paese compare nei dati, prendi le prime dieci osservazioni e ti assicuri di ordinare i conteggi dal valore più alto al più basso quando crei il barplot:
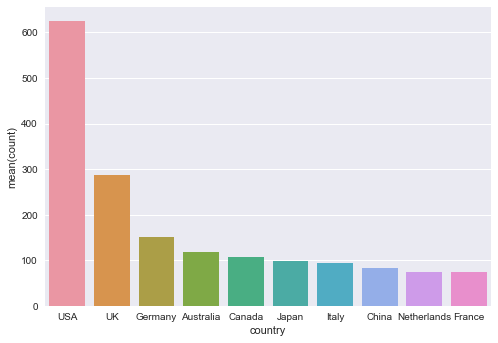
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbWF0cGxvdGxpYi5weXBsb3QgYXMgcGx0XG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpIiwic2FtcGxlIjoiIyBBYmJyZXZpYXRlIGNvdW50cnkgbmFtZXMgb2YgVW5pdGVkIFN0YXRlcyBhbmQgVW5pdGVkIEtpbmdkb21cbnRpbWVzX2RmWydjb3VudHJ5J10gPSB0aW1lc19kZlsnY291bnRyeSddLnJlcGxhY2UoXCJVbml0ZWQgU3RhdGVzIG9mIEFtZXJpY2FcIiwgXCJVU0FcIikucmVwbGFjZShcIlVuaXRlZCBLaW5nZG9tXCIsIFwiVUtcIilcblxuIyBDb3VudCB0aGUgZnJlcXVlbmN5IG9mIGNvdW50cmllcyBcbmNvdW50ID0gdGltZXNfZGZbJ2NvdW50cnknXS52YWx1ZV9jb3VudHMoKVs6MTBdXG5cbiMgQ29udmVydCB0aGUgdG9wIDEwIGNvdW50cmllcyB0byBhIERhdGFGcmFtZSBcbmRmID0gY291bnQudG9fZnJhbWUoKVxuXG4jIFJlc2V0IHRoZSBpbmRleCBcbmRmLnJlc2V0X2luZGV4KGxldmVsPTAsIGlucGxhY2U9VHJ1ZSlcblxuIyBSZW5hbWUgdGhlIGNvbHVtbnNcbmRmLmNvbHVtbnMgPSBbJ2NvdW50cnknLCAnY291bnQnXVxuXG4jIFBsb3QgYSBiYXJwbG90IHdpdGggYGNvdW50cnlgIGFuZCBgY291bnRgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0nY291bnQnLCBkYXRhPWRmKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

bar plot

Poi, puoi proseguire e plottare questi paesi e i loro punteggi medi:
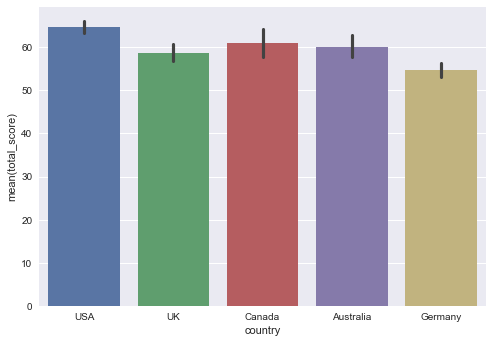
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdCBcbmltcG9ydCBzZWFib3JuIGFzIHNuc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3ZcIiwgdGhvdXNhbmRzPVwiLFwiKVxudGltZXNfZGZbJ2NvdW50cnknXSA9IHRpbWVzX2RmWydjb3VudHJ5J10ucmVwbGFjZShcIlVuaXRlZCBTdGF0ZXMgb2YgQW1lcmljYVwiLCBcIlVTQVwiKS5yZXBsYWNlKFwiVW5pdGVkIEtpbmdkb21cIiwgXCJVS1wiKVxudGltZXNfZGZbJ3RvdGFsX3Njb3JlJ109IHRpbWVzX2RmWyd0b3RhbF9zY29yZSddLnJlcGxhY2UoXCItXCIsIFwiTmFOXCIpLmFzdHlwZSgnZmxvYXQnKVxudGltZXNfZGZfZmlsdGVyZWQ9IHRpbWVzX2RmLnF1ZXJ5KCdjb3VudHJ5ID09XCJVU0FcIiBvciBjb3VudHJ5PT1cIkNhbmFkYVwiIG9yIGNvdW50cnkgPT1cIlVLXCIgb3IgY291bnRyeT09XCJHZXJtYW55XCIgb3IgY291bnRyeT09XCJBdXN0cmFsaWFcIicpIiwic2FtcGxlIjoiIyBCYXJwbG90IHdpdGggYGNvdW50cnlgIGFuZCBgdG90YWxfc2NvcmVgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0ndG90YWxfc2NvcmUnLCBkYXRhPXRpbWVzX2RmX2ZpbHRlcmVkKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

plot

I tuoi grafici possono diventare anche piuttosto complessi. Guarda il seguente pairplot, pensato per mostrarti più chiaramente le relazioni a coppie in un dataset:

import numpy as np

np.seterr(invalid='ignore')

sns.pairplot(times_df, hue='country')

plt.show()
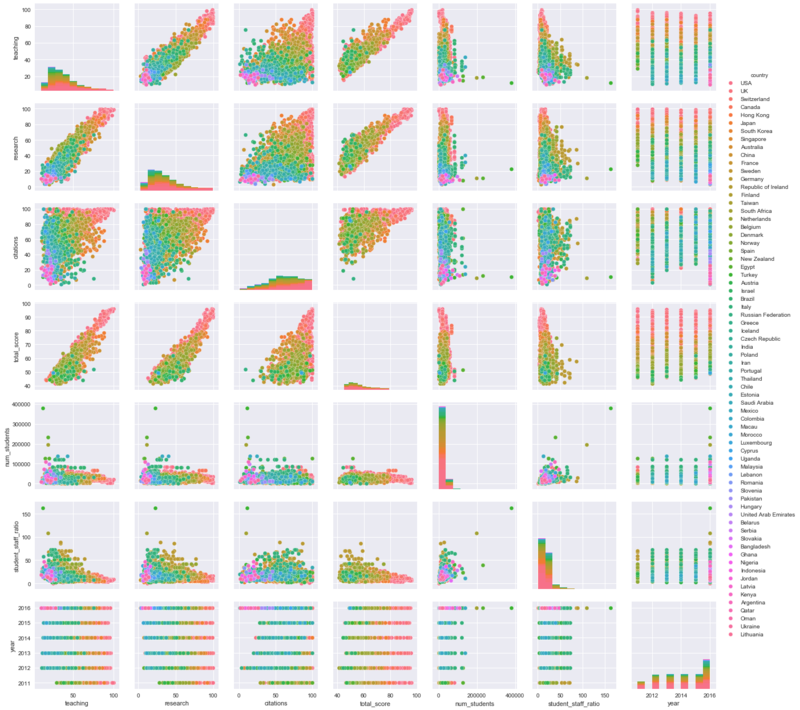
plots

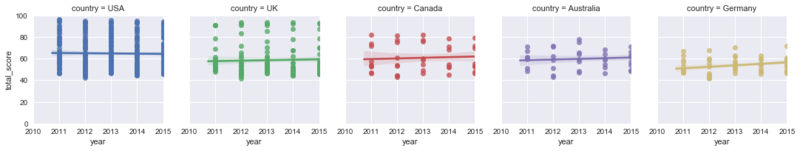
Allo stesso modo, puoi dare un’occhiata a questa combinazione di FacetGrid e regplot, che ti dà qualche insight sull’evoluzione del total_score nel corso degli anni per i 5 paesi principali:
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgcGFuZGFzIGFzIHBkXG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsnY291bnRyeSddID0gdGltZXNfZGZbJ2NvdW50cnknXS5yZXBsYWNlKFwiVW5pdGVkIFN0YXRlcyBvZiBBbWVyaWNhXCIsIFwiVVNBXCIpLnJlcGxhY2UoXCJVbml0ZWQgS2luZ2RvbVwiLCBcIlVLXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG50aW1lc19kZl9maWx0ZXJlZD0gdGltZXNfZGYucXVlcnkoJ2NvdW50cnkgPT1cIlVTQVwiIG9yIGNvdW50cnk9PVwiQ2FuYWRhXCIgb3IgY291bnRyeSA9PVwiVUtcIiBvciBjb3VudHJ5PT1cIkdlcm1hbnlcIiBvciBjb3VudHJ5PT1cIkF1c3RyYWxpYVwiJykiLCJzYW1wbGUiOiIjIEZpbHRlciBvdXQgcm93cyB3aXRoIE5hTiBlbnRyeSBmb3IgYHRvdGFsX3Njb3JlYFxudGltZXNfZGZfZmlsdGVyZWQgPSB0aW1lc19kZl9maWx0ZXJlZC5kcm9wbmEoc3Vic2V0PVsndG90YWxfc2NvcmUnXSwgaG93PSdhbGwnKVxuXG5nID0gc25zLkZhY2V0R3JpZCh0aW1lc19kZl9maWx0ZXJlZCwgY29sPSdjb3VudHJ5JywgaHVlPSdjb3VudHJ5JylcbmcubWFwKHNucy5yZWdwbG90LCAneWVhcicsICd0b3RhbF9zY29yZScpLnNldCh4bGltPSgyMDEwLCAyMDE1KSwgeWxpbT0oMCwxMDApKVxuZy5maWcuc3VicGxvdHNfYWRqdXN0KHdzcGFjZT0uMikifQ==

idiomatic pandas tutorial

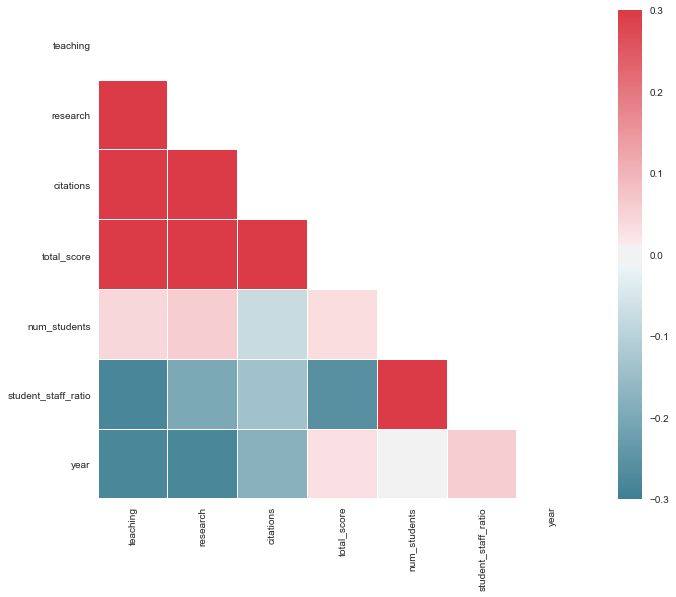
Infine, anche un grafico di correlazione può tornare utile quando esplori i dati. Puoi usare la funzione heatmap() di Seaborn per farlo:
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbnVtcHkgYXMgbnBcbmltcG9ydCBwYW5kYXMgYXMgcGRcbnRpbWVzX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3YnLCB0aG91c2FuZHM9XCIsXCIpIiwic2FtcGxlIjoiaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuXG5zbnMuc2V0KHN0eWxlPVwid2hpdGVcIilcblxuIyBDb21wdXRlIHRoZSBjb3JyZWxhdGlvbiBtYXRyaXhcbmNvcnIgPSB0aW1lc19kZi5jb3JyKClcblxuIyBHZW5lcmF0ZSBhIG1hc2sgZm9yIHRoZSB1cHBlciB0cmlhbmdsZVxubWFzayA9IG5wLnplcm9zX2xpa2UoY29yciwgZHR5cGU9bnAuYm9vbClcbm1hc2tbbnAudHJpdV9pbmRpY2VzX2Zyb20obWFzayldID0gVHJ1ZVxuXG4jIFNldCB1cCB0aGUgbWF0cGxvdGxpYiBmaWd1cmVcbmYsIGF4ID0gcGx0LnN1YnBsb3RzKGZpZ3NpemU9KDExLCA5KSlcblxuIyBHZW5lcmF0ZSBhIGN1c3RvbSBkaXZlcmdpbmcgY29sb3JtYXBcbmNtYXAgPSBzbnMuZGl2ZXJnaW5nX3BhbGV0dGUoMjIwLCAxMCwgYXNfY21hcD1UcnVlKVxuXG4jIERyYXcgdGhlIGhlYXRtYXAgd2l0aCB0aGUgbWFzayBhbmQgY29ycmVjdCBhc3BlY3QgcmF0aW9cbnNucy5oZWF0bWFwKGNvcnIsIG1hc2s9bWFzaywgY21hcD1jbWFwLCB2bWF4PS4zLFxuICAgICAgICAgICAgc3F1YXJlPVRydWUsIGxpbmV3aWR0aHM9LjUsIGF4PWF4KVxuICAgICAgICAgICAgXG5wbHQuc2hvdygpIn0=

chart

Potresti continuare all’infinito con queste visualizzazioni, quindi forse è meglio fermarsi per ora :)

Prossimi passi

È tutto per questa volta, spero ti sia piaciuto imparare alcune tecniche intermedie per lavorare con Pandas e, più specificamente, come scrivere codice Pandas più idiomatico.

Se ti è piaciuto questo post e vuoi approfondire le prestazioni in Pandas, consiglio vivamente il seguente materiale aggiuntivo:

Argomenti
Python
Data Science

Corsi su Pandas

{count, plural, one {Corso} other {Corsi}}

Python - Livello Intermedio

{hours} ore
1.4M
Migliora le tue competenze nella scienza dei dati creando visualizzazioni con Matplotlib e manipolando DataFrames con pandas.
Vedi i dettagliRight Arrow
Inizia Il Corso
Mostra altroRight Arrow
Correlato

{count, plural, one {blog} other {blogs}}

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

{count, plural, one {blog} other {blogs}}

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

{count, plural, one {blog} other {blogs}}

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

Mostra AltroMostra Altro

