Curso
Python intermedio
4 h
1.4M
Pandas es la caja de herramientas de facto para que los científicos de datos en Python agilicen el análisis de datos: por ejemplo, puedes usarlo antes de empezar a analizar para recopilar, explorar y dar formato a los datos. Pandas facilita estos pasos gracias a sus numerosas funciones de E/S y a sus prácticas operaciones de manipulación de datos. Además, como verás más adelante en este tutorial, también ofrece algunas capacidades de visualización (a través de matplotlib).
Aunque las estructuras de datos de Pandas son muy potentes y flexibles, también tienen ciertas complejidades que pueden hacer tu análisis más difícil que fácil, especialmente si estás empezando. En este tutorial nos centraremos en cómo ahorrarte dolores de cabeza y escribir código de Pandas más idiomático. Además de cargar, explorar y limpiar los datos, profundizarás en los siguientes cinco temas:
Por supuesto, este tutorial no pretende ser exhaustivo; El paquete Pandas es muy amplio y, sin duda, hay más formas de hacer tu código más idiomático.
¡No esperemos más y empecemos!
Como siempre, tu análisis de datos empieza cargando y explorando la información. Esta sección es un calentamiento en el que usarás la función read_csv() para cargar un ranking mundial de universidades y, a continuación, explorar rápidamente los datos con las funciones head() y describe(). Si te interesa una introducción completa a Pandas, plantéate hacer el curso de tres partes de DataCamp, empezando por Pandas Foundations.
Si todo esto ya lo dominas, puedes saltarte esta sección y ver cómo realizar indexación con Pandas de forma más idiomática.
Para empezar, importemos los paquetes habituales de ciencia de datos en Python. Como habrás imaginado, Pandas está entre ellos.
# If you're working with a notebook, don't forget to use Matplotlib magic!
%matplotlib inline

# Import pandas under the alias pd import pandas as pd # Import seaborn under the alias sns import seaborn as sns # Set the Seaborn theme if desired sns.set_style('darkgrid')
Además, puedes usar el paquete watermark: es una herramienta muy útil para que tu notebook sea más reproducible. La reproducibilidad es clave cuando colaboras con colegas. ¡Tu yo del futuro también te lo agradecerá! Puedes leer más sobre ciencia de datos reproducible aquí.
Para empezar este tutorial, también necesitarás obtener datos del mundo “real”. En este caso, trabajarás con un conjunto de datos de Kaggle. Si no conoces Kaggle, es una de las mayores comunidades de ciencia de datos y aprendizaje automático. Además, es un buen lugar para seguir aprendiendo una vez dominas los básicos.
El conjunto de datos que usarás es World University Rankings.
Como se mencionó arriba, Pandas tiene muchos métodos prácticos para leer datos de distintas fuentes (puedes aprender más aquí). Dado que los datos están en formato CSV, usaremos el método .read_csv. Pero antes, tienes que descargar los datos de Kaggle (o tomarlos del repositorio de código en la carpeta data si no quieres crear una cuenta).
Una vez descargados, deberías tener una carpeta data con los distintos archivos CSV.
Trabajarás con los datos de los rankings Times Higher Education World University Rankings (en corto, Times) y Academic Ranking of World Universities (en corto, Shanghai). En la carpeta data hay también un tercer sistema de ranking, CWUR, pero es mucho menos conocido, así que puedes ignorarlo por ahora.
# Import Times Higher Education World University Rankings data
times_df = pd.read_csv('data/timesData.csv', thousands=",")

# Import Academic Ranking of World Universities data
shanghai_df = pd.read_csv('data/shanghaiData.csv')Como has aprendido en el tutorial de análisis exploratorio de DataCamp, Pandas ofrece métodos para inspeccionar DataFrames rápidamente: .head() para ver las primeras n filas (n vale 5 por defecto) y .describe() para un resumen estadístico rápido.
Refresca estas funciones ejecutando las siguientes líneas. Los datos ya se han cargado en las variables times_df y shanghai_df:
Ahora que has cargado los datos, puedes empezar a pensar cómo manipularlos con Pandas de forma idiomática.
Para empezar, escribir código más idiomático con Pandas implica aprovechar la potencia de la indexación. Indexar significa seleccionar subconjuntos de tu DataFrame.
Cuando empiezas con Pandas, puede que necesites tiempo para acostumbrarte a cómo funcionan los índices. De hecho, si has trabajado con listas en Python, ya conocerás el uso de corchetes [] combinados con los dos puntos : para seleccionar elementos. Este método funciona en DataFrames.
Además, existen otras dos formas más idiomáticas de seleccionar un subconjunto de DataFrame: iloc y loc:
loc es por etiqueta. Esto significa que si escribes loc[2], buscas los valores con índice etiquetado como 2.iloc es por posición. Esto significa que si escribes iloc[2], buscas los valores que están en la posición de índice 2.Pruébalo en el bloque de DataCamp Light de abajo escribiendo times_df.loc[2] y times_df.iloc[2] en la consola de IPython para ver la diferencia. Luego, intenta resolver el ejercicio con loc, iloc y los corchetes tradicionales.
Por supuesto, puedes ir mucho más allá de simple subsetting o selección por filas y columnas. Las cosas se ponen interesantes cuando combinas loc e iloc con, por ejemplo, arrays booleanos.
Verás que esto va más allá de seleccionar datos por columnas o índices; ¡Es casi como consultar tu data!
loc e iloc son geniales para indexar tus datos, pero cuidado al usar dos pares de corchetes seguidos. Pandas podría devolverte una copia de una vista y, en esos casos, ¡no sabrás con qué estás trabajando! Piénsalo dos veces si combinas dos pares de corchetes con loc o iloc.
Nota: para consultar tus datos, Pandas también dispone de la función query(), que puedes usar para inspecciones rápidas (disponible desde la versión 0.13). Por ejemplo, puedes componer una consulta para ver qué universidades tienen un total_score ligeramente por debajo de 50:
¡Hay muchas más posibilidades al consultar datos! ¿Por qué no pruebas a crear algunas consultas y testearlas en la consola IPython del bloque anterior?
Si te falta inspiración, prueba consultas que devuelvan universidades con primer puesto nacional y con primer puesto mundial. Además, puedes consultar los números de alumni de las universidades.
¿No sabes por dónde empezar? Mira estos ejemplos:
shanghai_df.query("national_rank == 1 and world_rank == 1")
shanghai_df.query("alumni < 20")El encadenamiento de métodos es típico de Pandas, pero cuando estás empezando quizá no sea obvio cómo funciona exactamente. Básicamente, es ir llamando métodos sobre un objeto uno tras otro.
En esta sección profundizarás en el encadenamiento creando canalizaciones de datos con pipe().
Como ya habrás visto, los datasets son bastante distintos. Algunas diferencias:
Por tanto, para usar ambos DataFrames, tendremos que quedarnos solo con las columnas comunes. Con suerte, su contenido será comparable.
Las columnas comunes son:
total_score: puntuación usada para determinar el ranking. Como se menciona en la descripción de Kaggle, puede contener rangos (entre dos valores) y empates (con un signo =)university_name: nombre de la universidadworld_rank: posición de la universidad en el mundoyear: año del rankingPara concatenar ambos datos, primero hay que limpiar. Aplica ahora la canalización completa para limpiar los datos:
Como habrás notado, uso mucho el método .pipe en este tutorial. Si vienes del mundo R, seguramente te sonará.
Es un método nuevo de Pandas (desde la 0.16.2) que permite encadenar operaciones y evitar DataFrames intermedios. Tu código gana en legibilidad.
De hecho, sin este operador, en lugar de escribir df.pipe(f).pipe(g).pipe(h) escribirías h(g(f(df))). A medida que crecen las funciones anidadas, seguir la lógica se complica.
Para profundizar, te recomiendo este artículo.
Ahora que ambos DataFrames están limpios, podemos concatenarlos en un único DataFrame. Y no olvides limpiar los valores faltantes:
Como alrededor del 38% de la columna total_score falta, es mejor eliminarla con el método .drop.
Una tercera forma de hacer tu código de Pandas más “idiomático” —en este caso, más “eficiente”— es optimizando el uso de memoria. Especialmente cuando construyes canalizaciones con encadenamiento de métodos, verás que la memoria influye en la velocidad de ejecución. Aquí lo verás en acción.
Quizá sea excesivo para este dataset pequeño, pero a menudo es buena práctica convertir columnas a tipos específicos para optimizar la memoria. Para empezar, calculemos cuánta memoria usa ranking_df con el método .info.
El resultado de la primera línea indica que los datos ocupan 144 KB. Sin embargo, revisando los argumentos de .info, verás uno opcional, memory_usage, que por defecto es None. ¿Qué pasa si lo estableces en deep?
La huella de memoria nueva es 6 veces —5,6 para ser precisos— mayor que la estimación inicial.
¿Qué ha pasado?
La diferencia se debe a que, sin la marca “deep”, Pandas no estima el consumo de memoria para columnas de tipo object. Este tipo (de Python) ocupa más que dtypes optimizados de numpy. Por eso se recomienda convertir object a tipos más adecuados (por ejemplo, category para datos categóricos).
¡Hagámoslo!
def memory_change(input_df, column, dtype):
    df = input_df.copy()
    old = round(df[column].memory_usage(deep=True) / 1024, 2) # In KB
    new = round(df[column].astype(dtype).memory_usage(deep=True) / 1024, 2)# In KB
    change = round(100 * (old - new) / (old), 2)
    report = ("The inital memory footprint for {column} is: {old}KB.\n"
              "The casted {column} now takes: {new}KB.\n"
              "A change of {change} %.").format(**locals())
    return report

print(memory_change(ranking_df,'world_rank', 'int16'))
print(memory_change(ranking_df,'university_name', 'category'))
print(memory_change(ranking_df,'name', 'category'))
Ahora que sabes que, por ejemplo, cambiando world_rank a int16 la memoria se usa mejor, toca aplicar los cambios. Puedes usar astype() para hacerlo. Termina comprobando de nuevo el uso de memoria:
Mucho mejor. Aún puedes optimizar convirtiendo la columna year a int32.
Ahora que tenemos un conjunto bien formado (es decir, en estado tidy) y con memoria optimizada, empieza el análisis.
Hay algunas preguntas interesantes:
Vamos a resolver la primera usando las técnicas idiomáticas de Pandas vistas.
Antes de empezar, fíjate: ‘Massachusetts Institute of Technology (MIT)’ y ‘Massachusetts Institute of Technology’ son dos registros del mismo centro. Cambia el primero por el segundo.
En casos así, la función loc, que ya has visto, viene de perlas.
Para encontrar las 5 (en general n) mejores universidades por año y sistema de ranking, en pseudocódigo:
year) y para cada sistema (name):Vamos a aplicarlo.
Ahora que tenemos este diccionario, veamos en qué medida (en porcentaje) difieren ambos métodos de ranking cada año: serán 100% similares en conjunto si las 5 seleccionadas son las mismas, aunque el orden difiera.
Como habrás visto, ha sido tedioso. ¿Hay una forma más idiomática en Pandas?
¡Claro! Primero, filtra el DataFrame para quedarte con las 5 mejores por año y método. Revisa el resultado con head():
Con el DataFrame correcto, usemos .groupby para comparar ambos métodos utilizando la similitud de conjuntos definida arriba.
Obtienes lo mismo con mucha menos fricción.
Después del análisis inicial, también toca explorar visualmente. Escribir código idiomático con Pandas también implica aprovechar su integración de gráficos con Matplotlib. ¡Gracias a ello harás gráficos estupendos en nada!
En esta sección volverás a los datasets times_df y shanghai_df para crear visualizaciones básicas con Matplotlib y Seaborn.
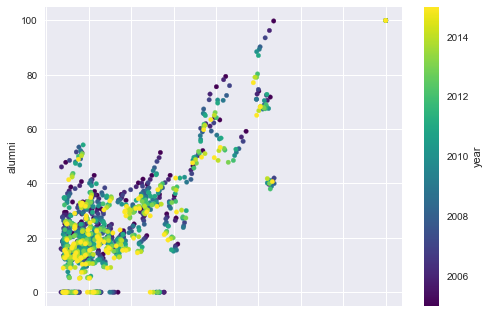
El gráfico anterior deja claro que hay valores 0 en la columna alumni. Esto es algo a tener muy en cuenta cuando exploras tus datos: con un buen perfilado podrás detectar esos 0 y decidir cómo tratarlos. Si quieres saber más, consulta el tutorial de data profiling de DataCamp.
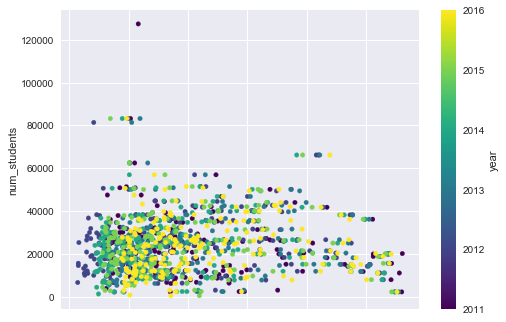
O, si tienes valores que no encajan en tu conjunto de datos, puedes sustituirlos por NaN y luego eliminar todos los NaN de las columnas que dificulten la visualización. Ten en cuenta que esto es solo un ajuste rápido: seguramente necesites un perfilado más completo para mejorar la calidad de los datos, porque aún se ven ceros en la columna num_students del siguiente gráfico:
Por supuesto, no tienes por qué limitarte a Matplotlib. Hay otras bibliotecas para visualizar rápido tus datos, como Seaborn.
Seaborn se usa sobre todo para crear gráficos estadísticos visualmente atractivos (como indica su web oficial). De hecho, antes de Matplotlib 2.0, crear gráficos bonitos era más laborioso (aunque posible).
La combinación de Pandas con Seaborn también te permite iterar rápido mediante visualizaciones.
¡Veamos algunos ejemplos!
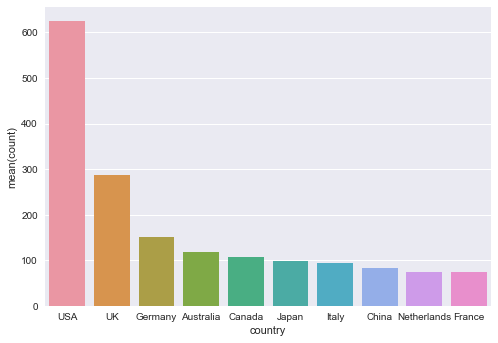
Observa este gráfico: contamos cuántas veces aparece un país en tus datos, tomamos las diez primeras observaciones y nos aseguramos de ordenar los recuentos de mayor a menor al dibujar el barplot:
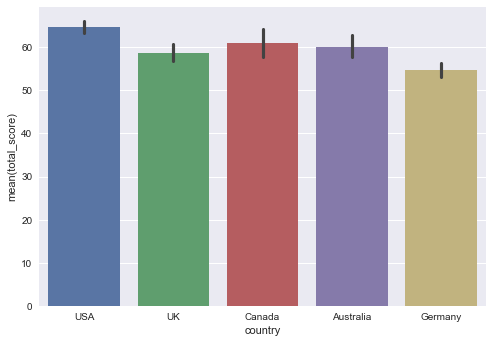
Después, puedes representar esos países y sus puntuaciones medias:
Tus gráficos también pueden ser bastante complejos. Mira este pairplot, pensado para mostrar mejor las relaciones por pares de un dataset:
import numpy as np

np.seterr(invalid='ignore')

sns.pairplot(times_df, hue='country')

plt.show()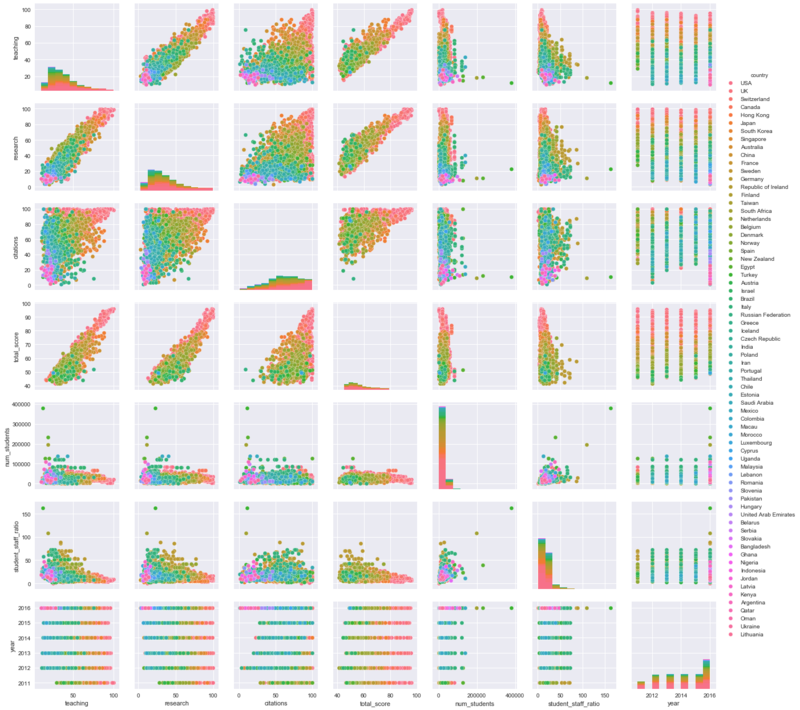
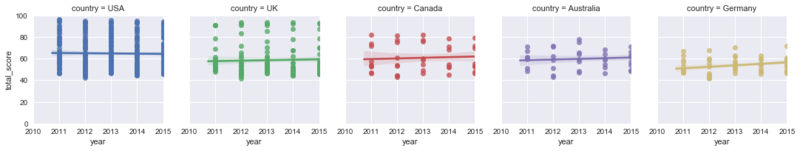
Del mismo modo, puedes probar esta combinación de FacetGrid y regplot, que da pistas sobre la evolución del total_score a lo largo de los años para los 5 países principales:
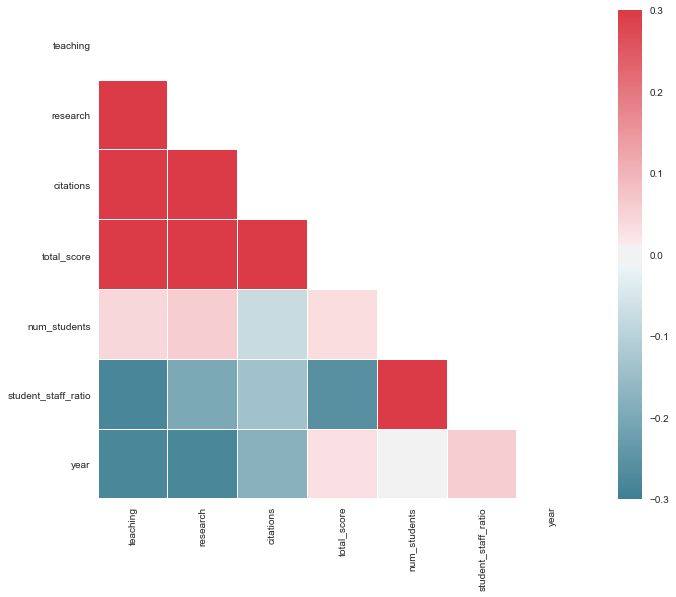
Por último, una gráfica de correlaciones puede ser de gran ayuda al explorar. Puedes usar heatmap() de Seaborn para crearla:
Puedes seguir con estas visualizaciones, así que mejor parar aquí :)
Esto es todo por ahora. Espero que hayas disfrutado aprendiendo técnicas intermedias con Pandas y, en concreto, cómo escribir código más idiomático.
Si te ha gustado este post y quieres profundizar en el rendimiento de Pandas, te recomiendo estos materiales:
Cursos de Pandas
Curso
Curso
Curso
Tutorial
Vidhi Chugh
15 min
Tutorial
Karlijn Willems
15 min
Tutorial
Adel Nehme
9 min
Tutorial
DataCamp Team
7 min
Tutorial
DataCamp Team
13 min
Tutorial
Moez Ali
14 min





