मुख्य सामग्री पर जाएं

मुहावरेदार Pandas कोड लिखने के 5 टिप्स

यह ट्यूटोरियल 5 तरीकों को कवर करता है जिनसे आप आसानी से pandorable या अधिक मुहावरेदार Pandas कोड लिख सकते हैं।
अपडेट किया गया 6 अक्टू॰ 2026  · 14 मि॰ पढ़ें

AI के साथ खोजें

ChatGPTClaudePerplexity

Pandas डेटा विश्लेषण को आसान बनाने के लिए Python डेटा वैज्ञानिकों का डि फ़ैक्टो टूलबॉक्स है: आप इसका उपयोग, उदाहरण के लिए, विश्लेषण शुरू करने से पहले, डेटा एकत्र करने, एक्सप्लोर करने और फ़ॉर्मेट करने के लिए कर सकते हैं। Pandas अपनी कई I/O और उपयोगी डेटा मैनिपुलेशन फ़ंक्शंस के माध्यम से इन चरणों को बेहद आसान बना देता है। इसके अलावा, जैसा कि आप इस ट्यूटोरियल में आगे सीखेंगे, इसमें कुछ विज़ुअलाइज़ेशन क्षमताएँ भी हैं (matplotlib के उपयोग के माध्यम से)।

भले ही Pandas की डेटा संरचनाएँ बहुत शक्तिशाली और लचीली हैं, वे कुछ जटिलताओं के साथ भी आती हैं जो खासकर शुरुआती लोगों के लिए आपके विश्लेषण को आसान के बजाय कठिन बना सकती हैं। इस ट्यूटोरियल में, आप इस पर ध्यान देंगे कि कैसे आप सिरदर्द से बच सकते हैं और अधिक मुहावरेदार Pandas कोड लिख सकते हैं। डेटा को लोड, एक्सप्लोर और साफ करने के अलावा, आप निम्नलिखित पाँच विषयों के बारे में अधिक जानेंगे:

बेशक, यह ट्यूटोरियल किसी भी तरह से संपूर्ण नहीं है; Pandas पैकेज बहुत समृद्ध है और निस्संदेह, ऐसे अन्य तरीके भी हैं जिनसे आप अपने Pandas कोड को और अधिक मुहावरेदार बना सकते हैं।

चलो और देर न करते हुए शुरू करते हैं!

पहला कदम: डेटा को लोड और एक्सप्लोर करें

हमेशा की तरह, आपका डेटा विश्लेषण डेटा को लोड और एक्सप्लोर करने से शुरू होता है। यह सेक्शन एक वॉर्म-अप है जिसमें आप read_csv() फ़ंक्शन का उपयोग करके विश्व विश्वविद्यालय रैंकिंग लोड करेंगे, जिसके बाद आप head() और describe() फ़ंक्शंस से अपने डेटा को जल्दी एक्सप्लोर कर सकते हैं। यदि आप Pandas का पूरा परिचय चाहते हैं, तो DataCamp के तीन-भाग वाले Pandas कोर्स पर विचार करें, जिसकी शुरुआत Pandas Foundations से होती है।

यदि आप यह सब पहले से जानते हैं, तो आप इस सेक्शन को छोड़ सकते हैं और देख सकते हैं कि आप Pandas के साथ अधिक मुहावरेदार तरीके से इंडेक्सिंग कैसे कर सकते हैं।

पैकेज इंपोर्ट करना

शुरू करने के लिए, डेटा साइंस के लिए प्रचलित Python पैकेज इंपोर्ट करें। जैसा कि आपने अनुमान लगाया होगा, Pandas भी इनमें शामिल है।

# If you're working with a notebook, don't forget to use Matplotlib magic! 
%matplotlib inline

# Import pandas under the alias pd import pandas as pd # Import seaborn under the alias sns import seaborn as sns # Set the Seaborn theme if desired sns.set_style('darkgrid')

साथ ही, आप watermark पैकेज का भी उपयोग कर सकते हैं: यह एक अच्छा टूल है जो आपके नोटबुक को अधिक पुनरुत्पादनीय बनाता है। सहकर्मियों के साथ सहयोग करते समय पुनरुत्पादनीय कार्य बहुत महत्वपूर्ण है। आपका भविष्य का स्व भी इसके लिए आपको धन्यवाद देगा! आप पुनरुत्पादनीय डेटा साइंस के बारे में और अधिक यहाँ पढ़ सकते हैं।

डेटा

इस ट्यूटोरियल को शुरू करने के लिए, आपको कुछ “वास्तविक” विश्व डेटा भी प्राप्त करने की आवश्यकता होगी। इस ट्यूटोरियल के लिए, आप Kaggle के एक डेटासेट के साथ काम करेंगे। यदि आप Kaggle से परिचित नहीं हैं, तो यह सबसे बड़े डेटा साइंस और मशीन लर्निंग समुदायों में से एक है। इसके अलावा, बुनियादी बातें जान लेने के बाद डेटा साइंस के बारे में अधिक सीखने के लिए यह एक अच्छा स्थान है।

जिस डेटासेट का आप उपयोग करेंगे, वह है World University Rankings।

जैसा कि ऊपर बताया गया है, Pandas में विभिन्न डेटा स्रोतों से डेटा पढ़ने के लिए कई सुविधाजनक मेथड हैं (आप इसके बारे में अधिक यहाँ सीख सकते हैं)। चूँकि डेटा CSV फ़ॉर्मेट में है, हम .read_csv मेथड का उपयोग करेंगे। लेकिन शुरू करने से पहले, आपको Kaggle से डेटा डाउनलोड करना होगा (या यदि आप खाता नहीं बनाना चाहते हैं तो कोड रिपॉज़िटरी के data फ़ोल्डर से इसे प्राप्त करें)।

एक बार जब आप डेटा ले आते हैं, तो आपके पास एक data फ़ोल्डर होना चाहिए जिसमें अलग-अलग csv फ़ाइलें हों।

इसके बाद, आप Times Higher Education World University Rankings (संक्षेप में Times) और Academic Ranking of World Universities (संक्षेप में Shanghai) रैंकिंग डेटा के साथ काम करेंगे। data फ़ोल्डर में CWUR नामक तीसरी रैंकिंग प्रणाली भी है, लेकिन यह काफी कम जानी-मानी है, इसलिए आप अभी के लिए इसे नज़रअंदाज़ कर सकते हैं।

# Import Times Higher Education World University Rankings data
times_df = pd.read_csv('data/timesData.csv', thousands=",")

# Import Academic Ranking of World Universities data
shanghai_df = pd.read_csv('data/shanghaiData.csv')

डेटा का त्वरित निरीक्षण

जैसा कि आपने DataCamp के Exploratory Data Analysis ट्यूटोरियल में सीखा, Pandas DataFrames का त्वरित निरीक्षण करने के लिए कुछ मेथड प्रदान करता है, जैसे .head() पहले n पंक्तियाँ देखने के लिए (n डिफ़ॉल्ट रूप से 5) और .describe() एक त्वरित सांख्यिकीय सारांश पाने के लिए।

इन फ़ंक्शंस को ताज़ा करने के लिए नीचे दी गई कोड लाइनों को चलाएँ। डेटा आपके लिए पहले से ही times_df और shanghai_df वेरिएबल्स में लोड है:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBSZXR1cm4gdGhlIGZpcnN0IHJvd3Mgb2YgYHRpbWVzX2RmYFxudGltZXNfZGYuX19fXygpXG5cbiMgRGVzY3JpYmUgYHRpbWVzX2RmYFxudGltZXNfZGYuZGVzY3JpYmUoKVxuXG4jIFJldHVybiB0aGUgZmlyc3Qgcm93cyBvZiBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5oZWFkKClcblxuIyBEZXNjcmliZSBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5fX19fX19fXygpIiwic2N0IjoiRXgqKS50ZXN0X2Z1bmN0aW9uKFwidGltZXNfZGYuaGVhZFwiKVxuRXgqKS50ZXN0X2Z1bmN0aW9uKFwidGltZXNfZGYuZGVzY3JpYmVcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInNoYW5naGFpX2RmLmhlYWRcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInNoYW5naGFpX2RmLmRlc2NyaWJlXCIpXG5zdWNjZXNzX21zZyhcIllvdSdyZSBvZmYgdG8gYSBncmVhdCBzdGFydCEgXCIpIn0=

अब जब आपने अपना डेटा लोड कर लिया है, तो आप सोचना शुरू कर सकते हैं कि आप Pandas के साथ मुहावरेदार तरीके से डेटा को कैसे मैनेज कर सकते हैं!

मुहावरेदार Pandas कोड के लिए हमारे टिप्स

1. इंडेक्सिंग

सबसे पहले, अधिक मुहावरेदार Pandas कोड लिखने का मतलब है इंडेक्सिंग की शक्ति का फायदा उठाना। इंडेक्सिंग का अर्थ है कि आप अपने DataFrame से सबसेट्स चुनते हैं।

जब आप Pandas के साथ बिल्कुल शुरू कर रहे होते हैं, तो आपको यह समझने में कुछ समय लग सकता है कि इंडेक्स कैसे काम करते हैं। वास्तव में, यदि आपने पहले (Python) लिस्ट्स के साथ काम किया है, तो आप वर्ग कोष्ठक [] का कॉलन : के साथ संयोजन में तत्वों का चयन करने के उपयोग से पहले से परिचित हो सकते हैं। यह तरीका DataFrames पर काम करता है।

इसके अलावा, सबसेट DataFrame का चयन करने के दो और, अधिक मुहावरेदार तरीके हैं। ये दो मेथड हैं iloc और loc:

  • loc लेबल-आधारित है। इसका मतलब है कि यदि आप loc[2] लिखते हैं, तो आप अपने DataFrame के उन मानों की तलाश कर रहे हैं जिनका इंडेक्स लेबल 2 है।
  • iloc पोज़िशन-आधारित है। यानी यदि आप iloc[2] लिखते हैं, तो आप अपने DataFrame के उन मानों की तलाश कर रहे हैं जो पोज़िशन इंडेक्स 2 पर हैं।

DataCamp Light के नीचे दिए गए हिस्से में times_df.loc[2] और times_df.iloc[2] टाइप करके इसका फर्क देखें। इसके बाद, loc, iloc और पारंपरिक वर्ग कोष्ठकों की मदद से नीचे दिए गए अभ्यास को हल करने का प्रयास करें!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJldHJpZXZlIHRoZSB0b3RhbCBzY29yZSBvZiB0aGUgZmlyc3Qgcm93XG5wcmludCh0aW1lc19kZi5sb2NbMCwgJ19fX19fX19fX19fJ10pXG5cbiMgUmV0cmlldmUgcm93cyAwIGFuZCAxXG5wcmludCh0aW1lc19kZltfOl9dKVxuXG4jIFJldHJpZXZlIHRoZSB2YWx1ZXMgYXQgY29sdW1ucyBhbmQgcm93cyAxLTNcbnByaW50KHRpbWVzX2RmLmlsb2NbMTo0LDE6NF0pXG5cbiMgUmV0cmlldmUgdGhlIGNvbHVtbiBgdG90YWxfc2NvcmVgIFxucHJpbnQodGltZXNfZGZbJ19fX19fX19fX18nXSkiLCJzb2x1dGlvbiI6IiMgUmV0cmlldmUgdGhlIHRvdGFsIHNjb3JlIG9mIHRoZSBmaXJzdCByb3dcbnByaW50KHRpbWVzX2RmLmxvY1swLCAndG90YWxfc2NvcmUnXSlcblxuIyBSZXRyaWV2ZSByb3dzIDAgYW5kIDFcbnByaW50KHRpbWVzX2RmWzA6Ml0pXG5cbiMgUmV0cmlldmUgdGhlIHZhbHVlcyBhdCBjb2x1bW5zIGFuZCByb3dzIDEtM1xucHJpbnQodGltZXNfZGYuaWxvY1sxOjQsMTo0XSlcblxuIyBSZXRyaWV2ZSB0aGUgY29sdW1uIGB0b3RhbF9zY29yZWAgXG5wcmludCh0aW1lc19kZlsndG90YWxfc2NvcmUnXSkiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0xKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTMpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD00KVxuc3VjY2Vzc19tc2coXCJBd2Vzb21lISBZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgc3Vic2V0dGVkIHlvdXIgZGF0YSB3aXRoIGBsb2NgIGFuZCBgaWxvY2AuXCIpIn0=

बेशक, आपकी खोज सिर्फ पंक्तियों और कॉलम से सबसेट चुनने तक ही सीमित नहीं है। जब आप loc और iloc को, उदाहरण के लिए, बूलियन ऐरेज़ के साथ जोड़ते हैं, तो चीज़ें बहुत रोचक हो जाती हैं।

आप देखते हैं कि यह कॉलम-आधारित चयन या इंडेक्सिंग से कुछ आगे जाता है; यह कुछ हद तक अपने डेटा को क्वेरी करने जैसा है!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3ZcIikiLCJzYW1wbGUiOiIjIEFyZSB0aGUgbGFzdCBlbnRyaWVzIGFmdGVyIDIwMDY/XG5wcmludChzaGFuZ2hhaV9kZi5sb2NbOi0xMCwgJ3llYXInXSA+IDIwMDYpXG5cbiMgV2FzIHRoZSBhbHVtbmkgY291bnQgaGlnaGVyIHRoYW4gOTAgZm9yIHRoZSBmaXJzdCAgdGVuIHVuaXZlcnNpdGllcz9cbnByaW50KHNoYW5naGFpX2RmLmxvY1swOjExLCAnYWx1bW5pJ10gPiA5MCkiLCJzb2x1dGlvbiI6IiMgQXJlIHRoZSBsYXN0IGVudHJpZXMgYWZ0ZXIgMjAwNj9cbnByaW50KHNoYW5naGFpX2RmLmxvY1s6LTEwLCAneWVhciddID4gMjAwNilcblxuIyBXYXMgdGhlIGFsdW1uaSBjb3VudCBoaWdoZXIgdGhhbiA5MCBmb3IgdGhlIGZpcnN0ICB0ZW4gdW5pdmVyc2l0aWVzP1xucHJpbnQoc2hhbmdoYWlfZGYubG9jWzA6MTEsICdhbHVtbmknXSA+IDkwKSIsInNjdCI6IkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTEpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgcXVlcmllZCB5b3VyIGRhdGEgd2l0aCBgbG9jYCFcIikifQ==

loc और iloc आपके डेटा को इंडेक्स करने के लिए बेहतरीन हैं, लेकिन सावधान रहें जब आप एक के बाद एक दो सेट वर्ग कोष्ठकों का उपयोग करना शुरू करते हैं! Pandas एक view की कॉपी लौटा सकता है और ऐसे मामलों में, आपको यह पता नहीं होगा कि आप किसके साथ काम कर रहे हैं! इसलिए loc या iloc के साथ दो सेट वर्ग कोष्ठकों का उपयोग करने से पहले दो बार सोचें।

ध्यान दें कि, अपने डेटा को क्वेरी करने के लिए, Pandas आपको query() फ़ंक्शन भी प्रदान करता है जिसे आप जल्दी निरीक्षण के लिए उपयोग कर सकते हैं (संस्करण 0.13 से उपलब्ध)। उदाहरण के लिए, आप एक क्वेरी बना सकते हैं यह देखने के लिए कि किन विश्वविद्यालयों का total_score 50 से थोड़ा कम है:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmdlX3NjaG9vbHMgPSBzaGFuZ2hhaV9kZi5xdWVyeSgndG90YWxfc2NvcmUgPiBfXyBhbmQgdG90YWxfc2NvcmUgPCBfXycpXG5cbiMgUHJpbnQgdGhlIHJlc3VsdFxucHJpbnQoYXZlcmFnZV9zY2hvb2xzKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmdlX3NjaG9vbHMgPSBzaGFuZ2hhaV9kZi5xdWVyeSgndG90YWxfc2NvcmUgPiA0MCBhbmQgdG90YWxfc2NvcmUgPCA1MCcpXG5cbiMgUHJpbnQgdGhlIHJlc3VsdFxucHJpbnQoYXZlcmFnZV9zY2hvb2xzKSIsInNjdCI6IkV4KCkudGVzdF9vYmplY3QoXCJhdmVyYWdlX3NjaG9vbHNcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIpXG5zdWNjZXNzX21zZyhcIldlbGwgZG9uZSFcIikifQ==

बेशक, अपने डेटा को क्वेरी करने के और भी कई तरीके हैं! क्यों न कुछ क्वेरीज़ बनाकर ऊपर दिए DataCamp Light के IPython कंसोल में टेस्ट करें?

यदि आपको प्रेरणा की कमी है, तो ऐसी क्वेरीज़ आज़माएँ जो पहले राष्ट्रीय रैंक वाले और पहले विश्व रैंक वाले विश्वविद्यालय लौटाएँ। इसके अतिरिक्त, आप विश्वविद्यालयों के एलुम्नाई नंबर भी क्वेरी कर सकते हैं।

क्या आपको समझ नहीं आ रहा कि क्वेरीज़ कैसे बनाएं? नीचे दिए कुछ उदाहरण देखें:

shanghai_df.query("national_rank == 1 and world_rank == 1")
shanghai_df.query("alumni < 20")

2. मेथड चेनिंग

मेथड चेनिंग Pandas की एक विशिष्ट बात है, लेकिन जब आप इस Python डेटा मैनिपुलेशन पैकेज के साथ शुरुआत करते हैं, तो यह समझना सीधा नहीं हो सकता कि यह ठीक से कैसे काम करता है। मूल रूप से, यह एक ऑब्जेक्ट पर एक के बाद एक मेथड कॉल करना है।

इस सेक्शन में, आप pipe() के साथ डेटा पाइपलाइंस बनाकर मेथड चेनिंग में गहराई से जाएँगे।

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6IiMgRXh0cmFjdCBpbmZvXG5kZWYgZXh0cmFjdF9pbmZvKGlucHV0X2RmLCBuYW1lKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGluZm9fZGYgPSBwZC5EYXRhRnJhbWUoeyduYl9yb3dzJzogZGYuc2hhcGVbMF0sICduYl9jb2xzJzogZGYuc2hhcGVbMV0sICduYW1lJzogbmFtZX0sIGluZGV4PXJhbmdlKDEpKVxuICAgIHJldHVybiBpbmZvX2RmxG5cbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNvbHV0aW9uIjoiIyBFeHRyYWN0IGluZm9cbmRlZiBleHRyYWN0X2luZm8oaW5wdXRfZGYsIG5hbWUpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgaW5mb19kZiA9IHBkLkRhdGFGcmFtZSh7J25iX3Jvd3MnOiBkZi5zaGFwZVswXSwgJ25iX2NvbHMnOiBkZi5zaGFwZVsxXSwgJ25hbWUnOiBuYW1lfSwgaW5kZXg9cmFuZ2UoMSkpXG4gICAgcmV0dXJuIGluZm9fZGZcbiBcbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNjdCI6ImZ1bl9kZWYgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImV4dHJhY3RfaW5mb1wiKS5tdWx0aShjaGVja19hcmdzKCdpbnB1dF9kZicpLCBjaGVja19hcmdzKCduYW1lJykpXG5mdW5fZGVmLmNoZWNrX2JvZHkoKVxuZnVuX2RlZi5jYWxsKFwiZih0aW1lc19kZiwgJ3RpbWVzJylcIilcbmZ1bl9kZWYuY2FsbChcImYoc2hhbmdoYWlfZGYsICdzaGFuZ2hhaScpXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwiYWxsX2luZm9cIilcbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

जैसा कि आपने पहले ही देखा, दोनों डेटासेट काफी अलग हैं। यहाँ कुछ अंतर दिए गए हैं:

  • Times डेटासेट में 14 कॉलम हैं जबकि Shanghai वाले में 11
  • Times डेटासेट में 2603 पंक्तियाँ हैं जबकि Shanghai वाले में 4897
  • Shanghai डेटासेट से एक प्रमुख मिसिंग कॉलम विश्वविद्यालय का देश है। यदि आवश्यकता हुई तो आप यह जानकारी बाद में Times डेटासेट से ले लेंगे।

इस प्रकार, दोनों DataFrames का उपयोग करने के लिए, हमें केवल समान (कॉमन) कॉलम चुनने होंगे। उम्मीद है, इन कॉमन कॉलम का कंटेंट समान होगा।

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6ImNvbW1vbl9jb2x1bW5zID0gc2V0KHNoYW5naGFpX2RmLmNvbHVtbnMpICYgc2V0KHRpbWVzX2RmLmNvbHVtbnMpXG5cbiMgUmV0dXJuIGBjb21tb25fY29sdW1uc2BcbnByaW50KGNvbW1vbl9jb2x1bW5zKSIsInNvbHV0aW9uIjoiY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcblxuIyBSZXR1cm4gYGNvbW1vbl9jb2x1bW5zYFxucHJpbnQoY29tbW9uX2NvbHVtbnMpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcImNvbW1vbl9jb2x1bW5zXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKSJ9

कॉमन कॉलम ये हैं:

  • total_score: रैंक निर्धारित करने के लिए उपयोग किया जाने वाला स्कोर। जैसा कि Kaggle के विवरण पृष्ठ में उल्लेख है, इनमें रेंज रैंक (यानी दो मानों के बीच) और समान रैंक (आगे = चिह्न) शामिल हैं
  • university_name: विश्वविद्यालय का नाम
  • world_rank: विश्वविद्यालय की रैंक
  • year: वह वर्ष जिसके लिए रैंकिंग की गई है

दोनों डेटा को concatenate करने के लिए, हमें पहले कुछ सफाई करनी होगी। फिर पूरी पाइपलाइन लागू करें और डेटा साफ करें:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucykiLCJzYW1wbGUiOiIjIENsZWFuIHVwIHRoZSBgd29ybGRfcmFua2AgXG5kZWYgY2xlYW5fd29ybGRfcmFuayhpbnB1dF9kZik6XG4gICAgZGYgPSBpbnB1dF9kZi5jb3B5KClcbiAgICBkZi53b3JsZF9yYW5rID0gZGYud29ybGRfcmFuay5zdHIuc3BsaXQoJy0nKS5zdHJbMF0uc3RyLnNwbGl0KCc9Jykuc3RyWzBdXG4gICAgcmV0dXJuIGRmXG4gICAgXG4jIEFzc2lnbiB0aGUgY29tbW9uIHllYXJzIG9mIGBzaGFuZ2hhaV9kZmAgYW5kIGB0aW1lc19kZmAgdG8gYGNvbW1vbl95ZWFyc2AgICAgXG5jb21tb25feWVhcnMgPSBzZXQoc2hhbmdoYWlfZGYueWVhcikgJiBzZXQodGltZXNfZGYueWVhcikgXG5cbiMgUHJpbnQgYGNvbW1vbl95ZWFyc2BcbnByaW50KGNvbW1vbl95ZWFycylcblxuIyBGaWx0ZXIgeWVhcnNcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuXG4jIENsZWFuIGB0aW1lc19kZmAgYW5kIGBzaGFuZ2hhaV9kZmBcbmNsZWFuZWRfdGltZXNfZGYgPSAodGltZXNfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3RpbWVzJykpXG5jbGVhbmVkX3NoYW5naGFpX2RmID0gKHNoYW5naGFpX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmspXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLmFzc2lnbihuYW1lPSdzaGFuZ2hhaScpKSIsInNvbHV0aW9uIjoiIyBDbGVhbiB1cCB0aGUgYHdvcmxkX3JhbmtgIFxuZGVmIGNsZWFuX3dvcmxkX3JhbmtvaW5wdXRfZGYpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgZGYud29ybGRfcmFuayA9IGRmLndvcmxkX3Jhbmsuc3RyLnNwbGl0KCctJykuc3RyWzBdLnN0ci5zcGxpdCgnPScpLnN0clswXVxuICAgIHJldHVybiBkZlxuICAgIFxuIyBBc3NpZ24gdGhlIGNvbW1vbiB5ZWFycyBvZiBgc2hhbmdoYWlfZGZgIGFuZCBgdGltZXNfZGZgIHRvIGBjb21tb25feWVhcnNgICAgIFxuY29tbW9uX3llYXJzID0gc2V0KHNoYW5naGFpX2RmLnllYXIpICYgc2V0KHRpbWVzX2RmLnllYXIpIFxuXG4jIFByaW50IGBjb21tb25feWVhcnNgXG5wcmludChjb21tb25feWVhcnMpXG5cbiMgRmlsdGVyIHllYXJzXG5kZWYgZmlsdGVyX3llYXIoaW5wdXRfZGYsIHllYXJzKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIHJldHVybiBkZi5xdWVyeSgneWVhciBpbiB7fScuZm9ybWF0KGxpc3QoeWVhcnMpKSlcblxuIyBDbGVhbiBgdGltZXNfZGZgIGFuZCBgc2hhbmdoYWlfZGZgXG5jbGVhbmVkX3RpbWVzX2RmID0gKHRpbWVzX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmslbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3RpbWVzJykpXG5jbGVhbmVkX3NoYW5naGFpX2RmID0gKHNoYW5naGFpX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmsplcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpIiwic2N0IjoiZnVuX2RlZjEgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImZpbHRlcl95ZWFyXCIpLm11bHRpKGNoZWNrX2FyZ3MoJ2lucHV0X2RmJyksIGNoZWNrX2FyZ3MoJ3llYXJzJykpXG5mdW5fZGVmMS5jaGVja19ib2R5KClcbmZ1bl9kZWYxLmNhbGwoXCJmKHRpbWVzX2RmLCBjb21tb25feWVhcnMpXCIpXG5mdW5fZGVmMS5jYWxsKFwiZihzaGFuZ2hhaV9kZiwgY29tbW9uX3llYXJzKVwiKVxuXG5FeCgpLnRlc3Rfb2JqZWN0KFwiY29tbW9uX3llYXJzXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKVxuXG5mdW5fZGVmID0gRXgoKS5jaGVja19mdW5jdGlvbl9kZWYoXCJjbGVhbl93b3JsZF9yYW5rXCIpXG5mdW5fZGVmLmNoZWNrX2JvZHkoKVxuZnVuX2RlZi5jYWxsKFwiZih0aW1lc19kZilcIilcbmZ1bl9kZWYuY2FsbChcImYoc2hhbmdoYWlfZGYpXCIpXG5cblh4KCkudGVzdF9vYmplY3QoXCJjbGVhbmVkX3RpbWVzX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwiY2xlYW5lZF9zaGFuZ2hhaV9kZlwiKVxuXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUgam9iIVwiKSJ9

जैसा कि आपने शायद नोट किया होगा, मैं इस ट्यूटोरियल में .pipe मेथड का बहुत उपयोग करता हूँ। यदि आप R दुनिया से आते हैं, तो आप शायद इससे (किसी हद तक) परिचित होंगे।

यह Pandas का एक उपयोगी नया (संस्करण 0.16.2 से) मेथड है जो आपको ऑपरेशंस को चेन करने की अनुमति देता है और इस तरह मध्यवर्ती DataFrames की आवश्यकता को समाप्त करता है। आपका कोड अधिक पठनीय हो जाता है।

वास्तव में, इस ऑपरेटर के बिना, df.pipe(f).pipe(g).pipe(h) लिखने के बजाय आप लिखेंगे: h(g(f(df)))। नेस्टेड फ़ंक्शंस की संख्या बढ़ने पर इसे फॉलो करना कठिन हो जाता है।

विषय के बारे में और जानने के लिए, मैं इस ब्लॉग पोस्ट को पढ़ने की सिफारिश करता हूँ।

अब जब दोनों DataFrames साफ हो गए हैं, तो हम उन्हें एकल DataFrame में concatenate कर सकते हैं। साथ ही, मिसिंग डेटा को साफ करना न भूलें:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpIiwic2FtcGxlIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNvbHV0aW9uIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNjdCI6IkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwibWlzc2luZ19kYXRhXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwicmFua2luZ19kZlwiKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgaW1wcm92ZWQgeW91ciBkYXRhIHF1YWxpdHkhXCIpIn0=

चूँकि total_score कॉलम में लगभग 38% डेटा गायब है, .drop मेथड के साथ इस कॉलम को हटाना बेहतर है।

3. मेमोरी ऑप्टिमाइज़ेशन

Pandas कोड को अधिक “मुहावरेदार” बनाने का तीसरा तरीका —जो इस मामले में “परफ़ॉर्मेंट” के अधिक क़रीब है— मेमोरी उपयोग को ऑप्टिमाइज़ करना है। खासकर जब आप मेथड चेनिंग द्वारा डेटा पाइपलाइंस बनाना शुरू करते हैं, तो आप देखेंगे कि मेमोरी यह तय करने में बड़ी भूमिका निभा सकती है कि आपकी पाइपलाइंस कितनी तेज़ चलती हैं। आप यहाँ इस सब पर और देखेंगे।

यह छोटे डेटासेट के लिए शायद ज़रूरत से ज़्यादा हो, लेकिन अक्सर कुछ कॉलम्स को विशिष्ट टाइप में कास्ट करना मेमोरी उपयोग को अनुकूल बनाने के लिए अच्छा अभ्यास है। शुरू करने के लिए, चलिए .info मेथड का उपयोग करके देखते हैं कि ranking_df के लिए कितनी मेमोरी एलोकेट हुई है।

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBQc्रिंट the memory usage of `ranking_df` \nranking_df.info()\n\n# Print the deep memory usage of `ranking_df` \nranking_df.info(memory_usage=\"deep\")","solution":"# Print the memory usage of `ranking_df` \nranking_df.info()\n\n# Print the deep memory usage of `ranking_df` \nranking_df.info(memory_usage=\"deep\")","sct":"RXgoKS50ZXN0X2Z1bmN0aW9uKFwicmFua2luZ19kZi5pbmZvXCIsIGluZGV4PTEpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJyYW5raW5nX2RmLmluZm9cIiwgaW5kZXg9MilcbnN1Y2Nlc3NfbXNnKFwiR3JlYXQhXCIp"}

कोड की पहली पंक्ति का परिणाम हमें बताता है कि डेटा 144 KB लेता है। हालाँकि, .info मेथड के आर्ग्युमेंट्स की जाँच करने पर, पता चलता है कि एक वैकल्पिक आर्ग्युमेंट memory_usage है जो डिफ़ॉल्ट रूप से None पर सेट है। जब आप memory_usage आर्ग्युमेंट को deep पर सेट करते हैं तो क्या होता है?

नया मेमोरी फ़ुटप्रिंट 6 —सटीक रूप से 5.6— गुना बड़ा है जितना शुरुआती उत्तर था।

यहाँ क्या हुआ?

मेमोरी के अनुमान में अंतर इस तथ्य से आता है कि “deep” फ़्लैग चालू किए बिना, Pandas object dtype के लिए मेमोरी खपत का अनुमान नहीं लगाता। इस (Python) प्रकार के डेटा को अन्य numpy ऑप्टिमाइज़्ड dtypes की तुलना में अधिक स्थान चाहिए। यही कारण है कि object टाइप्स को अधिक उपयुक्त टाइप (जैसे कि श्रेणीबद्ध डेटा के लिए category) में कास्ट करने की सिफारिश की जाती है।

आइए करें!

def memory_change(input_df, column, dtype):
    df = input_df.copy()
    old = round(df[column].memory_usage(deep=True) / 1024, 2) # In KB
    new = round(df[column].astype(dtype).memory_usage(deep=True) / 1024, 2)# In KB
    change = round(100 * (old - new) / (old), 2)
    report = ("The inital memory footprint for {column} is: {old}KB.\n" 
              "The casted {column} now takes: {new}KB.\n"
              "A change of {change} %.").format(**locals())
    return report

print(memory_change(ranking_df,'world_rank', 'int16'))
print(memory_change(ranking_df,'university_name', 'category'))
print(memory_change(ranking_df,'name', 'category'))

अब जब आप जानते हैं कि, उदाहरण के लिए, world_rank को int16 में बदलने से आपकी मेमोरी अधिक कुशलता से उपयोग होगी, तो अब इन बदलावों को वास्तव में लागू करने का समय है। आप इसे करने के लिए astype() फ़ंक्शन का उपयोग कर सकते हैं। अंत में फिर से जाँच लें कि अब आपका मेमोरी उपयोग कैसा दिखता है:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBDYXN0IGB3b3JsZF9yYW5rYCBhcyB0eXBlIGBpbnQxNmBcbnJhbmtpbmdfZGYud29ybGRfcmFuayA9IHJhbmtpbmdfZGYud29ybGRfcmFuay5hc3R5cGUoJ2ludDE2JylcblxuIyBDYXN0IGB1bnZlcnNpdHlfbmFtZWAgYXMgdHlwZSBgY2F0ZWdvcnlgXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIENhc3QgYG5hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIERvdWJsZSBjaGVjayB0aGUgbWVtb3J5IHVzYWdlIGFmdGVyIHR5cGUgY2FzdGluZ1xucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT0nZGVlcCcpIiwic29sdXRpb24iOiIjIENhc3QgYHdvcmxkX3JhbmtgIGFzIHR5cGUgYGludDE2YFxucmFua2luZ19kZi53b3JsZF9yYW5rID0gcmFua2luZ19kZi53b3JsZF9yYW5rLmFzdHlwZSgnaW50MTYnKVxuXG4jIENhc3QgYHVuaXZlcnNpdHlfbmFtZWAgYXMgdHlwZSBgY2F0ZWdvcnlgXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIENhc3QgYG5hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIERvdWJsZSBjaGVjayB0aGUgbWVtb3J5IHVzYWdlIGFmdGVyIHR5cGUgY2FzdGluZ1xucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT0nZGVlcCcpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcInJhbmtpbmdfZGZcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

यह बहुत बेहतर है। आप year कॉलम को int32 में कास्ट करके और भी ऑप्टिमाइज़ कर सकते हैं।

4. GroupBy

अब जब हमारे पास एक ठीक-ठाक डेटा सेट है (यानी यह tidy स्थिति में है) और मेमोरी फ़ुटप्रिंट ऑप्टिमाइज़ है, तो डेटा विश्लेषण शुरू हो सकता है।

अब कुछ सवाल हैं जिनका जवाब देने में आपकी दिलचस्पी हो सकती है:

  • प्रत्येक रैंकिंग सिस्टम द्वारा वर्षों में दिए गए शीर्ष 5 विश्वविद्यालय कौन से हैं?
  • प्रत्येक वर्ष के लिए ये रैंकिंग कितनी अलग हैं?

आइए पहले सवाल का जवाब ढूँढ़ते हैं, और ऐसा करते समय उन अधिक मुहावरेदार Pandas तरीकों का उपयोग करते हैं जो आपने पिछले सेक्शंस में देखे हैं!

शुरू करने से पहले, ध्यान दें कि ‘Massachusetts Institute of Technology (MIT)’ और ‘Massachusetts Institute of Technology’ एक ही विश्वविद्यालय के दो अलग-अलग रिकॉर्ड हैं। इसलिए, आप पहले नाम को बाद वाले में बदलें।

ऐसे मामलों में, इस ट्यूटोरियल में पहले देखे गए loc फ़ंक्शन विशेष रूप से उपयोगी साबित होते हैं!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgUXVlcnkgZm9yIHRoZSByb3dzIHdpdGggdW5pdmVyc2l0eSBuYW1lICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1xucHJpbnQocmFua2luZ19kZi5fX19fXyhcInVuaXZlcnNpdHlfbmFtZSA9PSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSAoTUlUKSdcIikpXG5cbiMgTG9jYWxpemUgdGhlIHJvd3Mgd2l0aCB0aGUgTUlUIHVuaXZlcnNpdHkgbmFtZSBhbmQgcmVwbGFjZSB2YWx1ZSBcbnJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogZGYudW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJywgJ3VuaXZlcnNpdHlfbmFtZSddID0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3knXG5cbiMgUHJpbnQgYHJhbmtpbmdfZGZgXG5wcmludChfX19fX19fX19fKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBmb3IgdGhlIHJvd3Mgd2l0aCB1bml2ZXJzaXR5IG5hbWUgJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknXG5wcmludChyYW5raW5nX2RmLnF1ZXJ5KFwidW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1wiKSlcblxuIyBMb2NhbGl6ZSB0aGUgcm93cyB3aXRoIHRoZSBNSVQgdW5pdmVyc2l0eSBuYW1lIGFuZCByZXBsYWNlIHZhbHVlIFxucmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi51bml2ZXJzaXR5X25hbWUgPT0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknLCAndW5pdmVyc2l0eV9uYW1lJ10gPSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSdcblxuIyBQc्रिंट `ranking_df`\nprint(ranking_df)" ,"sct":"RXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIp"}

वर्षों में, प्रत्येक रैंकिंग सिस्टम के लिए शीर्ष 5 (आम तौर पर n) विश्वविद्यालय खोजने के लिए, इसे छद्म-कोड में ऐसे करें:

  • प्रत्येक वर्ष (year कॉलम) और प्रत्येक रैंकिंग सिस्टम (name कॉलम) के लिए:
  • उस वर्ष और रैंकिंग सिस्टम के लिए डेटा का सबसेट चुनें
  • शीर्ष 5 विश्वविद्यालय चुनें और उन्हें एक लिस्ट में रखें
  • परिणाम को एक डिक्शनरी में स्टोर करें, जहाँ कुंजी (year, name) हो और मान यूनिवर्सिटीज़ की सूची (घटते क्रम में) हो

इसे लागू करें।

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgTG9hZCBpbiBgaXRlcnRvb2xzYFxuaW1wb3J0IGl0ZXJ0b29sc1xuXG4jIEluaXRpYWxpemUgYHJhbmtpbmdgXG5yYW5raW5nID0ge31cblxuZm9yIHllYXIsIG5hbWUgaW4gaXRlcnRvb2xzLnByb2R1Y3QoY29tbW9uX3llYXJzLCBbXCJ0aW1lc1wiLCBcInNoYW5naGFpXCJdKTpcbiAgICBzID0gKHJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogKChkZi55ZWFyID09IHllYXIpICYgKGRmLm5hbWUgPT0gbmFtZSlcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICYgKGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLDYpKSkpLCA6XVxuICAgICAgICAgICAgICAgICAgIC5zb3J0X3ZhbHVlcygnd29ybGRfcmFuaycsIGFzY2VuZGluZz1GYWxzZSlcbiAgICAgICAgICAgICAgICAgICAudW5pdmVyc2l0eV9uYW1lKVxuICAgIHJhbmtpbmdbKHllYXIsIG5hbWUpXSA9IGxpc3QocylcbiAgICBcblxuIyBQ्रिंट `ranking`\nprint(ranking)"}

अब जब हमारे पास यह रैंकिंग डिक्शनरी है, तो देखते हैं कि वर्षों में दोनों रैंकिंग मेथड्स कितने (प्रतिशत में) अलग हैं: दोनों 100% सेट-समान हैं यदि चुने गए शीर्ष 5 विश्वविद्यालय समान हैं, भले ही उनकी रैंकिंग एक जैसी न हो।

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IGl0ZXJ0b29sc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZyA9IHt9XG5mb3IgeWVhciwgbmFtZSBpbiBpdGVydG9vbHMucHJvZHVjdChjb21tb25feWVhcnMsIFtcInRpbWVzXCIsIFwic2hhbmdoYWlcIl0pOlxuICAgIHMgPSAocmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiAoKGRmLnllYXIgPT0geWVhcikgJiAoZGYubmFtZSA9PSBuYW1lKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgJiAoZGYud29ybGRfcmFuay5pc2luKHJhbmdlKDEsNikpKSksIDpdXG4gICAgICAgICAgICAgICAgICAgLnNvcnRfdmFsdWVzKCd3b3JsZF9yYW5rJywgYXNjZW5kaW5nPUZhbHNlKVxuICAgICAgICAgICAgICAgICAgIC51bml2ZXJzaXR5X25hbWUpXG4gICAgcmFua2luZ1soeWVhciwgbmFtZSldID0gbGlzdChzKSIsInNhbXBsZSI6IiMgSW1wb3J0IGBkZWZhdWx0ZGljdGBcbmZyb20gY29sbGVjdGlvbnMgaW1wb3J0IGRlZmF1bHRkaWN0XG5cbiMgSW5pdGlhbGl6ZSBgY29tcGFyZWBcbmNvbXBhcmUgPSBkZWZhdWx0ZGljdChsaXN0KVxuXG4jIEluaXRpYWxpemUgYGV4YWN0X3NpbWlsYXJpdHlgIGFuZCBgc2V0X3NpbWlsYXJpdHlgXG5leGFjdF9zaW1pbGFyaXR5ID0ge31cbnNldF9zaW1pbGFyaXR5ID0ge31cblxuZm9yICh5ZWFyLCBtZXRob2QpLCB1bml2ZXJzaXRpZXMgaW4gcmFua2luZy5pdGVtcygpOlxuICAgIGNvbXBhcmVbeWVhcl0uYXBwZW5kKHVuaXZlcnNpdGllcylcbiAgICBcbmZvciB5ZWFyLCByYW5rcyBpbiBjb21wYXJlLml0ZW1zKCk6XG4gICAgc2V0X3NpbWlsYXJpdHlbeyयeaXJ9ID0gMTAwICogbGVuKHNldChyYW5rc1swXSkgJiBzZXQocmFua3NbMV0pKSAvIDUuMFxuXG4j प्रिंट `set_similarity` \nprint(set_similarity)"}

जैसा कि आपने देखा, यह थकाऊ था। क्या कोई बेहतर, अधिक मुहावरेदार Pandas तरीका है?

बिल्कुल है! पहले, रैंकिंग DataFrame को फ़िल्टर करें ताकि प्रत्येक वर्ष और रैंकिंग मेथड के लिए केवल शीर्ष 5 विश्वविद्यालय ही रखें। head() फ़ंक्शन की मदद से परिणाम भी देख लें:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BलीXG4gICAgcmV0dXJuIGRmXG5jb21tb25feWVhcnMgPSBzZXQoc2hhbmdoYWlfZGYueWVhcikgJiBzZXQodGltZXNfZGYueWVhcikgXG5kZWYgZmlsdGVyX3llYXIoaW5wdXRfZGYsIHllYXJzKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIHJldHVybiBkZi5xdWVyeSgneWVhciBpbiB7fScuZm9ybWF0KGxpc3QoeWVhcnMpKSlcblxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVरX2VhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmsplcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3RpbWVzJykpXG5jbGVhbmVkX3NoYW5naGFpX2RmID0gKHNoYW5naGFpX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmsplcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgQ29uc3RydWN0IGEgRGF0YUZyYW1lIHdpdGggdGhlIHRvcCA1IHVuaXZlcnNpdGllcyBcbnRvcF81X2RmID0gcmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi53b3JsZF9yYW5rLmlzaW4ocmFuZ2UoMSwgNikpLCA6XVxuXG4j प्रिंट the first rows of `top_5_df`\nटop_5_df.head()" ,"solution":"# Construct a DataFrame with the top 5 universities \ntop_5_df = ranking_df.loc[lambda df: df.world_rank.isin(range(1, 6)), :]\n\n# Print the first rows of `top_5_df`\ntop_5_df.head()","sct":"RXgoKS50ZXN0X29iamVjdChcInRvcF81X2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJ0b3BfNV9kZi5oZWFkXCIpXG5zdWNjZXNzX21zZyhcIkdyZWF0IVwiKSJ9

अब जबकि आपके पास काम करने के लिए सही DataFrame है, ऊपर परिभाषित सेट समानता का उपयोग करते हुए दोनों रैंकिंग मेथड्स की तुलना करने के लिए .groupby मेथड का उपयोग करें।

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVरX2Vhरीलmsभc29ेाXMिgकिकाभाीdks")

आपको ऊपर जैसा ही परिणाम कम मेहनत में मिल जाता है।

5. विज़ुअलाइज़ेशन

अब जब आपने अपने डेटा सेट्स का कुछ प्रारंभिक विश्लेषण कर लिया है, तो अब अपने डेटा को दृश्य रूप से एक्सप्लोर करने का भी समय है। अधिक मुहावरेदार Pandas कोड का मतलब यह भी है कि आप Pandas के Matplotlib पैकेज के साथ प्लॉटिंग इंटीग्रेशन का उपयोग करें। इसकी वजह से, आप बहुत कम समय में बेहतरीन प्लॉट बना लेंगे!

इस सेक्शन के लिए, आप times_df और shanghai_df डेटासेट्स पर लौटेंगे और Matplotlib तथा Seaborn के साथ कुछ बुनियादी विज़ुअलाइज़ेशन बनाएँगे।
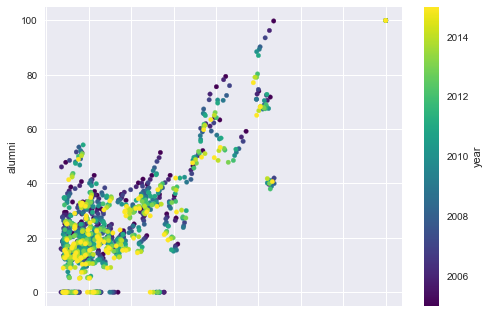
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvc2hhbmdoYWlEYXRhLmNzdicpIiwic2FtcGxlIjoiIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgYWx1bW5pYFxuc2hhbmdoYWlfZGYucGxvdC5zY2F0dGVyKCd0b3RhbF9zY29yZScsICdhbHVtbmknLCBjPSd5ZWFyJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

scatter plot

ऊपर का प्लॉट तुरंत स्पष्ट कर देता है कि alumni कॉलम के लिए कुछ 0 मान हैं। यह ऐसी चीज़ है जिसे डेटा एक्सप्लोर करते समय निश्चित रूप से ध्यान में रखना चाहिए: डेटा प्रोफाइलिंग की मदद से, आप इन 0 मानों को देख सकेंगे और उन्हें संभाल पाएँगे। यदि आप इसके बारे में अधिक जानना चाहते हैं, तो DataCamp का Data Profiling ट्यूटोरियल देखें।

या, यदि आपके पास ऐसे मान हैं जिनकी आपके डेटा सेट में जगह नहीं है, तो आप उन्हें बस NaN से बदल सकते हैं और फिर उन कॉलम्स के सभी NaN मानों को हटा सकते हैं जिनसे डेटा को प्लॉट करना कठिन हो जाएगा। ध्यान दें कि यह आपके डेटा को समायोजित करने का सिर्फ एक त्वरित तरीका है और आपको डेटा गुणवत्ता में सुधार सुनिश्चित करने के लिए शायद अधिक विस्तृत डेटा प्रोफाइलिंग चरण की आवश्यकता होगी, क्योंकि नीचे दिए गए प्लॉट में आपको अभी भी num_students कॉलम के लिए 0 मान दिखते हैं:
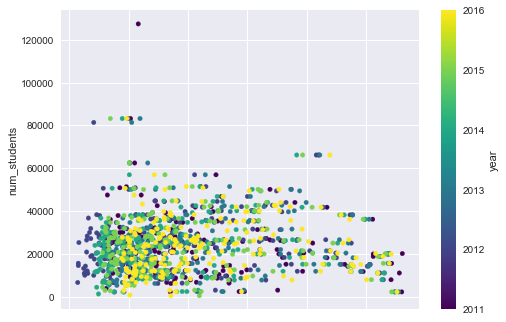
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJlcGxhY2UgYC1gIGVudHJpZXMgd2l0aCBOYU4gdmFsdWVzXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG5cbiMgRHJvcCBhbGwgcm93cyB3aXRoIE5hTiB2YWx1ZXMgZm9yIGBudW1fc3R1ZGVudHNgIFxudGltZXNfZGYgPSB0aW1lc19kZi5kcm9wbmEoc3Vic2V0PVsnbnVtX3N0dWRlbnRzJ10sIGhvdz0nYWxsJylcblxuIyBDYXN0IHRoZSByZW1haW5pbmcgcm93cyB3aXRoIGBudW1fc3R1ZGVudHNgIGFzIGludFxudGltZXNfZGZbJ251bV9zdHVkZW50cyddID0gdGltZXNfZGZbJ251bV9zdHVkZW50cyddLmFzdHlwZSgnaW50JylcblxuIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgbnVtX3N0dWRlbnRzYFxudGltZXNfZGYucGxvdC5zY2F0dGVरKCd0b3RhbF9zY29yZScsICdudW1fc3R1ZGVudHMnLCBjPSd5ZWFरJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

बेशक, अपने डेटा को विज़ुअलाइज़ करने के लिए आपको Matplotlib तक सीमित रहने की आवश्यकता नहीं है। अन्य लाइब्रेरीज़ भी हैं जो आपको अपने डेटा को जल्दी से विज़ुअलाइज़ करने देती हैं, जैसे कि Seaborn।

Seaborn प्लॉटिंग टूल मुख्य रूप से सांख्यिकीय प्लॉट बनाने के लिए उपयोग किया जाता है जो दृश्य रूप से आकर्षक होते हैं (जैसा कि आधिकारिक वेबसाइट में कहा गया है)। वास्तव में, Matplotlib के संस्करण 2.0 से पहले, सुंदर प्लॉट बनाना झंझट भरा (हालाँकि संभव) था।

Pandas और Seaborn का संयोजन आपको विज़ुअलाइज़ेशन के माध्यम से अपने डेटा पर जल्दी-जल्दी इटरेट करने की अनुमति भी देता है।

कुछ उदाहरण देखें!

निम्नलिखित प्लॉट पर नज़र डालें, जहाँ आप गिनते हैं कि कोई विशिष्ट देश आपके डेटा में कितनी बार आता है, पहले दस ऑब्ज़र्वेशंस लेते हैं और यह सुनिश्चित करते हैं कि जब आप barplot बनाते हैं तो काउंट्स उच्च से निम्न मान तक सॉर्ट हों:
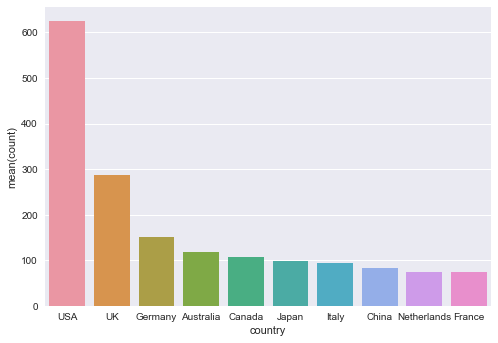
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbWF0cGxvdGxpYi5weXBsb3QgYXMgcGx0XG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpIiwic2FtcGxlIjoiIyBBYmJyZXZpYXRlIGNvdW50cnkgbmFtZXMgb2YgVW5pdGVkIFN0YXRlcyBhbmQgVW5pdGVkIEtpbmdkb21cbnRpbWVzX2RmWydjb3VudHJ5J10gPSB0aW1lc19kZlsnY291bnRyeSddLnJlcGxhY2UoXCJVbml0ZWQgU3RhdGVzIG9mIEFtZXJpY2FcIiwgXCJVU0FcIikucmVwbGFjZShcIlVuaXRlZCBLaW5nZG9tXCIsIFwiVUtcIilcblxuIyBDb3VudCB0aGUgZnJlcXVlbmN5IG9mIGNvdW50cmllcyBcbmNvdW50ID0gdGltZXNfZGZbJ2NvdW50cnknXS52YWx1ZV9jb3VudHMoKVs6MTBdXG5cbiMgQ29udmVydCB0aGUgdG9wIDEwIGNvdW50cmllcyB0byBhIERhdGFGcmFtZSBcbmRmID0gY291bnQudG9fZnJhbWUoKVxuXG4jIFJlc2V0IHRoZSBpbmRleCBcbmRmLnJlc2V0X2luZGV4KGxldmVsPTAsIGlucGxhY2U9VHJ1ZSlcblxuIyBSZW5hbWUgdGhlIGNvbHVtbnNcbmRmLmNvbHVtbnMgPSBbJ2NvdW50cnknLCAnY291bnQnXVxuXG4jIFBsb3QgYSBiYXJwbG90IHdpdGggYGNvdW50cnlgIGFuZCBgY291bnRgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0nY291bnQnLCBkYXRhPWRmKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

bar plot

फिर, आप इन देशों और उनके औसत स्कोर को भी प्लॉट कर सकते हैं:
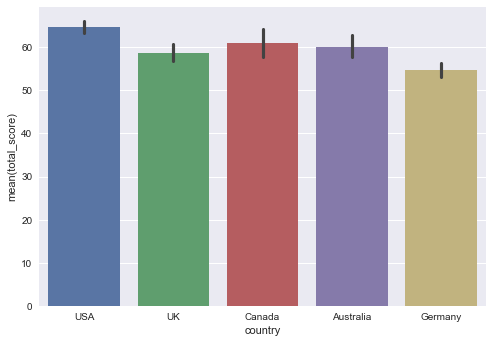
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdCBcbmltcG9ydCBzZWFib3JuIGFzIHNuc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3ZcIiwgdGhvdXNhbmRzPVwiLFwiKVxudGltZXNfZGZbJ2NvdW50cnknXSA9IHRpbWVzX2RmWydjb3VudHJ5J10ucmVwbGFjZShcIlVuaXRlZCBTdGF0ZXMgb2YgQW1lcmljYVwiLCBcIlVTQVwiKS5yZXBsYWNlKFwiVW5pdGVkIEtpbmdkb21cIiwgXCJVS1wiKVxudGltZXNfZGZbJ3RvdGFsX3Njb3JlJ109IHRpbWVzX2RmWyd0b3RhbF9zY29yZSddLnJlcGxhY2UoXCItXCIsIFwiTmFOXCIpLmFzdHlwZSgnZmxvYXQnKVxudGltZXNfZGZfZिल्टेरेdPSकspखचfलामखडहखदकारकlरjुहs")

plot

आपके प्लॉट काफ़ी जटिल भी हो सकते हैं। नीचे दिए गए pairplot पर नज़र डालें, जिसे किसी डेटासेट में पेयरवाइज़ रिलेशनशिप्स को और स्पष्ट रूप से दिखाने के लिए डिज़ाइन किया गया है:

import numpy as np

np.seterr(invalid='ignore')

sns.pairplot(times_df, hue='country')

plt.show()
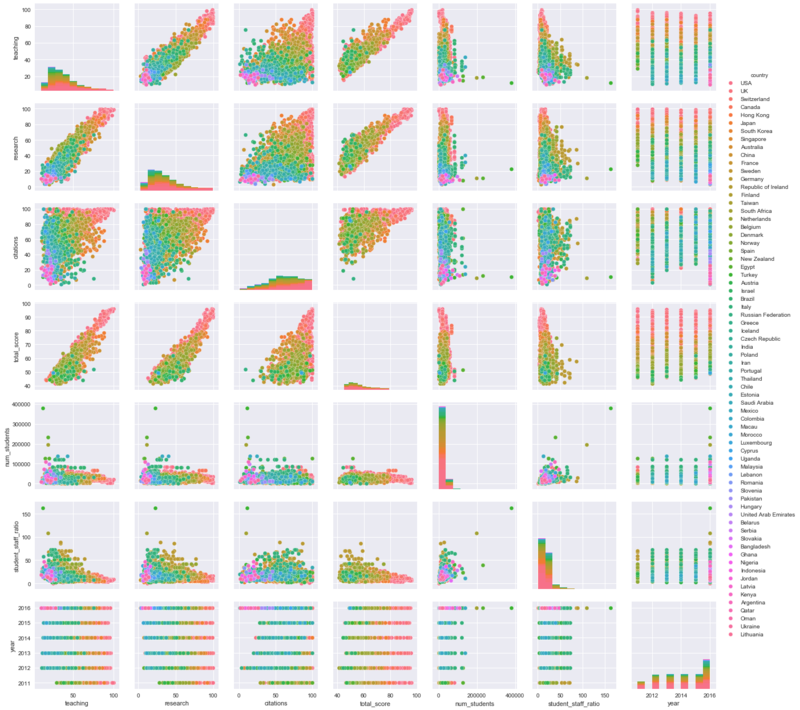
plots

इसी तरह, आप FacetGrid और regplot के इस संयोजन को देख सकते हैं, जो आपको शीर्ष 5 देशों के लिए वर्षों में total_score के विकास पर कुछ अंतर्दृष्टि देता है:
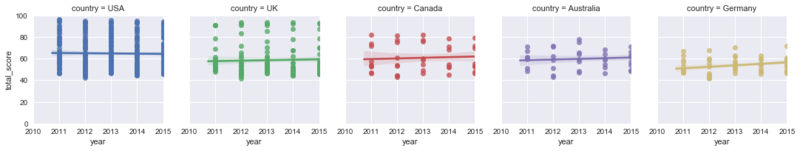
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgcGFuZGFzIGFzIHBkXG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsnY291bnRyeSddID0gdGltZXNfZGZbJ2NvdW50cnknXS5yZXBsYWNlKFwiVW5pdGVkIFN0YXRlcyBvZiBBbWVyaWNhXCIsIFwiVVNBXCIpLnJlcGxhY2UoXCJVbml0ZWQgS2luZ2RvbVwiLCBcIlVLXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG50aW1lc19kZl9maWx0ZXJlZD0gdGltZXNfZGYucXVlcnkoJ2NvdW50cnkgPT1cIlVTQVwiIG9yIGNvdW50cnk9PVwiQ2FuYWRhXCIgb3IgY291bnRyeSA9PVwiVUtcIiBvciBjb3VudHJ5PT1cIkdlcm1hbnlcIiBvciBjb3VudHJ5PT1cIkF1c3RyYWxpYVwiJykiLCJzYW1wbGUiOiIjIEZिल्टरेन्दश्र्य dealing with total_score\ntimes_df_filtered = times_df_filtered.dropna(subset=['total_score'], how='all')\n\ng = sns.FacetGrid(times_df_filtered, col='country', hue='country')\ng.map(sns.regplot, 'year', 'total_score').set(xlim=(2010, 2015), ylim=(0,100))\ng.fig.subplots_adjust(wspace=.2)"}

idiomatic pandas tutorial

अंत में, डेटा एक्सप्लोर करते समय एक कोरिलेशन प्लॉट भी काम आ सकता है। आप Seaborn के heatmap() फ़ंक्शन का उपयोग करके इसे कर सकते हैं:
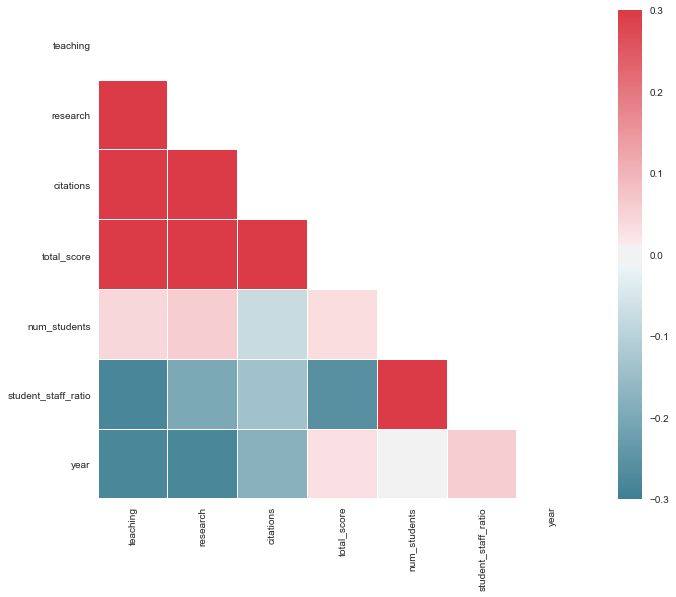
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbnVtcHkgYXMgbnBcbmltcG9ydCBwYW5kYXMgYXMgcGRcbnRpbWVzX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3YnLCB0aG91c2FuZHM9XCIsXCIpIiwic2FtcGxlIjoiaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuXG5zbnMuc2V0KHN0eWxlPVwid2hpdGVcIilcblxuIyBDb21wdXRlIHRoZSBjb3JyZWxhdGlvbiBtYXRyaXhcbmNvcnIgPSB0aW1lc19kZi5jb3JyKClcblxuIyBHZW5lcmF0ZSBhIG1hc2sgZm9yIHRoZSB1cHBlciB0cmlhbmdsZVxubWFzayA9IG5wLnplcm9zX2xpa2UoY29yciwgZHR5cGU9bnAuYm9vbClcbm1hc2tbbnAudHJpdV9pbmRpY2VzX2Zyb20obWFzayldID0gVHJ1ZVxuXG4jIFNldCB1cCB0aGUgbWF0cGxvdGxpYiBmaWd1cmVcbmYsIGF4ID0gcGx0LnN1YnBsb3RzKGZpZ3NpemU9KDExLCA5KSlcblxuIyBHZW5lcmF0ZSBhIGN1c3RvbSBkaXZlcmdpbmcgY29sb3JtYXBcbmNtYXAgPSBzbnMuZGl2ZXJnaW5nX3BhbGV0dGUoMjIwLCAxMCwgYXNfY21hcD1UcnVlKVxuXG4jIERyYXcgdGhlIGhlYXRtYXAgd2l0aCB0aGUgbWFzayBhbmQgY29ycmVjdCBhc3BlY3QgcmF0aW9cbnNucy5oZWF0bWFwKGNvcnIsIG1hc2s9bWFzaywgY21hcD1jbWFwLCB2bWF4PS4zLFxuICAgICAgICAgICAgc3F1YXJlPVRydWUsIGxpbmV3aWR0aHM9LjUsIGF4PWF4KVxuICAgICAgICAgICAgXG5wbHQuc2hvdygpIn0=

chart

आप इन विज़ुअलाइज़ेशन के साथ बहुत आगे तक जा सकते हैं, तो शायद अभी के लिए यहीं रुकना बेहतर है :)

आगे के कदम

फिलहाल के लिए बस इतना ही, उम्मीद है कि आपने Pandas के साथ काम करने की कुछ मध्यवर्ती तकनीकें और खास तौर पर अधिक मुहावरेदार Pandas कोड लिखना सीखकर आनंद लिया होगा।

यदि आपको यह ब्लॉग पोस्ट पसंद आई और आप Pandas में परफ़ॉर्मेंस के बारे में और गहराई से जाना चाहते हैं, तो मैं निम्न अतिरिक्त सामग्री की अत्यधिक सिफारिश करता हूँ:

विषय
Python
डेटा साइंस

Pandas Courses

कोर्स

इंटरमीडिएट Python

4 घंटा
1.4M
Matplotlib से विज़ुअलाइज़ेशन बनाकर और pandas से DataFrames को संभालकर अपने डेटा विज्ञान कौशल बढ़ाएँ।
विवरण देखेंRight Arrow
पाठ्यक्रम शुरू करें
और देखेंRight Arrow