Pular para o conteúdo principal

5 Tips to Write Idiomatic Pandas Code

This tutorial covers 5 ways in which you can easily write pandorable or more idiomatic Pandas code.
Atualizado 17 de set. de 2026  · 14 min lido

Explorar com IA

ChatGPTClaudePerplexity

Pandas é a caixa de ferramentas de facto dos cientistas de dados em Python para facilitar a análise de dados: você pode usá-lo, por exemplo, antes de começar a analisar, para coletar, explorar e formatar os dados. O Pandas torna essas etapas fáceis graças às suas inúmeras funções de I/O e de manipulação de dados. Além disso, como você vai ver mais adiante neste tutorial, ele também tem alguns recursos de visualização (por meio do matplotlib).

Embora as estruturas de dados do Pandas sejam muito poderosas e flexíveis, elas também trazem algumas complexidades que podem tornar sua análise mais difícil do que fácil, especialmente para quem está começando. Neste tutorial, o foco é aprender como evitar dor de cabeça e escrever código Pandas mais idiomático. Além de carregar, explorar e limpar os dados, você vai aprender mais sobre os cinco tópicos a seguir:

Claro, este tutorial não é exaustivo; O pacote Pandas é muito rico e certamente existem outras formas de deixar seu código mais idiomático.

Bora começar!

Primeiro passo: carregar e explorar os dados

Como sempre, sua análise de dados começa carregando e explorando os dados. Esta seção é um aquecimento em que você vai usar a função read_csv() para carregar rankings de universidades do mundo e, em seguida, explorar rapidamente os dados com as funções head() e describe(). Se quiser uma introdução completa a Pandas, considere fazer a trilha de três cursos da DataCamp, começando por Pandas Foundations.

Se você já sabe tudo isso, pode pular direto para a seção sobre como fazer indexação de um jeito mais idiomático no Pandas.

Importando pacotes

Para começar, vamos importar os pacotes básicos de Python para ciência de dados. Como você deve ter imaginado, Pandas está entre eles.

# If you're working with a notebook, don't forget to use Matplotlib magic! 
%matplotlib inline

# Import pandas under the alias pd import pandas as pd # Import seaborn under the alias sns import seaborn as sns # Set the Seaborn theme if desired sns.set_style('darkgrid')

Além disso, você também pode usar o pacote watermark: é uma ferramenta legal que deixa seu notebook mais reproduzível. Trabalhos reproduzíveis são muito importantes ao colaborar com colegas. Seu “eu do futuro” também agradece! Você pode ler mais sobre ciência de dados reproduzível aqui.

Os dados

Para começar este tutorial, você também vai precisar buscar alguns dados do “mundo real”. Neste caso, vamos trabalhar com um dataset do Kaggle. Se você não conhece, o Kaggle é uma das maiores comunidades de ciência de dados e machine learning. Além disso, é um ótimo lugar para aprender mais quando você já domina o básico.

O dataset que você vai usar é o World University Rankings.

Como mencionado, o Pandas tem vários métodos práticos para ler dados de diferentes fontes (saiba mais aqui). Como os dados estão em formato CSV, vamos usar o método .read_csv. Mas, antes de começar, você precisa baixar os dados do Kaggle (ou pegar no repositório de código, na pasta data, se não quiser criar uma conta).

Depois de baixar, você deve ter uma pasta data com os arquivos csv.

Em seguida, vamos trabalhar com os dados do ranking Times Higher Education World University Rankings (Times) e do Academic Ranking of World Universities (Shanghai). Há ainda um terceiro sistema de ranking na pasta data, o CWUR, mas ele é bem menos conhecido; pode ignorá-lo por enquanto.

# Import Times Higher Education World University Rankings data
times_df = pd.read_csv('data/timesData.csv', thousands=",")

# Import Academic Ranking of World Universities data
shanghai_df = pd.read_csv('data/shanghaiData.csv')

Inspecionando os dados rapidamente

Como você viu no tutorial de análise exploratória da DataCamp, Pandas oferece métodos para inspecionar DataFrames rapidamente: .head() para ver as primeiras n linhas (n é 5 por padrão) e .describe() para um resumo estatístico rápido.

Relembre essas funções executando as linhas de código a seguir. Os dados já foram carregados para você nas variáveis times_df e shanghai_df:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBSZXR1cm4gdGhlIGZpcnN0IHJvd3Mgb2YgYHRpbWVzX2RmYFxudGltZXNfZGYuX19fXygpXG5cbiMgRGVzY3JpYmUgYHRpbWVzX2RmYFxudGltZXNfZGYuZGVzY3JpYmUoKVxuXG4jIFJldHVybiB0aGUgZmlyc3Qgcm93cyBvZiBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5oZWFkKClcblxuIyBEZXNjcmliZSBgc2hhbmdoYWlfZGZgXG5zaGFuZ2hhaV9kZi5fX19fX19fXygpIiwic29sdXRpb24iOiIjIFJldHVybiB0aGUgZmlyc3Qgcm93cyBvZiBgdGltZXNfZGZgXG50aW1lc19kZi5oZWFkKClcblxuIyBEZXNjcmliZSBgdGltZXNfZGZgXG50aW1lc19kZi5kZXNjcmliZSgpXG5cbiMgUmV0dXJuIHRoZSBmaXJzdCByb3dzIG9mIGBzaGFuZ2hhaV9kZmBcbnNoYW5naGFpX2RmLmhlYWQoKVxuXG4jIERlc2NyaWJlIGBzaGFuZ2hhaV9kZmBcbnNoYW5naGFpX2RmLmRlc2NyaWJlKCkiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJ0aW1lc19kZi5oZWFkXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJ0aW1lc19kZi5kZXNjcmliZVwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwic2hhbmdoYWlfZGYuaGVhZFwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwic2hhbmdoYWlfZGYuZGVzY3JpYmVcIilcbnN1Y2Nlc3NfbXNnKFwiWW91J3JlIG9mZiB0byBhIGdyZWF0IHN0YXJ0IVwiKSJ9

Agora que você carregou os dados, já pode pensar em como manipulá-los no Pandas de forma idiomática!

Nossas dicas para código Pandas idiomático

1. Indexação

Para começar, escrever código Pandas mais idiomático significa aproveitar o poder da indexação. Indexar é selecionar subconjuntos do seu DataFrame.

Quando você está começando no Pandas, pode levar um tempo até se acostumar com índices. Na verdade, se você já trabalhou com listas em Python, deve conhecer os colchetes [] combinados com os dois-pontos : para selecionar elementos. Esse método também funciona com DataFrames.

Além disso, há duas outras formas, mais idiomáticas, de selecionar um subconjunto de DataFrame: iloc e loc:

  • loc é baseada em rótulos. Isso significa que, se você escrever loc[2], estará buscando os valores cujo índice possui o rótulo 2.
  • iloc é baseada em posição. Isso significa que, se você escrever iloc[2], estará buscando os valores que estão na posição de índice 2.

Teste abaixo no bloco do DataCamp Light digitando times_df.loc[2] e times_df.iloc[2] no console IPython para ver a diferença. Depois, tente resolver o exercício com a ajuda de loc, iloc e os tradicionais colchetes!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJldHJpZXZlIHRoZSB0b3RhbCBzY29yZSBvZiB0aGUgZmlyc3Qgcm93XG5wcmludCh0aW1lc19kZi5sb2NbMCwgJ19fX19fX19fX19fJ10pXG5cbiMgUmV0cmlldmUgcm93cyAwIGFuZCAxXG5wcmludCh0aW1lc19kZltfOl9dKVxuXG4jIFJldHJpZXZlIHRoZSB2YWx1ZXMgYXQgY29sdW1ucyBhbmQgcm93cyAxLTNcbnByaW50KHRpbWVzX2RmLmlsb2NbMTo0LDE6NF0pXG5cbiMgUmV0cmlldmUgdGhlIGNvbHVtbiBgdG90YWxfc2NvcmVgIFxucHJpbnQodGltZXNfZGZbJ19fX19fX19fX18nXSkiLCJzb2x1dGlvbiI6IiMgUmV0cmlldmUgdGhlIHRvdGFsIHNjb3JlIG9mIHRoZSBmaXJzdCByb3dcbnByaW50KHRpbWVzX2RmLmxvY1swLC AndG90YWxfc2NvcmUnXSlcblxuIyBSZXRyaWV2ZSByb3dzIDAgYW5kIDFcbnByaW50KHRpbWVzX2RmWzA6Ml0pXG5cbiMgUmV0cmlldmUgdGhlIHZhbHVlcyBhdCBjb2x1bW5zIGFuZCByb3dzIDEtM1xucHJpbnQodGltZXNfZGYuaWxvY1sxOjQsMTo0XSlcblxuIyBSZXRyaWV2ZSB0aGUgY29sdW1uIGB0b3RhbF9zY29yZWAgXG5wcmludCh0aW1lc19kZlsndG90YWxfc2NvcmUnXSkiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0xKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTMpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD00KVxuc3VjY2Vzc19tc2coXCJBd2Vzb21lISBZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgc3Vic2V0dGVkIHlvdXIgZGF0YSB3aXRoIGBsb2NgIGFuZCBgaWxvY2AuXCIpIn0=

Claro, a exploração pode ir muito além de simplesmente selecionar linhas e colunas. As coisas ficam interessantes quando você combina loc e iloc com, por exemplo, arrays booleanos.

Isso vai um pouco além de selecionar por coluna ou índice; é quase como consultar seu dado!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3ZcIikiLCJzYW1wbGUiOiIjIEFyZSB0aGUgbGFzdCBlbnRyaWVzIGFmdGVyIDIwMDY/XG5wcmludChzaGFuZ2hhaV9kZi5sb2NbOi0xMCwgJ3llYXInXSA+IDIwMDYpXG5cbiMgV2FzIHRoZSBhbHVtbmkgY291bnQgaGlnaGVyIHRoYW4gOTAgZm9yIHRoZSBmaXJzdCAgdGVuIHVuaXZlcnNpdGllcz9cbnByaW50KHNoYW5naGFpX2RmLmxvY1swOjExLCAnYWx1bW5pJ10gPiA5MCkiLCJzb2x1dGlvbiI6IiMgQXJlIHRoZSBsYXN0IGVudHJpZXMgYWZ0ZXIgMjAwNj9cbnByaW50KHNoYW5naGFpX2RmLmxvY1s6LTEwLCAneWVhciddID4gMjAwNilcblxuIyBXYXMgdGhlIGFsdW1uaSBjb3VudCBoaWdoZXIgdGhhbiA5MCBmb3IgdGhlIGZpcnN0ICB0ZW4gdW5pdmVyc2l0aWVzP1xucHJpbnQoc2hhbmdoYWlfZGYubG9jWzA6MTEsICdhbHVtbmknXSA+IDkwKSIsInNjdCI6IkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIsIGluZGV4PTEpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgcXVlcmllZCB5b3VyIGRhdGEgd2l0aCBgbG9jYCFcIikifQ==

loc e iloc são ótimos para indexar, mas cuidado quando usar dois pares de colchetes em sequência! O Pandas pode retornar uma cópia de uma view e, nesses casos, você pode não saber com o que ainda está trabalhando. Pense duas vezes ao combinar dois pares de colchetes com loc ou iloc.

Observação: para consultar seus dados, o Pandas também oferece a função query(), que você pode usar para inspecionar rapidamente os dados (disponível desde a versão 0.13). Por exemplo, você pode montar uma consulta para ver quais universidades têm total_score um pouco abaixo de 50:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoXCJodHRwczovL3MzLmFtYXpvbmF3cy5jb20vYXNzZXRzLmRhdGFjYW1wLmNvbS9ibG9nX2Fzc2V0cy9zaGFuZ2hhaURhdGEuY3N2XCIpIiwic2FtcGxlIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmdlX3NjaG9vbHMgPSBzaGFuZ2hhaV9kZi5xdWVyeSgndG90YWxfc2NvcmUgPiBfXyBhbmQgdG90YWxfc2NvcmUgPCBfXycpXG5cbiMgUHJpbnQgdGhlIHJlc3VsdFxucHJpbnQoYXZlcmFnZV9zY2hvb2xzKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBgc2hhbmdoYWlfZGZgIGZvciB1bml2ZXJzaXRpZXMgd2l0aCB0b3RhbCBzY29yZSBiZXR3ZWVuIDQwIGFuZCA1MFxuYXZlcmdlX3NjaG9vbHMgPSBzaGFuZ2hhaV9kZi5xdWVyeSgndG90YWxfc2NvcmUgPiA0MCBhbmQgdG90YWxfc2NvcmUgPCA1MCcpXG5cbiMgUHJpbnQgdGhlIHJlc3VsdFxucHJpbnQoYXZlcmFnZV9zY2hvb2xzKSIsInNjdCI6IkV4KCkudGVzdF9vYmplY3QoXCJhdmVyYWdlX3NjaG9vbHNcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInByaW50XCIpXG5zdWNjZXNzX21zZyhcIldlbGwgZG9uZSFcIikifQ==

Claro, existem muitas outras possibilidades para consultar seus dados! Que tal criar algumas consultas e testá-las no console IPython do bloco acima?

Sem ideias? Tente consultas que retornem universidades com primeiro lugar nacional e com primeiro lugar mundial. Além disso, você pode consultar os números de ex-alunos das universidades.

Ficou na dúvida de como montar as consultas? Veja alguns exemplos:

shanghai_df.query("national_rank == 1 and world_rank == 1")
shanghai_df.query("alumni < 20")

2. Encadeamento de métodos

O encadeamento de métodos é algo típico do Pandas, mas, quando você está começando com esse pacote de manipulação de dados em Python, pode não ser óbvio como funciona. Basicamente, é chamar métodos em um objeto, um após o outro.

Nesta seção, vamos aprofundar o encadeamento criando pipelines de dados com pipe().

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6IiMgRXh0cmFjdCBpbmZvXG5kZWYgZXh0cmFjdF9pbmZvKGlucHV0X2RmLCBuYW1lKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGluZm9fZGYgPSBwZC5EYXRhRnJhbWUoeyduYl9yb3dzJzogZGYuc2hhcGVbMF0sICduYl9jb2xzJzogZGYuc2hhcGVbMV0sICduYW1lJzogbmFtZX0sIGluZGV4PXJhbmdlKDEpKVxuICAgIHJldHVybiBpbmZvX2RmXG5cbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNvbHV0aW9uIjoiIyBFeHRyYWN0IGluZm9cbmRlZiBleHRyYWN0X2luZm8oaW5wdXRfZGYsIG5hbWUpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgaW5mb19kZiA9IHBkLkRhdGFGcmFtZSh7J25iX3Jvd3MnOiBkZi5zaGFwZVswXSwgJ25iX2NvbHMnOiBkZi5zaGFwZVsxXSwgJ25hbWUnOiBuYW1lfSwgaW5kZXg9cmFuZ2UoMSkpXG4gICAgcmV0dXJuIGluZm9fZGZcbiBcbiMgR2F0aGVyIGFsbCBpbmZvICAgXG5hbGxfaW5mbyA9IHBkLmNvbmNhdChbdGltZXNfZGYucGlwZShleHRyYWN0X2luZm8sICd0aW1lcycpLCBzaGFuZ2hhaV9kZi5waXBlKGV4dHJhY3RfaW5mbywgJ3NoYW5naGFpJyldKSIsInNjdCI6ImZ1bl9kZWYgPSBFeCgpLmNoZWNrX2Z1bmN0aW9uX2RlZihcImV4dHJhY3RfaW5mb1wiKS5tdWx0aShjaGVja19hcmdzKCdpbnB1dF9kZicpLCBjaGVja19hcmdzKCduYW1lJykpXG5mdW5fZGVmLmNoZWNrX2JvZHkoKVxuZnVuX2RlZi5jYWxsKFwiZih0aW1lc19kZiwgJ3RpbWVzJylcIilcbmZ1bl9kZWYuY2FsbChcImYoc2hhbmdoYWlfZGYsICdzaGFuZ2hhaScpXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwiYWxsX2luZm9cIilcbnN1Y2Nlc3NfbXNnKFwiQXdlc29tZSBqb2IhXCIpIn0=

Como você já deve ter notado, os datasets são bem diferentes. Eis algumas diferenças:

  • O dataset Times tem 14 colunas, enquanto o Shanghai tem 11
  • O Times tem 2603 linhas, enquanto o Shanghai tem 4897
  • Uma coluna importante ausente no Shanghai é o país da universidade. Se necessário, você pode obter essa informação a partir do Times mais tarde.

Assim, para usar ambos os DataFrames, precisamos selecionar apenas as colunas em comum. Com sorte, essas colunas têm conteúdo semelhante.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKSIsInNhbXBsZSI6ImNvbW1vbl9jb2x1bW5zID0gc2V0KHNoYW5naGFpX2RmLmNvbHVtbnMpICYgc2V0KHRpbWVzX2RmLmNvbHVtbnMpXG5cbiMgUmV0dXJuIGBjb21tb25fY29sdW1uc2BcbnByaW50KGNvbW1vbl9jb2x1bW5zKSIsInNvbHV0aW9uIjoiY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcblxuIyBSZXR1cm4gYGNvbW1vbl9jb2x1bW5zYFxucHJpbnQoY29tbW9uX2NvbHVtbnMpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcImNvbW1vbl9jb2x1bW5zXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiKSJ9

As colunas em comum são:

  • total_score: pontuação usada para determinar o ranking. Segundo a página do Kaggle, pode conter faixas (entre dois valores) e empates (com sinal = antes)
  • university_name: nome da universidade
  • world_rank: posição da universidade
  • year: ano do ranking

Para concatenar os dois dados, precisamos limpar algumas coisas antes. Aplique agora o pipeline completo para limpar os dados:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucykiLCJzYW1wbGUiOiIjIENsZWFuIHVwIHRoZSBgd29ybGRfcmFua2AgXG5kZWYgY2xlYW5fd29ybGRfcmFuayhpbnB1dF9kZik6XG4gICAgZGYgPSBpbnB1dF9kZi5jb3B5KClcbiAgICBkZi53b3JsZF9yYW5rID0gZGYud29ybGRfcmFuay5zdHIuc3BsaXQoJy0nKS5zdHJbMF].zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbiAgICBcbiMgQXNzaWduIHRoZSBjb21tb24geWVhcnMgb2YgYHNoYW5naGFpX2RmYCBhbmQgYHRpbWVzX2RmYCB0byBgY29tbW9uX3llYXJzYCAgICBcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcblxuIyBQcmludCBgY29tbW9uX3llYXJzYFxucHJpbnQoY29tbW9uX3llYXJzKVxuXG4jIEZpbHRlciB5ZWFyc1xuZGVmIGZpbHRlcl95ZWFyKGlucHV0X2RmLCB5ZWFycyk6XG4gICAgZGYgPSBpbnB1dF9kZi5jb3B5KClcbiAgICByZXR1cm4gZGYucXVlcnkoJ3llYXIgaW4ge30nLmZvcm1hdChsaXN0KHllYXJzKSkpXG5cbiMgQ2xlYW4gYHRpbWVzX2RmYCBhbmQgYHNoYW5naGFpX2RmYFxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpIiwic29sdXRpb24iOiIjIENsZWFuIHVwIHRoZSBgd29ybGRfcmFua2AgXG5kZWYgY2xlYW5fd29ybGRfcmFuayhpbnB1dF9kZik6XG4gICAgZGYgPSBpbnB1dF9kZi5jb3B5KClcbiAgICBkZi53b3JsZF9yYW5rID0gZGYud29ybGRfcmFuay5zdHIuc3BsaXQoJy0nKS5zdHJbMF0uc3RyLnNwbGl0KCc9Jykuc3RyWzBdXG4gICAgcmV0dXJuIGRmXG4gICAgXG4jIEFzc2lnbiB0aGUgY29tbW9uIHllYXJzIG9mIGBzaGFuZ2hhaV9kZmAgYW5kIGB0aW1lc19kZmAgdG8gYGNvbW1vbl95ZWFyc2AgICAgXG5jb21tb25feWVhcnMgPSBzZXQoc2hhbmdoYWlfZGYueWVhcikgJiBzZXQodGltZXNfZGYueWVhcikgXG5cbiMgUHJpbnQgYGNvbW1vbl95ZWFyc2BcbnByaW50KGNvbW1vbl95ZWFycylcblxuIyBGaWx0ZXIgeWVhcnNcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuXG4jIENsZWFuIGB0aW1lc19kZmAgYW5kIGBzaGFuZ2hhaV9kZmBcbmNsZWFuZWRfdGltZXNfZGYgPSAodGltZXNfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3RpbWVzJykpXG5jbGVhbmVkX3NoYW5naGFpX2RmID0gKHNoYW5naGFpX2RmLmxvY1s6LCBjb21tb25fY29sdW1uc11cbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShmaWx0ZXJfeWVhciwgY29tbW9uX3llYXJzKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGNsZWFuX3dvcmxkX3JhbmspXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLmFzc2lnbihuYW1lPSdzaGFuZ2hhaScpKSIsInNjdCI6ImZ1bl9kZWYxID0gRXgoKS5jaGVja19mdW5jdGlvbl9kZWYoXCJmaWx0ZXJfeWVhclwiKS5tdWx0aShjaGVja19hcmdzKCdpbnB1dF9kZicpLCBjaGVja19hcmdzKCd5ZWFycycpKVxuZnVuX2RlZjEuY2hlY2tfYm9keSgpXG5mdW5fZGVmMS5jYWxsKFwiZih0aW1lc19kZiwgY29tbW9uX3llYXJzKVwiKVxuZnVuX2RlZjEuY2FsbChcImYoc2hhbmdoYWlfZGYsIGNvbW1vbl95ZWFycylcIilcblxuRXgoKS50ZXN0X29iamVjdChcImNvbW1vbl95ZWFyc1wiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIilcblxuZnVuX2RlZiA9IEV4KCkuY2hlY2tfZnVuY3Rpb25fZGVmKFwiY2xlYW5fd29ybGRfcmFuayIpXG5mdW5fZGVmLmNoZWNrX2JvZHkoKVxuZnVuX2RlZi5jYWxsKFwiZih0aW1lc19kZilcIilcbmZ1bl9kZWYuY2FsbChcImYoc2hhbmdoYWlfZGYpXCIpXG5cbkV4KCkudGVzdF9vYmplY3QoXCJjbGVhbmVkX3RpbWVzX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwiY2xlYW5lZF9zaGFuZ2hhaV9kZlwiKVxuXG5zdWNjZXNzX21zZyhcIkF3ZXNvbWUgam9iIVwiKSJ9

Como você deve ter percebido, uso bastante o método .pipe neste tutorial. Se você vem do mundo R, provavelmente já está (de certa forma) familiarizado.

É um método útil do Pandas (desde a versão 0,16,2) que permite encadear operações e eliminar a necessidade de DataFrames intermediários. Seu código fica mais legível.

Sem esse operador, em vez de escrever df.pipe(f).pipe(g).pipe(h) você escreveria: h(g(f(df))). Isso fica difícil de acompanhar conforme o número de funções aninhadas cresce.

Para se aprofundar no tema, recomendo muito este post.

Agora que os dois DataFrames estão limpos, podemos concatená-los em um único DataFrame. E não se esqueça de limpar os dados ausentes:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpIiwic2FtcGxlIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNvbHV0aW9uIjoiIyBDb21wb3NlIGByYW5raW5nX2RmYCB3aXRoIGBjbGVhbmVkX3RpbWVzX2RmYCBhbmQgYGNsZWFuZWRfc2hhbmdoYWlfZGZgXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSlcblxuIyBDYWxjdWxhdGUgdGhlIHBlcmNlbnRhZ2Ugb2YgbWlzc2luZyBkYXRhXG5taXNzaW5nX2RhdGEgPSAxMDAgKiBwZC5pc251bGwocmFua2luZ19kZi50b3RhbF9zY29yZSkuc3VtKCkgLyBsZW4ocmFua2luZ19kZilcblxuIyBEcm9wIHRoZSBgdG90YWxfc2NvcmVgIGNvbHVtbiBvZiBgcmFua2luZ19kZmBcbnJhbmtpbmdfZGYgPSByYW5raW5nX2RmLmRyb3AoJ3RvdGFsX3Njb3JlJywgYXhpcz0xKSIsInNjdCI6IkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwibWlzc2luZ19kYXRhXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwicmFua2luZ19kZlwiKVxuc3VjY2Vzc19tc2coXCJZb3UgaGF2ZSBzdWNjZXNzZnVsbHkgaW1wcm92ZWQgeW91ciBkYXRhIHF1YWxpdHkhXCIpIn0=

Como cerca de 38% dos dados estão ausentes na coluna total_score, é melhor remover essa coluna com o método .drop.

3. Otimização de memória

Uma terceira forma de deixar seu código Pandas mais “idiomático” —neste caso, mais “performático”— é otimizando o uso de memória. Especialmente ao criar pipelines com encadeamento de métodos, a memória pode ter um grande impacto na velocidade. Veja mais sobre isso aqui.

Provavelmente é exagero para este dataset pequeno, mas costuma ser boa prática converter algumas colunas para tipos específicos e otimizar o consumo de memória. Para começar, vamos ver quanta memória ranking_df está usando com o método .info.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBQcmludCB0aGUgbWVtb3J5IHVzYWdlIG9mIGByYW5raW5nX2RmYCBcbnJhbmtpbmdfZGYuX19fXygpXG5cbiMgUHJpbnQgdGhlIGRlZXAgbWVtb3J5IHVzYWdlIG9mIGByYW5raW5nX2RmYCBcbnJhbmtpbmdfZGYuaW5mbyhtZW1vcnlfdXNhZ2U9XCJkZWVwXCIpIiwic29sdXRpb24iOiIjIFByaW50IHRoZSBtZW1vcnkgdXNhZ2Ugb2YgYHJhbmtpbmdfZGZgIFxucmFua2luZ19kZi5pbmZvKClcblxuIyBQcmludCB0aGUgZGVlcCBtZW1vcnkgdXNhZ2Ugb2YgYHJhbmtpbmdfZGZgIFxucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT1cImRlZXBcIikiLCJzY3QiOiJFeCgpLnRlc3RfZnVuY3Rpb24oXCJyYW5raW5nX2RmLmluZm9cIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJHcmVhdCFcIikifQ==

O resultado da primeira linha indica 144 KB. Porém, inspecionando os argumentos de .info, vemos o opcional memory_usage, que é None por padrão. O que acontece ao definir memory_usage como deep?

A nova pegada de memória fica 6 —5,6, mais precisamente— vezes maior que a estimativa inicial.

O que rolou aqui?

A diferença vem do fato de que, sem o modo “deep”, o Pandas não estima o consumo de memória para colunas do tipo object. Esse tipo (Python) ocupa mais espaço do que dtypes otimizados do numpy. Por isso, recomenda-se converter object para tipos mais apropriados (por exemplo, category quando os dados são categóricos).

Vamos fazer isso!

def memory_change(input_df, column, dtype):
    df = input_df.copy()
    old = round(df[column].memory_usage(deep=True) / 1024, 2) # In KB
    new = round(df[column].astype(dtype).memory_usage(deep=True) / 1024, 2)# In KB
    change = round(100 * (old - new) / (old), 2)
    report = ("The inital memory footprint for {column} is: {old}KB.\n" 
              "The casted {column} now takes: {new}KB.\n"
              "A change of {change} %.").format(**locals())
    return report

print(memory_change(ranking_df,'world_rank', 'int16'))
print(memory_change(ranking_df,'university_name', 'category'))
print(memory_change(ranking_df,'name', 'category'))

Agora que você sabe que, ao mudar world_rank para int16, por exemplo, a memória é usada de forma mais eficiente, é hora de aplicar as mudanças com astype(). Finalize conferindo novamente o consumo de memória:

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpIiwic2FtcGxlIjoiIyBDYXN0IGB3b3JsZF9yYW5rYCBhcyB0eXBlIGBpbnQxNmBcbnJhbmtpbmdfZGYud29ybGRfcmFuayA9IHJhbmtpbmdfZGYud29ybGRfcmFuay5fX19fX19fKCdpbnQxNicpXG5cbiMgQ2FzdCBgdW52ZXJzaXR5X25hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi51bml2ZXJzaXR5X25hbWUgPSByYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZS5hc3R5cGUoJ2NhdGVnb3J5JylcblxuIyBDYXN0IGBuYW1lYCBhcyB0eXBlIGBjYXRlZ29yeWBcbnJhbmtpbmdfZGYubmFtZSA9IHJhbmtpbmdfZGYuX19fXy5hc3R5cGUoJ2NhdGVnb3J5JylcblxuIyBEb3VibGUgY2hlY2sgdGhlIG1lbW9yeSB1c2FnZSBhZnRlciB0eXBlIGNhc3RpbmdcbnJhbmtpbmdfZGYuaW5mbyhtZW1vcnlfdXNhZ2U9J2RlZXAnKSIsInNvbHV0aW9uIjoiIyBDYXN0IGB3b3JsZF9yYW5rYCBhcyB0eXBlIGBpbnQxNmBcbnJhbmtpbmdfZGYud29ybGRfcmFuayA9IHJhbmtpbmdfZGYud29ybGRfcmFuay5hc3R5cGUoJ2ludDE2JylcblxuIyBDYXN0IGB1bnZlcnNpdHlfbmFtZWAgYXMgdHlwZSBgY2F0ZWdvcnlgXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIENhc3QgYG5hbWVgIGFzIHR5cGUgYGNhdGVnb3J5YFxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxuXG4jIERvdWJsZSBjaGVjayB0aGUgbWVtb3J5IHVzYWdlIGFmdGVyIHR5cGUgY2FzdGluZ1xucmFua2luZ19kZi5pbmZvKG1lbW9yeV91c2FnZT0nZGVlcCcpIiwic2N0IjoiRXgoKS50ZXN0X29iamVjdChcInJhbmtpbmdfZGZcIilcbkV4KCkudGVzdF9mdW5jdGlvbihcInJhbmtpbmdfZGYuaW5mb1wiKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Bem melhor. Você ainda pode otimizar convertendo a coluna year para int32.

4. GroupBy

Agora que temos um conjunto de dados bem formado (isto é, em estado tidy) e com memória otimizada, a análise pode começar.

Algumas perguntas que podem interessar:

  • Quais são as 5 melhores universidades dadas por cada sistema de ranking ao longo dos anos?
  • Quão diferentes são esses rankings a cada ano?

Vamos responder à primeira usando as técnicas idiomáticas vistas nas seções anteriores!

Antes de começar, repare que ‘Massachusetts Institute of Technology (MIT)’ e ‘Massachusetts Institute of Technology’ são dois registros diferentes da mesma universidade. Altere o primeiro nome para o segundo.

Nesses casos, a função loc, vista anteriormente, é especialmente útil!

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgUXVlcnkgZm9yIHRoZSByb3dzIHdpdGggdW5pdmVyc2l0eSBuYW1lICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1xucHJpbnQocmFua2luZ19kZi5fX19fXyhcInVuaXZlcnNpdHlfbmFtZSA9PSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSAoTUlUKSdcIikpXG5cbiMgTG9jYWxpemUgdGhlIHJvd3Mgd2l0aGUgTUlUIHVuaXZlcnNpdHkgbmFtZSBhbmQgcmVwbGFjZSB2YWx1ZSBcbnJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogZGYudW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJywgJ3VuaXZlcnNpdHlfbmFtZSddID0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3knXG5cbiMgUHJpbnQgYHJhbmtpbmdfZGZgXG5wcmludChfX19fX19fX19fKSIsInNvbHV0aW9uIjoiIyBRdWVyeSBmb3IgdGhlIHJvd3Mgd2l0aCB1bml2ZXJzaXR5IG5hbWUgJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknXG5wcmludChyYW5raW5nX2RmLnF1ZXJ5KFwidW5pdmVyc2l0eV9uYW1lID09ICdNYXNzYWNodXNldHRzIEluc3RpdHV0ZSBvZiBUZWNobm9sb2d5IChNSVQpJ1wiKSlcblxuIyBMb2NhbGl6ZSB0aGUgcm93cyB3aXRoIHRoZSBNSVQgdW5pdmVyc2l0eSBuYW1lIGFuZCByZXBsYWNlIHZhbHVlIFxucmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi51bml2ZXJzaXR5X25hbWUgPT0gJ01hc3NhY2h1c2V0dHMgSW5zdGl0dXRlIG9mIFRlY2hub2xvZ3kgKE1JVCknLC AndW5pdmVyc2l0eV9uYW1lJ10gPSAnTWFzc2FjaHVzZXR0cyBJbnN0aXR1dGUgb2YgVGVjaG5vbG9neSdcblxuIyBQcmludCBgcmFua2luZ19kZmBcbnByaW50KHJhbmtpbmdfZGYpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uKFwicHJpbnRcIiwgaW5kZXg9MSlcbkV4KCkudGVzdF9vYmplY3QoXCJyYW5raW5nX2RmXCIpXG5FeCgpLnRlc3RfZnVuY3Rpb24oXCJwcmludFwiLCBpbmRleD0yKVxuc3VjY2Vzc19tc2coXCJXZWxsIGRvbmUhXCIpIn0=

Para encontrar as 5 (no geral, n) melhores universidades ao longo dos anos, para cada sistema de ranking, o pseudo-código é:

  • Para cada ano (coluna year) e para cada sistema (coluna name):
  • Selecione o subconjunto referente a esse ano e sistema
  • Selecione as 5 melhores universidades e guarde em uma lista
  • Armazene o resultado em um dicionário com (year, name) como chave e a lista de universidades (em ordem decrescente) como valor

Vamos aplicar.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgTG9hZCBpbiBgaXRlcnRvb2xzYFxuaW1wb3J0IGl0ZXJ0b29sc1xuXG4jIEluaXRpYWxpemUgYHJhbmtpbmdgXG5yYW5raW5nID0ge31cblxuZm9yIHllYXIsIG5hbWUgaW4gaXRlcnRvb2xzLnByb2R1Y3QoY29tbW9uX3llYXJzLCBbXCJ0aW1lc1wiLCBcInNoYW5naGFpXCJdKTpcbiAgICBzID0gKHJhbmtpbmdfZGYubG9jW2xhbWJkYSBkZjogKChkZi55ZWFyID09IHllYXIpICYgKGRmLm5hbWUgPT0gbmFtZSlcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICYgKGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLDYpKSkpLCA6XVxuICAgICAgICAgICAgICAgICAgIC5zb3J0X3ZhbHVlcygnd29ybGRfcmFuaycsIGFzY2VuZGluZz1GYWxzZSlcbiAgICAgICAgICAgICAgICAgICAudW5pdmVyc2l0eV9uYW1lKVxuICAgIHJhbmtpbmdbKHllYXIsIG5hbWUpXSA9IGxpc3QocyklXG4gICAgXG5cbiMgUHJpbnQgYHJhbmtpbmdgXG5wcmludChyYW5raW5nKSJ9

Agora que temos esse dicionário de rankings, vamos medir o quanto (em %) os dois métodos diferem ao longo dos anos: eles são 100% semelhantes em conjunto se as 5 universidades selecionadas forem as mesmas, mesmo que em ordens diferentes.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IGl0ZXJ0b29sc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZyA9IHt9XG5mb3IgeWVhciwgbmFtZSBpbiBpdGVydG9vbHMucHJvZHVjdChjb21tb25feWVhcnMsIFtcInRpbWVzXCIsIFwic2hhbmdoYWlcIl0pOlxuICAgIHMgPSAocmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiAoKGRmLnllYXIgPT0geWVhcikgJiAoZGYubmFtZSA9PSBuYW1lKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgJiAoZGYud29ybGRfcmFuay5pc2luKHJhbmdlKDEsNikpKSksIDpdXG4gICAgICAgICAgICAgICAgICAgLnNvcnRfdmFsdWVzKCd3b3JsZF9yYW5rJywgYXNjZW5kaW5nPUZhbHNlKVxuICAgICAgICAgICAgICAgICAgIC51bml2ZXJzaXR5X25hbWUpXG4gICAgcmFua2luZ1soeWVhciwgbmFtZSldID0gbGlzdChzKSIsInNhbXBsZSI6IiMgSW1wb3J0IGBkZWZhdWx0ZGljdGBcbmZyb20gY29sbGVjdGlvbnMgaW1wb3J0IGRlZmF1bHRkaWN0XG5cbiMgSW5pdGlhbGl6ZSBgY29tcGFyZWBcbmNvbXBhcmUgPSBkZWZhdWx0ZGljdChsaXN0KVxuXG4jIEluaXRpYWxpemUgYGV4YWN0X3NpbWlsYXJpdHlgIGFuZCBgc2V0X3NpbWlsYXJpdHlgXG5leGFjdF9zaW1pbGFyaXR5ID0ge31cbnNldF9zaW1pbGFyaXR5ID0ge31cblxuZm9yICh5ZWFyLCBtZXRob2QpLCB1bml2ZXJzaXRpZXMgaW4gcmFua2luZy5pdGVtcygpOlxuICAgIGNvbXBhcmVbeWVhcl0uYXBwZW5kKHVuaXZlcnNpdGllcylcbiAgICBcbmZvciB5ZWFyLCByYW5rcyBpbiBjb21wYXJlLml0ZW1zKCk6XG4gICAgc2V0X3NpbWlsYXJpdHlbeWVhcl0gPSAxMDAgKiBsZW4oc2V0KHJhbmtzWzBdKSAmIHNldChyYW5rc1sxXSkpIC8gNS4wXG5cbiMgUHJpbnQgYHNldF9zaW1pbGFyaXR5YCAgXG5wcmludChzZXRfc2ltaWxhcml0eSkifQ==

Deu trabalho, né? Tem um jeito melhor —e mais idiomático— com Pandas?

Claro! Primeiro, filtre o DataFrame para manter apenas as 5 melhores universidades por ano e método de ranking. Confira o resultado com head():

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKSIsInNhbXBsZSI6IiMgQ29uc3RydWN0IGEgRGF0YUZyYW1lIHdpdGggdGhlIHRvcCA1IHVuaXZlcnNpdHllcyBcbnRvcF81X2RmID0gcmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi53b3JsZF9yYW5rLmlzaW4ocmFuZ2UoMSwgNikpLCA6XVxuXG4jIFByaW50IHRoZSBmaXJzdCByb3dzIG9mIGB0b3BfNV9kZmBcbnRvcF81X2RmLl9fX18oKSIsInNvbHV0aW9uIjoiIyBDb25zdHJ1Y3QgYSBEYXRhRnJhbWUgd2l0aGUgdGhlIHRvcCA1IHVuaXZlcnNpdHllcyBcbnRvcF81X2RmID0gcmFua2luZ19kZi5sb2NbbGFtYmRhIGRmOiBkZi53b3JsZF9yYW5rLmlzaW4ocmFuZ2UoMSwgNikpLCA6XVxuXG4jIFByaW50IHRoZSBmaXJzdCByb3dzIG9mIGB0b3BfNV9kZmBcbnRvcF81X2RmLmhlYWQoKSIsInNjdCI6IkV4KCkudGVzdF9vYmplY3QoXCJ0b3BfNV9kZlwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwidG9wXzVfZGYuaGVhZFwiKVxuc3VjY2Vzc19tc2coXCJHcmVhdCFcIikifQ

Com o DataFrame correto em mãos, vamos usar .groupby para comparar os dois métodos de ranking usando a similaridade de conjuntos definida acima.

eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIilcbnNoYW5naGFpX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3NoYW5naGFpRGF0YS5jc3YnKVxuY29tbW9uX2NvbHVtbnMgPSBzZXQoc2hhbmdoYWlfZGYuY29sdW1ucykgJiBzZXQodGltZXNfZGYuY29sdW1ucylcbmRlZiBjbGVhbl93b3JsZF9yYW5rKGlucHV0X2RmKTpcbiAgICBkZiA9IGlucHV0X2RmLmNvcHkoKVxuICAgIGRmLndvcmxkX3JhbmsgPSBkZi53b3JsZF9yYW5rLnN0ci5zcGxpdCgnLScpLnN0clswXS5zdHIuc3BsaXQoJz0nKS5zdHJbMF1cbiAgICByZXR1cm4gZGZcbmNvbW1vbl95ZWFycyA9IHNldChzaGFuZ2hhaV9kZi55ZWFyKSAmIHNldCh0aW1lc19kZi55ZWFyKSBcbmRlZiBmaWx0ZXJfeWVhcihpbnB1dF9kZiwgeWVhcnMpOlxuICAgIGRmID0gaW5wdXRfZGYuY29weSgpXG4gICAgcmV0dXJuIGRmLnF1ZXJ5KCd5ZWFyIGluIHt9Jy5mb3JtYXQobGlzdCh5ZWFycykpKVxuY2xlYW5lZF90aW1lc19kZiA9ICh0aW1lc19kZi5sb2NbOiwgY29tbW9uX2NvbHVtbnNdXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoZmlsdGVyX3llYXIsIGNvbW1vbl95ZWFycylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAucGlwZShjbGVhbl93b3JsZF9yYW5rKVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5hc3NpZ24obmFtZT0ndGltZXMnKSlcbmNsZWFuZWRfc2hhbmdoYWlfZGYgPSAoc2hhbmdoYWlfZGYubG9jWzosIGNvbW1vbl9jb2x1bW5zXVxuICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgIC5waXBlKGZpbHRlcl95ZWFyLCBjb21tb25feWVhcnMpXG4gICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgLnBpcGUoY2xlYW5fd29ybGRfcmFuaylcbiAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAgICAuYXNzaWduKG5hbWU9J3NoYW5naGFpJykpXG5yYW5raW5nX2RmID0gcGQuY29uY2F0KFtjbGVhbmVkX3RpbWVzX2RmLCBjbGVhbmVkX3NoYW5naGFpX2RmXSkuZHJvcCgndG90YWxfc2NvcmUnLCBheGlzPTEpXG5yYW5raW5nX2RmLndvcmxkX3JhbmsgPSByYW5raW5nX2RmLndvcmxkX3JhbmsuYXN0eXBlKCdpbnQxNicpXG5yYW5raW5nX2RmLnVuaXZlcnNpdHlfbmFtZSA9IHJhbmtpbmdfZGYudW5pdmVyc2l0eV9uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxucmFua2luZ19kZi5uYW1lID0gcmFua2luZ19kZi5uYW1lLmFzdHlwZSgnY2F0ZWdvcnknKVxudG9wXzVfZGYgPSByYW5raW5nX2RmLmxvY1tsYW1iZGEgZGY6IGRmLndvcmxkX3JhbmsuaXNpbihyYW5nZSgxLCA2KSksIDpdIiwic2FtcGxlIjoiIyBDb21wdXRlIHRoZSBzaW1pbGFyaXR5XG5kZWYgY29tcHV0ZV9zZXRfc2ltaWxhcml0eShzKTpcbiAgICBwaXZvdGVkID0gcy5waXZvdCh2YWx1ZXM9J3dvcmxkX3JhbmsnLCBjb2x1bW5zPSduYW1lJywgaW5kZXg9J3VuaXZlcnNpdHlfbmFtZScpLmRyb3BuYSgpXG4gICAgc2V0X3NpbWxhcml0eSA9IDEwMCAqIGxlbigoc2V0KHBpdm90ZWRbJ3NoYW5naGFpJ10uaW5kZXgpICYgc2V0KHBpdm90ZWRbJ3RpbWVzJ10uaW5kZXgpKSkgLyA1XG4gICAgcmV0dXJuIHNldF9zaW1sYXJpdHlcblxuIyBHcm91cCBgdG9wXzVfZGZgIGJ5IGB5ZWFyYCAgICBcbmdyb3VwZWRfZGYgPSB0b3BfNV9kZi5fX19fX19fKCd5ZWFyJylcblxuIyBVc2UgYGNvbXB1dGVfc2V0X3NpbWlsYXJpdHlgIHRvIGNvbnN0cnVjdCBhIERhdGFGcmFtZVxuc2V0c2ltaWxhcml0eV9kZiA9IHBkLkRhdGFGcmFtZSh7J3NldF9zaW1pbGFyaXR5JzogZ3JvdXBlZF9kZi5hcHBseShjb21wdXRlX3NldF9zaW1pbGFyaXR5KX0pLnJlc2V0X2luZGV4KClcblxuIyBQcmludCB0aGUgZmlyc3Qgcm93cyBvZiBgc2V0c2ltaWxhcml0eV9kZmBcbnNldHNpbWlsYXJpdHlfZGYuX19fXygpIiwic29sdXRpb24iOiIjIENvbXB1dGUgdGhlIHNpbWlsYXJpdHlcbmRlZiBjb21wdXRlX3NldF9zaW1pbGFyaXR5KHMpOlxuICAgIHBpdm90ZWQgPSBzLnBpdm90KHZhbHVlcz0nd29ybGRfcmFuaycsIGNvbW1vbnM9J25hbWUnLCBpbmRleD0ndW5pdmVyc2l0eV9uYW1lJykuZHJvcG5hKClcbiAgICBzZXRfc2ltbGFyaXR5ID0gMTAwICogbGVuKChzZXQocGl2b3RlZFsnc2hhbmdoYWknXS5pbmRleCkgJiBzZXQocGl2b3RlZFsndGltZXMnXS5pbmRleCkpKSAvIDVcbiAgICByZXR1cm4gc2V0X3NpbWxhcml0eVxuICAgIFxuIyBHcm91cCBgdG9wXzVfZGZgIGJ5IGB5ZWFyYCAgICBcbmdyb3VwZWRfZGYgPSB0b3BfNV9kZi5ncm91cGJ5KCd5ZWFyJylcblxuIyBVc2UgYGNvbXB1dGVfc2V0X3NpbWlsYXJpdHlgIHRvIGNvbnN0cnVjdCBhIERhdGFGcmFtZVxuc2V0c2ltaWxhcml0eV9kZiA9IHBkLkRhdGFGcmFtZSh7J3NldF9zaW1pbGFyaXR5JzogZ3JvdXBlZF9kZi5hcHBseShjb21wdXRlX3NldF9zaW1pbGFyaXR5KX0pLnJlc2V0X2luZGV4KClcblxuIyBQcmludCB0aGUgZmlyc3Qgcm93cyBvZiBgc2V0c2ltaWxhcml0eV9kZmBcbnNldHNpbWlsYXJpdHlfZGYuaGVhZCgpIiwic2N0IjoiRXgoKS50ZXN0X2Z1bmN0aW9uX2RlZihcImNvbXB1dGVfc2V0X3NpbWlsYXJpdHlcIilcbkV4KCkudGVzdF9vYmplY3QoXCJncm91cGVkX2RmXCIpXG5FeCgpLnRlc3Rfb2JqZWN0KFwic2V0c2ltaWxhcml0eV9kZlwiKVxuRXgoKS50ZXN0X2Z1bmN0aW9uKFwic2V0c2ltaWxhcml0eV9kZi5oZWFkXCIpXG5zdWNjZXNzX21zZyhcIldlbGwgZG9uZSFcIikifQ

Você obtém o mesmo resultado de antes com menos esforço.

5. Visualização

Agora que você já fez uma análise inicial, é hora de explorar visualmente. Código Pandas idiomático também significa aproveitar a integração de gráficos com Matplotlib. Assim, você cria ótimos gráficos em pouco tempo!

Nesta seção, vamos voltar aos datasets times_df e shanghai_df para criar algumas visualizações básicas com Matplotlib e Seaborn.
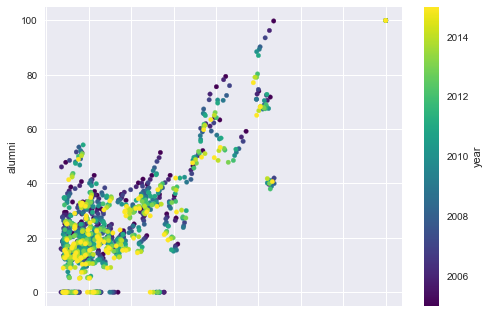
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuc2hhbmdoYWlfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvc2hhbmdoYWlEYXRhLmNzdicpIiwic2FtcGxlIjoiIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgYWx1bW5pYFxuc2hhbmdoYWlfZGYucGxvdC5zY2F0dGVyKCd0b3RhbF9zY29yZScsICdhbHVtbmknLCBjPSd5ZWFyJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

gráfico de dispersão

O gráfico acima deixa claro imediatamente que existem alguns valores 0 na coluna alumni. Isso é algo para ficar de olho ao explorar seus dados: com perfilamento de dados, você consegue ver esses zeros e tratá-los. Para saber mais, veja o tutorial de Data Profiling da DataCamp.

Ou, se houver valores que não fazem sentido no seu conjunto de dados, você pode simplesmente substituí-los por NaN e, em seguida, remover todos os NaN das colunas que dificultariam os gráficos. Note que isso é só um ajuste rápido e que provavelmente você vai precisar de um passo de data profiling mais completo para garantir a qualidade dos dados, pois ainda aparecem zeros na coluna num_students no gráfico abaixo:
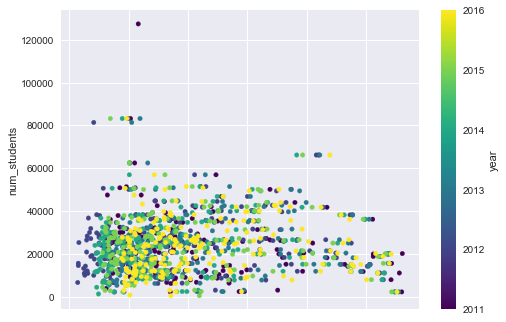
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxudGltZXNfZGYgPSBwZC5yZWFkX2NzdignaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdicsIHRob3VzYW5kcz1cIixcIikiLCJzYW1wbGUiOiIjIFJlcGxhY2UgYC1gIGVudHJpZXMgd2l0aCBOYU4gdmFsdWVzXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG5cbiMgRHJvcCBhbGwgcm93cyB3aXRoIE5hTiB2YWx1ZXMgZm9yIGBudW1fc3R1ZGVudHNgIFxudGltZXNfZGYgPSB0aW1lc19kZi5kcm9wbmEoc3Vic2V0PVsnbnVtX3N0dWRlbnRzJ10sIGhvdz0nYWxsJylcblxuIyBDYXN0IHRoZSByZW1haW5pbmcgcm93cyB3aXRoIGBudW1fc3R1ZGVudHNgIGFzIGludFxudGltZXNfZGZbJ251bV9zdHVkZW50cyddID0gdGltZXNfZGZbJ251bV9zdHVkZW50cyddLmFzdHlwZSgnaW50JylcblxuIyBQbG90IGEgc2NhdHRlcnBsb3Qgd2l0aCBgdG90YWxfc2NvcmVgIGFuZCBgbnVtX3N0dWRlbnRzYFxudGltZXNfZGYucGxvdC5zY2F0dGVyKCd0b3RhbF9zY29yZScsICdudW1fc3R1ZGVudHMnLCBjPSd5ZWFyJywgY29sb3JtYXA9J3ZpcmlkaXMnKVxuXG5wbHQuc2hvdygpIn0=

Claro, você não precisa se limitar ao Matplotlib. Existem outras bibliotecas para visualizar seus dados rapidamente, como o Seaborn.

Segundo o site oficial, o Seaborn é usado principalmente para criar gráficos estatísticos visualmente atraentes. De fato, antes da versão 2.0 do Matplotlib, era trabalhoso (embora possível) criar gráficos bonitos.

A combinação de Pandas com Seaborn também permite iterar rapidamente sobre seus dados por meio de visualizações.

Vamos ver alguns exemplos!

Confira o gráfico a seguir, em que contamos quantas vezes um país aparece nos dados, pegamos as dez primeiras ocorrências e garantimos que a ordenação do barplot vai do maior para o menor:
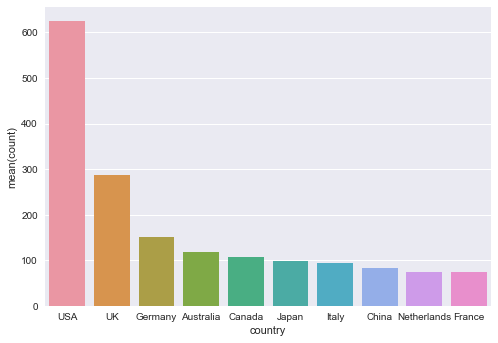
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbWF0cGxvdGxpYi5weXBsb3QgYXMgcGx0XG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpIiwic2FtcGxlIjoiIyBBYmJyZXZpYXRlIGNvdW50cnkgbmFtZXMgb2YgVW5pdGVkIFN0YXRlcyBhbmQgVW5pdGVkIEtpbmdkb21cbnRpbWVzX2RmWydjb3VudHJ5J10gPSB0aW1lc19kZlsnY291bnRyeSddLnJlcGxhY2UoXCJVbml0ZWQgU3RhdGVzIG9mIEFtZXJpY2FcIiwgXCJVU0FcIikucmVwbGFjZShcIlVuaXRlZCBLaW5nZG9tXCIsIFwiVUtcIilcblxuIyBDb3VudCB0aGUgZnJlcXVlbmN5IG9mIGNvdW50cmllcyBcbmNvdW50ID0gdGltZXNfZGZbJ2NvdW50cnknXS52YWx1ZV9jb3VudHMoKVs6MTBdXG5cbiMgQ29udmVydCB0aGUgdG9wIDEwIGNvdW50cmllcyB0byBhIERhdGFGcmFtZSBcbmRmID0gY291bnQudG9fZnJhbWUoKVxuXG4jIFJlc2V0IHRoZSBpbmRleCBcbmRmLnJlc2V0X2luZGV4KGxldmVsPTAsIGlucGxhY2U9VHJ1ZSlcblxuIyBSZW5hbWUgdGhlIGNvbHVtbnNcbmRmLmNvbHVtbnMgPSBbJ2NvdW50cnknLCAnY291bnQnXVxuXG4jIFBsb3QgYSBiYXJwbG90IHdpdGggYGNvdW50cnlgIGFuZCBgY291bnRgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0nY291bnQnLCBkYXRhPWRmKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

gráfico de barras

Depois, você pode plotar esses países e suas pontuações médias:
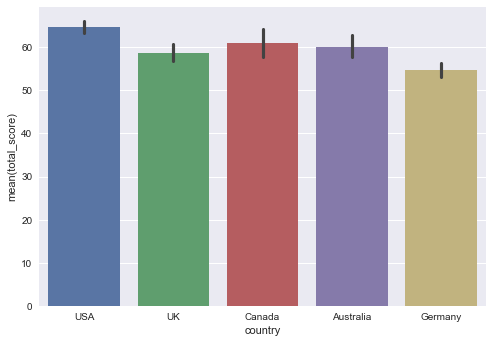
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHBhbmRhcyBhcyBwZFxuaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdCBcbmltcG9ydCBzZWFib3JuIGFzIHNuc1xudGltZXNfZGYgPSBwZC5yZWFkX2NzdihcImh0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3ZcIiwgdGhvdXNhbmRzPVwiLFwiKVxudGltZXNfZGZbJ2NvdW50cnknXSA9IHRpbWVzX2RmWydjb3VudHJ5J10ucmVwbGFjZShcIlVuaXRlZCBTdGF0ZXMgb2YgQW1lcmljYVwiLCBcIlVTQVwiKS5yZXBsYWNlKFwiVW5pdGVkIEtpbmdkb21cIiwgXCJVS1wiKVxudGltZXNfZGZbJ3RvdGFsX3Njb3JlJ109IHRpbWVzX2RmWyd0b3RhbF9zY29yZSddLnJlcGxhY2UoXCItXCIsIFwiTmFOXCIpLmFzdHlwZSgnZmxvYXQnKVxudGltZXNfZGZfZmlsdGVyZWQ9IHRpbWVzX2RmLnF1ZXJ5KCdjb3VudHJ5ID09XCJVU0FcIiBvciBjb3VudHJ5PT1cIkNhbmFkYVwiIG9yIGNvdW50cnkgPT1cIlVLXCIgb3IgY291bnRyeT09XCJHZXJtYW55XCIgb3IgY291bnRyeT09XCJBdXN0cmFsaWFcIicpIiwic2FtcGxlIjoiIyBCYXJwbG90IHdpdGggYGNvdW50cnlgIGFuZCBgdG90YWxfc2NvcmVgXG5zbnMuYmFycGxvdCh4PSdjb3VudHJ5JywgeT0ndG90YWxfc2NvcmUnLCBkYXRhPXRpbWVzX2RmX2ZpbHRlcmVkKVxuc25zLmRlc3BpbmUoKVxuXG5wbHQuc2hvdygpIn0=

plot

Seus gráficos também podem ficar bem complexos. Veja o pairplot a seguir, feito para mostrar com clareza as relações par-a-par em um dataset:

import numpy as np

np.seterr(invalid='ignore')

sns.pairplot(times_df, hue='country')

plt.show()
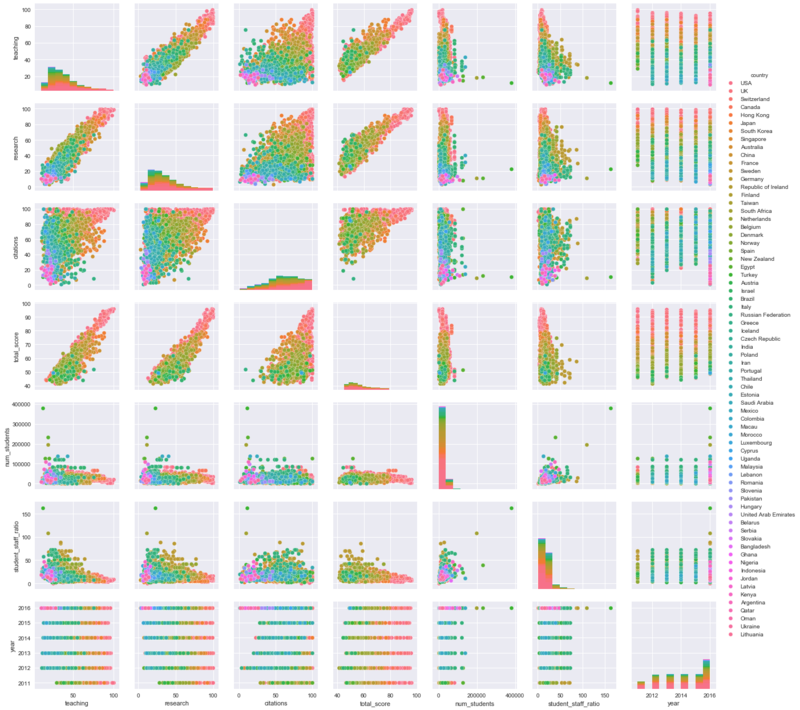
gráficos

Da mesma forma, você pode testar esta combinação de FacetGrid e regplot, que mostra a evolução do total_score ao longo dos anos para os 5 principais países:
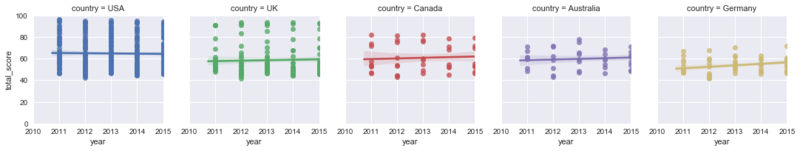
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgcGFuZGFzIGFzIHBkXG50aW1lc19kZiA9IHBkLnJlYWRfY3N2KFwiaHR0cHM6Ly9zMy5hbWF6b25hd3MuY29tL2Fzc2V0cy5kYXRhY2FtcC5jb20vYmxvZ19hc3NldHMvdGltZXNEYXRhLmNzdlwiLCB0aG91c2FuZHM9XCIsXCIpXG50aW1lc19kZlsnY291bnRyeSddID0gdGltZXNfZGZbJ2NvdW50cnknXS5yZXBsYWNlKFwiVW5pdGVkIFN0YXRlcyBvZiBBbWVyaWNhXCIsIFwiVVNBXCIpLnJlcGxhY2UoXCJVbml0ZWQgS2luZ2RvbVwiLCBcIlVLXCIpXG50aW1lc19kZlsndG90YWxfc2NvcmUnXT0gdGltZXNfZGZbJ3RvdGFsX3Njb3JlJ10ucmVwbGFjZShcIi1cIiwgXCJOYU5cIikuYXN0eXBlKCdmbG9hdCcpXG50aW1lc19kZl9maWx0ZXJlZD0gdGltZXNfZGYucXVlcnkoJ2NvdW50cnkgPT1cIlVTQVwiIG9yIGNvdW50cnk9PVwiQ2FuYWRhXCIgb3IgY291bnRyeSA9PVwiVUtcIiBvciBjb3VudHJ5PT1cIkdlcm1hbnlcIiBvciBjb3VudHJ5PT1cIkF1c3RyYWxpYVwiJykiLCJzYW1wbGUiOiIjIEZpbHRlciBvdXQgcm93cyB3aXRoIE5hTiBlbnRyeSBmb3IgYHRvdGFsX3Njb3JlYFxudGltZXNfZGZfZmlsdGVyZWQgPSB0aW1lc19kZl9maWx0ZXJlZC5kcm9wbmEoc3Vic2V0PVsndG90YWxfc2NvcmUnXSwgaG93PSdhbGwnKVxuXG5nID0gc25zLkZhY2V0R3JpZCh0aW1lc19kZl9maWx0ZXJlZCwgY29sPSdjb3VudHJ5JywgaHVlPSdjb3VudHJ5JylcbmcubWFwKHNucy5yZWdwbG90LCAneWVhcicsICd0b3RhbF9zY29yZScpLnNldCh4bGltPSgyMDEwLCAyMDE1KSwgeWxpbT0oMCwxMDApKVxuZy5maWcuc3VicGxvdHNfYWRqdXN0KHdzcGFjZT0uMikifQ==

idiomatic pandas tutorial

Por fim, um gráfico de correlação também ajuda bastante na exploração. Use a função heatmap() do Seaborn para isso:
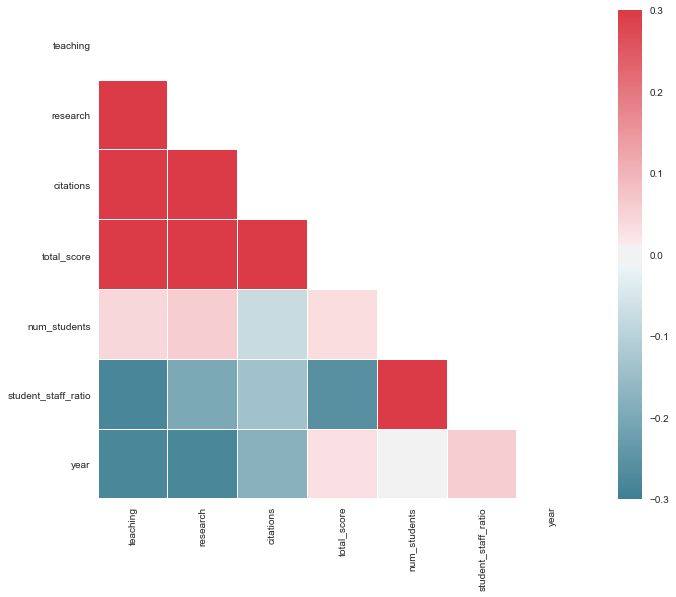
eyJsYW5ndWFnZSI6InB5dGhvbiIsInByZV9leGVyY2lzZV9jb2RlIjoiaW1wb3J0IHNlYWJvcm4gYXMgc25zXG5pbXBvcnQgbnVtcHkgYXMgbnBcbmltcG9ydCBwYW5kYXMgYXMgcGRcbnRpbWVzX2RmID0gcGQucmVhZF9jc3YoJ2h0dHBzOi8vczMuYW1hem9uYXdzLmNvbS9hc3NldHMuZGF0YWNhbXAuY29tL2Jsb2dfYXNzZXRzL3RpbWVzRGF0YS5jc3YnLCB0aG91c2FuZHM9XCIsXCIpIiwic2FtcGxlIjoiaW1wb3J0IG1hdHBsb3RsaWIucHlwbG90IGFzIHBsdFxuXG5zbnMuc2V0KHN0eWxlPVwid2hpdGVcIilcblxuIyBDb21wdXRlIHRoZSBjb3JyZWxhdGlvbiBtYXRyaXhcbmNvcnIgPSB0aW1lc19kZi5jb3JyKClcblxuIyBHZW5lcmF0ZSBhIG1hc2sgZm9yIHRoZSB1cHBlciB0cmlhbmdsZVxubWFzayA9IG5wLnplcm9zX2xpa2UoY29yciwgZHR5cGU9bnAuYm9vbClcbm1hc2tbbnAudHJpdV9pbmRpY2VzX2Zyb20obWFzayldID0gVHJ1ZVxuXG4jIFNldCB1cCB0aGUgbWF0cGxvdGxpYiBmaWd1cmVcbmYsIGF4ID0gcGx0LnN1YnBsb3RzKGZpZ3NpemU9KDExLCA5KSlcblxuIyBHZW5lcmF0ZSBhIGN1c3RvbSBkaXZlcmdpbmcgY29sb3JtYXBcbmNtYXAgPSBzbnMuZGl2ZXJnaW5nX3BhbGV0dGUoMjIwLCAxMCwgYXNfY21hcD1UcnVlKVxuXG4jIERyYXcgdGhlIGhlYXRtYXAgd2l0aCB0aGUgbWFzayBhbmQgY29ycmVjdCBhc3BlY3QgcmF0aW9cbnNucy5oZWF0bWFwKGNvcnIsIG1hc2s9bWFzaywgY21hcD1jbWFwLCB2bWF4PS4zLFxuICAgICAgICAgICAgc3F1YXJlPVRydWUsIGxpbmV3aWR0aHM9LjUsIGF4PWF4KVxuICAgICAgICAgICAgXG5wbHQuc2hvdygpIn0=

gráfico

Daria para seguir com mais e mais visualizações, então melhor parar por aqui :)

Próximos passos

É isso! Espero que você tenha curtido aprender técnicas intermediárias com Pandas e, em especial, como escrever código mais idiomático.

Se você gostou deste post e quer se aprofundar em performance com Pandas, recomendo muito o seguinte material:

Tópicos
Python
Ciência de dados

Cursos de Pandas

Curso

Python intermediário

4 h
1.4M
Aumente o nível de suas habilidades em ciência de dados criando visualizações usando Matplotlib e manipulando DataFrames com pandas.
Ver detalhesRight Arrow
Iniciar Curso
Ver maisRight Arrow