{count, plural, one {Cursus} other {Cursussen}}
Introductie tot Deep Learning met Keras
{hours} uur
46.4K
Je gebruikt een 3T-MRI-hersendataset om je netwerk te trainen. Om de effectiviteit van je model te beoordelen, test je je model op:
Deze tutorial gaat niet in op de finesses van medische beeldvorming, maar focust op het deep-learninggedeelte! Let op: deze tutorial behandelt hoofdzakelijk de praktische implementatie van convolutionele auto-encoders. Als je nog niet bekend bent met convolutionele neurale netwerken (CNN) en auto-encoders, kijk dan eens naar de tutorials over CNN en Autoencoder. Het mooiste van deze tutorial is dat je de 3D-volumes als 2D-beelden laadt en die aan het model voert. Kort samengevat behandel je vandaag het volgende:
Voor medische beeldvorming worden uiteenlopende systemen gebruikt, van open MRI-units met een magnetische veldsterkte van 0,3 Tesla (T) tot extremiteits-MRI-systemen met veldsterktes tot 1,0 T en whole-body scanners met veldsterktes tot 3,0 T (in klinisch gebruik). Tesla is de eenheid waarin de kwantitatieve sterkte van het magnetisch veld van MR-beelden wordt gemeten. Hoogveld-MR-scanners (7T, 11,5T) leveren een hogere SNR (signal-to-noise ratio), zelfs bij kleinere voxelgroottes (een driedimensionale patch of rooster), en zijn daarom te verkiezen voor een nauwkeurigere diagnose.
Een kleinere voxelgrootte leidt tot een betere resolutie, wat op zijn beurt de klinische diagnose kan ondersteunen. De gebruikte magnetische veldsterkte in de MR-scanner legt echter een ondergrens op aan de voxelgrootte om een goede signaal-ruisverhouding (SNR) te behouden en zo de details van het MR-beeld te bewaren.
Ondanks de superieure beeldkwaliteit van 7T en 11,5T worden ze zelden in productie ingezet vanwege kostenbeperkingen.
Volgens recente publicaties zijn er naar schatting ~20.000 3T-scanners tegenover slechts ~40 7T-scanners.
De MRI-hersendataset bestaat uit 3D-volumes; elk volume bevat in totaal 207 slices/beelden van MRI’s die op verschillende hersenslices zijn genomen. Elke slice heeft de afmeting 173 x 173. De beelden zijn enkelkanaals-grijswaardenbeelden. Er zijn in totaal 30 proefpersonen, waarbij elke proefpersoon de MRI-scan van een patiënt bevat. Het beeldformaat is geen jpeg, png enz., maar nifti-formaat. In een later gedeelte zie je hoe je beelden in nifti-formaat leest.
De dataset bevat MR-beelden met T1-modaliteit; T1-sequenties worden traditioneel als goed beschouwd voor de evaluatie van anatomische structuren. De dataset waarmee je vandaag werkt, bestaat uit 3T-hersen-MRI’s.
De dataset is openbaar en kan worden gedownload via deze bron.
Tip: wil je leren hoe je een Multi-Layer Perceptron (MLP) implementeert voor classificatietaken met de MNIST-dataset, bekijk dan deze tutorial.
Let op : voordat je begint, houd er rekening mee dat het model wordt getraind op een systeem met een Nvidia 1080 Ti GPU, Xeon e5 GeForce-processor en 32 GB RAM. Als je Jupyter Notebook gebruikt, moet je drie extra regels code toevoegen waarin je de CUDA device order en de zichtbare CUDA-apparaten opgeeft met behulp van de module os.
In onderstaande code stel je in feite omgevingsvariabelen in de notebook in met os.environ. Het is handig dit vóór de initialisatie van Keras te doen om de Keras-backend TensorFlow te beperken tot de eerste GPU. Als de machine waarop je traint een GPU op 0 heeft, gebruik dan 0 in plaats van 1. Je kunt dit controleren door een eenvoudige opdracht in je terminal uit te voeren, bijvoorbeeld nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Eerst importeer je alle benodigde modules zoals cv2, numpy, matplotlib en vooral keras, omdat je dat framework in deze tutorial gebruikt!
Om beelden in nifti-formaat te kunnen lezen, moet je ook een module genaamd nibabel importeren.
import os
import cv2
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
Using TensorFlow backend.
import numpy as np
import scipy.misc
import numpy.random as rng
from PIL import Image, ImageDraw, ImageFont
from sklearn.utils import shuffle
import nibabel as nib #reading MR images
from sklearn.cross_validation import train_test_split
import math
import glob
from matplotlib import pyplot as plt
%matplotlib inline
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:44: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also note that the interface of the new CV iterators are different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
Je gebruikt de glob-module die een lijst teruggeeft met alle volumes in de door jou opgegeven map!
ff = glob.glob('ground3T/*')
Laten we het eerste element van de lijst printen en ook de lengte van de lijst controleren: die zou in ons geval 30 moeten zijn.
ff[0]
'ground3T/181232.nii.gz'
len(ff)
30
Nu ben je klaar om de 3D-volumes te laden met nibabel. Let op: wanneer je een Nifti-volume laadt, laadt Nibabel de beeldarray niet meteen. Het wacht totdat je om de arraydata vraagt. De gebruikelijke manier om de arraydata op te vragen is door de methode get_data() aan te roepen.
Omdat je 2D-slices wilt in plaats van 3D, initialiseer je een lijst waarin je, telkens wanneer je een volume leest, over alle 207 slices van het 3D-volume itereert en elke slice één voor één aan een lijst toevoegt.
images = []
Laten we ook de vorm (shape) van een van de 3D-volumes printen; die zou 173 x 207 x 173 (x-, y-, z-coördinaten) moeten zijn.
Let op: je gebruikt alleen de middelste 51 slices van de hersenen en niet alle 207 slices. Laten we dus ook bekijken hoe je alleen de middelste slices gebruikt en ze laadt.
for f in range(len(ff)):
    a = nib.load(ff[f])
    a = a.get_data()
    a = a[:,78:129,:]
    for i in range(a.shape[1]):
        images.append((a[:,i,:]))
print (a.shape)
(173, 51, 173)
Laten we de vorm van één slice uit de 207 slices analyseren.
a[:,0,:].shape
(173, 173)
Aangezien images een lijst is, gebruik je de numpy-module om de lijst om te zetten naar een numpy-array.
images = np.asarray(images)
Tijd om de vorm van de numpy-array te controleren; de eerste dimensie van de array zou respectievelijk 207 x 30 = 6210 moeten zijn en de overige twee dimensies 173 x 173.
images.shape
(1530, 173, 173)
De beelden in de dataset zijn inderdaad grijswaarden met een afmeting van 173 x 173, dus vóórdat we de data aan het model voeren, is het belangrijk om te preprocessen. Je zet eerst elk 173 x 173-beeld om naar een matrix van 173 x 173 x 1, die je in het netwerk kunt voeren:
images = images.reshape(-1, 173,173,1)
images.shape
(1530, 173, 173, 1)
Schaal vervolgens de data met behulp van max-min-normalisatie:
m = np.max(images)
mi = np.min(images)
m, mi
(3599.0959, -341.83853)
images = (images - mi) / (m - mi)
Laten we de minimale en maximale waarde van de data verifiëren; die zouden 0,0 en 1,0 moeten zijn na het reschalen!
np.min(images), np.max(images)
(0.0, 1.0)
Dit is een belangrijke stap: hier pad je de beelden met nullen aan de randen zodat de afmetingen even zijn en het makkelijker is om het beeld telkens met een factor twee te downsamplen in het model. Laten we drie rijen en drie kolommen nullen toevoegen om de afmeting 176 x 176 te maken
temp = np.zeros([1530,176,176,1])
temp[:,3:,3:,:] = images
images = temp
Daarna is het belangrijk om de data te splitsen. Om je model goed te laten generaliseren, splits je de data in twee delen: een trainings- en een validatieset. Je traint je model op 80% van de data en valideert op 20% van de resterende trainingsdata.
Dit helpt ook om de kans op overfitting te verkleinen, omdat je je model valideert op data die het in de trainingsfase niet heeft gezien.
Je kunt de module train_test_split uit scikit-learn gebruiken om de data netjes te verdelen:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images,
                                                             images,
                                                             test_size=0.2,
                                                             random_state=13)
Let op dat je voor deze taak geen trainings- en testlabels nodig hebt. Daarom geef je de trainingsbeelden twee keer door. Je trainingsbeelden fungeren zowel als input als als ground truth, vergelijkbaar met labels bij een classificatietaak.
Laten we nu bekijken hoe de beelden in de dataset eruitzien en nogmaals de afmetingen van de beelden checken, aangezien je drie extra rijen en kolommen hebt toegevoegd met behulp van het NumPy-arrayattribuut .shape:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images.shape))
Dataset (images) shape: (1530, 176, 176, 1)
Uit de bovenstaande output zie je dat de data de vorm 6210 x 176 x 176 heeft, aangezien er 6210 samples zijn, elk met een matrix van 176 x 176 x 1.
Laten we nu naar een paar trainings- en validatiebeelden in je dataset kijken:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(valid_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7ff67d5d59b0>
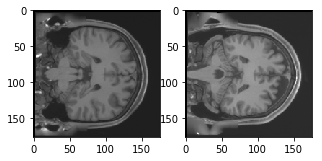
De output van de twee bovenstaande plots komt uit de trainings- en validatieset. Je ziet dat de trainings- en validatiebeelden verschillend zijn; het wordt interessant om te zien of de convolutionele auto-encoder de kenmerken kan leren en deze beelden goed reconstrueert.
Nu ben je klaar om het netwerk te definiëren en de data erin te voeren. Dus zonder verder oponthoud: door naar de volgende stap!
De beelden hebben het formaat 176 x 176 x 1, oftewel een vector van 30.976 dimensies. Je zet de beeldmatrix om naar een array, schaalt die tussen 0 en 1, vormt die om tot 176 x 176 x 1 en voedt dit als input aan het netwerk.
Bovendien gebruik je een batchgrootte van 128; een hogere batchgrootte van 256 of 512 is ook prima — het hangt af van het systeem waarop je je model traint. Dit draagt sterk bij aan de leerparameters en beïnvloedt de voorspellingsnauwkeurigheid. Je traint je netwerk 50 epochs.
batch_size = 128
epochs = 300
inChannel = 1
x, y = 176, 176
input_img = Input(shape = (x, y, inChannel))
Zoals je waarschijnlijk al weet, is de auto-encoder in twee delen verdeeld: een encoder en een decoder.
Encoder: bevat 3 convolutionele blokken; elk blok heeft een convolutielaag gevolgd door een batchnormalisatielaag. Na het eerste en tweede convolutionele blok wordt een max-poolinglaag gebruikt.
Decoder: bevat 2 convolutionele blokken; elk blok heeft een convolutielaag gevolgd door een batchnormalisatielaag. Na het eerste en tweede convolutionele blok wordt een upsamplinglaag gebruikt.
De max-poolinglaag downsamplet de input telkens met een factor twee wanneer je die gebruikt, terwijl de upsamplinglaag de input telkens met een factor twee opwaardeert.
Let op: het aantal filters, de filtergrootte, het aantal lagen en het aantal epochs waarop je je model traint zijn allemaal hyperparameters en zouden op basis van je eigen intuïtie gekozen moeten worden; je bent vrij om nieuwe experimenten te proberen door met deze hyperparameters te spelen en de prestaties van je model te meten. Zo leer je stap voor stap de kunst van deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)


    #decoder
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Nadat het model is aangemaakt, moet je het compileren met de optimizer RMSProp.
Let op dat je ook het type verliesfunctie moet opgeven via het argument loss. In dit geval is dat de mean squared error, aangezien het verlies na elke batch wordt berekend tussen de batch met voorspelde output en de ground truth, pixel voor pixel via de mean squared error:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Laten we de lagen die je in de stap hierboven hebt gemaakt visualiseren met de summary-functie; deze toont het aantal parameters (gewichten en bias) in elke laag en ook het totaal aantal parameters in je model.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 176, 176, 1)       0
_________________________________________________________________
conv2d_18 (Conv2D)           (None, 176, 176, 32)      320
_________________________________________________________________
batch_normalization_11 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
conv2d_19 (Conv2D)           (None, 176, 176, 32)      9248
_________________________________________________________________
batch_normalization_12 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
max_pooling2d_5 (MaxPooling2 (None, 88, 88, 32)        0
_________________________________________________________________
conv2d_20 (Conv2D)           (None, 88, 88, 64)        18496
_________________________________________________________________
batch_normalization_13 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
conv2d_21 (Conv2D)           (None, 88, 88, 64)        36928
_________________________________________________________________
batch_normalization_14 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
max_pooling2d_6 (MaxPooling2 (None, 44, 44, 64)        0
_________________________________________________________________
conv2d_22 (Conv2D)           (None, 44, 44, 128)       73856
_________________________________________________________________
batch_normalization_15 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_23 (Conv2D)           (None, 44, 44, 128)       147584
_________________________________________________________________
batch_normalization_16 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_24 (Conv2D)           (None, 44, 44, 64)        73792
_________________________________________________________________
batch_normalization_17 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 44, 44, 64)        36928
_________________________________________________________________
batch_normalization_18 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
up_sampling2d_5 (UpSampling2 (None, 88, 88, 64)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 88, 88, 32)        18464
_________________________________________________________________
batch_normalization_19 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 88, 88, 32)        9248
_________________________________________________________________
batch_normalization_20 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
up_sampling2d_6 (UpSampling2 (None, 176, 176, 32)      0
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 176, 176, 1)       289
=================================================================
Total params: 427,713
Trainable params: 426,433
Non-trainable params: 1,280
_________________________________________________________________
Het is eindelijk tijd om het model te trainen met Keras’ fit()-functie! Het model traint 50 epochs. De fit()-functie retourneert een history-object; door het resultaat hiervan op te slaan in fashion_train kun je het later gebruiken om de verliesfunctie tussen training en validatie te plotten, wat je helpt om de prestaties van je model visueel te analyseren.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 1224 samples, validate on 306 samples
Epoch 1/300
1224/1224 [==============================] - 7s - loss: 0.1201 - val_loss: 0.0838
Epoch 2/300
1224/1224 [==============================] - 7s - loss: 0.0492 - val_loss: 0.0534
...
Epoch 299/300
1224/1224 [==============================] - 7s - loss: 1.3101e-04 - val_loss: 6.1086e-04
Epoch 300/300
1224/1224 [==============================] - 7s - loss: 1.0711e-04 - val_loss: 3.9641e-04
Eindelijk! Je hebt het model op de vingerafdrukdataset getraind voor 200 epochs. Laten we nu de verliescurve tussen training en validatie plotten om de modelprestaties te visualiseren.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(300)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
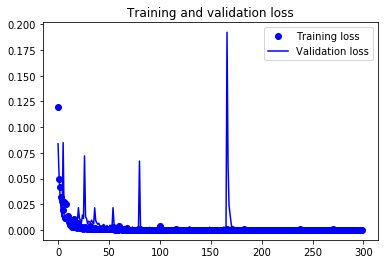
Je ziet dat het validatieverlies en het trainingsverlies in de pas lopen. Dit laat zien dat je model niet overfit: het validatieverlies neemt af in plaats van toe te nemen, en er is zelden een grote kloof tussen trainings- en validatieverlies gedurende de hele trainingsfase.
Daarom kun je zeggen dat de generalisatiecapaciteit van je model goed is.
Het is nu tijd om de testbeelden te reconstrueren met de predict()-functie van Keras en te zien hoe goed je model reconstrueert op de testdata.
Laten we nu het getrainde model opslaan. Dat is een belangrijke stap bij Deep Learning. De gewichten zijn immers het hart van de oplossing voor het probleem dat je aanpakt!
Je kunt op elk moment de opgeslagen gewichten in hetzelfde model laden en verder trainen vanaf waar je was gestopt. Bijvoorbeeld: als je het bovenstaande model opnieuw traint, zullen parameters zoals gewichten, bias en de verliesfunctie niet vanaf nul beginnen en is het geen frisse training meer.
Met slechts één regel code kun je de gewichten opslaan en weer in het model laden.
autoencoder = autoencoder.save_weights('autoencoder_mri.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder_mri.h5')
Aangezien je hier geen testdata hebt, gebruiken we de validatiedata om te voorspellen met het model dat je zojuist hebt getraind.
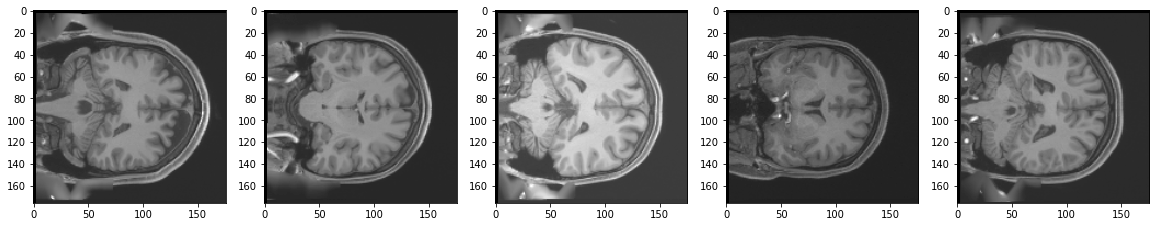
Je laat het getrainde model voorspellingen doen op de resterende 306 validatiebeelden en plot een paar van de gereconstrueerde beelden om te visualiseren hoe goed je model de validatiebeelden reconstrueert.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
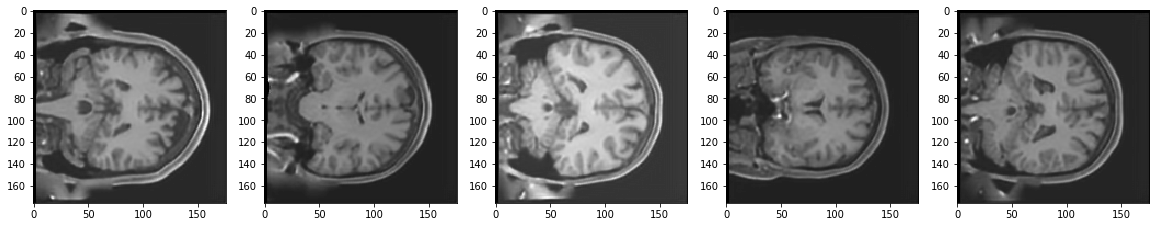
Uit de bovenstaande figuren kun je opmaken dat je model een fantastische prestatie heeft geleverd bij het reconstrueren van de testbeelden die je met het model hebt voorspeld. Althans kwalitatief lijken de test- en gereconstrueerde beelden vrijwel identiek.
Misschien kan het nog net iets beter presteren bij het reconstrueren van enkele lokale details in de oorspronkelijke 3T-beelden.
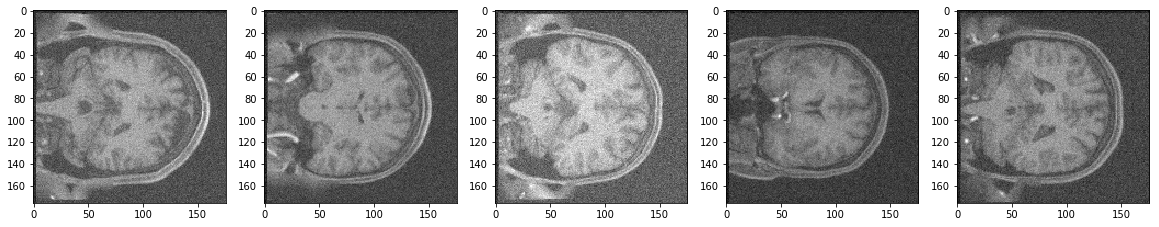
Voeg eerst wat ruis toe aan de validatiebeelden met een gemiddelde van nul en een standaarddeviatie van 0,03.
[a,b,c,d]= np.shape(valid_X)
mean = 0
sigma = 0.03
gauss = np.random.normal(mean,sigma,(a,b,c,d))
noisy_images = valid_X + gauss
Tijd om te voorspellen op de ruisachtige validatiebeelden. Laten we zien hoe goed je model presteert op ruisachtige beelden, ondanks dat het daar niet op is getraind.
pred_noisy = autoencoder.predict(noisy_images)
plt.figure(figsize=(20, 4))
print("Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(noisy_images[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred_noisy[i, ..., 0], cmap='gray')
plt.show()
Noisy Test Images
Reconstruction of Noisy Test Images
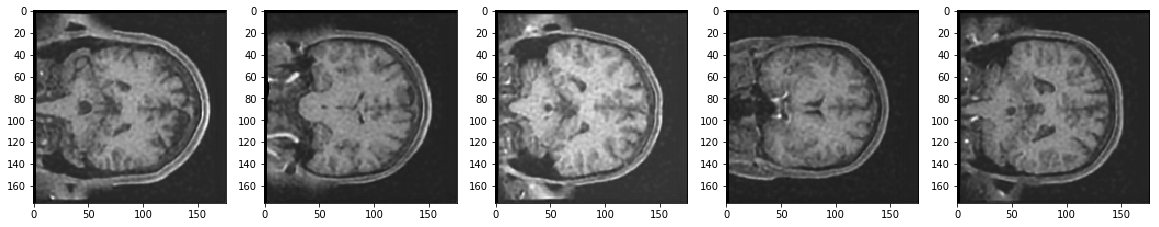
Het lijkt erop dat het model het behoorlijk goed doet. Toch? Uiteindelijk zien de gereconstrueerde beelden er beter uit dan de ruisachtige beelden. Bovendien heeft het model tijdens de training nooit ruisachtige beelden gezien.
Het PSNR-blok berekent de peak signal-to-noise ratio, in decibel (dB), tussen twee beelden. Deze ratio wordt vaak gebruikt als kwaliteitsmaat tussen het origineel en een gereconstrueerd beeld. Hoe hoger de PSNR, hoe beter de kwaliteit van het gereconstrueerde beeld.
Laten we eerst de prestaties van de validatiebeelden en de gereconstrueerde validatiebeelden berekenen.
valid_pred = autoencoder.predict(valid_X)
mse =  np.mean((valid_X - valid_pred) ** 2)
psnr = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr,2)))
PSNR of reconstructed validation images: 34.02dB
Vervolgens berekenen we de PSNR tussen de oorspronkelijke validatiebeelden en de voorspelde ruisachtige beelden
noisy_pred = autoencoder.predict(noisy_images)
mse =  np.mean((valid_X - noisy_pred) ** 2)
psnr_noisy = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr_noisy,2)))
PSNR of reconstructed validation images: 32.48dB
Het lijkt er dus op dat er kwantitatief slechts een verschil van 1,54 dB is tussen de PSNR van reconstructies zonder ruis en met ruis. En dat terwijl je je model niet hebt getraind om met ruis om te gaan. Best gaaf, toch?
Deze tutorial was een goed begin om te begrijpen hoe je MRI-beelden in nifti-formaat leest, analyseert, voorbewerkt en in een model voert met behulp van een 3T-MRI-hersendataset. Je zag een van de mooie, praktische toepassingen van auto-encoders. Als je dit gemakkelijk kon volgen, of zelfs met wat extra inspanning: goed gedaan!
Je kunt spelen met de architectuur en proberen de voorspellingen zowel kwantitatief als kwalitatief te verbeteren. Misschien door meer lagen toe te voegen, of door langer te trainen? Probeer deze combinaties en kijk of dat helpt.
Er valt nog veel meer te ontdekken, dus waarom zou je niet DataCamps cursus Deep Learning in Python volgen, als je dat nog niet hebt gedaan? Je begint bij de basis en gaat stap voor stap richting beheersing van deep learning. Het zal ongetwijfeld een onmisbare bron zijn wanneer je leert werken met convolutionele neurale netwerken in Python, gezichten, objecten enz. detecteren.
Deep Learning-cursussen
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

