Corso
Introduzione al Deep Learning con Keras
4 ore
46.4K
Utilizzerai un dataset di MRI cerebrali 3T per addestrare la tua rete. Per osservare l’efficacia del modello, lo testerai su:
Questo tutorial non affronterà le complessità dell’imaging medico, ma si concentrerà sul deep learning! Nota: questo tutorial coprirà soprattutto l’implementazione pratica degli autoencoder convoluzionali. Quindi, se non conosci ancora le reti neurali convoluzionali (CNN) e gli autoencoder, potresti voler dare un’occhiata ai tutorial su CNN e Autoencoder. La parte migliore di questo tutorial è che caricherai volumi 3D come immagini 2D e li darai in pasto al modello. In poche parole, oggi affronterai i seguenti argomenti:
In diagnostica per immagini si utilizzano vari sistemi, che vanno da unità MRI aperte con intensità di campo magnetico di 0,3 Tesla (T) a sistemi per estremità con intensità fino a 1,0 T e scanner total-body con intensità fino a 3,0 T (in uso clinico). Il Tesla è l’unità di misura dell’intensità del campo magnetico nelle immagini MR. Gli scanner MR ad alto campo (7T, 11,5T) forniscono un SNR (rapporto segnale-rumore) più elevato anche con voxel (una “patch” o griglia tridimensionale) di dimensioni minori e sono quindi preferiti per diagnosi più accurate.
Un voxel più piccolo porta a una risoluzione migliore, che a sua volta può aiutare la diagnosi clinica. Tuttavia, l’intensità del campo magnetico utilizzato nello scanner MR impone un limite inferiore alla dimensione del voxel per mantenere un buon rapporto segnale-rumore (SNR), così da preservare i dettagli dell’immagine MR.
Nonostante la qualità d’immagine superiore dei 7T e 11,5T, sono raramente utilizzati in produzione a causa dei costi.
Secondo articoli recenti, il numero di scanner 3T riportato è di circa 20.000 rispetto a soli ~40 scanner 7T.
Il dataset MRI cerebrale è composto da volumi 3D: ogni volume ha in totale 207 slice/immagini di MRI cerebrali acquisite a diverse sezioni del cervello. Ogni slice ha dimensioni 173 x 173. Le immagini sono in scala di grigi a singolo canale. In totale ci sono 30 soggetti, ciascuno contenente la scansione MRI di un paziente. Il formato immagine non è jpeg, png, ecc., ma il formato nifti. Nella sezione successiva vedrai come leggere le immagini in formato nifti.
Il dataset consiste di immagini MR in modalità T1; le sequenze T1 sono tradizionalmente considerate adatte alla valutazione delle strutture anatomiche. Il dataset su cui lavorerai oggi è composto da MRI cerebrali 3T.
Il dataset è pubblico ed è disponibile per il download a questa fonte.
Consiglio: se vuoi imparare a implementare un Multi-Layer Perceptron (MLP) per compiti di classificazione con il dataset MNIST, dai un’occhiata a questo tutorial.
Nota : Prima di iniziare, sappi che il modello sarà addestrato su un sistema con GPU Nvidia 1080 Ti, processore Xeon e5 GeForce e 32GB di RAM. Se usi Jupyter Notebook, dovrai aggiungere tre righe di codice per specificare l’ordine dei dispositivi CUDA e i dispositivi CUDA visibili usando un modulo chiamato os.
Nel codice seguente, imposti sostanzialmente variabili d’ambiente nel notebook usando os.environ. È buona norma farlo prima di inizializzare Keras, per limitare il backend TensorFlow all’uso della prima GPU. Se la macchina su cui addestri ha una GPU su 0, assicurati di usare 0 invece di 1. Puoi verificarlo eseguendo un semplice comando nel terminale: per esempio, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Per prima cosa, importi tutti i moduli necessari come cv2, numpy, matplotlib e soprattutto keras, dato che userai questo framework nel tutorial di oggi!
Per leggere le immagini in formato nifti, devi anche importare un modulo chiamato nibabel.
import os
import cv2
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
Using TensorFlow backend.
import numpy as np
import scipy.misc
import numpy.random as rng
from PIL import Image, ImageDraw, ImageFont
from sklearn.utils import shuffle
import nibabel as nib #reading MR images
from sklearn_cross_validation import train_test_split
import math
import glob
from matplotlib import pyplot as plt
%matplotlib inline
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:44: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also note that the interface of the new CV iterators are different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
Userai il modulo glob che restituirà una lista con tutti i volumi presenti nella cartella che specifichi!
ff = glob.glob('ground3T/*')
Stampiamo il primo elemento della lista e verifichiamo anche la lunghezza della lista: nel nostro caso dovrebbe essere 30.
ff[0]
'ground3T/181232.nii.gz'
len(ff)
30
Ora sei pronto per caricare i volumi 3D usando nibabel. Nota che quando carichi un volume in formato Nifti, Nibabel non carica l’array dell’immagine. Attende finché non richiedi i dati dell’array. Il modo normale per richiederli è chiamare il metodo get_data().
Poiché vuoi le slice 2D invece del 3D, inizializzerai una lista in cui, ogni volta che leggi un volume, itererai su tutte le 207 slice complete del volume 3D e aggiungerai ciascuna slice una per una alla lista.
images = []
Stampiamo anche la forma di uno dei volumi 3D: dovrebbe essere 173 x 207 x 173 (coordinate x, y, z).
Nota: userai solo le 51 slice centrali del cervello e non tutte le 207. Quindi vediamo anche come usare solo le slice centrali e caricarle.
for f in range(len(ff)):
    a = nib.load(ff[f])
    a = a.get_data()
    a = a[:,78:129,:]
    for i in range(a.shape[1]):
        images.append((a[:,i,:]))
print (a.shape)
(173, 51, 173)
Analizziamo la forma di una slice su 207.
a[:,0,:].shape
(173, 173)
Dato che images è una lista, userai il modulo numpy per convertirla in un array numpy.
images = np.asarray(images)
È il momento di controllare la forma dell’array numpy: la prima dimensione dovrebbe essere rispettivamente 207 x 30 = 6210 e le restanti due dimensioni 173 x 173.
images.shape
(1530, 173, 173)
Le immagini del dataset sono in effetti immagini in scala di grigi di dimensione 173 x 173, quindi prima di dare i dati al modello è molto importante fare il preprocessing. Per prima cosa convertirai ogni immagine 173 x 173 in una matrice di dimensione 173 x 173 x 1, che puoi dare in input alla rete:
images = images.reshape(-1, 173,173,1)
images.shape
(1530, 173, 173, 1)
Successivamente, riscalare i dati utilizzando la tecnica di normalizzazione max-min:
m = np.max(images)
mi = np.min(images)
m, mi
(3599.0959, -341.83853)
images = (images - mi) / (m - mi)
Verifichiamo il valore minimo e massimo dei dati, che dopo il riscalamento dovrebbero essere 0.0 e 1.0!
np.min(images), np.max(images)
(0.0, 1.0)
Questo è un passaggio importante: qui padroneggerai le immagini con zeri ai bordi in modo che le dimensioni siano pari e sia più semplice ridurre l’immagine di un fattore due durante il passaggio nel modello. Aggiungiamo zeri in tre righe e tre colonne per portare la dimensione a 176 x 176
temp = np.zeros([1530,176,176,1])
temp[:,3:,3:,:] = images
images = temp
Dopo tutto questo, è importante partizionare i dati. Affinché il tuo modello generalizzi bene, dividi i dati in due parti: un training set e un validation set. Allenerai il modello sull’80% dei dati e lo validerai sul 20% rimanente.
Questo ti aiuterà anche a ridurre le probabilità di overfitting, poiché validerai il modello su dati che non ha visto in fase di training.
Puoi usare il modulo train_test_split di scikit-learn per dividere correttamente i dati:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images,
                                                             images,
                                                             test_size=0.2,
                                                             random_state=13)
Nota: per questo task non ti servono etichette di training e testing. Ecco perché passerai le immagini di training due volte. Le immagini di training fungeranno sia da input sia da ground truth, analogamente alle etichette che hai in un task di classificazione.
Analizziamo ora come sono le immagini nel dataset e verifichiamo anche le dimensioni delle immagini ancora una volta, dato che hai aggiunto tre righe e tre colonne extra alle immagini con l’attributo .shape degli array NumPy:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images.shape))
Dataset (images) shape: (1530, 176, 176, 1)
Dal risultato sopra, puoi vedere che i dati hanno forma 6210 x 176 x 176 dato che ci sono 6210 campioni, ciascuno con una matrice 176 x 176 x 1.
Ora, diamo un’occhiata a un paio di immagini di training e validazione del tuo dataset:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(valid_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7ff67d5d59b0>
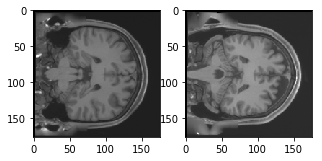
L’output dei due grafici sopra proviene dal training e dal validation set. Puoi vedere che le immagini di training e validazione sono diverse; sarà interessante vedere se l’autoencoder convoluzionale riesce a imparare le caratteristiche e a ricostruire correttamente queste immagini.
Ora sei pronto per definire la rete e dare i dati in input. Quindi, senza ulteriori indugi, passiamo allo step successivo!
Le immagini hanno dimensione 176 x 176 x 1, ovvero un vettore a 30976 dimensioni. Converti la matrice dell’immagine in un array, la riscali tra 0 e 1, la ridimensioni a 176 x 176 x 1 e la dai in input alla rete.
Inoltre, userai un batch size di 128; anche batch size più alti, come 256 o 512, sono preferibili: dipende tutto dal sistema su cui alleni il modello. Incide molto nella determinazione dei parametri di apprendimento e influenza l’accuratezza di predizione. Allenerai la rete per 50 epoche.
batch_size = 128
epochs = 300
inChannel = 1
x, y = 176, 176
input_img = Input(shape = (x, y, inChannel))
Come già saprai, l’autoencoder è diviso in due parti: un encoder e un decoder.
Encoder: ha 3 blocchi convoluzionali, ognuno con uno strato di convoluzione seguito da uno strato di batch normalization. Dopo il primo e il secondo blocco convoluzionale si usa un livello di max pooling.
Decoder: ha 2 blocchi convoluzionali, ognuno con uno strato di convoluzione seguito da uno strato di batch normalization. Dopo il primo e il secondo blocco convoluzionale si usa un livello di upsampling.
Il livello di max pooling ridurrà l’input di due volte ogni volta che lo usi, mentre il livello di upsampling aumenterà l’input di due volte ogni volta che lo usi.
Nota: il numero di filtri, la dimensione dei filtri, il numero di layer, il numero di epoche di training, sono tutti iperparametri e dovrebbero essere decisi in base alla tua intuizione; sei libero di provare nuovi esperimenti modificando questi iperparametri e misurando le prestazioni del modello. Ed è così che imparerai lentamente l’arte del deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)


    #decoder
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Dopo aver creato il modello, devi compilarlo usando l’ottimizzatore RMSProp.
Nota che devi anche specificare il tipo di loss tramite l’argomento loss. In questo caso è la mean squared error, poiché la loss dopo ogni batch verrà calcolata tra il batch di output predetti e il ground truth usando l’errore quadratico medio, pixel per pixel:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualizziamo i layer creati nello step precedente usando la funzione summary: mostrerà il numero di parametri (pesi e bias) in ogni layer e anche il totale dei parametri del modello.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 176, 176, 1)       0
_________________________________________________________________
conv2d_18 (Conv2D)           (None, 176, 176, 32)      320
_________________________________________________________________
batch_normalization_11 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
conv2d_19 (Conv2D)           (None, 176, 176, 32)      9248
_________________________________________________________________
batch_normalization_12 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
max_pooling2d_5 (MaxPooling2 (None, 88, 88, 32)        0
_________________________________________________________________
conv2d_20 (Conv2D)           (None, 88, 88, 64)        18496
_________________________________________________________________
batch_normalization_13 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
conv2d_21 (Conv2D)           (None, 88, 88, 64)        36928
_________________________________________________________________
batch_normalization_14 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
max_pooling2d_6 (MaxPooling2 (None, 44, 44, 64)        0
_________________________________________________________________
conv2d_22 (Conv2D)           (None, 44, 44, 128)       73856
_________________________________________________________________
batch_normalization_15 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_23 (Conv2D)           (None, 44, 44, 128)       147584
_________________________________________________________________
batch_normalization_16 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_24 (Conv2D)           (None, 44, 44, 64)        73792
_________________________________________________________________
batch_normalization_17 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 44, 44, 64)        36928
_________________________________________________________________
batch_normalization_18 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
up_sampling2d_5 (UpSampling2 (None, 88, 88, 64)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 88, 88, 32)        18464
_________________________________________________________________
batch_normalization_19 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 88, 88, 32)        9248
_________________________________________________________________
batch_normalization_20 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
up_sampling2d_6 (UpSampling2 (None, 176, 176, 32)      0
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 176, 176, 1)       289
=================================================================
Total params: 427,713
Trainable params: 426,433
Non-trainable params: 1,280
_________________________________________________________________
È finalmente il momento di addestrare il modello con la funzione fit() di Keras! Il modello si allena per 50 epoche. La funzione fit() restituirà un oggetto history; salvando il risultato in fashion_train potrai usarlo in seguito per tracciare il grafico della loss tra training e validazione, che ti aiuterà ad analizzare visivamente le prestazioni del modello.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 1224 samples, validate on 306 samples
Epoch 1/300
1224/1224 [==============================] - 7s - loss: 0.1201 - val_loss: 0.0838
Epoch 2/300
1224/1224 [==============================] - 7s - loss: 0.0492 - val_loss: 0.0534
...
Epoch 299/300
1224/1224 [==============================] - 7s - loss: 1.3101e-04 - val_loss: 6.1086e-04
Epoch 300/300
1224/1224 [==============================] - 7s - loss: 1.0711e-04 - val_loss: 3.9641e-04
Finalmente! Hai addestrato il modello sul dataset di impronte digitali per 200 epoche. Ora, tracciamo il grafico della loss tra training e validazione per visualizzare le prestazioni del modello.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(300)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
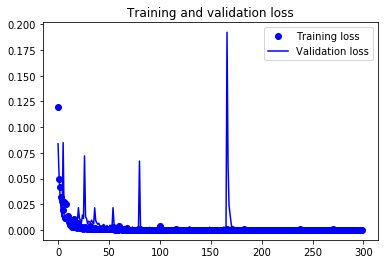
Si vede che la validation loss e la training loss sono allineate. Questo indica che il modello non sta overfittando: la validation loss diminuisce e non aumenta, e c’è raramente uno scarto tra training e validation loss durante tutto il training.
Pertanto, possiamo dire che la capacità di generalizzazione del modello è buona.
Infine, è il momento di ricostruire le immagini di test usando la funzione predict() di Keras e vedere quanto bene il modello riesce a ricostruire sui dati di test.
Salviamo ora il modello addestrato. È un passaggio importante quando lavori con il Deep Learning. Poiché i pesi sono il cuore della soluzione al problema che stai affrontando!
Puoi sempre caricare i pesi salvati nello stesso modello e riprendere l’addestramento da dove si era fermato. Per esempio: se il modello sopra viene addestrato di nuovo, i parametri come pesi, bias, la funzione di loss, ecc. non ripartiranno da zero e non sarà più un training da capo.
Con una sola riga di codice puoi salvare e ricaricare i pesi nel modello.
autoencoder = autoencoder.save_weights('autoencoder_mri.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder_mri.h5')
Dato che qui non hai un testing set, usiamo i dati di validazione per fare predizioni con il modello appena addestrato.
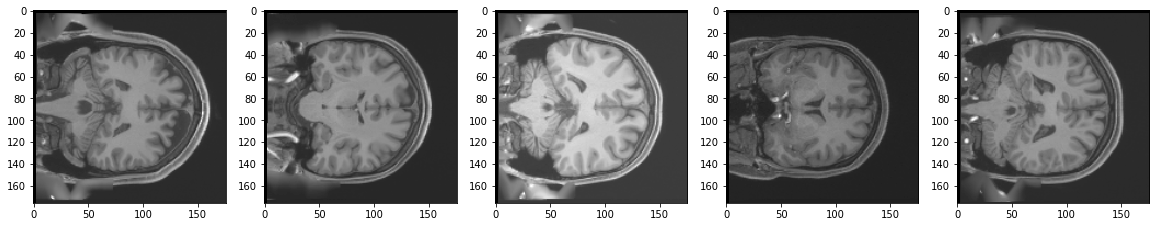
Effettuerai le predizioni del modello addestrato sulle 306 immagini di validazione rimanenti e traccerai alcune delle immagini ricostruite per visualizzare quanto bene il modello riesce a ricostruire le immagini di validazione.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
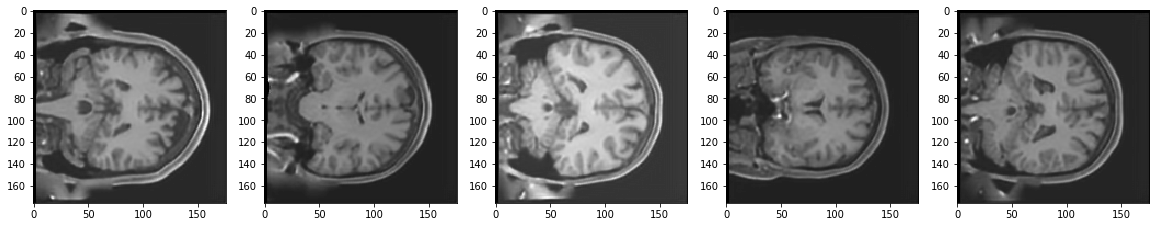
Dalle figure sopra, puoi osservare che il modello ha fatto un ottimo lavoro nel ricostruire le immagini di test che hai predetto col modello. Almeno qualitativamente, le immagini di test e quelle ricostruite sembrano quasi identiche.
Forse potrebbe fare un po’ meglio nel ricostruire alcuni dettagli locali presenti nelle immagini 3T originali.
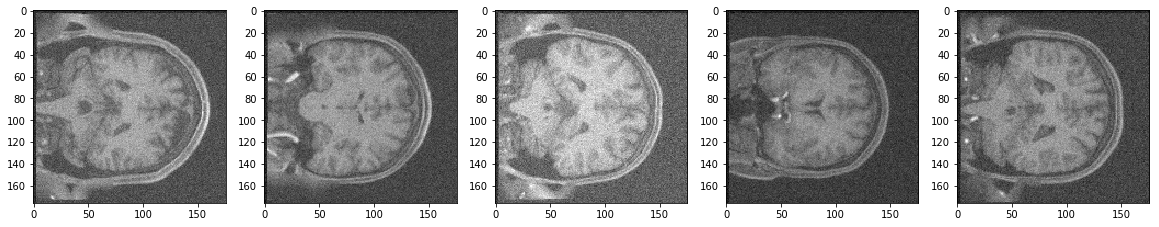
Per prima cosa aggiungiamo un po’ di rumore alle immagini di validazione con media zero e deviazione standard 0,03.
[a,b,c,d]= np.shape(valid_X)
mean = 0
sigma = 0.03
gauss = np.random.normal(mean,sigma,(a,b,c,d))
noisy_images = valid_X + gauss
È il momento di fare predizioni sulle immagini di validazione rumorose. Vediamo come si comporta il modello su immagini rumorose nonostante non sia stato addestrato su di esse.
pred_noisy = autoencoder.predict(noisy_images)
plt.figure(figsize=(20, 4))
print("Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(noisy_images[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred_noisy[i, ..., 0], cmap='gray')
plt.show()
Noisy Test Images
Reconstruction of Noisy Test Images
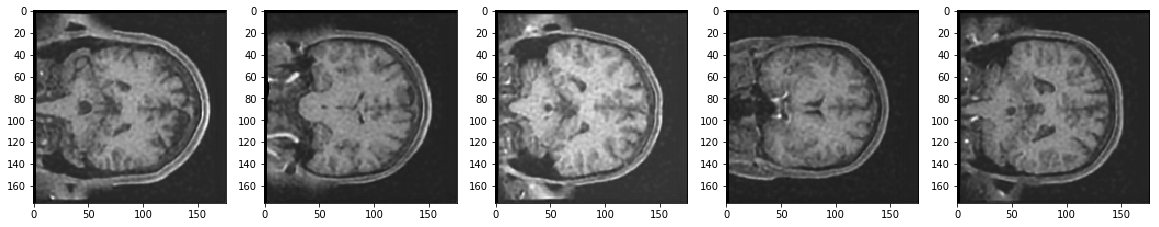
Sembra che il modello se la cavi piuttosto bene, vero? In fin dei conti, le immagini ricostruite appaiono migliori di quelle rumorose. Inoltre, il modello non ha mai visto immagini rumorose durante l’addestramento.
Il blocco PSNR calcola il rapporto segnale-rumore di picco, in decibel (dB), tra due immagini. Questo rapporto è spesso usato come misura della qualità tra l’originale e un’immagine ricostruita. Più alto è il PSNR, migliore è la qualità dell’immagine ricostruita.
Quindi, per prima cosa calcoliamo le prestazioni tra le immagini di validazione e le rispettive ricostruzioni.
valid_pred = autoencoder.predict(valid_X)
mse =  np.mean((valid_X - valid_pred) ** 2)
psnr = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr,2)))
PSNR of reconstructed validation images: 34.02dB
Successivamente, calcoliamo il PSNR tra le immagini di validazione originali e le immagini rumorose predette
noisy_pred = autoencoder.predict(noisy_images)
mse =  np.mean((valid_X - noisy_pred) ** 2)
psnr_noisy = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr_noisy,2)))
PSNR of reconstructed validation images: 32.48dB
Sembra che quantitativamente ci sia appena una differenza di 1,54 dB tra il PSNR delle ricostruzioni senza rumore e con rumore. Inoltre, non hai addestrato il modello per gestire il rumore. Non è fantastico?
Questo tutorial è stato un buon inizio per capire come leggere immagini MRI in formato nifti, analizzarle, preprocessarle e dar loro in pasto al modello usando un dataset di MRI cerebrali 3T. Ti ha mostrato una delle belle applicazioni pratiche degli autoencoder. Se sei riuscito a seguirlo facilmente o anche con un po’ di impegno in più, ottimo lavoro!
Puoi sperimentare con l’architettura e provare a migliorare le predizioni sia quantitativamente che qualitativamente. Magari aggiungendo più layer, oppure addestrandolo più a lungo? Prova queste combinazioni e vedi se aiutano.
C’è ancora molto da coprire, quindi perché non seguire il corso di DataCamp Deep Learning in Python? Se non l’hai già fatto. Partirai dalle basi e passerai gradualmente a padroneggiare il deep learning: sarà senza dubbio una risorsa indispensabile quando imparerai a lavorare con le reti neurali convoluzionali in Python, a rilevare volti, oggetti, ecc.
Corsi di Deep Learning
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



