Kurs
Introduction to Deep Learning with Keras
4 Std.
46.3K
Du verwendest ein 3T-Gehirn-MRT-Dataset, um dein Netzwerk zu trainieren. Um die Wirksamkeit deines Modells zu beurteilen, testest du es auf:
Dieses Tutorial geht nicht auf die Details der medizinischen Bildgebung ein, sondern konzentriert sich auf Deep Learning! Hinweis: Das Tutorial behandelt vor allem die praktische Umsetzung von konvolutionalen Autoencodern. Falls dir Convolutional Neural Networks (CNN) und Autoencoder noch nichts sagen, wirf vorher einen Blick auf das CNN- und das Autoencoder-Tutorial. Das Beste daran: Du lädst die 3D-Volumina als 2D-Bilder und fütterst sie so ins Modell. Kurz gesagt, du behandelst heute folgende Themen:
In der medizinischen Bildgebung kommen unterschiedliche Systeme zum Einsatz: von offenen MRT-Geräten mit einer Feldstärke von 0,3 Tesla (T) über Extremitäten-MRTs bis 1,0 T bis hin zu Ganzkörperscannern mit bis zu 3,0 T (in der klinischen Nutzung). Tesla ist die Einheit zur Messung der magnetischen Feldstärke in der MRT. Hochfeld-MRTs (7T, 11,5T) liefern trotz kleinerer Voxel (dreidimensionale Bildpunkte bzw. Gitter) einen höheren SNR (Signal-Rausch-Verhältnis) und werden deshalb für präzisere Diagnosen bevorzugt.
Kleinere Voxel bedeuten höhere Auflösung und können so die Diagnose unterstützen. Die eingesetzte Magnetfeldstärke setzt jedoch eine Untergrenze für die Voxelgröße, um ein gutes Signal-Rausch-Verhältnis (SNR) und damit Bilddetails zu erhalten.
Trotz der überlegenen Bildqualität von 7T und 11,5T kommen sie wegen der Kosten selten in der Routine zum Einsatz.
Laut aktueller Publikationen gibt es weltweit rund 20.000 3T-Scanner gegenüber nur etwa 40 7T-Scannern.
Das Gehirn-MRT-Dataset besteht aus 3D-Volumina. Jedes Volumen umfasst insgesamt 207 Schnitte/Bilder des Gehirns, aufgenommen in unterschiedlichen Ebenen. Jeder Schnitt hat die Dimension 173 × 173. Die Bilder sind ein-kanalige Graustufenbilder. Es gibt insgesamt 30 Probanden, pro Proband einen MRT-Scan. Das Bildformat ist nicht jpeg, png etc., sondern NIfTI. In einem späteren Abschnitt siehst du, wie man NIfTI-Bilder einliest.
Das Dataset enthält MR-Bilder der T1-Sequenz, die traditionell zur Beurteilung anatomischer Strukturen geeignet ist. Das heutige Dataset umfasst 3T-Gehirn-MRTs.
Das Dataset ist öffentlich und kann unter dieser Quelle heruntergeladen werden.
Tipp: Wenn du lernen willst, wie du ein Multi-Layer Perceptron (MLP) für Klassifikationsaufgaben mit dem MNIST-Dataset implementierst, schau dir dieses Tutorial an.
Hinweis: Bevor du startest, beachte bitte, dass das Modell auf einem System mit Nvidia 1080 Ti GPU, Xeon e5 GeForce Prozessor und 32 GB RAM trainiert wird. Wenn du Jupyter Notebook nutzt, musst du drei Zeilen Code ergänzen, um die CUDA-Gerätereihenfolge und die sichtbaren CUDA-Geräte mit dem Modul os festzulegen.
Im folgenden Code setzt du Umgebungsvariablen im Notebook mit os.environ. Es ist sinnvoll, dies vor der Initialisierung von Keras zu tun, um das Keras-Backend TensorFlow auf die erste GPU zu beschränken. Wenn die Trainingsmaschine die GPU auf 0 hat, nutze 0 statt 1. Das kannst du z. B. mit dem Terminalbefehl nvidia-smi prüfen.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Zuerst importierst du alle benötigten Module wie cv2, numpy, matplotlib und vor allem Keras, da du dieses Framework heute verwendest!
Um Bilder im NIfTI-Format zu lesen, importierst du außerdem das Modul nibabel.
import os
import cv2
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
Using TensorFlow backend.
import numpy as np
import scipy.misc
import numpy.random as rng
from PIL import Image, ImageDraw, ImageFont
from sklearn.utils import shuffle
import nibabel as nib #reading MR images
from sklearn.cross_validation import train_test_split
import math
import glob
from matplotlib import pyplot as plt
%matplotlib inline
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:44: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also note that the interface of the new CV iterators are different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
Du verwendest das Modul glob, das dir eine Liste mit allen Volumina im angegebenen Ordner zurückgibt.
ff = glob.glob('ground3T/*')
Lass uns das erste Listenelement ausgeben und die Länge der Liste prüfen: In unserem Fall sollten es 30 sein.
ff[0]
'ground3T/181232.nii.gz'
len(ff)
30
Jetzt kannst du die 3D-Volumina mit nibabel laden. Beachte: Beim Laden eines NIfTI-Volumens lädt Nibabel das Bildarray nicht sofort, sondern erst, wenn du die Daten explizit anforderst, z. B. mit get_data().
Da du 2D-Schnitte statt 3D möchtest, initialisierst du eine Liste. Jedes Mal, wenn du ein Volumen liest, iterierst du über alle 207 Schnitte des 3D-Volumens und hängst jeden Schnitt einzeln an die Liste an.
images = []
Gib außerdem die Form eines 3D-Volumens aus. Sie sollte 173 × 207 × 173 (x-, y-, z-Koordinaten) sein.
Hinweis: Du verwendest nur die mittleren 51 Gehirnschnitte, nicht alle 207. Sieh dir an, wie du nur die mittleren Schnitte auswählst und lädst.
for f in range(len(ff)):
    a = nib.load(ff[f])
    a = a.get_data()
    a = a[:,78:129,:]
    for i in range(a.shape[1]):
        images.append((a[:,i,:]))
print (a.shape)
(173, 51, 173)
Analysiere die Form eines einzelnen Schnitts der 207 Schnitte.
a[:,0,:].shape
(173, 173)
Da images eine Liste ist, wandelst du sie mit NumPy in ein Array um.
images = np.asarray(images)
Prüfe die Form des Arrays. Die erste Dimension sollte 207 × 30 = 6210 betragen, die restlichen Dimensionen 173 × 173.
images.shape
(1530, 173, 173)
Die Bilder sind Graustufen mit 173 × 173. Bevor du die Daten ins Modell gibst, ist Vorverarbeitung wichtig. Du erweiterst jedes 173 × 173-Bild zu einer Matrix 173 × 173 × 1, damit sie ins Netzwerk passt:
images = images.reshape(-1, 173,173,1)
images.shape
(1530, 173, 173, 1)
Als Nächstes skalierst du die Daten mit der Min-Max-Normalisierung:
m = np.max(images)
mi = np.min(images)
m, mi
(3599.0959, -341.83853)
images = (images - mi) / (m - mi)
Überprüfe Minimum und Maximum. Nach der Skalierung sollten sie 0,0 bzw. 1,0 sein.
np.min(images), np.max(images)
(0.0, 1.0)
Wichtiger Schritt: Du paddest die Bilder mit Nullen an den Rändern, damit die Dimensionen gerade sind und sich beim Durchlaufen des Modells einfacher jeweils durch zwei heruntersampeln lassen. Füge drei Zeilen und drei Spalten mit Nullen hinzu, sodass die Dimension 176 × 176 beträgt.
temp = np.zeros([1530,176,176,1])
temp[:,3:,3:,:] = images
images = temp
Danach teilst du die Daten auf. Damit dein Modell gut generalisiert, trennst du in Trainings- und Validierungsdaten: 80% Training, 20% Validierung.
Das reduziert die Gefahr von Overfitting, da du auf Daten validierst, die das Modell im Training nicht gesehen hat.
Mit train_test_split aus scikit-learn teilst du sauber:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images,
                                                             images,
                                                             test_size=0.2,
                                                             random_state=13)
Hinweis: Für diese Aufgabe brauchst du keine Labels für Training und Test. Deshalb übergibst du die Trainingsbilder doppelt. Sie dienen sowohl als Input als auch als Ground Truth – analog zu Labels bei der Klassifikation.
Schauen wir uns an, wie die Bilder aussehen, und prüfen die Dimensionen erneut, da du drei zusätzliche Zeilen und Spalten hinzugefügt hast. Das geht bequem mit .shape:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images.shape))
Dataset (images) shape: (1530, 176, 176, 1)
Aus der Ausgabe siehst du: Die Daten haben die Form 6210 × 176 × 176, denn es gibt 6210 Samples mit je 176 × 176 × 1.
Jetzt werfen wir einen Blick auf einige Trainings- und Validierungsbilder:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(valid_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7ff67d5d59b0>
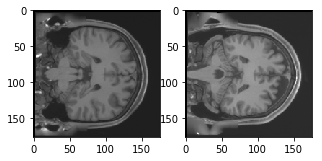
Die beiden Plots stammen aus Trainings- und Validierungsmenge. Beide Bildsätze unterscheiden sich. Es wird spannend zu sehen, ob der konvolutionale Autoencoder die Merkmale gut lernt und die Bilder sauber rekonstruiert.
Jetzt kannst du das Netzwerk definieren und die Daten einspeisen. Los geht’s!
Die Bilder sind 176 × 176 × 1 groß, also ein 30976-dimensionaler Vektor. Du wandelst die Bildmatrix in ein Array um, skalierst auf 0 bis 1, formst zu 176 × 176 × 1 und gibst das als Input ins Netzwerk.
Du nutzt eine Batchgröße von 128. Größere Batches wie 256 oder 512 sind ebenfalls möglich – abhängig vom System. Sie beeinflussen die Lernparameter und wirken sich auf die Vorhersagegenauigkeit aus. Du trainierst 50 Epochen.
batch_size = 128
epochs = 300
inChannel = 1
x, y = 176, 176
input_img = Input(shape = (x, y, inChannel))
Wie du sicher weißt, besteht der Autoencoder aus zwei Teilen: Encoder und Decoder.
Encoder: 3 Convolution-Blöcke, jeweils mit einer Convolution-Schicht, gefolgt von Batch Normalization. Nach dem ersten und zweiten Block kommt jeweils Max-Pooling.
Decoder: 2 Convolution-Blöcke, jeweils mit Convolution-Schicht und Batch Normalization. Nach dem ersten und zweiten Block wird upgesampelt.
Max-Pooling halbiert die räumliche Auflösung bei jeder Anwendung, Upsampling verdoppelt sie.
Hinweis: Anzahl der Filter, Filtergröße, Layeranzahl, Epochen usw. sind Hyperparameter. Passe sie nach deinem Gefühl an, experimentiere und miss die Performance. So lernst du nach und nach die Kunst des Deep Learnings.
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)


    #decoder
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Nach dem Erstellen des Modells kompilierst du es mit dem Optimierer RMSProp.
Außerdem gibst du den Loss-Typ an. Hier ist es der Mean Squared Error, berechnet pixelweise zwischen Vorhersage und Ground Truth pro Batch:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Lass dir mit summary die Modellschichten anzeigen. So siehst du die Parameter (Gewichte und Biases) pro Layer sowie die Gesamtanzahl.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 176, 176, 1)       0
_________________________________________________________________
conv2d_18 (Conv2D)           (None, 176, 176, 32)      320
_________________________________________________________________
batch_normalization_11 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
conv2d_19 (Conv2D)           (None, 176, 176, 32)      9248
_________________________________________________________________
batch_normalization_12 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
max_pooling2d_5 (MaxPooling2 (None, 88, 88, 32)        0
_________________________________________________________________
conv2d_20 (Conv2D)           (None, 88, 88, 64)        18496
_________________________________________________________________
batch_normalization_13 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
conv2d_21 (Conv2D)           (None, 88, 88, 64)        36928
_________________________________________________________________
batch_normalization_14 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
max_pooling2d_6 (MaxPooling2 (None, 44, 44, 64)        0
_________________________________________________________________
conv2d_22 (Conv2D)           (None, 44, 44, 128)       73856
_________________________________________________________________
batch_normalization_15 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_23 (Conv2D)           (None, 44, 44, 128)       147584
_________________________________________________________________
batch_normalization_16 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_24 (Conv2D)           (None, 44, 44, 64)        73792
_________________________________________________________________
batch_normalization_17 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 44, 44, 64)        36928
_________________________________________________________________
batch_normalization_18 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
up_sampling2d_5 (UpSampling2 (None, 88, 88, 64)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 88, 88, 32)        18464
_________________________________________________________________
batch_normalization_19 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 88, 88, 32)        9248
_________________________________________________________________
batch_normalization_20 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
up_sampling2d_6 (UpSampling2 (None, 176, 176, 32)      0
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 176, 176, 1)       289
=================================================================
Total params: 427,713
Trainable params: 426,433
Non-trainable params: 1,280
_________________________________________________________________
Jetzt trainierst du das Modell mit der Keras-Funktion fit(). Das Modell trainiert 50 Epochen. Die Funktion gibt ein History-Objekt zurück; speichere das Ergebnis, um später Trainings- und Validierungsverlust zu plotten und die Performance visuell zu analysieren.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 1224 samples, validate on 306 samples
Epoch 1/300
1224/1224 [==============================] - 7s - loss: 0.1201 - val_loss: 0.0838
Epoch 2/300
1224/1224 [==============================] - 7s - loss: 0.0492 - val_loss: 0.0534
...
Epoch 299/300
1224/1224 [==============================] - 7s - loss: 1.3101e-04 - val_loss: 6.1086e-04
Epoch 300/300
1224/1224 [==============================] - 7s - loss: 1.0711e-04 - val_loss: 3.9641e-04
Geschafft! Du hast das Modell 200 Epochen auf dem Fingerabdruck-Dataset trainiert. Jetzt plotten wir den Verlustverlauf zwischen Training und Validierung, um die Leistung zu visualisieren.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(300)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
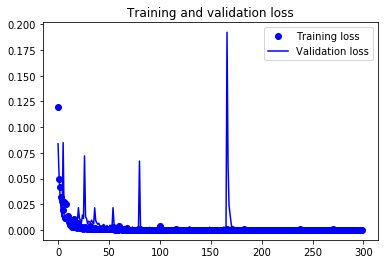
Du siehst, dass Validierungs- und Trainingsverlust im Gleichklang sind. Das Modell überfitten nicht: Die Validierungskurve fällt und driftet nicht nach oben, und es gibt kaum Lücke zwischen beiden Kurven.
Damit ist die Generalisierungsfähigkeit deines Modells gut.
Jetzt rekonstruierst du die Testbilder mit der predict()-Funktion von Keras und prüfst, wie gut das Modell auf den Testdaten rekonstruiert.
Speichere nun das trainierte Modell. Das ist bei Deep Learning wichtig, denn die Gewichte sind das Herzstück deiner Lösung.
Du kannst die gespeicherten Gewichte jederzeit wieder in dasselbe Modell laden und dort weitertrainieren, wo du aufgehört hast. Beim erneuten Training startest du also nicht bei null.
Mit einer Codezeile kannst du Gewichte speichern und wieder laden.
autoencoder = autoencoder.save_weights('autoencoder_mri.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder_mri.h5')
Da es hier keinen separaten Testsatz gibt, verwenden wir die Validierungsdaten für Vorhersagen mit dem soeben trainierten Modell.
Du sagst 306 Validierungsbilder vorher und plottest einige Rekonstruktionen, um die Qualität visuell zu beurteilen.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
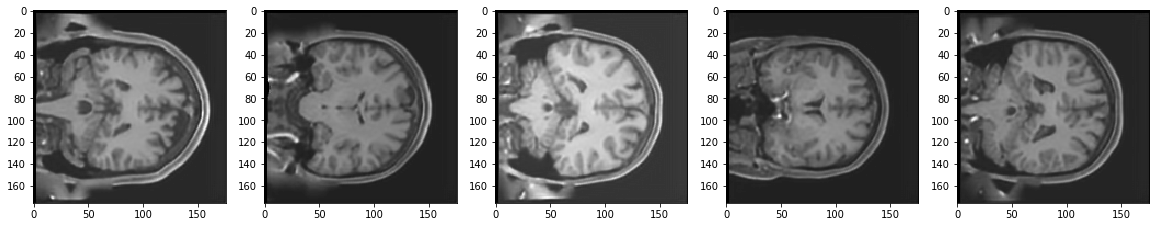
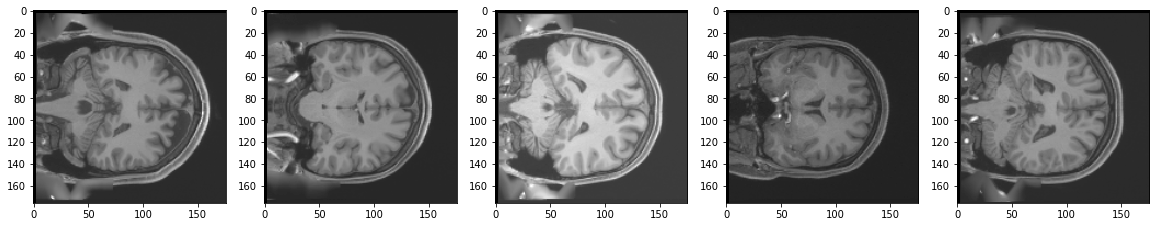
Aus den Abbildungen siehst du: Das Modell rekonstruiert die Testbilder beeindruckend gut. Qualitativ wirken Original und Rekonstruktion fast identisch.
Vielleicht lässt sich die Rekonstruktion lokaler Details der ursprünglichen 3T-Bilder noch etwas verbessern.
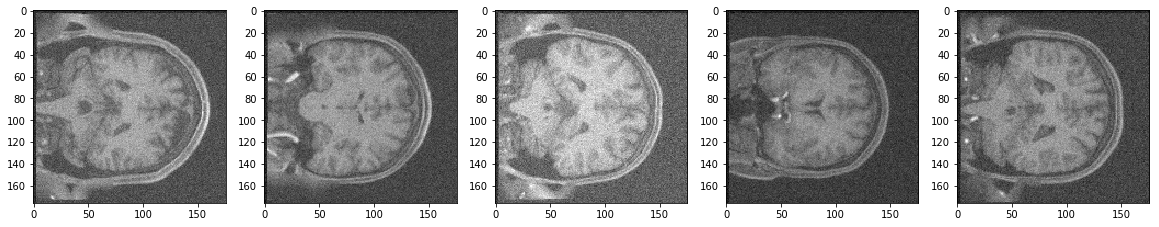
Fügen wir zunächst den Validierungsbildern Rauschen mit Mittelwert 0 und Standardabweichung 0,03 hinzu.
[a,b,c,d]= np.shape(valid_X)
mean = 0
sigma = 0.03
gauss = np.random.normal(mean,sigma,(a,b,c,d))
noisy_images = valid_X + gauss
Jetzt sagen wir auf den verrauschten Bildern vorher. Mal sehen, wie gut das Modell trotz fehlendem Rausch-Training abschneidet.
pred_noisy = autoencoder.predict(noisy_images)
plt.figure(figsize=(20, 4))
print("Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(noisy_images[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred_noisy[i, ..., 0], cmap='gray')
plt.show()
Noisy Test Images
Reconstruction of Noisy Test Images
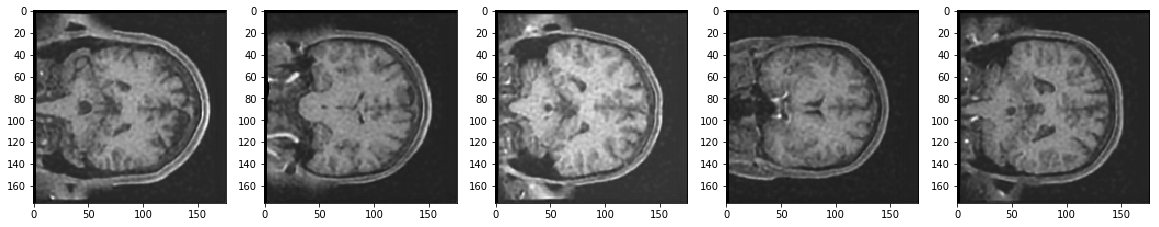
Sieht so aus, als hätte das Modell einen richtig guten Job gemacht, oder? Die rekonstruierten Bilder sehen klar besser aus als die verrauschten – und das, obwohl das Modell nie mit Rauschen trainiert wurde.
Der PSNR-Wert misst das Spitzen-Signal-Rausch-Verhältnis in Dezibel (dB) zwischen zwei Bildern. Er dient häufig als Qualitätsmaß zwischen Original und Rekonstruktion. Je höher der PSNR, desto besser die Qualität des rekonstruierten Bildes.
Berechnen wir zuerst die Leistung zwischen den Validierungsbildern und deren Rekonstruktionen.
valid_pred = autoencoder.predict(valid_X)
mse =  np.mean((valid_X - valid_pred) ** 2)
psnr = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr,2)))
PSNR of reconstructed validation images: 34.02dB
Als Nächstes berechnen wir den PSNR zwischen den Original-Validierungsbildern und den vorhergesagten verrauschten Bildern.
noisy_pred = autoencoder.predict(noisy_images)
mse =  np.mean((valid_X - noisy_pred) ** 2)
psnr_noisy = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr_noisy,2)))
PSNR of reconstructed validation images: 32.48dB
Quantitativ liegt der Unterschied also nur bei etwa 1,54 dB zwischen Rekonstruktionen ohne und mit Rauschen. Und das ganz ohne spezielles Rausch-Training. Ziemlich stark, oder?
Dieses Tutorial war ein guter Einstieg: Du hast gelernt, NIfTI-MRT-Bilder zu lesen, zu analysieren, vorzuverarbeiten und mit einem 3T-Gehirn-MRT-Dataset ins Modell zu geben. Du hast eine praktische Anwendung von Autoencodern kennengelernt. Wenn du gut folgen konntest – top!
Spiele mit der Architektur und versuche, die Vorhersagen quantitativ und qualitativ zu verbessern. Vielleicht mit mehr Schichten oder längerer Trainingszeit? Probiere Kombinationen aus und schau, was hilft.
Es gibt noch viel zu entdecken. Warum nicht den DataCamp-Kurs Deep Learning in Python belegen, falls noch nicht geschehen? Du startest bei den Grundlagen und arbeitest dich Schritt für Schritt vor – ein unverzichtbarer Begleiter, wenn du mit Convolutional Neural Networks in Python arbeiten, Gesichter, Objekte usw. erkennen willst.
Deep-Learning-Kurse
Kurs
Kurs
Kurs