Cours
Introduction au Deep Learning avec Keras
4 h
46.3K
Vous utiliserez un jeu de données IRM cérébrales 3T pour entraîner votre réseau. Pour évaluer l’efficacité du modèle, vous le testerez sur :
Ce tutoriel ne traitera pas les subtilités de l’imagerie médicale : nous nous concentrerons sur l’aspect deep learning ! Remarque : ce tutoriel couvre essentiellement l’implémentation pratique des autoencodeurs convolutionnels. Si vous n’êtes pas encore à l’aise avec les réseaux de neurones convolutionnels (CNN) et les autoencodeurs, nous vous recommandons ces tutoriels : CNN et Autoencoder. Le point fort de ce tutoriel : vous chargerez des volumes 3D comme des images 2D et les passerez au modèle. En résumé, voici les sujets abordés aujourd’hui :
En imagerie médicale, on trouve différents systèmes : des IRM ouvertes avec un champ magnétique de 0,3 Tesla (T), des systèmes pour les extrémités jusqu’à 1,0 T et des scanners corps entier jusqu’à 3,0 T (en clinique). Le Tesla est l’unité qui mesure l’intensité du champ magnétique en IRM. Les scanners IRM à champ élevé (7T, 11,5T) offrent un meilleur SNR (signal‑sur‑bruit) même avec des voxels plus petits (un patch ou une grille en 3D) et sont donc privilégiés pour un diagnostic plus précis.
Des voxels plus petits donnent une meilleure résolution, ce qui aide le diagnostic clinique. Cependant, l’intensité du champ magnétique de l’IRM impose une limite inférieure à la taille des voxels pour conserver un bon SNR et préserver les détails de l’image.
Malgré leur qualité d’image supérieure, les 7T et 11,5T sont rarement utilisés en production à cause des coûts.
Selon des publications récentes, on dénombre environ 20 000 scanners 3T contre seulement ~40 scanners 7T.
Le jeu de données d’IRM cérébrales est constitué de volumes 3D ; chaque volume regroupe 207 coupes/images acquises à différentes tranches du cerveau. Chaque coupe est de dimension 173 x 173. Les images sont en niveaux de gris monocanal. Il y a 30 sujets au total, chaque sujet correspondant à l’IRM d’un patient. Le format d’image n’est pas jpeg, png, etc., mais le format NIfTI. Vous verrez plus loin comment lire des images au format NIfTI.
Le jeu de données contient des IRM en modalité T1, traditionnellement adaptées à l’évaluation des structures anatomiques. Le jeu sur lequel vous allez travailler aujourd’hui regroupe des IRM cérébrales 3T.
Ce jeu de données est public et disponible en téléchargement depuis cette source.
Astuce : si vous souhaitez apprendre à implémenter un perceptron multicouche (MLP) pour des tâches de classification avec le jeu de données MNIST, consultez ce tutoriel.
Remarque : avant de commencer, notez que le modèle sera entraîné sur une machine avec GPU Nvidia 1080 Ti, processeur Xeon e5 GeForce et 32 Go de RAM. Si vous utilisez Jupyter Notebook, vous devrez ajouter trois lignes de code pour préciser l’ordre des périphériques CUDA et les périphériques CUDA visibles avec le module os.
Dans le code ci‑dessous, vous définissez des variables d’environnement dans le notebook via os.environ. Il est recommandé de le faire avant d’initialiser Keras pour limiter le backend TensorFlow de Keras à un seul GPU. Si la machine d’entraînement a un GPU en position 0, utilisez 0 au lieu de 1. Vous pouvez le vérifier en lançant une simple commande dans votre terminal : par exemple, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Commencez par importer les modules nécessaires : cv2, numpy, matplotlib et surtout keras, puisque c’est le framework utilisé dans ce tutoriel !
Pour lire des images au format NIfTI, vous devrez aussi importer le module nibabel.
import os
import cv2
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
Using TensorFlow backend.
import numpy as np
import scipy.misc
import numpy.random as rng
from PIL import Image, ImageDraw, ImageFont
from sklearn.utils import shuffle
import nibabel as nib #reading MR images
from sklearn.cross_validation import train_test_split
import math
import glob
from matplotlib import pyplot as plt
%matplotlib inline
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:44: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also note that the interface of the new CV iterators are different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
Vous utiliserez le module glob qui renverra une liste de tous les volumes présents dans le dossier que vous indiquerez.
ff = glob.glob('ground3T/*')
Affichons le premier élément de la liste et vérifions également sa longueur : dans notre cas, elle doit être de 30.
ff[0]
'ground3T/181232.nii.gz'
len(ff)
30
Vous êtes prêt à charger les volumes 3D avec nibabel. Notez qu’en chargeant un volume NIfTI, Nibabel ne lit pas immédiatement le tableau d’images : il attend que vous le demandiez, via la méthode get_data().
Comme vous souhaitez des coupes 2D au lieu de volumes 3D, vous allez initialiser une liste : à chaque lecture d’un volume, vous itérerez sur les 207 coupes du volume 3D et ajouterez chaque coupe à la liste.
images = []
Affichons aussi la forme d’un volume 3D : elle devrait être 173 x 207 x 173 (coordonnées x, y, z).
Remarque : vous n’utiliserez que les 51 coupes centrales du cerveau, et non les 207. Voyons comment sélectionner et charger uniquement les coupes centrales.
for f in range(len(ff)):
    a = nib.load(ff[f])
    a = a.get_data()
    a = a[:,78:129,:]
    for i in range(a.shape[1]):
        images.append((a[:,i,:]))
print (a.shape)
(173, 51, 173)
Analysons la forme d’une coupe parmi les 207.
a[:,0,:].shape
(173, 173)
Puisque images est une liste, utilisez numpy pour la convertir en tableau NumPy.
images = np.asarray(images)
Vérifions la forme du tableau : la première dimension devrait correspondre à 207 x 30 = 6210 et les deux autres à 173 x 173.
images.shape
(1530, 173, 173)
Les images sont bien en niveaux de gris 173 x 173. Avant de les passer au modèle, un prétraitement est indispensable. Vous allez d’abord convertir chaque image 173 x 173 en un tenseur 173 x 173 x 1, compatible avec l’entrée du réseau :
images = images.reshape(-1, 173,173,1)
images.shape
(1530, 173, 173, 1)
Ensuite, re‑scalez les données avec une normalisation min‑max :
m = np.max(images)
mi = np.min(images)
m, mi
(3599.0959, -341.83853)
images = (images - mi) / (m - mi)
Vérifions que le min et le max valent bien 0,0 et 1,0 après re‑scaling.
np.min(images), np.max(images)
(0.0, 1.0)
Étape importante : remplir les bords d’images avec des zéros afin d’obtenir des dimensions paires, ce qui facilite l’échantillonnage par 2 dans le modèle. Ajoutons trois lignes et trois colonnes de zéros pour obtenir 176 x 176.
temp = np.zeros([1530,176,176,1])
temp[:,3:,3:,:] = images
images = temp
Après cela, il est essentiel de partitionner les données pour bien généraliser : créez un ensemble d’entraînement et un ensemble de validation. Vous entraînerez le modèle sur 80 % des données et validerez sur 20 %.
Cela limite aussi le sur‑apprentissage, puisque vous validez sur des données non vues pendant l’entraînement.
Utilisez train_test_split de scikit‑learn pour diviser correctement les données :
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images,
                                                             images,
                                                             test_size=0.2,
                                                             random_state=13)
Remarque : pour cette tâche, vous n’avez pas besoin de labels d’entraînement/test. C’est pourquoi les images d’entraînement sont passées deux fois : elles servent à la fois d’entrée et de vérité‑terrain, comme des labels en classification.
Analysons maintenant l’aspect des images et revérifions leurs dimensions après l’ajout des trois lignes et colonnes, via l’attribut NumPy .shape :
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images.shape))
Dataset (images) shape: (1530, 176, 176, 1)
On voit que les données ont la forme 6210 x 176 x 176, avec 6210 échantillons de matrices 176 x 176 x 1.
Regardons quelques images d’entraînement et de validation :
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(valid_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7ff67d5d59b0>
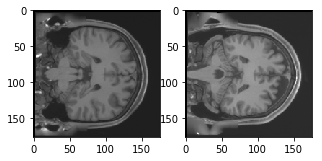
Les deux sorties ci‑dessus proviennent des ensembles d’entraînement et de validation. Les images sont différentes : il sera intéressant de voir si l’autoencodeur convolutionnel apprend bien les caractéristiques et reconstruit correctement ces images.
Vous êtes prêt à définir le réseau et à y injecter les données. Passons à l’étape suivante !
Les images sont de taille 176 x 176 x 1 (soit un vecteur de 30 976 valeurs). Vous convertissez la matrice en tableau, la re‑scalez entre 0 et 1, la re‑façonnez en 176 x 176 x 1, puis l’utilisez comme entrée du réseau.
Vous utiliserez une taille de lot de 128 ; des tailles plus élevées (256/512) sont également envisageables selon la machine. Elle influence fortement l’apprentissage et la précision. Vous entraînerez le réseau pendant 50 époques.
batch_size = 128
epochs = 300
inChannel = 1
x, y = 176, 176
input_img = Input(shape = (x, y, inChannel))
Comme vous le savez, l’autoencodeur est composé de deux parties : un encodeur et un décodeur.
Encodeur : 3 blocs convolutionnels, chacun suivi d’une couche de normalisation de lot. Une couche de max‑pooling est utilisée après les 1er et 2e blocs.
Décodeur : 2 blocs convolutionnels, chacun suivi d’une normalisation de lot. Une couche d’upsampling est utilisée après les 1er et 2e blocs.
Chaque couche de max‑pooling réduit les dimensions d’un facteur 2, tandis que chaque couche d’upsampling les augmente d’un facteur 2.
Remarque : le nombre de filtres, la taille des filtres, le nombre de couches, le nombre d’époques, etc., sont des hyperparamètres à ajuster. N’hésitez pas à expérimenter et à mesurer l’impact sur les performances. C’est ainsi que vous affinerez votre intuition en deep learning.
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)


    #decoder
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Une fois le modèle créé, compilez‑le avec l’optimiseur RMSProp.
Indiquez également la fonction de perte via l’argument loss. Ici, on utilise l’erreur quadratique moyenne, calculée pixel par pixel entre la sortie prédite et la vérité‑terrain à chaque lot :
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualisons les couches créées avec summary : vous obtiendrez le nombre de paramètres (poids et biais) par couche et le total pour le modèle.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 176, 176, 1)       0
_________________________________________________________________
conv2d_18 (Conv2D)           (None, 176, 176, 32)      320
_________________________________________________________________
batch_normalization_11 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
conv2d_19 (Conv2D)           (None, 176, 176, 32)      9248
_________________________________________________________________
batch_normalization_12 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
max_pooling2d_5 (MaxPooling2 (None, 88, 88, 32)        0
_________________________________________________________________
conv2d_20 (Conv2D)           (None, 88, 88, 64)        18496
_________________________________________________________________
batch_normalization_13 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
conv2d_21 (Conv2D)           (None, 88, 88, 64)        36928
_________________________________________________________________
batch_normalization_14 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
max_pooling2d_6 (MaxPooling2 (None, 44, 44, 64)        0
_________________________________________________________________
conv2d_22 (Conv2D)           (None, 44, 44, 128)       73856
_________________________________________________________________
batch_normalization_15 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_23 (Conv2D)           (None, 44, 44, 128)       147584
_________________________________________________________________
batch_normalization_16 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_24 (Conv2D)           (None, 44, 44, 64)        73792
_________________________________________________________________
batch_normalization_17 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 44, 44, 64)        36928
_________________________________________________________________
batch_normalization_18 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
up_sampling2d_5 (UpSampling2 (None, 88, 88, 64)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 88, 88, 32)        18464
_________________________________________________________________
batch_normalization_19 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 88, 88, 32)        9248
_________________________________________________________________
batch_normalization_20 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
up_sampling2d_6 (UpSampling2 (None, 176, 176, 32)      0
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 176, 176, 1)       289
=================================================================
Total params: 427,713
Trainable params: 426,433
Non-trainable params: 1,280
_________________________________________________________________
Il est enfin temps d’entraîner le modèle avec la fonction fit() de Keras ! Le modèle s’entraîne pendant 50 époques. La fonction fit() renvoie un objet history : en le stockant dans fashion_train, vous pourrez ensuite tracer la courbe de perte entraînement/validation pour analyser visuellement les performances.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 1224 samples, validate on 306 samples
Epoch 1/300
1224/1224 [==============================] - 7s - loss: 0.1201 - val_loss: 0.0838
Epoch 2/300
1224/1224 [==============================] - 7s - loss: 0.0492 - val_loss: 0.0534
...
Epoch 299/300
1224/1224 [==============================] - 7s - loss: 1.3101e-04 - val_loss: 6.1086e-04
Epoch 300/300
1224/1224 [==============================] - 7s - loss: 1.0711e-04 - val_loss: 3.9641e-04
Enfin ! Vous avez entraîné le modèle sur le jeu d’empreintes pendant 200 époques. Traçons maintenant les courbes de perte entraînement/validation pour visualiser la performance du modèle.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(300)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
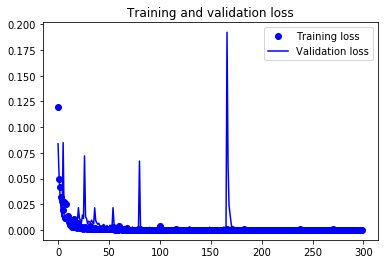
On observe que les pertes d’entraînement et de validation évoluent de concert. Le modèle ne sur‑apprend pas : la perte de validation diminue et reste proche de la perte d’entraînement tout au long de l’apprentissage.
On peut donc dire que la capacité de généralisation du modèle est bonne.
Il est temps de reconstruire les images de test avec predict() de Keras et de voir la qualité des reconstructions.
Sauvegardons maintenant le modèle entraîné. C’est crucial en deep learning : les poids sont au cœur de votre solution !
Vous pouvez recharger ces poids à tout moment dans le même modèle et reprendre l’entraînement où vous l’aviez laissé. Par exemple, si vous réentraîne(z) le modèle ci‑dessus, les paramètres (poids, biais, fonction de perte, etc.) ne repartiront pas de zéro : ce ne sera plus un entraînement à froid.
En une ligne de code, vous sauvegardez et rechargez les poids.
autoencoder = autoencoder.save_weights('autoencoder_mri.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder_mri.h5')
Comme vous n’avez pas d’ensemble de test dédié, utilisons l’ensemble de validation pour évaluer le modèle entraîné.
Vous allez lancer la prédiction sur les 306 images de validation et afficher quelques reconstructions pour juger visuellement la qualité.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
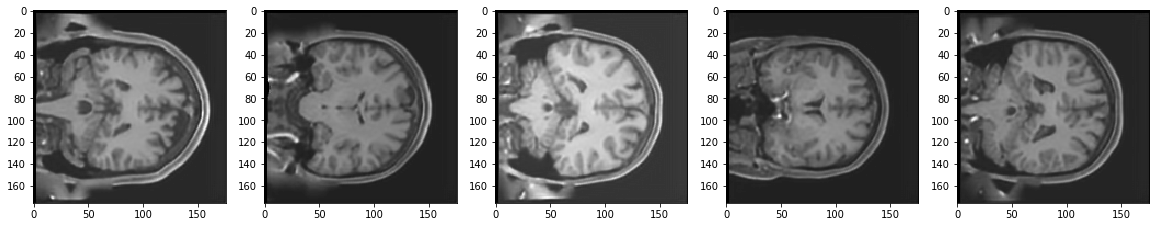
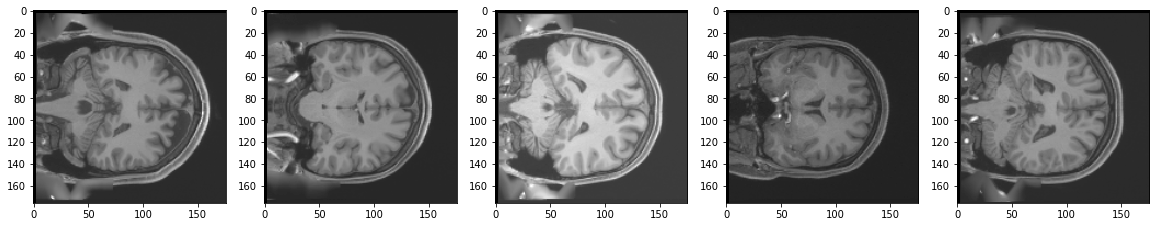
On constate que le modèle reconstruit très bien les images de test : qualitativement, les originaux et les reconstructions sont quasi identiques.
Peut‑être reste‑t‑il des détails locaux à mieux restituer sur certaines images 3T d’origine.
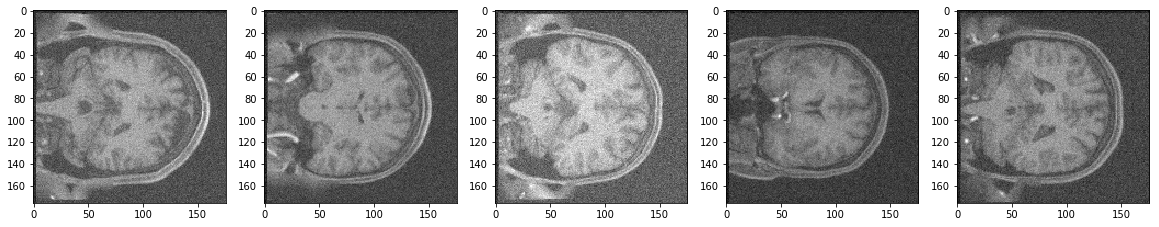
Ajoutons d’abord du bruit aux images de validation : moyenne nulle et écart‑type de 0,03.
[a,b,c,d]= np.shape(valid_X)
mean = 0
sigma = 0.03
gauss = np.random.normal(mean,sigma,(a,b,c,d))
noisy_images = valid_X + gauss
Il est temps de prédire sur ces images bruitées. Voyons si le modèle s’en sort bien malgré l’absence d’entraînement spécifique au bruit.
pred_noisy = autoencoder.predict(noisy_images)
plt.figure(figsize=(20, 4))
print("Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(noisy_images[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred_noisy[i, ..., 0], cmap='gray')
plt.show()
Noisy Test Images
Reconstruction of Noisy Test Images
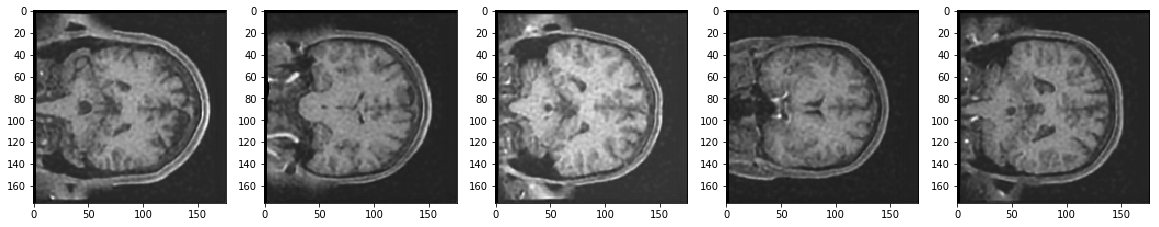
Le modèle s’en sort plutôt bien, n’est‑ce pas ? Les reconstructions sont déjà plus propres que les entrées bruitées, alors même que le modèle n’a jamais vu d’images bruitées à l’entraînement.
Le PSNR calcule le rapport signal‑sur‑bruit de crête, en décibels (dB), entre deux images. Il est souvent utilisé pour comparer une image reconstruite à l’originale. Plus le PSNR est élevé, meilleure est la qualité de reconstruction.
Commençons par mesurer la performance entre les images de validation et leurs reconstructions.
valid_pred = autoencoder.predict(valid_X)
mse =  np.mean((valid_X - valid_pred) ** 2)
psnr = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr,2)))
PSNR of reconstructed validation images: 34.02dB
Calculons ensuite le PSNR entre les images de validation originales et les images prédites à partir des entrées bruitées.
noisy_pred = autoencoder.predict(noisy_images)
mse =  np.mean((valid_X - noisy_pred) ** 2)
psnr_noisy = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr_noisy,2)))
PSNR of reconstructed validation images: 32.48dB
Quantitativement, l’écart n’est que de 1,54 dB entre les reconstructions sans bruit et avec bruit. Et pourtant, le modèle n’a pas été entraîné à gérer le bruit. Impressionnant, non ?
Ce tutoriel constitue une bonne introduction pour lire des images IRM au format NIfTI, les analyser, les prétraiter et les injecter dans un modèle à partir d’un jeu de données IRM cérébrales 3T. Vous avez vu une application concrète et élégante des autoencodeurs. Si vous avez pu suivre facilement (ou avec un peu d’effort), bravo !
Vous pouvez faire évoluer l’architecture et tenter d’améliorer les prédictions, quantitativement et qualitativement : ajouter des couches, entraîner plus longtemps… Testez et voyez ce qui fonctionne.
Il reste encore beaucoup à couvrir : pourquoi ne pas suivre le cours Deep Learning in Python de DataCamp si ce n’est pas déjà fait ? Vous partirez des bases pour progressivement maîtriser le deep learning : un atout incontournable pour travailler avec des réseaux convolutionnels en Python, détecter des visages, des objets, etc.
Cours de deep learning
Cours
Cours
Cours