Curso
Introdução ao Deep Learning com Keras
4 h
46.3K
Você vai usar o dataset de ressonância magnética do cérebro em 3T para treinar sua rede. Para observar a eficácia do seu modelo, você vai testá-lo em:
Este tutorial não vai entrar nas minúcias da imagem médica — o foco aqui é o lado de deep learning! Observação: este tutorial é principalmente prático sobre a implementação de autoencoders convolucionais. Então, se você ainda não está familiarizado com redes neurais convolucionais (CNN) e autoencoders, vale conferir os tutoriais de CNN e Autoencoder. A melhor parte: você vai carregar volumes 3D como imagens 2D e alimentá-los no modelo. Em resumo, você vai abordar os seguintes tópicos no tutorial de hoje:
Há uma variedade de sistemas usados em imagem médica, desde equipamentos abertos de RM com campo magnético de 0,3 Tesla (T), passando por sistemas para extremidades com até 1,0 T, até scanners de corpo inteiro com até 3,0 T (em uso clínico). Tesla é a unidade que mede a intensidade quantitativa do campo magnético nas imagens de RM. Scanners de alto campo (7T, 11,5T) oferecem SNR (relação sinal-ruído) mais alta mesmo com voxels menores (um patch ou grade 3D) e, por isso, são preferidos para diagnósticos mais precisos.
Voxels menores levam a melhor resolução, o que pode ajudar no diagnóstico clínico. Porém, a intensidade do campo magnético usada no scanner impõe um limite inferior ao tamanho do voxel para manter uma boa relação sinal-ruído (SNR) e preservar os detalhes da imagem de RM.
Apesar da qualidade superior de imagem em 7T e 11,5T, eles raramente são usados em produção por restrições de custo.
Segundo publicações recentes, há cerca de 20.000 scanners de 3T contra apenas ~40 scanners de 7T.
O dataset de MRI do cérebro é composto por volumes 3D; cada volume tem 207 cortes/imagens de RM obtidas em diferentes fatias do cérebro. Cada corte tem dimensão 173 x 173. As imagens são em tons de cinza de canal único. No total, são 30 sujeitos, cada um contendo o exame de RM de um paciente. O formato das imagens não é jpeg, png etc., mas sim NIfTI. Você vai ver na seção adiante como ler imagens no formato NIfTI.
O dataset contém imagens de RM na modalidade T1, tradicionalmente usadas para avaliação de estruturas anatômicas. O dataset que você vai usar hoje consiste em RM cerebrais de 3T.
O dataset é público e pode ser baixado nesta fonte.
Dica: se você quer aprender a implementar um Multi-Layer Perceptron (MLP) para classificação com o MNIST, confira este tutorial.
Observação : antes de começar, note que o modelo será treinado em um sistema com GPU Nvidia 1080 Ti, processador Xeon e5 GeForce e 32GB de RAM. Se você estiver usando Jupyter Notebook, será preciso adicionar três linhas de código para especificar a ordem do dispositivo CUDA e os dispositivos visíveis CUDA usando o módulo os.
No código abaixo, você define variáveis de ambiente no notebook usando os.environ. É uma boa prática fazer isso antes de inicializar o Keras para limitar o backend TensorFlow a usar a primeira GPU. Se a máquina em que você treina tem a GPU em 0, use 0 em vez de 1. Você pode verificar isso rodando um comando simples no terminal, por exemplo, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Primeiro, importe todos os módulos necessários como cv2, numpy, matplotlib e, mais importante, keras, já que é o framework que você vai usar hoje!
Para ler imagens em formato NIfTI, você também precisa importar um módulo chamado nibabel.
import os
import cv2
from keras.layers import Input,Dense,Flatten,Dropout,merge,Reshape,Conv2D,MaxPooling2D,UpSampling2D,Conv2DTranspose
from keras.layers.normalization import BatchNormalization
from keras.models import Model,Sequential
from keras.callbacks import ModelCheckpoint
from keras.optimizers import Adadelta, RMSprop,SGD,Adam
from keras import regularizers
from keras import backend as K
Using TensorFlow backend.
import numpy as np
import scipy.misc
import numpy.random as rng
from PIL import Image, ImageDraw, ImageFont
from sklearn.utils import shuffle
import nibabel as nib #reading MR images
from sklearn.cross_validation import train_test_split
import math
import glob
from matplotlib import pyplot as plt
%matplotlib inline
/usr/local/lib/python3.5/dist-packages/sklearn/cross_validation.py:44: DeprecationWarning: This module was deprecated in version 0.18 in favor of the model_selection module into which all the refactored classes and functions are moved. Also note that the interface of the new CV iterators are different from that of this module. This module will be removed in 0.20.
  "This module will be removed in 0.20.", DeprecationWarning)
Você vai usar o módulo glob, que retorna uma lista com todos os volumes na pasta que você especificar!
ff = glob.glob('ground3T/*')
Vamos imprimir o primeiro elemento da lista e também checar o tamanho da lista: no nosso caso, deve ser 30.
ff[0]
'ground3T/181232.nii.gz'
len(ff)
30
Agora está tudo pronto para carregar os volumes 3D usando nibabel. Observe que, ao carregar um volume no formato NIfTI, o Nibabel não carrega imediatamente o array da imagem; ele espera até você solicitar os dados. A forma usual é chamar o método get_data().
Como você quer os cortes 2D em vez do 3D, vai inicializar uma lista na qual, toda vez que ler um volume, vai iterar por todas as 207 fatias do volume 3D e adicionar cada corte, um a um, à lista.
images = []
Vamos também imprimir o shape de um dos volumes 3D; deve ser 173 x 207 x 173 (coordenadas x, y, z).
Observação: você vai usar apenas as 51 fatias centrais do cérebro, não todas as 207. Então, veja como selecionar apenas as fatias do centro e carregá-las.
for f in range(len(ff)):
    a = nib.load(ff[f])
    a = a.get_data()
    a = a[:,78:129,:]
    for i in range(a.shape[1]):
        images.append((a[:,i,:]))
print (a.shape)
(173, 51, 173)
Vamos analisar o shape de um corte dentre as 207 fatias.
a[:,0,:].shape
(173, 173)
Como images é uma lista, você vai usar o NumPy para convertê-la em um array.
images = np.asarray(images)
Hora de checar o shape do array NumPy. A primeira dimensão deve ser 207 x 30 = 6210 e as demais, 173 x 173.
images.shape
(1530, 173, 173)
As imagens do dataset são de fato em tons de cinza com dimensão 173 x 173, então, antes de alimentar os dados no modelo, é fundamental pré-processá-los. Primeiro, você vai converter cada imagem 173 x 173 em uma matriz 173 x 173 x 1, que pode ser passada para a rede:
images = images.reshape(-1, 173,173,1)
images.shape
(1530, 173, 173, 1)
Em seguida, reescale os dados usando a técnica de normalização max-min:
m = np.max(images)
mi = np.min(images)
m, mi
(3599.0959, -341.83853)
images = (images - mi) / (m - mi)
Vamos verificar o valor mínimo e máximo dos dados, que após o reescalonamento devem ser 0,0 e 1,0!
np.min(images), np.max(images)
(0.0, 1.0)
Este passo é importante: aqui você vai preencher as bordas das imagens com zeros para que as dimensões fiquem pares e seja mais fácil reduzir pela metade ao passá-las pelo modelo. Vamos adicionar zeros em três linhas e três colunas para chegar à dimensão 176 x 176.
temp = np.zeros([1530,176,176,1])
temp[:,3:,3:,:] = images
images = temp
Depois disso, é importante particionar os dados. Para que seu modelo generalize bem, divida em treino e validação. Você vai treinar em 80% dos dados e validar em 20%.
Isso também ajuda a reduzir as chances de overfitting, já que você valida em dados não vistos durante o treino.
Você pode usar o train_test_split do scikit-learn para dividir corretamente:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images,
                                                             images,
                                                             test_size=0.2,
                                                             random_state=13)
Observação: para esta tarefa, você não precisa de rótulos de treino e teste. Por isso, você passa as imagens de treino duas vezes. Elas atuam tanto como entrada quanto como ground truth, de forma semelhante aos rótulos em tarefas de classificação.
Agora vamos analisar como são as imagens do dataset e ver novamente as dimensões depois de adicionar três linhas e colunas extras, usando o atributo .shape do NumPy:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images.shape))
Dataset (images) shape: (1530, 176, 176, 1)
Pelo output acima, dá para ver que os dados têm shape 6210 x 176 x 176, já que há 6210 amostras, cada uma com matriz 176 x 176 x 1.
Agora, vamos ver algumas imagens de treino e validação do seu dataset:
plt.figure(figsize=[5,5])

# Display the first image in training data
plt.subplot(121)
curr_img = np.reshape(train_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')

# Display the first image in testing data
plt.subplot(122)
curr_img = np.reshape(valid_X[0], (176,176))
plt.imshow(curr_img, cmap='gray')
<matplotlib.image.AxesImage at 0x7ff67d5d59b0>
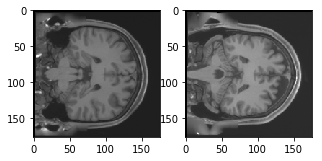
Os dois gráficos acima correspondem aos conjuntos de treino e validação. Você pode ver que são diferentes — vai ser interessante observar se o autoencoder convolucional consegue aprender as features e reconstruir bem essas imagens.
Agora é só definir a rede e alimentar os dados. Sem mais demora, vamos ao próximo passo!
As imagens têm tamanho 176 x 176 x 1 (um vetor de 30.976 dimensões). Você converte a matriz da imagem para array, reescala entre 0 e 1, faz o reshape para 176 x 176 x 1 e usa como entrada da rede.
Além disso, você vai usar batch size de 128; tamanhos maiores como 256 ou 512 também funcionam — depende do hardware em que você treina. O batch size influencia bastante na aprendizagem e na acurácia. Você vai treinar por 50 épocas.
batch_size = 128
epochs = 300
inChannel = 1
x, y = 176, 176
input_img = Input(shape = (x, y, inChannel))
Como você já deve saber, o autoencoder tem duas partes: encoder e decoder.
Encoder: 3 blocos convolucionais; cada bloco tem uma camada convolucional seguida de batch normalization. Max-pooling após o primeiro e o segundo blocos.
Decoder: 2 blocos convolucionais; cada bloco tem uma camada convolucional seguida de batch normalization. Upsampling após o primeiro e o segundo blocos.
O max-pooling reduz a entrada pela metade a cada uso, enquanto o upsampling aumenta pela metade a cada uso.
Observação: número de filtros, tamanho de filtro, número de camadas, épocas de treino — tudo são hiperparâmetros e devem ser ajustados com sua intuição. Sinta-se à vontade para experimentar e medir a performance. É assim que você evolui em deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    conv1 = BatchNormalization()(conv1)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv1)
    conv1 = BatchNormalization()(conv1)
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    conv2 = BatchNormalization()(conv2)
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv2)
    conv2 = BatchNormalization()(conv2)
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)
    conv3 = BatchNormalization()(conv3)
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3)
    conv3 = BatchNormalization()(conv3)


    #decoder
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    conv4 = BatchNormalization()(conv4)
    conv4 = Conv2D(64, (3, 3), activation='relu', padding='same')(conv4)
    conv4 = BatchNormalization()(conv4)
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    conv5 = BatchNormalization()(conv5)
    conv5 = Conv2D(32, (3, 3), activation='relu', padding='same')(conv5)
    conv5 = BatchNormalization()(conv5)
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Depois de criar o modelo, faça a compilação usando o otimizador RMSProp.
Observe que você também precisa especificar o tipo de loss via o argumento loss. Aqui, usamos mean squared error, já que a perda após cada batch será calculada entre a saída predita e o ground truth, pixel a pixel:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Vamos visualizar as camadas criadas usando a função summary — ela mostra o número de parâmetros (pesos e vieses) em cada camada e o total do modelo.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_2 (InputLayer)         (None, 176, 176, 1)       0
_________________________________________________________________
conv2d_18 (Conv2D)           (None, 176, 176, 32)      320
_________________________________________________________________
batch_normalization_11 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
conv2d_19 (Conv2D)           (None, 176, 176, 32)      9248
_________________________________________________________________
batch_normalization_12 (Batc (None, 176, 176, 32)      128
_________________________________________________________________
max_pooling2d_5 (MaxPooling2 (None, 88, 88, 32)        0
_________________________________________________________________
conv2d_20 (Conv2D)           (None, 88, 88, 64)        18496
_________________________________________________________________
batch_normalization_13 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
conv2d_21 (Conv2D)           (None, 88, 88, 64)        36928
_________________________________________________________________
batch_normalization_14 (Batc (None, 88, 88, 64)        256
_________________________________________________________________
max_pooling2d_6 (MaxPooling2 (None, 44, 44, 64)        0
_________________________________________________________________
conv2d_22 (Conv2D)           (None, 44, 44, 128)       73856
_________________________________________________________________
batch_normalization_15 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_23 (Conv2D)           (None, 44, 44, 128)       147584
_________________________________________________________________
batch_normalization_16 (Batc (None, 44, 44, 128)       512
_________________________________________________________________
conv2d_24 (Conv2D)           (None, 44, 44, 64)        73792
_________________________________________________________________
batch_normalization_17 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
conv2d_25 (Conv2D)           (None, 44, 44, 64)        36928
_________________________________________________________________
batch_normalization_18 (Batc (None, 44, 44, 64)        256
_________________________________________________________________
up_sampling2d_5 (UpSampling2 (None, 88, 88, 64)        0
_________________________________________________________________
conv2d_26 (Conv2D)           (None, 88, 88, 32)        18464
_________________________________________________________________
batch_normalization_19 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
conv2d_27 (Conv2D)           (None, 88, 88, 32)        9248
_________________________________________________________________
batch_normalization_20 (Batc (None, 88, 88, 32)        128
_________________________________________________________________
up_sampling2d_6 (UpSampling2 (None, 176, 176, 32)      0
_________________________________________________________________
conv2d_28 (Conv2D)           (None, 176, 176, 1)       289
=================================================================
Total params: 427,713
Trainable params: 426,433
Non-trainable params: 1,280
_________________________________________________________________
Finalmente, é hora de treinar o modelo com a função fit() do Keras! O modelo treina por 50 épocas. A fit() retorna um objeto de histórico; salvando o resultado em autoencoder_train, você pode depois plotar o loss de treino e validação para analisar visualmente o desempenho.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 1224 samples, validate on 306 samples
Epoch 1/300
1224/1224 [==============================] - 7s - loss: 0.1201 - val_loss: 0.0838
Epoch 2/300
1224/1224 [==============================] - 7s - loss: 0.0492 - val_loss: 0.0534
...
Epoch 299/300
1224/1224 [==============================] - 7s - loss: 1.3101e-04 - val_loss: 6.1086e-04
Epoch 300/300
1224/1224 [==============================] - 7s - loss: 1.0711e-04 - val_loss: 3.9641e-04
Pronto! Você treinou o modelo no dataset por 200 épocas. Agora, vamos plotar o gráfico de loss de treino e validação para visualizar a performance.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(300)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
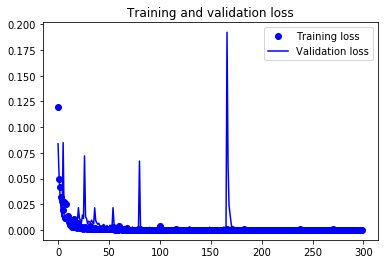
Dá para ver que o loss de validação e o de treino caminham juntos. Isso indica que seu modelo não está overfitting: o loss de validação está diminuindo e não aumentando, e quase não há gap entre ambos ao longo do treino.
Portanto, podemos dizer que a capacidade de generalização do seu modelo é boa.
Agora é hora de reconstruir as imagens de teste usando predict() do Keras e ver como o modelo se sai nos dados de teste.
Vamos salvar o modelo treinado. Esse passo é essencial em Deep Learning — afinal, os pesos são o coração da sua solução!
Você pode carregar os pesos salvos a qualquer momento no mesmo modelo e retomar o treino de onde parou. Por exemplo: ao treinar novamente, parâmetros como pesos, vieses e a função de loss não começam do zero — não é mais um treino do zero.
Com uma única linha, você salva e recarrega os pesos no modelo.
autoencoder = autoencoder.save_weights('autoencoder_mri.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder_mri.h5')
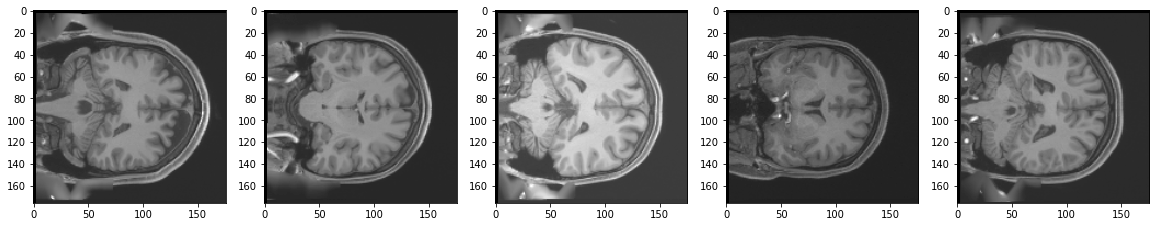
Como aqui você não tem um conjunto de teste separado, vamos usar os dados de validação para prever com o modelo recém-treinado.
Você vai rodar a previsão nas 306 imagens de validação e plotar algumas reconstruções para visualizar o quão bem o modelo reconstrói.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
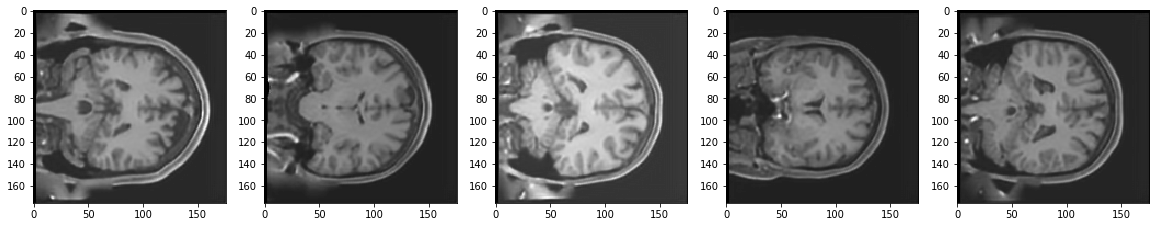
Pelas figuras acima, dá para ver que o modelo fez um ótimo trabalho ao reconstruir as imagens de teste. Pelo menos qualitativamente, as imagens originais e as reconstruídas parecem quase idênticas.
Talvez ainda dê para melhorar alguns detalhes locais presentes nas imagens 3T originais.
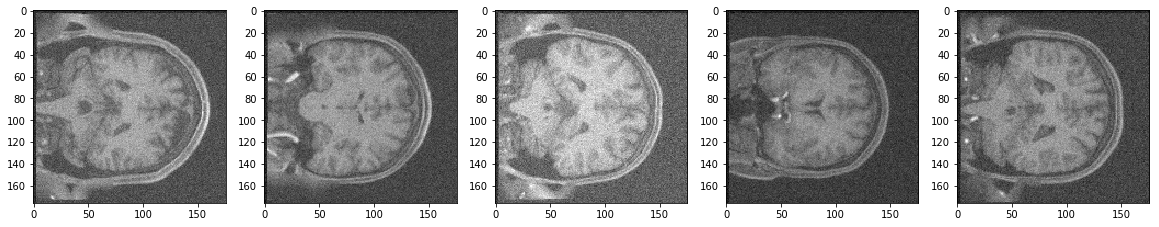
Primeiro, vamos adicionar ruído às imagens de validação, com média zero e desvio padrão de 0,03.
[a,b,c,d]= np.shape(valid_X)
mean = 0
sigma = 0.03
gauss = np.random.normal(mean,sigma,(a,b,c,d))
noisy_images = valid_X + gauss
Hora de prever nas imagens de validação com ruído. Vamos ver como seu modelo se sai, mesmo sem ter sido treinado com ruído.
pred_noisy = autoencoder.predict(noisy_images)
plt.figure(figsize=(20, 4))
print("Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(noisy_images[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Noisy Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred_noisy[i, ..., 0], cmap='gray')
plt.show()
Noisy Test Images
Reconstruction of Noisy Test Images
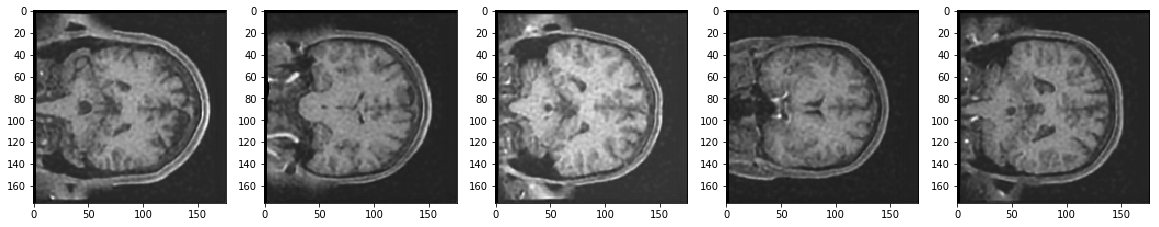
Parece que o modelo mandou bem, não é? As imagens reconstruídas ficaram melhores do que as com ruído — e o modelo nunca viu imagens ruidosas durante o treino.
O bloco de PSNR calcula o pico da relação sinal-ruído, em decibéis (dB), entre duas imagens. Essa razão é usada como medida de qualidade entre a imagem original e a reconstruída. Quanto maior o PSNR, melhor a qualidade da imagem reconstruída.
Então, vamos calcular primeiro o desempenho entre as imagens de validação e suas reconstruções.
valid_pred = autoencoder.predict(valid_X)
mse =  np.mean((valid_X - valid_pred) ** 2)
psnr = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr,2)))
PSNR of reconstructed validation images: 34.02dB
Agora, vamos calcular o PSNR entre as imagens de validação originais e as imagens ruidosas reconstruídas.
noisy_pred = autoencoder.predict(noisy_images)
mse =  np.mean((valid_X - noisy_pred) ** 2)
psnr_noisy = 20 * math.log10( 1.0 / math.sqrt(mse))
print('PSNR of reconstructed validation images: {psnr}dB'.format(psnr=np.round(psnr_noisy,2)))
PSNR of reconstructed validation images: 32.48dB
Pelo visto, quantitativamente há uma diferença de apenas 1,54 dB entre o PSNR das reconstruções sem ruído e com ruído. E você nem treinou o modelo para lidar com ruído. Incrível, né?
Este tutorial foi um ótimo ponto de partida para entender como ler imagens de MRI no formato NIfTI, analisar, pré-processar e alimentá-las no modelo usando um dataset de MRI cerebral 3T. Você viu, na prática, uma aplicação bacana de autoencoders. Se você acompanhou com facilidade — ou mesmo com um pouco mais de esforço — parabéns!
Brinque com a arquitetura e tente melhorar as previsões, tanto quantitativa quanto qualitativamente. Talvez adicionando mais camadas? Ou treinando por mais tempo? Teste essas combinações e veja o que funciona melhor.
Ainda há muito o que explorar, então por que não fazer o curso Deep Learning in Python da DataCamp, se você ainda não fez? Você vai aprender do básico até dominar o universo de deep learning — será um recurso indispensável para trabalhar com redes neurais convolucionais em Python, detecção de faces, objetos e muito mais.
cursos de deep learning
Curso
Curso
Curso
blog
Abid Ali Awan
7 min
Tutorial
Abid Ali Awan
10 min
Tutorial
Zoumana Keita
14 min
Tutorial
Zoumana Keita
14 min
Tutorial
Bharath K
13 min
Tutorial
Kurtis Pykes
14 min