
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Als je bent begonnen met lineaire algebra voor data science, heb je de term "rij-echelonvorm" vast al vaak gehoord.
Rij-echelonvorm (REF) is een vorm van een matrix die helpt bij het oplossen van een stelsel lineaire vergelijkingen. Door een matrix naar deze speciale vorm te transformeren, kunnen we bepalen of een stelsel oplossingen heeft, die oplossingen vinden en de structuur van het lineaire stelsel begrijpen.
In dit artikel bekijken we wat rij-echelonvorm is en hoe die verschilt van gereduceerde rij-echelonvorm. We schetsen ook stap voor stap hoe je matrices transformeert met elementaire rijoperaties, leren hoe je lineaire stelsels oplost met terugsubstitutie en verkennen geavanceerde technieken en concepten rond rij-echelonvorm.
Laten we begrijpen wat rij-echelonvorm is en de belangrijkste concepten eromheen.
Een matrix staat in rij-echelonvorm als deze aan drie voorwaarden voldoet:
Dit creëert een soort “trappatroon” waarbij de leidende elementen (pivots) van links naar rechts naar beneden lopen.
Deze matrix staat bijvoorbeeld in rij-echelonvorm:
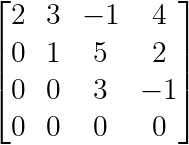
Rij-echelonvorm. (Afbeelding door auteur)
Zoals we hierboven zien, vormen de pivots (2, 1 en 3) het trappatroon, met nullen onder elke pivot. Deze structuur maakt het eenvoudig om stelsels op te lossen via terugsubstitutie (zoals we later zullen bekijken).
Gereduceerde rij-echelonvorm gaat een stap verder met twee extra eisen:
Hier is hetzelfde stelsel als hierboven, na transformatie naar RREF:
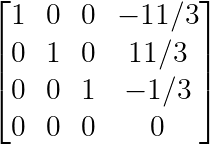
Gereduceerde rij-echelonvorm. (Afbeelding door auteur)
Hoewel een stelsel meerdere rij-echelonvormen kan hebben, is de gereduceerde rij-echelonvorm uniek.
Die uniciteit maakt RREF handig om de structuur van oplossingsverzamelingen te herkennen, maar de extra rekenstappen om RREF te bereiken betekenen dat de gewone rij-echelonvorm in combinatie met terugsubstitutie vaak efficiënter is om stelsels op te lossen.
Er zijn drie soorten elementaire rijoperaties die de oplossingsverzameling behouden terwijl ze matrices transformeren.
Rijen wisselen verwisselt twee rijen; handig als we een niet-nul element als pivot willen positioneren:
R₁ ↔ R₂Rijschaalvergroting vermenigvuldigt alle elementen in een rij met een niet-nul constante, wat helpt om pivotwaarden te normaliseren:
R₁ → cR₁ (where c ≠ 0)Rijoptelling vervangt één rij door de som van zichzelf en een veelvoud van een andere rij; nuttig om nullen onder pivots te creëren:
R₂ → R₂ + cR₁Deze operaties vormen de bouwstenen van Gaussiaanse eliminatie, het algoritme waarmee we systematisch elke matrix naar rij-echelonvorm kunnen transformeren met behoud van dezelfde oplossingsverzameling.
Laten we stap voor stap een voorbeeld uitwerken, waarin we eerst een lineair stelsel nemen en het terugbrengen tot rij-echelonvorm.
Beschouw het stelsel:
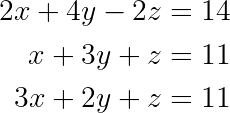
Stelsel van lineaire vergelijkingen. (Afbeelding door auteur)
We maken eerst de uitgebreide matrix door de coëfficiëntenmatrix te combineren met de constanten:
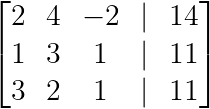
De uitgebreide matrix maken (afbeelding door auteur)
We willen het element linksboven als eerste pivot. We zouden met 2 kunnen werken, maar rijen wisselen om 1 als pivot te krijgen vereenvoudigt de berekeningen:
R₁ ↔ R₂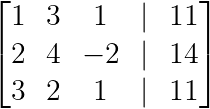
De eerste pivot maken (afbeelding door auteur)
We maken nu nullen onder de eerste pivot door passende veelvouden van rij 1 af te trekken:
R₂ → R₂ - 2R₁
R₃ → R₃ - 3R₁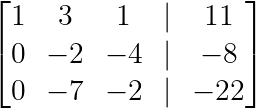
Elimineren onder de eerste pivot. (Afbeelding door auteur)
We gaan naar de tweede kolom en vereenvoudigen door rij 2 te schalen:
R₂ → -½R₂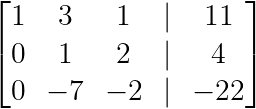
De tweede pivot maken. (Afbeelding door auteur)
Maak een nul onder de tweede pivot:
R₃ → R₃ + 7R₂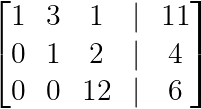
Elimineren onder de tweede pivot. (Afbeelding door auteur)
De matrix staat nu in rij-echelonvorm! Dat zien we door onze drie criteria te controleren:
Zodra een matrix in rij-echelonvorm staat, kunnen we oplossingen vinden met terugsubstitutie of de eigenschappen van het stelsel analyseren via de rang.
Met onze matrix in rij-echelonvorm helpt terugsubstitutie om de variabelen te vinden door onderaan te beginnen en naar boven te werken.
Met ons voorbeeld hierboven:
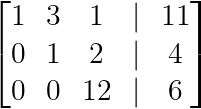
Rij-echelonvorm (afbeelding door auteur)
Uit de uitgebreide matrix kunnen we het equivalente stelsel opschrijven:
We beginnen onderaan:
Invullen in de tweede vergelijking:
Tot slot vullen we beide waarden in:
Voor onderbepaalde stelsels (als het aantal variabelen groter is dan het aantal vergelijkingen) onthult de rij-echelonvorm vrije variabelen.
Laten we nog zo'n voorbeeld bekijken:
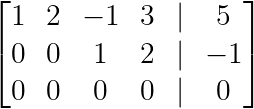
Rij-echelonvorm van onderbepaalde stelsels. (Afbeelding door auteur)
Hier is y een vrije variabele (geen pivot in kolom 2), wat leidt tot een parametrische oplossing:
De oplossing kun je zien als een vlak in de 4D-ruimte, geparametriseerd door y en w.
De rang van een matrix is gelijk aan het aantal niet-nul rijen in de rij-echelonvorm, wat overeenkomt met het aantal pivots.
Dit helpt ons de oplossingsruimte te begrijpen:
Met deze aanpak via rij-echelonvorm kunnen we het gedrag van een stelsel begrijpen voordat we het oplossen.
Als je geïnteresseerd bent in meer geavanceerde onderwerpen rond REF, verkent deze sectie verschillende pivottechnieken die gebruikt worden bij het transformeren van matrices.
Bij het computationeel bereiken van rij-echelonvorm heeft de keuze van de pivot veel invloed op de numerieke nauwkeurigheid.
Laten we dit begrijpen met een voorbeeld:
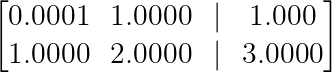
Voorbeeld numerieke stabiliteit. (Afbeelding door auteur)
Zonder pivoteren kunnen we de tweede rij delen door 0,0001 om de piepkleine pivot te elimineren:
R₂ → R₂ — (1/0.0001)R₁ = R₂ — 10,000R₁Deze vermenigvuldiging met 10.000 versterkt afrondingsfouten, wat de nauwkeurigheid van onze oplossing kan ondermijnen.
Als we echter eerst de rijen omwisselen, wordt de matrix:
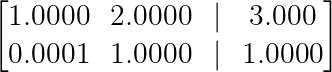
Voorbeeld numerieke stabiliteit. (Afbeelding door auteur)
Nu hoeven we alleen R₂ → R₂ — 0,0001R₁ te doen, een veel stabielere bewerking die de numerieke nauwkeurigheid behoudt. Dit idee vormt de basis van partiële pivotering, die veel wordt gebruikt in numerieke software.
Partiële pivotering kiest het element met de grootste absolute waarde in de huidige kolom (beginnend vanaf de huidige rij naar beneden) en wisselt rijen om die waarde in de pivotpositie te brengen.
In het onderstaande voorbeeld, bij het verwerken van kolom 2:
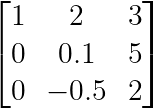
Voorbeeld van partiële pivotering. (Afbeelding door auteur)
Partiële pivotering zou rijen 2 en 3 omwisselen om -0,5 de pivot te maken, aangezien |−0,5| > |0,1|. Deze strategie verbetert de stabiliteit en is standaard geworden in numerieke bibliotheken zoals NumPy, SciPy en MATLAB.
Geschaalde partiële pivotering voegt een extra stap toe waarbij elke kandidaat wordt gedeeld door de grootste absolute waarde in zijn rij voordat de pivot wordt gekozen.
Deze “schaalfactor” houdt rekening met de grootte van de elementen in elke rij en voorkomt een voorkeur voor rijen met van nature grote waarden.
Bij volledige pivotering worden zowel rijen als kolommen verwisseld om te garanderen dat de pivot de grootste absolute waarde is in de overblijvende submatrix (niet alleen in de kolom).
Hoewel dit het meest numeriek stabiele eliminatieproces oplevert, gaat het ten koste van extra rekenwerk. Daarom wordt het zelden in de praktijk gebruikt, tenzij extreme precisie nodig is, zoals bij symbolische berekeningen of cruciale wetenschappelijke simulaties.
Zoals we eerder leerden, zijn beide vormen nuttig in de lineaire algebra, maar we moeten ook weten wanneer we welke vorm gebruiken.
De tabel hieronder vat de verschillen tussen beide vormen samen:
|
Kenmerk |
Rij-echelonvorm (REF) |
Gereduceerde rij-echelonvorm (RREF) |
|
Pivotvereisten |
Elke niet-nul waarde |
Moet 1 zijn |
|
Elementen boven pivots |
Mogen elke waarde hebben |
Moeten 0 zijn |
|
Uniciteit |
Niet uniek |
Uniek voor elke matrix |
|
Rekenkosten |
Lager (minder bewerkingen) |
Hoger (extra stappen) |
|
Oplossingsmethode |
Vereist terugsubstitutie |
Oplossingen direct af te lezen |
|
Beste usecase |
Snel stelsels oplossen |
Inzicht in de structuur van oplossingen |
Rij-echelonvorm is het best als je snel een stelsel wilt oplossen, vooral bij grote matrices, waar de extra stappen voor RREF kostbaar zouden zijn. Het is de voorkeursvorm voor numerieke algoritmen zoals LU-decompositie.
Gereduceerde rij-echelonvorm is geschikter voor onderzoek en theorie, wanneer je direct de fundamentele structuur van een lineaire transformatie wilt begrijpen, bases voor rij- en kolomruimten wilt vinden of lineaire onafhankelijkheid van vectoren wilt vaststellen. De unieke representatie maakt het ideaal voor theoretische analyse en geautomatiseerd stellingbewijzen.
In dit artikel hebben we gezien hoe elementaire rijoperaties matrices kunnen transformeren met behoud van oplossingen, en de verschillen tussen REF en RREF begrepen. Verder leerden we enkele geavanceerde pivotstrategieën en varianten van REF die nuttig zijn in speciale situaties.
Wil je je begrip van lineaire algebra en de toepassingen in data science verdiepen, overweeg dan je in te schrijven voor onze Linear Algebra for Data Science-cursus, waar je dieper ingaat op andere concepten en technieken in de lineaire algebra naast essentiële matrixbewerkingen.
Leer met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


