

TabPy Tools
TabPy Tools is een Python-pakket voor het implementeren en beheren van Python-functies op de TabPy-server.
Laten we dieper ingaan op de functionaliteiten van TabPy Tools.
Verbinding maken met TabPy
Met de clientfunctie kun je de Python-API via URL en PORT met de TabPy-server verbinden.
rom tabpy.tabpy_tools.client import Client
client = Client('http://localhost:9004/')We kunnen het object “client” gebruiken om authenticatie in te stellen en Python-functies op de server te beheren.
Authenticatie
Je kunt je gebruikersnaam en wachtwoord instellen met de functie “set_credentials”. Het is nodig om inloggegevens in te stellen om een model op de server te implementeren.
Opmerking: voer deze functie alleen uit als je authenticatie op de TabPy-server hebt ingeschakeld. Lees de documentatie over serverconfiguratie voor meer informatie.
client.set_credentials('username', 'password')Een functie implementeren
Maak een functie en publiceer deze met de functie `client.deploy()`. Deze vereist drie argumenten: functienaam, Python-functie en beschrijving.
De functie addition telt twee gegevensvelden op en retourneert de lijst. Later wordt de functie “add” in Tableau gebruikt.
client.deploy('add', addition, 'Adds two numbers x and y')Een model implementeren
Wanneer je een machinelearningmodel hebt getraind en de inferentiefunctie van het model hebt geïmplementeerd, slaat Tableau het model en de functiedefinities automatisch op met cloudpickle. Het blijft in het servergeheugen voor een snellere responstijd.
Met andere woorden: je hoeft je model niet opnieuw te trainen wanneer er iets in Tableau verandert. We leren later meer over het implementeren van modellen.
Endpoints verwijderen
Gebruik de functie `remove` om een functie of model te verwijderen. Hiervoor is alleen een functienaam nodig.
client.remove('add')>>> Voor meer geavanceerde functies, bekijk de TabPy/tabpy-repository op GitHub.
Een Python-functie implementeren met een IDE
Net als in deel één maken we een functie voor de Pearson-correlatiecoëfficiënt. In plaats van de functie in Tableau te schrijven, implementeren we haar op de server met de Python-API en gebruiken we de functie vervolgens via een Tableau-berekening.
In deze sectie gebruiken we de Sales Store Product-dataset van Kaggle om de correlatie tussen de gegevensvelden sales en profit te berekenen.
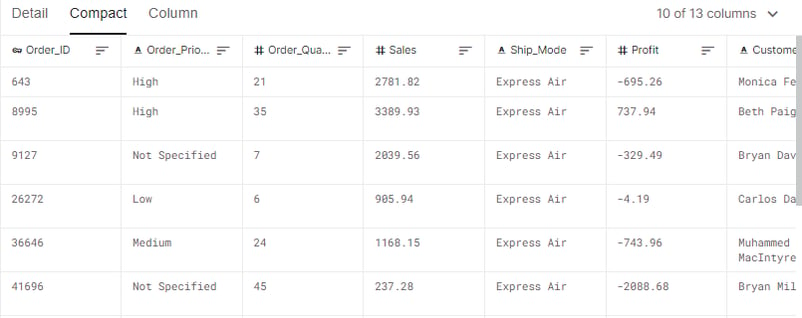
Kaggle-dataset Sales Store Product
Voordat we Python-code gaan schrijven, zorg dat je de nieuwste TabPy-package hebt.
pip install -U tabpyDraai de server lokaal via een terminal.
tabpyTabPy Client
Als je vertrouwd bent met Python, is dit deel eenvoudig te begrijpen. Je kunt alles over Python-functies leren in de cursus introductie tot Python.
- We importeren Client uit tabpy_tools en NumPy voor berekeningen.
- Verbind de TabPy-server via URL en PORT.
- Maak pearson_correlation_coefficient() die x en y aanneemt en de correlatiecoëfficiënt als enkele kolom retourneert.
- Gebruik de functie client.deploy() om de functie “pcc” te publiceren. Deze vereist drie argumenten: naam, functie en beschrijving.
from tabpy.tabpy_tools.client import Client
import numpy as np
client = Client('http://localhost:9004/')
def pearson_correlation_coefficient(x,y):
return np.corrcoef(x,y)[0,1]
client.deploy('pcc', pearson_correlation_coefficient, 'correlation coefficient is extracted of x and y')TabPy Query
We roepen deze functie nu aan in Tableau met tabpy.query(). Hiervoor zijn de Python-functienaam en argumentplaceholders zoals _arg1 en _arg2 nodig.
- Voeg binnen SCRIPT_REAL het queryscript toe en aggregeer de gegevensvelden.
- Het queryscript begint met return en eindigt met [‘response’] om resultaten uit JSON te halen.
- Stel de standaard tabelberekening in op het gegevensveld Customer Name.
- Apply en klik op OK.
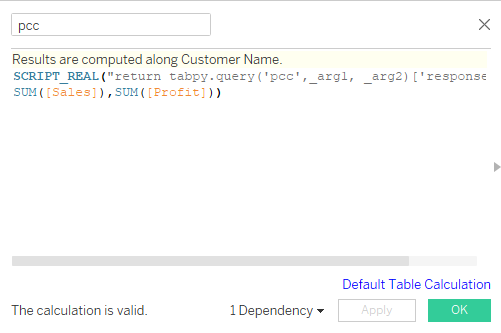
Berekend veld Pearson-correlatiecoëfficiënt
Je kunt het eerste deel van de tutorial bekijken om de Tableau-script te begrijpen.
SCRIPT_REAL("return tabpy.query('pcc',_arg1, _arg2)['response']",
SUM([Sales]),SUM([Profit]))Datavisualisatie
We maken nu een visualisatie die de correlatie toont, uitgesplitst naar productcategorie en klantsegmentatie.
- Sleep Customer Name naar Detail en Ship Mode naar Kleur in het Marks-paneel.
- Sleep Customer Segment en pcc (berekend correlatieveld) naar de plank Kolommen.
- Sleep Product Category naar de plank Rijen.
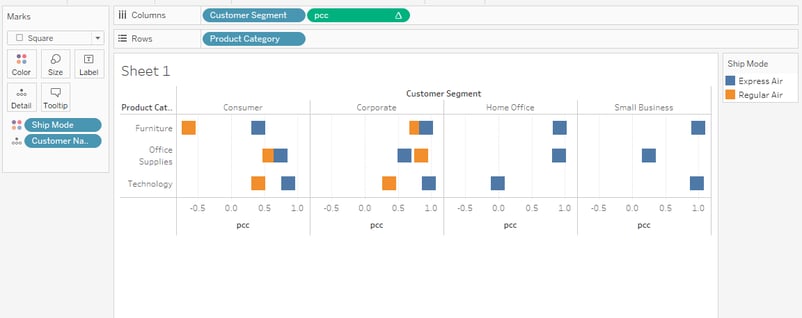
Staafdiagram van de correlatiecoëfficiënt
In de meeste gevallen heeft de Corporate-sector een hoge correlatie tussen sales en profit. Over het geheel genomen kun je correlatiecoëfficiënten gebruiken om datagedreven beslissingen te nemen die de winst van het bedrijf verhogen.
Lees onze tutorial Python details on correlation om te leren over andere correlatiecoëfficiënten, het berekenen van correlatie in Python en de relatie tussen correlatie en causaliteit.
Prophet-model implementeren in Tableau
In deze sectie leren we het Facebook Prophet-voorspellingsmodel te implementeren en datumvelden te bewerken. We trainen het tijdreeksmodel op Apple Stock Prices van 2015 tot 2020.
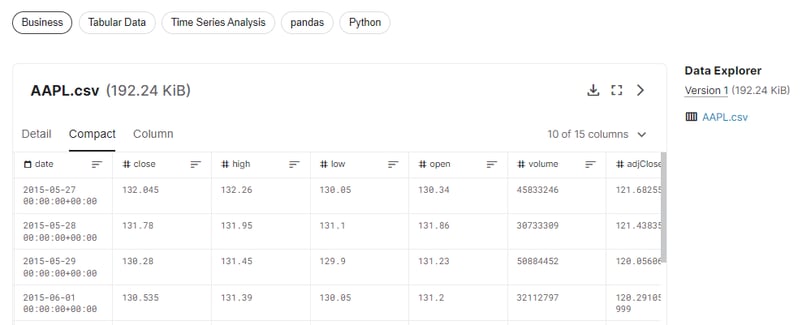
Kaggle-dataset Apple Stock Prices (2015-2020)
Voordat we scripts schrijven en een voorspellingsvisualisatie in Tableau maken, moeten we Python-code testen en het voorspellingsmodel evalueren in Jupyter Notebook.
Facebook Prophet
Facebook Prophet is een open-sourcelibrary voor automatische voorspelling van univariate tijdreeksdata. Het werkt het best met jaarlijkse, wekelijkse en dagelijkse seizoenseffecten.
Waarom Prophet?
Het kan goed overweg met ontbrekende data, trendverschuivingen en uitschieters.
Prophet installeren
Je kunt het Prophet-Python-pakket installeren met onderstaand commando in de terminal.
pip install pystan==2.19.1.1
pip install prophetOf als je de Anaconda-Pythonomgeving gebruikt, gebruik dan onderstaand commando.
conda install -c conda-forge prophetProjectinitialisatie
- We beginnen met het importeren van pandas voor data-inname en -bewerking en Prophet voor het trainen en evalueren van voorspellingsmodellen.
- Lees de Apple-aandelendataset (AAPL.csv) in met de pandas-functie read_csv.
- Definieer X met de kolommen date en high.
- Toon de vorm (shape) van de dataframe en visualiseer de tijdreeks-lijngrafiek van de kolom high.
import pandas as pd
from prophet import Prophet
data = pd.read_csv("AAPL.csv")
X = data.loc[:, ['date','high']]
print(X.shape)
X.plot();Uitvoer
(1258, 2)De Apple-aandelen stijgen in de tijd. Er zijn twee dips geweest, maar de koers is hersteld naar stabiele groei.
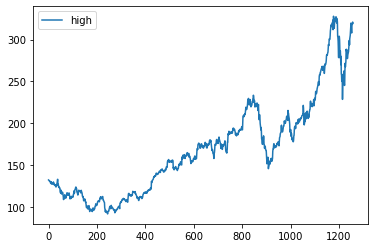
Volg de tutorial Python tijdreeksanalyse door Hugo Bowne-Anderson voor diepgaande kennis. Je kunt ook een korte cursus bij DataCamp volgen over tijdreeksanalyse in Python voor hands-on ervaring.
Het machinelearningmodel bouwen
In dit deel bereiden we de data voor het Prophet-model voor en trainen we het met standaardhyperparameters.
- Hernoem de kolommen naar ds en y
- Zet de kolom ds om naar datetime (datum)
- Definieer een model met Prophet()
- Train het model met model.fit()
X.columns = ['ds', 'y']
X['ds']= pd.to_datetime(X['ds'], format='%Y-%m-%d').dt.date
model = Prophet()
# fit the model
model.fit(X)Model-evaluatie
Voor de evaluatie moeten we toekomstige datums aan de dataset toevoegen. Dat kan met make_future_dataframe.
We stellen in:
- prediods op 365 dagen
- freq op “D”. Je kunt dit ook wijzigen naar “Y”, maar dan moet je periods op 1 zetten.
- include_history op false om eerdere data weg te laten.
future = model.make_future_dataframe(periods=365,
freq='D',
include_history=False
)
future.tail()Uitvoer
Zoals we zien eindigt de dataset future in het jaar 2021.
ds
360 2021-05-18
361 2021-05-19
362 2021-05-20
363 2021-05-21
364 2021-05-22De volgende stap is deze data te gebruiken om de high-waarden van het Apple-aandeel te voorspellen. Daarna tonen we 'ds', 'yhat', 'yhat_lower' en 'yhat_upper'.
De yhat_lower en yhat_upper definiëren het acceptabele variatiebereik. Simpel gezegd: de aandelenkoers kan oplopen tot 485,3 en dalen tot 365,4. Deze informatie kan daghandelaren helpen het risico in te schatten.
forecast = model.predict(future)
forecast[['ds', 'yhat', 'yhat_lower', 'yhat_upper']].tailUitvoer
ds yhat yhat_lower yhat_upper
360 2021-05-18 423.757736 365.415878 485.293438
361 2021-05-19 423.862811 365.527086 482.751097
362 2021-05-20 423.918642 365.233839 482.501335
363 2021-05-21 423.842872 364.454184 483.672508
364 2021-05-22 421.187822 360.181717 481.024524Laten we de voorspellingsdata visualiseren met de functie plot(). Deze heeft de voorspelde waarden nodig om de punten- en lijngrafiek te tonen met het acceptabele bereik in blauw.
model.plot(forecast)De onderstaande visualisatie laat zien dat de Apple-aandelen in waarde zullen groeien zonder dip.
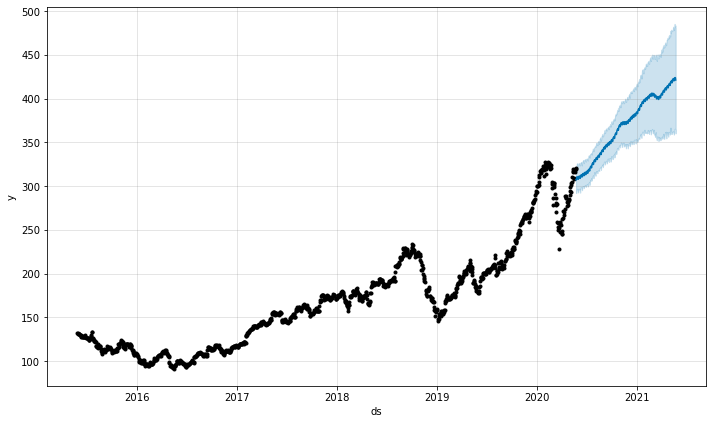
Je kunt de voorspelling verbeteren door hyperparameters aan te passen die te maken hebben met verzadigende voorspellingen, trend-breekpunten, seizoensinvloeden, vakantiedagen en regressoren, multiplicatieve seizoensinvloeden, onzekerheidsintervallen en uitschieters. Je kunt ze ook automatisch afstemmen met hyperparameter-tuning. Leer meer over Facebook Prophet in de documentatie.
Tijdreeksvoorspelling is een breed vakgebied. Je kunt alles leren over tijdreeksvoorspelling in onze tutorial time series forecasting door Moez Ali. De tutorial behandelt tijdreeksanalyse, statistische modellen, Python-frameworks en AutoML.
Je kunt ook onze cursus visualizing time series data in Python volgen en alles leren over lijngrafieken, seizoenspatronen, trend en ruis detecteren, en meerdere tijdreeksen tonen.
De modelinferentie implementeren
In deze sectie implementeren we modelinferentie. Hiermee kunnen we het model en de functiedefinitie opslaan op de TabPy-server voor een snellere responstijd.
We maken eerst verbinding met de Client via URL en PORT. Daarna definiëren we de functie prophet_forecasting.
- Deze neemt een aantal jaren voor de voorspelling en gebruikt dat om een future-dateframe te maken.
- Maak voorspellingen met model.predict en de future-dataframe.
- Hernoem “yhat” naar “y” zodat we de voorspelling met historische data kunnen samenvoegen.
- Het laatste deel is lastig. In Tableau kunnen we geen waarde toevoegen aan het data-veld. In plaats daarvan verschuiven we de datumwaarden met 365*n. Waarbij n het aantal jaren is.
Tot slot verpakken en implementeren we dit op de TabPy-server met client.deploy(). We stellen de functienaam in op “prophet”. Het argument override helpt ons versies van het model en de functie te maken. Dit is nodig in de beginfase waarin we code debuggen.
from tabpy.tabpy_tools.client import Client
client = Client('http://localhost:9004/')
def prophet_forecasting(n):
future = model.make_future_dataframe(periods=365*n,include_history=False)
prediction = model.predict(future)
prediction.rename(columns={"yhat":"y"}, inplace=True)
return pd.concat([X,prediction[['ds','y']]])['y'].to_list()[365*n:]
client.deploy('prophet',
prophet_forecasting,
'forecast time series data using prophet',override=True)Tableau instellen
Om het aantal jaren binnen Tableau te bepalen, moeten we een Years-parameter maken. Deze wordt gebruikt in de prophet-functie.
We kunnen een Years-parameter maken door in de sectie Data met de rechtermuisknop te klikken en Create Parameter te kiezen. Verander het Data type naar Integer, Current value naar 1, en klik op Range om Minimum 1 en Maximum 5 toe te voegen.
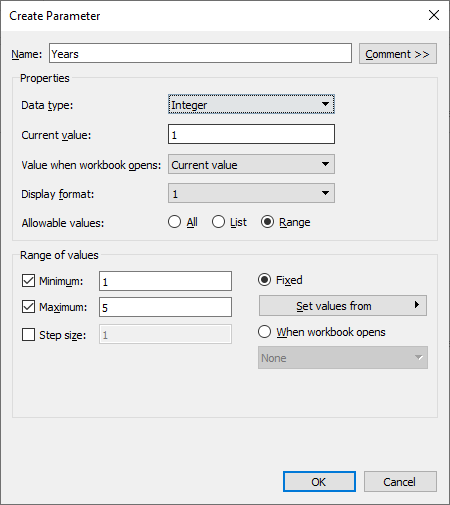
Years-parameter maken
Daarna maken we een berekend veld Forecast_date. We gebruiken het gegevensveld Date en verschuiven de waarden met het aantal Years.
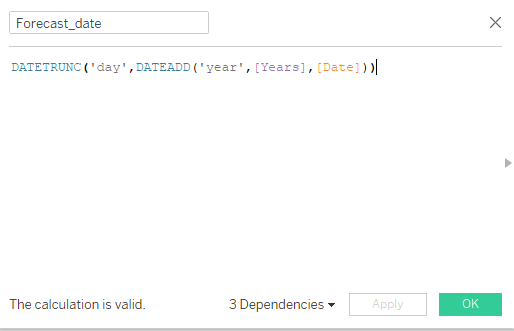
Berekend veld Forecast_date
De functie DATEADD voegt Years toe aan het gegevensveld Date en wordt vervolgens afgekapt tot dag.
DATETRUNC('day',DATEADD('year',[Years],[Date])))In het volgende deel maken we een berekend veld forecast en gebruiken we het geïmplementeerde model via tabpy.query(). De queryfunctie bestaat uit twee delen: het eerste deel is de naam van de Python-functie en het tweede deel is de lijst met placeholders voor argumenten.
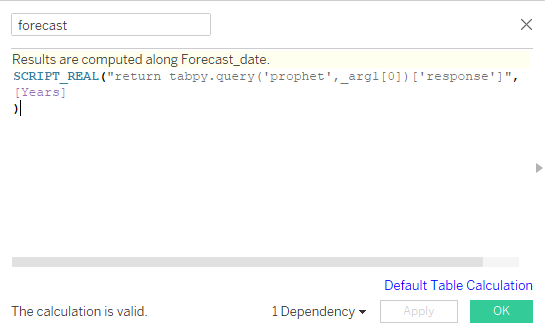
berekend veld forecast
In ons geval is het slechts één argument, dus voegen we _arg1 toe. We verpakken de query in een Tableau-functie genaamd SCRIPT_REAL en geven de Years-parameter als input. Voordat je op de knop OK drukt, zorg dat de resultaten worden berekend langs Forecast_date. Je kunt dit wijzigen door op de blauwe tekst te klikken (Default Table Calculation).
SCRIPT_REAL("return tabpy.query('prophet',_arg1[0])['response']",
[Years]
)Daarna maken we een berekend veld Actual met het gegevensveld High en de parameter Years.
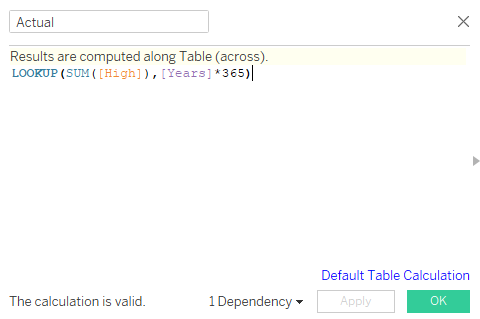
Berekend veld Actual
LOOKUP helpt ons de waarden van High te verschuiven met Years*365. Bijvoorbeeld: als de parameter Years 2 is, dan worden de waarden met 730 verschoven.
LOOKUP(SUM([High]),[Years]*365)Actual vs. Forecast
We zijn eindelijk aan het einde. Om de lijngrafiek van Actual vs. Forecast te plotten, volgen we deze eenvoudige stappen:
- Ga naar de sectie Parameters linksonder, klik met de rechtermuisknop op de parameter Years en selecteer Show Parameters.
- Sleep Forecast_date naar de plank Kolommen. Verander dit naar Day.
- Sleep Measure Names van Dimensions naar Filters. Selecteer alleen Actual en forecast.
- Sleep Measure Names van Dimensions naar Kleur.
- Sleep ten slotte Measure Names van Measures naar de plank Rijen.
Na alle stappen zie je Actual en forecast in verschillende kleuren.
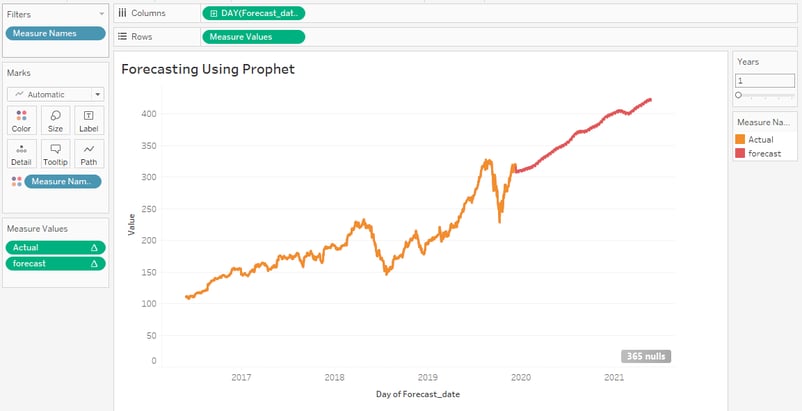
Lijngrafiek Actual vs. Forecast
De bovenstaande lijngrafiek is verre van perfect en vraagt om hyperparameter-tuning, cross-validatie, imputatie van missende waarden en datums, en verbetering van de datumfunctie.
Conclusie
In deze tutorial hebben we geleerd een machinelearningmodel te bouwen en te implementeren op de TabPy-server en het te gebruiken via een Tableau-script. We hebben ook de basis van tabpy_tools behandeld en gezien hoe we dit kunnen inzetten om functies of modellen te implementeren.
Leer meer over financiële voorspellingen met de DataCamp-cursus. Je leert resultatenrekeningen, balansen en prognoseratio’s begrijpen, ruwe data opmaken, datums en financiële perioden beheren, en aannames en afwijkingen in prognoses.
Tijdreeksvoorspelling is de basis; we verbeteren onze voorspellingen door de data te trainen met andere machinelearningalgoritmes zoals:
- Autoregressive Integrated Moving Average (ARIMA)
- Seasonal Autoregressive Integrated Moving Average (SARIMA)
- Exponential Smoothing (ES)
- XGBoost
- LSTM (Deep Learning)
- Temporal Fusion Transformer (Google)
Ben je nieuw in Tableau en wil je alles leren over datavisualisatie en statistische berekeningen? Volg dan het skill track Tableau fundamentals.
Dit is het laatste deel van de serie. In het eerste deel van deze TabPy-tutorial hebben we alles over TabPy geleerd en een Python-script binnen Tableau uitgevoerd om verschillende clusters van Airbnb-lijsten in Amsterdam te maken.

