Curso
Introdução ao R
4 h
3.1M
Neste tutorial, você vai conhecer o ecossistema do Bioconductor. Com isso, será capaz de realizar análises computacionais e estatísticas sobre os resultados do seu experimento biológico — algo essencial para qualquer pesquisador comprovar a relevância de suas conclusões. Em outras palavras, você poderá verificar se os dados usados são consistentes com sua hipótese ao utilizar este projeto. Além disso, dá para validar sua pergunta científica estatisticamente sem desperdiçar tempo e dinheiro.
Em resumo, este tutorial vai esclarecer:
- O que é o Bioconductor?
- O que são os pacotes R do Bioconductor?
- Como podemos usá-lo?
O Bioconductor é um projeto de software aberto para biologia computacional e bioinformática. É um projeto de código aberto e desenvolvimento aberto para a comunidade de biologia computacional. É open-source porque qualquer pessoa pode ler e modificar o código, e de desenvolvimento aberto porque qualquer um pode contribuir e participar da evolução do projeto. Ele fala a linguagem R, amplamente usada em ciência de dados por ser flexível, especialmente para análise de dados. O R também tem gráficos de alta qualidade e interopera com outras linguagens. O Bioconductor oferece acesso a métodos estatísticos e gráficos poderosos para análise de dados genômicos. Também facilita a integração de metadados biológicos como GenBank, GO, LocusLink e PubMed na análise de dados experimentais.
Além disso, permite o desenvolvimento rápido de softwares extensíveis, interoperáveis e escaláveis. Documentação de alta qualidade e pesquisas reprodutíveis podem ser promovidas com o Bioconductor. Ele oferece treinamento em métodos computacionais e estatísticos. Em linhas gerais, o Bioconductor pode ser dividido em três partes:
| Análise estatística | Compreensão | Alto rendimento |
|---|---|---|
| Grandes volumes de dados | Contexto biológico | Sequenciamento |
| Artefatos tecnológicos | Visualização | Microarranjos |
| Experimentos planejados | Reprodutibilidade | Citometria de fluxo |
Análises em biologia computacional quase sempre exigem várias ferramentas diferentes combinadas para responder a uma pergunta específica. Isso geralmente resulta em um pacote que outros pesquisadores também podem usar. Assim, o Bioconductor é também um repositório de pacotes R com regras e princípios orientadores. A versão 3.7 tem mais de 1500 pacotes, usados por milhares de pesquisadores no mundo todo. Esses pacotes costumam ter documentação excelente. Como qualquer pessoa pode contribuir, pode haver mais de uma opção de pacote para resolver um mesmo problema — o que cria um ambiente competitivo entre os desenvolvedores.
O site traz materiais sobre como instalar, aprender, usar e contribuir com projetos do Bioconductor. O projeto começou no outono de 2001 e reúne mais de 20 desenvolvedores centrais nos EUA, Europa e Austrália.
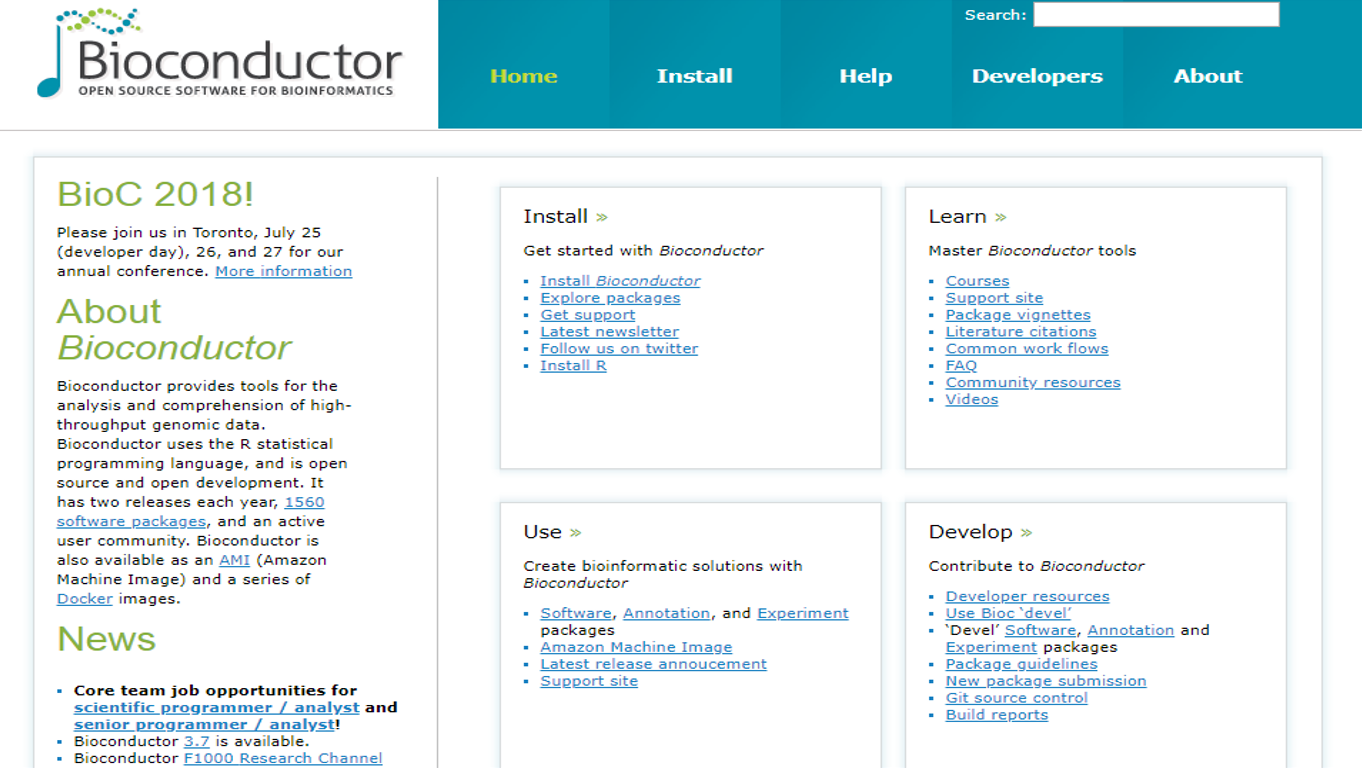
Em síntese, o Bioconductor atua na análise estatística e na compreensão de dados genômicos de alto rendimento. O foco em análise estatística vem da natureza dos dados: métodos modernos geram volumes massivos de dados que exigem sumarização estatística. Como pesquisadores, precisamos conduzir experimentos focados e planejados dentro de um arcabouço estatístico. A tecnologia que gera os dados genéticos modernos e os protocolos de laboratório produzem artefatos tecnológicos que precisam ser tratados com técnicas estatísticas. Por fim, desafios de integração de dados compactos nos fazem considerar cuidadosamente as consequências estatísticas de cada etapa envolvida.
O software do Bioconductor é composto por pacotes adicionais de R. Um pacote R é uma coleção estruturada de código (R, C ou outros), documentação e/ou dados para realizar tipos específicos de análise, por exemplo, pacotes affy, cluster, graph. Ele implementa métodos estatísticos e gráficos específicos.
Na versão mais recente do Bioconductor, há mais de 1500 pacotes disponíveis. Eles podem ser classificados em quatro tipos:
• Pacotes de software de análise: ferramentas para analisar dados genômicos de alto rendimento, por exemplo, IMMAN, limma
• Pacotes de anotação: bases estáticas de mapeamentos de identificadores, modelos gênicos, vias, etc.; por exemplo, TxDb.Hsapiens.UCSC.hg19.knownGene
• Pacotes de dados de experimentos ilustrativos: conjuntos de dados usados para demonstrar funcionalidades de software, por exemplo, airway
• Pacotes de workflow: documentos que descrevem um fluxo de trabalho em bioinformática envolvendo vários pacotes do Bioconductor para explicar áreas específicas da biologia, como Proteômica; por exemplo, highthroughputassays
GenomicRanges: “ranges” para descrever dados e anotações; GRanges(), GRangesList()
Biostrings: sequências de DNA e outras, DNAStringSet()
GenomicAlignments: leituras alinhadas; GAlignemts() e relacionados
GenomicFeatures, AnnotationDbi: recursos de anotação, pacotes TxDb e org.
SummarizedExperiment: coordenação de dados experimentais
rtracklayer: importação de anotações do genoma, como BED, WIG, GTF etc.
Para usar o Bioconductor pela primeira vez, é preciso ter a versão mais recente do R e então instalar a versão mais atual do Bioconductor, iniciando o R e digitando os comandos a seguir:
## try http:// if https:// URLs are not supported
source("https://bioconductor.org/biocLite.R")
biocLite()
Com esses comandos, todos os pacotes centrais da última versão do Bioconductor serão instalados. Para instalar pacotes específicos como IMMAN e GenomicRanges, que estão no repositório do Bioconductor, siga as instruções na página do pacote, como no exemplo:
source("https://bioconductor.org/biocLite.R")
biocLite(c( "Biostrings", "GenomicRanges", "IMMAN"))
A função biocLite() do pacote BiocInstaller é usada para instalar pacotes, em vez da função comum install.packages() do R. O motivo é que o Bioconductor tem um repositório separado do CRAN e um calendário de releases diferente do R. Isso pode causar desencontro entre as versões do R e do Bioconductor. Assim, a versão identificada por install.packages() nem sempre é a mais recente “release” disponível.
Após a instalação inicial, esta parte traz exemplos simples do ambiente do Bioconductor para você se familiarizar com o contexto. Aqui, dois exemplos reúnem componentes diversos do projeto, como sequenciamento de alto rendimento, análise estatística e compreensão.
Para começar, para conhecer dados de alto rendimento, você vai trabalhar com sequências de DNA. Para isso, use o Biostring, um pacote essencial para manipular grandes sequências biológicas. Nele, a função DNAStringSet() armazena um conjunto de DNAString (uma string baseada no alfabeto de DNA segundo o Alfabeto Genético Estendido IUPAC). Ela converte a entrada em um objeto XStringSet do tipo base de DNA. As letras são codificadas para otimizar algoritmos de busca.
library(Biostrings)

## Loading required package: BiocGenerics

## Loading required package: parallel

##
## Attaching package: 'BiocGenerics'

## The following objects are masked from 'package:parallel':
##
##     clusterApply, clusterApplyLB, clusterCall, clusterEvalQ,
##     clusterExport, clusterMap, parApply, parCapply, parLapply,
##     parLapplyLB, parRapply, parSapply, parSapplyLB

## The following objects are masked from 'package:stats':
##
##     IQR, mad, sd, var, xtabs

## The following objects are masked from 'package:base':
##
##     anyDuplicated, append, as.data.frame, basename, cbind,
##     colMeans, colnames, colSums, dirname, do.call, duplicated,
##     eval, evalq, Filter, Find, get, grep, grepl, intersect,
##     is.unsorted, lapply, lengths, Map, mapply, match, mget, order,
##     paste, pmax, pmax.int, pmin, pmin.int, Position, rank, rbind,
##     Reduce, rowMeans, rownames, rowSums, sapply, setdiff, sort,
##     table, tapply, union, unique, unsplit, which, which.max,
##     which.min

## Loading required package: S4Vectors

## Loading required package: stats4

##
## Attaching package: 'S4Vectors'

## The following object is masked from 'package:base':
##
##     expand.grid

## Loading required package: IRanges

##
## Attaching package: 'IRanges'

## The following object is masked from 'package:grDevices':
##
##     windows

## Loading required package: XVector

##
## Attaching package: 'Biostrings'

## The following object is masked from 'package:base':
##
##     strsplit

dnaSequence <- DNAStringSet( c("AAACTG", "CCCAACCA") )
dnaSequence

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 AAACTG
## [2]     8 CCCAACCA
Em seguida, podemos usar a função complement() para obter o complemento das sequências de DNA.
complement(dnaSequence)

##   A DNAStringSet instance of length 2
##     width seq
## [1]     6 TTTGAC
## [2]     8 GGGTTGGT
Aprender a trabalhar com pacotes como DNAStringSet e Biostrings abre caminho para usar outros pacotes.
Em outro exemplo, vamos usar o pacote GenomicRanges, voltado a representar localizações genômicas dentro do projeto Bioconductor. Ele fornece a base para análises genômicas por meio de três classes (GRanges, GPos e GRangesList), usadas para representar intervalos genômicos, posições genômicas e grupos de intervalos.
A classe GRanges representa um conjunto de intervalos genômicos, cada um com início e fim no genoma. Ela armazena a localização de recursos genômicos como sítios de ligação contíguos, transcritos e exons. Podemos criar esses objetos com o construtor GRanges como abaixo:
library(GenomicRanges)

## Loading required package: GenomeInfoDb

grangeObj <-
  GRanges(seqnames =
            Rle(c("chr1", "chr2", "chr1", "chr3"), c(1, 3, 2, 4)),
          ranges =
            IRanges(1:10, end = 7:16, names = head(letters, 10)),
          strand =
            Rle(strand(c("-", "+", "*", "+", "-")),
                c(1, 2, 2, 3, 2)),
          score = 1:10,
          GC = seq(1, 0, length=10))

grangeObj

## GRanges object with 10 ranges and 2 metadata columns:
##     seqnames    ranges strand |     score                GC
##        <Rle> <IRanges>  <Rle> | <integer>         <numeric>
##   a     chr1       1-7      - |         1                 1
##   b     chr2       2-8      + |         2 0.888888888888889
##   c     chr2       3-9      + |         3 0.777777777777778
##   d     chr2      4-10      * |         4 0.666666666666667
##   e     chr1      5-11      * |         5 0.555555555555556
##   f     chr1      6-12      + |         6 0.444444444444444
##   g     chr3      7-13      + |         7 0.333333333333333
##   h     chr3      8-14      + |         8 0.222222222222222
##   i     chr3      9-15      - |         9 0.111111111111111
##   j     chr3     10-16      - |        10                 0
##   -------
##   seqinfo: 3 sequences from an unspecified genome; no seqlengths
O resultado é um objeto GRanges com 10 intervalos genômicos. Como mostrado, a impressão divide as informações em regiões à esquerda e à direita, separadas por |. As coordenadas do genoma (seqnames, ranges e strand) ficam à esquerda, e as colunas de metadados (anotação) à direita. Neste exemplo, os metadados incluem score e GC. Porém, quase qualquer informação pode ser armazenada na parte de metadados de um objeto GRanges.
As funções auxiliares seqnames(), ranges() e strand() são usadas para acessar os componentes das coordenadas genômicas em um objeto GRanges. Por exemplo:
seqnames(grangeObj)

## factor-Rle of length 10 with 4 runs
##   Lengths:    1    3    2    4
##   Values : chr1 chr2 chr1 chr3
## Levels(3): chr1 chr2 chr3

ranges(grangeObj)

## IRanges object with 10 ranges and 0 metadata columns:
##         start       end     width
##     <integer> <integer> <integer>
##   a         1         7         7
##   b         2         8         7
##   c         3         9         7
##   d         4        10         7
##   e         5        11         7
##   f         6        12         7
##   g         7        13         7
##   h         8        14         7
##   i         9        15         7
##   j        10        16         7

strand(grangeObj)

## factor-Rle of length 10 with 5 runs
##   Lengths: 1 2 2 3 2
##   Values : - + * + -
## Levels(3): + - *
No último exemplo, mostramos uma aplicação simples da parte de análise estatística do projeto. Para isso, discutimos a classificação Gene Ontology (GO). A GO é um conjunto de conceitos (função molecular, componente celular e processo biológico) usados para descrever a função de genes e as relações entre esses conceitos. Especificamente, a GO classifica genes e produtos gênicos hierarquicamente em um grafo chamado ontologia. Para um exemplo prático, podemos usar três pacotes do Bioconductor: clusterProfiler, DOSE e org.Hs.eg.db.
library("clusterProfiler")

##

## clusterProfiler v3.8.1  For help: https://guangchuangyu.github.io/software/clusterProfiler
##
## If you use clusterProfiler in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Yanyan Han, Qing-Yu He. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS: A Journal of Integrative Biology. 2012, 16(5):284-287.

library("DOSE")

## DOSE v3.6.1  For help: https://guangchuangyu.github.io/DOSE
##
## If you use DOSE in published research, please cite:
## Guangchuang Yu, Li-Gen Wang, Guang-Rong Yan, Qing-Yu He. DOSE: an R/Bioconductor package for Disease Ontology Semantic and Enrichment analysis. Bioinformatics 2015, 31(4):608-609

library("org.Hs.eg.db")

## Loading required package: AnnotationDbi

## Loading required package: Biobase

## Welcome to Bioconductor
##
##     Vignettes contain introductory material; view with
##     'browseVignettes()'. To cite Bioconductor, see
##     'citation("Biobase")', and for packages 'citation("pkgname")'.

##
O pacote clusterProfiler reúne métodos para analisar e visualizar perfis funcionais, como GO, de genes e clusters de genes. Com ele, você consegue agrupar genes diferentes conforme suas semelhanças. Para exemplificar, o conjunto de dados geneList, usado no pacote DOSE, é uma boa escolha. Ele contém o conteúdo de informação de IDs de genes. Já o pacote org.Hs.eg.db inclui anotações de todo o genoma humano, representações de sequências enriquecidas com informações sobre posição genômica.
data(geneList, package="DOSE")

gene <- names(geneList)[abs(geneList) > 2]
A função enrichGO() realiza a análise de enriquecimento GO para um vetor de genes. A análise de enriquecimento distingue grupos de genes atribuídos a categorias predefinidas com base em suas funções. O resultado enriquecido pode conter termos bem gerais. Para usar essa função, é preciso preencher o argumento “OrgDb”. Para isso, usamos o pacote org.Hs.eg.db, que traz anotações de todo o genoma humano. Esse pacote contém representações de sequência enriquecidas com informações de posição genômica.
ego <- enrichGO(gene          = gene,
                universe      = names(geneList),
                OrgDb         = org.Hs.eg.db,
                ont           = "CC",
                pAdjustMethod = "BH",
                pvalueCutoff  = 0.01,
                qvalueCutoff  = 0.05,
        readable      = TRUE)
head(ego)

##                    ID                              Description GeneRatio
## GO:0005819 GO:0005819                                  spindle    25/201
## GO:0000779 GO:0000779 condensed chromosome, centromeric region    15/201
## GO:0072686 GO:0072686                          mitotic spindle    14/201
## GO:0000775 GO:0000775           chromosome, centromeric region    18/201
## GO:0000776 GO:0000776                              kinetochore    15/201
## GO:0000793 GO:0000793                     condensed chromosome    18/201
##              BgRatio       pvalue     p.adjust       qvalue
## GO:0005819 256/11817 1.353146e-12 3.897060e-10 3.546666e-10
## GO:0000779  91/11817 3.013479e-11 3.393318e-09 3.088217e-09
## GO:0072686  77/11817 3.534706e-11 3.393318e-09 3.088217e-09
## GO:0000775 156/11817 1.429309e-10 1.029103e-08 9.365738e-09
## GO:0000776 106/11817 2.849245e-10 1.406873e-08 1.280378e-08
## GO:0000793 163/11817 2.970249e-10 1.406873e-08 1.280378e-08
##                                                                                                                                                         geneID
## GO:0005819 CDCA8/CDC20/KIF23/CENPE/ASPM/DLGAP5/SKA1/NUSAP1/TPX2/TACC3/NEK2/CDK1/MAD2L1/KIF18A/BIRC5/KIF11/TTK/AURKB/PRC1/KIFC1/KIF18B/KIF20A/AURKA/CCNB1/KIF4A
## GO:0000779                                                            CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/AURKA/CCNB1
## GO:0072686                                                                KIF23/CENPE/ASPM/NUSAP1/TPX2/TACC3/CDK1/MAD2L1/KIF18A/KIF11/AURKB/KIFC1/KIF18B/AURKA
## GO:0000775                                           CDCA8/CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/NCAPG/AURKB/AURKA/CCNB1
## GO:0000776                                                             CENPE/NDC80/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/KIF18A/CDT1/BIRC5/TTK/AURKB/CCNB1
## GO:0000793                                          CENPE/NDC80/TOP2A/NCAPH/HJURP/SKA1/NEK2/CENPM/CENPN/ERCC6L/MAD2L1/CDT1/BIRC5/NCAPG/AURKB/CHEK1/AURKA/CCNB1
##            Count
## GO:0005819    25
## GO:0000779    15
## GO:0072686    14
## GO:0000775    18
## GO:0000776    15
## GO:0000793    18
Para visualizar o mapa de enriquecimento, use a função emapplot(). Ela representa conjuntos de genes como uma rede. De forma simples, conjuntos de genes com sobreposição mútua formam clusters.
emapplot(ego)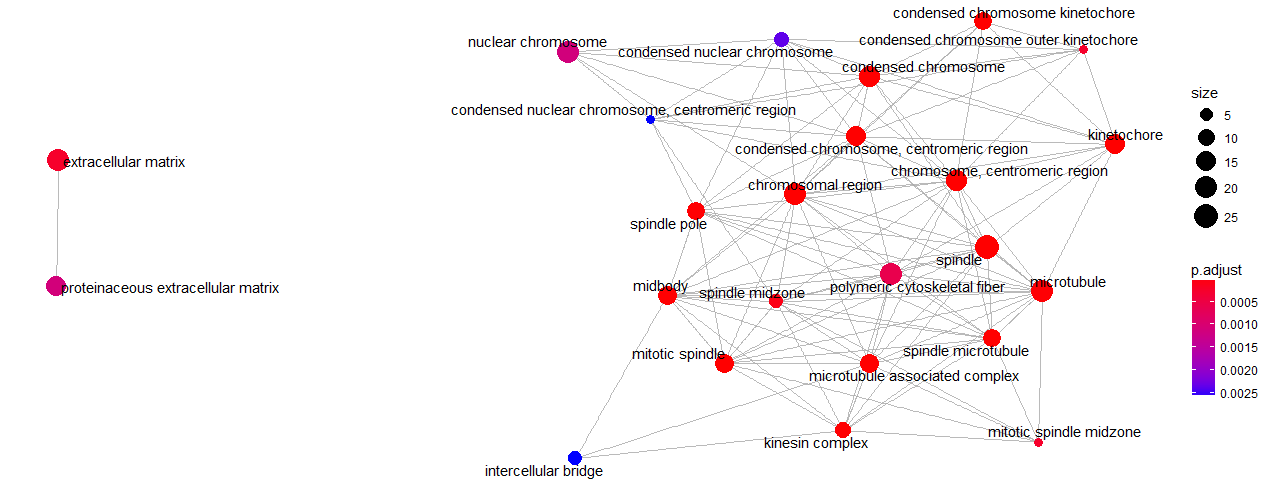
Ao usar os pacotes do Bioconductor, se precisar de ajuda, experimente os comandos abaixo:
class(dnaSequence) # Indica a classe do objeto de entrada

## [1] "DNAStringSet"
## attr(,"package")
## [1] "Biostrings"

methods(class = "DNAStringSet") # Lista todos os métodos disponíveis para uma função ou classe genérica S3/S4

##   [1] !                               !=
##   [3] $                               $<-
##   [5] %in%                            [
##   [7] [[                              [[<-
##   [9] [<-                             <
##  [11] <=                              ==
##  [13] >                               >=
##  [15] aggregate                       alphabetFrequency
##  [17] anyNA                           append
##  [19] as.character                    as.complex
##  [21] as.data.frame                   as.env
##  [23] as.factor                       as.integer
##  [25] as.list                         as.logical
##  [27] as.matrix                       as.numeric
##  [29] as.raw                          as.vector
##  [31] by                              c
##  [33] cbind                           chartr
##  [35] coerce                          compact
##  [37] compareStrings                  complement
##  [39] concatenateObjects              consensusMatrix
##  [41] consensusString                 countOverlaps
##  [43] countPattern                    countPDict
##  [45] dinucleotideFrequencyTest       do.call
##  [47] droplevels                      duplicated
##  [49] elementMetadata                 elementMetadata<-
##  [51] elementNROWS                    elementType
##  [53] eval                            expand
##  [55] expand.grid                     extractAt
##  [57] extractROWS                     Filter
##  [59] findOverlaps                    getListElement
##  [61] hasOnlyBaseLetters              head
##  [63] ifelse2                         intersect
##  [65] is.na                           is.unsorted
##  [67] isEmpty                         isMatchingEndingAt
##  [69] isMatchingStartingAt            lapply
##  [71] length                          lengths
##  [73] letterFrequency                 match
##  [75] matchPattern                    matchPDict
##  [77] mcols                           mcols<-
##  [79] merge                           metadata
##  [81] metadata<-                      mstack
##  [83] names                           names<-
##  [85] nchar                           neditEndingAt
##  [87] neditStartingAt                 NROW
##  [89] nucleotideFrequencyAt           oligonucleotideFrequency
##  [91] order                           overlapsAny
##  [93] PairwiseAlignments              PairwiseAlignmentsSingleSubject
##  [95] parallelSlotNames               parallelVectorNames
##  [97] pcompare                        pcompareRecursively
##  [99] PDict                           PWM
## [101] rank                            rbind
## [103] Reduce                          relist
## [105] relistToClass                   rename
## [107] rep                             rep.int
## [109] replaceAt                       replaceLetterAt
## [111] replaceROWS                     rev
## [113] revElements                     reverse
## [115] reverseComplement               ROWNAMES
## [117] sapply                          seqinfo
## [119] seqinfo<-                       seqlevelsInUse
## [121] seqtype                         seqtype<-
## [123] setdiff                         setequal
## [125] setListElement                  shiftApply
## [127] show                            showAsCell
## [129] sort                            split
## [131] split<-                         stack
## [133] stringDist                      strsplit
## [135] subseq                          subseq<-
## [137] subset                          subsetByOverlaps
## [139] table                           tail
## [141] tapply                          threebands
## [143] toString                        transform
## [145] translate                       trimLRPatterns
## [147] twoWayAlphabetFrequency         union
## [149] unique                          uniqueLetters
## [151] unlist                          unsplit
## [153] unstrsplit                      updateObject
## [155] values                          values<-
## [157] vcountPattern                   vcountPDict
## [159] vmatchPattern                   vwhichPDict
## [161] which.isMatchingEndingAt        which.isMatchingStartingAt
## [163] whichPDict                      width
## [165] window                          window<-
## [167] windows                         with
## [169] within                          xtabs
## [171] xvcopy                          zipdown
## see '?methods' for accessing help and source code

?complement # Mostra a página de ajuda da função

## starting httpd help server ... done

browseVignettes(package="Biostrings") # Lista todas as vinhetas disponíveis do pacote informado
Além disso, há muitas páginas de ajuda e workflows úteis nos sites do Bioconductor:
Ao ler este tutorial, você conheceu o projeto Bioconductor e seu papel fundamental em pesquisas biológicas. Também vimos os tipos de pacotes do Bioconductor e alguns dos mais importantes. Em seguida, explicamos rapidamente como instalar e usar o projeto. Você aprendeu a trabalhar com os pacotes Biostring e GenomicRanges e, com isso, se familiarizou com sequências de DNA e intervalos no genoma. Em outro exemplo, você aplicou análise de enriquecimento em um conjunto de genes humanos e conheceu os conceitos de análise de enriquecimento e GO. Por fim, indicamos diferentes formas de obter ajuda ao trabalhar com o Bioconductor. Se quiser saber mais, veja Bioconductor_courses.
Se você quer aprender mais sobre R, faça o curso Experimental Design in R da DataCamp.
Cursos de R
Curso
Curso
Curso
blog
Summer Worsley
15 min
Tutorial
DataCamp Team
15 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Ryan Sheehy
3 min
Tutorial
Kevin Babitz
15 min
Tutorial
Karlijn Willems
15 min