Curso
Introdução ao R
4 h
3.1M

Técnicas de mineração de dados ou aprendizado de máquina costumam ser usadas nas fases iniciais da pesquisa biomédica para analisar grandes volumes de dados, por exemplo, para ajudar a identificar genes candidatos ou biomarcadores preditivos de doença em conjuntos de dados de sequenciamento de alto rendimento. Porém, dados de ensaios clínicos geralmente incluem "dados de sobrevivência", que exigem uma abordagem bem diferente de análise.
Nesse tipo de análise, o interesse é o tempo até um evento específico, como morte ou recorrência da doença, e dois (ou mais) grupos de pacientes são comparados em relação a esse tempo. Três conceitos centrais ajudam a extrair resultados relevantes desse tipo de conjunto de dados, e o objetivo deste tutorial é apresentar os conceitos estatísticos, sua interpretação e um exemplo prático de aplicação desses métodos, junto com sua implementação em R:
Neste tutorial, você também vai usar os pacotes survival e survminer no R e o conjunto de dados ovarian (Edmunson J.H. et al., 1979), que vem com o pacote survival. Você vai ler mais sobre esse dataset ao longo do tutorial!
Dica: confira este cheat sheet do survminer
Depois deste tutorial, você estará pronto para responder perguntas como: pacientes se beneficiam do esquema terapêutico A em comparação ao B? Idade e condição clínica dos pacientes influenciam significativamente o desfecho? Doença residual é um biomarcador prognóstico em termos de sobrevivência?
Antes de entrar nos detalhes estatísticos, vale conhecer alguns termos úteis:
O termo "censura" (censoring) se refere a dados incompletos. Embora existam diferentes tipos, vale focar aqui na censura à direita, que é a mais comum em bases de sobrevivência.
Para alguns pacientes, você pode saber que houve acompanhamento por certo tempo sem ocorrência do "evento", mas não sabe se o paciente, no fim, sobreviveu ou não. Isso pode acontecer se o paciente se perdeu no seguimento (loss to follow-up) ou desistiu do estudo. Os dados desse paciente serão "censurados" após o último momento em que você tem certeza de que o evento de interesse não ocorreu. O evento é o desfecho pré-especificado do estudo, por exemplo, morte ou recorrência. Além disso, todos os pacientes que não apresentarem o evento até o término do estudo serão censurados nesse último ponto no tempo.
Basicamente, estes são os três motivos para dados censurados.
Assim, o número de observações censuradas é sempre n >= 0. Todos esses exemplos são casos de censura à direita e ainda podem ser classificados em censura tipo I (fixa ou aleatória) e tipo II, mas essas classificações interessam mais ao desenho do estudo e não serão o foco deste material introdutório.
Algo importante: todo tipo de censura é um caso de não informação e nunca é causado pelo "evento" que define o desfecho do estudo. Isso também implica que nenhum dos pacientes censurados no conjunto ovarian foi censurado porque morreu.
Como é a cara de uma função de sobrevivência que descreve a sobrevivência dos pacientes ao longo do tempo?
O estimador de Kaplan-Meier, descrito independentemente por Edward Kaplan e Paul Meier e publicado em 1958 no Journal of the American Statistical Association, é uma estatística não paramétrica que permite estimar a função de sobrevivência.
Lembre-se de que uma estatística não paramétrica não assume uma distribuição de probabilidade subjacente, o que faz sentido aqui, já que dados de sobrevivência costumam ter distribuição assimétrica.
Essa estatística fornece a probabilidade de um paciente sobreviver além de um tempo t específico. Em t = 0, o estimador de Kaplan-Meier é 1 e, conforme t tende ao infinito, o estimador tende a 0. Em teoria, com um conjunto de dados infinitamente grande e t medido ao segundo, a função correspondente de t versus probabilidade de sobrevivência seria suave. Mais adiante, você verá como isso aparece na prática.
Ele parte da suposição de que a probabilidade de sobreviver além de um ponto t é igual ao produto das taxas de sobrevivência observadas até t. Mais precisamente, S(t) #probabilidade de sobrevivência no tempo t é dada por S(t) = p.1 * p.2 * … * p.t, em que p.1 é a proporção de todos os pacientes que sobrevivem além do primeiro ponto no tempo, p.2 a proporção que sobrevive além do segundo, e assim por diante até t.
É importante notar que, a partir de p.2 até p.t, você considera apenas os pacientes que sobreviveram além do ponto anterior ao calcular cada nova proporção; portanto, p.2, p.3, …, p.t são proporções condicionadas às anteriores.
Na prática, primeiro ordene os tempos de sobrevivência em ordem crescente, incluindo os valores censurados. Em seguida, calcule as proporções como descrito e multiplique para obter S(t). Pacientes censurados são omitidos após o momento da censura, então não influenciam a proporção de sobreviventes a partir dali. Para detalhes, veja (Swinscow e Campbell, 2002).
Por fim, você pode usar o teste log-rank para comparar curvas de sobrevivência de dois grupos. O log-rank é um teste de hipótese que avalia a hipótese nula de que as curvas de sobrevivência de duas populações não diferem. Uma distribuição qui-quadrado é usada para derivar o p-valor. Em resumo, p-valores quantificam a significância estatística; resultados com p < 0.05 são geralmente considerados significativos. No nosso caso, p < 0.05 indicaria que os dois tratamentos diferem significativamente em termos de sobrevivência.
Outra função útil nesse contexto é a função de risco (hazard) h(t). Ela descreve a probabilidade instantânea de ocorrência do evento, ou o risco h (neste caso, morte), dado que o indivíduo sobreviveu até o tempo t. É um pouco mais difícil de visualizar do que o estimador de Kaplan-Meier porque mede o risco instantâneo de morte. Ainda assim, você precisa da função de risco para considerar covariáveis ao comparar a sobrevivência entre grupos. Covariáveis, também chamadas de variáveis explicativas ou independentes em regressão, são variáveis potencialmente preditivas do desfecho ou que você quer ajustar para capturar interações.
Enquanto o teste log-rank compara duas curvas de Kaplan-Meier, possivelmente obtidas ao dividir a população em subgrupos de tratamento, os modelos de riscos proporcionais de Cox são derivados das funções de risco basais das populações em questão e de um número arbitrário de covariáveis dicotomizadas. Novamente, não se assume uma distribuição subjacente, mas se assume que os riscos relativos entre os grupos comparados se mantêm constantes ao longo do tempo — daí o nome "modelo de riscos proporcionais". Mais adiante, veremos um exemplo que ilustra isso.
Agora, vamos analisar o conjunto ovarian!
Com esses conceitos em mãos, vamos analisar um conjunto de dados real e tentar responder algumas das perguntas acima. Comece carregando os dois pacotes necessários para as análises e o pacote dplyr, que traz funções úteis para manipular data frames.
# Load required packages
library(survival)
library(survminer)
library(dplyr)Dica: não se esqueça de usar install.packages() para instalar os pacotes que ainda não estiverem no seu ambiente!
O próximo passo é carregar o conjunto de dados e examinar sua estrutura. Como vimos no início do tutorial, vamos trabalhar com o conjunto ovarian. Ele reúne uma coorte de pacientes com câncer de ovário e informações clínicas, incluindo o tempo de acompanhamento até morte ou perda de seguimento (futime), se o paciente foi censurado ou não (fustat), idade, grupo de tratamento, presença de doença residual e performance status.
Como dá para notar, alguns nomes de variáveis são um pouco crípticos; vale consultar a página de ajuda.
# Import the ovarian cancer dataset and have a look at it
data(ovarian)
glimpse(ovarian)
## Observations: 26
## Variables: 6
## $ futime   <dbl> 59, 115, 156, 421, 431, 448, 464, 475, 477, 563, 638,...
## $ fustat   <dbl> 1, 1, 1, 0, 1, 0, 1, 1, 0, 1, 1, 0, 0, 0, 0, 0, 0, 0,...
## $ age      <dbl> 72.3315, 74.4932, 66.4658, 53.3644, 50.3397, 56.4301,...
## $ resid.ds <dbl> 2, 2, 2, 2, 2, 1, 2, 2, 2, 1, 1, 1, 2, 2, 1, 1, 2, 1,...
## $ rx       <dbl> 1, 1, 1, 2, 1, 1, 2, 2, 1, 2, 1, 2, 2, 2, 1, 1, 1, 1,...
## $ ecog.ps  <dbl> 1, 1, 2, 1, 1, 2, 2, 2, 1, 2, 2, 1, 2, 1, 1, 2, 2, 1,...
help(ovarian)
A coluna futime contém os tempos de sobrevivência — é a variável resposta. Já fustat informa se o tempo de sobrevivência do paciente foi censurado. Ao que tudo indica, os 26 pacientes deste estudo receberam um de dois esquemas terapêuticos (rx) e o médico avaliou a regressão tumoral (resid.ds) e a performance dos pacientes (segundo os critérios padronizados ECOG; ecog.ps) em algum momento.
Além disso, você tem a idade dos pacientes e, se quiser incluí-la como variável preditora, precisará dicotomizar um contínuo em valores binários. Mas qual ponto de corte escolher? Vamos olhar a distribuição geral das idades:
# Dichotomize age and change data labels
ovarian$rx <- factor(ovarian$rx,
                     levels = c("1", "2"),
                     labels = c("A", "B"))
ovarian$resid.ds <- factor(ovarian$resid.ds,
                           levels = c("1", "2"),
                           labels = c("no", "yes"))
ovarian$ecog.ps <- factor(ovarian$ecog.ps,
                          levels = c("1", "2"),
                          labels = c("good", "bad"))

# Data seems to be bimodal
hist(ovarian$age) 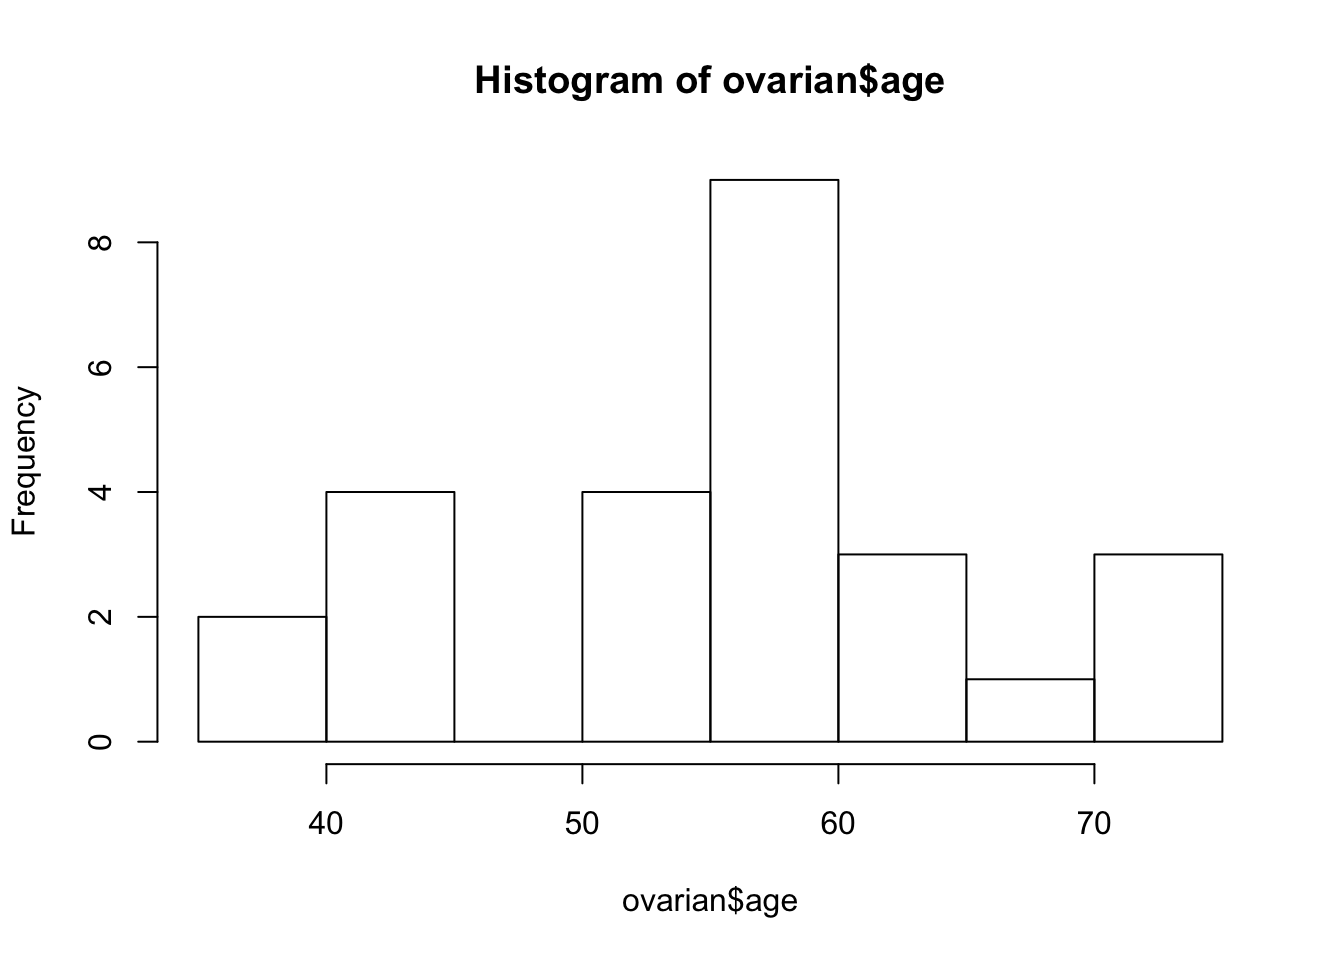
ovarian <- ovarian %>% mutate(age_group = ifelse(age >=50, "old", "young"))
ovarian$age_group <- factor(ovarian$age_group)
A distribuição claramente bimodal sugere um corte em 50 anos. Você pode usar mutate para adicionar uma coluna age_group ao data frame, que será útil mais adiante. Também é recomendável converter as futuras covariáveis em fatores.
Agora, vamos criar um objeto de sobrevivência. Basicamente, é uma versão compilada das colunas futime e fustat que pode ser interpretada pela função survfit. Um + atrás dos tempos de sobrevivência indica dados censurados.
# Fit survival data using the Kaplan-Meier method
surv_object <- Surv(time = ovarian$futime, event = ovarian$fustat)
surv_object
##  [1]   59   115   156   421+  431   448+  464   475   477+  563   638
## [12]  744+  769+  770+  803+  855+ 1040+ 1106+ 1129+ 1206+ 1227+  268
## [23]  329   353   365   377+
O próximo passo é ajustar as curvas de Kaplan-Meier. Você faz isso passando o surv_object para a função survfit. Também dá para estratificar a curva pelo esquema de tratamento rx ao qual os pacientes foram atribuídos. Um summary() do objeto fit1 resultante mostra, entre outras coisas, os tempos de sobrevivência, a proporção de sobreviventes em cada ponto no tempo — seus p.1, p.2, ... de antes — e os grupos de tratamento.
fit1 <- survfit(surv_object ~ rx, data = ovarian)
summary(fit1)
## Call: survfit(formula = surv_object ~ rx, data = ovarian)
##
##                 rx=A
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##    59     13       1    0.923  0.0739        0.789        1.000
##   115     12       1    0.846  0.1001        0.671        1.000
##   156     11       1    0.769  0.1169        0.571        1.000
##   268     10       1    0.692  0.1280        0.482        0.995
##   329      9       1    0.615  0.1349        0.400        0.946
##   431      8       1    0.538  0.1383        0.326        0.891
##   638      5       1    0.431  0.1467        0.221        0.840
##
##                 rx=B
##  time n.risk n.event survival std.err lower 95% CI upper 95% CI
##   353     13       1    0.923  0.0739        0.789        1.000
##   365     12       1    0.846  0.1001        0.671        1.000
##   464      9       1    0.752  0.1256        0.542        1.000
##   475      8       1    0.658  0.1407        0.433        1.000
##   563      7       1    0.564  0.1488        0.336        0.946
Você pode visualizar a curva correspondente passando o objeto de sobrevivência para ggsurvplot. O argumento pval = TRUE é muito útil, pois já plota o p-valor do teste log-rank!
ggsurvplot(fit1, data = ovarian, pval = TRUE)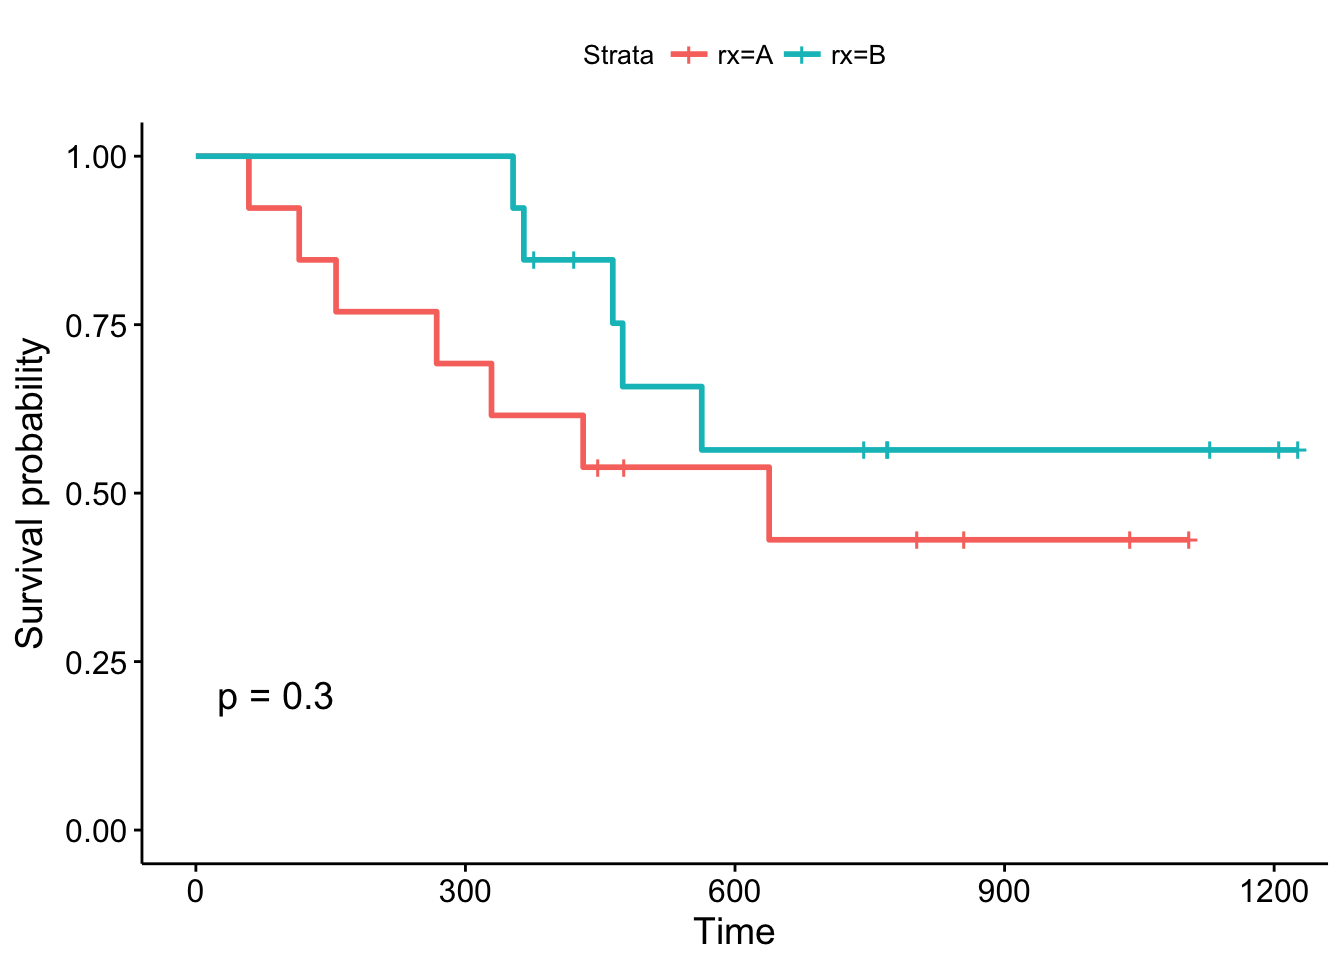
Por convenção, linhas verticais indicam dados censurados e seus valores em x marcam o momento da censura.
O p-valor de log-rank de 0,3 indica resultado não significativo, tomando p < 0.05 como corte de significância. Neste estudo, nenhum dos tratamentos foi significativamente superior, embora pacientes no tratamento B pareçam melhores no primeiro mês de seguimento. E as outras variáveis?
# Examine prdictive value of residual disease status
fit2 <- survfit(surv_object ~ resid.ds, data = ovarian)
ggsurvplot(fit2, data = ovarian, pval = TRUE)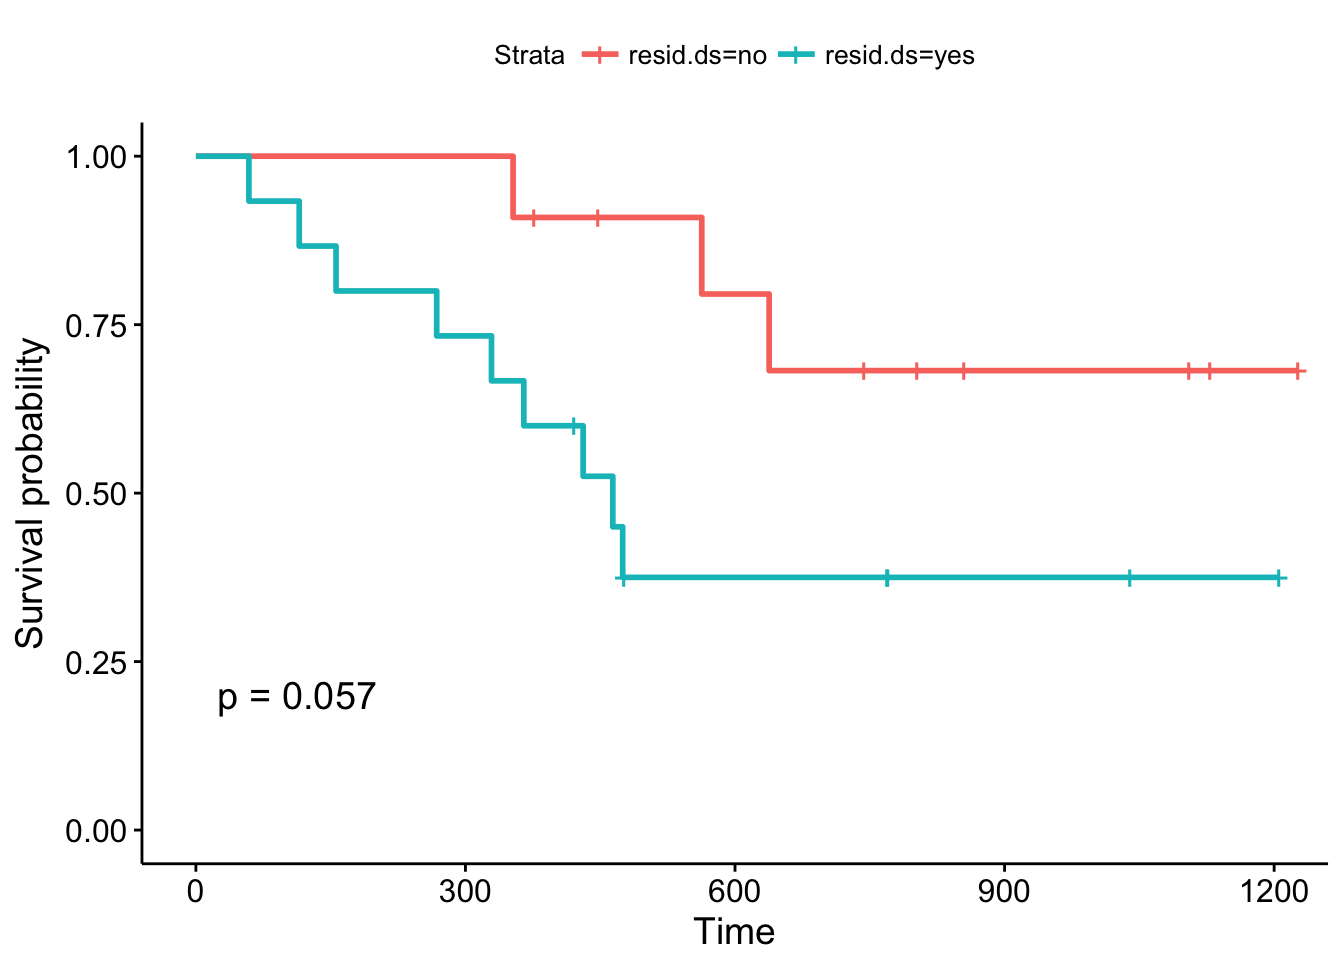
As curvas de Kaplan-Meier estratificadas por status de doença residual parecem diferentes: as curvas se separam cedo e o teste log-rank fica quase significativo. Dá para argumentar que um estudo de seguimento com amostra maior poderia validar esses achados — isto é, que pacientes com doença residual positiva têm prognóstico significativamente pior do que aqueles sem doença residual.
Mas existe uma forma mais sistemática de avaliar várias covariáveis? Como vimos, os modelos de riscos proporcionais de Cox permitem incluir covariáveis. Você pode ajustá-los com coxph e visualizá-los com ggforest. Esse tipo de gráfico é chamado de forest plot. Ele mostra as razões de risco (HR) derivadas do modelo para todas as covariáveis incluídas na fórmula de coxph. Em linhas gerais, HR > 1 indica aumento do risco de morte (segundo h(t)) quando uma condição específica é satisfeita; HR < 1 indica redução de risco. Vamos ver a saída do modelo:
# Fit a Cox proportional hazards model
fit.coxph <- coxph(surv_object ~ rx + resid.ds + age_group + ecog.ps,
                   data = ovarian)
ggforest(fit.coxph, data = ovarian)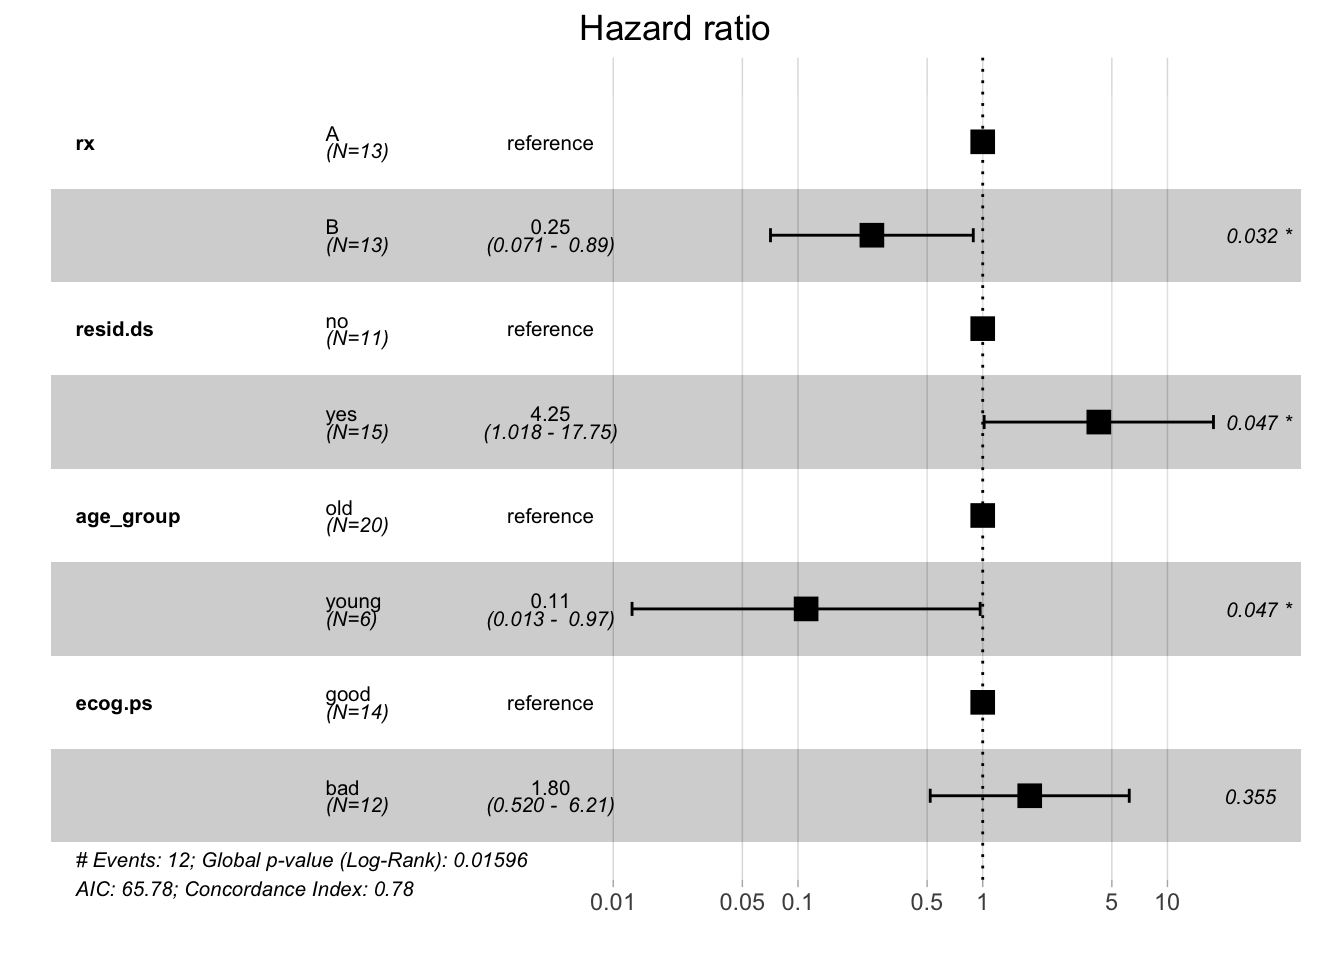
Cada HR representa o risco relativo de morte que compara uma categoria binária com a outra. Por exemplo, uma razão de risco de 0,25 para os grupos de tratamento indica que pacientes que receberam o tratamento B têm risco reduzido de morrer em comparação aos que receberam o tratamento A (categoria de referência). Como mostra o forest plot, o intervalo de confiança de 95% é 0,071 – 0,89 e o resultado é significativo.
Nesse modelo, as variáveis grupo de tratamento, status de doença residual e grupo de idade influenciam significativamente o risco de morte dos pacientes neste estudo. Isso é bem diferente do que vimos com o estimador de Kaplan-Meier e o teste log-rank. Enquanto o primeiro estima a probabilidade de sobrevivência, o segundo calcula o risco de morte e as razões de risco correspondentes. Sua análise mostra que a significância dos resultados pode divergir entre esses métodos.
Os exemplos acima mostram como é simples colocar em prática os conceitos estatísticos de análise de sobrevivência em R. Nesta introdução, você aprendeu a construir os modelos, visualizá-los e também viu a base estatística que ajuda a interpretar os resultados. Agora é sua vez de aplicar essas técnicas para analisar seus próprios dados. Obrigado por acompanhar!
Confira nosso tutorial de regressão linear em R.
Cursos de R
Curso
Curso
Curso
Tutorial
Eladio Montero Porras
15 min
Tutorial
Vidhi Chugh
14 min
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
10 min
Tutorial
DataCamp Team
15 min
Tutorial
Ryan Sheehy
3 min


