


OpenAI o3 Nedir?
o3, OpenAI’nin en yeni sınır modeli olup kodlama, matematik, bilim ve görsel algı gibi karmaşık görevlerde muhakeme yeteneklerini ilerletmek için tasarlanmıştır.
o3 muhakeme modeli, özerk araç kullanımına erişimi olan ilk muhakeme modelidir. Bu, o3’ün arama, Python, görsel üretim ve yorumlama gibi yetenekleri görevlerini başarmak için kullanabildiği anlamına gelir.
Bu, gerçek dünya problem çözmeyi sınayan gelişmiş kıyaslamalarda güçlü bir performansa dönüşmüştür; önceki modellerin zorlandığı alanlarda öne çıkar. OpenAI, o3’ün o1’e kıyasla kaydettiği ilerlemeyi vurgulayarak onu şimdiye kadarki en yetkin ve çok yönlü modelleri olarak konumlandırıyor.
O1 vs. O3
o3, o1’in attığı temelin üzerine doğrudan inşa edilmiştir; ancak kilit alanlarda kayda değer iyileştirmeler sunar. OpenAI, o3’ü daha karmaşık muhakeme görevlerini üstlenmek üzere tasarlanmış bir model olarak konumlandırıyor ve bu, kıyaslama sonuçlarına da yansıyor.
Kodlama
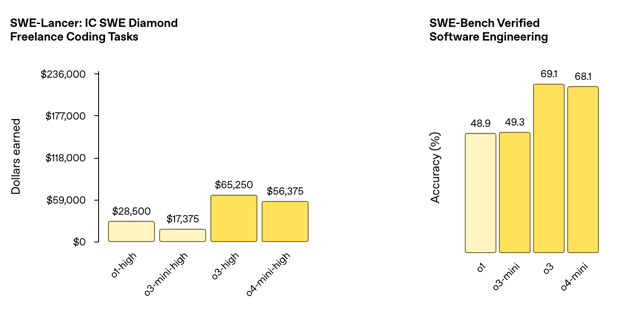
Yazılım mühendisliği görevlerinde test edildiğinde, o3 SWE-Bench Doğrulanmış Yazılım Mühendisliği kıyaslamasında %69,1 doğruluk elde etti; bu, o1’in %48,9’luk skoruna göre önemli bir iyileşme.
Kaynak: OpenAI
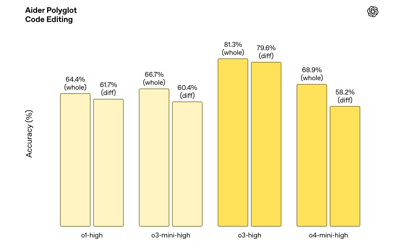
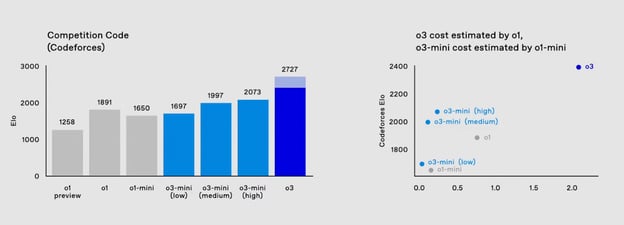
Benzer şekilde, rekabetçi programlamada o3, o1’in daha önceki 1891’lik zirvesini açık ara geride bırakarak 2706 ELO puanına ulaştı. Ayrıca, kod düzenleme kıyaslamalarında da o3 belirgin şekilde daha iyi performans gösteriyor; o3 varyantları, Aider Polyglot Code Editing kıyaslamasında her alanda o1’i geride bırakıyor.
Kaynak: OpenAI
Matematik ve bilim
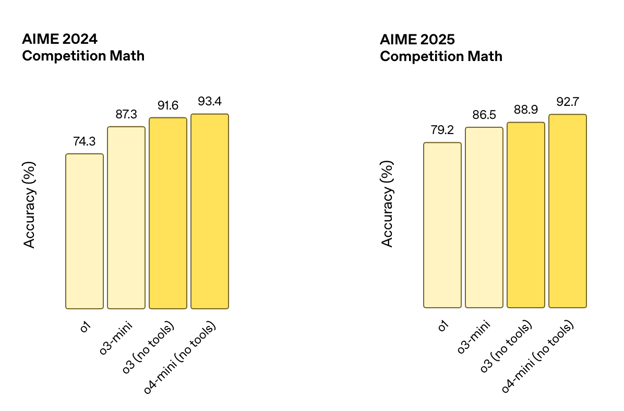
İyileştirmeler kodlamayla sınırlı değil. o3, matematiksel muhakemede de üstün; AIME 2024’te %91,6 doğruluk elde ederken o1 %74,3’te kaldı. Ayrıca AIME 2025’te %88,9 puan aldı. Bu kazanımlar, modelin daha ince ayarlı ve zor sorunları ele alabildiğini, geleneksel olarak insan uzmanların baskın olduğu kıyaslamalara yaklaştığını gösteriyor.
Kaynak: OpenAI
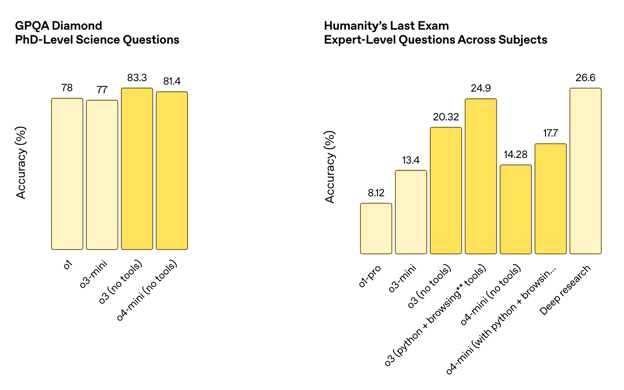
Bilimle ilgili kıyaslamalarda da benzer bir sıçrama görülüyor. Doktora seviyesindeki bilim sorularındaki performansı ölçen GPQA Diamond’da o3, o1’in %78’ine karşı %83,3 doğruluk elde etti. Bu kazanımlar, modelin disiplinler arasında teknik olarak zorlu problemleri çözme yeteneğinde geniş çaplı bir iyileşmeye işaret ediyor.
Kaynak: OpenAI
Görsel muhakeme
Yeni o3 modelinin en çarpıcı yönlerinden biri, düşünce zinciri içinde görüntülerle doğrudan muhakeme edebilmesidir. Bu, o3’ün problem çözerken görsel ve metinsel muhakemeyi harmanlayabildiği anlamına gelir ve bu durum, çeşitli görsel muhakeme kıyaslamalarındaki performansına yansımaktadır.
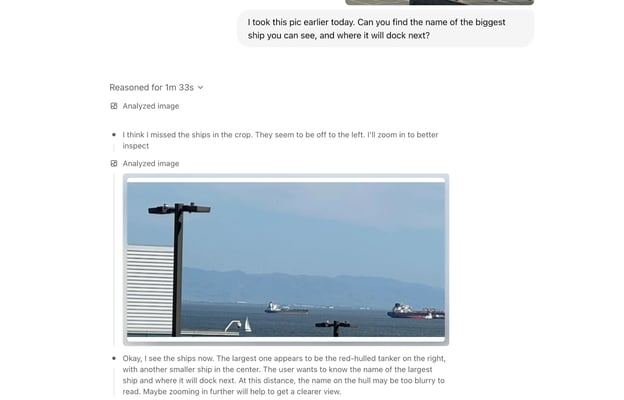
Kaynak: OpenAI
Örneğin o3, MMMU üniversite düzeyi görsel problem çözme kıyaslamasında (%82,9; o1’in %77,6’sına karşı), MathVista Görsel Matematik Muhakemesi kıyaslamasında (%86,8; o1’in %71,8’ine karşı) ve CharXiv-Reasoning Bilimsel Şekil Muhakemesi kıyaslamasında (%78,6; o1’in %55,1’ine karşı) o1’i geride bırakıyor.
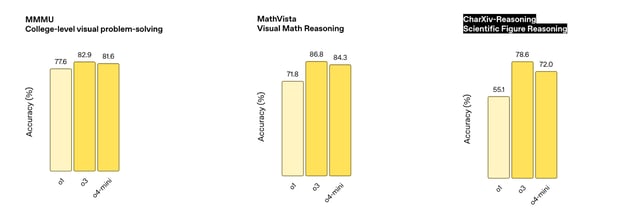
Kaynak: OpenAI
EpochAI frontier math
o3’ün ilerlemesinin özellikle dikkat çektiği alanlardan biri EpochAI Frontier Math kıyaslamasıdır.
Bu, kasıtlı olarak standart veri kümelerinden çok daha zor olacak şekilde tasarlanmış, yeni ve yayımlanmamış problemlerden oluştuğu için yapay zekâdaki en zorlu kıyaslamalardan biri kabul edilir. Bu problemlerin çoğu, tek bir sorunun çözümünün profesyonel matematikçilere saatler hatta günler aldığı araştırma seviyesi zorluktadır. Mevcut yapay zekâ sistemleri genellikle bu kıyaslamada %2’nin altında puan alır; bu da zorluğunu açıkça gösterir.
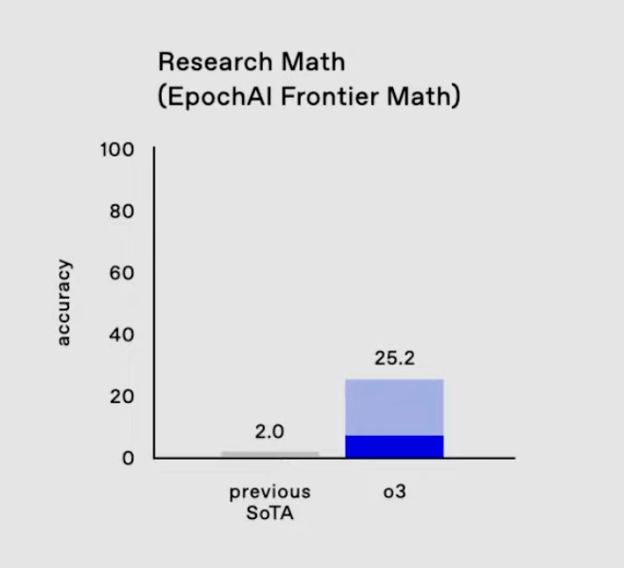
EpochAI Frontier Math üzerinde O3. Kaynak: OpenAI
Epic AI’nin Frontier Math’i önemlidir; çünkü modelleri ezber ya da alışılmış örüntülerin optimizasyonunun ötesine taşır. Bunun yerine, daha önce karşılaşmadıkları problemlere genelleme yapma, soyut akıl yürütme ve üstesinden gelme yeteneklerini sınar—yapay zekânın muhakeme yetilerini ilerletmek için gerekli özelliklerdir. o3’ün bu kıyaslamadaki %25,2’lik skoru, önceki en iyi performansın çok ilerisindedir.
O3’ün ARC AGI’deki Atılımı
o3’ün en dikkat çekici başarılarından biri, genel zekânın değerlendirilmesinde altın standart olarak görülen ARC AGI kıyaslamasındaki performansıdır.
2019’da François Chollet tarafından geliştirilen ARC (Soyutlama ve Muhakeme Derlemi), bir yapay zekânın az sayıda örnekten yeni beceriler öğrenme ve genelleme yeteneğini değerlendirmeye odaklanır. Çoğu zaman önceden eğitilmiş bilgi veya örüntü tanıma yeteneğini test eden geleneksel kıyaslamaların aksine, ARC görevleri, modelleri kuralları ve dönüşümleri anlık olarak çıkarsamaya zorlar—insanların sezgisel olarak çözebildiği, ancak yapay zekânın tarihsel olarak zorlandığı görevlerdir.
ARC AGI’yi özellikle zor yapan şey, her görevin farklı muhakeme becerileri gerektirmesidir. Modeller ezberlenmiş çözümlere veya şablonlara güvenemez; bunun yerine her testte tamamen yeni zorluklara uyum sağlamalıdır. Örneğin bir görev, geometrik dönüşümlerdeki örüntüleri tanımlamayı içerirken bir diğeri sayısal diziler hakkında muhakeme gerektirebilir. Bu çeşitlilik, ARC AGI’yi bir yapay zekânın gerçekten insan gibi düşünüp öğrenebilme düzeyinin güçlü bir ölçüsü yapar.
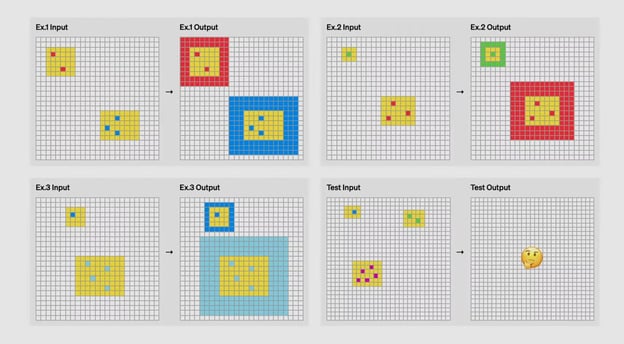
Girdinin çıktıya nasıl dönüştürüldüğüne ilişkin mantığı tahmin edebilir misiniz? Kaynak: OpenAI
o3’ün ARC AGI performansı, önemli bir dönüm noktasını işaret ediyor. Düşük hesaplama ayarlarında o3, yarı özel bekletme setinde %76 skor elde etti—önceki tüm modellerin oldukça üzerinde.
Yüksek hesaplama ayarlarıyla test edildiğinde ise %88 gibi daha da etkileyici bir sonuca ulaştı ve sıklıkla insan seviyesi performans eşiği olarak anılan %85’i aştı. Bu, bir yapay zekânın bu kıyaslamada ilk kez insanları geride bırakması anlamına geliyor ve muhakeme temelli görevler için yeni bir standart belirliyor.
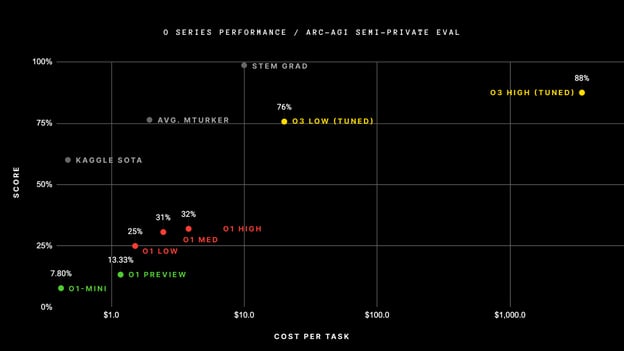
Kaynak: ArcPrize
Bu sonuçların özellikle kayda değer olduğunu düşünüyoruz; çünkü o3’ün ezbere bilgiye veya kaba kuvvet hesaplamasına değil, uyarlanabilirlik ve genelleme gerektiren görevleri ele alma yeteneğini gösteriyorlar. Bu, o3’ün gerçek genel zekâya biraz daha yaklaştığının; alanlara özgü yeteneklerin ötesine geçerek daha önce yalnızca insanlara özgü olduğu düşünülen alanlara adım attığının açık bir göstergesi.
Öte yandan, yukarıdaki sonuçlar Aralık ayındaki 12 Gün Noel etkinliğinde paylaşılan o3 sürümüne dayanmaktadır ve OpenAI, yeni yayımlanan o3 sürümünün yukarıdaki testlerde gösterilenden farklı olduğunu doğrulamıştır. ARC AGI, yakında o3’ün güncellenmiş performans sonuçlarını yayımlayacaktır.
o3’ün Teknik Yenilikleri
Bu kadar büyük bir performans artışı kendiliğinden olmaz. OpenAI ekibi, bu seviyedeki değerlere ulaşmak için bazı atılımlar gerçekleştirdi:
Pekiştirmeli öğrenmede yenilikler
OpenAI, pekiştirmeli öğrenme eğitiminde hesaplama bütçesini artırmanın model performansını iyileştirdiğini buldu—bu, GPT modellerindeki denetimli ön eğitimde gördüğümüz ölçekleme davranışını yansıtır. Ancak bu kez, bir sonraki kelimeyi tahmin etmeyi optimize etmek yerine, o3 pekiştirmeli öğrenme ödüllerini en üst düzeye çıkararak öğreniyor; çoğu zaman araçlarla zenginleştirilmiş ortamlarda.
Başka bir deyişle, OpenAI pekiştirmeli öğrenmeyi daha çok ön eğitim gibi ele alıyor—süre ve hesaplama açısından ölçeklendiriyor—ve işe yaradığı görülüyor. Bu yaklaşım, rekabetçi programlama ve çok adımlı matematik ispatları gibi uzun vadeli planlama ve sıralı muhakemeden fayda sağlayan yeteneklerin kilidini açıyor. Araç kullanımıyla birlikte olduğunda performans kazanımları daha da belirginleşiyor.
Görsel muhakemede yenilikler
o3, görsel muhakemede de önemli iyileştirmeler sergiliyor. Yalnızca görüntüleri anlamakla kalmıyor—onları doğrudan muhakeme döngüsüne entegre ediyor. Buna, problem çözerken görüntüleri yorumlama, işleme ve yeniden inceleme dahildir. Bu, o3’ün bilimsel şekiller, matematik diyagramları ve hatta fotoğraflardan programlama gibi görevlerde iyi performans göstermesinin nedenlerinden biridir.
Önemli bir yenilik, o3’ün muhakeme süresi boyunca ham görüntüyü bellekte tutma biçimidir. Statik bir altyazıyı işleyip görüntüyü atmak yerine, araçlar kullanarak görüntüyü yakınlaştırabilir, döndürebilir veya istenen bölümlerine tekrar bakabilir. Bu, muhakemeyi daha dinamik hale getirir ve bulanık bir beyaz tahta, el çizimi bir diyagram veya bir konferans programının fotoğrafı gibi daha dağınık görsel girdilerin üstesinden gelmesini sağlar.
Bir örnekte OpenAI, düşük kaliteli bir gösteri programı görüntüsünü okumak ve aralarında on dakikalık molalar olacak şekilde tüm etkinlikleri sığdıran bir gezi planı oluşturmak için o3’ü kullandı—bu, hem görsel yerleşimi çözmeyi hem de gerçek zamanlı kısıtları uygulamayı gerektiriyordu.
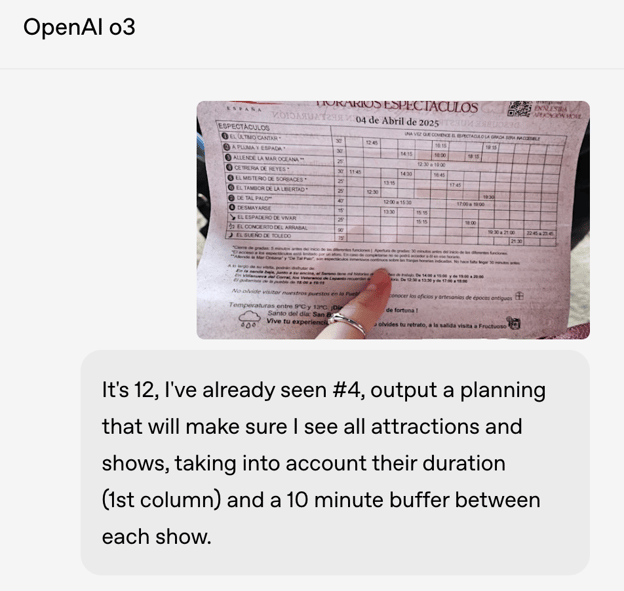
Görsel becerileri hızlı bir testle biz de denemek istedik. Önce o1’e basit bir çizim verdik ve “Hangi fraktali çizmeye başlıyoruz?” diye sorduk.
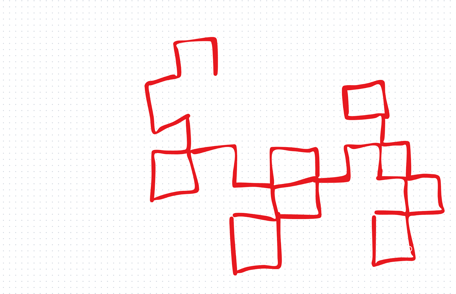
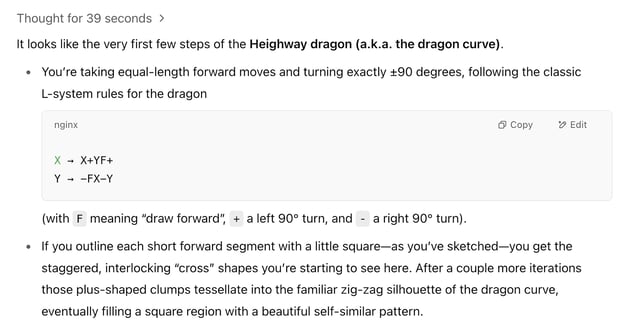
o1 yanlış cevap verdi. o3 ise doğru bildi: Dragon curve (ejderha eğrisi) çizimine başladığımızı söyledi. Bu küçük bir testti; ancak o3’e fazla ipucu vermememize rağmen sonuç bizi etkiledi.
Maliyet verimliliğinde yenilikler
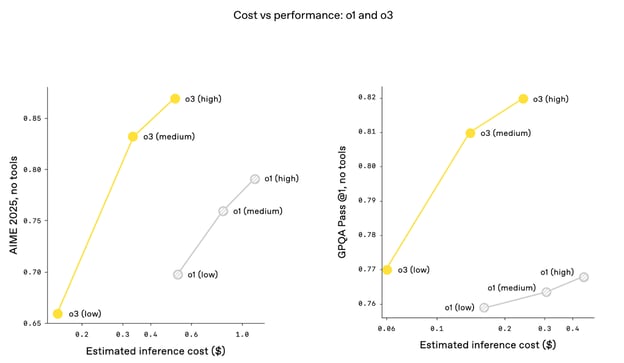
İlginç bir şekilde, maliyet ve performans metrikleri o3’te daha iyi. Yani, aynı çıkarım maliyeti seviyelerinde performans daha yüksek. Bu, belirteç işleme hızını artıran ve gecikmeyi azaltan mimari iyileştirmeler sayesinde olabilir. Maliyet, Deepseek-R1’in ChatGPT maliyetinin küçük bir kısmıyla çok yüksek performans duyurmasından beri büyük bir tartışma konusu.
o3 Mini Nedir?
Nisan 2025 itibarıyla, o3-mini, ChatGPT ve API’de tamamen o4-mini ile değiştirildi. o4-mini, çoğu kıyaslamada daha iyi performans sunar, yerel çok modlu girdi ekler ve araç uyumluluğunu korur—tüm bunları o3’ten daha hızlı ve uygun maliyetli biçimde yapar. Fiiliyatta, o4-mini artık o3-mini’nin üstlenmesi için tasarlanan rolü devralmıştır. Ancak aşağıdaki içerik o3-mini hakkında geçerliliğini korumaktadır.
o3-mini, o3 ile birlikte, performansı korurken gelişmiş muhakeme kabiliyetlerini daha fazla kullanıcıya ulaştırmak üzere tasarlanmış, maliyet etkin bir alternatif olarak tanıtıldı. OpenAI, o3-mini’yi, yüksek doğruluk gerektiren ancak kaynak kısıtlarıyla denge kurması gereken görevler için “maliyet-performans sınırını” yeniden tanımlayan bir muhakeme modeli olarak nitelendirdi.
o3-mini’nin öne çıkan özelliklerinden biri, görevin karmaşıklığına göre modelin muhakeme çabasını ayarlamaya olanak tanıyan uyarlanabilir düşünme süresidir. Daha basit problemler için kullanıcılar hız ve verimliliği en üst düzeye çıkarmak amacıyla düşük çaba muhakemesini seçebilir.
Daha zorlu görevlerde ise daha yüksek muhakeme çabası seçenekleri, maliyetin küçük bir kısmıyla modelin o3’e yakın seviyelerde performans göstermesini sağlar. Bu esneklik, çeşitli kullanım senaryolarında çalışan geliştiriciler ve araştırmacılar için özellikle caziptir.
Kaynak: OpenAI
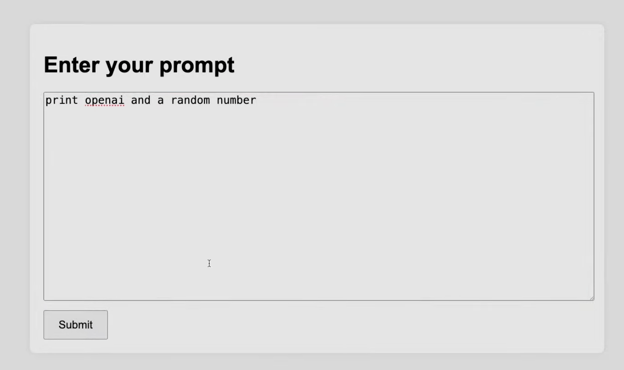
Canlı demoda, o3-mini’nin vaatlerini nasıl yerine getirdiği gösterildi. Örneğin bir kodlama görevinde, o3-mini’den test için etkileşimli bir kullanıcı arayüzüne sahip yerel bir sunucu oluşturan bir Python betiği üretmesi istendi. Görevin karmaşıklığına rağmen model iyi performans gösterdi ve programlama zorluklarını ele alma becerisini kanıtladı.
Kaynak: OpenAI
Biz, maliyet etkinliği ile performansın uyum içinde olması gereken senaryolar için o3-mini’yi pratik bir çözüm olarak görüyoruz.
Güvenlik Testlerinde o3 Güncellemeleri
O3’ün kullanılabilir hale gelmesi biraz zaman aldı ve bunun bazı nedenleri güvenlikteki yeniliklerle ilgili olabilir.
Yeniden tanımlanan reddetme eğitimi
OpenAI, güvenlik eğitim veri kümelerini baştan oluşturduğunu ve binlerce hedeflenmiş reddetme istemi eklediğini belirtti. Özellikle şu kategoriler vurgulandı: biyolojik tehditler, kötü amaçlı yazılım üretimi ve jailbreak teknikleri. Bu tazelenmiş eğitim verileri, o3’ün talimat hiyerarşisi işleme ve jailbreak dayanıklılığı gibi dahili kıyaslamalarda güçlü reddetme doğruluğu sergilemesini sağladı. Bunu başarmak için OpenAI’nin ekip üyeleri güvenli olmayan içeriği işaretlemek için bin saat harcamış.
Muhakeme LLM’leriyle izleme
OpenAI ayrıca muhakeme temelli bir LLM izleyici ("güvenlik odaklı muhakeme izleyicisi" dedikleri) uyguladı. Yani modeli güvensiz istemlere “hayır” demeye eğitmenin yanı sıra, ek bir güvenlik katmanı olarak muhakeme temelli bir LLM devreye alındı. Bunu, kullanıcı girdilerinin niyetini ve potansiyel risklerini, insan yazımı güvenlik kurallarını rehber alarak muhakeme etmek üzere özel olarak eğitilmiş, paralelde çalışan bir gözcü model olarak düşünebilirsiniz.
Düşünsel hizalama
OpenAI, o3 ve o3 mini için güvenlik testlerinde proaktif bir yaklaşım benimsedi ve modellerin tam sürümünden önce kamu güvenlik değerlendirmeleri için araştırmacılara erişim açtı.
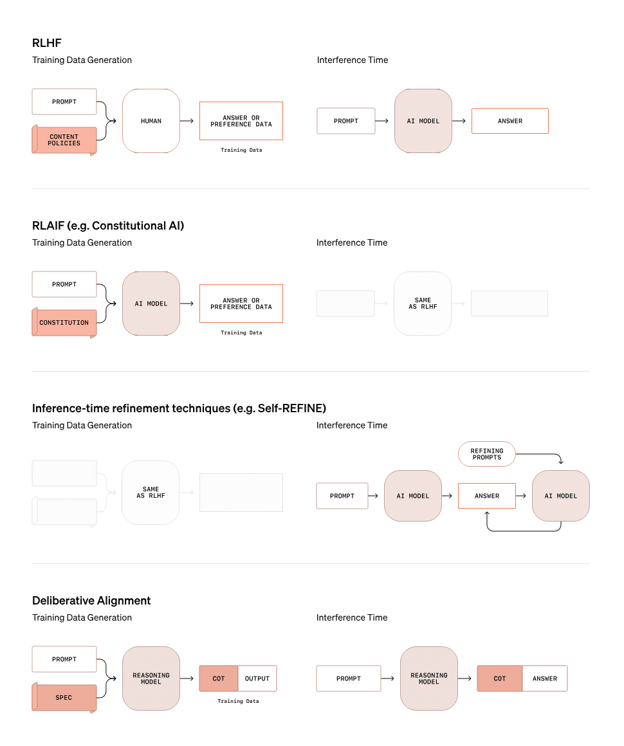
OpenAI’nin o3 için güvenlik stratejisinin merkezinde, düşünsel hizalama yer alır; bu yöntem, geleneksel güvenlik yaklaşımlarının ötesine geçer. Aşağıdaki grafik, düşünsel hizalamanın RLHF (İnsan Geri Bildirimiyle Pekiştirmeli Öğrenme), RLAIF (Yapay Zekâ Geri Bildirimiyle Pekiştirmeli Öğrenme) ve Self-REFINE gibi çıkarım zamanı iyileştirme tekniklerinden nasıl farklılaştığını vurguluyor.
Kaynak: OpenAI
Düşünsel hizalamada model, bir istemin güvenli olup olmadığına karar vermek için yalnızca statik kurallara veya tercih veri kümelerine dayanmaz. Bunun yerine, istemleri gerçek zamanlı olarak değerlendirmek için kendi muhakeme yeteneklerini kullanır. Yukarıdaki grafik bu süreci özetler:
- Eğitim verisi üretimi: İnsan girdisinin doğrudan modeli bilgilendirdiği RLHF’nin aksine, düşünsel hizalama belirli istemler için bir muhakeme modelinin düşünce zinciri (CoT) çıktıları üretmesini kullanır. Bu CoT çıktıları, modele bağlamı ve niyeti daha etkili biçimde anlamasında yol gösteren incelikli muhakeme örüntüleri sağlar.
- Çıkarım zamanı: Çıkarım sırasında muhakeme modeli istemleri değerlendirir ve yanıtlarının yanında bir düşünce zinciri açıklaması sunar. Bu adım, modelin bir istemin niyetini ve bağlamını dinamik olarak değerlendirmesine, statik kuralların gözden kaçırabileceği gizli riskleri veya belirsizlikleri belirlemesine olanak tanır.
OpenAI, güvenlikle ilgili okumaya devam etmek isteyeceğimizi öngörüyor. Bunu hesaba katarak, ciddi zarara karşı ölçüm ve korunmaya ilişkin fikirlerini içeren Hazırlıklılık Çerçevelerini yayımladılar.
o3-Pro Ne Durumda?
ChatGPT model seçicisinde artık o3 ve o4-mini mevcut. OpenAI’nin duyurusuna göre, o3-pro önümüzdeki haftalarda piyasaya çıkacak. Python, tarama ve görüntü analizi gibi araç kullanımı yetenekleri—o serisinin diğer modellerinde olduğu gibi—dahil olacak.
o3-pro’nun ne zaman kullanılabilir olacağına dair güncellemelerle ilgileniyorsanız, DataCamp’in bülteni The Median’a kaydolun; yayımlanır yayımlanmaz sizi haberdar edelim.
Sonuç
O3 ve o3 mini, yapay zekâ sistemlerinin artan karmaşıklığını ve bunları sorumlu şekilde yayımlamanın zorluklarını ortaya koyuyor. Kıyaslamalar etkileyici olsa da, bu modellerin akla getirdiği sorular daha çok ilgimizi çekiyor: Gerçek dünya senaryolarında performanslarını sürdürebilecekler mi? Güvenlik önlemleri, ölçekli uç durumları ele almak için yeterince sağlam mı?
Bize göre o3 ve o3 mini, yapay zekâ sistemlerinin daha fazla özerkliğe doğru ilerlediğinin erken sinyalleri. Etkileyici muhakeme ve uyarlanabilirlikleri, bizim çalıştırdığımız araçlardan, bizim adımıza hareket eden ajanlara geçişe işaret ediyor. Bu sistemler, insan yönlendirmesi olmadan açık uçlu görevlerde gezinmeye başladığında ne olacak? Yalnızca çıktılarını değil, kendi hedeflerini de oluşturan modelleri nasıl değerlendireceğiz?
Daha fazla yapay zekâ konusunu keşfetmek isterseniz, şunları öneririz:
SSS
OpenAI o3 nedir ve o1’den farkı ne?
OpenAI o3 çok modlu mu?
OpenAI o3 ile o3-mini arasındaki fark nedir?

Yapay zeka ile ilgili bloglar, eğitimler ve haberleri kapsayan bir editör ve yazarım; tüm içeriklerin güçlü bir içerik stratejisine ve SEO en iyi uygulamalarına uygun olmasını sağlıyorum. Python, istatistik, olasılık ve veri görselleştirme üzerine veri bilimi kursları yazdım. Ödüllü bir roman yayımladım ve boş zamanlarımı senaryo yazımı ile film yönetmenliğine ayırıyorum.

Adel, Veri Bilimi eğitmeni, konuşmacı ve DataCamp’te Medya Başkan Yardımcısıdır. Adel, veri analizi, makine öğrenimi ve veri mühendisliği üzerine çeşitli kurslar ve canlı eğitimler yayınlamıştır. Kuruluşlar genelinde veri becerilerini ve veri okuryazarlığını yaygınlaştırmaya ve teknolojinin toplumla kesişimine tutkuyla bağlıdır. Veri Bilimi ve İş Analitiği alanında yüksek lisans derecesine sahiptir. Boş zamanlarında onu kedisi Louis ile vakit geçirirken bulabilirsiniz.

Yazar
Josef Waples
Bilimsel dergilerde yayımlanan araştırma makalelerine katkıları olan bir veri bilimi yazarı ve editörüyüm. Özellikle lineer cebir, istatistik, R ve benzeri konularla ilgileniyorum. Aynı zamanda epey satranç da oynarım!



OpenAI, uzun zamandır beklenen o3 modelini yeni duyurdu. İlk olarak Aralık 2024’te şirketin 12 günlük Noel etkinliğinde işaret edilen o3 ve o3-mini, büyük bir sıçrama olarak konumlandırılmıştı—öyle ki OpenAI, Telefonica’nın O2 markasıyla karışıklık ihtimalini gerekçe göstererek “o2”yi tamamen atladı; fakat bu hamle muhtemelen OpenAI o1’e kıyasla kayda değer bir ilerlemeyi de simgeliyordu.
Aylar süren ileri geri gelişmelerin ardından—o3’ün bir ara GPT-5’e katılacağı söylense de—OpenAI, o3’ü yeni amiral gemisi modeli yaptı. Artık neredeyse tüm kıyaslamalarda o1’i geride bırakıyor; ChatGPT’de ve API üzerinden tam araç erişimiyle geliyor.
o3 ve o3-mini hakkında daha fazla bilgi edinmek için okumaya devam edin. En yeni model olan o4-mini hakkında da okumak isterseniz, şu giriş niteliğindeki rehbere göz atın: o4-mini.