

Kurs
Python ile DeepSeek Kullanımı
3 sa
1.4K
Alıştırma and program your progress.
Google Ile Devam EdinOcak 2025'te DeepSeek, muhakeme modelleri üzerindeki çalışmalarında bir sonraki adım olan DeepSeek-R1'i yayınladı. Bu model, daha önceki DeepSeek-R1-Lite-Preview sürümünün bir yükseltmesi ve OpenAI'nın o1 modeliyle rekabette ciddi olduklarını gösteriyor.
O zamandan beri DeepSeek modeli iyileştirmeye devam etti. Mayıs 2025'te, daha iyi kıyaslama performansı, daha az halüsinasyon ve fonksiyon çağırma ile JSON çıktı desteği gibi yeni yetenekler sunan yükseltilmiş sürüm DeepSeek-R1-0528'i yayımladılar.
DeepSeek bazı alanlarda rakiplerinin biraz gerisinde kalsa da, açık kaynak yapısı ve belirgin şekilde daha düşük fiyatlandırması onu yapay zekâ topluluğu için cazip bir seçenek haline getiriyor.
Bu blog yazısında, DeepSeek-R1'ın temel özelliklerini, geliştirme sürecini, damıtılmış modellerini, nasıl erişileceğini, fiyatlandırmasını ve OpenAI'nın modelleriyle nasıl karşılaştırıldığını ele alacağım.
Bu makaleyi aslen DeepSeek-R1 yayımlandığı gün yazmıştım; şimdi ise etkilerini kapsayan yeni bir bölümle güncelledim—borsaya etkisi, yapay zekânın ekonomisi (Jevons paradoksu ve yapay zekâ modellerinin metalaşması dahil) ve OpenAI'nın DeepSeek'in modellerini damıttığı iddiası. Ayrıca yeni DeepSeek-R1-0528 hakkında güncellenmiş bir bölüm de ekledim.
Okurlarımızı yapay zekâ dünyasındaki en son gelişmelerden haberdar etmek için her Cuma ücretsiz bültenimiz The Median’ı gönderiyoruz; haftanın önemli haberlerini özetliyoruz. Abone olun, haftada sadece birkaç dakikada güncel kalın:
DeepSeek-R1, Çinli bir yapay zekâ şirketi olan DeepSeek tarafından, mantıksal çıkarım, matematiksel problem çözme ve gerçek zamanlı karar verme gerektiren görevleri ele almak için geliştirilen açık kaynaklı bir muhakeme modelidir.
DeepSeek-R1 ve OpenAI'nın o1 gibi muhakeme modellerini geleneksel dil modellerinden ayıran şey, sonuca nasıl ulaştıklarını gösterebilmeleridir.
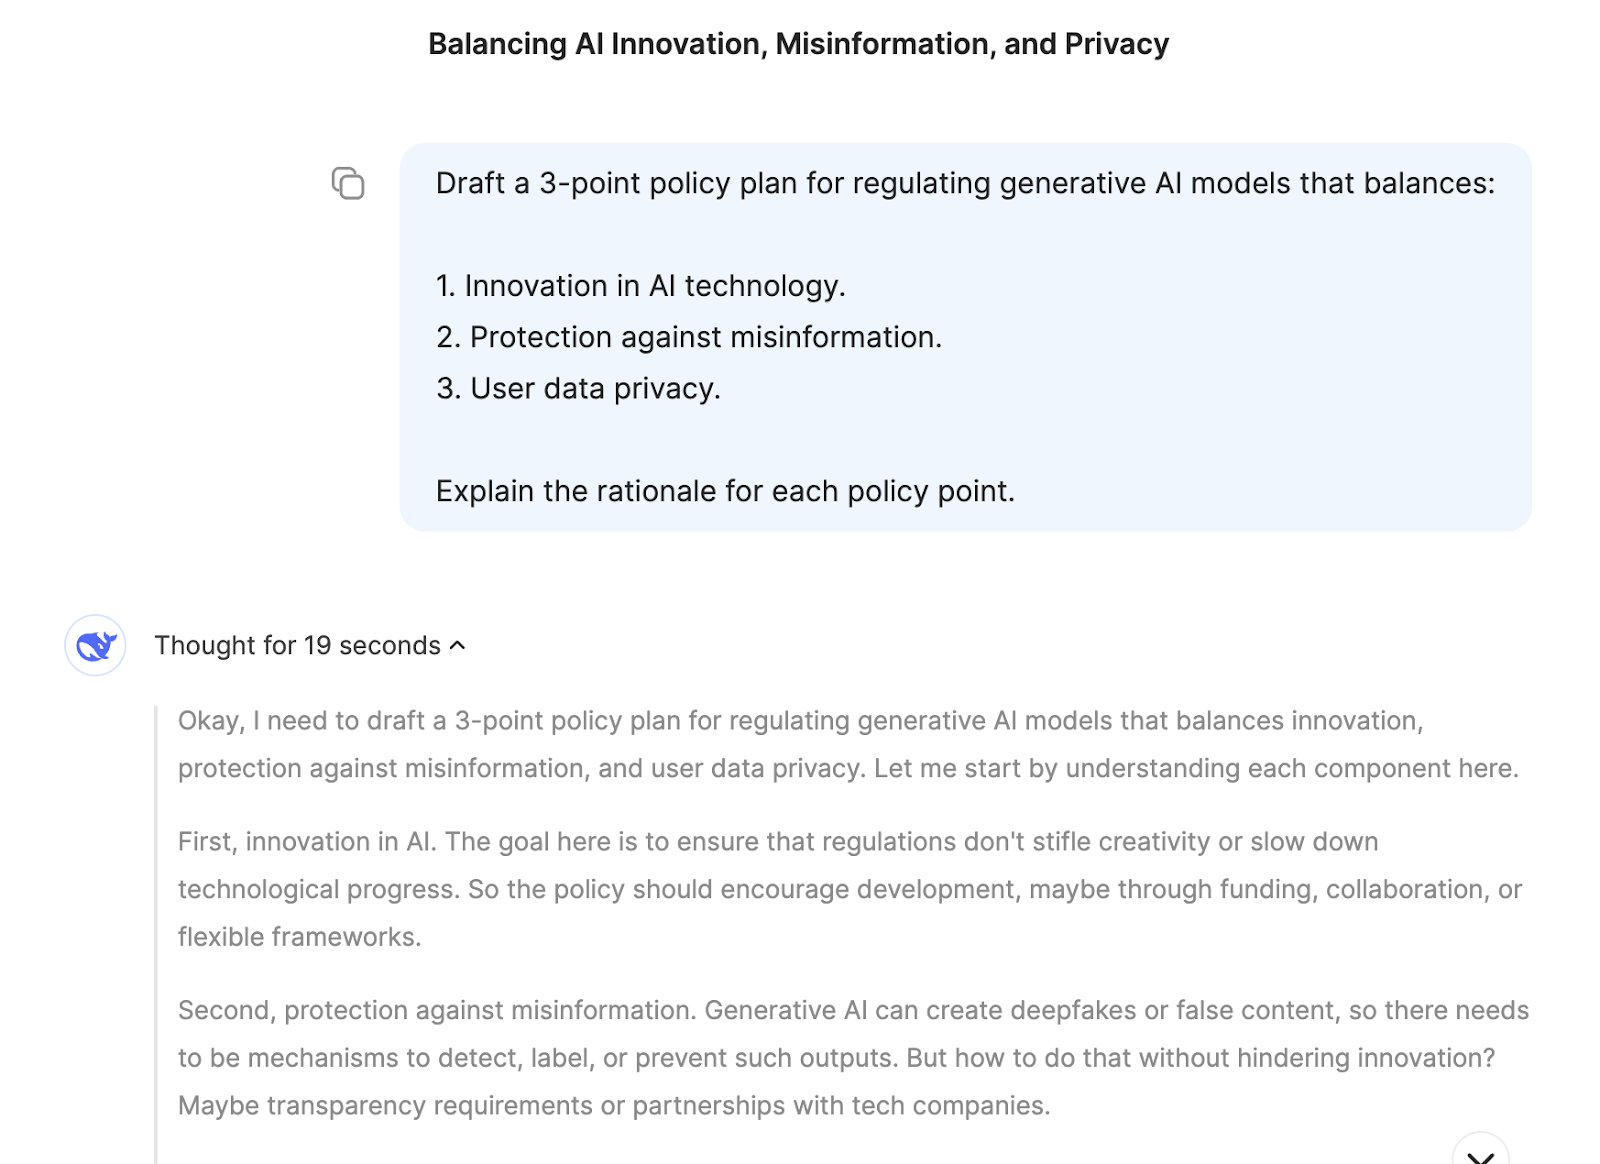
DeepSeek-R1 ile mantık akışını adım adım takip edebilir, böylece çıktısını anlamak ve gerekirse sorgulamak kolaylaşır. Bu yetenek, sonuçların açıklanabilir olmasının gerektiği araştırma veya karmaşık karar alma gibi alanlarda muhakeme modellerine avantaj sağlar.
DeepSeek-R1'ı özellikle rekabetçi ve çekici kılan şey, açık kaynak doğasıdır. Mülkiyetli modellere kıyasla, açık kaynak yapısı geliştiricilerin ve araştırmacıların belirli teknik sınırlar (örneğin kaynak gereksinimleri) dahilinde modeli incelemesine, değiştirmesine ve dağıtmasına olanak tanır.
Bu bölümde, selefi DeepSeek-R1-Zero'dan başlayarak DeepSeek-R1'ın nasıl geliştirildiğini anlatacağım.
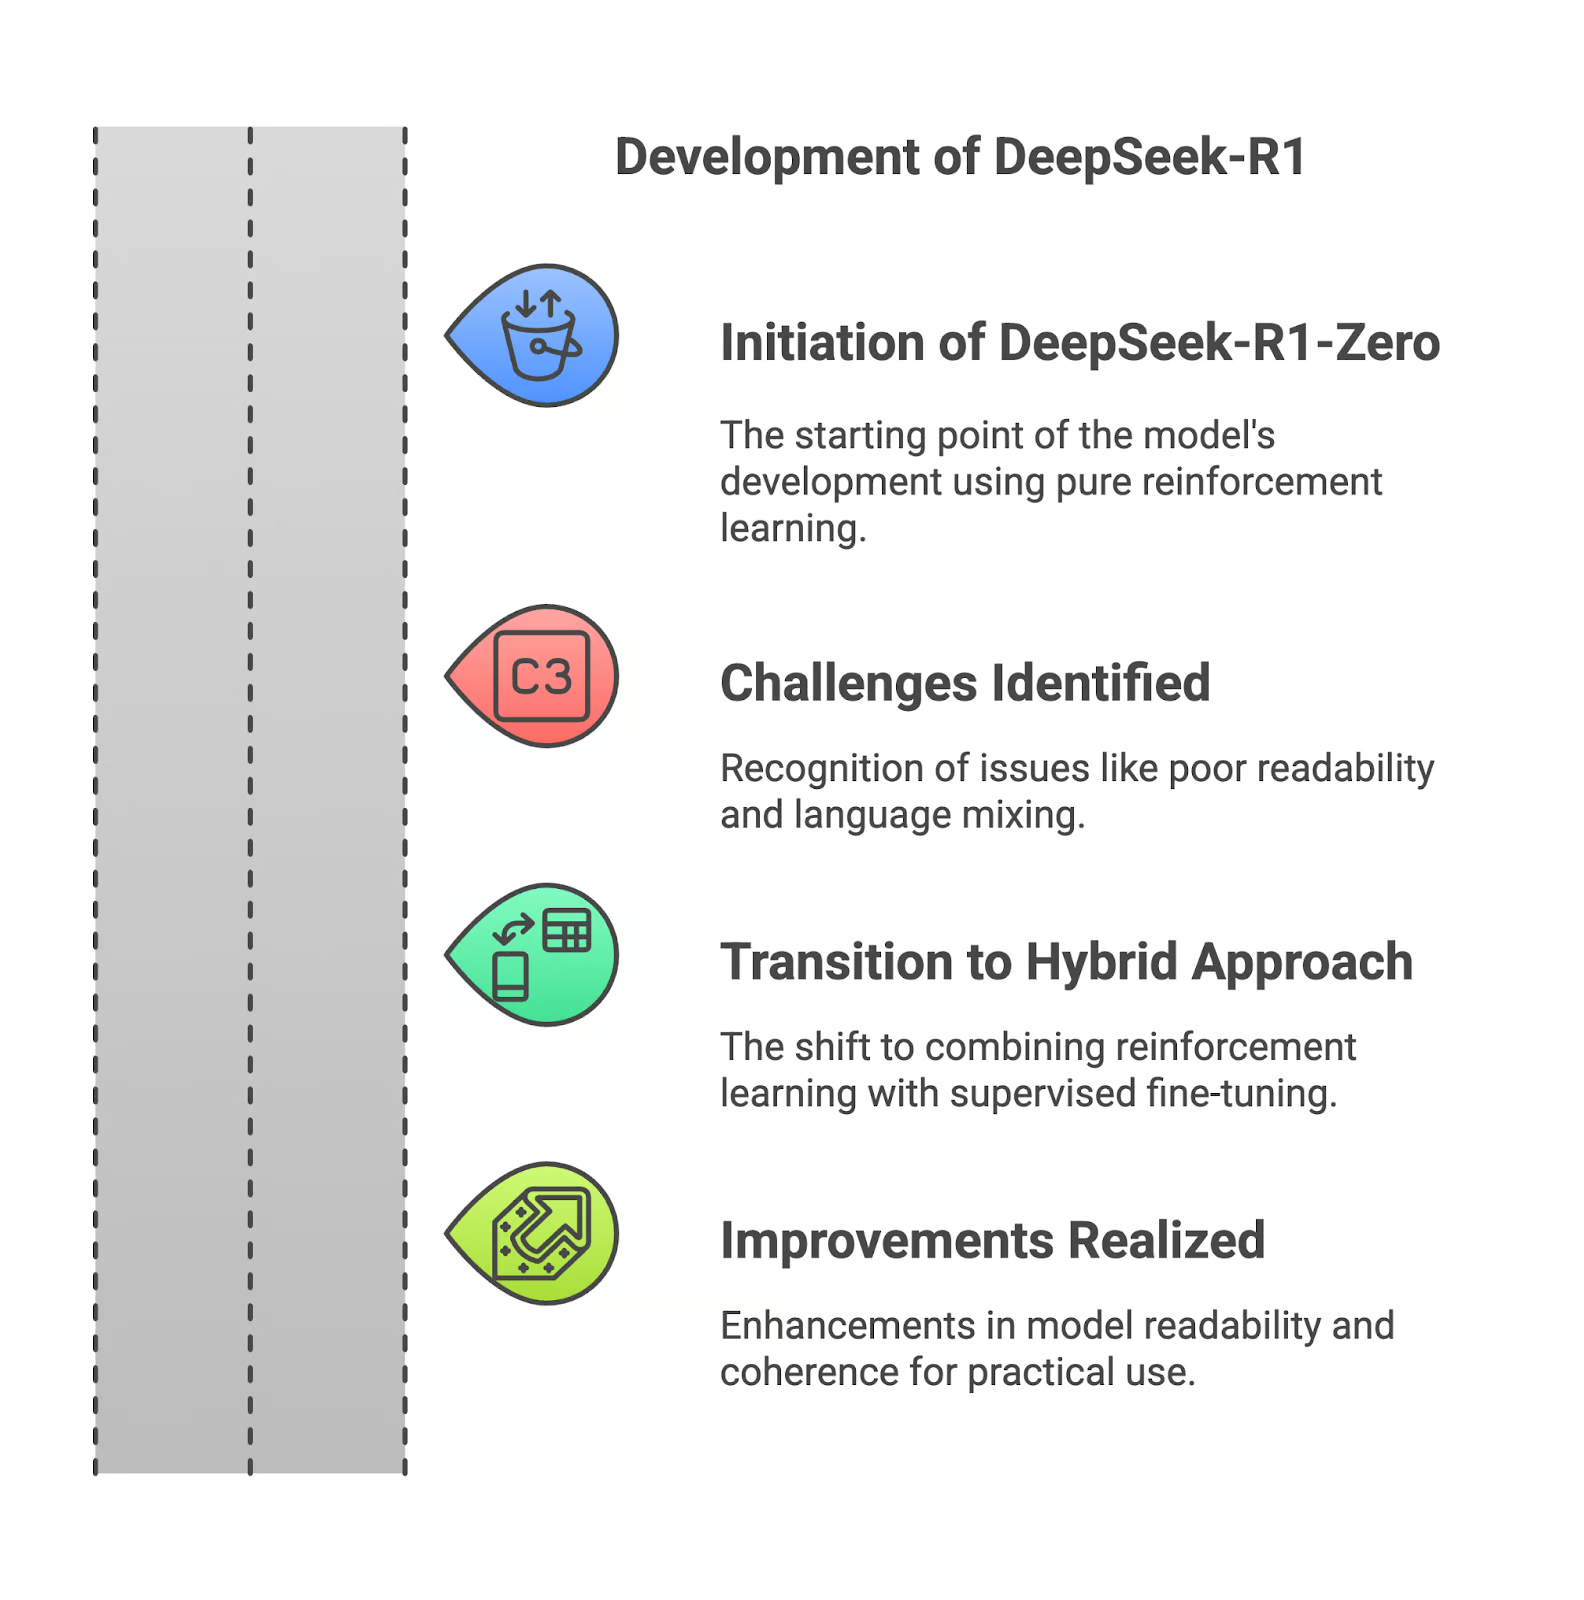
DeepSeek-R1, tamamen pekiştirmeli öğrenme ile eğitilmiş bir model olan R1-Zero ile başladı. Bu yaklaşım güçlü muhakeme yetenekleri geliştirmesini sağlasa da, önemli dezavantajlar getirdi. Çıktılar çoğu zaman okumaya elverişli değildi ve model bazen yanıtlarında dilleri karıştırıyordu. Bu sınırlamalar, R1-Zero'yu gerçek dünya uygulamaları için daha az pratik hale getirdi.
Saf pekiştirmeli öğrenmeye dayanmak, mantıksal olarak tutarlı ancak zayıf yapılandırılmış çıktılar üretti. Denetimli verinin rehberliği olmadan, model muhakemesini etkili biçimde aktarmakta zorlandı. Bu durum, sonuçlarda açıklık ve hassasiyet arayan kullanıcılar için bir engeldi.
Bu sorunları ele almak için DeepSeek, R1'ın geliştirilmesinde pekiştirmeli öğrenmeyi denetimli ince ayarla birleştiren bir değişikliğe gitti. Bu hibrit yaklaşım, seçilmiş veri kümelerini içerecek şekilde tasarlandı ve modelin okunabilirliğini ve tutarlılığını artırdı. Dil karışımı ve parçalı muhakeme gibi sorunlar önemli ölçüde azaltıldı; böylece model pratik kullanım için daha uygun hale geldi.
DeepSeek-R1'ın geliştirilmesi hakkında daha fazla bilgi edinmek isterseniz, yayımlanan makaleyi okumanızı öneririm.
Yapay zekâda damıtma, daha büyük modellerden daha küçük ve verimli modeller oluşturma sürecidir; hesaplama gereksinimlerini azaltırken muhakeme gücünün büyük bölümünü korur. DeepSeek bu tekniği, Qwen ve Llama mimarilerini kullanarak R1'dan bir dizi damıtılmış model yaratmak için uyguladı.
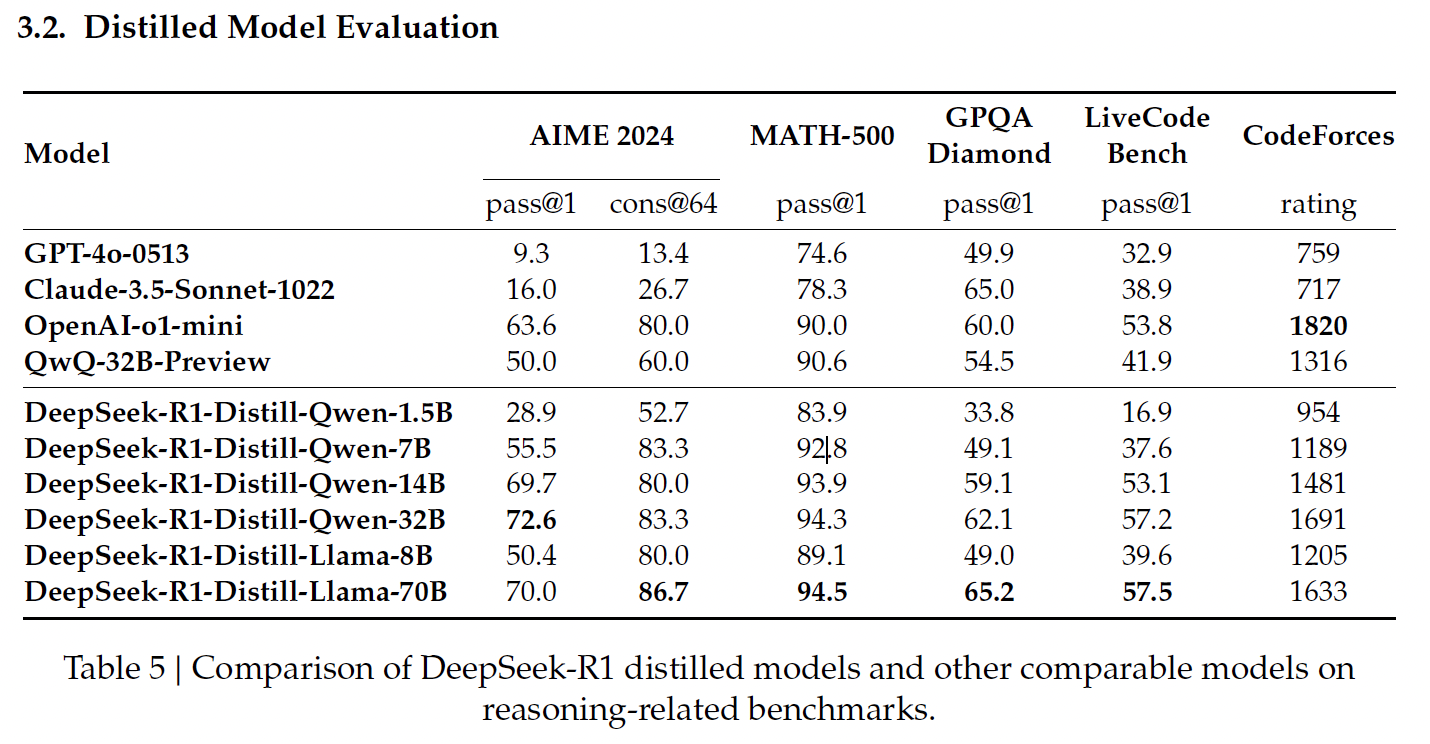
Kaynak: DeepSeek'in yayımladığı makale
DeepSeek'in Qwen tabanlı damıtılmış modelleri, performans ile hesaplama gereksinimleri arasında denge kurarak verimlilik ve ölçeklenebilirliğe odaklanır.
Bu, MATH-500'de %83,9'a ulaşan en küçük damıtılmış modeldir. MATH-500, mantıksal muhakeme ve çok adımlı çözümlerle lise düzeyindeki matematik problemlerini çözme yeteneğini test eder. Bu sonuç, modelin kompakt boyutuna rağmen temel matematiksel görevleri iyi idare ettiğini gösterir.
Bununla birlikte, LiveCodeBench'te (%16,9) performansı önemli ölçüde düşer; bu kıyaslama, kodlama yeteneklerini değerlendirmek için tasarlanmıştır ve programlama görevlerindeki sınırlı yetkinliğini ortaya koyar.
Qwen-7B, MATH-500'de %92,8 ile parlıyor; bu, güçlü matematiksel muhakeme kabiliyetlerini gösterir. GPQA Diamond'da da (%49,1) makul bir performans sergiler; bu kıyaslama, olgusal soru yanıtlama yeteneğini değerlendirir ve matematiksel ile olgusal muhakeme arasında iyi bir dengeye sahip olduğunu gösterir.
Buna karşın, LiveCodeBench (%37,6) ve CodeForces (1189 puan) sonuçları, karmaşık kodlama görevleri için daha az uygun olduğunu düşündürür.
Bu model, MATH-500'de (%93,9) iyi bir performans sergileyerek karmaşık matematiksel problemleri ele alma yeteneğini yansıtır. GPQA Diamond'daki %59,1 skoru da olgusal muhakemede yetkinliğe işaret eder.
LiveCodeBench (%53,1) ve CodeForces (1481 puan) performansı, kodlama ve programlamaya özgü muhakeme görevlerinde gelişme alanı olduğunu gösterir.
En büyük Qwen tabanlı model, gelişmiş çok adımlı matematiksel muhakemeyi değerlendiren AIME 2024'te akranları arasında en yüksek skoru (%72,6) elde eder. MATH-500 (%94,3) ve GPQA Diamond (%62,1) kıyaslarında da üstün performans göstererek hem matematiksel hem de olgusal muhakemede güçlü olduğunu kanıtlar.
LiveCodeBench (%57,2) ve CodeForces (1691 puan) sonuçları, çok yönlü olduğunu ancak kodlamaya özel modellere kıyasla programlama görevleri için hâlâ optimize edilmediğini düşündürür.
DeepSeek'in Llama tabanlı damıtılmış modelleri, özellikle matematiksel ve olgusal hassasiyet gerektiren görevlerde yüksek performans ve ileri düzey muhakemeyi önceleyerek öne çıkar.
Llama-8B, MATH-500'de (%89,1) iyi, GPQA Diamond'da (%49,0) ise makul bir performans sergileyerek matematiksel ve olgusal muhakemeyi ele alma becerisini gösterir. Ancak LiveCodeBench (%39,6) ve CodeForces (1205 puan) gibi kodlama kıyaslarında daha düşük puan alır; bu da Qwen tabanlı modellere kıyasla programlama odaklı görevlerdeki sınırlamalarını vurgular.
En büyük damıtılmış model olan Llama-70B, MATH-500'de (%94,5) en iyi sonucu vererek tüm damıtılmış modeller arasında zirvede yer alır ve AIME 2024'te %86,7 gibi güçlü bir skor elde ederek ileri düzey matematiksel muhakeme için mükemmel bir seçenek haline gelir.
LiveCodeBench (%57,5) ve CodeForces (1633 puan) kıyaslarında da iyi performans gösterir; bu da onu çoğu diğer modele göre kodlama görevlerinde daha yetkin kılar. Bu alanda OpenAI'nın o1-mini veya GPT-4o'ya denk düzeydedir.
DeepSeek-R1'a iki ana yöntemle erişebilirsiniz: web tabanlı DeepSeek Chat platformu ve DeepSeek API'ı. İhtiyaçlarınıza en uygun seçeneği tercih edebilirsiniz.
DeepSeek Chat platformu, DeepSeek-R1 ile etkileşime geçmenin doğrudan bir yolunu sunar. Erişmek için doğrudan sohbet sayfasına gidebilir veya Start Now düğmesine ana sayfadan tıklayabilirsiniz.
Kayıt olduktan sonra, Deepseek-R1'ın adım adım muhakeme yeteneklerini deneyimlemek için “Deep Think” modunu seçebilirsiniz.
DeepSeek-R1'ı uygulamalarınıza entegre etmek için DeepSeek API programatik erişim sağlar.
Başlamak için DeepSeek Platformunda kayıt olarak bir API anahtarı edinmeniz gerekir.
API, OpenAI biçimiyle uyumludur; OpenAI araçlarına aşinaysanız entegrasyon süreci oldukça rahattır. Daha fazla talimatı DeepSeek'in API dokümantasyonunda bulabilirsiniz.
Mayıs 2025 itibarıyla sohbet platformunda R1 modeli ücretsiz olarak kullanılabiliyor.
API iki model sunar—deepseek-chat (DeepSeek-V3) ve deepseek-reasoner (DeepSeek-R1)—ve aşağıdaki fiyatlandırma yapısına sahiptir (1M token başına):
|
MODEL |
BAĞLAM UZUNLUĞU |
AZAMİ CoT TOKEN'I |
AZAMİ ÇIKTI TOKEN'I |
1M TOKEN GİRDİ FİYATI (ÖNBELLEK VURUMU) |
1M TOKEN GİRDİ FİYATI (ÖNBELLEK ISKASI) |
1M TOKEN ÇIKTI FİYATI |
|
deepseek-chat |
64K |
- |
8K |
$0.07 $0.014 |
$0.27 $0.14 |
$1.10 $0.28 |
|
deepseek-reasoner |
64K |
32K |
8K |
$0.14 |
$0.55 |
$2.19 |
Kaynak: DeepSeek'in fiyatlandırma sayfası
En güncel fiyat bilgilerine sahip olmak ve CoT (Chain-of-Thought) muhakemesinin maliyetini nasıl hesaplayacağınızı anlamak için DeepSeek'in fiyatlandırma sayfasını ziyaret edin.
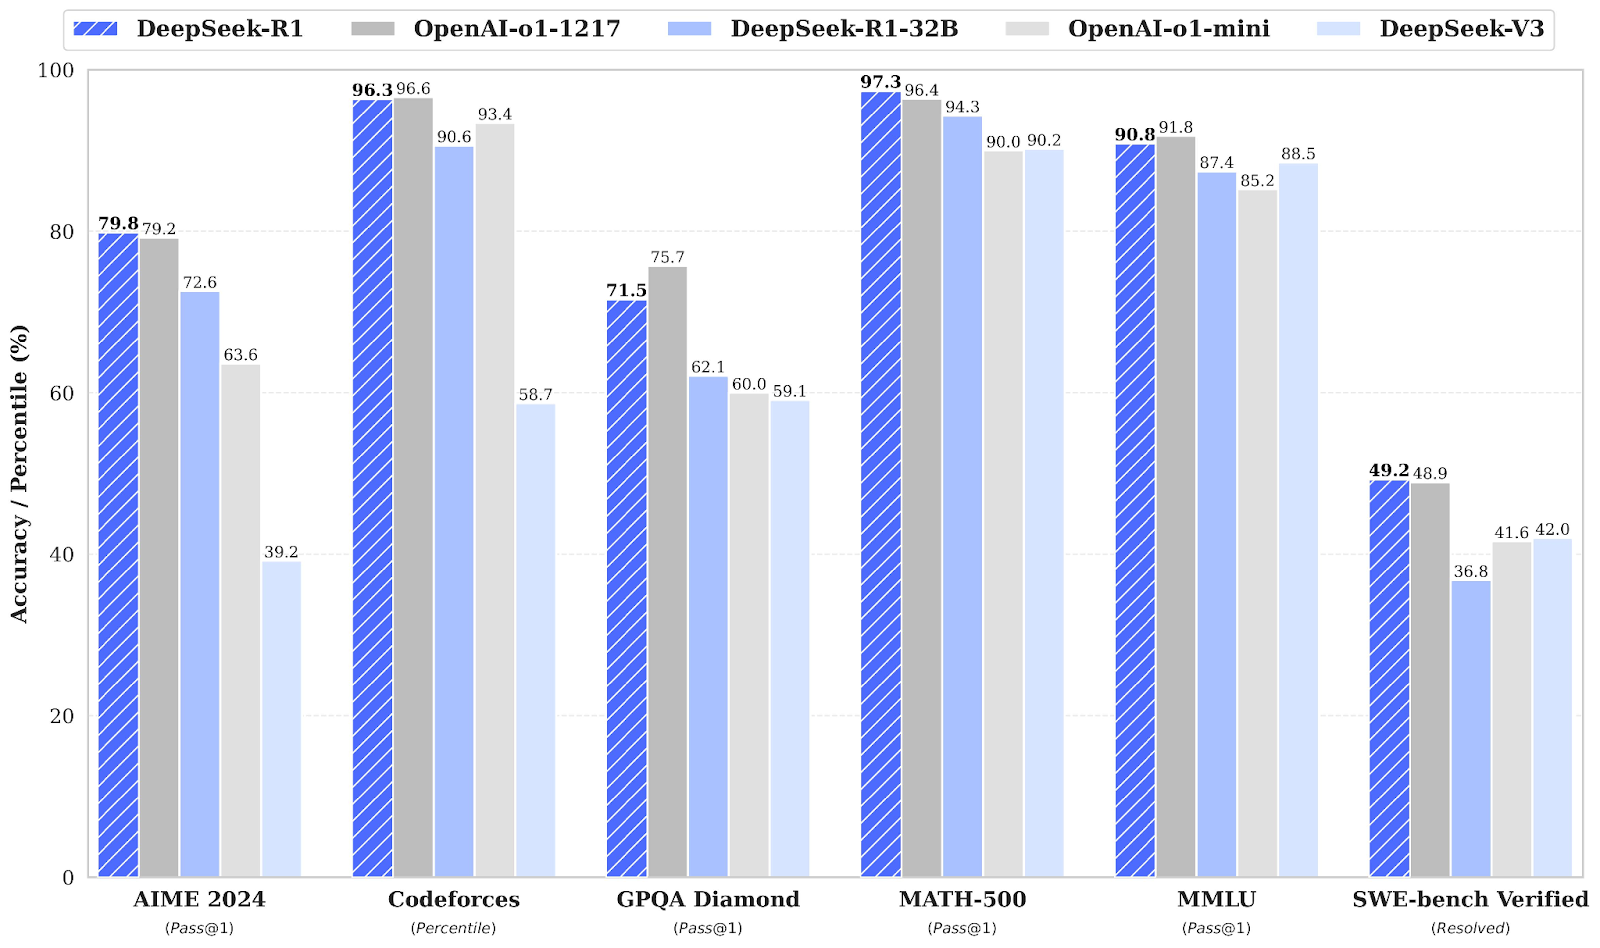
DeepSeek-R1, çeşitli kıyaslamalarda OpenAI o1 ile doğrudan rekabet eder; sıkça OpenAI'nın o1 modeline denk ya da onu aşan sonuçlar elde eder.
Kaynak: DeepSeek'in yayımladığı makale
Matematik kıyaslamalarında DeepSeek-R1 güçlü bir performans sergiler. Gelişmiş çok adımlı matematiksel muhakemeyi değerlendiren AIME 2024'te DeepSeek-R1 %79,8 puan alarak OpenAI o1-1217'nin %79,2'lik skorunun biraz önüne geçer.
MATH-500'de DeepSeek-R1 %97,3 gibi etkileyici bir sonuçla liderliği alır; OpenAI o1-1217 ise %96,4 ile onu yakından izler. Bu kıyaslama, ayrıntılı muhakeme gerektiren çeşitli lise düzeyi matematik problemlerinde modelleri test eder.
Codeforces kıyaslaması, bir modelin kodlama ve algoritmik muhakeme yeteneklerini, insan katılımcılara karşı yüzdelik dilim şeklinde değerlendirir. OpenAI o1-1217 %96,6 ile önde, DeepSeek-R1 ise %96,3 ile çok rekabetçi bir sonuç elde eder; aradaki fark oldukça küçüktür.
SWE-bench Verified kıyaslaması, yazılım mühendisliği görevlerinde muhakemeyi değerlendirir. DeepSeek-R1 %49,2 ile güçlü bir performans gösterir ve OpenAI o1-1217'nin %48,9'luk skorunun biraz önündedir. Bu sonuç, yazılım doğrulama gibi uzmanlaşmış muhakeme görevlerinde DeepSeek-R1'ı güçlü bir rakip konumuna getirir.
Olgu temelli muhakeme için GPQA Diamond, genel amaçlı bilgi sorularını yanıtlama yeteneğini ölçer. DeepSeek-R1 %71,5 alırken, OpenAI o1-1217 %75,7 ile öndedir. Bu sonuç, olgusal muhakeme görevlerinde OpenAI o1-1217'nin hafif üstünlüğünü ortaya koyar.
MMLU'da—çeşitli disiplinleri kapsayan ve çok görevli dil anlama yeteneğini değerlendiren bir kıyaslama—OpenAI o1-1217 %91,8 ile DeepSeek-R1'in %90,8'lik skorunu az bir farkla geride bırakır.
DeepSeek-R1'ın piyasaya çıkışı, borsaları etkileyen, yapay zekâ ekonomisini yeniden şekillendiren ve model geliştirme uygulamaları hakkında tartışma başlatan geniş kapsamlı sonuçlar doğurdu.
DeepSeek'in rakiplerin maliyetinin çok küçük bir kısmına gelişmiş yapay zekâ yetenekleri sunan R1 modelini tanıtması, büyük ABD teknoloji şirketlerinin hisse fiyatlarında önemli düşüşe yol açtı.
Örneğin Nvidia, hisse değerinde yaklaşık %18'lik bir düşüş yaşadı; bu da yaklaşık 600 milyar dolarlık piyasa değeri kaybına denk geliyor. Bu düşüş, DeepSeek'in verimli yapay zekâ modellerinin, geleneksel olarak Nvidia gibi şirketlerin sağladığı yüksek performanslı donanım talebini azaltabileceğine dair yatırımcı endişeleriyle tetiklendi.
DeepSeek-R1 gibi açık ağırlıklı modeller maliyetleri düşürüyor ve yapay zekâ şirketlerini fiyatlandırma stratejilerini yeniden düşünmeye zorluyor. Bu durum, çarpıcı fiyat farkında açıkça görülüyor:
Bazı sektör liderleri, verimlilik arttıkça toplam tüketimin azalmak yerine artabileceğini öne süren Jevons paradoksuna işaret etti. Microsoft CEO'su Satya Nadella da buna değinerek yapay zekâ ucuzladıkça talebin patlayacağını savundu.
Ancak The Economist'teki bu dengeli görüşü beğendim; makale, tam ölçekli bir Jevons etkisinin çok nadir olduğunu ve benimsenmenin önündeki ana engelin fiyat olup olmamasına bağlı bulunduğunu savunuyor. “Amerikan şirketlerinin yalnızca %5'i hâlihazırda yapay zekâ kullanıyor ve %7'si benimsemeyi planlıyor” olduğundan Jevons etkisi muhtemelen düşük kalacak. Birçok işletme, yapay zekâ entegrasyonunu hâlâ zor ya da gereksiz buluyor.
Yıkıcı etkisinin yanı sıra DeepSeek kendini tartışmaların merkezinde de buldu. OpenAI, DeepSeek'i modellerini damıtarak—özünde OpenAI'nın tescilli sistemlerinden bilgi çıkarıp, performanslarını daha kompakt ve verimli bir modelde çoğaltmakla—suçladı.
Şu ana kadar OpenAI bu iddia için doğrudan bir kanıt sunmadı ve birçok kişiye göre bu suçlama, değişen yapay zekâ manzarasında yatırımcıları teskin etmeye yönelik stratejik bir hamle gibi görünüyor.
28 Mayıs 2025'te DeepSeek, muhakeme modelinin yükseltilmiş bir sürümünü yayımladı: DeepSeek-R1-0528. Bu güncelleme birkaç önemli iyileştirme getiriyor:
Bu eklemelere rağmen API uç noktalarında bir değişiklik yok—DeepSeek-R1-0528 geriye dönük olarak tamamen uyumludur. Geliştiriciler aynı arayüzü kullanmaya devam ederken yeni modelin avantajlarından yararlanabilir.
DeepSeek Chat platformunda deneyebilir veya Hugging Face'teki açık kaynak ağırlıkları inceleyebilirsiniz.
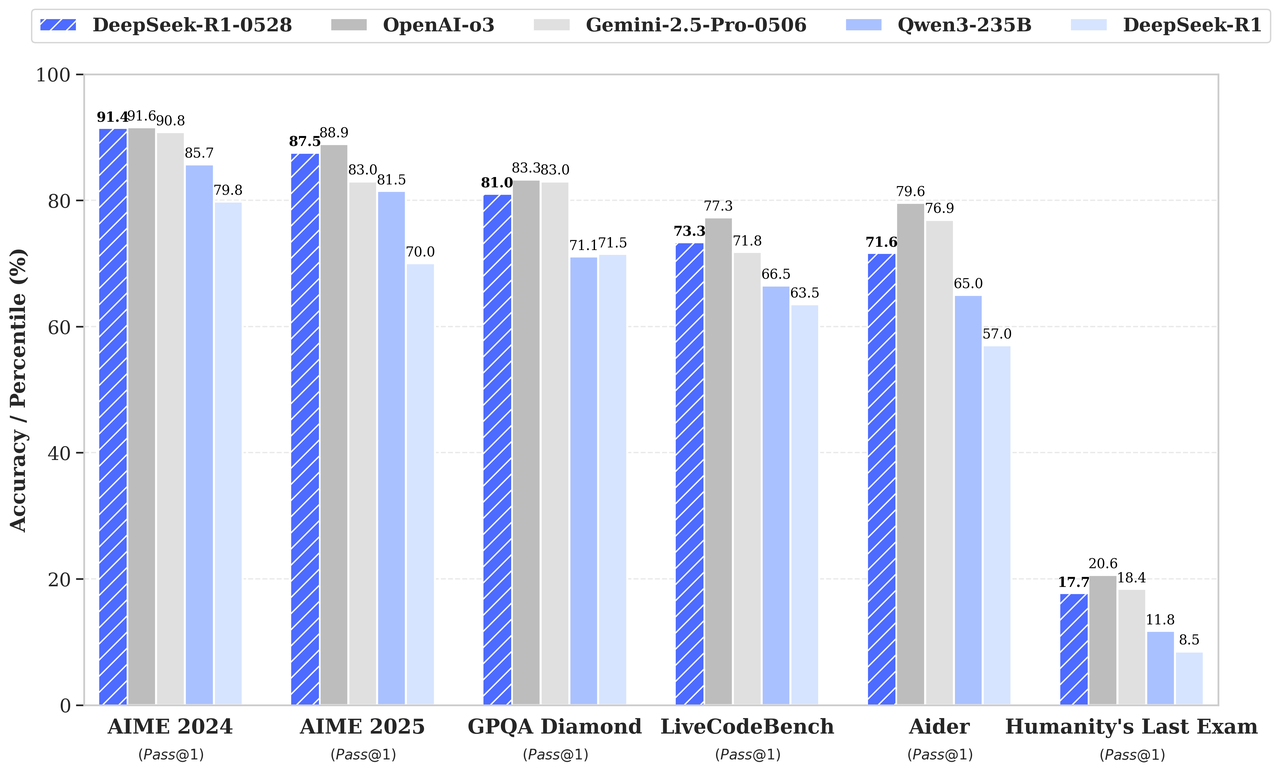
Yayın duyurusundaki kıyaslama grafiğine göre DeepSeek-R1-0528 selefini geride bırakıyor ve OpenAI'nın o3 ile Gemini 2.5 Pro ile güçlü biçimde rekabet ediyor:
Kaynak: DeepSeek
DeepSeek-R1, muhakemeye odaklı yapay zekâ alanında güçlü bir rakip olup OpenAI'nın o1 modeliyle başa baş performans sergiler. OpenAI'nın o1 modeli kodlama ve olgusal muhakemede hafif bir avantaja sahip olsa da, DeepSeek-R1'ın açık kaynak doğası ve maliyet etkin erişimi onu cazip bir seçenek kılıyor.
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



