Kurs
Bir DBMS mülakatına mı hazırlanıyorsunuz? Doğru yerdesiniz.
Veritabanlarını günlük işinizden tanıyorsunuz, ancak mülakatlar gerçek hayattaki senaryolardan farklı şekilde sınar. Görüşmeciler yalnızca SQL sorguları yazabildiğinizi görmek istemez; normalleştirme, ACID özellikleri ve baskı altında veritabanı performans sorunlarını nasıl ele alacağınız konularını da yoklar. Birçok veritabanı profesyoneli, her gün kullandıkları kavramları açıklayamadıkları veya veri ekipleriyle nasıl çalıştıklarını ölçen davranışsal sorularda zorlandıkları için tökezler.
Bu rehber, tüm zorluk seviyelerinde en sık sorulan DBMS mülakat sorularını kapsar. Senaryoya dayalı sorularda öne çıkmanızı sağlayacak kanıtlanmış stratejiler ve diğer adaylardan ayrışmanıza yardımcı olacak ipuçları da bulacaksınız.
Hemen hemen her DBMS mülakatının başında gelen temel sorularla başlayalım.
>Mülakatın sadece kodlama kısmına odaklanmak mı istiyorsunuz? İşte 2026 için 85 SQL mülakat sorusu ve cevabı.
Temel DBMS Mülakat Soruları
Bu soruları teknik mülakatın başında bekleyin. Veritabanı yönetim sistemlerine dair temel anlayışınızı ölçerler.
Görüşmeciler, karmaşık senaryolara geçmeden önce temel veritabanı kavramlarını anlayıp anlamadığınızı görmek için bu soruları kullanır. Aradıkları şey, ezber tanımlardan ziyade veritabanlarıyla çalıştığınızı gösteren net açıklamalar ve pratik örneklerdir.
Veritabanı Yönetim Sistemi (DBMS) nedir?
Bir DBMS, veritabanlarını yöneten bir yazılımdır – verileri depolamayı, almayı ve düzenlemeyi güvenlik ve tutarlılığı sağlayarak yürütür.
Uygulamalarınız ile gerçek veri dosyaları arasında bir aracı gibi düşünün. Popüler örnekler: MySQL, PostgreSQL, Oracle ve SQL Server. DBMS; kullanıcı kimlik doğrulaması, yedekleme ve birden fazla kullanıcının veriye bozulmaya yol açmadan erişebilmesini sağlama gibi görevleri üstlenir.
Veritabanı ile DBMS arasındaki fark nedir?
Bir veritabanı, verinin kendisinin bulunduğu koleksiyondur; DBMS ise bu veriyi yöneten yazılımdır.
Veritabanı; tablolarınızı, kayıtlarınızı ve ilişkilerinizi barındırır. DBMS ise bu verilerle etkileşim kurmanızı sağlayan araçları ve arayüzü sunar. Kütüphane (veritabanı) ile kitapları bulup ödünç almanıza yardım eden kütüphane sistemi (DBMS) arasındaki fark gibi düşünebilirsiniz.
Veritabanı işlemlerinde ACID özelliklerini açıklayın
ACID ilkeleri, veritabanı işlemlerinin güvenilir olmasını ve veri bütünlüğünü korumasını sağlar:
- Atomiklik (Atomicity): Bir işlemdeki tüm operasyonlar birlikte başarılı olur veya birlikte başarısız olur
- Tutarlılık (Consistency): Veri, tanımlı kurallara göre geçerli kalır
- Yalıtım (Isolation): Eşzamanlı işlemler birbirini etkilemez
- Kalıcılık (Durability): Onaylanan değişiklikler sistem çökse bile korunur
Günlük hayattan bir örnek: Banka hesapları arasında para transferi yaptığınızda, hem çekim hem de yatırma birlikte gerçekleşmelidir (atomiklik), toplam bakiye kuralları geçerli kalır (tutarlılık), diğer işlemler kısmi durumları görmez (yalıtım) ve sistem çökse bile değişiklik kalıcı olur (kalıcılık).
Farklı veritabanı anahtarları nelerdir?
Veritabanı anahtarları, kayıtları benzersiz olarak tanımlamak ve ilişkiler kurmak için kullanılır. Bilmeniz gereken türler:
- Birincil anahtar (Primary key): Her satırı benzersiz tanımlar (null ve tekrar olamaz)
- Yabancı anahtar (Foreign key): Başka bir tablodaki birincil anahtara referans verir
- Aday anahtar (Candidate key): Birincil anahtar olarak kullanılabilecek her sütun
- Bileşik anahtar (Composite key): Birden çok sütundan oluşan birincil anahtar
- Benzersiz anahtar (Unique key): Benzersizliği sağlar ancak bir adet null değere izin verebilir
Basit bir örnek:
CREATE TABLE employees (
employee_id INT PRIMARY KEY,
department_id INT,
email VARCHAR(100) UNIQUE,
FOREIGN KEY (department_id) REFERENCES departments(id)
);
Normalleştirme nedir ve neden iyidir?
Normalleştirme, veriyi ilişkili, ayrı tablolara düzenleyerek fazlalıkları ortadan kaldırır.
Tutarsızlıkları önler ve depolama alanı kazandırır. Başlıca normal formlar şöyle çalışır:
Birinci Normal Form (1NF): Her sütun bölünemez (atomik) değerler içerir – tek bir hücrede liste veya birden fazla değer bulunmaz.
Kötü örnek:
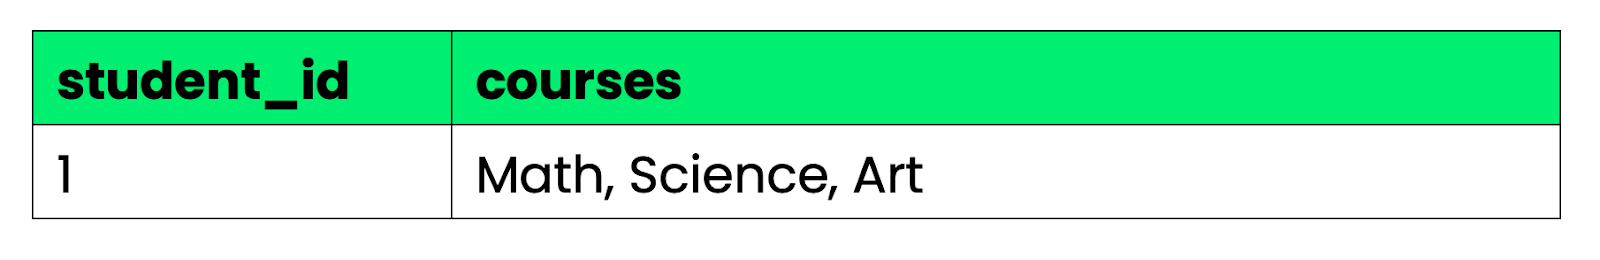
Görsel 1 - 1NF kötü örnek
İyi örnek:
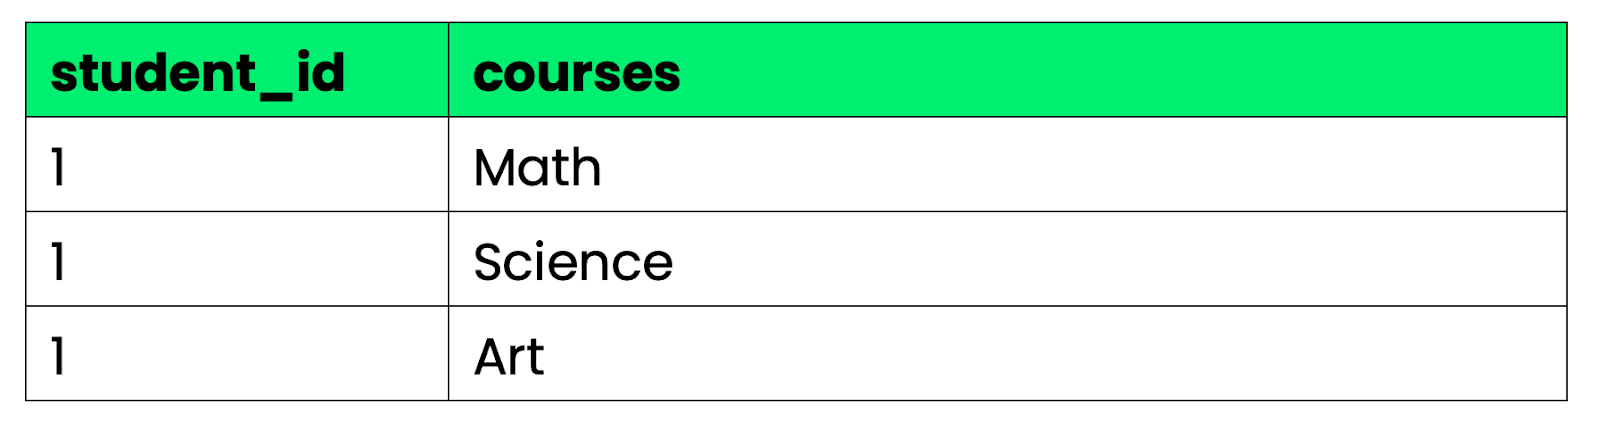
Görsel 2 - 1NF iyi örnek
İkinci Normal Form (2NF): 1NF şarttır ve kısmi bağımlılıkları kaldırır—anahtar olmayan sütunlar birincil anahtarın tamamına, sadece bir kısmına değil, bağımlı olmalıdır.
Bu, bileşik birincil anahtar olduğunda geçerlidir. Bir tabloda birincil anahtar (student_id, course_id) ise, student_name bu tabloda olmamalıdır; çünkü yalnızca student_id’ye bağımlıdır, her iki anahtara değil.
Üçüncü Normal Form (3NF): 2NF olmalı ve geçişli bağımlılıkları kaldırmalıdır. Anahtar olmayan sütunlar diğer anahtar olmayan sütunlara bağımlı olmamalıdır.
Kötü örnek:
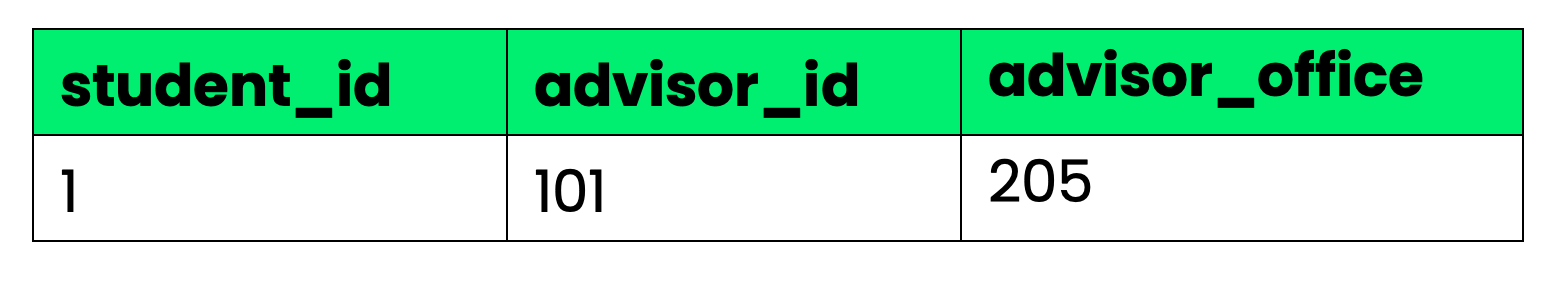
Görsel 3 - 3NF kötü örnek
Burada, advisor_office doğrudan student_id’ye değil, advisor_id’ye bağımlıdır. Bunu ayrı tablolara bölün.
Normalleştirme olmadan, her siparişle birlikte müşteri bilgisini depolarsınız; bu hem alan israfına yol açar hem de müşteri detayları değiştiğinde güncelleme sorunları yaratır.
DELETE, DROP ve TRUNCATE arasındaki farkı açıklayın
Bu komutlar verileri farklı şekillerde kaldırır:
- DELETE belirli satırları kaldırır ve geri alınabilir:
DELETE FROM employees WHERE department_id = 5;
- TRUNCATE tüm satırları kaldırır ancak tablo yapısını korur (DELETE’ten daha hızlıdır):
TRUNCATE TABLE employees;
- DROP tüm tabloyu ve yapısını kaldırır:
DROP TABLE employees;
INNER JOIN ile OUTER JOIN arasındaki fark nedir?
INNER JOIN yalnızca her iki tablodaki eşleşen kayıtları döndürür:
SELECT e.name, d.department_name
FROM employees e
INNER JOIN departments d ON e.department_id = d.id;
OUTER JOIN eşleşmeyen kayıtları da dahil eder:
- LEFT JOIN: Sol tablodaki tüm kayıtlar, sağdan eşleşenler
- RIGHT JOIN: Sağ tablodaki tüm kayıtlar, soldan eşleşenler
- FULL OUTER JOIN: Her iki tablodaki tüm kayıtlar
>SQL join’leri başlı başına karmaşık bir konudur – Sadece join’lere dair 20 mülakat sorusu burada
Dizin (index) nedir ve performansı nasıl artırır?
Bir dizin, tablo satırlarına kısayollar oluşturarak veri erişimini hızlandıran bir veri yapısıdır.
Bir kitabın dizini gibi düşünün – bir konuyu bulmak için her sayfayı okumak yerine, dizinden bakıp doğrudan doğru sayfaya gidersiniz. Dizinler SELECT sorgularını hızlandırır; ancak dizinin güncellenmesi gerektiği için INSERT, UPDATE ve DELETE işlemlerini yavaşlatabilir.
CREATE INDEX idx_employee_email ON employees(email);
Veritabanlarında görünüm (view) kavramını açıklayın
Bir görünüm, veriyi kendisi depolamayan, bir SQL sorgusundan oluşturulan sanal bir tablodur.
Görünümler karmaşık sorguları basitleştirir, hassas sütunları gizleyerek güvenlik sağlar ve veriyi farklı formatlarda sunar. Bir görünümü sorguladığınızda, veritabanı altta yatan SQL’i çalıştırır ve sanki gerçek bir tabloymuş gibi sonuçları döndürür.
CREATE VIEW active_employees AS
SELECT employee_id, name, email
FROM employees
WHERE status = 'active';
SELECT * FROM active_employees;
Saklı yordamlar (stored procedures) nedir ve avantajları nelerdir?
Saklı yordamlar, veritabanında saklanan ve adıyla çalıştırılabilen önceden derlenmiş SQL kodlarıdır.
Önceden derlendikleri için performansı artırırlar, bir çağrıda birden fazla deyim çalıştırarak ağ trafiğini azaltırlar ve parametreli sorgularla daha iyi güvenlik sağlarlar. Ayrıca iş mantığını veritabanında merkezileştirirler.
CREATE PROCEDURE GetEmployeesByDepartment(IN dept_id INT)
BEGIN
SELECT * FROM employees WHERE department_id = dept_id;
END;
>Prosedürel SQL, göreve bağlı olarak büyük bir mülakat konusu olabilir. Bu 20 mülakat sorusu Oracle PL/SQL’e odaklanıyor
Bunları geride bıraktığımıza göre, bilginizi ölçecek orta seviye sorulara dalalım.
Orta Seviye DBMS Mülakat Soruları
Bu sorular, DBMS araçları ve kavramlarındaki teknik yetkinliğinizi ölçer.
Görüşmeciler, orta seviye sorularla veritabanı bilginizi gerçek sorunları çözmek için uygulayıp uygulayamadığınızı görmek ister. Sorgu optimizasyonunda uygulamalı deneyim ve veritabanlarının perde arkasında nasıl çalıştığını anlama beklerler.
Farklı dizin türlerini ve her birinin ne zaman kullanılacağını açıklayın
- Kümelenmiş (clustered) dizinler tablo verisini anahtar değerlere göre fiziksel olarak yeniden sıralar – veri yalnızca bir şekilde sıralanabileceğinden tablo başına yalnızca bir tane olabilir.
- Kümelenmemiş (non-clustered) dizinler fiziksel sıralamayı değiştirmeden tablo satırlarına işaret eden ayrı bir yapı oluşturur. Bir tabloda birden çok kümelenmemiş dizin olabilir.
- Bileşik (composite) dizinler birden çok sütunu kapsar ve sorgular bu sütunlarda birlikte filtreleme yaptığında en iyi sonucu verir.
- Benzersiz (unique) dizinler hem benzersizliği zorunlu kılar hem de hızlı aramalar sağlar.
- Kısmi (partial) dizinler yalnızca belirli koşulları sağlayan satırları indeksleyerek yer tasarrufu sağlar.
Kümelenmiş ve kümelenmemiş dizin arasındaki fark nedir?
- Kümelenmiş dizinler tablodaki verinin fiziksel saklama sırasını belirler – soyadına göre sıralı bir telefon rehberi gibi düşünün.
- Kümelenmemiş dizinler bir ders kitabının arka dizini gibidir – kitabın sayfa sırasını değiştirmeden verinin bulunduğu yere işaret eder.
Kümelenmiş ve kümelenmemiş dizinlerin nasıl oluşturulacağı:
-- Birincil anahtar varsayılan olarak kümelenmiş dizin oluşturur
CREATE TABLE employees (
id INT PRIMARY KEY CLUSTERED,
name VARCHAR(100),
email VARCHAR(100)
);
-- E-posta aramalarını hızlandırmak için ayrı dizin
CREATE NONCLUSTERED INDEX idx_email ON employees(email);
Bir tabloda yalnızca bir kümelenmiş dizin, ancak birçok kümelenmemiş dizin bulunabilir. Kümelenmiş dizinler aralık sorgularında daha hızlıdır; kümelenmemiş dizinler ise farklı sütunlarda kesin eşleşmeler için daha iyidir.
Yavaş bir sorguyu nasıl optimize edersiniz?
Önce darboğazın nerede olduğunu görmek için yürütme planını analiz edin.
EXPLAIN SELECT * FROM orders o
JOIN customers c ON o.customer_id = c.id
WHERE o.order_date > '2025-07-01';
Yaygın optimizasyon teknikleri:
- WHERE, JOIN ve ORDER BY klozlarında kullanılan sütunlara dizin ekleyin
- Sonuç kümelerini daraltın – join’den önce WHERE ile filtreleyin
- Kapsayıcı dizinler (covering indexes) kullanın – sorgunun ihtiyaç duyduğu tüm sütunları içersin
- Alt sorguları mümkünse JOIN olarak yeniden yazın
- SELECT *’tan kaçının – yalnızca ihtiyacınız olan sütunları getirin
Yürütme planında tablo taramalarını (table scan) kontrol edin – genellikle en büyük performans katilleridir.
Veritabanı işlemleri ve yalıtım seviyeleri nedir?
Veritabanı işlemleri birden çok işlemi, bütünüyle başarılı olan veya bütünüyle başarısız olan tek bir birim halinde gruplar.
Yalıtım seviyeleri eşzamanlı işlemlerin birbirlerinin değişikliklerini nasıl gördüğünü kontrol eder:
- READ UNCOMMITTED: Onaylanmamış değişiklikler okunabilir (kirli okuma mümkün)
- READ COMMITTED: Yalnızca onaylanmış veriler okunur (çoğu veritabanında varsayılan)
- REPEATABLE READ: Aynı işlem içinde aynı sorgu aynı sonuçları döndürür
- SERIALIZABLE: En güçlü yalıtım, işlemler sanki sıralıymış gibi yürür
Daha yüksek yalıtım seviyeleri daha fazla sorunu önler, ancak eşzamanlılığı ve performansı düşürür.
Veritabanı bölümleme (partitioning) kavramını açıklayın
Veritabanı bölümleme, büyük tabloları, mantıksal olarak tek bir tablo olarak kalacak şekilde daha küçük ve yönetilebilir parçalara böler. Bilmeniz gereken dört yaklaşım vardır.
- Yatay bölümleme satırları tarih aralıkları gibi ölçütlere göre böler:
-- Yıla göre bölümlenmiş Orders tablosu
CREATE TABLE orders_2023 (...);
CREATE TABLE orders_2024 (...);
CREATE TABLE orders_2025 (...);
- Dikey bölümleme sütunları böler – sık erişilen sütunlar bir bölümde, nadiren kullanılanlar başka bir bölümde.
- Karma (hash) bölümleme satırları bir karma fonksiyonuna göre dağıtır.
- Aralık (range) bölümleme tarih veya ID gibi değer aralıklarını kullanır.
Faydaları: daha hızlı sorgular (yalnızca ilgili bölümler sorgulanır), daha kolay bakım ve daha iyi paralelleştirme.
UNION ile UNION ALL arasındaki fark nedir?
UNION birden fazla sorgunun sonuçlarını birleştirir ve yinelenenleri kaldırır; UNION ALL ise sonuçları birleştirir ancak yinelenenler dahil tüm satırları korur.
-- UNION yinelenenleri kaldırır (daha yavaş)
SELECT name FROM employees WHERE department = 'IT'
UNION
SELECT name FROM employees WHERE salary > 50000;
-- UNION ALL yinelenenleri korur (daha hızlı)
SELECT name FROM employees WHERE department = 'IT'
UNION ALL
SELECT name FROM employees WHERE salary > 50000;
Şu durumlarda UNION ALL kullanın: yinelenen olmayacağını biliyorsanız veya yinelenenler önemli değilse – yinelenenleri kaldırma adımını atladığı için çok daha hızlıdır.
Veritabanında kilitlenmeleri (deadlock) nasıl ele alırsınız?
Deadlock, iki işlemin birbirlerinin kaynakları serbest bırakmasını beklemesiyle oluşur ve dairesel bir bağımlılık yaratır.
Çoğu veritabanı kilitlenmeleri otomatik olarak tespit eder ve bir işlemi ("deadlock kurbanı") sonlandırır; diğer işlemin devam etmesine izin verir. Sonlandırılan işlem geri alınır ve hata döner.
-- İşlem 1
BEGIN;
UPDATE accounts SET balance = balance - 100 WHERE id = 1;
-- hesap 2 üzerindeki kilidi bekler
-- İşlem 2
BEGIN;
UPDATE accounts SET balance = balance + 50 WHERE id = 2;
-- hesap 1'i güncellemeye çalışır -> DEADLOCK
Deadlock’ları önleme stratejileri:
- İşlemler genelinde tablolara aynı sırayla erişin
- İşlemleri kısa tutun
- Uygun yalıtım seviyeleri kullanın
- Uygulamanızda yeniden deneme (retry) mantığı uygulayın
Veritabanı kısıtlarının amacı nedir?
Veritabanı kısıtları, iş kurallarını uygular ve veri bütünlüğünü veritabanı seviyesinde korur. Her veritabanı profesyonelinin bilmesi gereken beş kısıt türü şunlardır:
- Birincil anahtar: Benzersiz tanımlama sağlar
- Yabancı anahtar: İlişkisel bütünlüğü korur
- Check: Verinin belirli koşulları sağlamasını doğrular
- Not null: Boş değerleri engeller
- Unique: Çift kayıtları önler
Uygulamadaki karşılığı şöyle:
CREATE TABLE employees (
id INT PRIMARY KEY,
email VARCHAR(100) UNIQUE NOT NULL,
age INT CHECK (age >= 18 AND age <= 65),
department_id INT,
FOREIGN KEY (department_id) REFERENCES departments(id)
);
Kısıtlar, hatalı verinin veritabanınıza girmesini engeller ve hataları uygulamanıza yayılmadan erken yakalar.
Veritabanı çoğaltma (replication) ve türlerini açıklayın
Veritabanı çoğaltma, kullanılabilirliği, performansı ve felaket kurtarmayı iyileştirmek için veriyi bir veritabanından diğerlerine kopyalar.
Bilmeniz gereken dört çoğaltma türü vardır:
- Master-slave çoğaltma: Yazmaları tek bir master yapar, okumaları birden çok slave yürütür. Değişiklikler master’dan slave’lere akar.
- Master-master çoğaltma: Birden çok master hem yazma hem okuma yapabilir. Daha karmaşıktır ancak tek hata noktasını ortadan kaldırır.
- Eşzamanlı (synchronous) çoğaltma: Onaylamadan önce replikalardan teyit bekler (daha yavaş ama daha tutarlı).
- Eşzamanlı olmayan (asynchronous) çoğaltma: Hemen onaylar, sonra çoğaltır (daha hızlıdır ancak veri kaybı riski taşır).
Veritabanı tetikleyicileri (triggers) nedir ve ne zaman kullanılmalıdır?
Veritabanı tetikleyicileri, INSERT, UPDATE veya DELETE gibi veritabanı olaylarına yanıt olarak otomatik çalışan özel yordamlar (prosedürler)dir.
Basit bir örnek:
CREATE TRIGGER update_modified_date
BEFORE UPDATE ON employees
FOR EACH ROW
BEGIN
SET NEW.modified_at = NOW();
END;
Tetikleyiciler; zaman damgalarını otomatik güncellemek, denetim izleri için değişiklikleri kaydetmek, karmaşık iş kurallarını uygulamak veya hesaplanan alanları korumak için kullanışlıdır.
Ancak hata ayıklamayı zorlaştırabilir, işlemleri yavaşlatabilir ve gizli bağımlılıklar yaratabilirler. Ölçülü kullanın ve iyi belgelendirin.
Şimdi ileri seviye DBMS mülakat sorularına geçelim.
İleri Seviye DBMS Mülakat Soruları
Bu sorular, DBMS mimarisi ve karmaşık veritabanı işlemleri konusundaki derin bilginizi test eder.
Görüşmeciler, ileri seviye sorularla ölçekli veritabanı sistemlerini tasarlayıp sorun giderebilmenizi görmek ister. Farklı yaklaşımlar arasındaki ödünleşimleri anlayıp veritabanı mimarisine dair bilinçli kararlar verebilmenizi beklerler.
Veritabanı sharding’ini ve getirdiği ödünleşimleri açıklayın
Sharding, büyük bir veritabanını yatay olarak birden çok sunucuya böler; her shard verinin yalnızca bir alt kümesini içerir.
Veriyi kullanıcı ID’si, coğrafi konum veya tarih aralığı gibi bir shard anahtarına göre bölümlersiniz. Her shard bağımsız çalışır; bu da tek bir sunucunun kapasitesini aşacak şekilde ölçeklemenizi sağlar.
-- Örnek: Kullanıcıları ID aralıklarına göre shard etme
-- Shard 1: user_id 1-1000000
-- Shard 2: user_id 1000001-2000000
-- Shard 3: user_id 2000001-3000000
Faydalar: yatay ölçekleme, daha iyi performans ve hata yalıtımı (bir shard’ın çökmesi her şeyi durdurmaz).
Ödünleşimler: karmaşık uygulama mantığı, shard’lar arası işlem olmaması, yeniden dengeleme zorluğu ve shard’lar genelinde bazı ACID garantilerinin yitirilmesi. Birden çok shard’ı kapsayan sorgular pahalı hale gelir.
CAP teoremi nedir ve veritabanı tasarımını nasıl etkiler?
CAP teoremi, dağıtık sistemlerin üç özelliğin yalnızca ikisini aynı anda garanti edebileceğini söyler: Tutarlılık, kullanılabilirlik ve bölüm (partition) toleransı:
- Tutarlılık (Consistency): Tüm düğümler aynı anda aynı veriyi görür
- Kullanılabilirlik (Availability): Düğümler arızalansa da sistem çalışır durumda kalır
- Bölüm toleransı (Partition tolerance): Düğümler arası ağ hatalarına rağmen sistem çalışmaya devam eder
Yalnızca üçte ikisi garanti edilebildiği için en yaygın kombinasyonlar şunlardır:
- CA sistemler (geleneksel RDBMS gibi) bölüm toleransından feragat eder – ağ bölünmelerini iyi yönetemezler
- CP sistemler (bazı konfigürasyonlarda MongoDB gibi) kullanılabilirlikten feragat eder – tutarlılığı korumak için istekleri reddedebilirler
- AP sistemler (Cassandra gibi) tutarlılıktan feragat eder – kullanılabilir kalırlar, ancak veriler geçici olarak düğümler arasında tutarsız olabilir
Çoğu modern dağıtık veritabanı nihai tutarlılık yaklaşımını benimser – kullanılabilirlik ve bölüm toleransını önceliklendirir, tutarlılık ise zamanla sağlanır.
Yüksek eşzamanlılık için bir veritabanı şemasını nasıl tasarlarsınız?
Eşzamanlı işlemler arasındaki çakışmaları azaltan tablolar tasarlayarak kilit rekabetini (lock contention) düşürmekle başlayın.
Kötümser kilitler yerine sürüm sütunlarıyla iyimser kilitleme kullanın:
-- İyimser kilitleme için sürüm sütunu ekleyin
CREATE TABLE products (
id INT PRIMARY KEY,
name VARCHAR(100),
price DECIMAL(10,2),
inventory_count INT,
version INT DEFAULT 1
);
-- Sürüm kontrolü ile güncelleme
UPDATE products
SET inventory_count = inventory_count - 1, version = version + 1
WHERE id = 123 AND version = 5;
Yüksek eşzamanlılık için diğer ipuçları:
- Sıcak (hot) tabloları zamana veya diğer mantıksal sınırlara göre bölümleyin
- Farklı erişim modelleri için ayrı tablolar kullanın – karma kullanım içeren geniş tablolardan kaçının
- Geniş dizinlerden kaçının; rekabet yaratırlar
- Mümkünse çoğunlukla ekleme (append-mostly) iş yüklerine göre tasarlayın – eklemeler, güncellemelerden daha az rekabete yol açar
MVCC (Çok Sürümlü Eşzamanlılık Denetimi) nedir?
MVCC, her satırın birden çok sürümünü tutarak aynı veriye aynı anda birden çok işlemin kilitleme olmadan erişebilmesini sağlar.
Bir işlem başlattığınızda, o andaki veritabanının bir anlık görüntüsünü (snapshot) alırsınız. Diğer işlemler veriyi değiştirebilir; ancak sizin işleminiz, başladığınız andaki sürümü görür.
-- İşlem A, T1 anında başlar
BEGIN; -- Tüm verinin 1. sürümünü görür
-- İşlem B, T2 anında veriyi değiştirir
UPDATE accounts SET balance = 1000 WHERE id = 1; -- 2. sürümü oluşturur
-- İşlem A hâlâ 1. sürümü görür
SELECT balance FROM accounts WHERE id = 1; -- Eski değeri döndürür
COMMIT; -- İşlem A anlık görüntüsüyle commit eder
Faydalar: okuyucular yazarları engellemez, yazarlar okuyucuları engellemez ve işlemler içinde tutarlı okumalar sağlanır.
Dezavantajlar: birden çok sürüm için depolama yükü ve eski sürümlerin temizlenmesi süreçleri.
Maddileştirilmiş görünümler (materialized views) nedir ve ne zaman kullanılır?
Maddileştirilmiş görünümler, normal görünümlerden farklı olarak bir sorgunun sonucunu diskte fiziksel olarak depolar.
Gerçek zamanlı veriye ihtiyaç duyulmayan pahalı toplulaştırmalar için idealdir:
-- Aylık satış özetleri için maddileştirilmiş görünüm oluşturma
CREATE MATERIALIZED VIEW monthly_sales AS
SELECT
DATE_TRUNC('month', order_date) as month,
SUM(total_amount) as total_sales,
COUNT(*) as order_count
FROM orders
GROUP BY DATE_TRUNC('month', order_date);
-- Gerekince yenileyin
REFRESH MATERIALIZED VIEW monthly_sales;
Gösterge paneli sorguları, raporlama ve stabil veri üzerinde tekrarlanan karmaşık analizler için harikadır.
Ödünleşimler: ekstra depolama alanı, bakım yükü ve yenilemeler arasında veri eskimesi. Sorgu performansı için hafif gecikmeyi tolere edebildiğiniz durumlarda en iyi sonucu verirler.
Belleğe sığmayan çok büyük veri kümeleriyle nasıl başa çıkarsınız?
Veritabanınızın depolamadan veriye nasıl eriştiğini anlayarak disk tabanlı işlemlere göre tasarlayın.
Bölümleme kullanın – sorguların yalnızca ilgili veri segmentlerine dokunduğundan emin olun:
-- İlgisiz bölümleri atlayabilmek için tarihe göre bölümleyin
CREATE TABLE sales_data (
sale_date DATE,
amount DECIMAL(10,2),
customer_id INT
) PARTITION BY RANGE (sale_date);
Bellekten büyük veri kümeleriyle başa çıkmak için diğer ipuçları:
- Dizinleri aralık taramalarına uygun optimize edin, rastgele erişime değil
- Sütun bazlı depolama kullanın – belirli sütunları topladığınız analitik iş yüklerinde
- Sorgu sonucu önbellekleme ve sayfalamayı kullanıcıya dönük sorgular için uygulayın
- Okuma replikaları kullanarak sorgu yükünü birden çok makineye dağıtın
- Arşivlemeyi değerlendirin – eski veriyi daha ucuz depolamaya taşıyın, ana veritabanında yalnızca güncel veriyi tutun
Kötümser ve iyimser kilitleme arasındaki farkı açıklayın
Kötümser kilitleme, çakışmaların olacağını varsayar ve bunları önlemek için kaynakları hemen kilitler; iyimser kilitleme ise çakışmaların nadir olduğunu varsayar ve yalnızca değişiklikleri onaylarken çakışma kontrolü yapar.
-- Kötümser: Satırı hemen kilitle
BEGIN;
SELECT * FROM accounts WHERE id = 1 FOR UPDATE; -- Satırı kilitler
UPDATE accounts SET balance = balance - 100 WHERE id = 1;
COMMIT;
-- İyimser: Güncellemeden önce sürümü kontrol et
SELECT id, balance, version FROM accounts WHERE id = 1;
-- Uygulama mantığı burada
UPDATE accounts
SET balance = balance - 100, version = version + 1
WHERE id = 1 AND version = 3; -- Başkası güncellediyse başarısız olur
- Kötümser yaklaşım, çakışmaların yaygın olduğu yüksek rekabetli senaryolarda daha iyi çalışır.
- İyimser yaklaşım, çakışmaların nadir olduğu okuma ağırlıklı iş yüklerinde daha uygundur.
Denormalizasyon nedir ve ne zaman uygundur?
Denormalizasyon, sorgu performansını artırmak için normalleştirilmiş tablolara bilerek fazlalık eklemektir.
Pahalı join’lerden kaçınmak için veriyi tablolar arasında çoğaltırsınız:
-- Normalleştirilmiş: sipariş detayları için join gerekir
SELECT o.id, c.name, c.email
FROM orders o
JOIN customers c ON o.customer_id = c.id;
-- Denormalize: Müşteri bilgisi orders tablosunda saklı
SELECT id, customer_name, customer_email
FROM orders_denormalized;
Ne zaman denormalize etmeli:
- Okuma performansı yazma performansından daha önemliyse
- Join’lerden kaçınmanın fayda sağladığı öngörülebilir sorgu kalıpları varsa
- Depolama maliyeti, hesaplama süresinden daha düşükse
- Denormalize veriyi senkron tutmanın karmaşıklığını yönetebiliyorsanız
Riskler: veri tutarsızlığı, artan depolama maliyeti ve daha karmaşık güncelleme mantığı.
Felaket kurtarma ve yüksek kullanılabilirlik için nasıl tasarım yaparsınız?
Her seviyede yedekliğe göre tasarlayarak başlayın – birden çok veritabanı sunucusu, ağ yolu ve veri merkezi.
Otomatik failover ile çoğaltma kurun:
- Birincil: Tüm yazmaları işler
- Replika 1: Aynı bölgede okuma sorgularını karşılar
- Replika 2: Farklı bir bölgede okuma sorgularını karşılar
- Replika 3: Felaket kurtarma için beklemede
Diğer ipuçları:
- Nokta atışı kurtarma yeteneğiyle düzenli yedeklemeler uygulayın
- Failover prosedürlerini düzenli test edin – baskı altında çalışmayan bir felaket kurtarma planı işe yaramaz
- Yük dengeleyiciler kullanarak trafiği arızalı sunuculardan uzaklaştırın
- Her şeyi izleyin – sorunları kullanıcılarınızdan önce bilmeniz gerekir
- Farklı arıza senaryoları için plan yapın – tek sunucu arızası, veri merkezi kesintisi, bölgesel felaketler ve veri bozulması
Veritabanı bağlantı havuzu (connection pooling) nedir ve neden önemlidir?
Bağlantı havuzu, her istek için yeni bağlantı oluşturmaktansa, uygulamaların yeniden kullanabileceği bir veritabanı bağlantıları önbelleği tutar.
Veritabanı bağlantısı oluşturmak pahalıdır – ağ el sıkışmaları, kimlik doğrulama ve kaynak ayırma içerir. Bağlantı havuzları bu ek yükü ortadan kaldırır.
İşte bir Python örneği:
# Havuz olmadan: Her seferinde yeni bağlantı oluşturur
def get_user(user_id):
conn = create_connection() # Pahalı!
result = conn.execute("SELECT * FROM users WHERE id = ?", user_id)
conn.close()
return result
# Havuz ile: Mevcut bağlantıları yeniden kullanır
pool = ConnectionPool(max_connections=20)
def get_user(user_id):
conn = pool.get_connection() # Hızlı!
result = conn.execute("SELECT * FROM users WHERE id = ?", user_id)
pool.return_connection(conn)
return result
Faydaları: daha hızlı yanıt süreleri, azalan veritabanı yükü, kontrollü kaynak kullanımı ve trafik sıçramalarını daha iyi karşılama.
Havuz boyutunu eşzamanlı kullanıcı sayısı ve veritabanı kapasitesine göre ayarlamalısınız—çok küçük olursa beklemeye yol açar, çok büyük olursa kaynak israfı olur.
Davranışsal ve Senaryoya Dayalı DBMS Soruları
Bu sorular, sorun çözme becerilerinizi ve müşteriler ile veri ekipleriyle çalışma deneyiminizi değerlendirir.
Görüşmeciler, davranışsal ve senaryoya dayalı sorularla gerçek dünya veritabanı zorluklarını nasıl ele aldığınızı görmek ister. Düşünce sürecinizi, iletişim becerilerinizi ve veritabanı sorunları ortaya çıktığında teknik olmayan kişilerle çalışma yeteneğinizi anlamak isterler.
Yavaş bir sorguyu optimize etmek zorunda kaldığınız bir zamandan bahsedin. Yaklaşımınız neydi?
Cevabınızı net bir problem çözme süreci gösterecek şekilde yapılandırın.
Sorunu ve etkisini anlatarak başlayın: "Müşteri panomuz, ana sorgu bir milyon satırlık tabloda tam tarama yaptığı için yüklenmesi 45 saniye sürüyordu. Bu durum kullanıcıları rahatsız ediyor ve sayfayı terk etmelerine neden oluyordu."
Tanılama yaklaşımınızı anlatın: "Sorgu yürütme planını analiz ettim ve WHERE klozunda kullanılan sütunlarda dizin eksikliği olduğunu gördüm. Ayrıca ORDER BY klozunun da optimize edilmediğini fark ettim."
Çözümünüzü ve sonuçları açıklayın: "Filtre ve sıralama sütunlarını kapsayan bir bileşik dizin oluşturdum. Staging ortamında test ettikten sonra düşük trafik saatlerinde canlıya aldım. Sorgu süresi 45 saniyeden 2 saniyenin altına düştü ve pano performans sorunu çözüldü."
Yanıtınızda ölçüm, test ve sayısal sonuçlara vurgu yapın.
Teknik olmayan bir paydaşa karmaşık bir veritabanı kavramını açıklamak zorunda kaldığınız bir durumu anlatın
Teknik kavramları iş paydaşları için nasıl anlaşılır kıldığınıza odaklanın.
Teknik boşluğu başarıyla kapattığınız spesifik bir örnek seçin. Şöyle diyebilirsiniz: "Pazarlama ekibi, müşteri segmentasyon raporunun 20 dakika sürmesinden rahatsızdı. Veritabanı join’leri ve dizinlerini anlatmak yerine basit bir benzetme kullandım."
İletişim yaklaşımınızı anlatın: "A ve B ürünlerini satın alan müşterileri aramayı hayal etmelerini istedim. Mevcut sistem, dev bir dosya dolabındaki her fişi tek tek aramak gibiydi. Optimizasyondan sonra, ürün türüne göre düzenlenmiş klasörlere sahip olmak gibi, arama çok daha hızlı olacaktı."
İş etkisini gösterin: "Onlar için önemli olana odaklandım – rapor 20 dakika yerine 2 dakikada çalışacak, böylece daha hızlı içgörü elde edip pazardaki değişimlere daha çabuk yanıt verebileceklerdi."
Teknik çalışmaları, teknik olmayan paydaşları ayrıntılarla boğmadan iş değerine çevirebildiğinizi gösterin.
Veritabanı iş saatlerinin en yoğun olduğu sırada çökerse nasıl hareket edersiniz?
Yapılandırılmış bir yanıtla kriz yönetimi becerilerinizi gösterin:
- Anında durum değerlendirmesi: "Önce kapsamı belirlerim – tam bir kesinti mi, yoksa bazı servisler çalışıyor mu? Kritik salt-okunur işlemler için okuma replikalarına erişilip erişilemediğine bakarım."
- Paydaş iletişimi: "Olay müdahale ekibini derhal bilgilendiririm ve etkilenen iş birimlerine, henüz çözüm olmasa bile, güncellemeler için tahmini zaman içeren kısa bir durum notu gönderirim."
- Tanılama süreci: "Sistem günlüklerini, disk alanını, bellek kullanımını, ağ bağlantısını ve veritabanı hata günlüklerini kontrol ederim. Donanım arızasıysa, bekleyen sunucuya failover başlatırım."
- Düzenli güncellemeler: "Her 15-30 dakikada bir durum güncellemesi gönderirim; ilerleme olmasa bile. İletişim, sorunu çözmek kadar önemlidir."
- Olay sonrası inceleme: "Çözümden sonra, ne olduğuna, neden olduğuna ve gelecekte nasıl önleneceğine dair dokümantasyon hazırlarım."
Esas olan, baskı altında sakin kalıp net iletişimi sürdürdüğünüzü göstermek.
Yeni bir e-ticaret uygulaması için veritabanı şemasını nasıl tasarlayacağınızı anlatın
Yaklaşımınızı adım adım anlatın:
- Gereksinim toplama: "İşe, iş ihtiyaçlarını anlayarak başlarım – hangi ürünler satılıyor, müşteriler nasıl alışveriş yapıyor, hangi raporlar gerekiyor ve beklenen trafik hacmi nedir?"
- Varlık (entity) belirleme: "Kullanıcılar, Ürünler, Siparişler, SiparişKalemleri, Kategoriler ve Ödemeler gibi çekirdek varlıkları belirlerim. Her varlık, izlenmesi gereken temel bir iş kavramını temsil eder."
- İlişki tasarımı: "Bu varlıkların birbirleriyle nasıl ilişkili olduğunu haritalarım. Örneğin, Kullanıcıların birçok Siparişi vardır; Siparişler, SiparişKalemleri aracılığıyla birçok Ürün içerir ve Ürünler Kategorilere aittir."
- Performans planlama: "Giriş için kullanıcı e-postası, arama için ürün SKU’su ve raporlama için sipariş tarihleri gibi sık sorgulanacak sütunlara dizinler eklerim. Ayrıca Siparişler gibi büyük tabloları tarihe göre bölümlemeyi düşünürüm."
- Geleceğe hazırlık: "Şemayı, büyük yeniden yapılandırmalar gerektirmeden ürün yorumları, promosyonlar ve stok takibi gibi muhtemel gelecekteki özellikleri barındıracak şekilde tasarlarım."
Başından itibaren hem anlık ihtiyaçları hem de uzun vadeli ölçeklenebilirliği düşündüğünüzü gösterin.
Bir veritabanı sisteminden diğerine veri taşımak zorunda kaldığınız bir zamandan bahsedin. Hangi zorluklarla karşılaştınız?
Planlama, yürütme ve sorun çözmeye odaklanın.
Bağlam sağlayarak başlayın: "Analitik iş yükümüz için daha iyi JSON desteği ve gelişmiş indeksleme özelliklerinden yararlanmak amacıyla MySQL’den PostgreSQL’e geçtik."
Sorunları ve zorlukları listeleyin: "En büyük zorluk veri tipi farklılıklarıydı – MySQL’in zaman damgası davranışı PostgreSQL’den farklıydı. Ayrıca yeniden yazılması gereken saklı yordamlarımız vardı."
Çözümünüzü tartışın: "Geri alma prosedürlerini içeren ayrıntılı bir geçiş planı oluşturdum. Geçişi aşamalı yaptık: önce tabloların bir alt kümesi, sonra veri tutarlılığını koruyarak kademeli geçiş."
Test ve doğrulama sonuçlarıyla bitirin: "İki hafta boyunca paralel sistemler çalıştırdık; eski ve yeni veritabanlarının sonuçlarını karşılaştırarak veri bütünlüğünü doğruladık. Tam geçişten önce yeni sistemi yük testlerine tabi tuttuk."
Veritabanı tasarım kararları konusunda ekip arkadaşlarınızla yaşadığınız anlaşmazlıkları nasıl ele alırsınız?
İş birliği ve çatışma çözme becerilerinizi gösterin:
- Dinleyin ve anlayın: "Her zaman önce karşı tarafın bakış açısını anlamaya çalışırım. Çoğu anlaşmazlık, farklı önceliklerden kaynaklanır – onlar geliştirici kolaylığını, ben performansı önceliklendirebilirim."
- Veriye dayalı argümanlar sunun: "Önerilerimi somut örneklerle desteklerim. Dizin gerektiğini düşünüyorsam yürütme planlarını ve performans kıyaslarını gösteririm."
- Ortak zemin bulun: "Genellikle hedefte hemfikiriz – hızlı ve güvenilir uygulamalar. Anlaşmazlık, oraya nasıl ulaşılacağıyla ilgilidir."
Örnek: "Bir geliştirici, kullanıcı profilleri için NoSQL yaklaşımı kullanmak istedi; ben ise ilişkisel tasarım önerdim. Ödünleşimleri tartıştık, her iki yaklaşımın prototiplerini çalıştırdık ve tutarlılık gereksinimlerimize ve ekibin uzmanlığına en uygun çözümü seçtik."
Sıkı bir teslim tarihine sahip bir veritabanı projesinde çalıştığınız bir zamandan bahsedin
Önceliklendirme ve baskı altında teslim yeteneğinizi gösterin.
Durumu özetleyin: "Yönetim kurulu toplantısı için üç gün içinde hazır olması gereken kritik bir müşteri raporu vardı; ancak sorgu bir saatten fazla sürüyordu."
Görevleri nasıl önceliklendirdiğinizi belirtin: "En büyük performans kazanımlarına odaklandım. Her şeyi optimize etmek yerine, yürütme planındaki en pahalı iki işlemi belirledim."
Hızlı kazanımları söyleyin: "Ana sorgu için kapsayıcı bir dizin ekledim ve en büyük tabloyu tarihe göre bölümledim. Çalışma süresi 60 dakikadan 8 dakikaya indi."
İletişim ve sonuçla bitirin: "Ürün yöneticisini birkaç saatte bir güncelledim; gerekirse kurul beklentilerini yönetebilsin diye. Optimize edilmiş raporu iki gün erken teslim ettik ve benzer raporlar için şablon oldu."
Yalnızca zaman zaman ortaya çıkan bir veritabanı performans sorununu nasıl giderirsiniz?
Aralıklı sorunlar için sistematik hata ayıklama yaklaşımınızı gösterin:
- İzleme kurun: "Sorun oluştuğunda performans metriklerini yakalamak için izleme kurarım – sorgu yürütme süreleri, sistem kaynakları, eşzamanlı bağlantılar."
- Veri toplayın: "Performans düştüğünde hangi sorguların çalıştığını görmek için sorgu günlüğünü etkinleştiririm. Ayrıca kalıpları kontrol ederim – belirli zamanlarda mı oluyor, belirli kullanıcılarla mı, yoksa belirli işlemler sırasında mı?"
- Varsayımlar oluşturun: "Verilere dayanarak varsayımlar geliştiririm. Belki her saat çalışan bir toplu iş (batch) vardır veya belirli bir rapor tabloları kilitliyordur."
- Yalıtım ve test: "Benzer veri hacimleri ve sorgu kalıplarıyla bir test ortamında sorunu yeniden üretmeye çalışırım."
Örnek: "Salı sabahları ortaya çıkan bir performans sorununu izini sürerek buldum. Meğerse haftalık veri eşitleme işi, en yoğun kullanıcı aktivitesiyle aynı anda çalışıyor ve kilit rekabetine neden oluyormuş."
Normalde veritabanlarıyla çalışmayan birinin veritabanına erişim talebini nasıl karşılarsınız?
Güvenlik farkındalığınızı ve öğretme becerinizi gösterin.
İhtiyaçları değerlendirin: "Önce neyi başarmaya çalıştıklarını anlarım. Çoğu zaman, doğrudan veritabanı erişimi olmadan ihtiyaç duydukları bilgiyi almanın daha iyi bir yolu vardır."
Güvenlik endişelerini gösteren alternatifler sunun: "Veritabanı erişimi yerine salt-okunur bir görünüm oluşturabilir, bir gösterge paneli hazırlayabilir veya ihtiyaç duydukları veriyi CSV olarak dışa aktarabilirim."
Erişim gerekliyse güvenliğin hâlâ öncelik olduğunu açıklayın: "Sadece ihtiyaç duydukları tablolara erişimi olan salt-okunur bir hesap oluştururum. Ayrıca temel SQL en iyi uygulamaları ve performansı etkileyebilecek sorgular hakkında kısa bir eğitim veririm."
Beklentileri belirleyin: "Yoğun saatlerde pahalı sorgular çalıştırmamanın önemini anlatır ve karmaşık bir şey çalıştırmadan önce benimle iletişime geçmelerini isterim."
Canlı (prod) veritabanında veri tutarsızlığı raporlarını nasıl araştırırsınız?
Veri bütünlüğü sorunlarına sistematik yaklaşımınızı gösterin:
- İlk değerlendirme: "Önce tutarsızlığa dair spesifik örnekler toplarım. Hangi veri yanlış, ne zaman fark edildi ve doğrusu ne olmalı?"
- Zaman çizelgesi oluşturma: "Veritabanı ve uygulama günlüklerini ve son dağıtımları kontrol ederek tutarsızlığın ne zaman ortaya çıkmış olabileceğini anlarım."
- Kapsam değerlendirmesi: "Sorunun ne kadar yaygın olduğunu belirlemek için sorgular çalıştırırım. Tüm kayıtları mı etkiliyor yoksa belirli olanları mı? Zaman, kullanıcı eylemleri veya veri kaynaklarına göre kalıplar var mı?"
- Kök neden analizi: "Olası nedenleri araştırırım – uygulama hataları, başarısız işlemler, veri içe aktarma sorunları veya eşzamanlı erişim problemleri."
- Anında sınırlandırma: "Sorun devam ediyorsa, bunu tetikleyen süreci tespit eder ve durdururum. Geçmiş veriler için düzeltmenin mümkün ve güvenli olup olmadığını belirlerim."
Örnek: "Negatif adetli müşteri siparişleri buldum. Uygulama günlüklerini kontrol ederek stok güncelleme sürecinde bir yarış durumu olduğunu keşfettim. Uygulama hatasını düzelttik ve etkilenen siparişleri işlem günlüklerini kullanarak düzelttik."
DBMS Mülakatına Hazırlık İpuçları
Bir DBMS mülakatında başarılı olmanın en iyi yolu, sadece teoriyi ezberlemek değil, gerçek veritabanlarıyla pratik yapmaktır. Görüşmeciler, tanımları tekrarlamanızdan ziyade gerçek sorunları çözebildiğinizi görmek ister.
Gerçek veri kümeleri üzerinde SQL pratiği yapın
Sadece temel SELECT ifadelerini çalışmayın – dağınık, gerçek dünya verisiyle uğraşın.
Kaggle’dan veri kümeleri indirin veya MySQL için Sakila örnek veritabanı gibi açık veritabanlarını kullanın. Birden çok join, alt sorgu ve toplulaştırma içeren karmaşık sorgular çalışın. Amaç, işte gerçekten karşılaşacağınız senaryolara aşina olmaktır.
Şu tür sorgular size kolay gelmeli ve her bir kısmını açıklamakta zorlanmamalısınız:
SELECT
c.customer_id,
c.first_name,
c.last_name,
COUNT(r.rental_id) as total_rentals,
SUM(p.amount) as total_spent
FROM customer c
LEFT JOIN rental r ON c.customer_id = r.customer_id
LEFT JOIN payment p ON r.rental_id = p.rental_id
WHERE r.rental_date >= '2025-07-01'
GROUP BY c.customer_id, c.first_name, c.last_name
HAVING COUNT(r.rental_id) > 10
ORDER BY total_spent DESC;
Kendi veritabanı ortamınızı kurun
Bir veritabanı sistemini yerelde kurun ve gerçekten nasıl çalıştığını öğrenin.
Önde gelen sistemlerden birini seçin – PostgreSQL, MySQL veya SQL Server – ve yerel bir örnek kurun. Tablolar oluşturun, veri ekleyin ve farklı yapılandırmalarla deney yapın. Yürütme planlarını okumayı, dizin oluşturmayı ve performansı izlemeyi öğrenin.
Bu uygulamalı deneyim, yalnızca SQL söz dizimini değil, veritabanı yönetimine dair soruları da yanıtlamanıza yardımcı olacaktır.
>Bir Veritabanı Yöneticisi rolü için mülakata giriyorsanız, şu soraların yanıtlarını bilmelisiniz: en iyi 30 DBA mülakat sorusu
Gerçek performans sorunlarını inceleyin
Yaygın performans darboğazlarını tanımayı ve çözmeyi öğrenin.
EXPLAIN veya EXPLAIN ANALYZE gibi araçları kullanarak sorgularınızın nasıl yürütüldüğünü anlayın:
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 12345
AND order_date > '2023-01-01';
Tablo taramalarını, eksik dizinleri ve verimsiz join’leri tespit etmeyi pratiğe dökün. Büyük veri kümeleri oluşturun ve farklı stratejilerin sorgu performansını nasıl etkilediğini görün.
Yürütme planlarını anlamak, mülakatlarda kıdemli adayları daha gençlerden ayırır.
Veritabanı tasarımı pratiği yapın
Sadece tek tek tabloları değil, tam şema tasarımı egzersizleri üzerinde çalışın.
E-ticaret sitesi, sosyal medya platformu veya envanter sistemi gibi gerçek dünya senaryoları seçin. İlişkiler, kısıtlar ve dizinler dahil olmak üzere tüm veritabanı şemasını tasarlayın. Tasarımın büyümeyi ve değişen gereksinimleri nasıl karşılayacağını düşünün.
Varlık-ilişki diyagramları çizin ve tasarım kararlarınızı açıklamaya hazır olun. Görüşmeciler sıkça "Bu yaklaşımı alternatiflere neden tercih ettiniz?" diye sorar. Hazır bir yanıtınız olsun.
>Bilginizi bir üst seviyeye taşımak için Veritabanı Tasarımı kursuna göz atmanızı öneririm.
Hem SQL hem NoSQL kavramlarını gözden geçirin
Rol ilişkisel veritabanlarına odaklansa bile, NoSQL’in ne zaman mantıklı olduğunu anlayın.
MongoDB gibi doküman depolarının, Redis gibi anahtar-değer depolarının ve Cassandra gibi sütun aileli veritabanlarının temelini bilin. Dağıtık sistemlerde tutarlılık ile kullanılabilirlik arasındaki ödünleşimleri anlayın.
Bu, yalnızca tek bir teknolojinin ötesinde düşünebildiğinizi ve probleme uygun doğru aracı seçebildiğinizi gösterir.
>NOSQL Concepts kursu mükemmel bir başlangıç noktasıdır.
Gerçek veritabanı sorunlarına dair hikâyeler hazırlayın
Çözdüğünüz veritabanı zorluklarına dair somut örnekler düşünün.
Yavaş sorguları optimize ettiğiniz, şema tasarladığınız, veri taşıdığınız veya veritabanı kesintilerini yönettiğiniz zamanlara dair 3-4 hikâye hazırlayın. Yanıtlarınızı STAR yöntemiyle yapılandırın – Durum, Görev, Aksiyon, Sonuç.
Teknik kavramları teknik olmayan dinleyicilere açıklamayı pratiğe dökün. Görüşmeciler, veritabanı sorunlarını iş paydaşlarına nasıl aktaracağınızı sıkça sorar.
Veritabanı trendlerini takip edin
Modern veritabanı teknolojileri ve uygulamalarını okuyun.
Veritabanı bloglarını takip edin, web seminerlerine katılın veya topluluklara dahil olun. Sharding, MVCC, dağıtık veritabanları ve bulut veritabanı hizmetleri gibi konulara hâkim olun.
Her şeyin uzmanı olmanız gerekmez; ancak güncel trendlere hâkim olduğunuzu göstermek, alana bağlı kaldığınızı gösterir.
DBMS Mülakat Sorularının Özeti
DBMS mülakatları, temel SQL söz diziminden karmaşık sistem tasarım kararlarına kadar her şeyi test eder.
Başarılı olmak için normalleştirme, indeksleme ve işlemler gibi temel kavramlara hakim olun. Ardından sharding ve yüksek kullanılabilirlik tasarımı gibi ileri konulara geçin. Sadece teori yetmez – veritabanı bilginizi gerçek iş problemleriyle ilişkilendirmelisiniz.
En iyi adaylar, teknik kavramları pratik sonuçlarla ilişkilendirir. Dizinleri anlatırken, sorgu süresini dakikalardan saniyelere nasıl indirdiğini söyleyin. Çoğaltmayı tartışırken, maliyetli kesintileri nasıl önlediğini açıklayın.
Karmaşık veritabanı kavramlarını teknik olmayan paydaşlara net şekilde açıklamayı pratiğe dökün. Performans optimizasyonu, kesinti yönetimi veya şema tasarımına dair ölçülebilir sonuçlarla desteklenmiş somut hikâyeler hazırlayın – "sorgu süresini %90 azalttım" ifadesi, "sorguları hızlandırdım" demekten daha etkilidir.
>SQL ve DBMS’in yanı sıra, şu konulara da hazırlıklı olmakta fayda var: Veri Ambarı mülakat soruları
Temelleri ustalaşın, gerçek verilerle pratik yapın ve teknik bilginizi her zaman iş değerine bağlayın – DBMS mülakatlarında başarı böyle gelir. Pratik mükemmelleştirir.
Temel veritabanı ve veritabanı tasarım becerilerini öğrenmek için, DataCamp’ten şu kurs ve materyalleri öneririm:
FAQs
Mülakatlarda yaygın olarak hangi DBMS soruları sorulur?
DBMS mülakatları genellikle dört ana alanı kapsar: normalleştirme ve ACID özellikleri gibi temel kavramlar, SQL söz dizimi ve sorgu optimizasyonu, ölçeklenebilirlik ve performansla ilgili sistem tasarımı soruları ve gerçek dünya veritabanı problemlerini ele almaya yönelik davranışsal senaryolar. Temel sorular çekirdek veritabanı ilkelerini anladığınızı ölçerken, orta seviye sorular pratik SQL becerileri ve performans ayarına odaklanır. İleri seviye sorular, ölçekli veritabanı sistemleri tasarlama ve karmaşık mimari kararları yönetme yeteneğinizi değerlendirir.
Yeni başlayan biri olarak DBMS mülakat sorularına nasıl hazırlanmalıyım?
SQL temellerine hâkim olarak başlayın – SELECT ifadeleri, join’ler, toplulaştırmalar ve normalleştirme gibi temel veritabanı tasarım ilkeleri. SQLBolt veya W3Schools gibi platformlarda gerçek veri kümeleri üzerinde sorgu yazmayı pratiğe dökün ve uygulamalı deneyim için yerel bir veritabanı ortamı kurun. Sözdizimini ezberlemekten ziyade veritabanı kavramlarının neden var olduğunu anlamaya odaklanın – bu, mülakatlarda gerekçenizi açıklamanıza yardımcı olur.
Junior ile senior DBMS rolleri için hazırlık arasındaki fark nedir?
Junior roller, SQL söz dizimi, temel veritabanı kavramları ve mevcut veritabanı tasarımlarını takip etmeye daha fazla odaklanır. Senior roller ise sistem tasarımı, performans optimizasyonu, veritabanı kesintilerinin yönetimi ve sharding, çoğaltma ve ölçekleme stratejilerine dair mimari kararları vurgular. Kıdemli adayların, gerçek dünya veritabanı zorluklarıyla ilgili deneyimlerini ve teknik kavramları hem teknik hem de teknik olmayan paydaşlara aktarabilme becerisini göstermesi gerekir.
Farklı veritabanı sistemlerine özgü SQL sözdizimini ezberlemeli miyim?
Farklı veritabanı sistemlerindeki her sözdizimi varyasyonunu ezberlemeyin – platformlar arasında çalışan temel SQL kavramlarını anlamaya odaklanın. Çoğu mülakatta standart SQL sözdizimi kullanılır ve görüşmeciler, belirli sözdizimi ayrıntılarının iş başında bakılabileceğini bilir. Bunun yerine sorgu mantığınızı ve problem çözme yaklaşımınızı açıklamayı pratiğe dökün.
Kullanmadığım teknolojiler hakkındaki DBMS sorularını nasıl ele alırım?
Deneyim seviyeniz konusunda dürüst olun; ancak öğrenme ve uyum sağlama becerinizi gösterin. Anladığınız kavramları açıklayın ve çalıştığınız teknolojilerle paralellik kurun. Örneğin, MongoDB hakkında soru sorulursa ama yalnızca MySQL biliyorsanız, doküman tabanlı ve ilişkisel veritabanları arasındaki genel farkları tartışın. Merakınızı, açıklayıcı sorular sorarak ve yeni teknolojiyi nasıl öğreneceğinizi anlatarak gösterin.


