Khóa học
Đang chuẩn bị cho buổi phỏng vấn DBMS? Bạn đến đúng chỗ rồi.
Bạn quen làm việc với cơ sở dữ liệu hằng ngày, nhưng phỏng vấn đánh giá bạn theo cách khác với tình huống thực tế. Nhà tuyển dụng không chỉ muốn xem liệu bạn có thể viết truy vấn SQL hay không - họ sẽ kiểm tra hiểu biết của bạn về chuẩn hóa, các thuộc tính ACID, và cách bạn xử lý vấn đề hiệu năng cơ sở dữ liệu dưới áp lực. Nhiều chuyên gia cơ sở dữ liệu vấp ngã vì không thể giải thích các khái niệm họ dùng mỗi ngày hoặc lúng túng với câu hỏi hành vi nhằm đánh giá cách họ làm việc với đội dữ liệu.
Hướng dẫn này bao quát những câu hỏi phỏng vấn DBMS thường gặp nhất ở mọi cấp độ khó. Bạn cũng sẽ nhận được các chiến lược đã được kiểm chứng để xử lý câu hỏi theo kịch bản và mẹo giúp bạn nổi bật so với ứng viên khác.
Hãy bắt đầu với những câu hỏi nền tảng mà bất kỳ buổi phỏng vấn DBMS nào cũng mở đầu.
>Bạn chỉ muốn tập trung vào phần mã hóa của buổi phỏng vấn? Đây là 85 câu hỏi và câu trả lời phỏng vấn SQL cho năm 2026.
Câu hỏi phỏng vấn DBMS cơ bản
Hãy kỳ vọng các câu hỏi này ở phần đầu buổi phỏng vấn kỹ thuật. Chúng kiểm tra hiểu biết nền tảng của bạn về hệ quản trị cơ sở dữ liệu.
Nhà tuyển dụng dùng các câu hỏi này để xem bạn có hiểu các khái niệm cốt lõi về cơ sở dữ liệu trước khi chuyển sang kịch bản phức tạp hay không. Họ tìm kiếm lời giải thích rõ ràng và ví dụ thực tiễn cho thấy bạn đã làm việc với cơ sở dữ liệu, chứ không chỉ học thuộc định nghĩa.
DBMS (Hệ quản trị Cơ sở dữ liệu) là gì?
Một DBMS là phần mềm quản lý cơ sở dữ liệu - nó xử lý việc lưu trữ, truy xuất và tổ chức dữ liệu, đồng thời đảm bảo bảo mật và tính nhất quán.
Hãy coi nó như lớp trung gian giữa ứng dụng của bạn và các tệp dữ liệu thực. Ví dụ phổ biến gồm MySQL, PostgreSQL, Oracle và SQL Server. DBMS xử lý các tác vụ như xác thực người dùng, sao lưu dữ liệu và đảm bảo nhiều người dùng có thể truy cập dữ liệu mà không làm hỏng dữ liệu.
Sự khác nhau giữa cơ sở dữ liệu và DBMS là gì?
Một cơ sở dữ liệu là tập hợp dữ liệu, còn DBMS là phần mềm quản lý dữ liệu đó.
Cơ sở dữ liệu chứa bảng, bản ghi và các mối quan hệ. DBMS cung cấp công cụ và giao diện để tương tác với dữ liệu đó. Nó giống như sự khác nhau giữa một thư viện (cơ sở dữ liệu) và hệ thống thủ thư (DBMS) giúp bạn tìm và mượn sách.
Giải thích các thuộc tính ACID trong giao dịch cơ sở dữ liệu
Nguyên tắc ACID đảm bảo giao dịch cơ sở dữ liệu đáng tin cậy và duy trì tính toàn vẹn dữ liệu:
- Atomicity (Tính nguyên tử): Mọi thao tác trong một giao dịch thành công hoặc thất bại cùng nhau
- Consistency (Tính nhất quán): Dữ liệu vẫn hợp lệ theo các quy tắc đã định
- Isolation (Tính cô lập): Các giao dịch đồng thời không can thiệp lẫn nhau
- Durability (Tính bền vững): Thay đổi đã cam kết sẽ tồn tại ngay cả khi hệ thống gặp sự cố
Ví dụ đời thường: Khi bạn chuyển tiền giữa các tài khoản ngân hàng, cả ghi nợ và ghi có phải xảy ra cùng nhau (tính nguyên tử), các quy tắc về tổng số dư vẫn đúng (tính nhất quán), giao dịch khác không nhìn thấy trạng thái dở dang (tính cô lập), và thay đổi vẫn tồn tại ngay cả khi hệ thống sập (tính bền vững).
Các loại khóa trong cơ sở dữ liệu là gì?
Khóa cơ sở dữ liệu dùng để định danh duy nhất bản ghi và thiết lập quan hệ. Đây là những loại bạn cần biết:
- Khóa chính (Primary key): Định danh duy nhất mỗi dòng (không thể null hoặc trùng)
- Khóa ngoại (Foreign key): Tham chiếu đến khóa chính ở bảng khác
- Khóa ứng viên (Candidate key): Bất kỳ cột nào có thể làm khóa chính
- Khóa tổng hợp (Composite key): Khóa chính tạo từ nhiều cột
- Khóa duy nhất (Unique key): Đảm bảo tính duy nhất nhưng cho phép một giá trị null
Ví dụ đơn giản:
CREATE TABLE employees (
employee_id INT PRIMARY KEY,
department_id INT,
email VARCHAR(100) UNIQUE,
FOREIGN KEY (department_id) REFERENCES departments(id)
);
Chuẩn hóa là gì và tại sao lại tốt?
Chuẩn hóa loại bỏ dữ liệu dư thừa bằng cách tổ chức dữ liệu vào các bảng riêng biệt nhưng có liên hệ.
Nó ngăn bất nhất dữ liệu và tiết kiệm dung lượng. Đây là cách các dạng chuẩn chính hoạt động:
Dạng chuẩn thứ nhất (1NF): Mỗi cột chứa giá trị nguyên tử (không thể chia nhỏ) - không có danh sách hay nhiều giá trị trong một ô.
Ví dụ xấu:
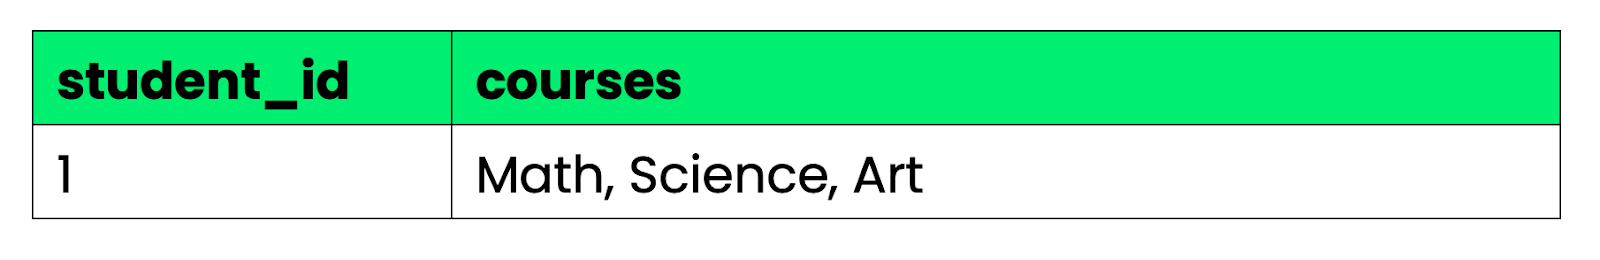
Hình 1 - Ví dụ 1NF không tốt
Ví dụ tốt:
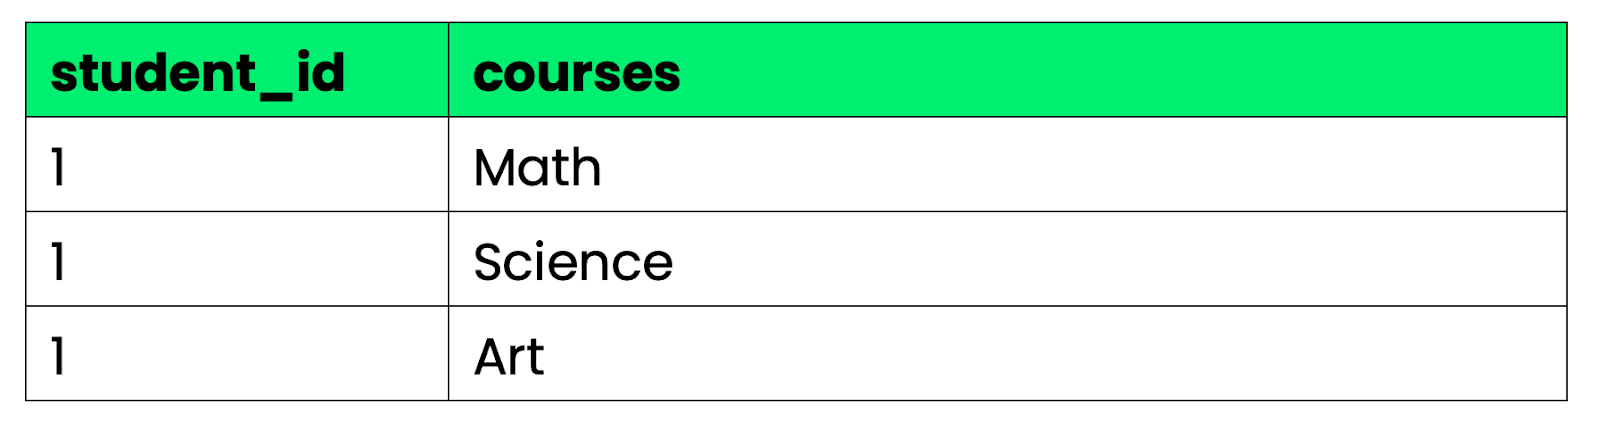
Hình 2 - Ví dụ 1NF tốt
Dạng chuẩn thứ hai (2NF): Phải đạt 1NF và loại bỏ phụ thuộc bộ phận — các cột không khóa phải phụ thuộc vào toàn bộ khóa chính, không chỉ một phần.
Điều này áp dụng khi bạn có khóa chính tổng hợp. Nếu có bảng với khóa chính (student_id, course_id), thì student_name không nên nằm trong bảng này vì nó chỉ phụ thuộc vào student_id, không phải cả hai.
Dạng chuẩn thứ ba (3NF): Phải đạt 2NF và loại bỏ phụ thuộc bắc cầu. Các cột không khóa không nên phụ thuộc vào các cột không khóa khác.
Ví dụ xấu:
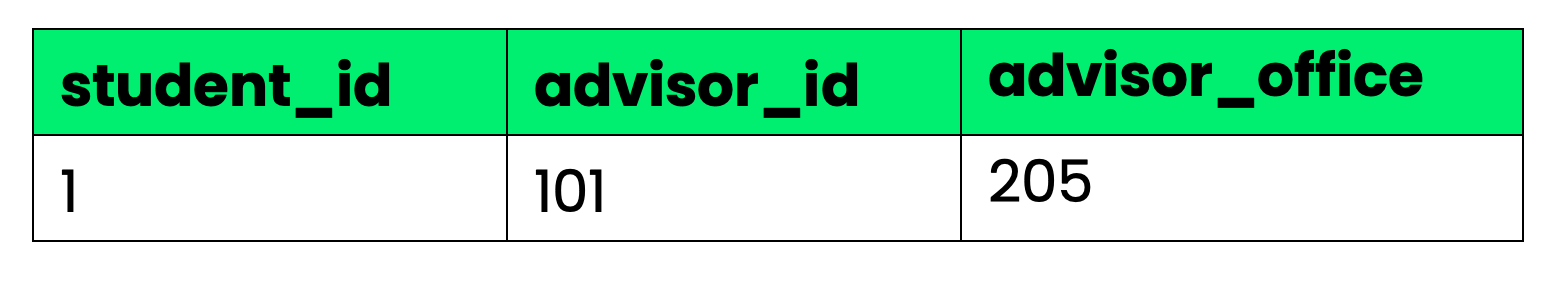
Hình 3 - Ví dụ 3NF không tốt
Ở đây, advisor_office phụ thuộc vào advisor_id, không phụ thuộc trực tiếp vào student_id. Hãy tách thành các bảng riêng.
Không có chuẩn hóa, bạn sẽ lưu thông tin khách hàng trong mọi đơn hàng, lãng phí dung lượng và gây rắc rối khi cập nhật chi tiết khách hàng.
Giải thích sự khác nhau giữa DELETE, DROP và TRUNCATE
Các lệnh này xóa dữ liệu theo những cách khác nhau:
- DELETE xóa các hàng cụ thể và có thể hoàn tác:
DELETE FROM employees WHERE department_id = 5;
- TRUNCATE xóa toàn bộ hàng nhưng giữ cấu trúc bảng (nhanh hơn DELETE):
TRUNCATE TABLE employees;
- DROP xóa toàn bộ bảng và cấu trúc của nó:
DROP TABLE employees;
Sự khác nhau giữa INNER JOIN và OUTER JOIN là gì?
INNER JOIN chỉ trả về các bản ghi khớp ở cả hai bảng:
SELECT e.name, d.department_name
FROM employees e
INNER JOIN departments d ON e.department_id = d.id;
OUTER JOIN bao gồm cả các bản ghi không khớp:
- LEFT JOIN: Tất cả bản ghi từ bảng trái, và phần khớp từ bảng phải
- RIGHT JOIN: Tất cả bản ghi từ bảng phải, và phần khớp từ bảng trái
- FULL OUTER JOIN: Tất cả bản ghi từ cả hai bảng
>Chủ đề join trong SQL tự thân rất phức tạp - Đây là 20 câu hỏi phỏng vấn chỉ về join
Chỉ mục (index) là gì và nó cải thiện hiệu năng như thế nào?
Một chỉ mục là cấu trúc dữ liệu giúp tăng tốc truy xuất bằng cách tạo “đường tắt” đến các dòng trong bảng.
Hãy hình dung nó như mục lục ở cuối sách - thay vì đọc từng trang để tìm chủ đề, bạn tra cứu và nhảy thẳng đến trang phù hợp. Chỉ mục làm truy vấn SELECT nhanh hơn, nhưng làm chậm các thao tác INSERT, UPDATE và DELETE vì phải cập nhật chỉ mục.
CREATE INDEX idx_employee_email ON employees(email);
Giải thích khái niệm view trong cơ sở dữ liệu
Một view là bảng ảo được tạo từ một truy vấn SQL và bản thân không lưu dữ liệu.
View đơn giản hóa truy vấn phức tạp, tăng bảo mật bằng cách ẩn cột nhạy cảm, và trình bày dữ liệu theo các định dạng khác nhau. Khi bạn truy vấn view, cơ sở dữ liệu thực thi SQL nền và trả kết quả như thể đó là bảng thực.
CREATE VIEW active_employees AS
SELECT employee_id, name, email
FROM employees
WHERE status = 'active';
SELECT * FROM active_employees;
Thủ tục lưu trữ (stored procedure) là gì và ưu điểm của chúng?
Stored procedure là mã SQL được biên dịch sẵn và lưu trong cơ sở dữ liệu, bạn có thể thực thi bằng tên.
Chúng cải thiện hiệu năng vì được biên dịch sẵn, giảm lưu lượng mạng bằng cách thực thi nhiều câu lệnh trong một lần gọi, và tăng bảo mật qua truy vấn tham số hóa. Chúng cũng tập trung hóa logic nghiệp vụ trong cơ sở dữ liệu.
CREATE PROCEDURE GetEmployeesByDepartment(IN dept_id INT)
BEGIN
SELECT * FROM employees WHERE department_id = dept_id;
END;
>SQL thủ tục có thể là chủ đề lớn trong phỏng vấn, tùy vào vị trí. Đây là 20 câu hỏi phỏng vấn về Oracle PL/SQL
Vượt qua phần này rồi, hãy đi sâu vào các câu hỏi trung cấp để kiểm tra kiến thức của bạn.
Câu hỏi phỏng vấn DBMS trung cấp
Các câu hỏi này kiểm tra mức độ thành thạo kỹ thuật của bạn với các công cụ và khái niệm DBMS.
Nhà tuyển dụng dùng câu hỏi trung cấp để xem bạn có thể áp dụng kiến thức cơ sở dữ liệu để giải quyết vấn đề thực tế hay không. Họ tìm kiếm kinh nghiệm thực hành tối ưu truy vấn và hiểu cách cơ sở dữ liệu vận hành bên trong.
Giải thích các loại chỉ mục khác nhau và khi nào dùng từng loại
- Chỉ mục cụm (Clustered indexes) sắp xếp lại vật lý dữ liệu bảng theo giá trị khóa - mỗi bảng chỉ có tối đa một chỉ mục cụm vì dữ liệu chỉ có thể được sắp theo một cách.
- Chỉ mục không cụm (Non-clustered indexes) tạo cấu trúc riêng trỏ đến các dòng bảng mà không thay đổi thứ tự vật lý. Có thể có nhiều chỉ mục không cụm trên một bảng.
- Chỉ mục tổng hợp (Composite indexes) bao phủ nhiều cột và hiệu quả nhất khi truy vấn lọc cùng lúc trên các cột đó.
- Chỉ mục duy nhất (Unique indexes) vừa đảm bảo tính duy nhất vừa hỗ trợ tra cứu nhanh.
- Chỉ mục một phần (Partial indexes) chỉ lập chỉ mục các hàng thỏa điều kiện nhất định, tiết kiệm dung lượng.
Sự khác nhau giữa chỉ mục cụm và không cụm là gì?
- Chỉ mục cụm quyết định thứ tự lưu trữ vật lý của dữ liệu trong bảng - hãy nghĩ đến danh bạ điện thoại sắp theo họ.
- Chỉ mục không cụm giống mục lục cuối sách giáo khoa - chúng trỏ đến nơi dữ liệu thực sự nằm mà không đổi thứ tự trang.
Cách tạo chỉ mục cụm và không cụm:
-- Khóa chính mặc định tạo chỉ mục cụm
CREATE TABLE employees (
id INT PRIMARY KEY CLUSTERED,
name VARCHAR(100),
email VARCHAR(100)
);
-- Chỉ mục riêng để tra cứu email nhanh
CREATE NONCLUSTERED INDEX idx_email ON employees(email);
Một bảng chỉ có thể có một chỉ mục cụm nhưng nhiều chỉ mục không cụm. Chỉ mục cụm nhanh hơn cho truy vấn phạm vi, còn chỉ mục không cụm phù hợp cho đối sánh chính xác trên các cột khác nhau.
Bạn tối ưu một truy vấn chậm như thế nào?
Bắt đầu bằng cách phân tích kế hoạch thực thi để xem nút thắt ở đâu.
EXPLAIN SELECT * FROM orders o
JOIN customers c ON o.customer_id = c.id
WHERE o.order_date > '2025-07-01';
Một số kỹ thuật tối ưu thường gặp:
- Thêm chỉ mục trên các cột dùng trong mệnh đề WHERE, JOIN và ORDER BY
- Giới hạn tập kết quả bằng WHERE trước khi JOIN
- Dùng chỉ mục bao phủ (covering indexes) bao gồm mọi cột mà truy vấn cần
- Viết lại truy vấn con thành JOIN khi có thể
- Tránh SELECT * - chỉ lấy các cột cần thiết
Kiểm tra các lần quét bảng trong kế hoạch thực thi - đây thường là “sát thủ” hiệu năng lớn nhất.
Giao dịch cơ sở dữ liệu và các mức độ cô lập là gì?
Giao dịch cơ sở dữ liệu gom nhiều thao tác thành một đơn vị duy nhất hoặc thành công hoàn toàn hoặc thất bại hoàn toàn.
Mức độ cô lập kiểm soát cách các giao dịch đồng thời nhìn thấy thay đổi của nhau:
- READ UNCOMMITTED: Có thể đọc thay đổi chưa cam kết (có thể xảy ra đọc bẩn)
- READ COMMITTED: Chỉ đọc dữ liệu đã cam kết (mặc định ở đa số hệ CSDL)
- REPEATABLE READ: Cùng một truy vấn trả về cùng kết quả trong một giao dịch
- SERIALIZABLE: Cô lập mạnh nhất, giao dịch chạy như thể tuần tự
Cấp cô lập cao hơn ngăn chặn nhiều vấn đề hơn, nhưng giảm tính đồng thời và hiệu năng.
Giải thích khái niệm phân vùng (partitioning) cơ sở dữ liệu
Phân vùng cơ sở dữ liệu chia các bảng lớn thành các phần nhỏ, dễ quản lý hơn trong khi vẫn giữ logic là một bảng. Có bốn cách tiếp cận bạn cần biết.
- Phân vùng ngang (Horizontal) chia theo hàng dựa trên tiêu chí như khoảng ngày:
-- Bảng Orders phân vùng theo năm
CREATE TABLE orders_2023 (...);
CREATE TABLE orders_2024 (...);
CREATE TABLE orders_2025 (...);
- Phân vùng dọc (Vertical) chia theo cột - các cột truy cập thường xuyên ở một phân vùng, cột ít dùng ở phân vùng khác.
- Phân vùng băm (Hash) phân phối hàng dựa trên hàm băm.
- Phân vùng theo khoảng (Range) dùng khoảng giá trị như ngày tháng hoặc ID.
Lợi ích gồm truy vấn nhanh hơn (chỉ quét phân vùng liên quan), dễ bảo trì và song song hóa tốt hơn.
Sự khác nhau giữa UNION và UNION ALL?
UNION kết hợp kết quả từ nhiều truy vấn và loại bỏ trùng lặp, trong khi UNION ALL cũng kết hợp nhưng giữ tất cả các hàng, bao gồm cả trùng lặp.
-- UNION loại trùng (chậm hơn)
SELECT name FROM employees WHERE department = 'IT'
UNION
SELECT name FROM employees WHERE salary > 50000;
-- UNION ALL giữ trùng (nhanh hơn)
SELECT name FROM employees WHERE department = 'IT'
UNION ALL
SELECT name FROM employees WHERE salary > 50000;
Dùng UNION ALL khi bạn biết sẽ không có trùng lặp hoặc khi trùng lặp không quan trọng - nhanh hơn nhiều vì bỏ qua bước khử trùng lặp.
Bạn xử lý deadlock trong cơ sở dữ liệu như thế nào?
Deadlock xảy ra khi hai giao dịch chờ nhau giải phóng tài nguyên, tạo thành vòng bế tắc.
Hầu hết cơ sở dữ liệu tự động phát hiện deadlock và hủy một giao dịch ("nạn nhân deadlock"), cho phép giao dịch còn lại tiếp tục. Giao dịch bị hủy sẽ bị rollback và trả lỗi.
-- Giao dịch 1
BEGIN;
UPDATE accounts SET balance = balance - 100 WHERE id = 1;
-- chờ khóa trên tài khoản 2
-- Giao dịch 2
BEGIN;
UPDATE accounts SET balance = balance + 50 WHERE id = 2;
-- cố gắng cập nhật tài khoản 1 -> DEADLOCK
Một số chiến lược ngăn ngừa deadlock:
- Truy cập bảng theo cùng thứ tự giữa các giao dịch
- Giữ giao dịch ngắn
- Dùng cấp cô lập phù hợp
- Triển khai logic thử lại trong ứng dụng
Mục đích của ràng buộc (constraint) trong cơ sở dữ liệu là gì?
Ràng buộc thực thi quy tắc nghiệp vụ và duy trì tính toàn vẹn dữ liệu ở mức cơ sở dữ liệu. Dưới đây là năm loại ràng buộc mà mọi chuyên gia CSDL phải biết:
- Khóa chính: Đảm bảo định danh duy nhất
- Khóa ngoại: Duy trì toàn vẹn tham chiếu
- Check: Xác thực dữ liệu đáp ứng điều kiện cụ thể
- Not null: Ngăn giá trị rỗng
- Unique: Đảm bảo không trùng lặp
Cách chúng hoạt động trong thực tế:
CREATE TABLE employees (
id INT PRIMARY KEY,
email VARCHAR(100) UNIQUE NOT NULL,
age INT CHECK (age >= 18 AND age <= 65),
department_id INT,
FOREIGN KEY (department_id) REFERENCES departments(id)
);
Ràng buộc ngăn dữ liệu xấu đi vào cơ sở dữ liệu và phát hiện lỗi sớm, trước khi chúng lan rộng trong ứng dụng.
Giải thích sao chép (replication) cơ sở dữ liệu và các loại của nó
Sao chép cơ sở dữ liệu sao chép dữ liệu từ một cơ sở dữ liệu sang cơ sở dữ liệu khác để cải thiện khả dụng, hiệu năng và khắc phục thảm họa.
Có bốn loại sao chép bạn cần biết:
- Master-slave replication: Một master xử lý ghi, nhiều slave xử lý đọc. Thay đổi chảy từ master đến slave.
- Master-master replication: Nhiều master có thể xử lý cả ghi và đọc. Phức tạp hơn, nhưng loại bỏ điểm lỗi đơn.
- Sao chép đồng bộ (Synchronous): Chờ xác nhận từ bản sao trước khi cam kết (chậm hơn nhưng nhất quán hơn).
- Sao chép bất đồng bộ (Asynchronous): Cam kết ngay, sao chép sau (nhanh hơn nhưng có nguy cơ mất dữ liệu).
Trigger cơ sở dữ liệu là gì và khi nào nên dùng?
Trigger là thủ tục đặc biệt tự động thực thi khi có sự kiện trong CSDL như INSERT, UPDATE hoặc DELETE.
Ví dụ đơn giản:
CREATE TRIGGER update_modified_date
BEFORE UPDATE ON employees
FOR EACH ROW
BEGIN
SET NEW.modified_at = NOW();
END;
Trigger hữu ích để tự động cập nhật thời gian, ghi log thay đổi phục vụ kiểm toán, áp đặt quy tắc nghiệp vụ phức tạp hoặc duy trì các trường tính toán.
Nhưng trigger có thể khiến việc gỡ lỗi khó khăn, làm chậm thao tác và tạo phụ thuộc ẩn. Hãy dùng tiết chế và ghi chép rõ ràng.
Giờ hãy chuyển sang các câu hỏi DBMS nâng cao.
Câu hỏi phỏng vấn DBMS nâng cao
Các câu hỏi này kiểm tra hiểu biết sâu của bạn về kiến trúc DBMS và các thao tác cơ sở dữ liệu phức tạp.
Nhà tuyển dụng dùng câu hỏi nâng cao để xem bạn có thể thiết kế và xử lý sự cố hệ thống cơ sở dữ liệu ở quy mô lớn hay không. Họ muốn thấy bạn hiểu đánh đổi giữa các cách tiếp cận và có thể đưa ra quyết định sáng suốt về kiến trúc cơ sở dữ liệu.
Giải thích sharding cơ sở dữ liệu và các đánh đổi của nó
Sharding tách ngang một cơ sở dữ liệu lớn trên nhiều máy chủ, mỗi shard chỉ chứa một phần dữ liệu.
Bạn phân vùng dữ liệu dựa trên khóa shard, như ID người dùng, vị trí địa lý hoặc khoảng thời gian. Mỗi shard vận hành độc lập, cho phép mở rộng vượt quá khả năng của một máy chủ đơn lẻ.
-- Ví dụ: Shard người dùng theo dải ID
-- Shard 1: user_id 1-1000000
-- Shard 2: user_id 1000001-2000000
-- Shard 3: user_id 2000001-3000000
Lợi ích gồm mở rộng theo chiều ngang, hiệu năng tốt hơn và cô lập lỗi (một shard hỏng không làm sập toàn bộ).
Đánh đổi gồm logic ứng dụng phức tạp, không có giao dịch xuyên shard, cân bằng lại khó, và mất một số đảm bảo ACID giữa các shard. Truy vấn xuyên nhiều shard trở nên tốn kém.
Định lý CAP là gì và ảnh hưởng thế nào đến thiết kế cơ sở dữ liệu?
Định lý CAP nói rằng hệ thống phân tán chỉ có thể đảm bảo hai trong ba thuộc tính: Tính nhất quán, tính sẵn sàng và khả năng chịu phân hoạch:
- Consistency (Nhất quán): Mọi nút thấy cùng dữ liệu tại cùng thời điểm
- Availability (Sẵn sàng): Hệ thống vẫn hoạt động ngay cả khi một số nút lỗi
- Partition tolerance (Chịu phân hoạch): Hệ thống tiếp tục bất chấp lỗi mạng giữa các nút
Vì chỉ đảm bảo được hai trong ba, đây là các kết hợp phổ biến nhất:
- Hệ CA (như RDBMS truyền thống) hy sinh khả năng chịu phân hoạch - xử lý kém khi mạng bị chia cắt
- Hệ CP (như MongoDB trong một số cấu hình) hy sinh tính sẵn sàng - có thể từ chối yêu cầu để duy trì nhất quán
- Hệ AP (như Cassandra) hy sinh tính nhất quán - vẫn sẵn sàng nhưng dữ liệu có thể tạm thời không nhất quán giữa các nút
Phần lớn cơ sở dữ liệu phân tán hiện đại đạt nhất quán cuối cùng (eventually consistent) - ưu tiên tính sẵn sàng và chịu phân hoạch, trong khi đạt được nhất quán theo thời gian.
Thiết kế lược đồ CSDL cho mức độ đồng thời cao như thế nào?
Bắt đầu bằng cách giảm tranh chấp khóa bằng cách thiết kế bảng để giảm xung đột giữa các thao tác đồng thời.
Dùng khóa lạc quan (optimistic locking) với cột phiên bản thay vì khóa bi quan:
-- Thêm cột version cho khóa lạc quan
CREATE TABLE products (
id INT PRIMARY KEY,
name VARCHAR(100),
price DECIMAL(10,2),
inventory_count INT,
version INT DEFAULT 1
);
-- Cập nhật kèm kiểm tra version
UPDATE products
SET inventory_count = inventory_count - 1, version = version + 1
WHERE id = 123 AND version = 5;
Mẹo khác khi thiết kế cho mức độ đồng thời cao:
- Phân vùng các bảng nóng theo thời gian hoặc ranh giới logic khác
- Dùng bảng riêng cho các mẫu truy cập khác nhau thay vì bảng rộng với mục đích lẫn lộn
- Tránh chỉ mục quá rộng gây tranh chấp
- Thiết kế cho tải công việc chủ yếu là thêm (append-mostly) nếu có thể - các thao tác chèn ít gây tranh chấp hơn cập nhật
Giải thích MVCC (Multi-Version Concurrency Control)
MVCC cho phép nhiều giao dịch truy cập cùng dữ liệu đồng thời mà không cần khóa bằng cách duy trì nhiều phiên bản cho mỗi dòng.
Khi bạn bắt đầu một giao dịch, bạn nhận được một ảnh chụp (snapshot) của cơ sở dữ liệu tại thời điểm đó. Giao dịch khác có thể sửa dữ liệu, nhưng giao dịch của bạn chỉ thấy phiên bản tồn tại khi bạn bắt đầu.
-- Giao dịch A bắt đầu lúc T1
BEGIN; -- Thấy phiên bản 1 của mọi dữ liệu
-- Giao dịch B sửa dữ liệu lúc T2
UPDATE accounts SET balance = 1000 WHERE id = 1; -- Tạo phiên bản 2
-- Giao dịch A vẫn thấy phiên bản 1
SELECT balance FROM accounts WHERE id = 1; -- Trả về giá trị cũ
COMMIT; -- A cam kết với snapshot của mình
Lợi ích: đọc không chặn ghi, ghi không chặn đọc, và đọc nhất quán trong giao dịch.
Hạn chế: chi phí lưu trữ cho nhiều phiên bản và cần quy trình dọn dẹp để loại bỏ phiên bản cũ.
Materialized view là gì và khi nào nên dùng?
Materialized view lưu vật lý kết quả của một truy vấn trên đĩa, khác với view thường vốn thực thi truy vấn mỗi lần gọi.
Chúng hoàn hảo cho các phép tổng hợp tốn kém mà không cần dữ liệu thời gian thực:
-- Tạo materialized view cho tổng hợp doanh số theo tháng
CREATE MATERIALIZED VIEW monthly_sales AS
SELECT
DATE_TRUNC('month', order_date) as month,
SUM(total_amount) as total_sales,
COUNT(*) as order_count
FROM orders
GROUP BY DATE_TRUNC('month', order_date);
-- Làm mới khi cần
REFRESH MATERIALIZED VIEW monthly_sales;
Rất phù hợp cho truy vấn bảng điều khiển, báo cáo và phân tích phức tạp lặp lại trên dữ liệu ổn định.
Đánh đổi: tốn thêm dung lượng, chi phí bảo trì, và dữ liệu có thể lỗi thời giữa các lần làm mới. Tốt nhất khi bạn chấp nhận dữ liệu hơi trễ để đổi lấy hiệu năng truy vấn.
Bạn xử lý tập dữ liệu rất lớn không vừa bộ nhớ như thế nào?
Thiết kế cho các thao tác dựa trên đĩa bằng cách hiểu cách CSDL truy cập dữ liệu từ lưu trữ.
Dùng phân vùng để đảm bảo truy vấn chỉ chạm tới các phân đoạn liên quan:
-- Phân vùng theo ngày để truy vấn bỏ qua phân vùng không liên quan
CREATE TABLE sales_data (
sale_date DATE,
amount DECIMAL(10,2),
customer_id INT
) PARTITION BY RANGE (sale_date);
Mẹo khác xử lý dữ liệu lớn hơn bộ nhớ:
- Tối ưu chỉ mục cho quét theo phạm vi thay vì truy cập ngẫu nhiên
- Dùng lưu trữ dạng cột cho tải phân tích khi bạn tổng hợp trên các cột cụ thể
- Triển khai bộ nhớ đệm kết quả truy vấn và phân trang cho truy vấn hướng người dùng
- Dùng bản sao chỉ đọc (read replica) để phân tán tải truy vấn qua nhiều máy
- Cân nhắc lưu trữ lưu trữ (archival) - chuyển dữ liệu cũ sang lưu trữ rẻ hơn và chỉ giữ dữ liệu gần đây trong CSDL chính
Giải thích sự khác nhau giữa khóa bi quan và khóa lạc quan
Khóa bi quan giả định xung đột sẽ xảy ra và khóa tài nguyên ngay để ngăn chúng, còn khóa lạc quan giả định xung đột hiếm và chỉ kiểm tra khi cam kết thay đổi.
-- Bi quan: Khóa dòng ngay lập tức
BEGIN;
SELECT * FROM accounts WHERE id = 1 FOR UPDATE; -- Khóa dòng
UPDATE accounts SET balance = balance - 100 WHERE id = 1;
COMMIT;
-- Lạc quan: Kiểm tra phiên bản trước khi cập nhật
SELECT id, balance, version FROM accounts WHERE id = 1;
-- Logic ứng dụng diễn ra ở đây
UPDATE accounts
SET balance = balance - 100, version = version + 1
WHERE id = 1 AND version = 3; -- Thất bại nếu có người khác đã cập nhật
- Bi quan phù hợp hơn cho kịch bản tranh chấp cao, nơi xung đột phổ biến.
- Lạc quan phù hợp hơn cho tải đọc nhiều, nơi xung đột hiếm.
Phi chuẩn hóa (denormalization) là gì và khi nào phù hợp?
Phi chuẩn hóa cố ý thêm dư thừa vào các bảng đã chuẩn hóa để cải thiện hiệu năng truy vấn.
Bạn nhân đôi dữ liệu giữa các bảng để tránh join tốn kém:
-- Chuẩn hóa: Cần join để lấy chi tiết đơn hàng
SELECT o.id, c.name, c.email
FROM orders o
JOIN customers c ON o.customer_id = c.id;
-- Phi chuẩn hóa: Thông tin khách hàng lưu trong bảng orders
SELECT id, customer_name, customer_email
FROM orders_denormalized;
Khi nào nên phi chuẩn hóa:
- Hiệu năng đọc quan trọng hơn hiệu năng ghi
- Bạn có mẫu truy vấn dự đoán được và hưởng lợi khi tránh join
- Lưu trữ rẻ hơn thời gian tính toán
- Bạn có thể xử lý độ phức tạp khi đồng bộ dữ liệu phi chuẩn hóa
Rủi ro gồm dữ liệu không nhất quán, chi phí lưu trữ tăng, và logic cập nhật phức tạp hơn.
Thiết kế cho khắc phục thảm họa và tính sẵn sàng cao như thế nào?
Bắt đầu bằng cách thiết kế dự phòng ở mọi tầng - nhiều máy chủ CSDL, đường mạng và trung tâm dữ liệu.
Thiết lập sao chép với chuyển đổi dự phòng tự động:
- Primary: Xử lý mọi ghi
- Replica 1: Xử lý truy vấn đọc trong cùng khu vực
- Replica 2: Xử lý truy vấn đọc ở khu vực khác
- Replica 3: Dự phòng cho khắc phục thảm họa
Mẹo khác:
- Thực hiện sao lưu định kỳ với khả năng khôi phục theo thời điểm
- Kiểm tra quy trình failover thường xuyên - kế hoạch DR không hoạt động dưới áp lực thì vô dụng
- Dùng bộ cân bằng tải để điều hướng lưu lượng khỏi máy chủ lỗi
- Giám sát mọi thứ - bạn cần biết vấn đề trước người dùng
- Lên kế hoạch cho nhiều kịch bản lỗi - lỗi máy chủ đơn, mất điện trung tâm dữ liệu, thảm họa khu vực và hỏng dữ liệu
Giải thích pooling kết nối cơ sở dữ liệu và vì sao quan trọng
Connection pooling duy trì một bộ nhớ đệm các kết nối CSDL để ứng dụng tái sử dụng thay vì tạo kết nối mới cho mỗi yêu cầu.
Tạo kết nối CSDL tốn kém - gồm bắt tay mạng, xác thực và cấp phát tài nguyên. Pool kết nối loại bỏ chi phí này.
Ví dụ bằng Python:
# Không dùng pooling: Tạo kết nối mới mỗi lần
def get_user(user_id):
conn = create_connection() # Tốn kém!
result = conn.execute("SELECT * FROM users WHERE id = ?", user_id)
conn.close()
return result
# Dùng pooling: Tái sử dụng kết nối có sẵn
pool = ConnectionPool(max_connections=20)
def get_user(user_id):
conn = pool.get_connection() # Nhanh!
result = conn.execute("SELECT * FROM users WHERE id = ?", user_id)
pool.return_connection(conn)
return result
Lợi ích gồm thời gian phản hồi nhanh hơn, giảm tải cho CSDL, kiểm soát sử dụng tài nguyên và xử lý tốt đột biến lưu lượng.
Bạn nên đặt kích thước pool dựa trên người dùng đồng thời và năng lực CSDL — quá nhỏ gây chờ đợi, quá lớn lãng phí tài nguyên.
Câu hỏi DBMS theo tình huống và hành vi
Các câu hỏi này đánh giá kỹ năng giải quyết vấn đề và kinh nghiệm làm việc với khách hàng và đội dữ liệu.
Nhà tuyển dụng dùng câu hỏi hành vi và kịch bản để xem bạn xử lý thách thức CSDL trong thực tế như thế nào. Họ muốn hiểu tư duy, kỹ năng giao tiếp, và khả năng làm việc với người không chuyên khi xảy ra sự cố CSDL.
Hãy kể về lần bạn phải tối ưu một truy vấn chậm. Cách tiếp cận của bạn?
Cấu trúc câu trả lời để thể hiện quy trình giải quyết vấn đề rõ ràng.
Bắt đầu mô tả vấn đề và tác động: "Bảng điều khiển khách hàng mất 45 giây để tải vì truy vấn chính quét toàn bộ bảng một triệu dòng. Điều này khiến người dùng ức chế và rời trang."
Trình bày cách chẩn đoán: "Tôi phân tích kế hoạch thực thi và phát hiện thiếu chỉ mục trên các cột dùng trong WHERE. Tôi cũng nhận ra mệnh đề ORDER BY chưa được tối ưu."
Giải pháp và kết quả: "Tôi tạo chỉ mục tổng hợp bao phủ cả cột lọc và sắp xếp. Sau khi thử nghiệm ở môi trường staging, tôi triển khai vào giờ thấp điểm. Thời gian truy vấn giảm từ 45 giây xuống dưới 2 giây, giải quyết vấn đề hiệu năng của bảng điều khiển."
Luôn nhấn mạnh đo lường, thử nghiệm và kết quả định lượng trong câu trả lời.
Mô tả tình huống bạn phải giải thích khái niệm CSDL phức tạp cho người không kỹ thuật
Tập trung vào cách bạn làm cho khái niệm kỹ thuật trở nên dễ hiểu với người kinh doanh.
Chọn ví dụ cụ thể nơi bạn thành công trong việc thu hẹp khoảng cách kỹ thuật. Bạn có thể nói: "Đội marketing khó chịu vì báo cáo phân khúc khách hàng chạy mất 20 phút. Thay vì giải thích join và index, tôi dùng ví dụ đơn giản."
Cách giao tiếp: "Tôi bảo họ tưởng tượng tìm khách hàng mua cả sản phẩm A và B. Hệ thống hiện tại giống như phải lục từng hóa đơn trong một tủ hồ sơ khổng lồ. Sau tối ưu, sẽ như có thư mục được sắp theo loại sản phẩm, giúp tìm nhanh hơn."
Tác động kinh doanh: "Tôi tập trung vào điều họ quan tâm - báo cáo chạy trong 2 phút thay vì 20, giúp họ có insight nhanh hơn và phản ứng thị trường kịp thời."
Cho thấy bạn có thể chuyển ngữ công việc kỹ thuật thành giá trị kinh doanh mà không làm người không chuyên bị ngợp bởi chi tiết triển khai.
Bạn xử lý thế nào nếu CSDL bị sập vào giờ cao điểm?
Thể hiện kỹ năng quản lý khủng hoảng qua câu trả lời có cấu trúc:
- Đánh giá ngay: "Đầu tiên, tôi xác định phạm vi - có phải sập hoàn toàn hay một số dịch vụ còn chạy? Tôi kiểm tra bản sao đọc xem có thể dùng cho tác vụ chỉ đọc quan trọng không."
- Giao tiếp với bên liên quan: "Tôi lập tức thông báo đội ứng cứu sự cố và gửi cập nhật ngắn cho các bộ phận bị ảnh hưởng với thời gian ước tính cho lần cập nhật tiếp theo, ngay cả khi chưa có giải pháp."
- Quy trình chẩn đoán: "Tôi kiểm tra log hệ thống, dung lượng đĩa, bộ nhớ, kết nối mạng và log lỗi CSDL để tìm nguyên nhân gốc. Nếu là lỗi phần cứng, tôi kích hoạt failover sang máy dự phòng."
- Cập nhật định kỳ: "Tôi gửi cập nhật trạng thái mỗi 15-30 phút để giữ liên lạc, dù chưa có tiến triển. Giao tiếp quan trọng không kém việc sửa lỗi."
- Rà soát sau sự cố: "Sau khi giải quyết, tôi ghi lại điều gì đã xảy ra, vì sao, và chúng ta sẽ làm gì để ngăn ngừa."
Mấu chốt là thể hiện bạn bình tĩnh dưới áp lực và duy trì giao tiếp rõ ràng.
Hãy mô tả cách bạn thiết kế lược đồ CSDL cho một ứng dụng thương mại điện tử mới
Trình bày cách tiếp cận theo từng bước:
- Thu thập yêu cầu: "Tôi bắt đầu bằng việc hiểu nhu cầu kinh doanh - bán sản phẩm gì, khách mua sắm thế nào, cần báo cáo gì, và lưu lượng dự kiến ra sao."
- Xác định thực thể: "Tôi xác định thực thể cốt lõi như Users, Products, Orders, OrderItems, Categories và Payments. Mỗi thực thể đại diện một khái niệm kinh doanh cần theo dõi."
- Thiết kế quan hệ: "Tôi xác định cách các thực thể liên quan nhau. Ví dụ, Users có nhiều Orders, Orders chứa nhiều Products qua OrderItems, và Products thuộc Categories."
- Lập kế hoạch hiệu năng: "Tôi thêm chỉ mục trên các cột truy vấn thường xuyên, như email người dùng cho đăng nhập, SKU sản phẩm cho tìm kiếm, và ngày đặt hàng cho báo cáo. Tôi cũng cân nhắc phân vùng bảng lớn như Orders theo ngày."
- Tính tương lai: "Tôi thiết kế lược đồ để có thể mở rộng cho các tính năng tương lai như đánh giá sản phẩm, khuyến mãi và theo dõi tồn kho mà không cần tái cấu trúc lớn."
Cho thấy bạn nghĩ đến cả nhu cầu tức thời và khả năng mở rộng dài hạn ngay từ đầu.
Hãy kể về lần bạn phải di chuyển dữ liệu từ hệ CSDL này sang hệ khác. Bạn gặp thách thức gì?
Tập trung vào lập kế hoạch, thực thi và giải quyết vấn đề.
Bắt đầu bằng bối cảnh: "Chúng tôi di chuyển từ MySQL sang PostgreSQL để tận dụng hỗ trợ JSON tốt hơn và tính năng lập chỉ mục nâng cao cho tải phân tích."
Liệt kê vấn đề: "Thách thức lớn nhất là xử lý khác biệt kiểu dữ liệu - hành vi timestamp của MySQL khác PostgreSQL. Chúng tôi cũng có thủ tục lưu trữ cần viết lại."
Giải pháp: "Tôi lập kế hoạch di chuyển chi tiết với quy trình rollback. Chúng tôi thực hiện theo giai đoạn: đầu tiên một tập bảng con, rồi dần dần chuyển phần còn lại trong khi duy trì tính nhất quán dữ liệu."
Kết quả kiểm thử và xác nhận: "Chúng tôi chạy song song hai hệ trong hai tuần, so sánh kết quả giữa CSDL cũ và mới để đảm bảo toàn vẹn dữ liệu. Cũng kiểm thử tải hệ mới trước khi chuyển hẳn."
Bạn xử lý bất đồng với đồng đội về quyết định thiết kế CSDL như thế nào?
Thể hiện kỹ năng hợp tác và giải quyết xung đột:
- Lắng nghe và thấu hiểu: "Tôi luôn bắt đầu bằng việc hiểu quan điểm của họ. Thường bất đồng xuất phát từ ưu tiên khác nhau - họ có thể ưu tiên tiện lợi cho lập trình viên còn tôi ưu tiên hiệu năng."
- Trình bày luận điểm dựa trên dữ liệu: "Tôi chứng minh khuyến nghị bằng ví dụ cụ thể. Nếu cho rằng cần chỉ mục, tôi sẽ trình bày kế hoạch thực thi và số đo hiệu năng."
- Tìm điểm chung: "Thường chúng tôi đồng ý về mục tiêu cuối - ứng dụng nhanh, tin cậy. Bất đồng chỉ là về cách đạt được."
Ví dụ: "Một lập trình viên muốn dùng NoSQL cho hồ sơ người dùng, nhưng tôi đề xuất thiết kế quan hệ. Chúng tôi thảo luận đánh đổi, chạy thử cả hai cách và chọn giải pháp phù hợp nhất với yêu cầu nhất quán và năng lực đội ngũ."
Hãy kể về lần bạn làm dự án CSDL với hạn chót gấp
Thể hiện khả năng ưu tiên và hoàn thành dưới áp lực.
Bối cảnh: "Chúng tôi cần báo cáo khách hàng quan trọng cho buổi họp HĐQT trong ba ngày, nhưng truy vấn chạy hơn một giờ."
Cách ưu tiên: "Tôi tập trung vào những điểm cải thiện lớn nhất. Thay vì tối ưu mọi thứ, tôi xác định hai thao tác tốn kém nhất trong kế hoạch thực thi."
Giải pháp nhanh: "Tôi thêm chỉ mục bao phủ cho truy vấn chính và phân vùng bảng lớn nhất theo ngày. Thời gian chạy giảm từ 60 phút xuống 8 phút."
Giao tiếp và kết quả: "Tôi cập nhật cho PM vài giờ một lần để họ quản lý kỳ vọng với HĐQT nếu cần. Chúng tôi bàn giao báo cáo tối ưu sớm hai ngày và nó trở thành mẫu cho các báo cáo tương tự."
Bạn sẽ xử lý thế nào khi sự cố hiệu năng CSDL chỉ xảy ra thỉnh thoảng?
Thể hiện cách gỡ lỗi có hệ thống cho vấn đề gián đoạn:
- Thiết lập giám sát: "Tôi sẽ cấu hình giám sát thu thập chỉ số hiệu năng khi sự cố xảy ra - thời gian thực thi truy vấn, tài nguyên hệ thống, kết nối đồng thời."
- Thu thập dữ liệu: "Tôi bật ghi log truy vấn để xem những gì chạy khi hiệu năng giảm. Tôi cũng kiểm tra mẫu - có xảy ra vào giờ cụ thể, với người dùng nhất định, hay trong thao tác nào đó không?"
- Đưa ra giả thuyết: "Dựa trên dữ liệu, tôi đưa giả thuyết. Có thể là job định kỳ mỗi giờ, hoặc báo cáo nào đó khóa bảng."
- Cô lập và thử nghiệm: "Tôi cố tái hiện sự cố trong môi trường thử nghiệm với dữ liệu và mẫu truy vấn tương tự."
Ví dụ: "Tôi từng truy vết một vấn đề hiệu năng chỉ xảy ra sáng thứ Ba. Hóa ra job đồng bộ dữ liệu hàng tuần chạy trùng thời gian cao điểm người dùng, gây tranh chấp khóa."
Mô tả cách bạn xử lý yêu cầu truy cập CSDL từ người không thường làm việc với CSDL
Thể hiện nhận thức bảo mật và khả năng hướng dẫn.
Đánh giá nhu cầu: "Tôi sẽ hiểu trước họ muốn đạt điều gì. Thường có cách tốt hơn để lấy thông tin mà không cần truy cập trực tiếp."
Đưa ra lựa chọn thay thế để nhấn mạnh bảo mật: "Thay vì truy cập CSDL, tôi có thể tạo view chỉ đọc, xây dashboard, hoặc xuất dữ liệu họ cần thành CSV."
Nếu cần truy cập, bảo mật vẫn ưu tiên: "Tôi sẽ tạo tài khoản chỉ đọc với quyền giới hạn ở các bảng cần thiết. Tôi cũng hướng dẫn những thực hành SQL cơ bản và truy vấn nào có thể ảnh hưởng hiệu năng."
Đặt kỳ vọng: "Tôi giải thích tầm quan trọng của việc không chạy truy vấn tốn kém vào giờ cao điểm và yêu cầu họ trao đổi trước khi chạy tác vụ phức tạp."
Hãy mô tả cách bạn điều tra báo cáo về dữ liệu không nhất quán trong CSDL sản xuất
Thể hiện cách tiếp cận có hệ thống với vấn đề toàn vẹn dữ liệu:
- Đánh giá ban đầu: "Đầu tiên, tôi thu thập ví dụ cụ thể về sự không nhất quán. Dữ liệu nào sai, phát hiện khi nào, và đúng phải là gì?"
- Dựng lại dòng thời gian: "Tôi kiểm tra log CSDL, log ứng dụng và các triển khai gần đây để hiểu khi nào vấn đề có thể được đưa vào."
- Đánh giá phạm vi: "Tôi chạy truy vấn để xác định mức độ ảnh hưởng. Ảnh hưởng mọi bản ghi hay chỉ một số? Có mẫu theo thời gian, hành động người dùng, hay nguồn dữ liệu không?"
- Phân tích nguyên nhân gốc: "Tôi tìm các nguyên nhân khả dĩ - lỗi ứng dụng, giao dịch thất bại, lỗi nhập dữ liệu, hoặc vấn đề truy cập đồng thời."
- Kiểm soát ngay: "Nếu vấn đề đang diễn ra, tôi xác định và dừng quy trình gây ra nó. Với dữ liệu lịch sử, tôi xác định liệu có thể và an toàn để sửa hay không."
Ví dụ: "Tôi từng thấy đơn hàng khách có số lượng âm. Kiểm tra log ứng dụng cho thấy điều kiện tranh chấp trong quá trình cập nhật tồn kho. Chúng tôi sửa lỗi ứng dụng và hiệu chỉnh đơn bị ảnh hưởng bằng log giao dịch."
Mẹo chuẩn bị cho phỏng vấn DBMS
Cách tốt nhất để vượt qua phỏng vấn DBMS là thực hành với cơ sở dữ liệu thực, không chỉ học thuộc lý thuyết. Nhà tuyển dụng muốn thấy bạn giải quyết được vấn đề thực, không chỉ đọc lại định nghĩa.
Luyện SQL trên bộ dữ liệu thực
Đừng chỉ luyện các câu lệnh SELECT cơ bản - hãy làm việc với dữ liệu bẩn, đời thực.
Tải bộ dữ liệu từ Kaggle hoặc dùng CSDL công khai như Sakila cho MySQL. Luyện truy vấn phức tạp gồm nhiều join, truy vấn con và phép tổng hợp. Mục tiêu là thoải mái với các kịch bản bạn sẽ gặp khi làm việc.
Những truy vấn như thế này nên trở nên dễ dàng, và bạn không gặp khó khi giải thích bất kỳ phần nào:
SELECT
c.customer_id,
c.first_name,
c.last_name,
COUNT(r.rental_id) as total_rentals,
SUM(p.amount) as total_spent
FROM customer c
LEFT JOIN rental r ON c.customer_id = r.customer_id
LEFT JOIN payment p ON r.rental_id = p.rental_id
WHERE r.rental_date >= '2025-07-01'
GROUP BY c.customer_id, c.first_name, c.last_name
HAVING COUNT(r.rental_id) > 10
ORDER BY total_spent DESC;
Tự thiết lập môi trường CSDL
Cài đặt một hệ CSDL cục bộ và học cách nó thực sự hoạt động.
Chọn một trong các hệ phổ biến - PostgreSQL, MySQL hoặc SQL Server - và thiết lập bản cài cục bộ. Tạo bảng, chèn dữ liệu và thử nghiệm các cấu hình khác nhau. Học cách đọc kế hoạch thực thi, tạo chỉ mục và theo dõi hiệu năng.
Kinh nghiệm thực hành này sẽ giúp bạn trả lời câu hỏi về quản trị CSDL, không chỉ cú pháp SQL.
>Nếu bạn phỏng vấn cho vị trí Quản trị CSDL, bạn phải biết trả lời cho top 30 câu hỏi phỏng vấn DBA
Nghiên cứu các vấn đề hiệu năng thực
Học cách xác định và giải quyết các nút thắt hiệu năng phổ biến.
Dùng công cụ như EXPLAIN hoặc EXPLAIN ANALYZE để hiểu cách truy vấn thực thi:
EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 12345
AND order_date > '2023-01-01';
Luyện phát hiện quét bảng, thiếu chỉ mục và join kém hiệu quả. Tạo bộ dữ liệu lớn và xem các chiến lược khác nhau ảnh hưởng hiệu năng ra sao.
Hiểu kế hoạch thực thi là điểm khác biệt giữa lập trình viên junior và senior trong phỏng vấn.
Luyện thiết kế cơ sở dữ liệu
Làm các bài tập thiết kế lược đồ hoàn chỉnh, không chỉ từng bảng riêng lẻ.
Chọn các tình huống thực như trang thương mại điện tử, mạng xã hội hoặc hệ thống tồn kho. Thiết kế toàn bộ lược đồ, gồm quan hệ, ràng buộc, và chỉ mục. Nghĩ về cách thiết kế xử lý tăng trưởng và yêu cầu thay đổi.
Vẽ sơ đồ thực thể - quan hệ và sẵn sàng giải thích quyết định thiết kế. Nhà tuyển dụng hay hỏi "tại sao bạn chọn cách này thay vì cách khác?" Hãy chuẩn bị câu trả lời.
>Tôi khuyên bạn xem khóa Database Design để nâng tầm kiến thức.
Ôn cả khái niệm SQL và NoSQL
Ngay cả khi vai trò tập trung vào CSDL quan hệ, hãy hiểu khi nào NoSQL phù hợp.
Nắm cơ bản về kho tài liệu như MongoDB, kho key-value như Redis, và cơ sở dữ liệu cột như Cassandra. Hiểu đánh đổi giữa nhất quán và sẵn sàng trong hệ phân tán.
Điều này cho thấy bạn có thể nghĩ vượt qua một công nghệ và chọn đúng công cụ cho vấn đề.
>Khóa học NOSQL Concepts là điểm khởi đầu tuyệt vời.
Chuẩn bị câu chuyện về vấn đề CSDL thực
Nghĩ về các ví dụ cụ thể nơi bạn giải quyết thách thức CSDL.
Chuẩn bị 3-4 câu chuyện về lần bạn tối ưu truy vấn chậm, thiết kế lược đồ, di chuyển dữ liệu hoặc xử lý sự cố CSDL. Dùng phương pháp STAR - Tình huống, Nhiệm vụ, Hành động, Kết quả - để cấu trúc câu trả lời.
Luyện giải thích khái niệm kỹ thuật cho người không kỹ thuật. Nhà tuyển dụng thường hỏi bạn sẽ truyền đạt vấn đề CSDL cho bên kinh doanh thế nào.
Cập nhật xu hướng CSDL
Đọc về công nghệ và thực hành CSDL hiện đại.
Theo dõi blog, tham dự webinar hoặc tham gia cộng đồng CSDL. Biết về chủ đề như sharding, MVCC, cơ sở dữ liệu phân tán và dịch vụ CSDL trên đám mây.
Bạn không cần thành chuyên gia trong mọi thứ, nhưng nhận thức xu hướng hiện tại cho thấy bạn luôn gắn bó với lĩnh vực.
Tổng kết câu hỏi phỏng vấn DBMS
Phỏng vấn DBMS kiểm tra từ cú pháp SQL cơ bản đến quyết định thiết kế hệ thống phức tạp.
Để vượt qua, hãy nắm vững khái niệm nền tảng như chuẩn hóa, lập chỉ mục và giao dịch. Sau đó tiếp cận chủ đề nâng cao như sharding và thiết kế tính sẵn sàng cao. Lý thuyết thôi là chưa đủ - bạn phải liên hệ kiến thức CSDL với vấn đề kinh doanh thực.
Ứng viên tốt nhất liên kết khái niệm kỹ thuật với kết quả thực tiễn. Khi bạn giải thích chỉ mục, hãy nhắc cách chúng giảm thời gian truy vấn từ phút xuống giây. Khi thảo luận sao chép, hãy giải thích cách nó ngăn thời gian chết tốn kém.
Luyện giải thích khái niệm CSDL phức tạp một cách rõ ràng cho người không kỹ thuật. Chuẩn bị câu chuyện cụ thể về tối ưu hiệu năng, xử lý sự cố, hoặc thiết kế lược đồ với kết quả đo lường - "giảm 90% thời gian truy vấn" thuyết phục hơn "làm truy vấn nhanh hơn."
>Bên cạnh SQL và DBMS, sẽ rất hữu ích nếu bạn chuẩn bị cho câu hỏi phỏng vấn về Data Warehouse
Nắm vững cơ bản, thực hành với dữ liệu thực và luôn gắn kiến thức kỹ thuật với giá trị kinh doanh - đó là cách bạn thành công trong phỏng vấn DBMS. Luyện tập tạo nên sự hoàn hảo.
Để học các kỹ năng cơ bản về cơ sở dữ liệu và thiết kế CSDL, tôi khuyên dùng các khóa và tài liệu từ DataCamp sau:
Câu hỏi thường gặp
Những loại câu hỏi DBMS thường được hỏi trong phỏng vấn?
Phỏng vấn DBMS thường bao quát bốn mảng chính: khái niệm nền tảng như chuẩn hóa và thuộc tính ACID, cú pháp SQL và tối ưu truy vấn, câu hỏi thiết kế hệ thống về khả năng mở rộng và hiệu năng, và kịch bản hành vi về xử lý vấn đề CSDL thực tế. Câu hỏi cơ bản kiểm tra hiểu biết nguyên lý cốt lõi, trong khi câu hỏi trung cấp tập trung vào kỹ năng SQL thực hành và tinh chỉnh hiệu năng. Câu hỏi nâng cao đánh giá khả năng bạn thiết kế hệ thống CSDL ở quy mô lớn và xử lý quyết định kiến trúc phức tạp.
Là người mới, tôi nên chuẩn bị câu hỏi phỏng vấn DBMS như thế nào?
Bắt đầu bằng việc nắm vững nền tảng SQL - câu lệnh SELECT, join, phép tổng hợp và các nguyên tắc thiết kế CSDL cơ bản như chuẩn hóa. Luyện viết truy vấn trên bộ dữ liệu thực bằng các nền tảng như SQLBolt hoặc W3Schools, và thiết lập môi trường CSDL cục bộ để có trải nghiệm thực hành. Tập trung vào hiểu vì sao các khái niệm CSDL tồn tại thay vì chỉ học thuộc cú pháp - điều đó giúp bạn giải thích lập luận trong phỏng vấn.
Khác biệt khi chuẩn bị cho vai trò DBMS junior và senior là gì?
Vị trí junior tập trung nhiều vào cú pháp SQL, khái niệm CSDL cơ bản và tuân theo thiết kế có sẵn. Vị trí senior nhấn mạnh thiết kế hệ thống, tối ưu hiệu năng, xử lý sự cố CSDL và ra quyết định kiến trúc về sharding, sao chép và chiến lược mở rộng. Ứng viên senior cần chứng minh kinh nghiệm với thách thức CSDL thực và khả năng giao tiếp với cả đối tượng kỹ thuật lẫn phi kỹ thuật.
Tôi có nên học thuộc cú pháp SQL cụ thể cho từng hệ CSDL không?
Đừng học thuộc mọi biến thể cú pháp trên các hệ CSDL khác nhau - hãy tập trung vào hiểu các khái niệm SQL cốt lõi hoạt động xuyên nền tảng. Đa số phỏng vấn dùng cú pháp SQL chuẩn, và nhà tuyển dụng hiểu rằng chi tiết cú pháp cụ thể có thể tra cứu khi làm việc. Thay vào đó, luyện giải thích logic truy vấn và cách bạn tiếp cận giải quyết vấn đề.
Tôi xử lý câu hỏi DBMS về công nghệ mình chưa dùng thế nào?
Hãy trung thực về mức độ kinh nghiệm của bạn, nhưng thể hiện khả năng học hỏi và thích nghi. Giải thích các khái niệm bạn nắm và liên hệ với công nghệ bạn từng dùng. Ví dụ, nếu bị hỏi về MongoDB nhưng bạn chỉ biết MySQL, hãy bàn về khác biệt chung giữa CSDL tài liệu và quan hệ. Thể hiện sự tò mò bằng cách hỏi làm rõ và giải thích cách bạn sẽ tiếp cận học công nghệ mới.
