运行大型语言模型确实要花钱。您需要为每个处理的 token、每次 GPU 计算以及为模型增加的每一层复杂性买单。即使价格有所下降,当您处理大型应用、冗长的提示或频繁的更新时,账单仍会迅速攀升。
我见过这种情况多么快就会变成问题。团队以为成本会保持可控,却发现自己把预算烧在过大的模型、低效的提示或闲置的硬件上。
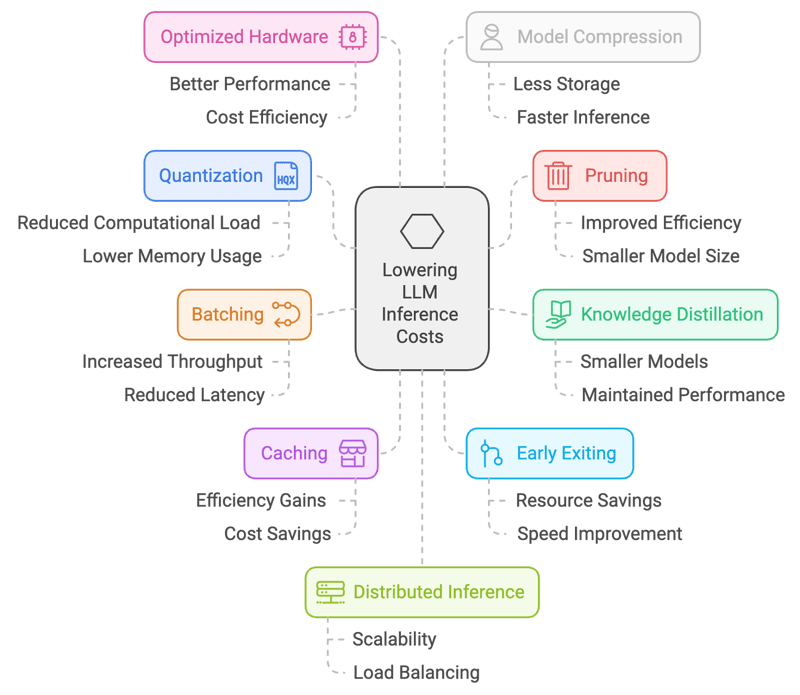
这就是我整理出10 种切实可行的推理降本方法的原因。从量化和剪枝到批处理、缓存与提示工程,这些都是我实际会用来在不牺牲太多性能的情况下,让 LLM 更加经济的做法。
1. 量化(Quantization)
量化是将模型权重与激活的数值精度降低的过程,通常从 32 位浮点数降为更低位表示(如 16 位甚至 8 位)。这能减少内存占用与计算需求,使资源受限设备上的推理更快。
实现方式:
- 训练后量化(PTQ):将预训练模型的权重量化到更低精度(如 8 位整数),无需再训练。实现相对简单,但可能带来一定精度损失。
- 量化感知训练(QAT):在训练过程中使用量化技术对模型进行微调,从而更好地保持精度。
收益:
- 更小的模型体积:带来更快的加载时间和更少的内存占用,特别是在按资源计费的云环境中能显著降低成本。
- 更快的推理:数值更小,计算更快,响应时间更短。
主要权衡在于潜在的精度损失。尽管现代量化技术已经相当成熟,但准确率仍可能略有下降。
2. 剪枝(Pruning)
剪枝通过移除神经网络中不重要或冗余的权重来精简模型。去掉对性能影响最小的连接,能降低模型体积与计算复杂度,从而加速推理。
实现方式:
- 非结构化剪枝:按权重的幅度或重要性移除单个权重。
- 结构化剪枝:移除整个通道或滤波器,得到更规整的模型结构,更利于硬件高效执行。
收益:
- 更小的模型体积:与量化类似,剪枝能让模型更小、加载更快。
- 减少计算量:连接更少,推理时的计算也更少,响应更快。
与量化类似,主要权衡在于潜在的精度损失。过度剪枝可能明显降低性能,关键在于把握好度。
3. 知识蒸馏(Knowledge Distillation)
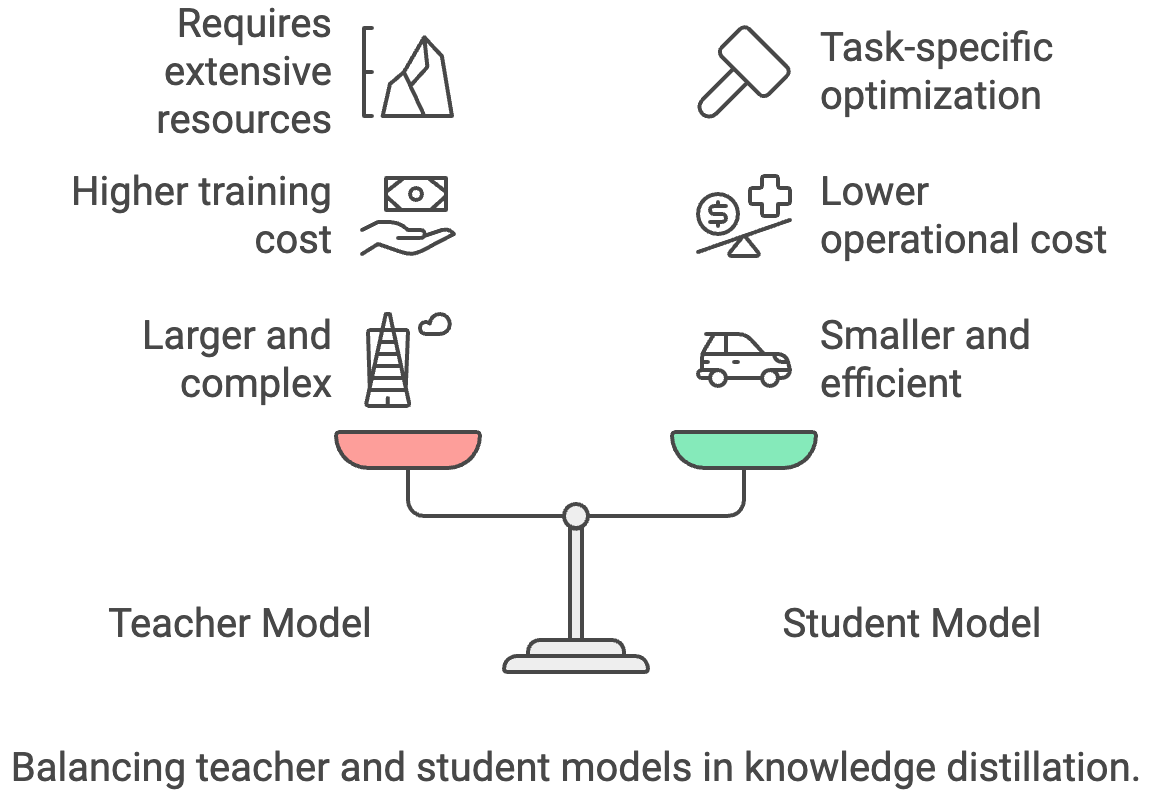
知识蒸馏是将大型、复杂的“教师”模型的知识迁移到更小、更高效的“学生”模型的过程。学生模型学习模仿教师的行为,从而以更小的体积实现接近的性能,并获得更快的推理速度。
实现方式:
- 训练更小的学生模型:使用大型教师模型的输出(logits 或软标签)作为学生模型的额外训练信号。
- 温度缩放:在蒸馏时调整温度参数,控制教师输出分布的“柔和度”。
收益:
- 显著更小的模型:学生模型通常能比教师模型小很多、快很多,从而带来可观的成本节省。
- 面向任务的优化:您可以针对特定任务微调学生模型,使其更高效。
主要权衡在于需要使用强大的教师模型,其训练或使用成本可能很高。
4. 批处理(Batching)
批处理是在推理时将多个输入样本一起作为一个批次并行处理。通过利用硬件的并行能力提升效率,从而加快整体推理速度。
实现方式:
- 聚合请求:收集多个推理请求并一并处理为一个批次。
- 动态批处理:根据传入请求速率动态调整批大小,以平衡时延与吞吐。
收益:
- 提升吞吐:批处理可大幅提高每秒处理的请求数量,让应用更高效。
- 更好地利用硬件:GPU 天生适合并行处理,批处理能充分发挥其能力。
不过,批处理可能为单个请求引入额外时延,因为系统可能会等待积累足够输入再处理。对于实时或低时延应用,若未精心调优,这种延迟会影响体验。动态批处理有助缓解,但会增加系统复杂度。流量不均时也存在批处理效率低的风险,从而削弱预期的降本效果。
5. 缓存(Caching)
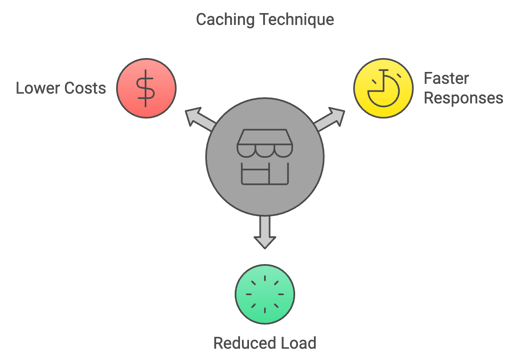
缓存是在推理时存储先前计算结果,并在遇到相同输入时复用,从而避免重复计算并加速推理。
实现方式:
- 存储历史计算:维护一个缓存,记录过往输入及其对应的输出。
- 缓存淘汰策略:在缓存达到容量上限时,移除使用频率较低的条目。
收益:
- 重复请求响应更快:对于频繁出现相同或相似请求的应用,缓存效果极佳。
- 降低计算负载:计算更少,成本更低。
然而,缓存只在输入重复或重叠时有效。在高度多变的工作负载下,命中率可能偏低,而维护缓存的开销可能超过收益。若缓存的结果过时,也会出现一致性问题。此外,实施与调优淘汰策略会提升工程复杂度,尤其在分布式系统中,缓存同步更具挑战。
6. 提前退出(Early Exiting)
提前退出是在推理过程中,当模型对其预测足够有信心时提前停止计算。对于不需要完整前向传播的简单情形,这能节省算力并加速推理。
实现方式:
- 置信度阈值:为模型预测设置置信度阈值。如果在中间层置信度超过阈值,则停止计算并返回当前输出。
- 自适应提前退出:根据输入或模型层次动态调整阈值,以平衡速度与精度。
收益:
- 简单样例更快推理:若模型较早即可做出有把握的预测,便能节省时间与算力。
- 降低成本:计算更少,成本更低。
权衡在于,对于复杂输入,提前退出可能导致精度略降。
7. 优化硬件(Optimized Hardware)
指使用为高效 AI 计算而设计的专用硬件架构与加速器,包括 GPU、TPU 以及其他专用 AI 芯片。与通用 CPU 相比,它们在推理任务上能显著提升性能。
实现方式:
- GPU:利用 GPU 在矩阵运算与神经网络计算上的并行能力。
- TPU:使用为 AI 负载专门设计的张量处理单元。
- 其他 AI 加速器:探索如 FPGA 或专用 AI 芯片等新兴硬件选项。
收益:
- 显著更快的推理:针对 LLM 计算,GPU 与专用芯片远快于 CPU。
- 更高的能效:从长期来看可降低能源成本。
不过,专用硬件通常需要较高的前期投入,且可能将您锁定在特定厂商生态中。GPU、TPU 或定制加速器在云端高峰期也可能难以持续供给。本地部署带来维护与扩展挑战,而云端租用的持续成本也更高。最后,为充分利用专用硬件对软件进行适配会增加工程复杂度并需要持续优化。
8. 模型压缩(Model Compression)
模型压缩是指综合使用多种技术在不显著影响性能的前提下,减少模型的大小与复杂度。这可以包含剪枝、量化、知识蒸馏或其他方法,以构建更紧凑高效、推理更快的模型。
实现方式:
- 组合多种技术:将量化、剪枝、知识蒸馏等方法组合使用,实现最优的模型缩减效果。
- 张量分解:将大的权重矩阵分解为更小、更高效的表示。
收益:
- 更小的模型体积:带来更快加载、更少内存占用,并有望降低成本。
若过于激进或缺乏细致调优,模型压缩可能导致精度下降。将剪枝、量化与蒸馏等方法叠加会增加系统复杂度,并可能需要额外的再训练或微调周期。压缩后的模型在迁移到新任务时也可能不够灵活,因为这些优化往往缩窄了模型表现良好的场景范围。在某些情况下,用于压缩的工程时间与计算开销会抵消短期的成本节省。
9. 分布式推理(Distributed Inference)
分布式推理是将推理工作负载划分到多台机器或设备上进行。这可以并行处理大规模推理任务,降低时延并提升吞吐。
实现方式:
- 模型切分:将模型划分到多台机器上,每台负责一部分计算。
- 负载均衡:将传入请求分配到可用机器上,以确保资源高效利用。
收益:
- 应对更大的模型与更高的流量:分布式推理可将大型任务拆解到多台机器并行处理,同时承载更大的模型与更多请求。这样能提升硬件效率,并在云端实现灵活扩缩,从而节约成本。
分布式推理会显著提高系统复杂度:跨机器协调计算需要稳健的编排、同步与容错机制。当需要交换大量中间数据时,网络时延与带宽限制可能抵消性能收益。基础设施成本也会上升,因为需要配置并维护额外的硬件与负载均衡机制。相比单机系统,分布式系统的调试与监控更困难,可靠性保障更具挑战。
10. 提示工程(Prompt Engineering)
提示工程是精心设计输入提示,引导大型语言模型(LLM)生成期望输出的过程。通过清晰、简明、具体的提示,用户可以提升 LLM 响应的质量与可控性,使其更贴合特定任务。
实现方式:
- 清晰简明:在提示中使用具体且不含歧义的语言。
- 提供上下文:包含相关背景信息或示例,以引导 LLM。
- 试验与迭代:测试不同的提示表述并评估结果,找到最有效的方案。
收益:
- 更相关、更精炼的输出:良好的提示工程可减少模型需要生成的 token 数,从而加快推理并有望降低成本。
- 更高的准确性:清晰的提示能帮助模型避免误解,生成更准确的回应。
提示工程需要持续试验与迭代,既耗时,又可能在不同用例间不一致。精心设计的提示未必具备通用性,一旦任务或模型变化,可能需要重新设计。提示改进也可能较为脆弱——轻微的措辞变化或模型更新都可能不可预测地改变结果。最后,若过度依赖提示工程而缺少上下文管理或微调等配套技术,扩展性与长期降本空间都会受限。
加分项:上下文工程(Context Engineering)
上下文工程是指设计系统来控制 LLM 在生成回复前所能看到的信息。与其把所有内容都塞进上下文窗口,不如只选择并组织最相关的细节——例如用户历史、检索到的文档或工具输出——以便模型更高效地推理。
实现方式:
- 上下文摘要:将累积的会话历史或文档压缩为更短的摘要,在减少 token 的同时保留含义。
- 工具载荷管理:使用检索系统只选择最相关的工具或描述,而不是传入所有可用选项。
- 上下文剪除:随着新数据到来,移除过时或冗余信息,保持活跃上下文精炼而有用。
- 上下文校验与隔离:在长时记忆遭到污染前,检测并隔离幻觉或错误。
收益:
- 更少的 token 使用:更短、更聚焦的上下文可减少处理的 token 数,直接降低成本。
- 更高的准确性:更干净的上下文让模型不易被无关或相互矛盾的细节干扰或误导。
- 更快的推理:token 更少、KV 缓存更稳定,请求完成更快,从而节省算力资源。
权衡在于,构建有效的上下文系统需要前期工程投入。您需要检索、摘要与校验流水线;糟糕的设计会造成上下文缺口,影响性能。但若做好了,上下文工程能让大型应用既更可靠也更经济。
结语
降低 LLM 推理成本并非一招制胜,而是要结合适合您工作负载的多种方法。量化、剪枝与知识蒸馏可缩小模型体积;批处理、缓存与分布式推理可优化请求处理方式;硬件选择与模型压缩进一步提升效率;而提示工程与上下文工程从源头减少不必要的 token 使用。
权衡是真实存在的:每种方法都会带来复杂性、潜在的精度损失或基础设施开销。但收益是可累积的。即便只应用其中几种技术,您也能让模型更可负担、在不失控的成本下扩大使用规模,并在模型与应用不断增长时,构建更可持续的系统。


运行大型语言模型确实要花钱。您需要为每个处理的 token、每次 GPU 计算以及为模型增加的每一层复杂性买单。即使价格有所下降,当您处理大型应用、冗长的提示或频繁的更新时,账单仍会迅速攀升。
我见过这种情况多么快就会变成问题。团队以为成本会保持可控,却发现自己把预算烧在过大的模型、低效的提示或闲置的硬件上。
这就是我整理出10 种切实可行的推理降本方法的原因。从量化和剪枝到批处理、缓存与提示工程,这些都是我实际会用来在不牺牲太多性能的情况下,让 LLM 更加经济的做法。
1. 量化(Quantization)
量化是将模型权重与激活的数值精度降低的过程,通常从 32 位浮点数降为更低位表示(如 16 位甚至 8 位)。这能减少内存占用与计算需求,使资源受限设备上的推理更快。
实现方式:
收益:
主要权衡在于潜在的精度损失。尽管现代量化技术已经相当成熟,但准确率仍可能略有下降。
2. 剪枝(Pruning)
剪枝通过移除神经网络中不重要或冗余的权重来精简模型。去掉对性能影响最小的连接,能降低模型体积与计算复杂度,从而加速推理。
实现方式:
收益:
与量化类似,主要权衡在于潜在的精度损失。过度剪枝可能明显降低性能,关键在于把握好度。
3. 知识蒸馏(Knowledge Distillation)
知识蒸馏是将大型、复杂的“教师”模型的知识迁移到更小、更高效的“学生”模型的过程。学生模型学习模仿教师的行为,从而以更小的体积实现接近的性能,并获得更快的推理速度。
实现方式:
收益:
主要权衡在于需要使用强大的教师模型,其训练或使用成本可能很高。
4. 批处理(Batching)
批处理是在推理时将多个输入样本一起作为一个批次并行处理。通过利用硬件的并行能力提升效率,从而加快整体推理速度。
实现方式:
收益:
不过,批处理可能为单个请求引入额外时延,因为系统可能会等待积累足够输入再处理。对于实时或低时延应用,若未精心调优,这种延迟会影响体验。动态批处理有助缓解,但会增加系统复杂度。流量不均时也存在批处理效率低的风险,从而削弱预期的降本效果。
5. 缓存(Caching)
缓存是在推理时存储先前计算结果,并在遇到相同输入时复用,从而避免重复计算并加速推理。
实现方式:
收益:
然而,缓存只在输入重复或重叠时有效。在高度多变的工作负载下,命中率可能偏低,而维护缓存的开销可能超过收益。若缓存的结果过时,也会出现一致性问题。此外,实施与调优淘汰策略会提升工程复杂度,尤其在分布式系统中,缓存同步更具挑战。
6. 提前退出(Early Exiting)
提前退出是在推理过程中,当模型对其预测足够有信心时提前停止计算。对于不需要完整前向传播的简单情形,这能节省算力并加速推理。
实现方式:
收益:
权衡在于,对于复杂输入,提前退出可能导致精度略降。
7. 优化硬件(Optimized Hardware)
指使用为高效 AI 计算而设计的专用硬件架构与加速器,包括 GPU、TPU 以及其他专用 AI 芯片。与通用 CPU 相比,它们在推理任务上能显著提升性能。
实现方式:
收益:
不过,专用硬件通常需要较高的前期投入,且可能将您锁定在特定厂商生态中。GPU、TPU 或定制加速器在云端高峰期也可能难以持续供给。本地部署带来维护与扩展挑战,而云端租用的持续成本也更高。最后,为充分利用专用硬件对软件进行适配会增加工程复杂度并需要持续优化。
8. 模型压缩(Model Compression)
模型压缩是指综合使用多种技术在不显著影响性能的前提下,减少模型的大小与复杂度。这可以包含剪枝、量化、知识蒸馏或其他方法,以构建更紧凑高效、推理更快的模型。
实现方式:
收益:
若过于激进或缺乏细致调优,模型压缩可能导致精度下降。将剪枝、量化与蒸馏等方法叠加会增加系统复杂度,并可能需要额外的再训练或微调周期。压缩后的模型在迁移到新任务时也可能不够灵活,因为这些优化往往缩窄了模型表现良好的场景范围。在某些情况下,用于压缩的工程时间与计算开销会抵消短期的成本节省。
9. 分布式推理(Distributed Inference)
分布式推理是将推理工作负载划分到多台机器或设备上进行。这可以并行处理大规模推理任务,降低时延并提升吞吐。
实现方式:
收益:
分布式推理会显著提高系统复杂度:跨机器协调计算需要稳健的编排、同步与容错机制。当需要交换大量中间数据时,网络时延与带宽限制可能抵消性能收益。基础设施成本也会上升,因为需要配置并维护额外的硬件与负载均衡机制。相比单机系统,分布式系统的调试与监控更困难,可靠性保障更具挑战。
10. 提示工程(Prompt Engineering)
提示工程是精心设计输入提示,引导大型语言模型(LLM)生成期望输出的过程。通过清晰、简明、具体的提示,用户可以提升 LLM 响应的质量与可控性,使其更贴合特定任务。
实现方式:
收益:
提示工程需要持续试验与迭代,既耗时,又可能在不同用例间不一致。精心设计的提示未必具备通用性,一旦任务或模型变化,可能需要重新设计。提示改进也可能较为脆弱——轻微的措辞变化或模型更新都可能不可预测地改变结果。最后,若过度依赖提示工程而缺少上下文管理或微调等配套技术,扩展性与长期降本空间都会受限。
加分项:上下文工程(Context Engineering)
上下文工程是指设计系统来控制 LLM 在生成回复前所能看到的信息。与其把所有内容都塞进上下文窗口,不如只选择并组织最相关的细节——例如用户历史、检索到的文档或工具输出——以便模型更高效地推理。
实现方式:
收益:
权衡在于,构建有效的上下文系统需要前期工程投入。您需要检索、摘要与校验流水线;糟糕的设计会造成上下文缺口,影响性能。但若做好了,上下文工程能让大型应用既更可靠也更经济。
结语
降低 LLM 推理成本并非一招制胜,而是要结合适合您工作负载的多种方法。量化、剪枝与知识蒸馏可缩小模型体积;批处理、缓存与分布式推理可优化请求处理方式;硬件选择与模型压缩进一步提升效率;而提示工程与上下文工程从源头减少不必要的 token 使用。
权衡是真实存在的:每种方法都会带来复杂性、潜在的精度损失或基础设施开销。但收益是可累积的。即便只应用其中几种技术,您也能让模型更可负担、在不失控的成本下扩大使用规模,并在模型与应用不断增长时,构建更可持续的系统。