Het draaien van large language models brengt echte kosten met zich mee. Je betaalt voor elke verwerkte token, elke gebruikte GPU-cyclus en elke extra laag complexiteit die aan een model wordt toegevoegd. Ook al zijn de prijzen gedaald, de rekening loopt nog steeds snel op als je werkt met grote applicaties, lange prompts of frequente updates.
Ik heb gezien hoe snel dit een probleem kan worden. Teams gaan ervan uit dat de kosten beheersbaar blijven, om er vervolgens achter te komen dat ze budget verbranden aan te grote modellen, inefficiënte prompts of stilstaande hardware.
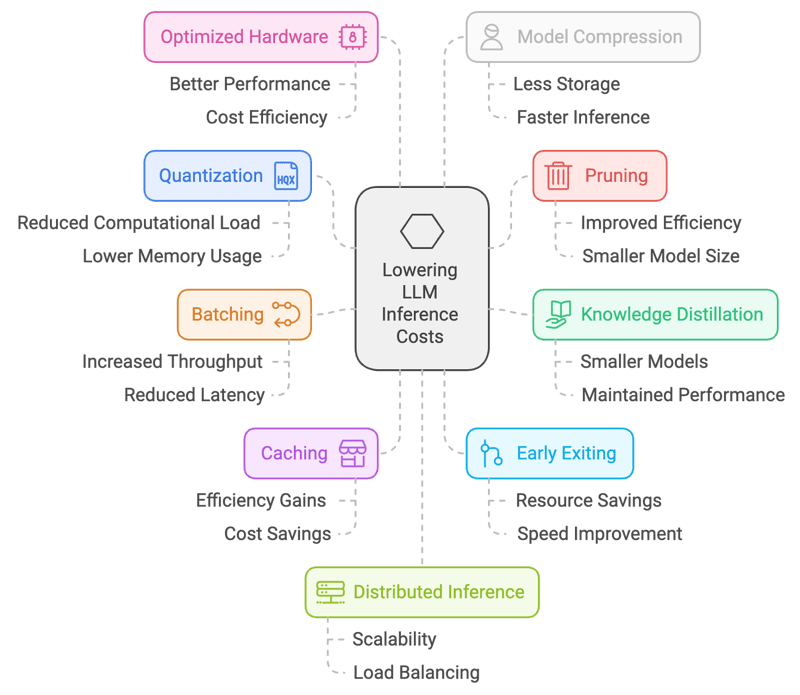
Daarom heb ik 10 praktische manieren om inferencekosten te verlagen bijeengebracht. Van quantization en pruning tot batching, caching en prompt engineering: dit zijn aanpakken die ik daadwerkelijk gebruik om LLM’s betaalbaar te houden zonder al te veel prestatieverlies.
1. Quantization
Quantization is het proces waarbij je de precisie van modelgewichten en activaties verlaagt, meestal van 32-bits drijvende-kommagetallen naar representaties met minder bits (bijv. 16-bits of zelfs 8-bits). Dit verkleint de geheugenvraag en rekenlast, waardoor inference sneller verloopt op apparaten met beperkte middelen.
Zo pak je het aan:
- Post-training quantization (PTQ): Zet de gewichten van een voorgetraind model om naar lagere precisie (bijv. 8-bits integers) zonder opnieuw te trainen. Dit is relatief eenvoudig, maar kan tot enig nauwkeurigheidsverlies leiden.
- Quantization-aware training (QAT): Fijn-afstemmen van het model met quantizationtechnieken tijdens het trainen, zodat de nauwkeurigheid beter behouden blijft.
Wat het oplevert:
- Kleiner model: Dit betekent snellere laadtijden en minder geheugengebruik, wat kosten aanzienlijk kan verlagen, vooral in cloudomgevingen waar je voor verbruikte resources betaalt.
- Snellere inference: Met kleinere getallen worden berekeningen sneller, wat tot kortere responstijden leidt.
De belangrijkste afweging is mogelijk nauwkeurigheidsverlies. Moderne quantizationtechnieken zijn behoorlijk goed, maar er is altijd kans op een lichte daling in modelnauwkeurigheid.
2. Pruning
Pruning is een techniek waarbij minder belangrijke of redundante gewichten uit een neuraal netwerk worden verwijderd. Door verbindingen te schrappen die weinig impact hebben op de modelprestaties, verklein je het model en verlaag je de rekenscomplexiteit, wat tot snellere inference leidt.
Zo pak je het aan:
- Unstructured pruning: Verwijdert individuele gewichten op basis van hun grootte of belangrijkheid.
- Structured pruning: Verwijdert complete kanalen of filters, wat leidt tot regelmatiger modelstructuren die efficiënter op hardware kunnen worden uitgevoerd.
Wat het oplevert:
- Kleiner model: Net als bij quantization resulteert pruning in een kleiner model dat sneller laadt.
- Minder berekeningen: Minder verbindingen betekent minder berekeningen tijdens inference, wat tot snellere reacties leidt.
Net als bij quantization is de belangrijkste afweging mogelijk nauwkeurigheidsverlies. Agressieve pruning kan tot merkbare prestatieafname leiden. Het is cruciaal de juiste balans te vinden.
3. Knowledge Distillation
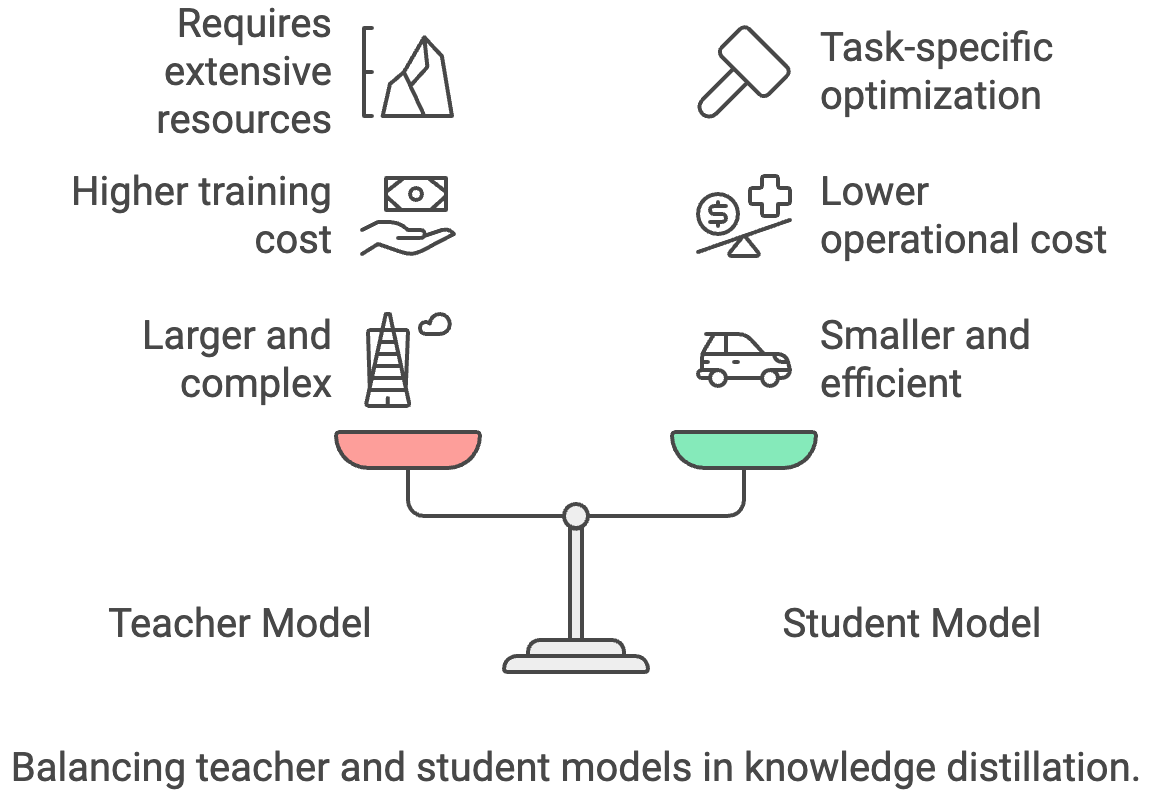
Knowledge distillation is het proces waarbij je kennis overdraagt van een groot, complex “teacher”-model naar een kleiner, efficiënter “student”-model. Het studentmodel leert het gedrag van de teacher na te bootsen en kan zo vergelijkbare prestaties leveren met een kleinere omvang en snellere inference.
Zo pak je het aan:
- Train een kleiner studentmodel: Gebruik de outputs (logits of zachte labels) van het grotere teachermodel als extra trainingssignalen voor het studentmodel.
- Temperatuurschaal: Pas de temperatuurparameter tijdens distillatie aan om de “zachtheid” van de outputverdeling van de teacher te sturen.
Wat het oplevert:
- Fors kleiner model: Studentmodellen kunnen aanzienlijk kleiner en sneller zijn dan hun teachers, wat grote kostenbesparingen oplevert.
- Taakspecifieke optimalisatie: Je kunt het studentmodel fijn-afstemmen voor een bepaalde taak, waardoor het nog efficiënter wordt.
De belangrijkste afweging is dat je toegang nodig hebt tot een krachtig teachermodel, wat duur kan zijn om te trainen of te gebruiken.
4. Batching
Batching houdt in dat je meerdere invoer-samples tegelijk in één batch verwerkt tijdens inference. Dit verbetert de efficiëntie door optimaal gebruik te maken van de parallelle verwerkingsmogelijkheden van de hardware, wat tot snellere totale inference leidt.
Zo pak je het aan:
- Verzoeken accumuleren: Verzamel meerdere inferentieverzoeken en verwerk ze samen als één batch.
- Dynamische batching: Pas de batchgrootte dynamisch aan op basis van de instroomsnelheid van verzoeken om latentie en throughput in balans te brengen.
Wat het oplevert:
- Verbeterde throughput: Batching kan het aantal verzoeken per seconde flink opschroeven, waardoor je applicatie efficiënter wordt.
- Betere hardwarebenutting: GPU’s zijn gemaakt voor parallelle verwerking en batching helpt je daar optimaal van te profiteren.
Batching kan echter extra latentie voor individuele verzoeken introduceren, omdat het systeem mogelijk wacht om genoeg inputs te verzamelen voordat er wordt verwerkt. Voor real-time of low-latency applicaties kan die vertraging de gebruikerservaring aantasten als je niet zorgvuldig afstemt. Dynamische batching helpt dit te beperken, maar voegt systeemcomplexiteit toe. Er is ook het risico op inefficiënte batching bij wisselende verkeerspatronen, wat de verwachte kostenbesparing kan verminderen.
5. Caching
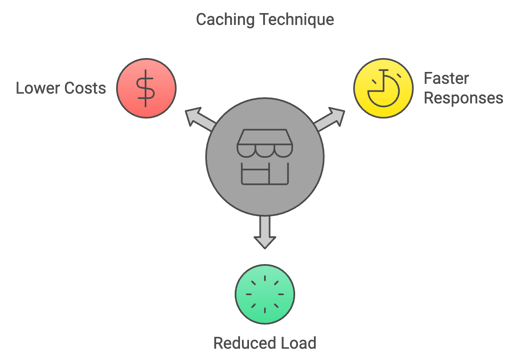
Caching is een techniek waarbij je de resultaten van eerdere berekeningen opslaat en hergebruikt wanneer tijdens inference dezelfde inputs opnieuw voorkomen. Dit voorkomt dubbele berekeningen en versnelt zo het inferenceproces.
Zo pak je het aan:
- Eerdere berekeningen opslaan: Onderhoud een cache met eerdere inputs en de bijbehorende outputs.
- Cache-evictionbeleid: Implementeer strategieën om minder vaak gebruikte items te verwijderen wanneer de cache zijn limiet bereikt.
Wat het oplevert:
- Snellere reacties bij herhaalde verzoeken: Caching is ontzettend effectief voor applicaties waarin dezelfde of vergelijkbare verzoeken vaak terugkomen.
- Lagere rekenlast: Minder berekeningen betekent lagere kosten.
Caching is echter alleen nuttig wanneer inputs zich herhalen of overlappen. Bij zeer variabele workloads kunnen hitrates laag zijn en kan de overhead van cachebeheer de voordelen overtreffen. Verouderde resultaten kunnen ook voor inconsistenties zorgen als cached outputs niet langer de meest relevante data weerspiegelen. Bovendien brengt het implementeren en afstemmen van evictionstrategieën extra engineeringcomplexiteit met zich mee, zeker in gedistribueerde systemen waar cachesynchronisatie een uitdaging is.
6. Early Exiting
Early Exiting houdt in dat je de berekening tijdens inference vroegtijdig stopt als het model voldoende zeker is van zijn voorspelling. Dit spaart rekenresources en versnelt inference voor eenvoudigere gevallen waarbij een volledige forward pass niet nodig is.
Zo pak je het aan:
- Drempel voor vertrouwen: Stel een drempel in voor het vertrouwen van het model in zijn voorspelling. Als het vertrouwen die drempel overschrijdt op een tussentijdse laag, stop je de berekening en retourneer je de huidige output.
- Adaptieve early exiting: Pas de drempel dynamisch aan op basis van de input of de modellayer om snelheid en nauwkeurigheid in balans te brengen.
Wat het oplevert:
- Snellere inference bij makkelijke gevallen: Als het model vroegtijdig met vertrouwen kan voorspellen, bespaar je tijd en rekenwerk.
- Lagere kosten: Minder berekeningen betekent lagere kosten.
De afweging is dat early exiting in sommige gevallen tot iets lagere nauwkeurigheid kan leiden, vooral bij complexe inputs.
7. Geoptimaliseerde hardware
Deze techniek draait om het benutten van gespecialiseerde hardware-architecturen en accelerators die zijn ontworpen voor efficiënte AI-berekeningen. Denk aan GPU’s, TPU’s en andere dedicated AI-chips die voor inferencetaken aanzienlijke prestatieverbeteringen bieden ten opzichte van algemene CPU’s.
Zo pak je het aan:
- GPU’s: Profiteer van de parallelle verwerkingscapaciteiten van GPU’s voor matrixbewerkingen en neurale netwerkberekeningen.
- TPU’s: Gebruik gespecialiseerde tensor processing units die specifiek voor AI-workloads zijn ontworpen.
- Andere AI-accelerators: Verken opkomende hardwareopties zoals FPGA’s of dedicated AI-chips.
Wat het oplevert:
- Aanzienlijk snellere inference: GPU’s en gespecialiseerde chips zijn veel sneller dan CPU’s voor de berekeningen die LLM’s nodig hebben.
- Betere energie-efficiëntie: Dit vertaalt zich op de lange termijn in lagere energiekosten.
Gespecialiseerde hardware vereist echter vaak een flinke investering vooraf en kan je vastzetten in een bepaald leveranciersecosysteem. GPU’s, TPU’s of maatwerkaccelerators zijn in de cloud soms ook lastig consistent te reserveren, vooral bij piekvraag. On-premises implementaties brengen onderhouds- en schaaluitdagingen met zich mee, terwijl cloudopties hogere doorlopende huurlasten kunnen hebben. Tot slot kan het aanpassen van software om gespecialiseerde hardware volledig te benutten extra engineeringcomplexiteit en voortdurende optimalisatie vereisen.
8. Modelcompressie
Modelcompressie betekent dat je meerdere technieken gebruikt om de grootte en complexiteit van een model te verkleinen zonder de prestaties noemenswaardig aan te tasten. Dit kan pruning, quantization, knowledge distillation of andere methoden omvatten die gericht zijn op een compacter en efficiënter model met snellere inference.
Zo pak je het aan:
- Combineer meerdere technieken: Pas een combinatie toe van quantization, pruning, knowledge distillation en andere methoden om optimale verkleining van het model te bereiken.
- Tensordecompositie: Splits grote gewichtsmatrices op in kleinere, efficiëntere representaties.
Wat het oplevert:
- Kleiner model: Dit betekent sneller laden, minder geheugenverbruik en mogelijk lagere kosten.
Modelcompressie kan tot nauwkeurigheidsverlies leiden als technieken te agressief of zonder zorgvuldige afstemming worden toegepast. Het combineren van methoden zoals pruning, quantization en distillation verhoogt de systeemcomplexiteit en kan extra retraining of fine-tuning vereisen. Gecomprimeerde modellen zijn soms minder flexibel bij overdracht naar nieuwe taken, omdat optimalisaties het toepassingsbereik kunnen vernauwen. In sommige gevallen kunnen de bestede engineeringstijd en rekenkosten aan compressie kortetermijnbesparingen tenietdoen.
9. Gedistribueerde inference
Gedistribueerde inference verdeelt de inferentielast over meerdere machines of apparaten. Dit maakt parallelle verwerking van grootschalige inferencetaken mogelijk, met lagere latentie en hogere throughput als resultaat.
Zo pak je het aan:
- Modelpartitionering: Verdeel het model over meerdere machines, die elk een deel van de berekening uitvoeren.
- Load balancing: Verdeel binnenkomende verzoeken over beschikbare machines voor efficiënte resourcebenutting.
Wat het oplevert:
- Grotere modellen en meer verkeer aan: Met gedistribueerde inference kun je grote taken opsplitsen over meerdere machines, waardoor je grotere modellen en meer verzoeken tegelijk aankunt. Dit maakt hardware efficiënter en biedt flexibele schaalbaarheid in de cloud, wat samen tot kostenbesparing leidt.
Gedistribueerde inference introduceert aanzienlijke systeemcomplexiteit, omdat coördinatie over meerdere machines robuuste orkestratie, synchronisatie en fouttolerantie vereist. Netwerklatentie en bandbreedtebeperkingen kunnen prestatievoordelen tenietdoen, vooral wanneer veel tussentijdse data moet worden uitgewisseld. De infrastructuurkosten stijgen ook, omdat extra hardware en load-balancingmechanismen moeten worden ingericht en onderhouden. Debuggen en monitoren van gedistribueerde systemen is lastiger, waardoor betrouwbaarheid een grotere uitdaging is dan bij single-node setups.
10. Prompt engineering
Prompt engineering is het zorgvuldig opstellen van inputprompts om large language models (LLM’s) aan te sturen richting gewenste outputs. Door duidelijke, beknopte en specifieke prompts te formuleren, kun je de kwaliteit en stuurbaarheid van LLM-antwoorden verbeteren, zodat ze relevanter en bruikbaarder zijn voor specifieke taken.
Zo pak je het aan:
- Wees duidelijk en beknopt: Gebruik specifieke en ondubbelzinnige taal in je prompts.
- Bied context: Voeg relevante achtergrondinformatie of voorbeelden toe om de LLM te sturen.
- Experimenteer en itereren: Test verschillende promptformuleringen en evalueer de resultaten om de meest effectieve te vinden.
Wat het oplevert:
- Meer relevante en beknopte outputs: Goede prompt engineering kan het aantal tokens dat het model moet genereren verminderen, wat tot snellere en mogelijk goedkopere inference leidt.
- Verbeterde nauwkeurigheid: Duidelijke prompts helpen misverstanden te voorkomen en leveren nauwkeurigere antwoorden op.
Prompt engineering vereist doorlopend experimenteren en itereren, wat tijdrovend kan zijn en per usecase kan verschillen. Goed opgestelde prompts generaliseren niet altijd, waardoor je ze opnieuw moet ontwerpen wanneer taken of modellen veranderen. Verbeteringen in promptontwerp kunnen ook fragiel zijn—kleine woordkeuzes of modelupdates kunnen resultaten onvoorspelbaar veranderen. Te veel vertrouwen op prompt engineering zonder aanvullende technieken zoals contextbeheer of fine-tuning kan bovendien schaalbaarheid en langetermijnbesparing beperken.
Bonus: Context engineering
Context engineering is de praktijk van het ontwerpen van systemen die bepalen welke informatie een LLM te zien krijgt voordat er een antwoord wordt gegenereerd. In plaats van alles in het contextvenster te proppen, selecteer en organiseer je alleen de meest relevante details—zoals gebruikersgeschiedenis, opgehaalde documenten of tooloutputs—zodat het model efficiënter kan redeneren.
Zo doe je het:
- Contextsamenvatting: Comprimeer opgebouwde gespreksgeschiedenis of documenten tot kortere samenvattingen om de essentie te behouden en het aantal tokens te verminderen.
- Beheer van toolloadout: Gebruik retrievalsystemen om alleen de meest relevante tools of beschrijvingen te selecteren in plaats van alle beschikbare opties door te geven.
- Contextpruning: Verwijder verouderde of redundante informatie zodra nieuwe data binnenkomt, zodat de actieve context slank en nuttig blijft.
- Contextvalidatie en -quarantaine: Detecteer en isoleer hallucinaties of fouten voordat ze de langetermijngeheugenbanken besmetten.
Wat het oplevert:
- Minder tokengebruik: Kortere en meer gefocuste contexten verminderen het aantal verwerkte tokens, wat direct kosten drukt.
- Hogere nauwkeurigheid: Schonere context maakt het minder waarschijnlijk dat het model wordt afgeleid of in de war raakt door irrelevante of conflicterende details.
- Snellere inference: Met minder tokens en een stabielere KV-cache worden verzoeken sneller afgerond, wat rekenresources bespaart.
De afweging is dat het bouwen van effectieve contextsysteemnen voorafgaande engineeringinspanningen vergt. Je hebt pipelines nodig voor retrieval, samenvatting en validatie, en een slecht ontwerp kan contextgaten veroorzaken die de prestaties schaden. Maar als het goed wordt gedaan, maakt context engineering grote applicaties zowel betrouwbaarder als betaalbaarder.
Conclusie
LLM-inferencekosten verlagen draait niet om één truc. Het gaat om het combineren van aanpakken die passen bij jouw workload. Technieken zoals quantization, pruning en knowledge distillation verkleinen het model. Batching, caching en gedistribueerde inference verbeteren de manier waarop verzoeken worden verwerkt. Hardwarekeuzes en modelcompressie duwen de efficiëntie verder, terwijl prompt- en contextengineering onnodig tokengebruik bij de bron terugdringen.
De afwegingen zijn reëel: elke methode brengt complexiteit, mogelijk nauwkeurigheidsverlies of infrastructuuroverhead met zich mee. Maar de voordelen stapelen zich op. Door zelfs maar enkele van deze technieken toe te passen, houd je modellen betaalbaar, schaal je gebruik zonder ontsporende kosten en bouw je systemen die duurzaam blijven naarmate modellen en applicaties groeien.



 Adel Nehme · 15 min
Het draaien van large language models brengt echte kosten met zich mee. Je betaalt voor elke verwerkte token, elke gebruikte GPU-cyclus en elke extra laag complexiteit die aan een model wordt toegevoegd. Ook al zijn de prijzen gedaald, de rekening loopt nog steeds snel op als je werkt met grote applicaties, lange prompts of frequente updates.
Ik heb gezien hoe snel dit een probleem kan worden. Teams gaan ervan uit dat de kosten beheersbaar blijven, om er vervolgens achter te komen dat ze budget verbranden aan te grote modellen, inefficiënte prompts of stilstaande hardware.
Daarom heb ik 10 praktische manieren om inferencekosten te verlagen bijeengebracht. Van quantization en pruning tot batching, caching en prompt engineering: dit zijn aanpakken die ik daadwerkelijk gebruik om LLM’s betaalbaar te houden zonder al te veel prestatieverlies.
1. Quantization
Quantization is het proces waarbij je de precisie van modelgewichten en activaties verlaagt, meestal van 32-bits drijvende-kommagetallen naar representaties met minder bits (bijv. 16-bits of zelfs 8-bits). Dit verkleint de geheugenvraag en rekenlast, waardoor inference sneller verloopt op apparaten met beperkte middelen.
Zo pak je het aan:
Wat het oplevert:
De belangrijkste afweging is mogelijk nauwkeurigheidsverlies. Moderne quantizationtechnieken zijn behoorlijk goed, maar er is altijd kans op een lichte daling in modelnauwkeurigheid.
2. Pruning
Pruning is een techniek waarbij minder belangrijke of redundante gewichten uit een neuraal netwerk worden verwijderd. Door verbindingen te schrappen die weinig impact hebben op de modelprestaties, verklein je het model en verlaag je de rekenscomplexiteit, wat tot snellere inference leidt.
Zo pak je het aan:
Wat het oplevert:
Net als bij quantization is de belangrijkste afweging mogelijk nauwkeurigheidsverlies. Agressieve pruning kan tot merkbare prestatieafname leiden. Het is cruciaal de juiste balans te vinden.
3. Knowledge Distillation
Knowledge distillation is het proces waarbij je kennis overdraagt van een groot, complex “teacher”-model naar een kleiner, efficiënter “student”-model. Het studentmodel leert het gedrag van de teacher na te bootsen en kan zo vergelijkbare prestaties leveren met een kleinere omvang en snellere inference.
Zo pak je het aan:
Wat het oplevert:
De belangrijkste afweging is dat je toegang nodig hebt tot een krachtig teachermodel, wat duur kan zijn om te trainen of te gebruiken.
4. Batching
Batching houdt in dat je meerdere invoer-samples tegelijk in één batch verwerkt tijdens inference. Dit verbetert de efficiëntie door optimaal gebruik te maken van de parallelle verwerkingsmogelijkheden van de hardware, wat tot snellere totale inference leidt.
Zo pak je het aan:
Wat het oplevert:
Batching kan echter extra latentie voor individuele verzoeken introduceren, omdat het systeem mogelijk wacht om genoeg inputs te verzamelen voordat er wordt verwerkt. Voor real-time of low-latency applicaties kan die vertraging de gebruikerservaring aantasten als je niet zorgvuldig afstemt. Dynamische batching helpt dit te beperken, maar voegt systeemcomplexiteit toe. Er is ook het risico op inefficiënte batching bij wisselende verkeerspatronen, wat de verwachte kostenbesparing kan verminderen.
5. Caching
Caching is een techniek waarbij je de resultaten van eerdere berekeningen opslaat en hergebruikt wanneer tijdens inference dezelfde inputs opnieuw voorkomen. Dit voorkomt dubbele berekeningen en versnelt zo het inferenceproces.
Zo pak je het aan:
Wat het oplevert:
Caching is echter alleen nuttig wanneer inputs zich herhalen of overlappen. Bij zeer variabele workloads kunnen hitrates laag zijn en kan de overhead van cachebeheer de voordelen overtreffen. Verouderde resultaten kunnen ook voor inconsistenties zorgen als cached outputs niet langer de meest relevante data weerspiegelen. Bovendien brengt het implementeren en afstemmen van evictionstrategieën extra engineeringcomplexiteit met zich mee, zeker in gedistribueerde systemen waar cachesynchronisatie een uitdaging is.
6. Early Exiting
Early Exiting houdt in dat je de berekening tijdens inference vroegtijdig stopt als het model voldoende zeker is van zijn voorspelling. Dit spaart rekenresources en versnelt inference voor eenvoudigere gevallen waarbij een volledige forward pass niet nodig is.
Zo pak je het aan:
Wat het oplevert:
De afweging is dat early exiting in sommige gevallen tot iets lagere nauwkeurigheid kan leiden, vooral bij complexe inputs.
7. Geoptimaliseerde hardware
Deze techniek draait om het benutten van gespecialiseerde hardware-architecturen en accelerators die zijn ontworpen voor efficiënte AI-berekeningen. Denk aan GPU’s, TPU’s en andere dedicated AI-chips die voor inferencetaken aanzienlijke prestatieverbeteringen bieden ten opzichte van algemene CPU’s.
Zo pak je het aan:
Wat het oplevert:
Gespecialiseerde hardware vereist echter vaak een flinke investering vooraf en kan je vastzetten in een bepaald leveranciersecosysteem. GPU’s, TPU’s of maatwerkaccelerators zijn in de cloud soms ook lastig consistent te reserveren, vooral bij piekvraag. On-premises implementaties brengen onderhouds- en schaaluitdagingen met zich mee, terwijl cloudopties hogere doorlopende huurlasten kunnen hebben. Tot slot kan het aanpassen van software om gespecialiseerde hardware volledig te benutten extra engineeringcomplexiteit en voortdurende optimalisatie vereisen.
8. Modelcompressie
Modelcompressie betekent dat je meerdere technieken gebruikt om de grootte en complexiteit van een model te verkleinen zonder de prestaties noemenswaardig aan te tasten. Dit kan pruning, quantization, knowledge distillation of andere methoden omvatten die gericht zijn op een compacter en efficiënter model met snellere inference.
Zo pak je het aan:
Wat het oplevert:
Modelcompressie kan tot nauwkeurigheidsverlies leiden als technieken te agressief of zonder zorgvuldige afstemming worden toegepast. Het combineren van methoden zoals pruning, quantization en distillation verhoogt de systeemcomplexiteit en kan extra retraining of fine-tuning vereisen. Gecomprimeerde modellen zijn soms minder flexibel bij overdracht naar nieuwe taken, omdat optimalisaties het toepassingsbereik kunnen vernauwen. In sommige gevallen kunnen de bestede engineeringstijd en rekenkosten aan compressie kortetermijnbesparingen tenietdoen.
9. Gedistribueerde inference
Gedistribueerde inference verdeelt de inferentielast over meerdere machines of apparaten. Dit maakt parallelle verwerking van grootschalige inferencetaken mogelijk, met lagere latentie en hogere throughput als resultaat.
Zo pak je het aan:
Wat het oplevert:
Gedistribueerde inference introduceert aanzienlijke systeemcomplexiteit, omdat coördinatie over meerdere machines robuuste orkestratie, synchronisatie en fouttolerantie vereist. Netwerklatentie en bandbreedtebeperkingen kunnen prestatievoordelen tenietdoen, vooral wanneer veel tussentijdse data moet worden uitgewisseld. De infrastructuurkosten stijgen ook, omdat extra hardware en load-balancingmechanismen moeten worden ingericht en onderhouden. Debuggen en monitoren van gedistribueerde systemen is lastiger, waardoor betrouwbaarheid een grotere uitdaging is dan bij single-node setups.
10. Prompt engineering
Prompt engineering is het zorgvuldig opstellen van inputprompts om large language models (LLM’s) aan te sturen richting gewenste outputs. Door duidelijke, beknopte en specifieke prompts te formuleren, kun je de kwaliteit en stuurbaarheid van LLM-antwoorden verbeteren, zodat ze relevanter en bruikbaarder zijn voor specifieke taken.
Zo pak je het aan:
Wat het oplevert:
Prompt engineering vereist doorlopend experimenteren en itereren, wat tijdrovend kan zijn en per usecase kan verschillen. Goed opgestelde prompts generaliseren niet altijd, waardoor je ze opnieuw moet ontwerpen wanneer taken of modellen veranderen. Verbeteringen in promptontwerp kunnen ook fragiel zijn—kleine woordkeuzes of modelupdates kunnen resultaten onvoorspelbaar veranderen. Te veel vertrouwen op prompt engineering zonder aanvullende technieken zoals contextbeheer of fine-tuning kan bovendien schaalbaarheid en langetermijnbesparing beperken.
Bonus: Context engineering
Context engineering is de praktijk van het ontwerpen van systemen die bepalen welke informatie een LLM te zien krijgt voordat er een antwoord wordt gegenereerd. In plaats van alles in het contextvenster te proppen, selecteer en organiseer je alleen de meest relevante details—zoals gebruikersgeschiedenis, opgehaalde documenten of tooloutputs—zodat het model efficiënter kan redeneren.
Zo doe je het:
Wat het oplevert:
De afweging is dat het bouwen van effectieve contextsysteemnen voorafgaande engineeringinspanningen vergt. Je hebt pipelines nodig voor retrieval, samenvatting en validatie, en een slecht ontwerp kan contextgaten veroorzaken die de prestaties schaden. Maar als het goed wordt gedaan, maakt context engineering grote applicaties zowel betrouwbaarder als betaalbaarder.
Conclusie
LLM-inferencekosten verlagen draait niet om één truc. Het gaat om het combineren van aanpakken die passen bij jouw workload. Technieken zoals quantization, pruning en knowledge distillation verkleinen het model. Batching, caching en gedistribueerde inference verbeteren de manier waarop verzoeken worden verwerkt. Hardwarekeuzes en modelcompressie duwen de efficiëntie verder, terwijl prompt- en contextengineering onnodig tokengebruik bij de bron terugdringen.
De afwegingen zijn reëel: elke methode brengt complexiteit, mogelijk nauwkeurigheidsverlies of infrastructuuroverhead met zich mee. Maar de voordelen stapelen zich op. Door zelfs maar enkele van deze technieken toe te passen, houd je modellen betaalbaar, schaal je gebruik zonder ontsporende kosten en bouw je systemen die duurzaam blijven naarmate modellen en applicaties groeien.