Büyük dil modellerini çalıştırmanın somut maliyetleri vardır. İşlenen her bir token, kullanılan her GPU döngüsü ve modele eklenen her karmaşıklık katmanı için ödeme yaparsınız. Fiyatlar düşmüş olsa da, büyük uygulamalarla, uzun promptlarla veya sık güncellemelerle çalıştığınızda fatura hâlâ hızla artar.
Bunun ne kadar hızlı bir soruna dönüşebildiğini gördüm. Ekipler maliyetlerin yönetilebilir kalacağını varsayıyor, ancak aşırı büyük modeller, verimsiz promptlar veya boşa yatan donanım için bütçe yaktıklarını fark ediyorlar.
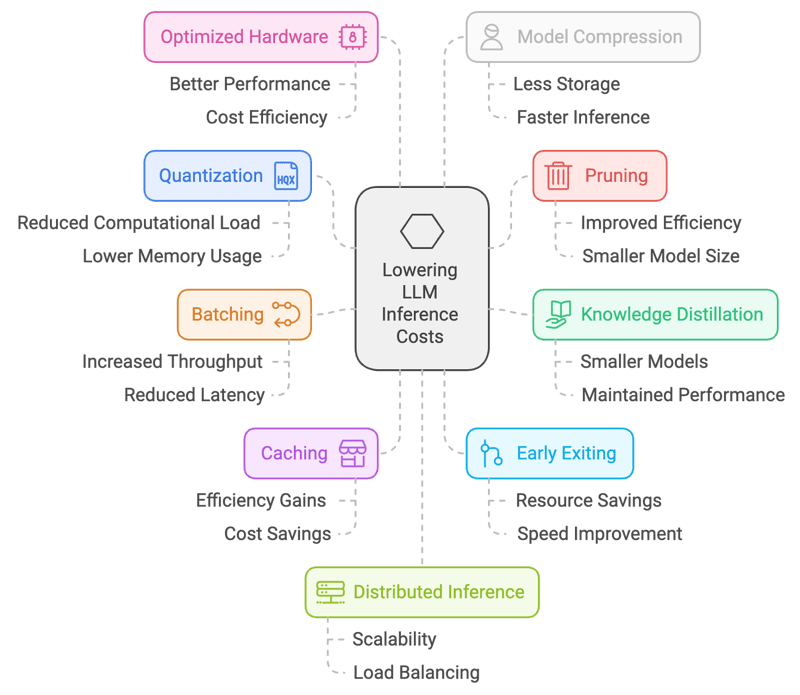
Bu yüzden çıkarım maliyetlerini düşürmenin 10 pratik yolunu bir araya getirdim. Kantifikasyon ve budamadan toplu işleme, önbellekleme ve prompt mühendisliğine kadar, performanstan çok fazla ödün vermeden LLM’leri uygun maliyetli tutmak için gerçekten kullandığım yaklaşımlar bunlar.
1. Kantifikasyon
Kantifikasyon, model ağırlıklarının ve aktivasyonlarının hassasiyetini düşürme sürecidir; genellikle 32 bit kayan noktalı sayılardan daha düşük bit temsillere (ör. 16 bit veya hatta 8 bit) indirilir. Bu, bellek ayak izini ve hesaplama gereksinimlerini azaltır, kaynak kısıtlı cihazlarda daha hızlı çıkarım sağlar.
Nasıl yapılır:
- Eğitim sonrası kantifikasyon (PTQ): Önceden eğitilmiş model ağırlıklarını yeniden eğitim yapmadan daha düşük hassasiyete (ör. 8 bit tamsayılar) dönüştürün. Görece basittir ancak bir miktar doğruluk kaybına yol açabilir.
- Kantifikasyon farkında eğitim (QAT): İnce ayar sırasında kantifikasyon teknikleriyle modeli eğitin; doğruluğun daha iyi korunmasını sağlar.
Nasıl yardımcı olur:
- Daha küçük model boyutu: Daha hızlı yükleme ve daha az bellek kullanımı demektir; özellikle kaynaklar için ödeme yaptığınız bulut ortamlarında maliyeti önemli ölçüde azaltabilir.
- Daha hızlı çıkarım: Daha küçük sayılarla hesaplamalar hızlanır ve yanıt süreleri kısalır.
Başlıca ödün potansiyel doğruluk kaybıdır. Modern kantifikasyon teknikleri oldukça iyi olsa da, model doğruluğunda hafif bir düşüş ihtimali her zaman vardır.
2. Budama
Budama, sinir ağından daha az önemli veya gereksiz ağırlıkların kaldırılması tekniğidir. Modelin performansını minimum etkileyen bağlantıları ortadan kaldırarak modelin boyutunu ve hesaplama karmaşıklığını azaltır, bu da daha hızlı çıkarıma yol açar.
Nasıl yapılır:
- Yapısız budama: Büyüklüklerine veya önemlerine göre tekil ağırlıkları kaldırır.
- Yapısal budama: Tüm kanalları veya filtreleri kaldırır; donanımda verimli şekilde çalıştırılabilen daha düzenli model yapıları üretir.
Nasıl yardımcı olur:
- Daha küçük model boyutu: Kantifikasyona benzer şekilde, budama daha küçük ve daha hızlı yüklenen bir modelle sonuçlanır.
- Azaltılmış hesaplama: Daha az bağlantı, çıkarım sırasında daha az hesaplama demektir; bu da daha hızlı yanıt sürelerine yol açar.
Kantifikasyonda olduğu gibi, başlıca ödün potansiyel doğruluk kaybıdır. Aşırı agresif budama, performansta belirgin bir düşüşe yol açabilir. Doğru dengeyi bulmak kritik önem taşır.
3. Bilgi Damıtma
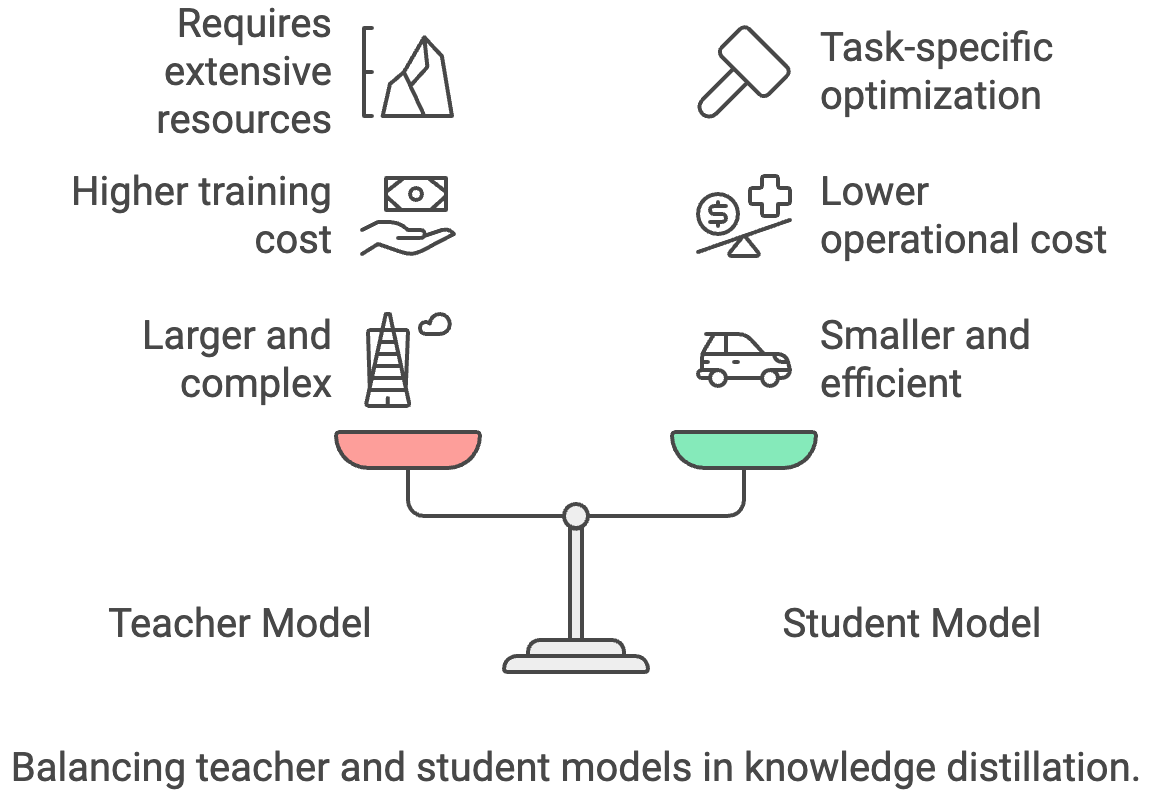
Bilgi damıtma, büyük ve karmaşık bir “öğretmen” modelden daha küçük ve verimli bir “öğrenci” modele bilgi aktarma sürecidir. Öğrenci model, öğretmenin davranışını taklit etmeyi öğrenir; böylece daha küçük boyutta ve daha hızlı çıkarımla karşılaştırılabilir performansa ulaşabilir.
Nasıl yapılır:
- Daha küçük bir öğrenci modeli eğitin: Daha büyük öğretmen modelin çıktıları (logitler veya yumuşatılmış etiketler), öğrenci modeli için ek eğitim sinyali olarak kullanılır.
- Sıcaklık ölçekleme: Öğretmenin çıktı dağılımının yumuşaklığını kontrol etmek için damıtma sırasında sıcaklık parametresini ayarlayın.
Nasıl yardımcı olur:
- Çok daha küçük model: Öğrenci modeller, öğretmenlerinden belirgin şekilde daha küçük ve daha hızlı olabilir; bu da büyük maliyet tasarrufu sağlar.
- Göreve özgü optimizasyon: Öğrenci modeli belirli bir göreve ince ayarlayarak daha da verimli hale getirebilirsiniz.
Başlıca ödün, güçlü bir öğretmen modele erişim gerekliliğidir; bu modeli eğitmek veya kullanmak pahalı olabilir.
4. Toplu İşleme (Batching)
Toplu işleme, çıkarım sırasında bir grup içinde birden çok girdi örneğinin eşzamanlı olarak işlenmesini içerir. Bu, donanımın paralel işlem yeteneklerini kullanarak verimliliği artırır ve toplam çıkarım süresini kısaltır.
Nasıl yapılır:
- İstekleri biriktirin: Birden çok çıkarım isteğini toplayıp bunları tek bir toplu iş olarak birlikte işleyin.
- Dinamik toplu işleme: Gecikme ve verim arasındaki dengeyi kurmak için gelen istek hızlarına göre toplu iş boyutunu dinamik olarak ayarlayın.
Nasıl yardımcı olur:
- Artan verim: Toplu işleme, saniye başına işlenen istek sayısını önemli ölçüde artırabilir; uygulamanızı daha verimli kılar.
- Daha iyi donanım kullanım oranı: GPU’lar paralel işlem için tasarlanmıştır ve toplu işleme bu yeteneklerden tam olarak yararlanmanıza yardımcı olur.
Bununla birlikte, toplu işleme bireysel istekler için ek gecikme getirebilir; sistem, işlem yapmadan önce yeterli girdi biriktirmeyi bekleyebilir. Gerçek zamanlı veya düşük gecikmeli uygulamalarda, dikkatli ayarlanmazsa bu gecikme kullanıcı deneyimini olumsuz etkileyebilir. Dinamik toplu işleme sorunu hafifletir ancak sisteme karmaşıklık katar. Trafik dengesiz olduğunda verimsiz toplu işleme riski de vardır; bu da beklenen maliyet tasarrufunu azaltabilir.
5. Önbellekleme
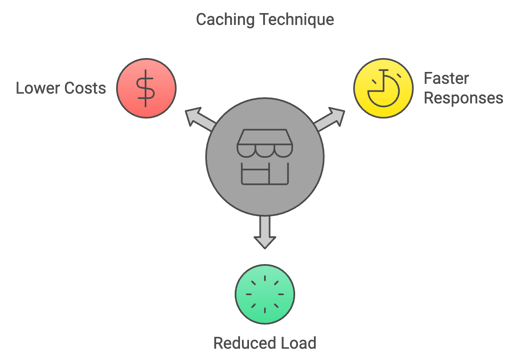
Önbellekleme, önceki hesaplama sonuçlarını saklayıp çıkarım sırasında aynı girdilerle tekrar karşılaşıldığında bunları yeniden kullanma tekniğidir. Bu, yinelenen hesaplamaları önleyerek çıkarım sürecini hızlandırır.
Nasıl yapılır:
- Geçmiş hesaplamaları saklayın: Önceki girdilerin ve bunlara karşılık gelen çıktılarının bir önbelleğini tutun.
- Önbellek tahliye politikaları: Önbellek kapasiteye ulaştığında daha az kullanılan öğeleri kaldırmak için stratejiler uygulayın.
Nasıl yardımcı olur:
- Tekrarlanan isteklerde daha hızlı yanıtlar: Önbellekleme, aynı veya benzer isteklerin sık yapıldığı uygulamalarda son derece etkilidir.
- Daha düşük hesaplama yükü: Daha az hesaplama, daha düşük maliyet demektir.
Ancak önbellekleme yalnızca girdiler tekrarlandığında veya örtüştüğünde faydalıdır. Yüksek değişkenlik gösteren iş yüklerinde isabet oranları düşük olabilir ve önbelleği sürdürmenin ek yükü faydaları aşabilir. Bayat veya güncelliğini yitirmiş sonuçlar, önbelleğe alınan çıktılar artık en ilgili veriyi yansıtmadığında tutarlılık sorunları yaratabilir. Ayrıca, önbellek tahliye stratejilerini uygulamak ve ayarlamak mühendislik karmaşıklığını artırır; özellikle dağıtık sistemlerde önbellek senkronizasyonu bir zorluk haline gelir.
6. Erken Çıkış (Early Exiting)
Erken Çıkış, model tahmini konusunda yeterince emin olduğunda çıkarım sırasında hesaplamayı erken durdurmayı içerir. Bu, hesaplama kaynaklarını tasarruflu kullanır ve tam ileri geçişin gereksiz olduğu daha basit durumlar için çıkarımı hızlandırır.
Nasıl yapılır:
- Güven eşiği: Modelin tahminine ilişkin güveni için bir eşik belirleyin. Güven, ara bir katmanda eşiği aşarsa, hesaplamayı durdurun ve mevcut çıktıyı döndürün.
- Uyarlanabilir erken çıkış: Hız ve doğruluk dengesini kurmak için eşiği girdi veya model katmanına göre dinamik olarak ayarlayın.
Nasıl yardımcı olur:
- Basit vakalarda daha hızlı çıkarım: Model çıktıyı erken aşamada güvenle tahmin edebiliyorsa, zaman ve hesaplama tasarrufu sağlar.
- Düşük maliyet: Daha az hesaplama, daha düşük maliyet demektir.
Ödün, özellikle karmaşık girdilerde, bazı durumlarda doğruluğun biraz düşebilmesidir.
7. Optimize Edilmiş Donanım
Bu teknik, verimli yapay zeka hesaplamaları için tasarlanmış özel donanım mimarileri ve hızlandırıcıların kullanılmasını içerir. Bunlar arasında çıkarım görevlerinde genel amaçlı CPU’lara kıyasla önemli performans artışları sunan GPU’lar, TPU’lar ve diğer özel yapay zeka çipleri bulunur.
Nasıl yapılır:
- GPU’lar: Matris işlemleri ve sinir ağı hesaplamaları için GPU’ların paralel işlem yeteneklerinden yararlanın.
- TPU’lar: Özellikle yapay zeka iş yükleri için tasarlanmış özel tensör işleme birimlerini kullanın.
- Diğer yapay zeka hızlandırıcıları: FPGA’lar veya özel yapay zeka çipleri gibi yeni donanım seçeneklerini keşfedin.
Nasıl yardımcı olur:
- Kayda değer ölçüde daha hızlı çıkarım: GPU’lar ve özel çipler, LLM’lerin ihtiyaç duyduğu türden hesaplamalarda CPU’lardan çok daha hızlıdır.
- Daha iyi enerji verimliliği: Uzun vadede daha düşük enerji maliyeti anlamına gelir.
Ancak, özel donanım genellikle önemli bir peşin yatırım gerektirir ve sizi belirli bir satıcı ekosistemine kilitleyebilir. GPU, TPU veya özel hızlandırıcıları bulutta tutarlı şekilde temin etmek de özellikle yoğun talep dönemlerinde zor olabilir. Şirket içi dağıtımlar bakım ve ölçekleme zorlukları getirirken, bulut seçenekleri daha yüksek devam eden kira maliyetleri taşıyabilir. Son olarak, yazılımı özel donanımdan tam verim alacak şekilde uyarlamak mühendislik karmaşıklığını artırır ve sürekli optimizasyon gerektirebilir.
8. Model Sıkıştırma
Model sıkıştırma, modelin performansını önemli ölçüde zedelemeden boyutunu ve karmaşıklığını azaltmak için birden fazla tekniğin kullanılmasını ifade eder. Bu, daha hızlı çıkarım için daha kompakt ve verimli bir model oluşturmayı amaçlayan budama, kantifikasyon, bilgi damıtma veya diğer yöntemleri içerebilir.
Nasıl yapılır:
- Birden fazla tekniği birleştirin: Model boyutunu en uygun düzeyde küçültmek için kantifikasyon, budama, bilgi damıtma ve diğer yöntemleri bir arada uygulayın.
- Tensör ayrıştırma: Büyük ağırlık matrislerini daha küçük ve verimli temsillere ayrıştırın.
Nasıl yardımcı olur:
- Daha küçük model boyutu: Daha hızlı yükleme, daha az bellek kullanımı ve potansiyel olarak daha düşük maliyet demektir.
Model sıkıştırma, teknikler çok agresif veya dikkatli ayarlama olmaksızın uygulandığında doğrulukta bozulmaya yol açabilir. Budama, kantifikasyon ve damıtma gibi yöntemleri birleştirmek sistem karmaşıklığını artırır ve ek yeniden eğitim veya ince ayar döngüleri gerektirebilir. Sıkıştırılmış modeller, optimizasyonlar çoğu zaman modelin iyi performans gösterdiği senaryo aralığını daralttığından yeni görevlere aktarım için daha az esnek olabilir. Bazı durumlarda, sıkıştırmaya harcanan mühendislik süresi ve hesaplama yükü, kısa vadeli maliyet tasarrufunu dengeleyebilir.
9. Dağıtık Çıkarım
Dağıtık çıkarım, çıkarım iş yükünün birden çok makine veya cihaza bölünmesi yaklaşımıdır. Bu, büyük ölçekli çıkarım görevlerinin paralel işlenmesini mümkün kılar; gecikmeyi azaltır ve verimi artırır.
Nasıl yapılır:
- Model bölütleme: Modeli birden çok makineye bölün; her biri hesaplamanın bir kısmını üstlensin.
- Yük dengeleme: Gelen istekleri mevcut makineler arasında dağıtarak kaynak kullanımını verimli kılın.
Nasıl yardımcı olur:
- Daha büyük modelleri ve daha yüksek trafiği yönetir: Dağıtık çıkarım, büyük görevleri birden çok makineye bölmenizi sağlar; böylece daha büyük modelleri ve daha fazla isteği eşzamanlı olarak işleyebilirsiniz. Bu, donanımı daha verimli kılar ve bulutta esnek ölçeklendirmeye imkân vererek maliyet tasarrufu sağlar.
Dağıtık çıkarım, birden çok makine arasında hesaplamayı koordine etmek için sağlam orkestrasyon, senkronizasyon ve hata toleransı gerektirdiğinden önemli sistem karmaşıklığı getirir. Büyük miktarda ara verinin değiş tokuş edilmesi gerektiğinde ağ gecikmesi ve bant genişliği kısıtları performans kazanımlarını azaltabilir. Ayrıca, ek donanım ve yük dengeleme mekanizmalarının sağlanması ve bakımını gerektirdiğinden altyapı maliyetlerini artırır. Dağıtık sistemlerin hata ayıklaması ve izlenmesi daha zor olabilir; tek düğümlü kurulumlara göre güvenilirlik bir zorluk haline gelir.
10. Prompt Mühendisliği
Prompt mühendisliği, büyük dil modellerini (LLM’ler) istenen çıktıları üretmeye yönlendirmek için girdilerin dikkatle tasarlanması sürecidir. Açık, öz ve spesifik promptlar formüle ederek, kullanıcılar LLM yanıtlarının kalitesini ve kontrol edilebilirliğini artırabilir; çıktıları belirli görevler için daha ilgili ve faydalı hale getirebilir.
Nasıl yapılır:
- Açık ve öz olun: Promptlarınızda spesifik ve yoruma kapalı bir dil kullanın.
- Bağlam sağlayın: LLM’i yönlendirmek için ilgili arka plan bilgilerini veya örnekleri ekleyin.
- Deneyin ve yineleyin: Farklı prompt formülasyonlarını test edin ve en etkili olanları bulmak için sonuçları değerlendirin.
Nasıl yardımcı olur:
- Daha ilgili ve öz çıktılar: İyi prompt mühendisliği, modelin üretmesi gereken token sayısını azaltabilir; bu da daha hızlı ve potansiyel olarak daha ucuz çıkarıma yol açar.
- Artırılmış doğruluk: Açık promptlar, modelin yanlış anlamaları önlemesine ve daha doğru yanıtlar üretmesine yardımcı olur.
Prompt mühendisliği, zaman alan ve kullanım senaryelerine göre tutarsız olabilen sürekli deney ve yineleme gerektirir. İyi tasarlanmış promptlar genelleşmeyebilir; görevler veya modeller değiştiğinde yeniden tasarlamayı zorunlu kılar. Prompt tasarımındaki iyileştirmeler kırılgan olabilir—küçük ifade değişiklikleri veya model güncellemeleri sonuçları öngörülemez biçimde değiştirebilir. Son olarak, bağlam yönetimi veya ince ayar gibi tamamlayıcı teknikler olmadan prompt mühendisliğine aşırı güvenmek ölçeklenebilirliği ve uzun vadeli maliyet tasarruflarını sınırlayabilir.
Bonus: Bağlam Mühendisliği
Bağlam mühendisliği, bir yanıt üretmeden önce bir LLM’in hangi bilgileri göreceğini kontrol eden sistemler tasarlama pratiğidir. Her şeyi bağlam penceresine sıkıştırmak yerine, yalnızca en ilgili ayrıntıları—kullanıcı geçmişi, getirilen belgeler veya araç çıktıları gibi—seçer ve düzenlersiniz; böylece model daha verimli akıl yürütebilir.
Nasıl yapılır:
- Bağlam özetleme: Biriken konuşma geçmişini veya belgeleri daha kısa özetlere sıkıştırarak anlamı korurken token sayısını azaltın.
- Araç yükü yönetimi: Mevcut her seçeneği iletmek yerine yalnızca en ilgili araçları veya açıklamaları seçmek için getirme sistemleri kullanın.
- Bağlam budama: Yeni veriler geldikçe güncelliğini yitirmiş veya yinelenen bilgileri kaldırın; etkin bağlamı yalın ve kullanışlı tutun.
- Bağlam doğrulama ve karantinaya alma: Halüsinasyonları veya hataları uzun vadeli belleği zehirlemeden önce tespit edip izole edin.
Nasıl yardımcı olur:
- Daha az token kullanımı: Daha kısa ve odaklı bağlamlar işlenen token sayısını azaltır; bu da doğrudan maliyetleri düşürür.
- Artırılmış doğruluk: Daha temiz bağlam, modelin ilgisiz veya çelişkili ayrıntılardan dikkati dağılmamasını sağlar.
- Daha hızlı çıkarım: Daha az token ve daha stabil KV önbelleği ile istekler daha hızlı tamamlanır; bu da hesaplama kaynaklarını tasarruflu kullanır.
Ödün, etkili bağlam sistemleri kurmanın başlangıçta mühendislik çabası gerektirmesidir. Getirme, özetleme ve doğrulama boru hatlarının kurulması gerekir; zayıf tasarım, performansı zedeleyen bağlam boşluklarına yol açabilir. Ancak iyi uygulandığında bağlam mühendisliği, büyük uygulamaları hem daha güvenilir hem de daha uygun maliyetli hale getirir.
Sonuç
LLM çıkarım maliyetlerini düşürmek tek bir numarayla ilgili değildir. İş yükünüz için mantıklı olan yaklaşımları birleştirmekle ilgilidir. Kantifikasyon, budama ve bilgi damıtma gibi teknikler model boyutunu küçültür. Toplu işleme, önbellekleme ve dağıtık çıkarım, isteklerin nasıl işlendiğini iyileştirir. Donanım tercihleri ve model sıkıştırma verimliliği daha da artırırken, prompt ve bağlam mühendisliği kaynağında gereksiz token kullanımını azaltır.
Ödünler gerçektir: Her yöntem beraberinde karmaşıklık, potansiyel doğruluk kaybı veya altyapı ek yükü getirir. Ancak kazanımlar birikir. Bu tekniklerden sadece birkaçını uygulayarak modelleri uygun maliyetli tutabilir, kullanımınızı kontrolden çıkmayan maliyetlerle ölçekleyebilir ve modeller ile uygulamalar büyüdükçe sürdürülebilir kalan sistemler kurabilirsiniz.



 Abid Ali Awan · 14 min

 Dario Radečić · 15 min

 Adel Nehme


Büyük dil modellerini çalıştırmanın somut maliyetleri vardır. İşlenen her bir token, kullanılan her GPU döngüsü ve modele eklenen her karmaşıklık katmanı için ödeme yaparsınız. Fiyatlar düşmüş olsa da, büyük uygulamalarla, uzun promptlarla veya sık güncellemelerle çalıştığınızda fatura hâlâ hızla artar.
Bunun ne kadar hızlı bir soruna dönüşebildiğini gördüm. Ekipler maliyetlerin yönetilebilir kalacağını varsayıyor, ancak aşırı büyük modeller, verimsiz promptlar veya boşa yatan donanım için bütçe yaktıklarını fark ediyorlar.
Bu yüzden çıkarım maliyetlerini düşürmenin 10 pratik yolunu bir araya getirdim. Kantifikasyon ve budamadan toplu işleme, önbellekleme ve prompt mühendisliğine kadar, performanstan çok fazla ödün vermeden LLM’leri uygun maliyetli tutmak için gerçekten kullandığım yaklaşımlar bunlar.
1. Kantifikasyon
Kantifikasyon, model ağırlıklarının ve aktivasyonlarının hassasiyetini düşürme sürecidir; genellikle 32 bit kayan noktalı sayılardan daha düşük bit temsillere (ör. 16 bit veya hatta 8 bit) indirilir. Bu, bellek ayak izini ve hesaplama gereksinimlerini azaltır, kaynak kısıtlı cihazlarda daha hızlı çıkarım sağlar.
Nasıl yapılır:
Nasıl yardımcı olur:
Başlıca ödün potansiyel doğruluk kaybıdır. Modern kantifikasyon teknikleri oldukça iyi olsa da, model doğruluğunda hafif bir düşüş ihtimali her zaman vardır.
2. Budama
Budama, sinir ağından daha az önemli veya gereksiz ağırlıkların kaldırılması tekniğidir. Modelin performansını minimum etkileyen bağlantıları ortadan kaldırarak modelin boyutunu ve hesaplama karmaşıklığını azaltır, bu da daha hızlı çıkarıma yol açar.
Nasıl yapılır:
Nasıl yardımcı olur:
Kantifikasyonda olduğu gibi, başlıca ödün potansiyel doğruluk kaybıdır. Aşırı agresif budama, performansta belirgin bir düşüşe yol açabilir. Doğru dengeyi bulmak kritik önem taşır.
3. Bilgi Damıtma
Bilgi damıtma, büyük ve karmaşık bir “öğretmen” modelden daha küçük ve verimli bir “öğrenci” modele bilgi aktarma sürecidir. Öğrenci model, öğretmenin davranışını taklit etmeyi öğrenir; böylece daha küçük boyutta ve daha hızlı çıkarımla karşılaştırılabilir performansa ulaşabilir.
Nasıl yapılır:
Nasıl yardımcı olur:
Başlıca ödün, güçlü bir öğretmen modele erişim gerekliliğidir; bu modeli eğitmek veya kullanmak pahalı olabilir.
4. Toplu İşleme (Batching)
Toplu işleme, çıkarım sırasında bir grup içinde birden çok girdi örneğinin eşzamanlı olarak işlenmesini içerir. Bu, donanımın paralel işlem yeteneklerini kullanarak verimliliği artırır ve toplam çıkarım süresini kısaltır.
Nasıl yapılır:
Nasıl yardımcı olur:
Bununla birlikte, toplu işleme bireysel istekler için ek gecikme getirebilir; sistem, işlem yapmadan önce yeterli girdi biriktirmeyi bekleyebilir. Gerçek zamanlı veya düşük gecikmeli uygulamalarda, dikkatli ayarlanmazsa bu gecikme kullanıcı deneyimini olumsuz etkileyebilir. Dinamik toplu işleme sorunu hafifletir ancak sisteme karmaşıklık katar. Trafik dengesiz olduğunda verimsiz toplu işleme riski de vardır; bu da beklenen maliyet tasarrufunu azaltabilir.
5. Önbellekleme
Önbellekleme, önceki hesaplama sonuçlarını saklayıp çıkarım sırasında aynı girdilerle tekrar karşılaşıldığında bunları yeniden kullanma tekniğidir. Bu, yinelenen hesaplamaları önleyerek çıkarım sürecini hızlandırır.
Nasıl yapılır:
Nasıl yardımcı olur:
Ancak önbellekleme yalnızca girdiler tekrarlandığında veya örtüştüğünde faydalıdır. Yüksek değişkenlik gösteren iş yüklerinde isabet oranları düşük olabilir ve önbelleği sürdürmenin ek yükü faydaları aşabilir. Bayat veya güncelliğini yitirmiş sonuçlar, önbelleğe alınan çıktılar artık en ilgili veriyi yansıtmadığında tutarlılık sorunları yaratabilir. Ayrıca, önbellek tahliye stratejilerini uygulamak ve ayarlamak mühendislik karmaşıklığını artırır; özellikle dağıtık sistemlerde önbellek senkronizasyonu bir zorluk haline gelir.
6. Erken Çıkış (Early Exiting)
Erken Çıkış, model tahmini konusunda yeterince emin olduğunda çıkarım sırasında hesaplamayı erken durdurmayı içerir. Bu, hesaplama kaynaklarını tasarruflu kullanır ve tam ileri geçişin gereksiz olduğu daha basit durumlar için çıkarımı hızlandırır.
Nasıl yapılır:
Nasıl yardımcı olur:
Ödün, özellikle karmaşık girdilerde, bazı durumlarda doğruluğun biraz düşebilmesidir.
7. Optimize Edilmiş Donanım
Bu teknik, verimli yapay zeka hesaplamaları için tasarlanmış özel donanım mimarileri ve hızlandırıcıların kullanılmasını içerir. Bunlar arasında çıkarım görevlerinde genel amaçlı CPU’lara kıyasla önemli performans artışları sunan GPU’lar, TPU’lar ve diğer özel yapay zeka çipleri bulunur.
Nasıl yapılır:
Nasıl yardımcı olur:
Ancak, özel donanım genellikle önemli bir peşin yatırım gerektirir ve sizi belirli bir satıcı ekosistemine kilitleyebilir. GPU, TPU veya özel hızlandırıcıları bulutta tutarlı şekilde temin etmek de özellikle yoğun talep dönemlerinde zor olabilir. Şirket içi dağıtımlar bakım ve ölçekleme zorlukları getirirken, bulut seçenekleri daha yüksek devam eden kira maliyetleri taşıyabilir. Son olarak, yazılımı özel donanımdan tam verim alacak şekilde uyarlamak mühendislik karmaşıklığını artırır ve sürekli optimizasyon gerektirebilir.
8. Model Sıkıştırma
Model sıkıştırma, modelin performansını önemli ölçüde zedelemeden boyutunu ve karmaşıklığını azaltmak için birden fazla tekniğin kullanılmasını ifade eder. Bu, daha hızlı çıkarım için daha kompakt ve verimli bir model oluşturmayı amaçlayan budama, kantifikasyon, bilgi damıtma veya diğer yöntemleri içerebilir.
Nasıl yapılır:
Nasıl yardımcı olur:
Model sıkıştırma, teknikler çok agresif veya dikkatli ayarlama olmaksızın uygulandığında doğrulukta bozulmaya yol açabilir. Budama, kantifikasyon ve damıtma gibi yöntemleri birleştirmek sistem karmaşıklığını artırır ve ek yeniden eğitim veya ince ayar döngüleri gerektirebilir. Sıkıştırılmış modeller, optimizasyonlar çoğu zaman modelin iyi performans gösterdiği senaryo aralığını daralttığından yeni görevlere aktarım için daha az esnek olabilir. Bazı durumlarda, sıkıştırmaya harcanan mühendislik süresi ve hesaplama yükü, kısa vadeli maliyet tasarrufunu dengeleyebilir.
9. Dağıtık Çıkarım
Dağıtık çıkarım, çıkarım iş yükünün birden çok makine veya cihaza bölünmesi yaklaşımıdır. Bu, büyük ölçekli çıkarım görevlerinin paralel işlenmesini mümkün kılar; gecikmeyi azaltır ve verimi artırır.
Nasıl yapılır:
Nasıl yardımcı olur:
Dağıtık çıkarım, birden çok makine arasında hesaplamayı koordine etmek için sağlam orkestrasyon, senkronizasyon ve hata toleransı gerektirdiğinden önemli sistem karmaşıklığı getirir. Büyük miktarda ara verinin değiş tokuş edilmesi gerektiğinde ağ gecikmesi ve bant genişliği kısıtları performans kazanımlarını azaltabilir. Ayrıca, ek donanım ve yük dengeleme mekanizmalarının sağlanması ve bakımını gerektirdiğinden altyapı maliyetlerini artırır. Dağıtık sistemlerin hata ayıklaması ve izlenmesi daha zor olabilir; tek düğümlü kurulumlara göre güvenilirlik bir zorluk haline gelir.
10. Prompt Mühendisliği
Prompt mühendisliği, büyük dil modellerini (LLM’ler) istenen çıktıları üretmeye yönlendirmek için girdilerin dikkatle tasarlanması sürecidir. Açık, öz ve spesifik promptlar formüle ederek, kullanıcılar LLM yanıtlarının kalitesini ve kontrol edilebilirliğini artırabilir; çıktıları belirli görevler için daha ilgili ve faydalı hale getirebilir.
Nasıl yapılır:
Nasıl yardımcı olur:
Prompt mühendisliği, zaman alan ve kullanım senaryelerine göre tutarsız olabilen sürekli deney ve yineleme gerektirir. İyi tasarlanmış promptlar genelleşmeyebilir; görevler veya modeller değiştiğinde yeniden tasarlamayı zorunlu kılar. Prompt tasarımındaki iyileştirmeler kırılgan olabilir—küçük ifade değişiklikleri veya model güncellemeleri sonuçları öngörülemez biçimde değiştirebilir. Son olarak, bağlam yönetimi veya ince ayar gibi tamamlayıcı teknikler olmadan prompt mühendisliğine aşırı güvenmek ölçeklenebilirliği ve uzun vadeli maliyet tasarruflarını sınırlayabilir.
Bonus: Bağlam Mühendisliği
Bağlam mühendisliği, bir yanıt üretmeden önce bir LLM’in hangi bilgileri göreceğini kontrol eden sistemler tasarlama pratiğidir. Her şeyi bağlam penceresine sıkıştırmak yerine, yalnızca en ilgili ayrıntıları—kullanıcı geçmişi, getirilen belgeler veya araç çıktıları gibi—seçer ve düzenlersiniz; böylece model daha verimli akıl yürütebilir.
Nasıl yapılır:
Nasıl yardımcı olur:
Ödün, etkili bağlam sistemleri kurmanın başlangıçta mühendislik çabası gerektirmesidir. Getirme, özetleme ve doğrulama boru hatlarının kurulması gerekir; zayıf tasarım, performansı zedeleyen bağlam boşluklarına yol açabilir. Ancak iyi uygulandığında bağlam mühendisliği, büyük uygulamaları hem daha güvenilir hem de daha uygun maliyetli hale getirir.
Sonuç
LLM çıkarım maliyetlerini düşürmek tek bir numarayla ilgili değildir. İş yükünüz için mantıklı olan yaklaşımları birleştirmekle ilgilidir. Kantifikasyon, budama ve bilgi damıtma gibi teknikler model boyutunu küçültür. Toplu işleme, önbellekleme ve dağıtık çıkarım, isteklerin nasıl işlendiğini iyileştirir. Donanım tercihleri ve model sıkıştırma verimliliği daha da artırırken, prompt ve bağlam mühendisliği kaynağında gereksiz token kullanımını azaltır.
Ödünler gerçektir: Her yöntem beraberinde karmaşıklık, potansiyel doğruluk kaybı veya altyapı ek yükü getirir. Ancak kazanımlar birikir. Bu tekniklerden sadece birkaçını uygulayarak modelleri uygun maliyetli tutabilir, kullanımınızı kontrolden çıkmayan maliyetlerle ölçekleyebilir ve modeller ile uygulamalar büyüdükçe sürdürülebilir kalan sistemler kurabilirsiniz.