
什么是上下文工程?
上下文工程是指设计系统来决定 AI 模型在生成响应之前能看到哪些信息的实践。
尽管术语较新,但其背后的原则早已存在。这一新抽象使我们能够系统性地思考一个长期且普遍的问题:如何设计 AI 系统的输入与输出信息流。
与其为单次请求撰写完美提示,不如创建能从多个来源收集相关细节并将其组织到模型上下文窗口中的系统。这意味着您的系统会汇总对话历史、用户数据、外部文档和可用工具,并将它们格式化为模型可用的形式。
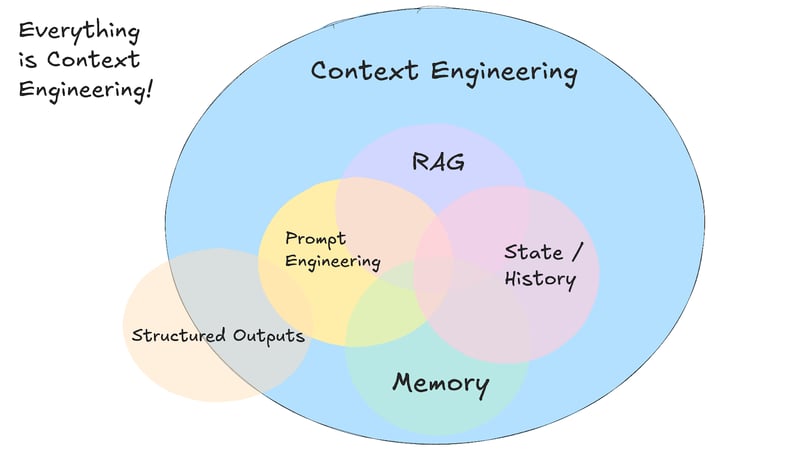
来源: 12-factor-agents
这种方法需要管理构成完整上下文的多种信息类型:
- 设定行为与规则的系统指令
- 对话历史与用户偏好
- 从文档或数据库检索的信息
- 可用工具及其定义
- 结构化输出格式与模式
- 实时数据与外部 API 响应
主要挑战是在上下文窗口限制内,仍能长期保持连贯对话。您的系统需要为每次请求判断最相关的信息,这通常意味着要构建能在需要时找到正确信息的检索系统。
这还涉及创建能同时跟踪短期对话流程和长期用户偏好的记忆系统,并清理过时信息,为当前需求留出空间。
当不同类型的上下文协同工作时,真正的收益才会显现——AI 系统会显得更智能、更具感知力。当您的 AI 助手能同时引用先前对话、访问您的日历并理解您的沟通风格时,互动将不再重复,而会让您感觉它“记得您”。
上下文工程 vs. 提示工程
如果您让 ChatGPT “写一封职业化的电子邮件”,那是提示工程——您在为单个任务编写指令。但如果您要构建一个客服机器人,需要记住先前工单、访问用户账户详情,并在多次交互中保持对话历史,那就是上下文工程。
Andrej Karpathy 对此有精彩阐述:
人们通常将提示与日常使用大语言模型时给出的简短任务描述联系在一起。而在每一个工业级 LLM 应用中,上下文工程都是一门微妙的艺术与科学:为下一步在上下文窗口中填入恰到好处的信息。
大多数 AI 应用同时使用提示工程和上下文工程。在上下文工程系统中,您仍然需要撰写良好的提示。不同之处在于,这些提示现在与经过精心管理的背景信息协同工作,而不是每次都从零开始。
|
方法 |
最佳适用场景 |
|
提示工程 |
一次性任务、内容生成、特定格式输出 |
|
上下文工程 |
对话式 AI、文档分析工具、编码助手 |
|
两者结合 |
需要稳定可靠表现的生产级 AI 应用 |
实践中的上下文工程
当您开始构建 AI 应用、使其能够处理复杂且相互关联的信息时,上下文工程便从理论走向现实。想象一个客服机器人,需要访问之前的支持工单、检查账户状态、参考产品文档,同时保持有帮助的对话语气。这正是传统提示方式失效、上下文工程变得必要的场景。
RAG 系统
可以说,上下文工程始于检索增强生成(RAG)系统。RAG 是最早让您能将不在原始训练数据中的信息引入 LLM 的技术之一。
RAG 系统使用先进的上下文工程技术,更有效地组织与呈现信息。它们将文档拆分为有意义的片段,按相关性排序,并在 token 限制内装入最有用的细节。
在 RAG 出现之前,如果您希望 AI 回答关于公司内部文档的问题,必须重新训练或微调整个模型。RAG 通过构建能搜索文档、找到相关片段,并将其与您的问题一起纳入上下文窗口的系统,改变了这一点。
这意味着 LLM 能够同时分析多份文档和来源,回答原本需要人类翻阅数百页才能解答的复杂问题。
AI 代理
RAG 系统为外部信息打开了大门,而 AI 代理则更进一步,让上下文变得动态且具响应性。代理不是只检索静态文档,而是在对话中使用外部工具。
AI 会决定哪种工具最能解决当前问题。一个代理可以开始对话,意识到需要当前的股票数据,调用金融 API,然后利用最新信息继续对话。
LLM token 成本的下降也使多代理系统成为可能。与其把一切都塞进单个模型的上下文窗口,您可以让专用代理分别处理问题的不同方面,并通过诸如A2A 或 MCP 等协议在它们之间共享信息。
想进一步了解 AI 代理,请查看这份AI 代理速查表。
AI 编码助手
AI 编码助手(如Cursor 或 Windsurf)代表了上下文工程的最前沿应用之一,因为它们在处理高度结构化、相互关联的信息时,融合了 RAG 与代理原则。
这些系统不仅需要理解单个文件,还要理解整个项目架构、模块之间的依赖关系,以及贯穿代码库的编码模式。
当您让编码助手重构一个函数时,它需要了解该函数的使用位置、期望的数据类型,以及更改将如何影响项目的其他部分。
在这里,上下文工程至关重要,因为代码的关联可能跨越多个文件,甚至多个代码库。优秀的编码助手会维护关于您的项目结构、您最近的更改、您的编码风格以及所用框架的上下文。
这就是为什么像 Cursor 这样的工具,在同一项目中使用得越久,效果越好的原因。它们会积累关于您特定代码库的上下文,并基于您的模式与偏好提出更相关的建议。
上下文失效及其缓解技术
读到这里,您可能会觉得上下文工程没有必要,或者很快会随着前沿模型的上下文窗口持续扩大而变得不再必要。这种推断很自然,因为如果上下文足够大,您可以把一切(工具、文档、指令等)都丢进提示里,让模型来处理剩下的工作。
然而, 这篇精彩文章(作者 Drew Breunig)展示了上下文如何以四种令人意外的方式失控,即便所用模型支持 100 万 token 的上下文窗口。在本节中,我将快速介绍 Drew Breunig 所描述的问题,以及解决它们的上下文工程模式——强烈建议阅读 Breunig 的文章以获取更多细节。
上下文中毒
当幻觉或错误进入 AI 系统的上下文,并在后续响应中被反复引用时,就会发生上下文中毒。DeepMind 团队在其Gemini 2.5 技术报告中发现了这个问题:在构建一个宝可梦游戏代理时,代理有时会对游戏状态产生幻觉,这些错误信息会污染其上下文中的“目标”部分,导致代理长期制定毫无意义的策略,追求不可能完成的目标。
在信息不断累积的代理工作流中,这个问题会变得尤为严重。一旦形成被污染的上下文,就很难修复,因为模型会把这些错误信息当作真实信息持续引用。
最佳修复方式是上下文校验与隔离。您可以将不同类型的上下文隔离到独立线程,并在其被加入长期记忆之前进行校验。上下文隔离意味着一旦检测到潜在中毒,就启动新的线程,防止错误信息扩散到未来的交互中。
上下文分心
当上下文变得过大,模型开始过度关注累积的历史,而不是利用其训练中学到的知识时,就会出现上下文分心。宝可梦代理表现出了这种现象——一旦上下文超过 100,000 个 token,代理就会重复其庞大历史中的动作,而不是发展新策略。
一项 Databricks 研究(非常有趣,值得一读)发现,对于Llama 3.1 405b,模型正确率在约 32,000 token 时开始下降,且更小的模型更早触及极限。这意味着模型在上下文窗口真正装满之前很久就开始犯错,这也让人质疑超大上下文窗口对复杂推理任务的实际价值。
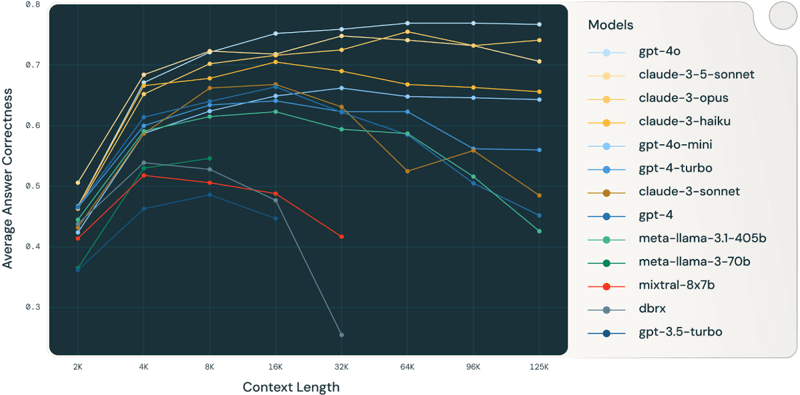
来源: Databricks
最佳做法是上下文总结。不要让上下文无限增长,而是将累积信息压缩为更短的摘要,保留重要细节,去除冗余历史。当触及“分心上限”时,您可以总结至今的对话,在保持一致性的同时重新开始。
上下文混淆
当您在上下文中包含了额外信息,即使这些信息与当前任务无关,模型仍会用其生成不佳的响应,这就是上下文混淆。 伯克利函数调用榜单显示了这一点——当提供超过一种工具时,每个模型的表现都会变差,且模型有时会调用与任务无关的工具。
随着模型变小、工具增多,问题会更严重。近期一项研究发现,当为量化的 Llama 3.1 8b 提供全部 46 种可用工具时,它在 GeoEngine 基准上失败,尽管上下文仍远低于 16k 窗口限制。但当研究者只给同一模型 19 种工具时,它就能正常工作。
解决方案是使用 RAG 技术进行工具载荷管理。 Tiantian Gan 与 Qiyao Sun 的研究表明,将 RAG 应用于工具描述能显著提升性能。通过将工具描述存入向量数据库,您可以为每个任务只选择最相关的工具。研究发现,将工具选择保持在 30 个以内,工具选择准确率可提升三倍,且提示更短。
上下文冲突
当您在上下文中汇集的信息与工具彼此冲突时,就会发生上下文冲突。微软与 Salesforce 的一项研究通过将基准提示中的信息“分片”到多轮对话而非一次性提供,展示了这一点。结果非常显著——平均性能下降 39%,其中OpenAI 的 o3 模型从 98.1 跌至 64.1。
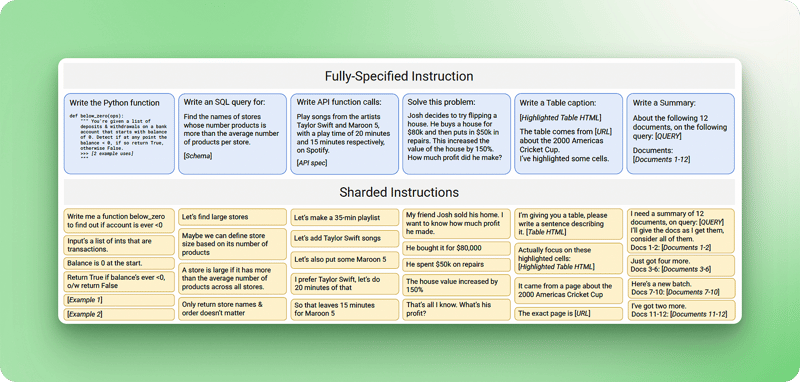
来源: Laban 等,2025
问题之所以出现,是因为当信息分阶段到来时,组装出的上下文包含了模型在信息尚不完整时给出的早期尝试性答案。这些错误的早期答案会留在上下文中,并在模型生成最终响应时产生影响。
最佳修复方式是上下文修剪与下放。上下文修剪是指随着新信息到来,移除过时或相互冲突的信息。上下文下放(如 Anthropic 的 “think” 工具)为模型提供一个独立的工作区,用于处理信息,而不致弄乱主上下文。这种草稿本式方法可在专业代理基准中带来最高 54% 的提升,因为它能防止内部矛盾干扰推理。
结论
上下文工程代表着 AI 发展的下一阶段,关注点从打造完美提示转向构建能随时间管理信息流的系统。能否在多次交互中保持相关上下文,将决定您的 AI 是显得真正智能,还是只能给出一次性的好答案。
本教程涉及的技术——从 RAG 系统到上下文校验与工具管理——已经在服务数百万用户的生产系统中广泛应用。
如果您构建的应用超出简单内容生成,上下文工程技术很可能是必需的。好消息是,您可以从基础的 RAG 实现起步,随着需求增长,逐步加入更复杂的记忆与工具管理能力。
想要进一步学习,推荐这些资源:
- Cursor AI 代码编辑器教程——通过 AI 编码助手了解上下文工程在实践中的运作
- Cursor 与 Windsurf 对比——了解 Cursor 与 Windsurf 的差异
- 最佳 AI 编码助手——比较不同工具及其上下文管理方法
- 使用 LangChain 的检索增强生成(RAG)课程——动手构建 RAG 系统
- 什么是检索增强生成(RAG)?——上下文工程的基础概念
- Agentic RAG 教程——面向动态上下文管理的高级技术
- 什么是提示工程?——理解提示工程与上下文工程的区别
- 使用 LangGraph 的多代理系统课程——学习如何用 LangGraph 构建多代理系统
- AI 代理入门课程——构建能使用工具并随时间维护上下文的系统
FAQs
我何时应该开始使用上下文工程,而不仅仅是提示?
当您的 AI 需要在对话之间记住信息、与多个信息源协同工作或维护长时间运行的任务时,就应开始使用上下文工程。如果您构建的应用不止是简单的内容生成,这些技术很可能是必需的。
上下文工程与提示工程的主要区别是什么?
提示工程专注于为单个任务编写指令,而上下文工程则设计跨多次交互管理信息流的系统。上下文工程构建记忆与检索系统,而提示工程打造单次请求。
我能用更大的上下文窗口来替代上下文工程吗?
更大的上下文窗口并不能解决核心问题。研究表明,即便上下文窗口可达百万 token,模型在约 32,000 token 处就会因上下文分心与混淆而表现下滑。无论上下文大小如何,您仍然需要总结、修剪与智能信息选择等技术。
为什么当我给 AI 提供更多工具或信息时,其表现反而变差?
这被称为上下文混淆——模型会被无关信息分散注意力,并可能使用与任务不匹配的工具。解决方案是工具载荷管理:使用 RAG 技术为每个具体任务仅选择最相关的工具,并将选择控制在 30 个以内。

我是一名数据科学内容创作者,拥有超过 2 年的经验,并在 Medium 上拥有较大的读者群。我喜欢用略带讽刺的笔调撰写有关 AI 和机器学习的深度文章——毕竟总得想点办法让这些内容不那么枯燥。我已发表 130 多篇文章,并制作了一门 DataCamp 课程,另有一门正在筹备中。我的内容已被超过 500 万人次阅读,其中有 2 万人在 Medium 和 LinkedIn 上成为关注者。
即使您已经是提示工程大师,随着对话推进,聊天机器人仍常常会忘记您最早且最重要的指令;代码助手会丢失对项目架构的把握;而 RAG 工具也难以在复杂文档与领域之间串联信息。
随着 AI 用例日益复杂,写出巧妙的提示只是更大挑战中的一小部分: 上下文工程。
在本教程中,我将解释什么是上下文工程、其工作方式、何时应优先于常规提示工程使用它,以及让 AI 系统更聪明、更具上下文感知的实用技巧。
如果您更喜欢看视频,请查看这节课: