Vận hành các mô hình ngôn ngữ lớn đi kèm chi phí thực. Bạn trả tiền cho từng token được xử lý, từng chu kỳ GPU được sử dụng và từng lớp độ phức tạp được thêm vào mô hình. Dù giá đã giảm, hóa đơn vẫn phình to rất nhanh khi bạn làm việc với ứng dụng lớn, prompt dài hoặc cập nhật thường xuyên.
Tôi đã thấy vấn đề này xuất hiện nhanh đến mức nào. Các nhóm thường cho rằng chi phí sẽ trong tầm kiểm soát, nhưng rồi nhận ra họ đang đốt ngân sách vào mô hình quá khổ, prompt kém hiệu quả hoặc phần cứng rỗi.
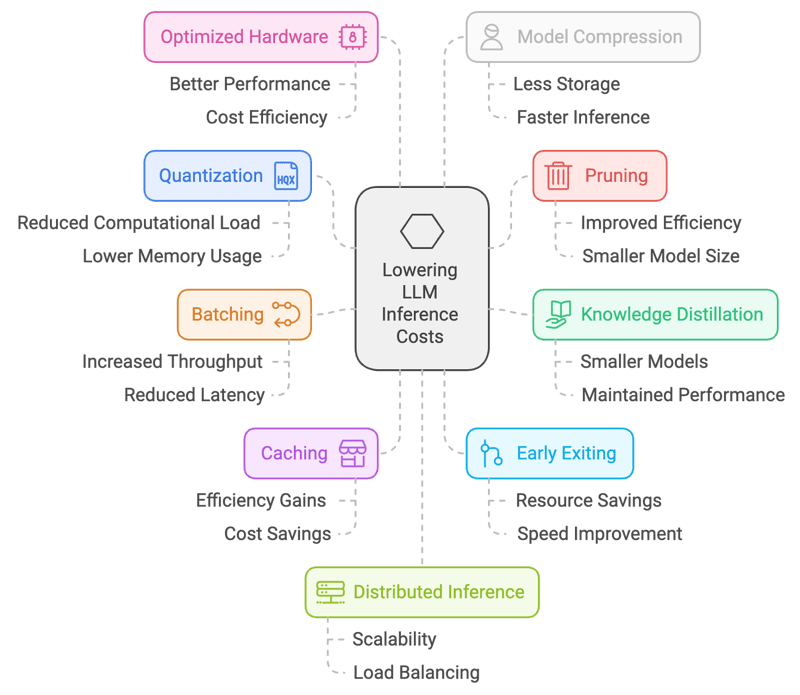
Đó là lý do tôi tổng hợp 10 cách thực tiễn để giảm chi phí suy luận. Từ lượng tử hóa và cắt tỉa đến batching, caching và kỹ thuật prompt, đây là những cách tiếp cận tôi thực sự dùng để giữ LLM ở mức chi phí phải chăng mà không đánh đổi quá nhiều hiệu năng.
1. Lượng tử hóa (Quantization)
Lượng tử hóa là quá trình giảm độ chính xác của trọng số và kích hoạt mô hình, thường từ số thực dấu phẩy động 32-bit xuống các biểu diễn ít bit hơn (ví dụ: 16-bit hoặc thậm chí 8-bit). Điều này giảm dung lượng bộ nhớ và yêu cầu tính toán, cho phép suy luận nhanh hơn trên thiết bị hạn chế tài nguyên.
Cách thực hiện:
- Lượng tử hóa sau huấn luyện (PTQ): Chuyển trọng số mô hình đã huấn luyện sang độ chính xác thấp hơn (ví dụ: số nguyên 8-bit) mà không cần huấn luyện lại. Tương đối đơn giản nhưng có thể gây mất mát độ chính xác nhất định.
- Huấn luyện nhận biết lượng tử (QAT): Tinh chỉnh mô hình với kỹ thuật lượng tử trong quá trình huấn luyện, giúp bảo toàn độ chính xác tốt hơn.
Lợi ích:
- Kích thước mô hình nhỏ hơn: Giúp tải nhanh hơn và dùng ít bộ nhớ hơn, có thể giảm đáng kể chi phí, đặc biệt trên đám mây nơi bạn trả tiền theo tài nguyên dùng.
- Suy luận nhanh hơn: Với số nhỏ hơn, phép tính nhanh hơn, dẫn tới thời gian phản hồi thấp hơn.
Đánh đổi chính là nguy cơ mất độ chính xác. Dù kỹ thuật lượng tử hiện đại khá tốt, vẫn luôn có khả năng suy giảm nhẹ độ chính xác của mô hình.
2. Cắt tỉa (Pruning)
Cắt tỉa là kỹ thuật loại bỏ các trọng số kém quan trọng hoặc dư thừa khỏi mạng nơ-ron. Bằng cách loại bỏ các kết nối có tác động tối thiểu đến hiệu năng, cắt tỉa giúp giảm kích thước và độ phức tạp tính toán của mô hình, từ đó suy luận nhanh hơn.
Cách thực hiện:
- Cắt tỉa phi cấu trúc: Loại từng trọng số dựa trên độ lớn hoặc tầm quan trọng.
- Cắt tỉa có cấu trúc: Loại cả kênh hoặc bộ lọc, tạo cấu trúc mô hình đều đặn hơn và thực thi hiệu quả trên phần cứng.
Lợi ích:
- Kích thước mô hình nhỏ hơn: Tương tự lượng tử hóa, cắt tỉa cho ra mô hình nhỏ hơn và tải nhanh hơn.
- Giảm phép tính: Ít kết nối hơn đồng nghĩa ít phép tính khi suy luận, dẫn tới phản hồi nhanh hơn.
Giống lượng tử hóa, đánh đổi chính là nguy cơ mất độ chính xác. Cắt tỉa quá mạnh có thể làm hiệu năng giảm đáng kể. Cần tìm điểm cân bằng phù hợp.
3. Chưng cất tri thức (Knowledge Distillation)
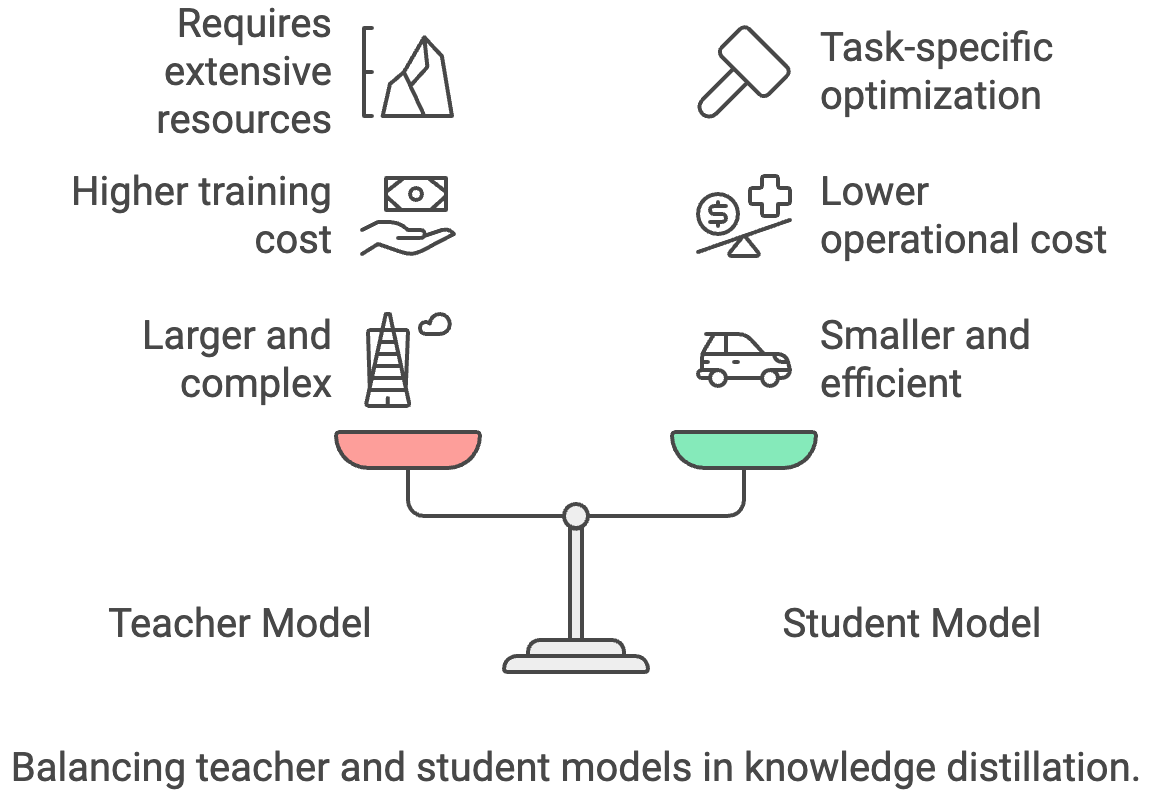
Chưng cất tri thức là quá trình chuyển giao tri thức từ mô hình “giáo viên” lớn, phức tạp sang mô hình “học sinh” nhỏ, hiệu quả hơn. Mô hình học sinh học cách bắt chước hành vi của giáo viên, nhờ đó đạt hiệu năng tương đương với kích thước nhỏ hơn và suy luận nhanh hơn.
Cách thực hiện:
- Huấn luyện mô hình học sinh nhỏ hơn: Dùng đầu ra của mô hình giáo viên (logit hoặc nhãn mềm) làm tín hiệu huấn luyện bổ sung cho mô hình học sinh.
- Tinh chỉnh nhiệt độ (temperature scaling): Điều chỉnh tham số nhiệt độ trong quá trình chưng cất để kiểm soát độ “mềm” của phân phối đầu ra từ giáo viên.
Lợi ích:
- Mô hình nhỏ gọn hơn rất nhiều: Mô hình học sinh có thể nhỏ và nhanh hơn đáng kể so với giáo viên, mang lại tiết kiệm chi phí lớn.
- Tối ưu theo tác vụ: Bạn có thể tinh chỉnh mô hình học sinh cho một nhiệm vụ cụ thể, khiến nó còn hiệu quả hơn.
Đánh đổi chính là bạn cần truy cập vào mô hình giáo viên mạnh mẽ, vốn tốn kém để huấn luyện hoặc sử dụng.
4. Batching
Batching là xử lý đồng thời nhiều mẫu đầu vào trong một lô khi suy luận. Cách này cải thiện hiệu quả bằng cách tận dụng khả năng xử lý song song của phần cứng, giúp suy luận tổng thể nhanh hơn.
Cách thực hiện:
- Tích lũy yêu cầu: Gom nhiều yêu cầu suy luận và xử lý cùng lúc như một lô.
- Batching động: Điều chỉnh kích thước lô linh hoạt dựa trên tốc độ yêu cầu đến để cân bằng độ trễ và thông lượng.
Lợi ích:
- Tăng thông lượng: Batching có thể tăng đáng kể số yêu cầu xử lý mỗi giây, khiến ứng dụng hiệu quả hơn.
- Tận dụng phần cứng tốt hơn: GPU được thiết kế cho xử lý song song, và batching giúp khai thác tối đa khả năng đó.
Tuy nhiên, batching có thể tăng độ trễ cho từng yêu cầu riêng lẻ, vì hệ thống có thể chờ gom đủ đầu vào trước khi xử lý. Với ứng dụng thời gian thực hoặc yêu cầu độ trễ thấp, độ trễ thêm này có thể làm giảm trải nghiệm nếu không tinh chỉnh cẩn thận. Batching động giúp giảm vấn đề nhưng làm hệ thống phức tạp hơn. Cũng có rủi ro batching kém hiệu quả khi lưu lượng không đều, làm giảm mức tiết kiệm chi phí kỳ vọng.
5. Bộ đệm (Caching)
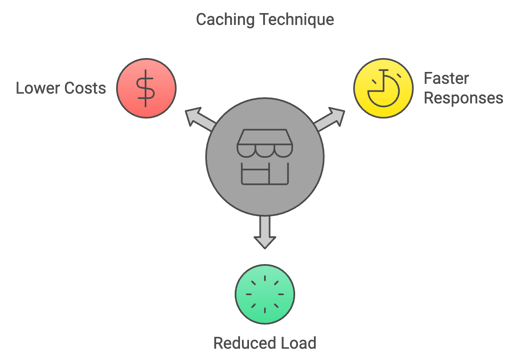
Caching là kỹ thuật lưu trữ kết quả tính toán trước đó và tái sử dụng khi gặp lại cùng đầu vào trong quá trình suy luận. Điều này tránh tính toán lặp lại, tăng tốc quá trình suy luận.
Cách thực hiện:
- Lưu kết quả trước đây: Duy trì bộ đệm các đầu vào trước đó và đầu ra tương ứng.
- Chính sách loại bỏ cache: Triển khai chiến lược loại các mục ít dùng khi bộ đệm đầy.
Lợi ích:
- Phản hồi nhanh hơn cho yêu cầu lặp lại: Caching đặc biệt hiệu quả với ứng dụng có nhiều yêu cầu giống hoặc tương tự nhau.
- Giảm tải tính toán: Ít phép tính hơn đồng nghĩa chi phí thấp hơn.
Tuy nhiên, caching chỉ hữu ích khi đầu vào lặp lại hoặc trùng lắp. Với khối lượng công việc biến động cao, tỉ lệ trúng cache có thể thấp, và chi phí duy trì bộ đệm có thể vượt lợi ích. Kết quả cũ hoặc lỗi thời cũng gây vấn đề nhất quán nếu đầu ra được lưu không còn phản ánh dữ liệu phù hợp nhất. Ngoài ra, triển khai và tinh chỉnh chiến lược loại bỏ cache làm tăng độ phức tạp kỹ thuật, đặc biệt trong hệ phân tán nơi đồng bộ cache là thách thức.
6. Thoát sớm (Early Exiting)
Early Exiting là dừng tính toán sớm trong quá trình suy luận nếu mô hình đủ tự tin về dự đoán của mình. Điều này tiết kiệm tài nguyên tính toán và tăng tốc suy luận cho các trường hợp đơn giản, nơi không cần chạy hết toàn bộ tầng.
Cách thực hiện:
- Ngưỡng tự tin: Đặt ngưỡng cho độ tự tin của mô hình. Nếu vượt ngưỡng ở một tầng trung gian, dừng tính toán và trả kết quả hiện tại.
- Thoát sớm thích ứng: Điều chỉnh linh hoạt ngưỡng dựa trên đầu vào hoặc tầng mô hình để cân bằng tốc độ và độ chính xác.
Lợi ích:
- Suy luận nhanh hơn cho ca dễ: Nếu mô hình có thể tự tin dự đoán sớm, sẽ tiết kiệm thời gian và tính toán.
- Giảm chi phí: Ít phép tính hơn đồng nghĩa chi phí thấp hơn.
Đánh đổi là thoát sớm có thể làm giảm nhẹ độ chính xác trong một số trường hợp, đặc biệt với đầu vào phức tạp.
7. Phần cứng tối ưu
Kỹ thuật này là tận dụng các kiến trúc và bộ tăng tốc phần cứng chuyên dụng được thiết kế cho tính toán AI hiệu quả. Bao gồm GPU, TPU và các chip AI chuyên dụng khác, mang lại cải thiện hiệu năng đáng kể so với CPU mục đích chung cho tác vụ suy luận.
Cách thực hiện:
- GPU: Tận dụng khả năng xử lý song song của GPU cho phép nhân ma trận và tính toán mạng nơ-ron.
- TPU: Dùng các đơn vị xử lý tensor chuyên dụng thiết kế riêng cho khối lượng công việc AI.
- Bộ tăng tốc AI khác: Khám phá các tùy chọn phần cứng mới như FPGA hoặc chip AI chuyên dụng.
Lợi ích:
- Suy luận nhanh hơn đáng kể: GPU và chip chuyên dụng nhanh hơn nhiều so với CPU cho kiểu tính toán mà LLM cần.
- Hiệu quả năng lượng tốt hơn: Điều này chuyển hóa thành chi phí năng lượng thấp hơn về lâu dài.
Tuy nhiên, phần cứng chuyên dụng thường đòi hỏi đầu tư ban đầu lớn và có thể khóa bạn trong hệ sinh thái của một nhà cung cấp. GPU, TPU hoặc bộ tăng tốc tùy chỉnh cũng khó cấp phát ổn định trên đám mây, nhất là lúc nhu cầu cao điểm. Triển khai on-premises kéo theo thách thức bảo trì và mở rộng, trong khi tùy chọn đám mây có thể tốn phí thuê thường xuyên cao hơn. Cuối cùng, thích nghi phần mềm để khai thác tối đa phần cứng chuyên dụng làm tăng độ phức tạp kỹ thuật và đòi hỏi tối ưu hóa liên tục.
8. Nén mô hình
Nén mô hình đề cập đến việc dùng nhiều hơn một kỹ thuật để giảm kích thước và độ phức tạp của mô hình mà không ảnh hưởng đáng kể đến hiệu năng. Có thể bao gồm cắt tỉa, lượng tử hóa, chưng cất tri thức hoặc các phương pháp khác nhằm tạo mô hình gọn nhẹ và hiệu quả hơn cho suy luận nhanh.
Cách thực hiện:
- Kết hợp nhiều kỹ thuật: Áp dụng kết hợp lượng tử hóa, cắt tỉa, chưng cất tri thức và các phương pháp khác để tối ưu giảm kích thước.
- Phân rã tensor: Phân rã các ma trận trọng số lớn thành biểu diễn nhỏ hơn, hiệu quả hơn.
Lợi ích:
- Kích thước mô hình nhỏ hơn: Dẫn tới tải nhanh hơn, ít dùng bộ nhớ hơn và có thể giảm chi phí.
Nén mô hình có thể gây suy giảm độ chính xác nếu áp dụng quá mạnh tay hoặc không tinh chỉnh cẩn thận. Kết hợp các phương pháp như cắt tỉa, lượng tử và chưng cất làm tăng độ phức tạp hệ thống và có thể đòi hỏi các vòng huấn luyện/tinh chỉnh bổ sung. Mô hình đã nén cũng kém linh hoạt khi chuyển sang tác vụ mới, do tối ưu hóa thường thu hẹp phạm vi kịch bản mà mô hình hoạt động tốt. Trong một số trường hợp, thời gian kỹ sư và chi phí tính toán dành cho nén có thể bù trừ lợi ích tiết kiệm ngắn hạn.
9. Suy luận phân tán
Suy luận phân tán là cách chia nhỏ khối lượng công việc suy luận trên nhiều máy hoặc thiết bị. Điều này cho phép xử lý song song các tác vụ suy luận quy mô lớn, giảm độ trễ và cải thiện thông lượng.
Cách thực hiện:
- Phân vùng mô hình: Chia mô hình cho nhiều máy, mỗi máy xử lý một phần tính toán.
- Cân bằng tải: Phân phối yêu cầu đến các máy sẵn có để sử dụng tài nguyên hiệu quả.
Lợi ích:
- Xử lý mô hình lớn hơn và lưu lượng cao hơn: Suy luận phân tán cho phép chia nhỏ tác vụ lớn trên nhiều máy, xử lý mô hình to hơn và nhiều yêu cầu cùng lúc. Điều này giúp phần cứng hiệu quả hơn và cho phép mở rộng linh hoạt trên đám mây, từ đó tiết kiệm chi phí.
Suy luận phân tán làm tăng đáng kể độ phức tạp hệ thống, do việc phối hợp tính toán trên nhiều máy cần điều phối vững chắc, đồng bộ và chịu lỗi. Độ trễ mạng và băng thông có thể triệt tiêu lợi ích hiệu năng, nhất là khi phải trao đổi lượng lớn dữ liệu trung gian. Nó cũng tăng chi phí hạ tầng, vì cần cấp phát và duy trì phần cứng bổ sung cùng cơ chế cân bằng tải. Gỡ lỗi và giám sát hệ phân tán khó hơn, khiến độ tin cậy là thách thức so với thiết lập một nút đơn.
10. Kỹ thuật prompt
Kỹ thuật prompt là quá trình soạn thảo cẩn thận các prompt đầu vào để định hướng LLM tạo ra đầu ra mong muốn. Bằng cách đặt prompt rõ ràng, súc tích và cụ thể, người dùng có thể cải thiện chất lượng và khả năng kiểm soát phản hồi của LLM, khiến chúng phù hợp và hữu ích hơn cho tác vụ cụ thể.
Cách thực hiện:
- Rõ ràng và súc tích: Dùng ngôn ngữ cụ thể và không mơ hồ trong prompt.
- Cung cấp ngữ cảnh: Bao gồm thông tin nền tảng liên quan hoặc ví dụ để định hướng LLM.
- Thử nghiệm và lặp lại: Kiểm thử nhiều cách diễn đạt prompt và đánh giá kết quả để tìm phương án hiệu quả nhất.
Lợi ích:
- Đầu ra phù hợp và ngắn gọn hơn: Kỹ thuật prompt tốt có thể giảm số token cần sinh, giúp suy luận nhanh hơn và có thể rẻ hơn.
- Cải thiện độ chính xác: Prompt rõ ràng giúp mô hình tránh hiểu sai và tạo phản hồi chính xác hơn.
Kỹ thuật prompt đòi hỏi thử nghiệm và lặp lại liên tục, có thể tốn thời gian và không nhất quán giữa các trường hợp sử dụng. Prompt soạn tốt có thể không khái quát, buộc bạn phải thiết kế lại khi tác vụ hoặc mô hình thay đổi. Các cải tiến trong thiết kế prompt cũng mong manh—chỉ thay đổi nhỏ về từ ngữ hoặc cập nhật mô hình có thể làm kết quả biến động khó lường. Cuối cùng, quá lệ thuộc vào kỹ thuật prompt mà thiếu các kỹ thuật bổ trợ như quản lý ngữ cảnh hoặc tinh chỉnh có thể hạn chế khả năng mở rộng và tiết kiệm chi phí dài hạn.
Bonus: Kỹ thuật ngữ cảnh (Context Engineering)
Kỹ thuật ngữ cảnh là thực hành thiết kế hệ thống kiểm soát thông tin mà LLM nhìn thấy trước khi sinh phản hồi. Thay vì nhồi nhét mọi thứ vào cửa sổ ngữ cảnh, bạn chọn lọc và tổ chức chỉ những chi tiết phù hợp nhất—như lịch sử người dùng, tài liệu truy hồi hoặc kết quả công cụ—để mô hình có thể suy luận hiệu quả hơn.
Cách thực hiện:
- Tóm tắt ngữ cảnh: Nén lịch sử hội thoại tích lũy hoặc tài liệu thành bản tóm tắt ngắn hơn để giữ ý nghĩa trong khi giảm token.
- Quản lý bộ công cụ: Dùng hệ thống truy hồi để chọn chỉ các công cụ hoặc mô tả phù hợp nhất thay vì chuyển tất cả tùy chọn sẵn có.
- Cắt tỉa ngữ cảnh: Loại thông tin lỗi thời hoặc dư thừa khi dữ liệu mới đến, giữ ngữ cảnh hoạt động gọn và hữu ích.
- Xác thực và cách ly ngữ cảnh: Phát hiện và cô lập ảo giác hoặc lỗi trước khi chúng làm hỏng bộ nhớ dài hạn.
Lợi ích:
- Giảm số token sử dụng: Ngữ cảnh ngắn gọn và tập trung hơn làm giảm số token xử lý, trực tiếp cắt giảm chi phí.
- Cải thiện độ chính xác: Ngữ cảnh sạch giúp mô hình ít bị phân tâm hoặc nhầm lẫn bởi chi tiết không liên quan hay mâu thuẫn.
- Suy luận nhanh hơn: Với ít token hơn và bộ nhớ KV ổn định hơn, yêu cầu hoàn tất nhanh hơn, tiết kiệm tài nguyên tính toán.
Đánh đổi là xây dựng hệ thống ngữ cảnh hiệu quả cần công sức kỹ thuật ban đầu. Bạn cần sẵn các pipeline truy hồi, tóm tắt và xác thực; thiết kế kém có thể gây thiếu hụt ngữ cảnh làm giảm hiệu năng. Nhưng nếu làm tốt, kỹ thuật ngữ cảnh khiến các ứng dụng lớn vừa tin cậy hơn vừa tiết kiệm chi phí hơn.
Kết luận
Giảm chi phí suy luận LLM không phải là một mẹo duy nhất. Đó là kết hợp những cách phù hợp với khối lượng công việc của bạn. Các kỹ thuật như lượng tử hóa, cắt tỉa và chưng cất tri thức giúp giảm kích thước mô hình. Batching, caching và suy luận phân tán cải thiện cách xử lý yêu cầu. Lựa chọn phần cứng và nén mô hình đẩy hiệu quả đi xa hơn, trong khi kỹ thuật prompt và ngữ cảnh giảm bớt token không cần thiết ngay từ nguồn.
Các đánh đổi là có thật: mỗi phương pháp mang đến độ phức tạp, nguy cơ mất chính xác hoặc chi phí hạ tầng. Nhưng lợi ích cộng dồn. Bằng cách áp dụng chỉ vài kỹ thuật, bạn có thể giữ mô hình ở mức chi phí phải chăng, mở rộng sử dụng mà không đội chi phí, và xây dựng hệ thống bền vững khi mô hình và ứng dụng lớn dần.


 Matt Crabtree · 10 min
Vận hành các mô hình ngôn ngữ lớn đi kèm chi phí thực. Bạn trả tiền cho từng token được xử lý, từng chu kỳ GPU được sử dụng và từng lớp độ phức tạp được thêm vào mô hình. Dù giá đã giảm, hóa đơn vẫn phình to rất nhanh khi bạn làm việc với ứng dụng lớn, prompt dài hoặc cập nhật thường xuyên.
Tôi đã thấy vấn đề này xuất hiện nhanh đến mức nào. Các nhóm thường cho rằng chi phí sẽ trong tầm kiểm soát, nhưng rồi nhận ra họ đang đốt ngân sách vào mô hình quá khổ, prompt kém hiệu quả hoặc phần cứng rỗi.
Đó là lý do tôi tổng hợp 10 cách thực tiễn để giảm chi phí suy luận. Từ lượng tử hóa và cắt tỉa đến batching, caching và kỹ thuật prompt, đây là những cách tiếp cận tôi thực sự dùng để giữ LLM ở mức chi phí phải chăng mà không đánh đổi quá nhiều hiệu năng.
1. Lượng tử hóa (Quantization)
Lượng tử hóa là quá trình giảm độ chính xác của trọng số và kích hoạt mô hình, thường từ số thực dấu phẩy động 32-bit xuống các biểu diễn ít bit hơn (ví dụ: 16-bit hoặc thậm chí 8-bit). Điều này giảm dung lượng bộ nhớ và yêu cầu tính toán, cho phép suy luận nhanh hơn trên thiết bị hạn chế tài nguyên.
Cách thực hiện:
Lợi ích:
Đánh đổi chính là nguy cơ mất độ chính xác. Dù kỹ thuật lượng tử hiện đại khá tốt, vẫn luôn có khả năng suy giảm nhẹ độ chính xác của mô hình.
2. Cắt tỉa (Pruning)
Cắt tỉa là kỹ thuật loại bỏ các trọng số kém quan trọng hoặc dư thừa khỏi mạng nơ-ron. Bằng cách loại bỏ các kết nối có tác động tối thiểu đến hiệu năng, cắt tỉa giúp giảm kích thước và độ phức tạp tính toán của mô hình, từ đó suy luận nhanh hơn.
Cách thực hiện:
Lợi ích:
Giống lượng tử hóa, đánh đổi chính là nguy cơ mất độ chính xác. Cắt tỉa quá mạnh có thể làm hiệu năng giảm đáng kể. Cần tìm điểm cân bằng phù hợp.
3. Chưng cất tri thức (Knowledge Distillation)
Chưng cất tri thức là quá trình chuyển giao tri thức từ mô hình “giáo viên” lớn, phức tạp sang mô hình “học sinh” nhỏ, hiệu quả hơn. Mô hình học sinh học cách bắt chước hành vi của giáo viên, nhờ đó đạt hiệu năng tương đương với kích thước nhỏ hơn và suy luận nhanh hơn.
Cách thực hiện:
Lợi ích:
Đánh đổi chính là bạn cần truy cập vào mô hình giáo viên mạnh mẽ, vốn tốn kém để huấn luyện hoặc sử dụng.
4. Batching
Batching là xử lý đồng thời nhiều mẫu đầu vào trong một lô khi suy luận. Cách này cải thiện hiệu quả bằng cách tận dụng khả năng xử lý song song của phần cứng, giúp suy luận tổng thể nhanh hơn.
Cách thực hiện:
Lợi ích:
Tuy nhiên, batching có thể tăng độ trễ cho từng yêu cầu riêng lẻ, vì hệ thống có thể chờ gom đủ đầu vào trước khi xử lý. Với ứng dụng thời gian thực hoặc yêu cầu độ trễ thấp, độ trễ thêm này có thể làm giảm trải nghiệm nếu không tinh chỉnh cẩn thận. Batching động giúp giảm vấn đề nhưng làm hệ thống phức tạp hơn. Cũng có rủi ro batching kém hiệu quả khi lưu lượng không đều, làm giảm mức tiết kiệm chi phí kỳ vọng.
5. Bộ đệm (Caching)
Caching là kỹ thuật lưu trữ kết quả tính toán trước đó và tái sử dụng khi gặp lại cùng đầu vào trong quá trình suy luận. Điều này tránh tính toán lặp lại, tăng tốc quá trình suy luận.
Cách thực hiện:
Lợi ích:
Tuy nhiên, caching chỉ hữu ích khi đầu vào lặp lại hoặc trùng lắp. Với khối lượng công việc biến động cao, tỉ lệ trúng cache có thể thấp, và chi phí duy trì bộ đệm có thể vượt lợi ích. Kết quả cũ hoặc lỗi thời cũng gây vấn đề nhất quán nếu đầu ra được lưu không còn phản ánh dữ liệu phù hợp nhất. Ngoài ra, triển khai và tinh chỉnh chiến lược loại bỏ cache làm tăng độ phức tạp kỹ thuật, đặc biệt trong hệ phân tán nơi đồng bộ cache là thách thức.
6. Thoát sớm (Early Exiting)
Early Exiting là dừng tính toán sớm trong quá trình suy luận nếu mô hình đủ tự tin về dự đoán của mình. Điều này tiết kiệm tài nguyên tính toán và tăng tốc suy luận cho các trường hợp đơn giản, nơi không cần chạy hết toàn bộ tầng.
Cách thực hiện:
Lợi ích:
Đánh đổi là thoát sớm có thể làm giảm nhẹ độ chính xác trong một số trường hợp, đặc biệt với đầu vào phức tạp.
7. Phần cứng tối ưu
Kỹ thuật này là tận dụng các kiến trúc và bộ tăng tốc phần cứng chuyên dụng được thiết kế cho tính toán AI hiệu quả. Bao gồm GPU, TPU và các chip AI chuyên dụng khác, mang lại cải thiện hiệu năng đáng kể so với CPU mục đích chung cho tác vụ suy luận.
Cách thực hiện:
Lợi ích:
Tuy nhiên, phần cứng chuyên dụng thường đòi hỏi đầu tư ban đầu lớn và có thể khóa bạn trong hệ sinh thái của một nhà cung cấp. GPU, TPU hoặc bộ tăng tốc tùy chỉnh cũng khó cấp phát ổn định trên đám mây, nhất là lúc nhu cầu cao điểm. Triển khai on-premises kéo theo thách thức bảo trì và mở rộng, trong khi tùy chọn đám mây có thể tốn phí thuê thường xuyên cao hơn. Cuối cùng, thích nghi phần mềm để khai thác tối đa phần cứng chuyên dụng làm tăng độ phức tạp kỹ thuật và đòi hỏi tối ưu hóa liên tục.
8. Nén mô hình
Nén mô hình đề cập đến việc dùng nhiều hơn một kỹ thuật để giảm kích thước và độ phức tạp của mô hình mà không ảnh hưởng đáng kể đến hiệu năng. Có thể bao gồm cắt tỉa, lượng tử hóa, chưng cất tri thức hoặc các phương pháp khác nhằm tạo mô hình gọn nhẹ và hiệu quả hơn cho suy luận nhanh.
Cách thực hiện:
Lợi ích:
Nén mô hình có thể gây suy giảm độ chính xác nếu áp dụng quá mạnh tay hoặc không tinh chỉnh cẩn thận. Kết hợp các phương pháp như cắt tỉa, lượng tử và chưng cất làm tăng độ phức tạp hệ thống và có thể đòi hỏi các vòng huấn luyện/tinh chỉnh bổ sung. Mô hình đã nén cũng kém linh hoạt khi chuyển sang tác vụ mới, do tối ưu hóa thường thu hẹp phạm vi kịch bản mà mô hình hoạt động tốt. Trong một số trường hợp, thời gian kỹ sư và chi phí tính toán dành cho nén có thể bù trừ lợi ích tiết kiệm ngắn hạn.
9. Suy luận phân tán
Suy luận phân tán là cách chia nhỏ khối lượng công việc suy luận trên nhiều máy hoặc thiết bị. Điều này cho phép xử lý song song các tác vụ suy luận quy mô lớn, giảm độ trễ và cải thiện thông lượng.
Cách thực hiện:
Lợi ích:
Suy luận phân tán làm tăng đáng kể độ phức tạp hệ thống, do việc phối hợp tính toán trên nhiều máy cần điều phối vững chắc, đồng bộ và chịu lỗi. Độ trễ mạng và băng thông có thể triệt tiêu lợi ích hiệu năng, nhất là khi phải trao đổi lượng lớn dữ liệu trung gian. Nó cũng tăng chi phí hạ tầng, vì cần cấp phát và duy trì phần cứng bổ sung cùng cơ chế cân bằng tải. Gỡ lỗi và giám sát hệ phân tán khó hơn, khiến độ tin cậy là thách thức so với thiết lập một nút đơn.
10. Kỹ thuật prompt
Kỹ thuật prompt là quá trình soạn thảo cẩn thận các prompt đầu vào để định hướng LLM tạo ra đầu ra mong muốn. Bằng cách đặt prompt rõ ràng, súc tích và cụ thể, người dùng có thể cải thiện chất lượng và khả năng kiểm soát phản hồi của LLM, khiến chúng phù hợp và hữu ích hơn cho tác vụ cụ thể.
Cách thực hiện:
Lợi ích:
Kỹ thuật prompt đòi hỏi thử nghiệm và lặp lại liên tục, có thể tốn thời gian và không nhất quán giữa các trường hợp sử dụng. Prompt soạn tốt có thể không khái quát, buộc bạn phải thiết kế lại khi tác vụ hoặc mô hình thay đổi. Các cải tiến trong thiết kế prompt cũng mong manh—chỉ thay đổi nhỏ về từ ngữ hoặc cập nhật mô hình có thể làm kết quả biến động khó lường. Cuối cùng, quá lệ thuộc vào kỹ thuật prompt mà thiếu các kỹ thuật bổ trợ như quản lý ngữ cảnh hoặc tinh chỉnh có thể hạn chế khả năng mở rộng và tiết kiệm chi phí dài hạn.
Bonus: Kỹ thuật ngữ cảnh (Context Engineering)
Kỹ thuật ngữ cảnh là thực hành thiết kế hệ thống kiểm soát thông tin mà LLM nhìn thấy trước khi sinh phản hồi. Thay vì nhồi nhét mọi thứ vào cửa sổ ngữ cảnh, bạn chọn lọc và tổ chức chỉ những chi tiết phù hợp nhất—như lịch sử người dùng, tài liệu truy hồi hoặc kết quả công cụ—để mô hình có thể suy luận hiệu quả hơn.
Cách thực hiện:
Lợi ích:
Đánh đổi là xây dựng hệ thống ngữ cảnh hiệu quả cần công sức kỹ thuật ban đầu. Bạn cần sẵn các pipeline truy hồi, tóm tắt và xác thực; thiết kế kém có thể gây thiếu hụt ngữ cảnh làm giảm hiệu năng. Nhưng nếu làm tốt, kỹ thuật ngữ cảnh khiến các ứng dụng lớn vừa tin cậy hơn vừa tiết kiệm chi phí hơn.
Kết luận
Giảm chi phí suy luận LLM không phải là một mẹo duy nhất. Đó là kết hợp những cách phù hợp với khối lượng công việc của bạn. Các kỹ thuật như lượng tử hóa, cắt tỉa và chưng cất tri thức giúp giảm kích thước mô hình. Batching, caching và suy luận phân tán cải thiện cách xử lý yêu cầu. Lựa chọn phần cứng và nén mô hình đẩy hiệu quả đi xa hơn, trong khi kỹ thuật prompt và ngữ cảnh giảm bớt token không cần thiết ngay từ nguồn.
Các đánh đổi là có thật: mỗi phương pháp mang đến độ phức tạp, nguy cơ mất chính xác hoặc chi phí hạ tầng. Nhưng lợi ích cộng dồn. Bằng cách áp dụng chỉ vài kỹ thuật, bạn có thể giữ mô hình ở mức chi phí phải chăng, mở rộng sử dụng mà không đội chi phí, và xây dựng hệ thống bền vững khi mô hình và ứng dụng lớn dần.