Eseguire large language model comporta costi reali. Paghi per ogni token elaborato, ogni ciclo GPU utilizzato e ogni livello di complessità aggiunto a un modello. Anche se i prezzi sono diminuiti, il conto cresce rapidamente quando lavori con applicazioni di grandi dimensioni, prompt lunghi o aggiornamenti frequenti.
Ho visto quanto velocemente questo diventa un problema. I team danno per scontato che i costi resteranno gestibili, salvo poi accorgersi che stanno bruciando budget su modelli sovradimensionati, prompt inefficienti o hardware inattivo.
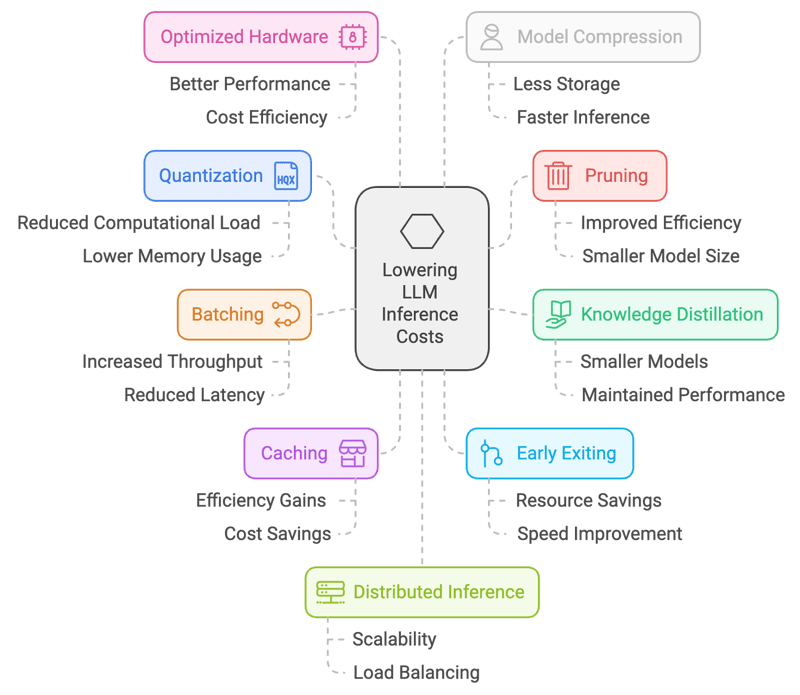
Per questo ho raccolto 10 modi pratici per ridurre i costi di inferenza. Dalla quantizzazione e pruning al batching, caching e prompt engineering, sono approcci che uso davvero per mantenere gli LLM accessibili senza sacrificare troppo le prestazioni.
1. Quantizzazione
La quantizzazione è un processo che riduce la precisione dei pesi e delle attivazioni del modello, in genere da numeri in virgola mobile a 32 bit a rappresentazioni a meno bit (ad es. 16 bit o persino 8 bit). Questo riduce l’occupazione di memoria e i requisiti computazionali, abilitando inferenze più veloci su dispositivi con risorse limitate.
Come si fa:
- Post-training quantization (PTQ): Converti i pesi di un modello pre-addestrato a una precisione inferiore (ad es. interi a 8 bit) senza riaddestrare. È relativamente semplice ma può comportare una perdita di accuratezza.
- Quantization-aware training (QAT): Effettua il fine-tuning del modello applicando tecniche di quantizzazione durante l’addestramento, così da preservare meglio l’accuratezza.
Come aiuta:
- Modello più piccolo: Si traduce in tempi di caricamento più rapidi e minore uso di memoria, con una riduzione significativa dei costi, soprattutto nel cloud dove paghi per le risorse utilizzate.
- Inferenza più veloce: Con numeri più piccoli, i calcoli sono più rapidi e i tempi di risposta diminuiscono.
Il principale compromesso è una possibile perdita di accuratezza. Anche se le tecniche moderne di quantizzazione sono molto valide, c’è sempre il rischio di un lieve calo delle prestazioni del modello.
2. Pruning
Il pruning è una tecnica che rimuove pesi meno importanti o ridondanti da una rete neurale. Eliminando connessioni con impatto minimo sulle prestazioni del modello, il pruning riduce dimensioni e complessità computazionale, portando a inferenze più veloci.
Come si fa:
- Pruning non strutturato: rimuove singoli pesi in base alla loro magnitudine o importanza.
- Pruning strutturato: rimuove interi canali o filtri, ottenendo strutture di modello più regolari ed efficienti da eseguire sull’hardware.
Come aiuta:
- Modello più piccolo: come per la quantizzazione, il pruning produce un modello più piccolo e veloce da caricare.
- Meno computazioni: meno connessioni significano meno calcoli in inferenza e tempi di risposta più rapidi.
Come per la quantizzazione, il principale compromesso è una possibile perdita di accuratezza. Un pruning aggressivo può causare un calo evidente delle prestazioni. È fondamentale trovare il giusto equilibrio.
3. Knowledge Distillation
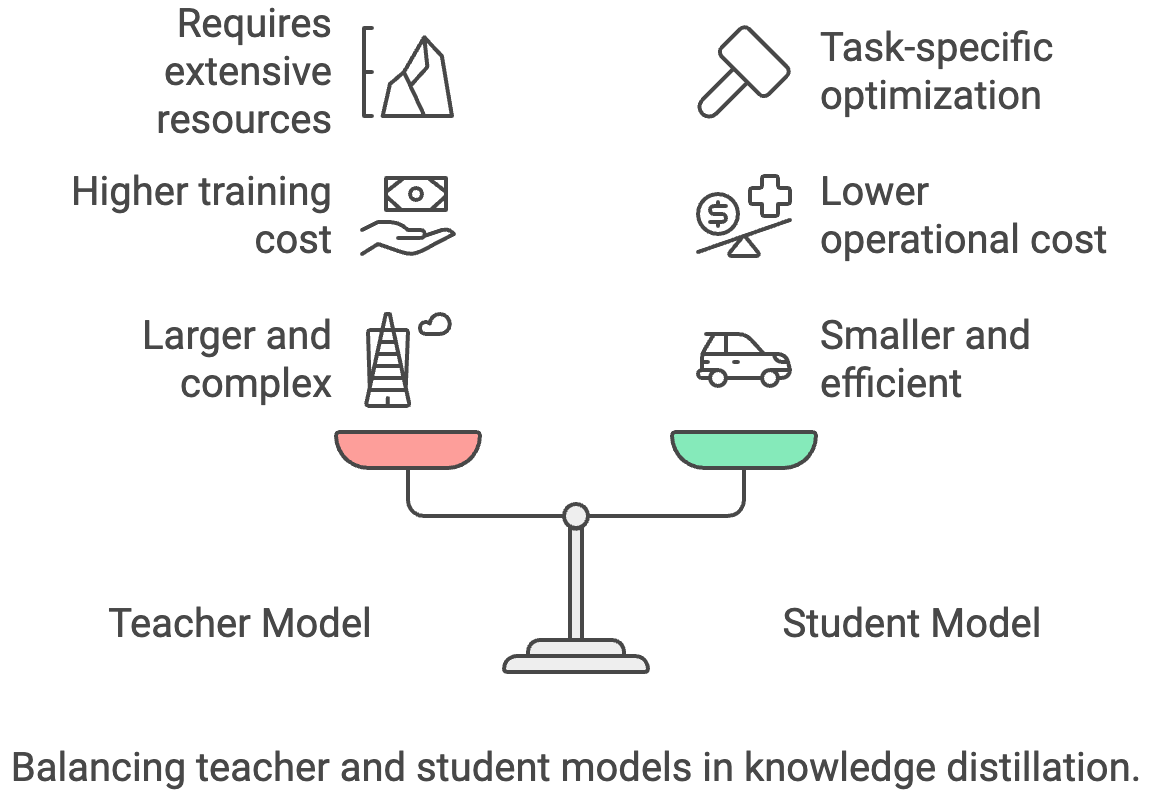
La knowledge distillation trasferisce la conoscenza da un grande e complesso modello “teacher” a un modello “student” più piccolo ed efficiente. Lo student impara a imitare il comportamento del teacher, raggiungendo prestazioni comparabili con dimensioni inferiori e inferenze più veloci.
Come si fa:
- Addestra un modello student più piccolo: usa le uscite del modello teacher (logit o etichette soft) come segnali di addestramento aggiuntivi per lo student.
- Temperature scaling: regola il parametro di temperatura durante la distillazione per controllare la “morbidezza” della distribuzione di output del teacher.
Come aiuta:
- Modello drasticamente più piccolo: gli student possono essere molto più piccoli e veloci dei teacher, con notevoli risparmi sui costi.
- Ottimizzazione specifica per il task: puoi fare fine-tuning dello student per un compito specifico, rendendolo ancora più efficiente.
Il principale compromesso è che serve accesso a un potente modello teacher, costoso da addestrare o utilizzare.
4. Batching
Il batching consiste nell’elaborare simultaneamente più campioni di input in un batch durante l’inferenza. Migliora l’efficienza sfruttando il parallelismo dell’hardware, con inferenze complessive più rapide.
Come si fa:
- Accumula richieste: raccogli più richieste di inferenza e processale insieme come un batch.
- Batching dinamico: adatta dinamicamente la dimensione del batch in base al flusso di richieste per bilanciare latenza e throughput.
Come aiuta:
- Throughput migliorato: il batching può aumentare significativamente il numero di richieste elaborate al secondo, rendendo l’applicazione più efficiente.
- Migliore utilizzo dell’hardware: le GPU sono progettate per l’elaborazione parallela e il batching permette di sfruttarle appieno.
Tuttavia, il batching può introdurre latenza aggiuntiva per le singole richieste, perché il sistema può attendere di accumulare input sufficienti prima di elaborare. Per applicazioni in tempo reale o a bassa latenza, questo ritardo extra può peggiorare l’esperienza utente se non viene calibrato con cura. Il batching dinamico aiuta ad attenuare il problema ma aggiunge complessità. C’è inoltre il rischio di batching inefficiente quando il traffico è irregolare, riducendo i risparmi attesi.
5. Caching
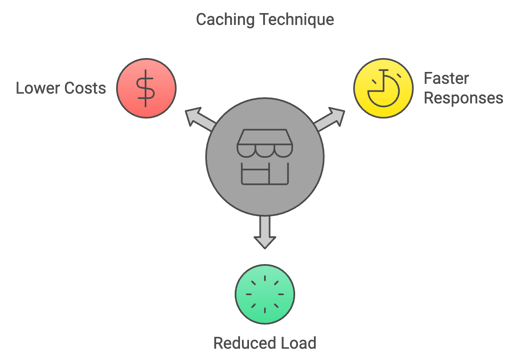
Il caching consiste nel memorizzare i risultati di calcoli precedenti e riutilizzarli quando si incontrano di nuovo gli stessi input in inferenza. Evita calcoli ridondanti e accelera il processo di inferenza.
Come si fa:
- Memorizza calcoli passati: mantieni una cache degli input precedenti e dei relativi output.
- Politiche di eviction della cache: implementa strategie per rimuovere gli elementi meno usati quando la cache raggiunge la capacità.
Come aiuta:
- Risposte più rapide per richieste ripetute: il caching è estremamente efficace quando le stesse o simili richieste si ripetono spesso.
- Carico computazionale ridotto: meno calcoli significano costi inferiori.
Il caching è utile solo quando gli input si ripetono o si sovrappongono. In carichi molto variabili, i tassi di hit possono essere bassi e l’overhead di gestione della cache superare i benefici. Risultati obsoleti possono creare problemi di coerenza se gli output memorizzati non riflettono più i dati più rilevanti. Inoltre, implementare e calibrare le strategie di eviction aggiunge complessità ingegneristica, soprattutto nei sistemi distribuiti, dove la sincronizzazione della cache è una sfida.
6. Early Exiting
L’Early Exiting prevede di interrompere il calcolo in anticipo durante l’inferenza se il modello è sufficientemente sicuro della propria previsione. Questo risparmia risorse computazionali e accelera l’inferenza nei casi semplici in cui un passaggio completo in avanti non è necessario.
Come si fa:
- Soglia di confidenza: imposta una soglia per la confidenza del modello nella previsione. Se la confidenza supera la soglia in un livello intermedio, interrompi il calcolo e restituisci l’output corrente.
- Early exiting adattivo: regola dinamicamente la soglia in base all’input o al livello del modello per bilanciare velocità e accuratezza.
Come aiuta:
- Inferenza più rapida per i casi facili: se il modello può prevedere con confidenza già in anticipo, si risparmiano tempo e calcolo.
- Costi ridotti: meno computazioni significano costi inferiori.
Il compromesso è che l’early exiting può portare a una leggera riduzione dell’accuratezza in alcuni casi, soprattutto con input complessi.
7. Hardware ottimizzato
Questo approccio prevede l’uso di architetture e acceleratori hardware specializzati progettati per calcoli di IA efficienti. Includono GPU, TPU e altri chip dedicati che offrono notevoli miglioramenti rispetto alle CPU generiche per i task di inferenza.
Come si fa:
- GPU: sfrutta le capacità di elaborazione parallela delle GPU per operazioni matriciali e calcoli di reti neurali.
- TPU: utilizza unità di elaborazione tensoriale specializzate per carichi di lavoro IA.
- Altri acceleratori IA: esplora opzioni hardware emergenti come FPGA o chip IA dedicati.
Come aiuta:
- Inferenza molto più veloce: GPU e chip specializzati sono molto più rapidi delle CPU per i calcoli richiesti dagli LLM.
- Migliore efficienza energetica: si traduce in costi energetici più bassi nel lungo periodo.
Tuttavia, l’hardware specializzato richiede spesso un investimento iniziale significativo e può legarti all’ecosistema di un fornitore. GPU, TPU o acceleratori personalizzati possono anche essere difficili da approvvigionare con costanza nel cloud, soprattutto nei picchi di domanda. Le installazioni on-prem introducono sfide di manutenzione e scalabilità, mentre le opzioni cloud possono avere canoni ricorrenti più alti. Infine, adattare il software per sfruttare pienamente l’hardware specializzato aggiunge complessità ingegneristica e richiede ottimizzazioni continue.
8. Compressione del modello
La compressione del modello consiste nell’usare più di una tecnica per ridurre dimensioni e complessità senza comprometterne significativamente le prestazioni. Può includere pruning, quantizzazione, knowledge distillation o altri metodi volti a creare un modello più compatto ed efficiente per inferenze più rapide.
Come si fa:
- Combina più tecniche: applica una combinazione di quantizzazione, pruning, knowledge distillation e altri metodi per ottenere la migliore riduzione possibile della dimensione del modello.
- Decomposizione dei tensori: decomponi grandi matrici di pesi in rappresentazioni più piccole ed efficienti.
Come aiuta:
- Modello più piccolo: si traduce in caricamenti più rapidi, minore uso di memoria e potenzialmente costi più bassi.
La compressione può degradare l’accuratezza se applicata troppo aggressivamente o senza un’attenta calibrazione. Combinare metodi come pruning, quantizzazione e distillazione aumenta la complessità e può richiedere cicli aggiuntivi di riaddestramento o fine-tuning. I modelli compressi possono anche essere meno flessibili nel trasferimento a nuovi task, poiché le ottimizzazioni spesso restringono gli scenari in cui il modello rende al meglio. In alcuni casi, il tempo ingegneristico e l’overhead computazionale spesi per la compressione possono compensare i risparmi nel breve termine.
9. Inferenza distribuita
L’inferenza distribuita suddivide il carico di lavoro di inferenza su più macchine o dispositivi. Consente l’elaborazione parallela di task su larga scala, riducendo la latenza e migliorando il throughput.
Come si fa:
- Partizionamento del modello: suddividi il modello tra più macchine, ciascuna responsabile di una parte del calcolo.
- Load balancing: distribuisci le richieste in arrivo sulle macchine disponibili per utilizzare al meglio le risorse.
Come aiuta:
- Gestisce modelli più grandi e traffico maggiore: l’inferenza distribuita permette di suddividere grandi task su più macchine, gestendo modelli più capienti e più richieste in parallelo. Rende l’hardware più efficiente e consente uno scaling flessibile nel cloud, con conseguenti risparmi.
L’inferenza distribuita introduce notevole complessità: coordinare i calcoli tra più macchine richiede orchestrazione, sincronizzazione e tolleranza ai guasti robuste. Latenza di rete e limiti di banda possono annullare i guadagni, soprattutto quando vanno scambiati grandi volumi di dati intermedi. Aumenta anche i costi infrastrutturali, perché servono hardware aggiuntivo e meccanismi di bilanciamento. Il debugging e il monitoraggio sono più difficili, rendendo l’affidabilità più sfidante rispetto a setup su singolo nodo.
10. Prompt Engineering
Il prompt engineering consiste nel progettare con cura i prompt di input per guidare i large language model (LLM) verso gli output desiderati. Con prompt chiari, concisi e specifici, puoi migliorare qualità e controllabilità delle risposte, rendendole più pertinenti e utili per task specifici.
Come si fa:
- Sii chiaro e conciso: usa un linguaggio specifico e non ambiguo nei prompt.
- Fornisci contesto: includi informazioni di background o esempi rilevanti per guidare l’LLM.
- Sperimenta e itera: prova diverse formulazioni e valuta i risultati per trovare le più efficaci.
Come aiuta:
- Output più pertinenti e concisi: un buon prompt engineering può ridurre il numero di token che il modello deve generare, con inferenze più veloci e potenzialmente più economiche.
- Accuratezza migliorata: prompt chiari aiutano il modello a evitare fraintendimenti e a generare risposte più accurate.
Il prompt engineering richiede sperimentazione e iterazione continue, può essere dispendioso in termini di tempo e incoerente tra i casi d’uso. Prompt ben progettati possono non generalizzare, costringendoti a ripensarli quando cambiano task o modelli. I miglioramenti possono essere fragili: piccole variazioni di testo o aggiornamenti del modello possono alterare i risultati in modo imprevedibile. Infine, affidarsi troppo al prompt engineering senza tecniche complementari come la gestione del contesto o il fine-tuning può limitarne la scalabilità e i risparmi a lungo termine.
Bonus: Context Engineering
Il context engineering è la pratica di progettare sistemi che controllano quali informazioni un LLM vede prima di generare una risposta. Invece di stipare tutto nella finestra di contesto, selezioni e organizzi solo i dettagli più rilevanti—come cronologia utente, documenti recuperati o output di strumenti—così che il modello possa ragionare in modo più efficiente.
Come si fa:
- Sintesi del contesto: comprimi la cronologia di conversazione o i documenti accumulati in sintesi più brevi per preservare il significato riducendo i token.
- Gestione del set di strumenti: usa sistemi di retrieval per selezionare solo gli strumenti o le descrizioni più rilevanti invece di passare ogni opzione disponibile.
- Potatura del contesto: rimuovi informazioni obsolete o ridondanti man mano che arrivano nuovi dati, mantenendo il contesto attivo snello e utile.
- Validazione e quarantena del contesto: rileva e isola allucinazioni o errori prima che contaminino la memoria a lungo termine.
Come aiuta:
- Meno token usati: contesti più brevi e mirati riducono il numero di token processati, tagliando direttamente i costi.
- Accuratezza migliorata: un contesto più pulito riduce il rischio che il modello venga distratto o confuso da dettagli irrilevanti o in conflitto.
- Inferenza più veloce: con meno token e una KV cache più stabile, le richieste si completano più rapidamente, risparmiando calcolo.
Il compromesso è che costruire sistemi di contesto efficaci richiede lavoro di ingegneria iniziale. Servono pipeline di retrieval, sintesi e validazione; un design carente può creare lacune di contesto che penalizzano le prestazioni. Ma quando è fatto bene, il context engineering rende le grandi applicazioni più affidabili e più economiche.
Conclusione
Ridurre i costi di inferenza degli LLM non è questione di un solo trucco. Si tratta di combinare approcci sensati per il tuo carico di lavoro. Tecniche come quantizzazione, pruning e knowledge distillation riducono la dimensione del modello. Batching, caching e inferenza distribuita migliorano l’elaborazione delle richieste. Le scelte hardware e la compressione spingono l’efficienza oltre, mentre prompt e context engineering riducono all’origine l’uso inutile di token.
I compromessi sono reali: ogni metodo introduce complessità, possibili perdite di accuratezza o overhead infrastrutturale. Ma i benefici si sommano. Applicando anche solo alcune di queste tecniche, puoi mantenere i modelli accessibili, scalare l’uso senza costi fuori controllo e costruire sistemi sostenibili man mano che modelli e applicazioni crescono.



 Abid Ali Awan · 10 min


 Tim Lu · 12 min
Eseguire large language model comporta costi reali. Paghi per ogni token elaborato, ogni ciclo GPU utilizzato e ogni livello di complessità aggiunto a un modello. Anche se i prezzi sono diminuiti, il conto cresce rapidamente quando lavori con applicazioni di grandi dimensioni, prompt lunghi o aggiornamenti frequenti.
Ho visto quanto velocemente questo diventa un problema. I team danno per scontato che i costi resteranno gestibili, salvo poi accorgersi che stanno bruciando budget su modelli sovradimensionati, prompt inefficienti o hardware inattivo.
Per questo ho raccolto 10 modi pratici per ridurre i costi di inferenza. Dalla quantizzazione e pruning al batching, caching e prompt engineering, sono approcci che uso davvero per mantenere gli LLM accessibili senza sacrificare troppo le prestazioni.
1. Quantizzazione
La quantizzazione è un processo che riduce la precisione dei pesi e delle attivazioni del modello, in genere da numeri in virgola mobile a 32 bit a rappresentazioni a meno bit (ad es. 16 bit o persino 8 bit). Questo riduce l’occupazione di memoria e i requisiti computazionali, abilitando inferenze più veloci su dispositivi con risorse limitate.
Come si fa:
Come aiuta:
Il principale compromesso è una possibile perdita di accuratezza. Anche se le tecniche moderne di quantizzazione sono molto valide, c’è sempre il rischio di un lieve calo delle prestazioni del modello.
2. Pruning
Il pruning è una tecnica che rimuove pesi meno importanti o ridondanti da una rete neurale. Eliminando connessioni con impatto minimo sulle prestazioni del modello, il pruning riduce dimensioni e complessità computazionale, portando a inferenze più veloci.
Come si fa:
Come aiuta:
Come per la quantizzazione, il principale compromesso è una possibile perdita di accuratezza. Un pruning aggressivo può causare un calo evidente delle prestazioni. È fondamentale trovare il giusto equilibrio.
3. Knowledge Distillation
La knowledge distillation trasferisce la conoscenza da un grande e complesso modello “teacher” a un modello “student” più piccolo ed efficiente. Lo student impara a imitare il comportamento del teacher, raggiungendo prestazioni comparabili con dimensioni inferiori e inferenze più veloci.
Come si fa:
Come aiuta:
Il principale compromesso è che serve accesso a un potente modello teacher, costoso da addestrare o utilizzare.
4. Batching
Il batching consiste nell’elaborare simultaneamente più campioni di input in un batch durante l’inferenza. Migliora l’efficienza sfruttando il parallelismo dell’hardware, con inferenze complessive più rapide.
Come si fa:
Come aiuta:
Tuttavia, il batching può introdurre latenza aggiuntiva per le singole richieste, perché il sistema può attendere di accumulare input sufficienti prima di elaborare. Per applicazioni in tempo reale o a bassa latenza, questo ritardo extra può peggiorare l’esperienza utente se non viene calibrato con cura. Il batching dinamico aiuta ad attenuare il problema ma aggiunge complessità. C’è inoltre il rischio di batching inefficiente quando il traffico è irregolare, riducendo i risparmi attesi.
5. Caching
Il caching consiste nel memorizzare i risultati di calcoli precedenti e riutilizzarli quando si incontrano di nuovo gli stessi input in inferenza. Evita calcoli ridondanti e accelera il processo di inferenza.
Come si fa:
Come aiuta:
Il caching è utile solo quando gli input si ripetono o si sovrappongono. In carichi molto variabili, i tassi di hit possono essere bassi e l’overhead di gestione della cache superare i benefici. Risultati obsoleti possono creare problemi di coerenza se gli output memorizzati non riflettono più i dati più rilevanti. Inoltre, implementare e calibrare le strategie di eviction aggiunge complessità ingegneristica, soprattutto nei sistemi distribuiti, dove la sincronizzazione della cache è una sfida.
6. Early Exiting
L’Early Exiting prevede di interrompere il calcolo in anticipo durante l’inferenza se il modello è sufficientemente sicuro della propria previsione. Questo risparmia risorse computazionali e accelera l’inferenza nei casi semplici in cui un passaggio completo in avanti non è necessario.
Come si fa:
Come aiuta:
Il compromesso è che l’early exiting può portare a una leggera riduzione dell’accuratezza in alcuni casi, soprattutto con input complessi.
7. Hardware ottimizzato
Questo approccio prevede l’uso di architetture e acceleratori hardware specializzati progettati per calcoli di IA efficienti. Includono GPU, TPU e altri chip dedicati che offrono notevoli miglioramenti rispetto alle CPU generiche per i task di inferenza.
Come si fa:
Come aiuta:
Tuttavia, l’hardware specializzato richiede spesso un investimento iniziale significativo e può legarti all’ecosistema di un fornitore. GPU, TPU o acceleratori personalizzati possono anche essere difficili da approvvigionare con costanza nel cloud, soprattutto nei picchi di domanda. Le installazioni on-prem introducono sfide di manutenzione e scalabilità, mentre le opzioni cloud possono avere canoni ricorrenti più alti. Infine, adattare il software per sfruttare pienamente l’hardware specializzato aggiunge complessità ingegneristica e richiede ottimizzazioni continue.
8. Compressione del modello
La compressione del modello consiste nell’usare più di una tecnica per ridurre dimensioni e complessità senza comprometterne significativamente le prestazioni. Può includere pruning, quantizzazione, knowledge distillation o altri metodi volti a creare un modello più compatto ed efficiente per inferenze più rapide.
Come si fa:
Come aiuta:
La compressione può degradare l’accuratezza se applicata troppo aggressivamente o senza un’attenta calibrazione. Combinare metodi come pruning, quantizzazione e distillazione aumenta la complessità e può richiedere cicli aggiuntivi di riaddestramento o fine-tuning. I modelli compressi possono anche essere meno flessibili nel trasferimento a nuovi task, poiché le ottimizzazioni spesso restringono gli scenari in cui il modello rende al meglio. In alcuni casi, il tempo ingegneristico e l’overhead computazionale spesi per la compressione possono compensare i risparmi nel breve termine.
9. Inferenza distribuita
L’inferenza distribuita suddivide il carico di lavoro di inferenza su più macchine o dispositivi. Consente l’elaborazione parallela di task su larga scala, riducendo la latenza e migliorando il throughput.
Come si fa:
Come aiuta:
L’inferenza distribuita introduce notevole complessità: coordinare i calcoli tra più macchine richiede orchestrazione, sincronizzazione e tolleranza ai guasti robuste. Latenza di rete e limiti di banda possono annullare i guadagni, soprattutto quando vanno scambiati grandi volumi di dati intermedi. Aumenta anche i costi infrastrutturali, perché servono hardware aggiuntivo e meccanismi di bilanciamento. Il debugging e il monitoraggio sono più difficili, rendendo l’affidabilità più sfidante rispetto a setup su singolo nodo.
10. Prompt Engineering
Il prompt engineering consiste nel progettare con cura i prompt di input per guidare i large language model (LLM) verso gli output desiderati. Con prompt chiari, concisi e specifici, puoi migliorare qualità e controllabilità delle risposte, rendendole più pertinenti e utili per task specifici.
Come si fa:
Come aiuta:
Il prompt engineering richiede sperimentazione e iterazione continue, può essere dispendioso in termini di tempo e incoerente tra i casi d’uso. Prompt ben progettati possono non generalizzare, costringendoti a ripensarli quando cambiano task o modelli. I miglioramenti possono essere fragili: piccole variazioni di testo o aggiornamenti del modello possono alterare i risultati in modo imprevedibile. Infine, affidarsi troppo al prompt engineering senza tecniche complementari come la gestione del contesto o il fine-tuning può limitarne la scalabilità e i risparmi a lungo termine.
Bonus: Context Engineering
Il context engineering è la pratica di progettare sistemi che controllano quali informazioni un LLM vede prima di generare una risposta. Invece di stipare tutto nella finestra di contesto, selezioni e organizzi solo i dettagli più rilevanti—come cronologia utente, documenti recuperati o output di strumenti—così che il modello possa ragionare in modo più efficiente.
Come si fa:
Come aiuta:
Il compromesso è che costruire sistemi di contesto efficaci richiede lavoro di ingegneria iniziale. Servono pipeline di retrieval, sintesi e validazione; un design carente può creare lacune di contesto che penalizzano le prestazioni. Ma quando è fatto bene, il context engineering rende le grandi applicazioni più affidabili e più economiche.
Conclusione
Ridurre i costi di inferenza degli LLM non è questione di un solo trucco. Si tratta di combinare approcci sensati per il tuo carico di lavoro. Tecniche come quantizzazione, pruning e knowledge distillation riducono la dimensione del modello. Batching, caching e inferenza distribuita migliorano l’elaborazione delle richieste. Le scelte hardware e la compressione spingono l’efficienza oltre, mentre prompt e context engineering riducono all’origine l’uso inutile di token.
I compromessi sono reali: ogni metodo introduce complessità, possibili perdite di accuratezza o overhead infrastrutturale. Ma i benefici si sommano. Applicando anche solo alcune di queste tecniche, puoi mantenere i modelli accessibili, scalare l’uso senza costi fuori controllo e costruire sistemi sostenibili man mano che modelli e applicazioni crescono.