Menjalankan model bahasa besar datang dengan biaya nyata. Anda membayar setiap token yang diproses, setiap siklus GPU yang digunakan, dan setiap lapisan kompleksitas yang ditambahkan ke model. Meskipun harga telah turun, tagihannya tetap meningkat cepat saat Anda bekerja dengan aplikasi besar, prompt panjang, atau pembaruan yang sering.
Saya sudah melihat betapa cepatnya ini menjadi masalah. Tim mengira biaya akan tetap terkendali, namun kemudian menyadari mereka menghabiskan anggaran untuk model yang terlalu besar, prompt yang tidak efisien, atau perangkat keras yang menganggur.
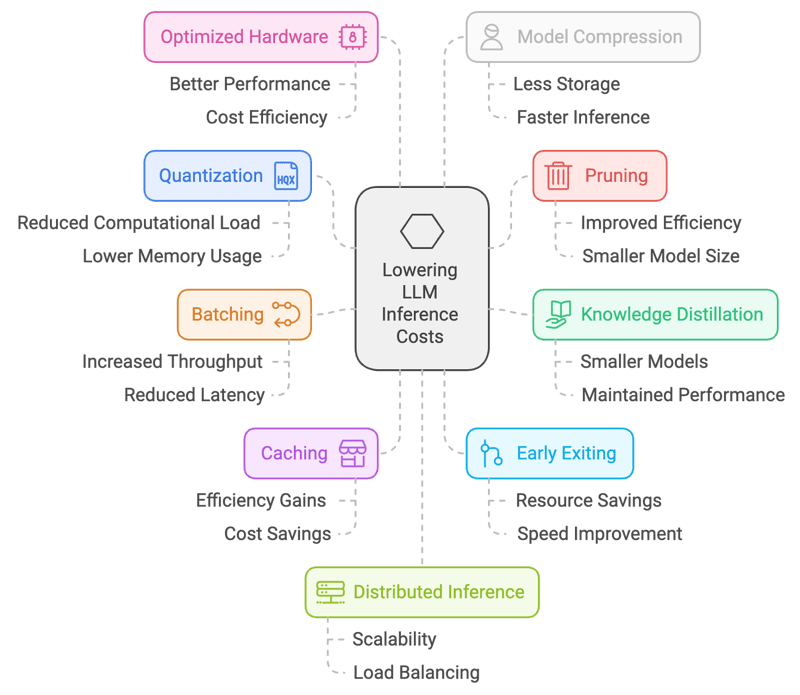
Itulah mengapa saya merangkum 10 cara praktis untuk menurunkan biaya inferensi. Dari kuantisasi dan pruning hingga batching, caching, dan rekayasa prompt, ini adalah pendekatan yang benar-benar saya gunakan untuk menjaga LLM tetap terjangkau tanpa terlalu mengorbankan kinerja.
1. Kuantisasi
Kuantisasi adalah proses mengurangi presisi bobot dan aktivasi model, umumnya dari angka floating point 32-bit ke representasi bit yang lebih rendah (misalnya 16-bit atau bahkan 8-bit). Ini mengurangi jejak memori dan kebutuhan komputasi, sehingga memungkinkan inferensi yang lebih cepat pada perangkat dengan sumber daya terbatas.
Cara melakukannya:
- Post-training quantization (PTQ): Mengonversi bobot model pra-latih ke presisi lebih rendah (misalnya bilangan bulat 8-bit) tanpa pelatihan ulang. Ini relatif sederhana tetapi dapat menyebabkan sedikit penurunan akurasi.
- Quantization-aware training (QAT): Fine-tune model dengan teknik kuantisasi selama pelatihan, sehingga akurasi lebih terjaga.
Manfaatnya:
- Ukuran model lebih kecil: Ini berarti waktu pemuatan lebih cepat dan penggunaan memori lebih sedikit, yang dapat mengurangi biaya secara signifikan, terutama di lingkungan cloud yang menagih berdasarkan sumber daya yang digunakan.
- Inferensi lebih cepat: Dengan angka yang lebih kecil, perhitungan menjadi lebih cepat, menghasilkan waktu respons yang lebih singkat.
Kompromi utamanya adalah potensi kehilangan akurasi. Meskipun teknik kuantisasi modern sudah cukup baik, selalu ada kemungkinan terjadi sedikit penurunan akurasi model.
2. Pruning
Pruning adalah teknik menghapus bobot yang kurang penting atau redundan dari jaringan saraf. Dengan menghilangkan koneksi yang berdampak minimal pada kinerja model, pruning mengurangi ukuran dan kompleksitas komputasi model, sehingga inferensi menjadi lebih cepat.
Cara melakukannya:
- Unstructured pruning: Menghapus bobot individual berdasarkan magnitudo atau tingkat kepentingannya.
- Structured pruning: Menghapus seluruh kanal atau filter, menghasilkan struktur model yang lebih teratur dan efisien dijalankan di perangkat keras.
Manfaatnya:
- Ukuran model lebih kecil: Mirip dengan kuantisasi, pruning menghasilkan model yang lebih kecil dan lebih cepat dimuat.
- Komputasi berkurang: Lebih sedikit koneksi berarti lebih sedikit perhitungan saat inferensi, sehingga waktu respons lebih cepat.
Sama seperti kuantisasi, kompromi utamanya adalah potensi kehilangan akurasi. Pruning yang agresif dapat menyebabkan penurunan kinerja yang nyata. Menemukan keseimbangan yang tepat sangat penting.
3. Distilasi Pengetahuan
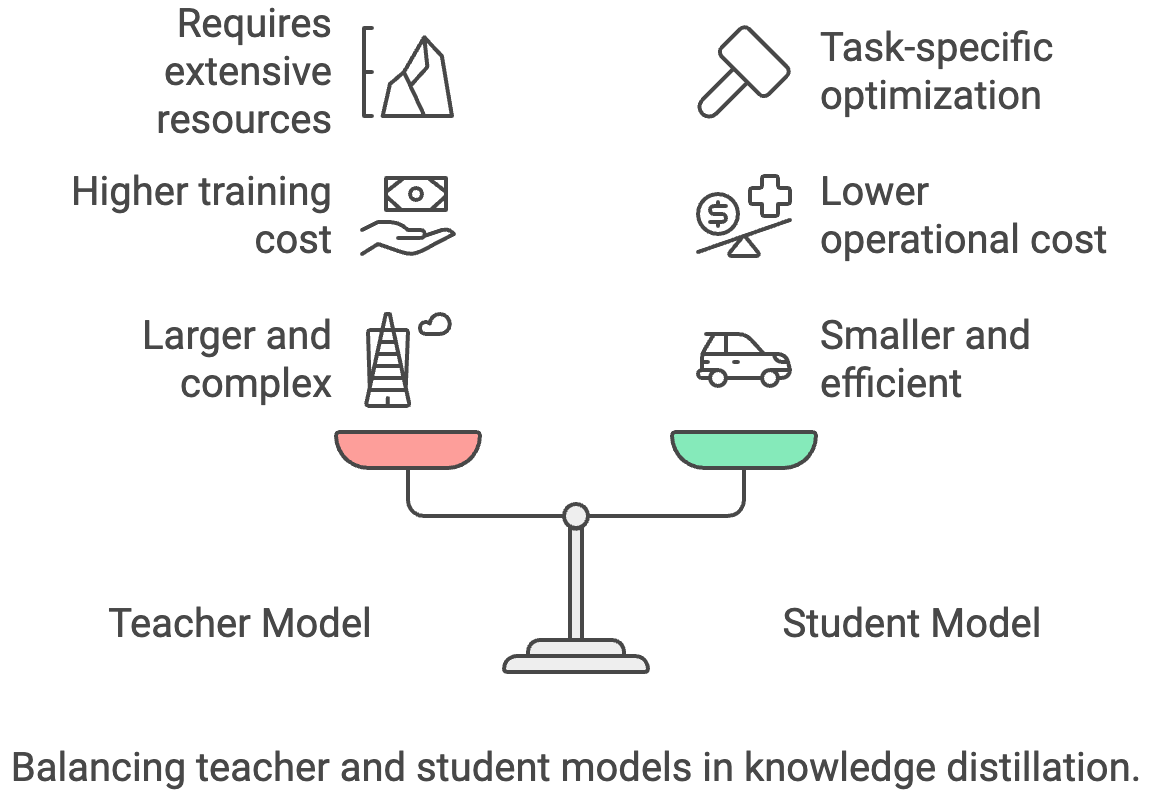
Knowledge distillation adalah proses mentransfer pengetahuan dari model "guru" yang besar dan kompleks ke model "murid" yang lebih kecil dan efisien. Model murid belajar meniru perilaku guru, sehingga mampu mencapai kinerja yang sebanding dengan ukuran lebih kecil dan inferensi lebih cepat.
Cara melakukannya:
- Latih model murid yang lebih kecil: Gunakan keluaran model guru yang lebih besar (logit atau soft labels) sebagai sinyal pelatihan tambahan untuk model murid.
- Temperature scaling: Sesuaikan parameter temperatur selama distilasi untuk mengontrol seberapa "lunak" distribusi keluaran guru.
Manfaatnya:
- Model jauh lebih kecil: Model murid bisa jauh lebih kecil dan lebih cepat daripada gurunya, menghasilkan penghematan biaya besar.
- Optimasi spesifik tugas: Anda dapat melakukan fine-tune model murid untuk tugas tertentu, sehingga makin efisien.
Kompromi utamanya adalah Anda memerlukan akses ke model guru yang kuat, yang bisa mahal untuk dilatih atau digunakan.
4. Batching
Batching melibatkan pemrosesan beberapa sampel input secara bersamaan dalam satu batch saat inferensi. Ini meningkatkan efisiensi dengan memanfaatkan kemampuan pemrosesan paralel pada perangkat keras, sehingga inferensi keseluruhan lebih cepat.
Cara melakukannya:
- Akumulasi permintaan: Kumpulkan beberapa permintaan inferensi dan proses bersama-sama sebagai satu batch.
- Dynamic batching: Sesuaikan ukuran batch secara dinamis berdasarkan laju permintaan yang masuk untuk menyeimbangkan latensi dan throughput.
Manfaatnya:
- Throughput meningkat: Batching dapat secara signifikan meningkatkan jumlah permintaan yang diproses per detik, membuat aplikasi Anda lebih efisien.
- Pemanfaatan perangkat keras lebih baik: GPU dirancang untuk pemrosesan paralel, dan batching membantu Anda memaksimalkan kemampuannya.
Namun, batching dapat menambah latensi untuk setiap permintaan individu, karena sistem mungkin menunggu hingga cukup input terkumpul sebelum memproses. Untuk aplikasi waktu nyata atau berlatensi rendah, penundaan tambahan ini dapat menurunkan pengalaman pengguna jika tidak ditata dengan cermat. Dynamic batching membantu mengurangi masalah tersebut tetapi menambah kompleksitas sistem. Ada juga risiko batching yang tidak efisien saat lalu lintas tidak merata, yang dapat mengurangi penghematan biaya yang diharapkan.
5. Caching
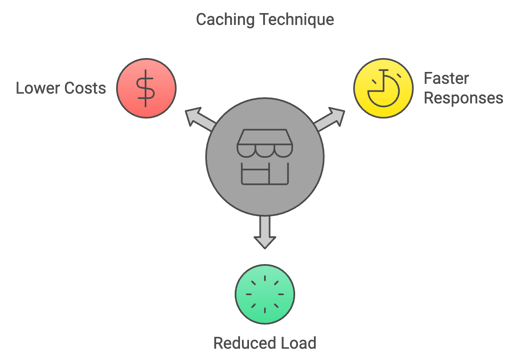
Caching adalah teknik menyimpan hasil komputasi sebelumnya dan menggunakannya kembali saat menemui input yang sama selama inferensi. Ini menghindari perhitungan berulang, mempercepat proses inferensi.
Cara melakukannya:
- Simpan komputasi sebelumnya: Pertahankan cache berisi input sebelumnya dan keluaran yang sesuai.
- Kebijakan penghapusan cache: Terapkan strategi untuk menghapus item yang jarang digunakan saat cache mencapai kapasitas.
Manfaatnya:
- Respons lebih cepat untuk permintaan berulang: Caching sangat efektif untuk aplikasi yang sering menerima permintaan yang sama atau mirip.
- Beban komputasi berkurang: Lebih sedikit komputasi berarti biaya lebih rendah.
Namun, caching hanya berguna saat input berulang atau tumpang tindih. Dalam beban kerja yang sangat bervariasi, tingkat hit bisa rendah, dan overhead untuk memelihara cache bisa melebihi manfaatnya. Hasil yang usang atau kedaluwarsa juga bisa menimbulkan masalah konsistensi jika keluaran cache tidak lagi mencerminkan data yang paling relevan. Selain itu, penerapan dan penyetelan strategi penghapusan cache menambah kompleksitas rekayasa, terutama di sistem terdistribusi di mana sinkronisasi cache menjadi tantangan.
6. Early Exiting
Early Exiting melibatkan penghentian komputasi lebih awal saat inferensi jika model sudah cukup yakin dengan prediksinya. Ini menghemat sumber daya komputasi dan mempercepat inferensi untuk kasus yang lebih sederhana di mana full forward pass tidak diperlukan.
Cara melakukannya:
- Ambang kepercayaan: Tetapkan ambang untuk tingkat kepercayaan model pada prediksinya. Jika kepercayaan melampaui ambang di lapisan menengah, hentikan komputasi dan kembalikan keluaran saat ini.
- Adaptive early exiting: Sesuaikan ambang secara dinamis berdasarkan input atau lapisan model untuk menyeimbangkan kecepatan dan akurasi.
Manfaatnya:
- Inferensi lebih cepat untuk kasus mudah: Jika model dapat memprediksi keluaran dengan yakin lebih awal, waktu dan komputasi bisa dihemat.
- Biaya berkurang: Lebih sedikit komputasi berarti biaya lebih rendah.
Komprominya adalah early exiting dapat menyebabkan sedikit penurunan akurasi pada beberapa kasus, terutama untuk input yang kompleks.
7. Perangkat Keras yang Dioptimalkan
Teknik ini melibatkan pemanfaatan arsitektur perangkat keras dan akselerator khusus yang dirancang untuk komputasi AI yang efisien. Ini mencakup GPU, TPU, dan chip AI khusus lainnya yang menawarkan peningkatan kinerja signifikan dibanding CPU tujuan umum untuk tugas inferensi.
Cara melakukannya:
- GPU: Manfaatkan kemampuan pemrosesan paralel GPU untuk operasi matriks dan komputasi jaringan saraf.
- TPU: Gunakan tensor processing unit khusus yang dirancang untuk beban kerja AI.
- Akselerator AI lainnya: Jelajahi opsi perangkat keras yang sedang berkembang seperti FPGA atau chip AI khusus.
Manfaatnya:
- Inferensi jauh lebih cepat: GPU dan chip khusus jauh lebih cepat daripada CPU untuk jenis perhitungan yang dibutuhkan LLM.
- Efisiensi energi lebih baik: Ini berarti biaya energi lebih rendah dalam jangka panjang.
Namun, perangkat keras khusus sering kali memerlukan investasi awal yang besar dan dapat mengunci Anda pada ekosistem vendor tertentu. GPU, TPU, atau akselerator khusus juga bisa lebih sulit disediakan secara konsisten di cloud, terutama saat permintaan puncak. Penerapan on-premise membawa tantangan pemeliharaan dan penskalaan, sementara opsi cloud mungkin memiliki biaya sewa berkelanjutan yang lebih tinggi. Terakhir, menyesuaikan perangkat lunak agar sepenuhnya memanfaatkan perangkat keras khusus dapat menambah kompleksitas rekayasa dan memerlukan optimalisasi berkelanjutan.
8. Kompresi Model
Kompresi model merujuk pada penggunaan lebih dari satu teknik untuk mengurangi ukuran dan kompleksitas model tanpa secara signifikan mengorbankan kinerjanya. Ini dapat melibatkan pruning, kuantisasi, distilasi pengetahuan, atau metode lain yang bertujuan menciptakan model yang lebih ringkas dan efisien untuk inferensi yang lebih cepat.
Cara melakukannya:
- Gabungkan beberapa teknik: Terapkan kombinasi kuantisasi, pruning, distilasi pengetahuan, dan metode lain untuk mencapai pengurangan ukuran model yang optimal.
- Dekomposisi tensor: Uraikan matriks bobot besar menjadi representasi yang lebih kecil dan lebih efisien.
Manfaatnya:
- Ukuran model lebih kecil: Ini berarti pemuatan lebih cepat, penggunaan memori lebih sedikit, dan berpotensi biaya lebih rendah.
Kompresi model dapat menyebabkan degradasi akurasi jika teknik diterapkan terlalu agresif atau tanpa penyetelan yang cermat. Menggabungkan metode seperti pruning, kuantisasi, dan distilasi meningkatkan kompleksitas sistem dan mungkin memerlukan siklus pelatihan ulang atau fine-tuning tambahan. Model terkompresi juga bisa kurang fleksibel untuk ditransfer ke tugas baru, karena optimalisasi sering mempersempit cakupan skenario tempat model berkinerja baik. Dalam beberapa kasus, waktu rekayasa dan overhead komputasi untuk kompresi dapat mengimbangi penghematan biaya jangka pendek.
9. Inferensi Terdistribusi
Inferensi terdistribusi adalah pendekatan membagi beban kerja inferensi di beberapa mesin atau perangkat. Ini memungkinkan pemrosesan paralel untuk tugas inferensi skala besar, mengurangi latensi dan meningkatkan throughput.
Cara melakukannya:
- Partisi model: Bagi model ke beberapa mesin, masing-masing menangani sebagian komputasi.
- Load balancing: Sebarkan permintaan yang masuk ke mesin yang tersedia untuk memastikan pemanfaatan sumber daya yang efisien.
Manfaatnya:
- Menangani model yang lebih besar dan trafik lebih tinggi: Inferensi terdistribusi memungkinkan Anda memecah tugas besar di banyak mesin, menangani model yang lebih besar dan lebih banyak permintaan secara bersamaan. Ini membuat perangkat keras lebih efisien dan memungkinkan penskalaan fleksibel di cloud, yang semuanya mengarah pada penghematan biaya.
Inferensi terdistribusi menambah kompleksitas sistem yang signifikan, karena koordinasi komputasi di banyak mesin memerlukan orkestrasi, sinkronisasi, dan toleransi kesalahan yang andal. Latensi jaringan dan keterbatasan bandwidth dapat mengimbangi peningkatan kinerja, terutama saat sejumlah besar data antara perlu dipertukarkan. Ini juga meningkatkan biaya infrastruktur, karena perangkat keras tambahan dan mekanisme load-balancing harus disediakan dan dipelihara. Debugging dan pemantauan sistem terdistribusi bisa lebih sulit, sehingga keandalannya menjadi tantangan dibandingkan pengaturan satu node.
10. Rekayasa Prompt
Rekayasa prompt adalah proses menyusun input prompt dengan saksama untuk mengarahkan model bahasa besar (LLM) menghasilkan keluaran yang diinginkan. Dengan merumuskan prompt yang jelas, ringkas, dan spesifik, pengguna dapat meningkatkan kualitas dan keterkendalian respons LLM, sehingga lebih relevan dan berguna untuk tugas tertentu.
Cara melakukannya:
- Jelas dan ringkas: Gunakan bahasa yang spesifik dan tidak ambigu dalam prompt Anda.
- Berikan konteks: Sertakan informasi latar atau contoh relevan untuk memandu LLM.
- Eksperimen dan iterasi: Uji berbagai formulasi prompt dan evaluasi hasilnya untuk menemukan yang paling efektif.
Manfaatnya:
- Keluaran lebih relevan dan ringkas: Rekayasa prompt yang baik dapat mengurangi jumlah token yang perlu dihasilkan model, sehingga inferensi lebih cepat dan berpotensi lebih murah.
- Akurasi meningkat: Prompt yang jelas dapat membantu model menghindari kesalahpahaman dan menghasilkan respons yang lebih akurat.
Rekayasa prompt memerlukan eksperimen dan iterasi berkelanjutan, yang bisa memakan waktu dan tidak konsisten lintas use case. Prompt yang tersusun baik mungkin tidak terumumkan, memaksa Anda mendesain ulang saat tugas atau model berubah. Peningkatan dalam desain prompt juga bisa rapuh—perubahan kecil kata atau pembaruan model dapat mengubah hasil secara tak terduga. Terakhir, terlalu bergantung pada rekayasa prompt tanpa teknik pelengkap seperti manajemen konteks atau fine-tuning dapat membatasi skalabilitas dan penghematan biaya jangka panjang.
Bonus: Rekayasa Konteks
Rekayasa konteks adalah praktik merancang sistem yang mengendalikan informasi apa yang dilihat LLM sebelum menghasilkan respons. Alih-alih memasukkan semuanya ke dalam jendela konteks, Anda memilih dan mengatur hanya detail yang paling relevan—seperti riwayat pengguna, dokumen yang diambil, atau keluaran alat—agar model dapat bernalar lebih efisien.
Cara melakukannya:
- Ringkasan konteks: Kompres riwayat percakapan atau dokumen yang menumpuk menjadi ringkasan yang lebih pendek untuk mempertahankan makna sambil mengurangi token.
- Manajemen tool loadout: Gunakan sistem retrieval untuk memilih hanya alat atau deskripsi yang paling relevan alih-alih meneruskan semua opsi yang tersedia.
- Pruning konteks: Hapus informasi yang kedaluwarsa atau redundan saat data baru masuk, menjaga konteks aktif tetap ramping dan bermanfaat.
- Validasi dan karantina konteks: Deteksi dan isolasi halusinasi atau kesalahan sebelum mencemari memori jangka panjang.
Manfaatnya:
- Penggunaan token lebih rendah: Konteks yang lebih pendek dan terfokus mengurangi jumlah token yang diproses, langsung memangkas biaya.
- Akurasi meningkat: Konteks yang lebih bersih berarti model lebih kecil kemungkinannya terdistraksi atau bingung oleh detail yang tidak relevan atau saling bertentangan.
- Inferensi lebih cepat: Dengan token yang lebih sedikit dan KV cache yang lebih stabil, permintaan selesai lebih cepat, sehingga menghemat sumber daya komputasi.
Komprominya adalah membangun sistem konteks yang efektif memerlukan upaya rekayasa awal. Anda memerlukan pipeline retrieval, peringkasan, dan validasi, dan desain yang buruk dapat menyebabkan celah konteks yang menurunkan kinerja. Namun jika dilakukan dengan baik, rekayasa konteks membuat aplikasi besar lebih andal dan lebih terjangkau.
Kesimpulan
Menurunkan biaya inferensi LLM bukan tentang satu trik. Ini tentang menggabungkan pendekatan yang masuk akal untuk beban kerja Anda. Teknik seperti kuantisasi, pruning, dan distilasi pengetahuan memangkas ukuran model. Batching, caching, dan inferensi terdistribusi meningkatkan cara permintaan diproses. Pilihan perangkat keras dan kompresi model mendorong efisiensi lebih jauh, sementara rekayasa prompt dan konteks mengurangi penggunaan token yang tidak perlu sejak awal.
Komprominya nyata: setiap metode membawa kompleksitas, potensi kehilangan akurasi, atau overhead infrastruktur. Namun keuntungannya terakumulasi. Dengan menerapkan beberapa teknik ini saja, Anda dapat menjaga model tetap terjangkau, meningkatkan skala penggunaan tanpa biaya yang melonjak, dan membangun sistem yang tetap berkelanjutan seiring pertumbuhan model dan aplikasi.


 Dario Radečić · 15 min

 Javier Canales Luna · 14 min

 David Woods · 13 min


Menjalankan model bahasa besar datang dengan biaya nyata. Anda membayar setiap token yang diproses, setiap siklus GPU yang digunakan, dan setiap lapisan kompleksitas yang ditambahkan ke model. Meskipun harga telah turun, tagihannya tetap meningkat cepat saat Anda bekerja dengan aplikasi besar, prompt panjang, atau pembaruan yang sering.
Saya sudah melihat betapa cepatnya ini menjadi masalah. Tim mengira biaya akan tetap terkendali, namun kemudian menyadari mereka menghabiskan anggaran untuk model yang terlalu besar, prompt yang tidak efisien, atau perangkat keras yang menganggur.
Itulah mengapa saya merangkum 10 cara praktis untuk menurunkan biaya inferensi. Dari kuantisasi dan pruning hingga batching, caching, dan rekayasa prompt, ini adalah pendekatan yang benar-benar saya gunakan untuk menjaga LLM tetap terjangkau tanpa terlalu mengorbankan kinerja.
1. Kuantisasi
Kuantisasi adalah proses mengurangi presisi bobot dan aktivasi model, umumnya dari angka floating point 32-bit ke representasi bit yang lebih rendah (misalnya 16-bit atau bahkan 8-bit). Ini mengurangi jejak memori dan kebutuhan komputasi, sehingga memungkinkan inferensi yang lebih cepat pada perangkat dengan sumber daya terbatas.
Cara melakukannya:
Manfaatnya:
Kompromi utamanya adalah potensi kehilangan akurasi. Meskipun teknik kuantisasi modern sudah cukup baik, selalu ada kemungkinan terjadi sedikit penurunan akurasi model.
2. Pruning
Pruning adalah teknik menghapus bobot yang kurang penting atau redundan dari jaringan saraf. Dengan menghilangkan koneksi yang berdampak minimal pada kinerja model, pruning mengurangi ukuran dan kompleksitas komputasi model, sehingga inferensi menjadi lebih cepat.
Cara melakukannya:
Manfaatnya:
Sama seperti kuantisasi, kompromi utamanya adalah potensi kehilangan akurasi. Pruning yang agresif dapat menyebabkan penurunan kinerja yang nyata. Menemukan keseimbangan yang tepat sangat penting.
3. Distilasi Pengetahuan
Knowledge distillation adalah proses mentransfer pengetahuan dari model "guru" yang besar dan kompleks ke model "murid" yang lebih kecil dan efisien. Model murid belajar meniru perilaku guru, sehingga mampu mencapai kinerja yang sebanding dengan ukuran lebih kecil dan inferensi lebih cepat.
Cara melakukannya:
Manfaatnya:
Kompromi utamanya adalah Anda memerlukan akses ke model guru yang kuat, yang bisa mahal untuk dilatih atau digunakan.
4. Batching
Batching melibatkan pemrosesan beberapa sampel input secara bersamaan dalam satu batch saat inferensi. Ini meningkatkan efisiensi dengan memanfaatkan kemampuan pemrosesan paralel pada perangkat keras, sehingga inferensi keseluruhan lebih cepat.
Cara melakukannya:
Manfaatnya:
Namun, batching dapat menambah latensi untuk setiap permintaan individu, karena sistem mungkin menunggu hingga cukup input terkumpul sebelum memproses. Untuk aplikasi waktu nyata atau berlatensi rendah, penundaan tambahan ini dapat menurunkan pengalaman pengguna jika tidak ditata dengan cermat. Dynamic batching membantu mengurangi masalah tersebut tetapi menambah kompleksitas sistem. Ada juga risiko batching yang tidak efisien saat lalu lintas tidak merata, yang dapat mengurangi penghematan biaya yang diharapkan.
5. Caching
Caching adalah teknik menyimpan hasil komputasi sebelumnya dan menggunakannya kembali saat menemui input yang sama selama inferensi. Ini menghindari perhitungan berulang, mempercepat proses inferensi.
Cara melakukannya:
Manfaatnya:
Namun, caching hanya berguna saat input berulang atau tumpang tindih. Dalam beban kerja yang sangat bervariasi, tingkat hit bisa rendah, dan overhead untuk memelihara cache bisa melebihi manfaatnya. Hasil yang usang atau kedaluwarsa juga bisa menimbulkan masalah konsistensi jika keluaran cache tidak lagi mencerminkan data yang paling relevan. Selain itu, penerapan dan penyetelan strategi penghapusan cache menambah kompleksitas rekayasa, terutama di sistem terdistribusi di mana sinkronisasi cache menjadi tantangan.
6. Early Exiting
Early Exiting melibatkan penghentian komputasi lebih awal saat inferensi jika model sudah cukup yakin dengan prediksinya. Ini menghemat sumber daya komputasi dan mempercepat inferensi untuk kasus yang lebih sederhana di mana full forward pass tidak diperlukan.
Cara melakukannya:
Manfaatnya:
Komprominya adalah early exiting dapat menyebabkan sedikit penurunan akurasi pada beberapa kasus, terutama untuk input yang kompleks.
7. Perangkat Keras yang Dioptimalkan
Teknik ini melibatkan pemanfaatan arsitektur perangkat keras dan akselerator khusus yang dirancang untuk komputasi AI yang efisien. Ini mencakup GPU, TPU, dan chip AI khusus lainnya yang menawarkan peningkatan kinerja signifikan dibanding CPU tujuan umum untuk tugas inferensi.
Cara melakukannya:
Manfaatnya:
Namun, perangkat keras khusus sering kali memerlukan investasi awal yang besar dan dapat mengunci Anda pada ekosistem vendor tertentu. GPU, TPU, atau akselerator khusus juga bisa lebih sulit disediakan secara konsisten di cloud, terutama saat permintaan puncak. Penerapan on-premise membawa tantangan pemeliharaan dan penskalaan, sementara opsi cloud mungkin memiliki biaya sewa berkelanjutan yang lebih tinggi. Terakhir, menyesuaikan perangkat lunak agar sepenuhnya memanfaatkan perangkat keras khusus dapat menambah kompleksitas rekayasa dan memerlukan optimalisasi berkelanjutan.
8. Kompresi Model
Kompresi model merujuk pada penggunaan lebih dari satu teknik untuk mengurangi ukuran dan kompleksitas model tanpa secara signifikan mengorbankan kinerjanya. Ini dapat melibatkan pruning, kuantisasi, distilasi pengetahuan, atau metode lain yang bertujuan menciptakan model yang lebih ringkas dan efisien untuk inferensi yang lebih cepat.
Cara melakukannya:
Manfaatnya:
Kompresi model dapat menyebabkan degradasi akurasi jika teknik diterapkan terlalu agresif atau tanpa penyetelan yang cermat. Menggabungkan metode seperti pruning, kuantisasi, dan distilasi meningkatkan kompleksitas sistem dan mungkin memerlukan siklus pelatihan ulang atau fine-tuning tambahan. Model terkompresi juga bisa kurang fleksibel untuk ditransfer ke tugas baru, karena optimalisasi sering mempersempit cakupan skenario tempat model berkinerja baik. Dalam beberapa kasus, waktu rekayasa dan overhead komputasi untuk kompresi dapat mengimbangi penghematan biaya jangka pendek.
9. Inferensi Terdistribusi
Inferensi terdistribusi adalah pendekatan membagi beban kerja inferensi di beberapa mesin atau perangkat. Ini memungkinkan pemrosesan paralel untuk tugas inferensi skala besar, mengurangi latensi dan meningkatkan throughput.
Cara melakukannya:
Manfaatnya:
Inferensi terdistribusi menambah kompleksitas sistem yang signifikan, karena koordinasi komputasi di banyak mesin memerlukan orkestrasi, sinkronisasi, dan toleransi kesalahan yang andal. Latensi jaringan dan keterbatasan bandwidth dapat mengimbangi peningkatan kinerja, terutama saat sejumlah besar data antara perlu dipertukarkan. Ini juga meningkatkan biaya infrastruktur, karena perangkat keras tambahan dan mekanisme load-balancing harus disediakan dan dipelihara. Debugging dan pemantauan sistem terdistribusi bisa lebih sulit, sehingga keandalannya menjadi tantangan dibandingkan pengaturan satu node.
10. Rekayasa Prompt
Rekayasa prompt adalah proses menyusun input prompt dengan saksama untuk mengarahkan model bahasa besar (LLM) menghasilkan keluaran yang diinginkan. Dengan merumuskan prompt yang jelas, ringkas, dan spesifik, pengguna dapat meningkatkan kualitas dan keterkendalian respons LLM, sehingga lebih relevan dan berguna untuk tugas tertentu.
Cara melakukannya:
Manfaatnya:
Rekayasa prompt memerlukan eksperimen dan iterasi berkelanjutan, yang bisa memakan waktu dan tidak konsisten lintas use case. Prompt yang tersusun baik mungkin tidak terumumkan, memaksa Anda mendesain ulang saat tugas atau model berubah. Peningkatan dalam desain prompt juga bisa rapuh—perubahan kecil kata atau pembaruan model dapat mengubah hasil secara tak terduga. Terakhir, terlalu bergantung pada rekayasa prompt tanpa teknik pelengkap seperti manajemen konteks atau fine-tuning dapat membatasi skalabilitas dan penghematan biaya jangka panjang.
Bonus: Rekayasa Konteks
Rekayasa konteks adalah praktik merancang sistem yang mengendalikan informasi apa yang dilihat LLM sebelum menghasilkan respons. Alih-alih memasukkan semuanya ke dalam jendela konteks, Anda memilih dan mengatur hanya detail yang paling relevan—seperti riwayat pengguna, dokumen yang diambil, atau keluaran alat—agar model dapat bernalar lebih efisien.
Cara melakukannya:
Manfaatnya:
Komprominya adalah membangun sistem konteks yang efektif memerlukan upaya rekayasa awal. Anda memerlukan pipeline retrieval, peringkasan, dan validasi, dan desain yang buruk dapat menyebabkan celah konteks yang menurunkan kinerja. Namun jika dilakukan dengan baik, rekayasa konteks membuat aplikasi besar lebih andal dan lebih terjangkau.
Kesimpulan
Menurunkan biaya inferensi LLM bukan tentang satu trik. Ini tentang menggabungkan pendekatan yang masuk akal untuk beban kerja Anda. Teknik seperti kuantisasi, pruning, dan distilasi pengetahuan memangkas ukuran model. Batching, caching, dan inferensi terdistribusi meningkatkan cara permintaan diproses. Pilihan perangkat keras dan kompresi model mendorong efisiensi lebih jauh, sementara rekayasa prompt dan konteks mengurangi penggunaan token yang tidak perlu sejak awal.
Komprominya nyata: setiap metode membawa kompleksitas, potensi kehilangan akurasi, atau overhead infrastruktur. Namun keuntungannya terakumulasi. Dengan menerapkan beberapa teknik ini saja, Anda dapat menjaga model tetap terjangkau, meningkatkan skala penggunaan tanpa biaya yang melonjak, dan membangun sistem yang tetap berkelanjutan seiring pertumbuhan model dan aplikasi.