语言是人类交流的核心,自动化处理语言能带来巨大的益处。多年来,自然语言处理(NLP)模型一直难以有效捕捉人类语言的微妙之处,直到一次突破——注意力机制。
注意力机制于 2017 年在论文 Attention Is All You Need 中提出。与把词语割裂处理的传统方法不同,注意力会根据与当前任务的相关性为每个词分配权重。这让模型能够捕捉远距离依赖,同时分析局部与全局上下文,并通过关注句子中更有信息量的部分来消解歧义。
考虑以下句子:“Miami, coined the 'magic city,' has beautiful white-sand beaches.” 传统模型会按顺序处理每个词。而注意力机制更像人脑,会根据理解当前焦点的需要为每个词打分。比如在考虑地点时,“Miami”和“beaches”会更重要,因此得分更高。
本文将以直观方式解释注意力机制。您也可以在这篇教程中找到更技术性的讲解:Transformer 的工作原理。让我们开始吧!
传统语言模型
我们先从语言模型的更大背景出发,开启理解注意力机制的旅程。
语言处理基础
语言模型通过试图理解语法结构(句法)和含义(语义)来处理语言。其目标是输出与输入相关、且在句法与语义上都正确的语言。
语言模型依赖一系列技术来拆解与理解文本:
- 解析(Parsing): 分析句子结构,为每个词标注词性(名词、动词、形容词等),并识别语法关系。
- 分词(Tokenization): 将句子切分为单独的词(标记),为进行语义分析打好基础(您可以在另一篇文章中进一步了解分词)。
- 词干提取(Stemming): 将词还原为词根形式(例如,将“walking”还原为“walk”),以确保模型一致地处理相似词。
- 实体识别与关系抽取: 协同识别并分类文本中的特定实体(如人物或地点),并挖掘它们之间的关系。
- 词向量(Word embeddings): 为每个词创建数值表示(向量),以捕捉其含义及与其他词的联系,从而使模型能够处理文本并执行如翻译或摘要等任务。
传统模型的局限
尽管传统语言模型为 NLP 的发展铺平了道路,但在充分把握自然语言的复杂性方面仍面临挑战:
- 上下文受限: 传统模型常将文本表示为一组独立的标记,无法捕捉句子的更广泛语境,因而难以理解句中相距较远的词之间可能存在的关联。
- 上下文窗口短: 这类模型在处理时考虑的上下文窗口往往有限,导致它们难以捕捉长距离依赖,即句中相距较远的词彼此影响含义的情况。
- 词义消歧困难: 仅凭周围词语,传统模型往往难以对一词多义进行消歧,缺乏利用更广泛语境来确定意图含义的能力。
- 泛化能力挑战: 受限于网络架构与可用训练数据量,这些模型常难以适应新的或未见过的情境(域外数据)。
语言模型中的注意力是什么?
与将词语孤立处理的传统模型不同,注意力让语言模型能够考虑上下文。我们来看看具体如何实现!
“注意力即一切”
NLP 领域的变革性进展出现在 2017 年,论文 Attention Is All You Need 引入了注意力机制。
该论文提出了一种新的架构——Transformer。与早期的循环神经网络(RNN)和卷积神经网络(CNN)不同,Transformer 使用注意力机制。
通过解决传统模型的诸多问题,Transformer(及其注意力机制)成为当今众多流行大型语言模型(LLM)的基础,如OpenAI 的 GPT-4 和 ChatGPT。
注意力如何工作?
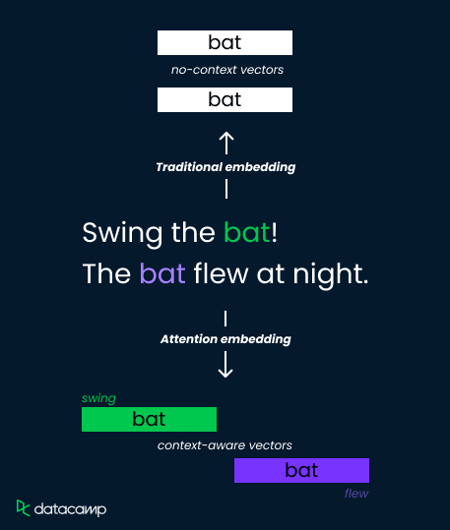
我们来看看“bat”在以下两句中的含义:
- "Swing the bat!"
- "The bat flew at night."
传统的嵌入方法会为“bat”分配单一向量表示,难以区分不同含义。而注意力机制通过计算与上下文相关的权重来解决这一问题。
它会分析周围词语("swing" 与 "flew"),计算决定相关性的注意力分数。随后,这些分数用于加权嵌入向量,从而为“bat”在运动器材意义(对 "swing" 权重更高)与飞行动物意义(对 "flew" 权重更高)分别得到不同表示。
这使模型能够捕捉语义细微差别并提升理解力。
注意力在 LLM 中的重要性
在对注意力建立直观理解的基础上,我们来看看该机制如何超越传统词向量以增强语言理解,并了解一些注意力的实际应用。
超越传统词向量
传统词向量技术(如 Word2Vec 和 GloVe)基于大规模语料中的共现统计,将词表示为语义空间中的固定维度向量。
这些嵌入虽能捕捉部分词语间的语义关系,但缺乏对上下文的敏感性。也就是说,无论一个词在句子或文档中的语境如何,其嵌入都相同。
在需要细腻语言理解的任务中,这一局限尤为明显——尤其当词在不同语境下承载不同含义时。注意力机制通过让模型选择性地关注输入序列中的相关部分,将上下文敏感性引入表示学习过程,从而解决这一问题。
提升语言理解
注意力让模型得以理解语言中的细微差别与歧义,从而更有效地处理复杂文本。其关键优势包括:
- 动态加权: 根据当前语境的相关性,动态调整某些词的重要性。
- 长程依赖: 能够捕捉相距较远词语之间的关系。
- 上下文理解: 除了提供具备上下文的表示外,还能帮助消除歧义,使模型适应多种下游任务。
应用与影响
基于注意力的语言模型影响深远。成千上万的人在使用其之上的各类应用。常见应用包括:
- 机器翻译: 如 Google 翻译等模型利用注意力聚焦源句中相关部分,生成更契合上下文的译文。
- 文本摘要: 借助注意力找出文档中的关键信句或短语,从而生成更信息密集、简洁的摘要。
- 问答系统: 注意力帮助深度学习模型将问题中的词与相关上下文对齐,从而更准确地抽取答案。
- 情感分析: 情感分析模型通过注意力捕捉承载情绪的词及其语境重要性。
- 内容生成: 内容生成模型利用注意力确保生成文本与输入上下文保持一致,从而生成连贯且上下文相关的内容。
进阶注意力机制
了解了注意力的工作方式后,我们来看看自注意力与多头注意力。
自注意力与多头注意力
自注意力使模型能够关注其输入序列中的不同位置,以计算该序列的表示。它让模型根据词与词之间的相对重要性进行加权,从而捕捉输入中不同词之间的依赖关系。该机制有三大要素:
- Query(查询): 表示模型针对序列中某个特定词当前关注点或问题的向量。就像模型打着手电筒聚焦在某个词上,以理解其在上下文中的含义。
- Key(键): 每个词都有一个标签或参照点——键向量就扮演这个角色。模型将查询向量与所有键向量比较,以找出回答所关注词问题时最相关的词。
- Value(值): 保存与每个词相关的实际信息。一旦模型通过键的比较确定了相关词,就取回对应的值向量,以获取理解所需的具体信息。
注意力分数可通过对查询与键向量做缩放点积来计算。最终,这些分数与值向量相乘,得到值的加权和作为输出。
多头注意力是自注意力机制的扩展。它通过同时关注输入序列的不同部分,增强模型捕捉多样化上下文信息的能力。其做法是并行执行多组自注意力操作,每组都有自己学习到的查询、键与值的变换。
多头注意力带来更细腻的上下文理解、更强的鲁棒性与表达力。
注意力:挑战与解决方案
尽管引入注意力机制有诸多益处,但也伴随一系列挑战,相关研究仍在不断推进以求解决。
计算复杂度
注意力机制需要计算输入序列中所有标记之间的两两相似度,其复杂度相对于序列长度呈二次增长。对于长序列,这在计算上代价高昂。
为缓解计算复杂度,人们提出了多种技术,例如稀疏注意力、近似注意力方法,以及如 Reformer 模型基于局部敏感哈希的高效注意力机制。
注意力过拟合
注意力机制可能会对输入序列中的噪声或无关信息过拟合,导致在未见数据上的性能不佳。
正则化技术(如 dropout 与层归一化)有助于防止基于注意力的模型过拟合。此外,还提出了注意力 dropout 与注意力掩码等技术,以鼓励模型聚焦于相关信息。
可解释性与可说明性
理解注意力机制如何运作并解释其输出并不容易,尤其是在拥有多层与多头注意力的复杂模型中。这也引发了对这类新技术伦理问题的关注——您可以在我们的AI 伦理课程中进一步了解,或收听这期与 AI 研究者 Dr. Joy Buolamwini 的播客。
为了增强基于注意力模型的可解释性,人们开发了可视化注意力权重并解读其含义的方法。此外,注意力归因等技术旨在识别单个标记对模型预测的贡献,从而提升可说明性。
可扩展性与内存约束
注意力机制会消耗大量内存与计算资源,使其在扩展至更大模型与数据集时面临挑战。
用于扩展基于注意力模型的技术(如分层注意力、内存高效注意力与稀疏注意力)旨在在维持模型性能的同时,降低内存占用与计算开销。
注意力:总结
我们通过对比传统模型与基于注意力的模型,总结一下要点:
|
特性
|
基于注意力的模型
|
传统 NLP 模型
|
|
词表示
|
具备上下文感知的嵌入向量(根据注意力分数动态加权)
|
静态嵌入向量(每词单一向量,不考虑上下文)
|
|
关注点
|
为理解含义考虑周围词语(着眼更广泛的上下文)
|
将每个词独立对待
|
|
优势
|
捕捉长程依赖、消解歧义、理解细微差别
|
更简单,计算成本更低
|
|
劣势
|
计算开销可能较大
|
理解复杂语言能力有限,难以处理上下文
|
|
底层机制
|
带有注意力的编码器-解码器网络(多种架构)
|
解析、词干提取、命名实体识别、词向量等技术
|
结语
本文探讨了颠覆 NLP 的注意力机制。不同于以往方法,注意力让语言模型能够在考虑上下文的同时聚焦句子中的关键部分,从而把握复杂语言、长距离关联与词义歧义。
您可以通过以下方式继续学习注意力机制:

语言是人类交流的核心,自动化处理语言能带来巨大的益处。多年来,自然语言处理(NLP)模型一直难以有效捕捉人类语言的微妙之处,直到一次突破——注意力机制。
注意力机制于 2017 年在论文 Attention Is All You Need 中提出。与把词语割裂处理的传统方法不同,注意力会根据与当前任务的相关性为每个词分配权重。这让模型能够捕捉远距离依赖,同时分析局部与全局上下文,并通过关注句子中更有信息量的部分来消解歧义。
考虑以下句子:“Miami, coined the 'magic city,' has beautiful white-sand beaches.” 传统模型会按顺序处理每个词。而注意力机制更像人脑,会根据理解当前焦点的需要为每个词打分。比如在考虑地点时,“Miami”和“beaches”会更重要,因此得分更高。
本文将以直观方式解释注意力机制。您也可以在这篇教程中找到更技术性的讲解:Transformer 的工作原理。让我们开始吧!
传统语言模型
我们先从语言模型的更大背景出发,开启理解注意力机制的旅程。
语言处理基础
语言模型通过试图理解语法结构(句法)和含义(语义)来处理语言。其目标是输出与输入相关、且在句法与语义上都正确的语言。
语言模型依赖一系列技术来拆解与理解文本:
传统模型的局限
尽管传统语言模型为 NLP 的发展铺平了道路,但在充分把握自然语言的复杂性方面仍面临挑战:
语言模型中的注意力是什么?
与将词语孤立处理的传统模型不同,注意力让语言模型能够考虑上下文。我们来看看具体如何实现!
“注意力即一切”
NLP 领域的变革性进展出现在 2017 年,论文 Attention Is All You Need 引入了注意力机制。
该论文提出了一种新的架构——Transformer。与早期的循环神经网络(RNN)和卷积神经网络(CNN)不同,Transformer 使用注意力机制。
通过解决传统模型的诸多问题,Transformer(及其注意力机制)成为当今众多流行大型语言模型(LLM)的基础,如OpenAI 的 GPT-4 和 ChatGPT。
注意力如何工作?
我们来看看“bat”在以下两句中的含义:
传统的嵌入方法会为“bat”分配单一向量表示,难以区分不同含义。而注意力机制通过计算与上下文相关的权重来解决这一问题。
它会分析周围词语("swing" 与 "flew"),计算决定相关性的注意力分数。随后,这些分数用于加权嵌入向量,从而为“bat”在运动器材意义(对 "swing" 权重更高)与飞行动物意义(对 "flew" 权重更高)分别得到不同表示。
这使模型能够捕捉语义细微差别并提升理解力。
注意力在 LLM 中的重要性
在对注意力建立直观理解的基础上,我们来看看该机制如何超越传统词向量以增强语言理解,并了解一些注意力的实际应用。
超越传统词向量
传统词向量技术(如 Word2Vec 和 GloVe)基于大规模语料中的共现统计,将词表示为语义空间中的固定维度向量。
这些嵌入虽能捕捉部分词语间的语义关系,但缺乏对上下文的敏感性。也就是说,无论一个词在句子或文档中的语境如何,其嵌入都相同。
在需要细腻语言理解的任务中,这一局限尤为明显——尤其当词在不同语境下承载不同含义时。注意力机制通过让模型选择性地关注输入序列中的相关部分,将上下文敏感性引入表示学习过程,从而解决这一问题。
提升语言理解
注意力让模型得以理解语言中的细微差别与歧义,从而更有效地处理复杂文本。其关键优势包括:
应用与影响
基于注意力的语言模型影响深远。成千上万的人在使用其之上的各类应用。常见应用包括:
进阶注意力机制
了解了注意力的工作方式后,我们来看看自注意力与多头注意力。
自注意力与多头注意力
自注意力使模型能够关注其输入序列中的不同位置,以计算该序列的表示。它让模型根据词与词之间的相对重要性进行加权,从而捕捉输入中不同词之间的依赖关系。该机制有三大要素:
注意力分数可通过对查询与键向量做缩放点积来计算。最终,这些分数与值向量相乘,得到值的加权和作为输出。
多头注意力是自注意力机制的扩展。它通过同时关注输入序列的不同部分,增强模型捕捉多样化上下文信息的能力。其做法是并行执行多组自注意力操作,每组都有自己学习到的查询、键与值的变换。
多头注意力带来更细腻的上下文理解、更强的鲁棒性与表达力。
注意力:挑战与解决方案
尽管引入注意力机制有诸多益处,但也伴随一系列挑战,相关研究仍在不断推进以求解决。
计算复杂度
注意力机制需要计算输入序列中所有标记之间的两两相似度,其复杂度相对于序列长度呈二次增长。对于长序列,这在计算上代价高昂。
为缓解计算复杂度,人们提出了多种技术,例如稀疏注意力、近似注意力方法,以及如 Reformer 模型基于局部敏感哈希的高效注意力机制。
注意力过拟合
注意力机制可能会对输入序列中的噪声或无关信息过拟合,导致在未见数据上的性能不佳。
正则化技术(如 dropout 与层归一化)有助于防止基于注意力的模型过拟合。此外,还提出了注意力 dropout 与注意力掩码等技术,以鼓励模型聚焦于相关信息。
可解释性与可说明性
理解注意力机制如何运作并解释其输出并不容易,尤其是在拥有多层与多头注意力的复杂模型中。这也引发了对这类新技术伦理问题的关注——您可以在我们的AI 伦理课程中进一步了解,或收听这期与 AI 研究者 Dr. Joy Buolamwini 的播客。
为了增强基于注意力模型的可解释性,人们开发了可视化注意力权重并解读其含义的方法。此外,注意力归因等技术旨在识别单个标记对模型预测的贡献,从而提升可说明性。
可扩展性与内存约束
注意力机制会消耗大量内存与计算资源,使其在扩展至更大模型与数据集时面临挑战。
用于扩展基于注意力模型的技术(如分层注意力、内存高效注意力与稀疏注意力)旨在在维持模型性能的同时,降低内存占用与计算开销。
注意力:总结
我们通过对比传统模型与基于注意力的模型,总结一下要点:
特性
基于注意力的模型
传统 NLP 模型
词表示
具备上下文感知的嵌入向量(根据注意力分数动态加权)
静态嵌入向量(每词单一向量,不考虑上下文)
关注点
为理解含义考虑周围词语(着眼更广泛的上下文)
将每个词独立对待
优势
捕捉长程依赖、消解歧义、理解细微差别
更简单,计算成本更低
劣势
计算开销可能较大
理解复杂语言能力有限,难以处理上下文
底层机制
带有注意力的编码器-解码器网络(多种架构)
解析、词干提取、命名实体识别、词向量等技术
结语
本文探讨了颠覆 NLP 的注意力机制。不同于以往方法,注意力让语言模型能够在考虑上下文的同时聚焦句子中的关键部分,从而把握复杂语言、长距离关联与词义歧义。
您可以通过以下方式继续学习注意力机制: