

Transformer 的背景与理论
Transformer 最早由 Vaswani 等人在论文 Attention is All You Need 中提出,凭借其独特的设计与卓越效果,已成为众多 NLP 任务的基石。
Transformer 的核心是注意力机制,尤其是“自注意力”的概念,它使模型能够为输入数据的不同部分分配权重与优先级。该机制让 Transformer 能够处理数据中的长程依赖。本质上,它是一种加权方案,使模型在生成输出时能关注输入的不同部分。
自注意力机制允许模型在输入序列中考虑不同的词或特征,并为每个元素分配一个表示其对生成某个输出的重要性的“权重”。例如,在句子翻译任务中,模型在翻译某个词时,可能会对与目标词在语法或语义上相关的词分配更高的注意力权重。这个过程使 Transformer 能够捕捉词或特征之间的依赖关系,而不受它们在序列中距离远近的限制。
Transformer 在 NLP 领域的影响力不可小觑。它们在许多任务上超越了传统模型,展现出更强的、更加细腻的人类语言理解与生成能力。
若想深入理解 NLP,推荐参考 DataCamp 的 Natural Language Processing in Python 学习路径。
设置 PyTorch
在构建 Transformer 之前,必须正确配置工作环境。首先需要安装 PyTorch。PyTorch 可以通过 pip 或 conda 包管理器安装。
使用 pip,请运行以下命令:
pip3 install torch torchvision torchaudio使用 conda,请运行以下命令:
conda install pytorch torchvision -c pytorch有关安装与运行 PyTorch 的其他选项,请参阅其官方网站。
此外,具备深度学习基础知识也很有帮助,这将有助于理解 Transformer 的运行机制。我们的 Deep Learning in Python 课程是很好的起点。
使用 PyTorch 构建 Transformer 模型
要构建 Transformer 模型,需要完成以下步骤:
- 导入库和模块。
- 定义基本构件:多头注意力、位置前馈网络、位置编码。
- 构建编码器模块。
- 构建解码器模块。
- 将编码器与解码器层组合,构建完整的 Transformer 网络。
1. 导入必要的库和模块
我们将首先导入 PyTorch 库以提供核心功能,导入神经网络模块以创建神经网络,导入优化模块以训练网络,以及用于处理数据的数据工具函数。此外,我们还将导入标准的 Python math 模块进行数学运算,以及 copy 模块用于复制复杂对象。
这些工具为定义模型架构、管理数据和建立训练流程奠定基础。
import torch
import torch.nn as nn
import torch.optim as optim
import torch.utils.data as data
import math
import copy2. 定义基本构件:多头注意力、位置前馈网络、位置编码
在开始实现各组件之前,先查看下表,了解 Transformer 不同组件及其作用:
| Component | Description | Purpose |
|---|---|---|
| Multi-Head Attention | Mechanism to focus on different parts of the input | Captures dependencies across different positions in the sequence |
| Feed-Forward Networks | Position-wise fully connected layers | Transforms the attention outputs, adding complexity |
| Positional Encoding | Adds positional information to embeddings | Provides sequence order context to the model |
| Layer Normalization | Normalizes inputs to each sub-layer | Stabilizes training, improves convergence |
| Residual Connections | Shortcuts between layers | Helps in training deeper networks by minimizing gradient issues |
| Dropout | Randomly zeroes some network connections | Prevents overfitting by regularizing the model |
多头注意力
多头注意力机制计算序列中各位置对之间的注意力。它由多个“注意力头”组成,用于捕捉输入序列的不同方面。
若要进一步了解多头注意力,请查看大型语言模型(LLMs)概念课程中的 attention mechanisms 章节。
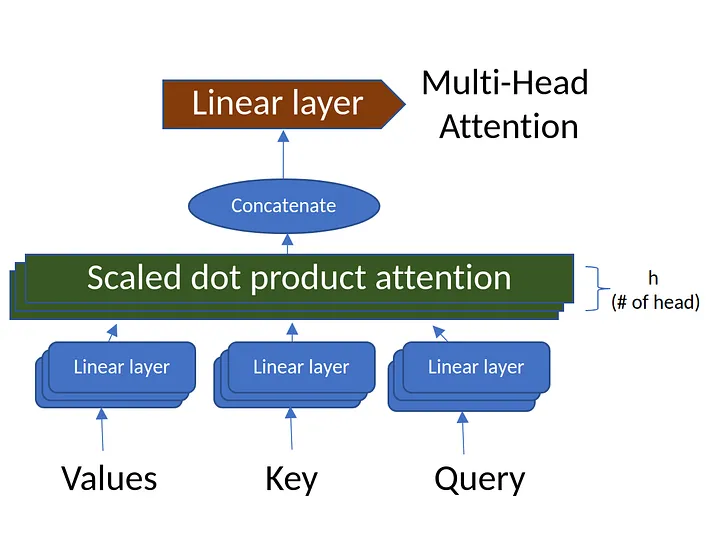
图 1. 多头注意力(来源:作者自制图片)
class MultiHeadAttention(nn.Module):
def __init__(self, d_model, num_heads):
super(MultiHeadAttention, self).__init__()
# Ensure that the model dimension (d_model) is divisible by the number of heads
assert d_model % num_heads == 0, "d_model must be divisible by num_heads"
# Initialize dimensions
self.d_model = d_model # Model's dimension
self.num_heads = num_heads # Number of attention heads
self.d_k = d_model // num_heads # Dimension of each head's key, query, and value
# Linear layers for transforming inputs
self.W_q = nn.Linear(d_model, d_model) # Query transformation
self.W_k = nn.Linear(d_model, d_model) # Key transformation
self.W_v = nn.Linear(d_model, d_model) # Value transformation
self.W_o = nn.Linear(d_model, d_model) # Output transformation
def scaled_dot_product_attention(self, Q, K, V, mask=None):
# Calculate attention scores
attn_scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)
# Apply mask if provided (useful for preventing attention to certain parts like padding)
if mask is not None:
attn_scores = attn_scores.masked_fill(mask == 0, -1e9)
# Softmax is applied to obtain attention probabilities
attn_probs = torch.softmax(attn_scores, dim=-1)
# Multiply by values to obtain the final output
output = torch.matmul(attn_probs, V)
return output
def split_heads(self, x):
# Reshape the input to have num_heads for multi-head attention
batch_size, seq_length, d_model = x.size()
return x.view(batch_size, seq_length, self.num_heads, self.d_k).transpose(1, 2)
def combine_heads(self, x):
# Combine the multiple heads back to original shape
batch_size, _, seq_length, d_k = x.size()
return x.transpose(1, 2).contiguous().view(batch_size, seq_length, self.d_model)
def forward(self, Q, K, V, mask=None):
# Apply linear transformations and split heads
Q = self.split_heads(self.W_q(Q))
K = self.split_heads(self.W_k(K))
V = self.split_heads(self.W_v(V))
# Perform scaled dot-product attention
attn_output = self.scaled_dot_product_attention(Q, K, V, mask)
# Combine heads and apply output transformation
output = self.W_o(self.combine_heads(attn_output))
return output类定义与初始化:
class MultiHeadAttention(nn.Module):
def __init__(self, d_model, num_heads):该类继承自 PyTorch 的 nn.Module。
d_model:输入的维度。num_heads:将输入划分为的注意力头数量。
初始化会检查 d_model 是否能被 num_heads 整除,然后定义 query、key、value 和 output 的变换权重。
缩放点积注意力:
def scaled_dot_product_attention(self, Q, K, V, mask=None):- 计算注意力分数:
attn_scores = torch.matmul(Q, K.transpose(-2, -1)) / math.sqrt(self.d_k)。这里通过Q与K的点积计算注意力分数,并按键的维度d_k的平方根进行缩放。 - 应用掩码:如提供掩码,会将其应用于注意力分数以屏蔽特定值。
- 计算注意力权重:对注意力分数施加 softmax,使其转化为和为 1 的概率。
- 计算输出:将注意力权重与
V相乘,得到最终输出。
拆分头:
def split_heads(self, x):该方法将输入 x 重塑为形状(batch_size,num_heads,seq_length,d_k)。它使模型能够并行地处理多个注意力头。
合并头:
def combine_heads(self, x):对每个头分别计算注意力后,该方法将结果合并回形状(batch_size,seq_length,d_model)的单个张量,以便进一步处理。
前向方法:
def forward(self, Q, K, V, mask=None):前向方法是实际计算发生的地方:
- 应用线性变换:将
Q、K、V分别通过初始化中定义的线性层。 - 拆分头:使用
split_heads将变换后的Q、K、V划分为多个头。 - 应用缩放点积注意力:对拆分后的各头调用
scaled_dot_product_attention。 - 合并头:使用
combine_heads将各头结果合并为单个张量。 - 应用输出变换:最后将合并后的张量通过输出线性层。
总之,MultiHeadAttention 类封装了 Transformer 模型中常用的多头注意力机制。它负责将输入拆分为多个注意力头、对每个头应用注意力并合并结果。通过这样做,模型能够在不同尺度上捕捉输入数据中的各种关系,从而提升表达能力。
位置前馈网络
class PositionWiseFeedForward(nn.Module):
def __init__(self, d_model, d_ff):
super(PositionWiseFeedForward, self).__init__()
self.fc1 = nn.Linear(d_model, d_ff)
self.fc2 = nn.Linear(d_ff, d_model)
self.relu = nn.ReLU()
def forward(self, x):
return self.fc2(self.relu(self.fc1(x)))类定义:
class PositionWiseFeedForward(nn.Module):该类继承自 PyTorch 的 nn.Module,可作为标准的 PyTorch 层使用。
初始化:
def __init__(self, d_model, d_ff):
super(PositionWiseFeedForward, self).__init__()
self.fc1 = nn.Linear(d_model, d_ff)
self.fc2 = nn.Linear(d_ff, d_model)
self.relu = nn.ReLU()d_model:模型输入与输出的维度。d_ff:前馈网络中间层的维度。self.fc1与self.fc2:两个全连接(线性)层,其输入与输出维度分别由d_model和d_ff决定。self.relu:ReLU(线性整流)激活函数,在两层线性层之间引入非线性。
前向方法:
def forward(self, x):
return self.fc2(self.relu(self.fc1(x)))x:前馈网络的输入。self.fc1(x):首先通过第一层线性层(fc1)。self.relu(...):将fc1的输出通过 ReLU 激活,为模型引入非线性(将负值置零)。self.fc2(...):将激活后的输出传入第二层线性层(fc2),得到最终输出。
总之,PositionWiseFeedForward 类定义了一个由两层线性层与中间的 ReLU 激活组成的位置前馈网络。在 Transformer 中,该前馈网络对每个位置独立且相同地应用,用于对注意力机制学到的特征进行变换,作为注意力输出的进一步处理步骤。
位置编码
位置编码用于注入输入序列中每个标记的位置置信息。它使用不同频率的正弦与余弦函数来生成位置编码。
class PositionalEncoding(nn.Module):
def __init__(self, d_model, max_seq_length):
super(PositionalEncoding, self).__init__()
pe = torch.zeros(max_seq_length, d_model)
position = torch.arange(0, max_seq_length, dtype=torch.float).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2).float() * -(math.log(10000.0) / d_model))
pe[:, 0::2] = torch.sin(position * div_term)
pe[:, 1::2] = torch.cos(position * div_term)
self.register_buffer('pe', pe.unsqueeze(0))
def forward(self, x):
return x + self.pe[:, :x.size(1)]类定义:
class PositionalEncoding(nn.Module):该类继承自 PyTorch 的 nn.Module,因此可作为标准 PyTorch 层使用。
初始化:
def __init__(self, d_model, max_seq_length):
super(PositionalEncoding, self).__init__()
pe = torch.zeros(max_seq_length, d_model)
position = torch.arange(0, max_seq_length, dtype=torch.float).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2).float() * -(math.log(10000.0) / d_model))
pe[:, 0::2] = torch.sin(position * div_term)
pe[:, 1::2] = torch.cos(position * div_term)
self.register_buffer('pe', pe.unsqueeze(0))d_model:模型输入的维度。max_seq_length:预计算位置编码的最大序列长度。pe:用零填充的张量,将被位置编码值替换。position:包含序列中每个位置索引的张量。div_term:用于按特定方式缩放位置索引的项。- 对
pe的偶数索引应用正弦函数,奇数索引应用余弦函数。 - 最后将
pe注册为 buffer,意味着它属于模块状态但不是可训练参数。
前向方法:
def forward(self, x):
return x + self.pe[:, :x.size(1)]前向方法将位置编码与输入 x 相加。
它使用 pe 的前 x.size(1) 个元素,以确保位置编码与 x 的实际序列长度匹配。
总结
PositionalEncoding 类为序列中的标记位置注入信息。由于 Transformer 模型(依赖自注意力机制)并不具备序列顺序的内在知识,该类帮助模型考虑标记在序列中的位置。采用正弦和余弦函数的目的,是让模型容易学习相对位置关系,因为这会为序列中每个位置生成独特且平滑的编码。
3. 构建编码器模块
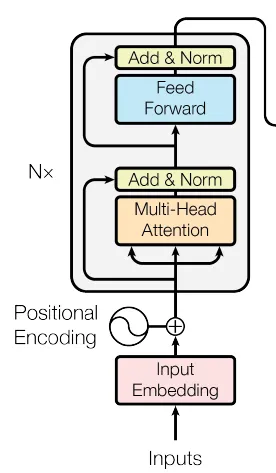
图 2. Transformer 网络的编码器部分(来源:原论文图片)
class EncoderLayer(nn.Module):
def __init__(self, d_model, num_heads, d_ff, dropout):
super(EncoderLayer, self).__init__()
self.self_attn = MultiHeadAttention(d_model, num_heads)
self.feed_forward = PositionWiseFeedForward(d_model, d_ff)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout)
def forward(self, x, mask):
attn_output = self.self_attn(x, x, x, mask)
x = self.norm1(x + self.dropout(attn_output))
ff_output = self.feed_forward(x)
x = self.norm2(x + self.dropout(ff_output))
return x类定义:
class EncoderLayer(nn.Module):该类继承自 PyTorch 的 nn.Module,可作为 PyTorch 神经网络的构件。
初始化:
def __init__(self, d_model, num_heads, d_ff, dropout):
super(EncoderLayer, self).__init__()
self.self_attn = MultiHeadAttention(d_model, num_heads)
self.feed_forward = PositionWiseFeedForward(d_model, d_ff)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout)参数:
d_model:输入的维度。num_heads:多头注意力中的头数。d_ff:位置前馈网络中间层维度。dropout:用于正则化的 dropout 比例。
组件:
self.self_attn:多头自注意力机制。self.feed_forward:位置前馈神经网络。self.norm1与self.norm2:层归一化,用于平滑各层输入。self.dropout:Dropout 层,通过在训练中随机置零部分激活以防止过拟合。
前向方法:
def forward(self, x, mask):
attn_output = self.self_attn(x, x, x, mask)
x = self.norm1(x + self.dropout(attn_output))
ff_output = self.feed_forward(x)
x = self.norm2(x + self.dropout(ff_output))
return x输入:
x:编码器层的输入。mask:可选掩码,用于忽略输入的某些部分。
处理步骤:
- 自注意力:将输入
x送入多头自注意力机制。 - 加和与归一化(注意力之后):将注意力输出与原始输入进行残差相加,随后应用 dropout 和
norm1归一化。 - 前馈网络:将上一步的输出送入位置前馈网络。
- 加和与归一化(前馈之后):类似步骤 2,将前馈输出与该阶段输入残差相加,随后应用 dropout 和
norm2归一化。 - 输出:返回编码器层的处理结果张量。
总结:
EncoderLayer 定义了 Transformer 编码器的单层结构。它包含多头自注意力和位置前馈网络,并配合残差连接、层归一化与 dropout。通过这些组件,编码器能够捕捉输入数据中的复杂关系,并将其转化为对下游任务有用的表示。通常会堆叠多个此类编码器层,构成完整的编码器部分。
4. 构建解码器模块
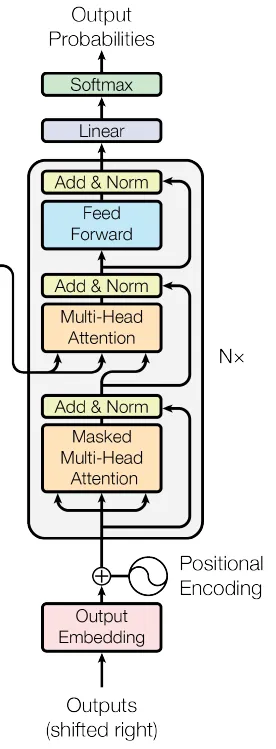
class DecoderLayer(nn.Module):
def __init__(self, d_model, num_heads, d_ff, dropout):
super(DecoderLayer, self).__init__()
self.self_attn = MultiHeadAttention(d_model, num_heads)
self.cross_attn = MultiHeadAttention(d_model, num_heads)
self.feed_forward = PositionWiseFeedForward(d_model, d_ff)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
self.norm3 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout)
def forward(self, x, enc_output, src_mask, tgt_mask):
attn_output = self.self_attn(x, x, x, tgt_mask)
x = self.norm1(x + self.dropout(attn_output))
attn_output = self.cross_attn(x, enc_output, enc_output, src_mask)
x = self.norm2(x + self.dropout(attn_output))
ff_output = self.feed_forward(x)
x = self.norm3(x + self.dropout(ff_output))
return x类定义:
class DecoderLayer(nn.Module):初始化:
def __init__(self, d_model, num_heads, d_ff, dropout):
super(DecoderLayer, self).__init__()
self.self_attn = MultiHeadAttention(d_model, num_heads)
self.cross_attn = MultiHeadAttention(d_model, num_heads)
self.feed_forward = PositionWiseFeedForward(d_model, d_ff)
self.norm1 = nn.LayerNorm(d_model)
self.norm2 = nn.LayerNorm(d_model)
self.norm3 = nn.LayerNorm(d_model)
self.dropout = nn.Dropout(dropout)参数:
d_model:输入的维度。num_heads:多头注意力中的头数。d_ff:前馈网络中间层维度。dropout:用于正则化的 dropout 比例。
组件:
self.self_attn:用于目标序列的多头自注意力机制。self.cross_attn:对编码器输出进行注意力的多头交叉注意力机制。self.feed_forward:位置前馈神经网络。self.norm1、self.norm2、self.norm3:层归一化组件。self.dropout:用于正则化的 Dropout 层。
前向方法:
ef forward(self, x, enc_output, src_mask, tgt_mask):
attn_output = self.self_attn(x, x, x, tgt_mask)
x = self.norm1(x + self.dropout(attn_output))
attn_output = self.cross_attn(x, enc_output, enc_output, src_mask)
x = self.norm2(x + self.dropout(attn_output))
ff_output = self.feed_forward(x)
x = self.norm3(x + self.dropout(ff_output))
return x输入:
x:解码器层的输入。enc_output:对应编码器的输出(用于交叉注意力步骤)。src_mask:源序列掩码,用于忽略编码器输出的某些部分。tgt_mask:目标序列掩码,用于忽略解码器输入的某些部分。
处理步骤:
- 目标序列上的自注意力:对输入 x 进行自注意力处理。
- 加和与归一化(自注意力后):将自注意力输出与原始 x 残差相加,随后应用 dropout 与
norm1归一化。 - 与编码器输出的交叉注意力:将上一步的归一化结果与编码器输出
enc_output进行交叉注意力。 - 加和与归一化(交叉注意力后):将交叉注意力输出与该阶段输入残差相加,随后应用 dropout 与
norm2归一化。 - 前馈网络:将结果送入前馈网络。
- 加和与归一化(前馈后):将前馈输出与该阶段输入残差相加,随后应用 dropout 与
norm3归一化。 - 输出:返回解码器层的处理结果张量。
总结:
DecoderLayer 定义了 Transformer 解码器的单层结构。它由多头自注意力、多头交叉注意力(关注编码器输出)、位置前馈网络以及相应的残差连接、层归一化和 dropout 组成。该组合使解码器能够基于编码器的表示生成有意义的输出,同时兼顾目标序列与源序列。与编码器类似,实际模型通常会堆叠多个解码器层。
接下来,将编码器与解码器模块组合,构建完整的 Transformer 模型。
5. 组合编码器与解码器层,构建完整的 Transformer 网络
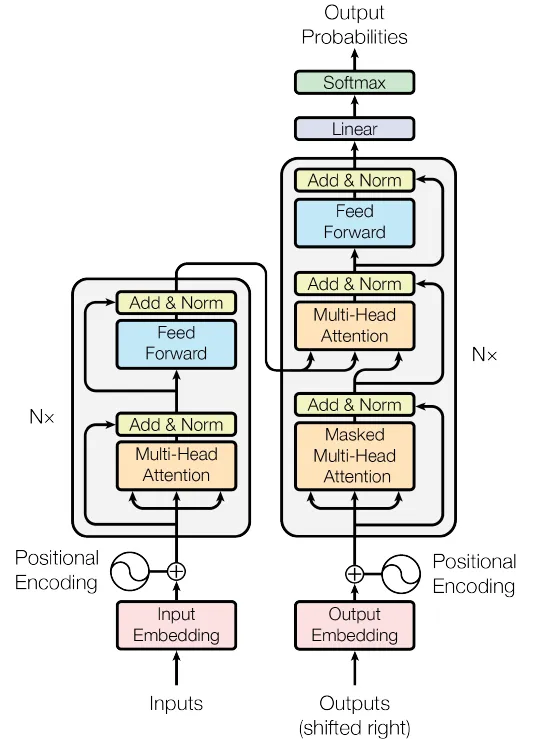
图 4. Transformer 网络(来源:原论文图片)
class Transformer(nn.Module):
def __init__(self, src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout):
super(Transformer, self).__init__()
self.encoder_embedding = nn.Embedding(src_vocab_size, d_model)
self.decoder_embedding = nn.Embedding(tgt_vocab_size, d_model)
self.positional_encoding = PositionalEncoding(d_model, max_seq_length)
self.encoder_layers = nn.ModuleList([EncoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
self.decoder_layers = nn.ModuleList([DecoderLayer(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
self.fc = nn.Linear(d_model, tgt_vocab_size)
self.dropout = nn.Dropout(dropout)
def generate_mask(self, src, tgt):
src_mask = (src != 0).unsqueeze(1).unsqueeze(2)
tgt_mask = (tgt != 0).unsqueeze(1).unsqueeze(3)
seq_length = tgt.size(1)
nopeak_mask = (1 - torch.triu(torch.ones(1, seq_length, seq_length), diagonal=1)).bool()
tgt_mask = tgt_mask & nopeak_mask
return src_mask, tgt_mask
def forward(self, src, tgt):
src_mask, tgt_mask = self.generate_mask(src, tgt)
src_embedded = self.dropout(self.positional_encoding(self.encoder_embedding(src)))
tgt_embedded = self.dropout(self.positional_encoding(self.decoder_embedding(tgt)))
enc_output = src_embedded
for enc_layer in self.encoder_layers:
enc_output = enc_layer(enc_output, src_mask)
dec_output = tgt_embedded
for dec_layer in self.decoder_layers:
dec_output = dec_layer(dec_output, enc_output, src_mask, tgt_mask)
output = self.fc(dec_output)
return output类定义:
class Transformer(nn.Module):初始化:
def __init__(self, src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout):构造函数接收以下参数:
src_vocab_size:源语言词表大小。tgt_vocab_size:目标语言词表大小。d_model:模型嵌入维度。num_heads:多头注意力的头数。num_layers:编码器与解码器的层数。d_ff:前馈网络中间层维度。max_seq_length:位置编码的最大序列长度。dropout:正则化的 dropout 比例。
并定义以下组件:
self.encoder_embedding:源序列的嵌入层。self.decoder_embedding:目标序列的嵌入层。self.positional_encoding:位置编码组件。self.encoder_layers:编码器层列表。self.decoder_layers:解码器层列表。self.fc:映射到目标词表大小的最终全连接(线性)层。self.dropout:Dropout 层。
掩码生成方法:
def generate_mask(self, src, tgt):该方法为源与目标序列创建掩码,确保忽略填充标记,并在训练中对目标序列屏蔽未来信息。
前向方法:
def forward(self, src, tgt):该方法定义了 Transformer 的前向传播,接收源与目标序列并生成输出预测。
- 输入嵌入与位置编码:首先将源与目标序列分别通过嵌入层,并加入对应的位置编码。
- 编码器层:将源序列依次通过编码器层,最终得到处理后的源序列表示。
- 解码器层:将目标序列与编码器输出一同传入解码器层,得到解码器输出。
- 最终线性层:将解码器输出通过全连接(线性)层映射到目标词表大小。
输出:
最终输出为一个张量,表示模型对目标序列的预测。
总结:
Transformer 类将模型的各个组件(嵌入、位置编码、编码器层与解码器层)整合在一起。它为训练与推理提供了便捷接口,封装了多头注意力、前馈网络与层归一化的复杂性。
该实现遵循标准的 Transformer 架构,适用于诸如机器翻译、文本摘要等序列到序列任务。通过使用掩码,模型能够遵循序列中的因果依赖,忽略填充标记并防止未来信息泄漏。
上述步骤使 Transformer 模型能够高效处理输入序列并生成相应的输出序列。
训练 PyTorch Transformer 模型
示例数据准备
为便于演示,本例将构造一个伪造数据集。但在实际场景中,您会使用更大规模的数据集,并进行文本预处理,同时为源语言与目标语言创建词表映射。
src_vocab_size = 5000
tgt_vocab_size = 5000
d_model = 512
num_heads = 8
num_layers = 6
d_ff = 2048
max_seq_length = 100
dropout = 0.1
transformer = Transformer(src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout)
# Generate random sample data
src_data = torch.randint(1, src_vocab_size, (64, max_seq_length)) # (batch_size, seq_length)
tgt_data = torch.randint(1, tgt_vocab_size, (64, max_seq_length)) # (batch_size, seq_length)超参数:
这些数值定义了 Transformer 模型的架构与行为:
src_vocab_size、tgt_vocab_size:源与目标序列的词表大小,均为 5000。d_model:模型嵌入维度,512。num_heads:多头注意力中的头数,8。num_layers:编码器与解码器的层数,6。d_ff:前馈网络中间层维度,2048。max_seq_length:位置编码的最大序列长度,100。dropout:正则化的 dropout 比例,0.1。
供参考,下表列出了 Transformer 模型最常见的超参数及其取值:
| Hyperparameter | Typical values | Impact on performance |
|---|---|---|
| d_model | 256, 512, 1024 | Higher values increase model capacity but require more computation |
| num_heads | 8, 12, 16 | More heads can capture diverse aspects of data, but are computationally intensive |
| num_layers | 6, 12, 24 | More layers improve representation power, but can lead to overfitting |
| d_ff | 2048, 4096 | Larger feed-forward networks increase model robustness |
| dropout | 0.1, 0.3 | Regularizes the model to prevent overfitting |
| learning rate | 0.0001 - 0.001 | Impacts convergence speed and stability |
| batch size | 32, 64, 128 | Larger batch sizes improve learning stability but require more memory |
创建 Transformer 实例:
transformer = Transformer(src_vocab_size, tgt_vocab_size, d_model, num_heads, num_layers, d_ff, max_seq_length, dropout)该行代码根据上述超参数创建一个 Transformer 实例。此实例将具备由这些超参数决定的架构与行为。
生成随机示例数据:
以下代码生成随机的源与目标序列:
src_data:在 1 到src_vocab_size之间的随机整数,形状为(64,max_seq_length),代表一批源序列。tgt_data:在 1 到tgt_vocab_size之间的随机整数,形状为(64,max_seq_length),代表一批目标序列。- 这些随机序列可作为 Transformer 模型的输入,模拟包含 64 个样本、序列长度为 100 的一批数据。
总结:
该代码片段演示了如何初始化一个 Transformer 模型,并生成可输入模型的随机源与目标序列。所选超参数决定了 Transformer 的具体结构与特性。该设置可作为更大脚本的一部分,用于在实际的序列到序列任务(如机器翻译、文本摘要)上训练与评估模型。
训练模型
接下来将使用上述示例数据训练模型。但在真实场景中,通常会使用规模更大的数据集,并将其划分为训练集与验证集。
criterion = nn.CrossEntropyLoss(ignore_index=0)
optimizer = optim.Adam(transformer.parameters(), lr=0.0001, betas=(0.9, 0.98), eps=1e-9)
transformer.train()
for epoch in range(100):
optimizer.zero_grad()
output = transformer(src_data, tgt_data[:, :-1])
loss = criterion(output.contiguous().view(-1, tgt_vocab_size), tgt_data[:, 1:].contiguous().view(-1))
loss.backward()
optimizer.step()
print(f"Epoch: {epoch+1}, Loss: {loss.item()}")损失函数与优化器:
criterion = nn.CrossEntropyLoss(ignore_index=0):定义交叉熵损失,ignore_index设为 0,表示不计算索引为 0 的目标(通常为填充标记)的损失。optimizer = optim.Adam(...):使用 Adam 优化器,学习率为 0.0001,并设置特定的 beta 值。
模型训练模式:
transformer.train():将模型设为训练模式,启用仅在训练阶段生效的行为(如 dropout)。
训练循环:
代码片段使用典型训练循环训练 100 个 epoch:
for epoch in range(100):迭代 100 个训练轮次。optimizer.zero_grad():清除上一轮的梯度。output = transformer(src_data, tgt_data[:, :-1]):将源数据与目标数据(每个序列去掉最后一个标记)输入模型。在序列到序列任务中,常将目标序列右移一个位置。loss = criterion(...):计算模型预测与目标数据(每个序列去掉第一个标记)之间的损失。通过将数据重塑为一维张量,并使用交叉熵损失进行计算。loss.backward():计算损失相对于模型参数的梯度。optimizer.step():使用计算得到的梯度更新模型参数。print(f"Epoch: {epoch+1}, Loss: {loss.item()}"):打印当前 epoch 编号与损失值。
总结:
该代码片段在随机生成的源与目标序列上训练 Transformer 模型 100 个 epoch。使用 Adam 优化器与交叉熵损失,并在每个 epoch 打印损失,以便监控训练进展。在实际场景中,您应将随机序列替换为具体任务(如机器翻译)的真实数据。
Transformer 模型性能评估
模型训练完成后,可以在验证集或测试集上评估其性能。以下是一个示例:
transformer.eval()
# Generate random sample validation data
val_src_data = torch.randint(1, src_vocab_size, (64, max_seq_length)) # (batch_size, seq_length)
val_tgt_data = torch.randint(1, tgt_vocab_size, (64, max_seq_length)) # (batch_size, seq_length)
with torch.no_grad():
val_output = transformer(val_src_data, val_tgt_data[:, :-1])
val_loss = criterion(val_output.contiguous().view(-1, tgt_vocab_size), val_tgt_data[:, 1:].contiguous().view(-1))
print(f"Validation Loss: {val_loss.item()}")评估模式:
transformer.eval():将模型置于评估模式。这很重要,因为它会关闭训练阶段才会启用的行为(如 dropout)。
生成随机验证数据:
val_src_data:1 到src_vocab_size之间的随机整数,形状为(64,max_seq_length),代表一批验证源序列。val_tgt_data:1 到tgt_vocab_size之间的随机整数,形状为(64,max_seq_length),代表一批验证目标序列。
验证流程:
with torch.no_grad():禁用梯度计算,因为验证时不需要更新权重。这能减少内存占用并加速计算。val_output = transformer(val_src_data, val_tgt_data[:, :-1]):将验证源数据与目标数据(每个序列去掉最后一个标记)输入模型。val_loss = criterion(...):计算模型预测与验证目标数据(每个序列去掉第一个标记)之间的损失,方法与训练一致。print(f"Validation Loss: {val_loss.item()}"):打印验证损失。
总结:
该代码片段在随机生成的验证数据集上评估 Transformer 模型,计算并打印验证损失。在实际场景中,应使用任务相关的真实验证数据。验证损失可以反映模型在未见数据上的表现,是衡量模型泛化能力的重要指标。
想进一步了解 Transformers 与 Hugging Face,请参考我们的教程 An Introduction to Using Transformers and Hugging Face。
结论与后续资源
总之,本教程演示了如何使用 PyTorch(最具通用性的深度学习工具之一)构建 Transformer 模型。凭借并行化能力与对数据长程依赖的建模能力,Transformer 在多个领域(尤其是翻译、摘要、情感分析等 NLP 任务)展现出巨大潜力。
如果您希望进一步深化对高级深度学习概念与技术的理解,建议探索 DataCamp 的课程 Advanced Deep Learning with Keras。您也可以阅读另一篇教程,了解如何用 PyTorch 从零构建一个简单的神经网络。
FAQs
自注意力与传统注意力机制有何不同?
自注意力不同于传统注意力机制之处在于,它允许模型在单个序列内关注所有位置来计算其表示;而传统注意力通常用于对齐两个独立序列,例如在编码器-解码器结构中,解码器关注编码器的输出。
为什么 Transformer 在处理长序列时比 LSTM 更高效?
Transformer 使用自注意力机制,支持并行化,并能在序列中为相距较远的元素建立直接联系。这不同于 LSTM 逐步处理序列的方式,后者因梯度消失等问题而难以处理长程依赖。
层归一化在 Transformer 架构中起什么作用?
层归一化通过对每一子层的输入进行归一化,帮助稳定并加速深层网络的训练,从而使各层输入的分布保持一致,提升收敛速度与模型性能。
位置编码如何帮助 Transformer 模型?
位置编码为序列中每个标记引入位置信息,使模型能够捕捉词序,这对于理解上下文和词语间关系至关重要。
Transformer 架构是否可用于 NLP 以外的任务,如计算机视觉?
可以。Transformer 架构已被改造用于计算机视觉任务,例如视觉 Transformer(ViT),其将图像划分为小块并视作序列处理,利用强大的注意力机制捕捉空间关系。
为何使用 Dropout?它对训练有何益处?
Dropout 通过在训练中随机将一部分输入单元置零来防止过拟合,鼓励模型学习更稳健、不过度依赖特定神经元的特征,从而提升泛化能力。
训练与评估模式下如何区别管理梯度计算?
训练阶段需要计算梯度以更新模型权重;而在评估模式下,会使用 torch.no_grad() 来禁用梯度计算,因为无需更新权重,这能降低内存占用并提升计算速度。
多头注意力中使用多个注意力头有何意义?
多个注意力头使模型能够同时关注输入序列的不同部分,捕捉多样的关系与模式,从而增强模型理解复杂数据结构的能力。
Transformer 如何处理变长序列?
Transformer 通过使用填充标记来统一批内输入的尺寸,并在注意力计算时应用掩码以忽略这些填充标记,从而避免其影响模型输出,以此处理变长序列。
从零开始训练 Transformer 模型可能面临哪些挑战?
从零开始训练 Transformer 计算开销大且耗时,因其结构复杂且需要大规模数据。此外,选择合适的超参数并确保在不过拟合的前提下实现收敛也颇具挑战。

博士研究员——德国莱布尼茨研究所-HKI,从事生物医学图像深度学习研究。热衷于在医疗保健领域应用人工智能。
Transformer 是现代机器学习中最强大的模型之一。它彻底改变了该领域,尤其是在自然语言处理(NLP)任务(如机器翻译和文本摘要)中。凭借处理长程依赖和并行计算的能力,Transformer 已在这些任务中取代长短期记忆(LSTM)网络。
PyTorch 是一款以简洁、灵活与高效著称的开源机器学习库,已成为机器学习和人工智能研究者与开发者的首选。本教程旨在帮助您全面理解如何使用 PyTorch 构建一个 Transformer 模型。
如果您对 PyTorch 不熟悉,建议先学习我们的课程 Efficient AI Model Training With PyTorch,打好基础。