कोर्स
PyTorch के साथ Deep Learning परिचय
4 घंटा
91.7K
भाषा मानवीय संचार के लिए अत्यंत महत्वपूर्ण है, और इसे स्वचालित करने से अपार लाभ मिल सकते हैं। प्राकृतिक भाषा संसाधन (NLP) मॉडल वर्षों तक मानवीय भाषा की बारीकियों को प्रभावी ढंग से पकड़ने में संघर्ष करते रहे, जब तक कि एक बड़ी प्रगति नहीं हुई — attention मेकैनिज़्म।
Attention मेकैनिज़्म 2017 में Attention Is All You Need नामक पेपर में प्रस्तुत किया गया था। पारंपरिक तरीकों से भिन्न, जो शब्दों को अलग-थलग देखते हैं, attention हर शब्द को उसके वर्तमान कार्य से प्रासंगिक होने के आधार पर भार (weight) देता है। यह मॉडल को लंबी दूरी की निर्भरताएँ पकड़ने, स्थानीय और वैश्विक संदर्भों का एक साथ विश्लेषण करने और वाक्य के सूचनात्मक हिस्सों पर ध्यान देकर अस्पष्टताओं को सुलझाने में सक्षम बनाता है।
निम्नलिखित वाक्य पर विचार करें: "Miami, जिसे 'magic city' कहा जाता है, में खूबसूरत सफ़ेद रेत वाले समुद्रतट हैं।" पारंपरिक मॉडल हर शब्द को क्रम से संसाधित करते। जबकि attention मेकैनिज़्म हमारे मस्तिष्क की तरह कार्य करता है। यह वर्तमान फोकस को समझने के लिए प्रत्येक शब्द की प्रासंगिकता के आधार पर एक स्कोर सौंपता है। "Miami" और "beaches" जैसे शब्द स्थान पर विचार करते समय अधिक महत्वपूर्ण हो जाते हैं, इसलिए उन्हें उच्च स्कोर मिलेंगे।
इस लेख में, हम attention मेकैनिज़्म की एक सहज व्याख्या देंगे। आप transformers कैसे काम करते हैं पर इस ट्यूटोरियल में एक अधिक तकनीकी दृष्टिकोण भी पा सकते हैं। आइए शुरू करते हैं!
Attention मेकैनिज़्म को समझने की अपनी यात्रा की शुरुआत भाषा मॉडलों के व्यापक संदर्भ से करते हैं।
भाषा मॉडल व्याकरणिक संरचना (syntax) और अर्थ (semantics) को समझने की कोशिश करके भाषा को संसाधित करते हैं। लक्ष्य यह है कि इनपुट के अनुरूप, सही सिंटैक्स और सैमांटिक्स के साथ भाषा आउटपुट हो।
भाषा मॉडल पाठ को तोड़ने और समझने के लिए तकनीकों की एक श्रृंखला पर निर्भर करते हैं:
जहाँ पारंपरिक भाषा मॉडलों ने NLP में प्रगति का रास्ता बनाया, वहीं वे प्राकृतिक भाषा की जटिलताओं को पूरी तरह समझने में चुनौतियों का सामना करते रहे:
पारंपरिक मॉडलों के विपरीत जो शब्दों को अलग-थलग देखते हैं, attention भाषा मॉडलों को संदर्भ पर विचार करने देता है। आइए देखें यह कैसे काम करता है!
NLP क्षेत्र के लिए निर्णायक मोड़ 2017 में आया जब Attention Is All You Need पेपर ने attention मेकैनिज़्म पेश किया।
इस पेपर ने transformer नामक एक नई आर्किटेक्चर का प्रस्ताव किया। recurrent neural networks (RNNs) और convolutional neural networks (CNNs) जैसी पुरानी विधियों के विपरीत, transformers attention मेकैनिज़्म का उपयोग करते हैं।
पारंपरिक मॉडलों की कई समस्याओं को हल करके, transformers (और attention) आज के कई लोकप्रिय large language models (LLMs) जैसे OpenAI के GPT-4 और ChatGPT की नींव बन गए हैं।
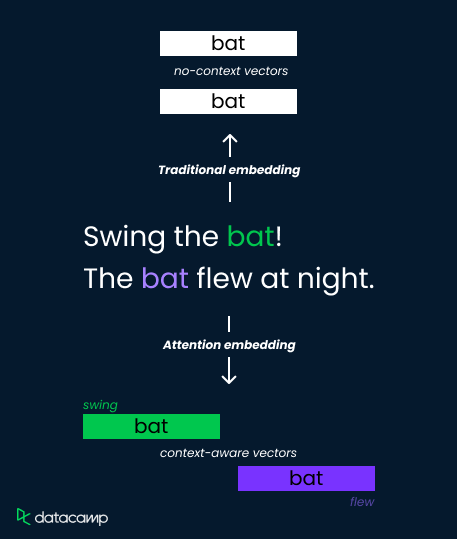
आइए इन दो वाक्यों में “bat” शब्द पर विचार करें:
पारंपरिक एम्बेडिंग विधियाँ “bat” के लिए एक ही वेक्टर प्रतिनिधित्व सौंपती हैं, जिससे अर्थ के बीच भेद करना सीमित हो जाता है। जबकि attention मेकैनिज़्म संदर्भ-आधारित वेट्स की गणना करके इसे संबोधित करता है।
ये आस-पास के शब्दों ("swing" बनाम "flew") का विश्लेषण करते हैं और प्रासंगिकता निर्धारित करने वाले attention स्कोर की गणना करते हैं। फिर इन स्कोरों का उपयोग एम्बेडिंग वेक्टरों को वेट करने में होता है, जिससे "bat" के लिए अलग-अलग प्रतिनिधित्व बनते हैं — एक खेल उपकरण के रूप में ("swing" पर उच्च वेट) या एक उड़ने वाले जीव के रूप में ("flew" पर उच्च वेट)।
यह मॉडल को सैमांटिक बारीकियाँ पकड़ने और समझ में सुधार करने देता है।
अब हम attention की सहज समझ पर आगे बढ़ते हुए देखेंगे कि यह पारंपरिक शब्द एम्बेडिंग से आगे जाकर भाषा समझ को कैसे बेहतर बनाता है। हम attention के कुछ वास्तविक-world अनुप्रयोग भी देखेंगे।
Word2Vec और GloVe जैसी पारंपरिक शब्द एम्बेडिंग तकनीकें, बड़े कॉर्पस में सह-अनुपस्थिति (co-occurrence) आँकड़ों के आधार पर, शब्दों को सैमांटिक स्पेस में स्थिर-आयामी वेक्टर के रूप में दर्शाती हैं।
ये एम्बेडिंग शब्दों के बीच कुछ सैमांटिक संबंध तो पकड़ती हैं, लेकिन संदर्भ-संवेदी नहीं होतीं। यानी वही शब्द, वाक्य या दस्तावेज़ में उसके संदर्भ की परवाह किए बिना, वही एम्बेडिंग रखता है।
यह सीमा उन कार्यों में चुनौती पेश करती है जिनमें भाषा की सूक्ष्म समझ आवश्यक है — खासकर जब शब्द अलग-अलग संदर्भों में अलग अर्थ रखते हैं। Attention मेकैनिज़्म इस समस्या को इनपुट अनुक्रम के प्रासंगिक हिस्सों पर चयनात्मक रूप से ध्यान केंद्रित करने की क्षमता देकर हल करता है, और इस तरह प्रतिनिधित्व सीखने की प्रक्रिया में संदर्भ-संवेदनशीलता शामिल करता है।
Attention मॉडलों को भाषा की बारीकियों और अस्पष्टताओं को समझने में सक्षम बनाता है, जिससे वे जटिल पाठ को संसाधित करने में अधिक प्रभावी हो जाते हैं। इसके कुछ प्रमुख लाभ हैं:
Attention-आधारित भाषा मॉडलों का प्रभाव अत्यंत व्यापक रहा है। हजारों लोग attention-आधारित मॉडलों पर बनी एप्लिकेशन का उपयोग करते हैं। कुछ सबसे लोकप्रिय अनुप्रयोग हैं:
अब जब हम समझ गए हैं कि attention कैसे काम करता है, तो self-attention और multi-head attention को देखते हैं।
Self-attention किसी अनुक्रम के प्रतिनिधित्व की गणना के लिए मॉडल को उसके इनपुट अनुक्रम की विभिन्न स्थितियों पर ध्यान देने में सक्षम बनाता है। यह मॉडल को अनुक्रम में प्रत्येक शब्द के महत्व को अन्य शब्दों के सापेक्ष तौलने देता है, जिससे इनपुट के विभिन्न शब्दों के बीच निर्भरताएँ पकड़ी जाती हैं। इस मेकैनिज़्म के तीन मुख्य तत्व हैं:
Attention स्कोर query और key वेक्टरों के बीच scaled dot product करके निकाले जा सकते हैं। अंततः, इन स्कोरों को value वेक्टरों से गुणा किया जाता है जिससे मानों का वेटेड सम प्राप्त होता है।
Multi-head attention self-attention मेकैनिज़्म का विस्तार है। यह इनपुट अनुक्रम के विभिन्न हिस्सों पर एक साथ ध्यान देकर विविध संदर्भगत जानकारी पकड़ने की मॉडल की क्षमता को बढ़ाता है। यह इसे कई समानांतर self-attention परिचालनों के माध्यम से प्राप्त करता है, जिनमें से प्रत्येक के पास सीखे गए query, key और value ट्रांसफॉर्मेशनों का अपना सेट होता है।
Multi-head attention अधिक सूक्ष्म संदर्भगत समझ, बढ़ी हुई robustness और अभिव्यक्तिक्षमता (expressivity) की ओर ले जाता है।
हालाँकि attention मेकैनिज़्म को लागू करने के कई लाभ हैं, यह अपनी कुछ चुनौतियों के साथ भी आता है, जिन्हें चल रहे शोध से संबोधित किया जा सकता है।
Attention मेकैनिज़्म इनपुट अनुक्रम के सभी टोकनों के बीच युग्म-समानताएँ (pairwise similarities) गणना करता है, जिससे अनुक्रम लंबाई के सापेक्ष जटिलता वर्गात्मक (quadratic) हो जाती है। यह विशेषकर लंबे अनुक्रमों के लिए गणनात्मक रूप से महँगा हो सकता है।
गणनात्मक जटिलता को कम करने के लिए विभिन्न तकनीकें प्रस्तावित की गई हैं, जैसे sparse attention मेकैनिज़्म, approximate attention विधियाँ, और Reformer मॉडल के locality-sensitive hashing जैसी कुशल attention तकनीकें।
Attention मेकैनिज़्म इनपुट अनुक्रम में शोरयुक्त या अप्रासंगिक जानकारी पर ओवरफिट हो सकते हैं, जिससे अनदेखे डेटा पर प्रदर्शन उप-इष्टतम हो जाता है।
Dropout और layer normalization जैसी regularization तकनीकें attention-आधारित मॉडलों में ओवरफिटिंग को रोकने में मदद कर सकती हैं। इसके अतिरिक्त, attention dropout और attention masking जैसी तकनीकें मॉडल को प्रासंगिक जानकारी पर ध्यान केंद्रित करने के लिए प्रोत्साहित करती हैं।
Attention मेकैनिज़्म कैसे काम करते हैं और उनके आउटपुट की व्याख्या करना चुनौतीपूर्ण हो सकता है, खासकर बहु-लेयर और बहु-अटेंशन-हेड वाले जटिल मॉडलों में। यह इस नई तकनीक की नैतिकता के बारे में चिंताएँ उठाता है — आप हमारे AI ethics पाठ्यक्रम में या AI शोधकर्ता Dr. Joy Buolamwini के साथ इस पॉडकास्ट को सुनकर अधिक जान सकते हैं।
Attention वेट्स को विज़ुअलाइज़ करने और उनके अर्थ की व्याख्या करने की विधियाँ विकसित की गई हैं, जो attention-आधारित मॉडलों की व्याख्यात्मकता बढ़ाती हैं। साथ ही, attention attribution जैसी तकनीकें मॉडल की भविष्यवाणियों में व्यक्तिगत टोकनों के योगदान की पहचान करने का लक्ष्य रखती हैं, जिससे explainability में सुधार होता है।
Attention मेकैनिज़्म पर्याप्त मेमोरी और गणनात्मक संसाधन खपत करते हैं, जिससे उन्हें बड़े मॉडलों और डेटासेट तक स्केल करना चुनौतीपूर्ण हो जाता है।
Attention-आधारित मॉडलों को स्केल करने की तकनीकें, जैसे hierarchical attention, memory-efficient attention, और sparse attention, मेमोरी खपत और गणनात्मक ओवरहेड को कम करते हुए मॉडल के प्रदर्शन को बनाए रखने का लक्ष्य रखती हैं।
आइए पारंपरिक और attention-आधारित मॉडलों के बीच के अंतर पर ध्यान केंद्रित करके अब तक सीखी बातों का सार लें:
|
विशेषता |
Attention-आधारित मॉडल |
पारंपरिक NLP मॉडल |
|
शब्द प्रतिनिधित्व |
संदर्भ-सचेत एम्बेडिंग वेक्टर (attention स्कोर के आधार पर डायनेमिकली वेटेड) |
स्थिर एम्बेडिंग वेक्टर (प्रति शब्द एक वेक्टर, संदर्भ पर विचार नहीं) |
|
फोकस |
अर्थ के लिए आस-पास के शब्दों पर विचार करता है (वृहत्तर संदर्भ को देखता है) |
प्रत्येक शब्द को स्वतंत्र रूप से देखता है |
|
ताकतें |
लंबी दूरी की निर्भरताएँ पकड़ता है, अस्पष्टता सुलझाता है, बारीकियाँ समझता है |
सरल, गणनात्मक रूप से सस्ता |
|
कमज़ोरियाँ |
गणनात्मक रूप से महँगा हो सकता है |
जटिल भाषा समझने की सीमित क्षमता, संदर्भ में संघर्ष |
|
आधारभूत मेकैनिज़्म |
Attention वाले encoder-decoder नेटवर्क (विभिन्न आर्किटेक्चर) |
Parsing, stemming, named entity recognition, word embeddings जैसी तकनीकें |
इस लेख में, हमने attention मेकैनिज़्म का अन्वेषण किया, जो NLP में क्रांतिकारी नवाचार रहा है। पूर्ववर्ती तरीकों से अलग, attention भाषा मॉडलों को वाक्य के महत्वपूर्ण हिस्सों पर, संदर्भ को ध्यान में रखते हुए, फोकस करने देता है। इससे वे जटिल भाषा, लंबी दूरी के संबंध और शब्द-अस्पष्टता को समझ पाते हैं।
आप attention मेकैनिज़्म के बारे में आगे सीख सकते हैं:
Deep Learning से शुरुआत करें!
कोर्स
कोर्स
कोर्स