
技术类 Azure Data Factory 面试题
技术面试题通常聚焦于具体功能、实现方式及其协同构建高效数据管道的原理。这些问题会评估您对 ADF 核心组件与能力的实操经验与知识。
如何在 Azure Data Factory 管道中实现错误处理?
说明: 此题考察您在 ADF 管道中实施错误处理策略的能力。
示例答案: 可以使用重试策略(Retry Policies)与错误处理活动实现 ADF 的错误处理。ADF 提供内置重试机制,您可配置失败时的重试次数与重试间隔。
例如,当复制活动(Copy Activity)因临时网络问题失败时,可设置重试 3 次,每次间隔 10 分钟。
此外,可设置活动依赖条件(如 Failure、Completion、Skipped),根据活动成功或失败触发相应操作。
例如,我可以定义管道流程,使在某活动失败后执行自定义的错误处理活动,如发送告警或执行回退流程。
集成运行时(Integration Runtime,IR)在 Azure Data Factory 中的作用是什么?
说明: 此题评估您对 ADF 背后数据移动与活动调度计算基础设施的理解。
示例答案: 集成运行时(IR)是 Azure Data Factory 用于执行数据移动、转换与活动调度的计算基础设施。它负责管理数据在哪儿、如何被处理,并可根据数据源、目标与转换需求进行优化。进一步来说,IR 有三种类型:
|
集成运行时(IR)类型 |
说明 |
|
Azure 集成运行时 |
用于 Azure 数据中心内的数据移动与转换活动。支持复制活动、数据流转换,并将活动调度到 Azure 资源。 |
|
自托管集成运行时 |
安装在本地或私有网络中的虚拟机上,支持跨本地、私有与 Azure 资源进行数据集成。适合本地到 Azure 的数据复制。 |
|
Azure-SSIS 集成运行时 |
支持将现有的 SQL Server Integration Services(SSIS)包迁移至 Azure,在 ADF 中原生运行 SSIS 包。适合希望在不进行大量重构的情况下迁移 SSIS 工作负载的用户。 |
如何在 Azure Data Factory 管道中实施参数化?
说明: 此题检验您对参数化机制的理解,以构建可复用、灵活的管道。
示例答案: 在 Azure Data Factory 中,参数化可以实现动态管道执行,即每次运行时可传入不同的值。
例如,在复制活动中,我可以使用参数动态指定源文件路径与目标文件夹。我会在管道层定义参数,并将其传递给相关的数据集或活动。
如下为一个简单示例:
{
"name": "CopyPipeline",
"type": "Copy",
"parameters": {
"sourcePath": { "type": "string" },
"destinationPath": { "type": "string" }
},
"activities": [
{
"name": "Copy Data",
"type": "Copy",
"source": {
"path": "@pipeline().parameters.sourcePath"
},
"sink": {
"path": "@pipeline().parameters.destinationPath"
}
}
]
}参数化让管道可复用,并可在运行时通过动态调整输入实现轻松扩展。
什么是 Azure Data Factory 中的 Mapping Data Flow?
说明: 此题评估您在无需外部计算服务情况下进行数据转换的能力。
示例答案: Mapping Data Flow 允许您在不编写代码、且不将数据移出 ADF 生态的前提下进行数据转换,并提供可视化界面以构建复杂的转换流程。
数据流在 ADF 托管环境中的 Spark 集群上执行,从而实现可扩展、高效的数据转换。
例如,在典型的转换场景中,我可以使用数据流将两个数据集进行关联、对结果进行聚合,并将输出写入新目标——全程可视化完成,无需依赖外部服务如 Databricks。
您如何在 Azure Data Factory 中处理架构漂移(Schema Drift)?
说明: 此题考察您在数据转换过程中管理动态架构变化的能力。
示例答案: 架构漂移是指源数据结构随时间发生变化。
Azure Data Factory 在 Mapping Data Flows 中提供 Allow Schema Drift(允许架构漂移)选项,使 ADF 能自动适应传入数据架构的变化,如新增或删除列,而无需重新定义整个架构。
通过启用架构漂移,我可以配置管道在源架构变化时仍能动态映射列。
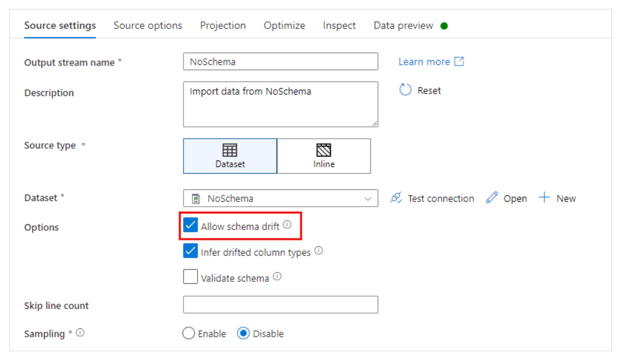
Azure Data Factory 中的允许架构漂移选项。图片来源: Microsoft
Azure Data Factory 中的变更数据捕获(CDC)资源如何工作?
说明: 此题评估您对现代化、持续数据摄取方式与批处理的对比理解。
示例答案: ADF 中的 CDC 资源提供低代码方式,将源(如 SQL 或 Cosmos 数据库)的变更数据持续复制到目标,无需复杂的水位线(watermark)逻辑。
与按计划运行的标准管道触发器不同,CDC 资源以持续(或微批)方式运行,自动跟踪源端的插入、更新与删除并应用到目标端。它非常适合需要准实时数据同步的场景。
高级 Azure Data Factory 面试题
高级问题更深入地探讨 ADF 的功能,侧重性能优化、真实用例与高级架构决策。
这些问题旨在评估您处理复杂数据场景的经验,以及使用 ADF 解决棘手问题的能力。
如何优化 Azure Data Factory 管道的性能?
说明: 此题考察您排障与提升管道效率的能力。
示例答案: 我通常通过多种策略优化 ADF 管道性能。
首先,尽可能利用并行性,通过并发管道运行(Concurrent Pipeline Runs)实现并行处理。我还会在复制活动中使用分区(Partitioning)来切分大数据集并并发传输小块数据。
另一项重要优化是根据数据源与转换需求选择合适的集成运行时。例如,在处理本地数据时使用自托管 IR,可加速本地到云的传输。
此外,在复制活动中启用 Staging(分阶段缓存)可先缓冲大数据集,再进行最终加载,从而提升性能。
Azure Key Vault 在 Azure Data Factory 中扮演什么角色?
说明: 此题评估您对 ADF 中安全凭据管理的理解。
示例答案: Azure Key Vault 对于在 ADF 中保护连接字符串、密码、API 密钥等敏感信息至关重要。我不会在管道或链接服务中硬编码机密,而是将其存储并由 Key Vault 统一管理。
ADF 管道可在运行时安全地从 Key Vault 检索机密,确保凭据受到保护且不暴露于代码中。例如,在设置连接 Azure SQL 数据库的链接服务时,我会使用来自 Key Vault 的机密引用完成安全认证。
Azure Data Factory 如何支持 CI/CD(持续集成/持续部署)?
说明: 此题检验您对版本控制与自动化部署的熟悉程度。
示例答案: Azure Data Factory 可与 Azure DevOps 或 GitHub 集成实现 CI/CD 工作流。我通常将 ADF 连接到 Git 仓库,为管道、数据集与链接服务启用版本控制。在开发环境中创建分支、修改并提交变更至仓库。
部署方面,ADF 支持导出 ARM 模板,并在不同环境(如预生产与生产)间使用。通过流水线,我可以自动化部署流程,确保变更在不同环境中得到测试与高效推广。
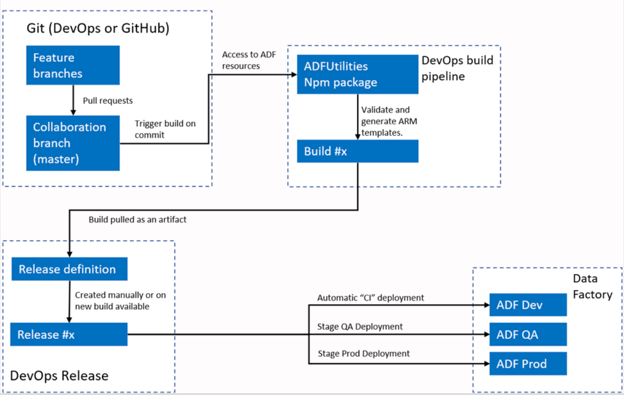
Azure Data Factory 自动化 CI/CI 工作流。图片来源:Microsoft。
如何设计一个使用 Azure Data Factory 的混合数据管道?
说明: 此题评估您对 ADF 处理混合数据环境能力的理解。
示例答案: 设计混合数据管道需要使用自托管集成运行时(IR)来桥接本地与云环境。IR 安装在本地网络中的机器上,使 ADF 能在本地与云资源(如 Azure Blob 存储或 Azure SQL 数据库)间安全移动数据。
例如,当需要将本地 SQL Server 的数据传输到 Azure Data Lake 时,我会设置自托管 IR 安全访问 SQL Server,定义源与目标的数据集,并使用复制活动移动数据;同时可通过 Mapping Data Flows 增加转换或清洗步骤。
如何在 Mapping Data Flow 中实现动态映射?
说明: 此题考察您在复杂数据流中配置动态架构映射的能力。
示例答案: Mapping Data Flow 中的动态映射支持源数据架构可能变化时的灵活性。我会使用数据流中的 Auto Mapping(自动映射)功能,按列名自动将源列映射到目标列。
对于更复杂的场景,我会使用派生列(Derived Columns)与表达式语言,基于元数据动态指定或修改列。该方法有助于应对架构漂移,或在面对多种源架构时无需手动重新映射。
Azure Data Factory 如何与 Microsoft Purview 集成?
说明: 此题检验您设计符合企业数据治理标准的管道能力。
示例答案: ADF 与 Microsoft Purview 原生集成以推送血缘(lineage)数据。管道运行时,ADF 会将以下元数据发送到 Purview:
- 移动了哪些数据(源到汇)。
- 执行了哪些转换。
- 运行统计(处理的行数)。
这使数据管理员可以可视化组织内的数据流。您可在 Purview 治理门户中注册 ADF 实例完成连接。
基于场景的 Azure Data Factory 面试题
行为与场景类面试题聚焦于候选人如何在真实环境中应用技术技能。
这些问题有助于评估候选人在复杂数据工作流中的问题解决、故障排查与优化能力,也可洞察其在数据集成与 ETL 流程相关挑战中的决策方式与经验。
描述一个您需要排查失败的 Azure Data Factory 管道的情境。
说明: 此题评估您在面对管道失败或异常问题时的解决能力。
示例答案: 在某项目中,我在将本地 SQL Server 数据传输到 Azure Blob 存储时,遇到管道持续失败。
错误日志显示数据移动过程出现超时。为排查问题,我首先检查了负责本地连接的自托管 IR 配置。
检查后发现承载 IR 的机器 CPU 占用较高,导致数据传输延迟。
为解决问题,我提升了该机器的处理能力,并通过复制活动的分区设置将工作负载拆分为更小的数据块并行处理。
这实现了并行处理,缩短了加载时间并避免了超时。变更后,管道成功运行,错误被消除。
请描述一个您在 ADF 中优化数据管道以提升性能的案例。
说明: 此题评估您识别并实施数据工作流优化技术的能力。
示例答案: 在一个需要处理多源大规模金融数据的项目中,因数据量庞大,初始管道执行耗时过长。为优化性能,我首先开启并行性,设置多个复制活动并行运行,每个处理一个数据集分区。
随后在复制活动中使用分阶段(staging)功能,将数据临时缓存在 Azure Blob 存储中再进一步处理,显著提升吞吐量。同时在数据流中缓存用于转换的查找表以优化性能。
这些调整使管道性能提升了 40%,执行时间显著缩短。
您是否遇到过数据源架构意外变化的情况?您是如何处理的?
说明: 此题检验您如何管理意外的架构变化并确保管道持续可用。
示例答案: 是的,其中一个项目中,某数据源(外部 API)意外新增了一列,导致管道失败,因为 Mapping Data Flow 中的架构不再对齐。
为解决问题,我在数据流中启用了 Allow Schema Drift 选项,使管道能自动检测并处理架构变化。
同时,我配置了使用派生列进行动态列映射,确保无需硬编码列名也能捕获新列。这样即便未来架构继续变化,管道也能自动适配。
请举例说明您如何使用 Azure Data Factory 集成多个数据源。
说明: 此题评估您处理多源数据集成(复杂 ETL 常见需求)的能力。
示例答案: 在最近的一个项目中,我需要集成三个来源的数据:本地 SQL Server、Azure Data Lake 与一个 REST API。我结合使用自托管 IR(连接本地 SQL Server)和 Azure IR(连接云端服务)。
我创建了一个管道,使用复制活动从 SQL Server 与 REST API 拉取数据,使用 Mapping Data Flows 进行转换,并与存于 Azure Data Lake 的数据进行合并。
通过参数化管道,我确保了在处理不同数据集与计划时的灵活性。这实现了多源数据的集成,对客户的数据分析平台至关重要。
当数据质量问题影响到 ADF 管道输出时,您如何处理?
说明: 此题考察您如何在管道工作流中识别并处理数据质量问题。
示例答案: 在某次从 CRM 系统抽取客户数据的管道中,数据存在缺失值与重复项,影响最终报表。为解决此类数据质量问题,我在管道中加入了数据流执行数据清洗操作。
我使用过滤器去重,用条件拆分(conditional split)处理缺失值,并设置查找以从参考数据集中补齐缺失或错误的数据。流程结束后,数据质量显著提升,确保了下游分析的准确与可靠。
请描述一次您在 ADF 中实现复杂数据转换的经历。
说明: 此题检验您使用 ADF 进行高级数据转换的经验。
示例答案: 在一个财务报表项目中,我需要合并多个来源的交易数据、执行聚合并为不同地区生成汇总报表。挑战在于各数据源的结构与命名略有不同。我使用 Mapping Data Flows 实现转换。
首先,我用派生列统一所有数据集的列名。随后进行聚合,计算各地区的指标,如总销售额与平均交易额。最后,我使用透视(pivot)转换重塑数据,便于报告展示。整个转换均在 ADF 内完成,充分利用了其内置转换与可扩展的基础设施。
请举例说明您如何在 Azure Data Factory 管道中保护敏感数据。
说明: 此题评估您对 ADF 数据安全实践的理解。
示例答案: 在某项目中,我们需要将敏感客户数据从本地 SQL Server 安全传输到 Azure SQL 数据库。我使用 Azure Key Vault 存储数据库凭据并保护数据,确保密码等敏感信息不被硬编码在管道或链接服务中。
此外,我通过启用本地 SQL Server 与 Azure 之间的 SSL 连接实现数据传输加密。
同时使用基于角色的访问控制(RBAC)限制对 ADF 管道的访问,确保只有授权用户可触发或修改。这既保证了安全传输,也实现了正确的访问管理。
当管道需要基于特定业务事件运行时,您如何实现?
说明: 此题评估您实现事件驱动型管道执行的能力。
示例答案: 在某场景中,只要新的销售数据文件被上传到 Azure Blob 存储,管道就需要运行。为实现此需求,我在 ADF 中使用了事件触发器(Event-Based Trigger)。该触发器监听特定容器中的 Blob Created 事件,一旦有新文件上传,就会自动触发管道。
这种事件驱动方式确保管道仅在有新数据时运行,无需手动执行或定时计划。随后管道会处理文件、进行转换并将其加载至数据仓库以供进一步分析。
请描述一次将本地 ETL 过程迁移到 Azure Data Factory 的经历。
说明: 此题评估您使用 ADF 将传统 ETL 迁移到云端的经验。
示例答案: 在将基于 SSIS 的本地 ETL 迁移到云端的项目中,我使用了 Azure Data Factory 的 Azure-SSIS 集成运行时。
我首先评估现有 SSIS 包与 ADF 的兼容性,并进行必要的修改以适配云端数据源。
随后我部署 Azure-SSIS IR 在云端运行 SSIS 包,保持原有工作流。同时,在新云环境中,我用 ADF 原生组件(如复制活动与 Mapping Data Flows)替代了部分传统 ETL 活动,从而提升了整体性能与可扩展性。
某管道虽然运行成功但成本较高。您如何分析并降低开销?
说明: 此题考察您的运维成熟度与对 ADF 计费模型的理解。
示例答案: 我会先在 Azure Monitor 中分析管道运行的消费报告,定位成本驱动因素(例如高 Data Flow 计算时长或过多 API 调用)。常见优化策略包括:
- 调整集成运行时:仅在必要时从通用计算切换到内存优化,或缩短 Data Flow 集群的存活时间(TTL),避免为空闲时间付费。
- 并发性:确保活动并行而非串行运行,以减少总运行时长。
- 触发器类型:检查 Tumbling Window 触发器是否相较于标准 Schedule 触发器,进行不必要的昂贵重试。
准备 Azure Data Factory 面试的建议
准备 Azure Data Factory 面试需要深入理解平台的技术与实践层面。您需要展示对 ADF 核心功能的掌握,以及在真实场景中应用这些功能的能力。
以下是我的面试备考要点:
- 掌握 ADF 概念与架构 —— 面试前应深入了解 Azure Data Factory 的整体架构。理解其核心组件,并能解释各组件在 ETL 管道中的工作原理与交互方式。您还应能说明 ADF 如何与 Data Lake、Blob 存储与 SQL 数据库等其他 Azure 服务集成。
- 熟悉工具与服务的使用 —— 熟悉与 ADF 配合使用的工具与服务。确保您了解如何高效配置数据移动与转换活动,因为这些往往是技术面问题的重点。
- 准备真实案例 —— 面试官通常希望看到可证明您 ADF 实战经验的案例。如果您有优化管道性能或排查问题的经历,请重点突出,这能展示您在真实场景中处理日常挑战的能力。
- 理解 ADF 的安全特性 —— 熟悉 ADF 如何处理安全问题,例如使用托管身份进行安全认证、利用 Azure Key Vault 管理机密、通过 RBAC 进行资源治理。强调您对这些安全措施的理解,能体现您构建安全合规数据方案的重视。
- 紧跟 ADF 最佳实践 —— Azure Data Factory 不断演进并频繁更新新功能!请查阅官方文档,了解最新特性或改进。
结语
Azure Data Factory 是构建云端 ETL 解决方案的强大工具,在数据工程领域备受青睐!
本文探讨了从通用概念到技术与场景类的关键面试题,强调了对 ADF 功能与工具的理解。关于管道管理、数据转换与故障排查的真实案例,展示了在云端 ETL 环境中所需的关键技能。
如需加深对 Microsoft Azure 的理解,建议学习 Azure 架构、管理与治理的基础课程,例如 Understanding Microsoft Azure、 Understanding Microsoft Azure Architecture and Services 与 Understanding Microsoft Azure Management and Governance。这些资源可帮助您更全面地了解 Azure 生态,补充 ADF 知识,为数据工程职业发展打下坚实基础。
Azure Data Factory 常见问答
Azure Data Factory 会被 Microsoft Fabric 取代吗?
不会,但格局在变化。尽管 Microsoft Fabric 成为 SaaS 分析的战略重点,Azure Data Factory(ADF)仍是现有企业架构与需要深度自定义基础设施控制场景中的关键 PaaS 解决方案。面试官期望您同时了解两者,并理解何时将工作流迁移到 Fabric、何时保留在 ADF 中。
使用 Azure Data Factory 是否需要掌握 Python 或 SQL?
需要,主要是 SQL。虽然 ADF 是“低代码”工具,但编写源端查询与存储过程需要中级 SQL 技能。Python 在高级场景中日益重要,例如为Batch Service 编写脚本,或在由 ADF 触发的Databricks Notebook 中进行复杂转换。
哪项认证最适合 ADF 岗位?
建议从 AZ-900 认证 入门,它涵盖胜任初级数据工程师所需的技术技能。 面向高级岗位的“金标准”是 DP-203:Microsoft Azure 数据工程。它与 Synapse、Data Lake、Databricks 一并深入覆盖 ADF。
没有企业账号,如何练习 ADF?
您可以创建一个免费的 Azure 帐户,在前 30 天获得 200 美元额度。但需注意成本:ADF 按活动运行与集成运行时的在线时长计费。为安全练习,请立即设置 Azure 预算警报,以免在构建作品集项目时产生意外费用。
候选人在 ADF 面试中最常见的错误是什么?
过度关注“理想路径”。初学者常只说明如何构建一个完美运行的管道。资深候选人则会讲清如何应对失败:实施重试策略、设置死信队列、在 Azure Monitor 中配置告警,以及在管道中途崩溃时确保数据一致性。

Azure Data Factory(ADF)是由 Microsoft Azure 提供的云端数据集成服务。
随着数据驱动的决策逐渐成为企业运营的核心,对云端数据工程工具的需求也达到了历史高点!由于 ADF 是领先的服务之一,越来越多的公司希望招聘具有实操经验的数据专业人士来管理其数据管道并整合各类系统。
本文旨在为有志于从事 ADF 的专业人士提供必备的 Azure Data Factory 面试题及答案,涵盖通用、技术、进阶与场景类问题,并提供拿下面试的实用提示。
什么是 Azure Data Factory,它为何重要?
Azure Data Factory 是一项基于云的 ETL 服务,帮助您创建以数据为驱动的工作流,用于编排与自动化数据的移动与转换。该服务可集成本地与云端的各类数据源与目标。
随着团队向云原生基础设施迁移,跨多样化环境管理数据的需求不断增长。ADF 与 Azure 生态及第三方数据源的集成能力很好地满足了这一点,使得对该服务的专业掌握成为组织高度青睐的技能。
使用 Azure Data Factory 的自动化 BI 架构。图片来源: Microsoft
通用 Azure Data Factory 面试题
本节聚焦于面试中常见的基础性问题,用以评估您对 ADF 的总体认知。这些问题会考察您对基本概念、架构与组件的理解。
Azure Data Factory 的主要组件有哪些?
说明: 此题常用于判断您是否理解 ADF 的构建基石。
示例答案: Azure Data Factory 的主要组件包括:
Azure Data Factory 如何在云端与本地环境之间进行数据移动?
说明: 此题考察您对 ADF 如何安全高效地实现混合数据移动的理解。
示例答案: Azure Data Factory 通过自托管集成运行时(Self-hosted IR)在云端与本地之间实现安全的数据移动,该运行时充当 ADF 与本地数据源之间的桥梁。
例如,将本地 SQL Server 的数据迁移到 Azure Blob 存储时,自托管 IR 会与本地系统安全连接,使 ADF 在传输过程中与落地存储均通过加密保障安全。此方式尤其适用于数据分布在本地与云基础设施的混合云场景。
解释 Azure Data Factory 中触发器(triggers)的工作方式。
说明: 此题评估您对 ADF 如何使用不同类型的触发器来自动化与调度管道的理解。
示例答案: 在 Azure Data Factory 中,触发器用于根据特定条件或计划自动启动管道执行。主要有三类触发器:
在 Azure Data Factory 中配置滚动时间窗触发器。图片来源:Microsoft。
在 Azure Data Factory 管道中可以使用哪些类型的活动(Activity)?
说明: 此题考察您对 ADF 管道可执行的各类任务的了解。
示例答案: Azure Data Factory 管道支持多种活动类型。以下是最常见的几类:
活动类型
说明
数据移动
使用复制活动(Copy Activity)在受支持的数据存储之间移动数据(如 Azure Blob 存储、SQL 数据库)。
数据转换
包括用于数据转换逻辑的 Data Flow 活动(基于 Spark)、用于 ETL 操作的 Mapping Data Flows,以及用于数据准备的 Wrangling Data Flows。
控制流
通过 ForEach、If Condition、Switch、Wait、Until 等活动对管道执行进行控制,以实现条件逻辑。
外部执行
执行外部应用或函数,包括 Azure Functions、Web 活动(调用 REST API)以及用于 SQL 的存储过程活动(Stored Procedure Activity)。
自定义活动
通过自定义活动(Custom Activity)在 .NET 或 Azure Batch 服务中执行自定义代码,为高级数据处理需求提供灵活性。
其他服务
支持 HDInsight、Databricks、Data Lake Analytics 等活动,与其他 Azure 分析服务集成以处理复杂数据任务。
您如何监控和调试 Azure Data Factory 管道?
说明: 此题检验您对 ADF 监控与调试工具的熟悉程度。
示例答案:Azure Data Factory 在 Azure 门户的 Monitor(监视)选项卡中提供了强大的监控与调试界面。我可以在此跟踪管道运行、查看活动状态并诊断失败原因。每个活动都会生成日志,可据此定位错误并排查问题。
此外,可以配置 Azure Monitor 基于管道失败或性能问题发送警报。调试时,我通常先查看失败活动的日志,审阅错误详情,修复问题后再重跑管道。
Azure Data Factory 与 Microsoft Fabric 中的 Data Factory 有何不同?
说明: 此题考察您是否紧跟微软数据平台的最新演进。
示例答案: 两者共享相同引擎,但 Fabric 中的 Data Factory 是集成于 Fabric 生态的 SaaS(软件即服务)产品,而 Azure Data Factory(ADF)是 PaaS(平台即服务)资源。主要差异包括:
Azure Data Factory 如何确保数据安全?
说明: 此题评估您对 ADF 在数据全生命周期保护机制方面的了解。
示例答案: Azure Data Factory 通过多种机制确保数据安全。
首先,它对传输与静态数据进行加密,使用 TLS 与 AES 等协议保障数据传输安全。ADF 集成 Azure Active Directory(AAD)进行身份验证,并通过基于角色的访问控制(RBAC)限制可访问与管理工厂的人员。
此外,托管标识(Managed Identities)使 ADF 能在不暴露凭据的情况下安全访问其他 Azure 服务。网络层面,ADF 支持专用终结点(Private Endpoints),确保数据流量留在 Azure 网络内,进一步提升防护。
在 Azure Data Factory 中,链接服务(Linked Service)与数据集(Dataset)有何区别?
说明: 此题考察您对链接服务与数据集在 ADF 中不同角色的理解。
示例答案: 在 Azure Data Factory 中,链接服务用于定义到外部数据源或计算服务的连接,类似于连接字符串,包含连接到资源所需的身份验证信息。
而数据集则表示您将要处理的具体数据,比如数据库中的表或 Blob 存储中的文件。
链接服务定义“数据在哪里”,数据集描述“数据长什么样、如何结构化”。两者配合以实现数据的移动与转换。