
头部玩家确实在押注——他们在建设更多算力,因此明年会通过更强计算来扩展。那么问题是:是否也会有更多数据?这里就更微妙了。我认为这是一个光谱,不是非黑即白。
什么是 Dremel?它如何支撑 BigQuery 的高速查询性能?
提问原因:评估您对 BigQuery 底层查询引擎 Dremel 的了解,以及其基于树形与列式的执行模型如何实现高性能分析。
Dremel 是为 BigQuery 提供动力的分布式查询执行引擎。不同于传统基于行的处理,Dremel 采用列式存储格式与树形查询执行模型来优化速度与效率。
Dremel 如何加速查询:
- 列式存储:只扫描所需列,减少处理数据量。
- 树形执行:将查询拆分为片段并在成千上万节点并行执行,结果以分层树结构聚合,降低时延。
- 无服务器资源分配:按查询复杂度动态分配计算 slot,提高资源利用率。
Dremel 的关键优势:
- 在 PB 级数据集上实现极速查询。
- 通过只扫描相关列来降低处理成本。
- 无需手动调优即可对大型工作负载自动并行化。
您可在Google 官方文档中进一步了解 Dremel。
BigQuery 中的反规范化如何实施?应在何时使用?
提问原因:评估您对数据建模策略及其对分析型数据库查询性能影响的理解。
在 BigQuery 中,反规范化有意引入冗余,通过合并表与复制数据优化查询性能。与通过拆分相关小表来最小化冗余的规范化不同,反规范化减少复杂 JOIN 的需求,从而实现更快的读取。该方法在数据仓库与分析场景尤为适用(读多写少)。但反规范化会增加存储需求,因此 BigQuery 建议使用嵌套与重复字段来高效组织反规范化数据,同时将存储开销降至更低。
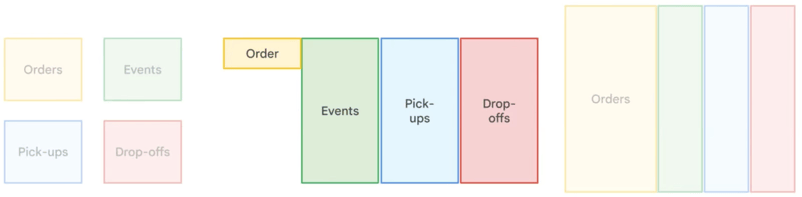
不同数据规范化策略的对比。图片来源 Google Cloud。
SQL 相关问题
当您对 BigQuery 架构与优化技巧有扎实理解后,下一个关键领域就是 SQL 能力。SQL 是使用 BigQuery 的基础,面试官通常会考察您编写、优化与排错查询的能力。为更好准备,建议报名学习 DataCamp 的 SQL 课程。
如何在 BigQuery 中执行 JOIN 操作?
提问原因:评估您使用 SQL JOIN 结合多表数据的能力。
BigQuery 支持多种 JOIN 类型,可基于共享列合并多表数据。例如,要同时获取产品详情与其销量信息,可在 SALES TABLE 与 PRODUCT TABLE 上按 Product_Id 执行 INNER JOIN:
SELECT
s.Id AS Sales_Id,
p.Product,
p.Price,
s.Purchase_date
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id;若需额外信息(如送达日期),可再关联 DELIVERY TABLE:
SELECT
s.Id AS Sales_Id,
p.Product,
p.Price,
s.Purchase_date,
d.Deliver_date
FROM sales_table s
JOIN product_table p ON s.Product_Id = p.Id
JOIN delivery_table d ON s.Id = d.Sales_Id;写一条 SQL 查询找出最贵的前 10 个产品。
提问原因:评估您高效检索与排序数据的能力。
使用 ORDER BY 按价格降序排序,并通过 LIMIT 限制结果:
SELECT
Product,
Price
FROM product_table
ORDER BY Price DESC
LIMIT 10;写一条 SQL 查询计算每月平均销量。
提问原因:评估您进行基于时间的聚合能力。
使用 EXTRACT 将销量按月份分组,并用 COUNT 统计每月销量:
SELECT
EXTRACT(MONTH FROM Purchase_date) AS Month,
COUNT(Id) AS Total_Sales,
AVG(COUNT(Id)) OVER () AS Average_Sales
FROM sales_table
GROUP BY Month;写一条 SQL 查询统计每种产品的总配送次数。
提问原因:评估您使用 GROUP BY 与 COUNT 进行聚合的能力。
按产品统计配送次数:
SELECT
p.Product,
COUNT(d.Id) AS Total_Deliveries
FROM delivery_table d
JOIN product_table p
ON d.Product_Id = p.Id
GROUP BY p.Product;写一条 SQL 查询获取每种产品的总配送次数。
提问原因:评估您筛选基于时间的数据能力。
查询最近 30 天的销量记录:
SELECT *
FROM sales_table
WHERE Purchase_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 30 DAY);写一条 SQL 查询统计上周售出的唯一产品数量。
提问原因:评估您对基于时间的数据进行去重计数的能力。
统计过去 7 天售出的去重产品数:
SELECT COUNT(DISTINCT Product_Id) AS Unique_Products_Sold
FROM sales_table
WHERE Purchase_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY);写一条 SQL 查询按产品分组并计算各产品总营收。
提问原因:考察您使用 GROUP BY 聚合销量的能力。
计算每个产品的总营收:
SELECT
p.Product,
SUM(p.Price) AS Total_Revenue
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;写一条 SQL 查询计算各产品占总销售额的百分比。
提问原因:评估您使用 SQL 计算百分比的能力。
计算各产品的销售额占比:
SELECT
p.Product,
SUM(p.Price) AS Product_Sales,
(SUM(p.Price) / (SELECT SUM(Price) FROM product_table)) * 100 AS Sales_Percentage
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;写一条 SQL 查询按总销量对产品进行排名。
提问原因:评估您使用窗口函数进行排名的能力。
按总销量为产品排名:
SELECT
p.Product,
SUM(p.Price) AS Total_Sales,
RANK() OVER (ORDER BY SUM(p.Price) DESC) AS Sales_Rank
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;写一条 SQL 查询计算每种产品的平均配送时长。
提问原因:评估您处理日期差值的能力。
计算每种产品的平均配送时长:
SELECT
p.Product,
AVG(DATE_DIFF(d.Deliver_date, s.Purchase_date, DAY)) AS Avg_Delivery_Time
FROM sales_table s
JOIN delivery_table d
ON s.Id = d.Sales_Id
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;高级与场景化问题
除基础知识与 SQL 能力外,解决实际问题的能力是大规模使用 BigQuery 的关键。
高级面试题通常聚焦于处理海量数据、优化性能、管理数据管道,以及在生产环境中排查常见问题。
请描述您在 BigQuery 中实现数据管道的经验。
提问原因:评估您在 BigQuery 中构建、管理与优化数据管道(接入、转换、编排与监控)的实操经验。
面试官希望了解您在设计与实施数据管道方面的实战经验。您可围绕以下方面展开:
- 数据接入:采用的方法(BigQuery 数据传输服务、Cloud Storage、流式摄取)。
- 数据转换:使用基于 SQL 的转换、定时查询,或 Dataflow、dbt 等工具。
- 编排:如何使用Cloud Composer(Apache Airflow)、Cloud Functions 或 Cloud Scheduler管理管道工作流。
- 监控与优化:如何跟踪管道性能、排障并优化查询成本。
有说服力的回答应包含真实案例,如如何处理海量数据、优化查询性能,或确保生产管道中的数据完整性。
实现此类项目的优质资源包括:
- 以下 YouTube 指南:基于 BigQuery 的 ETL 批处理管道。
- 这个端到端管道的 GitHub 仓库。
- 使用 Airflow 与 BigQuery 的 ETL 管道 GitHub 仓库。
如何在不更改表名的情况下,去除大表某一列的重复记录?
提问原因:评估您在不改变表结构前提下高效处理重复数据的能力。
当表包含数百万行、某列存在重复值时,可使用 ROW_NUMBER() 窗口函数标识重复记录,仅保留每组的第一条,其余删除。
可通过 CREATE OR REPLACE TABLE 将去重结果覆盖原表:
CREATE OR REPLACE TABLE tableX AS
SELECT * EXCEPT(row_number)
FROM (
SELECT *,
ROW_NUMBER() OVER (PARTITION BY troubleColumn ORDER BY someOtherColumn) AS row_number
FROM tableX
)
WHERE row_number = 1;工作原理如下:
-
ROW_NUMBER()为相同troubleColumn值内的记录编号,确保每组仅保留一条。 -
通过
PARTITION BYtroubleColumn按重复列分组。 -
通过
ORDER BYsomeOtherColumn(如Purchase_date)确定保留的记录。 -
外层查询仅保留首条记录(
row_number = 1),实现去重。 -
使用
CREATE OR REPLACE TABLE可在保持表名不变的前提下替换为清洗后的数据。
该方法无需新建表,也不影响整体表结构,即可高效去重。
如何将 BigQuery 用于数据可视化与报表?常用工具有哪些?
提问原因:评估您将 BigQuery 与可视化工具集成并通过报表有效传达洞察的能力。
BigQuery 是强大的可视化与报表后端,可与 Google Looker Studio(原 Data Studio)、Tableau、Power BI 等工具直接连接。
这些工具支持实时查询并创建自定义仪表板、图表与报告,无需手动导出数据。常见可视化技巧包括:
- 在 BigQuery 中先行聚合与转换,再进行可视化。
- 构建交互式仪表板,支持动态筛选与下钻。
- 优化查询与物化视图,提高仪表板性能。
有力的回答应突出真实业务用例,例如:
- 追踪商业 KPI
- 监控趋势
- 生成自动化报告
要实现您自己的数据可视化项目,可参考 DataCamp 关于使用 BigQuery 的专题项目: 分析电动汽车充电习惯 与 探索伦敦交通网络。
BigQuery 最佳实践与优化相关问题
高效使用 BigQuery 不仅在于编写 SQL,还需要优化性能、管理成本,并落实最佳实践以保障数据运维顺畅。由于 BigQuery 采用按使用量计费模型,理解如何减少数据扫描、用好分区与聚类,以及优化查询执行,对性能与成本效率都至关重要。
如何高效管理 BigQuery 成本?
提问原因:评估您在大数据量场景下优化 BigQuery 成本的能力。
有效管理成本的做法包括:
-
优化查询,仅扫描必要的列与行,避免
SELECT *。 -
使用分区与聚类表,以最小化数据扫描、提高查询性能。
-
利用成本监控工具,如预算、告警与成本控制策略。
-
利用 slot 预留获得更可预测的价格与节省。
-
定期清理未使用的表与分区,优化存储成本。
良好的成本管理策略可在控制支出的同时维持高效查询。
如何优化 BigQuery 查询性能?
提问原因:评估您编写高效、低时延低成本查询的能力。
优化查询性能的做法包括:
-
设计高效的模式,合理选择数据类型,避免过度规范化。
-
使用分区与聚类以减少扫描数据量。
-
避免
SELECT *,仅返回所需列。 -
优化 JOIN 与 GROUP BY 操作,遵循大规模查询最佳实践。
-
利用缓存与物化视图存储预计算结果,提升性能。
-
在可接受误差的场景使用近似聚合函数,如
APPROX_COUNT_DISTINCT。
遵循上述实践可加速查询、降低计算成本并提升整体效率。
什么是 BigQuery 的 slot?它如何影响查询性能?
提问原因:评估您对 BigQuery 计算资源及其对查询执行影响的理解。
BigQuery 的slot是处理 SQL 查询的计算能力单元,会根据工作负载动态分配以提升资源利用率。组织可在以下模式中选择:
- 按需 slot:根据查询需求自动伸缩。
- 预留 slot:适合稳定工作负载,性能更可预测且可节省成本。
合理的 slot 管理可缩短执行时间、优化资源分配并降低总体成本。
如何有效监控与优化 BigQuery 成本?
提问原因:评估您跟踪与控制 BigQuery 开支的能力。
监控与优化成本的方法包括:
- 分析查询执行,利用查询历史与 EXPLAIN 识别高成本操作。
- 启用审计日志,跟踪使用模式并发现低效查询。
- 设置预算与成本告警,防止意外支出。
- 优化 slot 使用,对稳定工作负载采用预留以降本。
- 定期清理未使用的表与分区,避免不必要的存储费用。
通过这些策略,您可在保持性能与可扩展性的同时,实现成本高效的数据处理。
拿下 BigQuery 面试的额外建议
以下是即将到来的 BigQuery 面试的一些最后建议。
夯实基础。通过我们的BigQuery 入门课程理解 BigQuery 的无服务器设计、存算分离与 Dremel 查询引擎。掌握数据集、表、视图与物化视图,以高效管理与组织数据。我们的SQL 物化视图教程将助您一臂之力。
打磨 SQL 与查询优化技能。通过我们的 BigQuery 入门代码演练练习 BigQuery 特有的 SQL 函数(ARRAY、STRUCT、窗口函数)来解决复杂查询。按照Google 官方文档,利用分区、聚类与近似函数优化查询以降本增效。
获取实战经验。利用公共数据集完成真实项目,并通过 Looker Studio、Tableau 或 Power BI 构建报告。尝试我们的 分析电动汽车充电习惯 与 探索伦敦交通网络 项目,全面提升您的 SQL 技能。

Josep 是一名专注于欧洲项目的自由职业数据科学家,擅长数据存储、处理、高级分析,以及具有影响力的数据叙事。
作为一名教育者,他在纳瓦拉大学硕士项目教授大数据课程,并在 Medium、KDNuggets 和 DataCamp 等平台发表文章分享见解。Josep 还在其通讯 Databites(databites.tech)撰写有关数据与技术的内容。
他拥有加泰罗尼亚理工大学工程物理学学士学位,以及庞培法布拉大学智能交互系统硕士学位。
FAQs
什么是 BigQuery?它与传统数据库有何不同?
BigQuery 是 Google Cloud 上的全托管、无服务器数据仓库,专为大规模数据分析而设计。不同于通常为行式且受硬件限制的本地关系型数据库,BigQuery 是云原生列式存储系统,具备近乎无限的可扩展性。其分布式架构与按需计费模式,使其在处理分析型工作负载方面比传统数据库更高效。
使用 BigQuery 的关键优势有哪些?
BigQuery 的五大优势:(1)可扩展性——可自动上下扩展资源;(2)灵活性——基础设施可随业务需求调整;(3)高安全性——内置加密与访问控制;(4)成本效益——按需计费;(5)数据共享与协作——云端方案支持团队间无缝访问。
什么是 BigQuery 的分区?它如何提升性能?
BigQuery 的分区是将大型表按日期、摄取时间或数值等规则划分为更小、易管理的片段。查询时仅扫描相关分区而非整表,从而降低查询成本并缩短执行时间。该功能对时序分析与大数据集尤为有益。
BigQuery 中的表与视图有何区别?
表是物理存储数据的结构,视图是基于预定义 SQL 动态检索数据的虚拟表。视图有助于简化复杂查询、实施数据访问控制,并在不复制数据的情况下改善查询执行。
BigQuery 如何保障数据安全?
BigQuery 采用多层安全机制:(1)静态与传输中加密;(2)IAM 实现细粒度访问控制;(3)审计日志用于监控与合规;(4)支持客户管理的加密密钥以增强控制力。
随着云服务的普及,数据仓库技术正向更高可扩展性和更低成本的方向整合演进。Google Cloud Platform 的数据仓库 BigQuery 就是最常用的解决方案之一。
Stack Overflow 2024 调查显示其受欢迎程度持续上升,全球云用户采用率已达 24.1%。各行业对 BigQuery 专业能力的需求显著增长,掌握其基础知识已成为数据从业者的必备技能。
本文整理了常见的 BigQuery 面试题,帮助您提前备战。如果您刚开始学习 BigQuery,建议先阅读这份GCP 数据仓库入门指南。
BigQuery 基础面试题
在深入复杂主题前掌握 BigQuery 基础至关重要。这些问题会考察您对其核心概念、架构与功能的理解。如果您无法回答下列问题,建议从头开始,先阅读BigQuery 新手指南并选修我们的BigQuery 入门课程。
什么是 BigQuery?它与传统数据库有何不同?
提问原因:评估您对现代数据仓库及其相较传统数据库优势的理解。
BigQuery 是 Google Cloud 上的全托管、无服务器数据仓库,专为大规模数据分析而设计。它支持在海量数据集上执行高速 SQL 查询,无需管理底层基础设施,使用户能够专注于洞察而非维护。
与传统本地关系型数据库(通常为行式存储且受限于硬件)不同,BigQuery 是云原生的列式存储系统,具备近乎无限的可扩展性。其分布式架构与按需计费模式,使其在处理分析型工作负载方面比传统数据库更高效。
BigQuery 中的数据集是什么?
提问原因:考察您对 BigQuery 数据组织与结构的了解。
在 BigQuery 中,数据集是组织表、视图及其他资源的最上层容器,为访问控制与数据定位提供基础。通过高效的数据结构化,数据集可提升查询性能与访问管理,是 BigQuery 架构的基本单元。
如何将数据加载到 BigQuery?
提问原因:考察您对不同数据接入方式的了解。
BigQuery 提供多种面向不同场景的数据接入方式。
对于高级 ETL 工作流,Google Cloud Dataflow及其他管道工具可实现数据与 BigQuery 的无缝对接。选择最适合的接入方式需综合考虑数据量、时延与处理需求。
BigQuery 支持哪些数据类型?
提问原因:考察您对 BigQuery 数据处理能力的了解。
BigQuery 支持多种数据类型,主要分为:
每种数据类型都有定义的逻辑存储大小,会影响查询性能与成本。例如,STRING 的存储取决于 UTF-8 编码长度,而 ARRAY<INT64> 每个元素需要 8 字节。理解这些类型有助于优化查询并高效控制成本。
下表展示了所有支持的数据类型。
BigQuery 数据类型。图片来源: Google Cloud 文档。
使用 BigQuery 的关键优势有哪些?
提问原因:确认您理解将 BigQuery 用作数据仓库的主要利好。
相比传统自管方案,使用 BigQuery 主要有五大优势:
BigQuery 优势。作者制图。
BigQuery 技术面试题
在掌握 BigQuery 基础之后,您需要进一步了解面试常考的技术要点。
这些问题超越基础定义,考察您在性能优化、成本治理,以及分区、聚类、安全等高级功能上的实践能力。
什么是 BigQuery 的分区?它如何提升性能?
提问原因:评估您对数据组织技术及其对查询效率影响的理解。
BigQuery 的分区是指基于某一准则(如日期、摄取时间或整数值)将大型表拆分为更小、可管理的片段。数据被划分为分区后,BigQuery 可在查询时限定扫描的数据量,从而显著提升性能并降低成本。
例如,按天分区的交易表可在查询时高效过滤指定日期范围,无需扫描整表。分区对时序分析与大规模分析型工作负载尤为有利。
什么是 BigQuery 的聚类?它如何提升查询性能?
提问原因:评估您对优化查询效率与成本的数据组织策略的理解。
聚类是指在分区内依据一个或多个指定列的值对数据进行组织。通过将相关行聚集,BigQuery 能减少扫描数据量,从而提升查询性能并降低处理成本。
在基于聚类列进行过滤、排序或聚合时尤为高效,查询引擎可跳过无关数据而非对整个分区全表扫描。聚类与分区结合使用效果最佳,处理大型数据集时优势更明显。
BigQuery 中的表与视图有何区别?
提问原因:评估您对 BigQuery 数据结构及其使用场景的理解。
在 BigQuery 中,表是物理存储数据的结构化单元;视图是基于预定义 SQL 查询动态检索数据的虚拟表。关键区别在于视图自身不存储数据,它可作为构建大型查询的模块,或用于基于数据子集实施访问控制避免重复数据。视图还能在无需重载或重组表的情况下复用数据,从而加速分析、实现数据抽象和强化安全策略。
简而言之:
BigQuery 如何保障数据安全?
提问原因:了解您对 BigQuery 安全机制与敏感数据保护的掌握情况。
BigQuery 采用分层安全策略,从数据全生命周期的各个层面进行防护。
这些内置安全特性有助于组织维护数据机密性、完整性与合规性。
什么是 BigQuery 数据传输服务?它如何简化数据接入?
提问原因:评估您对 BigQuery 内部自动化数据迁移与集成的理解。
BigQuery Data Transfer Service(BQ DTS)可自动、定时将各类外部数据源导入 BigQuery,免去手工 ETL 操作。它原生集成Google 服务(如 Google Ads、YouTube、Google Cloud Storage)及第三方 SaaS 应用。
通过自动化、定时的数据传输,BQ DTS 确保数据无需人工干预即可保持分析时的新鲜度。对于需要大规模管理周期性数据接入工作流的组织尤为实用,可提升效率并降低运维开销。
什么是 BigQuery 的嵌套与重复字段?它们为何有用?
提问原因:评估您对 BigQuery 对半结构化数据支持及其相对传统关系模型优势的理解。
BigQuery 支持嵌套与重复字段,从而高效存储与查询层级或数组型数据。嵌套字段使用STRUCT 数据类型,使单列可包含子字段,类似 JSON 对象。
重复字段相当于ARRAYS,允许单列存储多个值。这些结构有助于减少复杂 JOIN 的需求,提升查询性能,使 BigQuery 非常适合处理半结构化数据,如日志、事件流以及类 NoSQL 数据集。
如何在 BigQuery 中调度与自动化作业?
提问原因:评估您在 BigQuery 中自动化执行查询与管理工作流的能力。
BigQuery 提供多种方式来调度与自动化作业,确保周期性任务无需人工干预即可运行。
这些自动化工具有助于简化数据管道、降低人工工作量,并确保分析与报表的及时处理。
Big Query 如何进行数据分区与聚类?
提问原因:评估您对 BigQuery 数据组织策略的理解,以及其对查询性能与成本效率的影响。
分区将大型表拆分为更小的片段,通过仅扫描相关数据来提升查询性能。
基于时间:按 DATE、TIMESTAMP、DATETIME(如每日 sales_date 分区)。
整数范围:按 INTEGER 值(如
user_id范围)。摄取时间:按数据加载时间戳(
_PARTITIONDATE)。最适用于时序数据,并在按日期或数值范围过滤时降低查询成本。
聚类在表或分区内部按选定列排序组织数据,加速查询。
最适合按高频查询字段(如region 或
user_id)进行过滤与聚合。表聚类与分区示例。图片来源 Google Cloud。
BigQuery 架构面试题
Google BigQuery 的架构是如何设计的?它的独特之处是什么?
提问原因:评估您对 BigQuery 无服务器架构及其与传统数据仓库差异的理解。
BigQuery 具备无服务器、全托管架构,将存储与计算解耦,可根据需求独立伸缩。不同于传统云数据仓库或本地大规模并行处理(MPP)系统,这种分离带来灵活性、成本效率与高可用性,且无需用户管理基础设施。BigQuery 的计算引擎由Dremel提供支撑(多租户集群,高效执行 SQL 查询);数据存储于Colossus(Google 的全球分布式存储系统)。两者通过Jupiter(Google 的 Pb 级网络)进行通信,确保超高速数据传输。整个系统由Borg(Google 内部集群管理系统,Kubernetes 前身)编排。该架构使用户无需关注基础设施管理,即可在海量数据集上执行高性能、可扩展的分析。
Big Query 架构。图片来源:Google。
BigQuery 如何实现存储与计算分离?这有何益处?
提问原因:评估您对 BigQuery 架构中存算解耦模型如何提升可扩展性、成本效率与性能的理解。
BigQuery 采用无服务器、全托管架构,完全分离存储与计算:
存算分离的关键收益:
这一设计使 BigQuery 能以低成本高效处理 PB 级查询,是云端分析的理想之选。
随着行业重心转向更强计算能力,这种架构灵活性尤为关键。正如 DataFramed 播客在 2025 年数据趋势中所提到的: