
निश्चित रूप से सभी बड़े खिलाड़ी एक दांव लगा रहे हैं। वे अधिक कंप्यूट बना रहे हैं, और इसलिए वे अगले साल अधिक कंप्यूट के माध्यम से स्केल करेंगे। और फिर सवाल आता है, ठीक है, क्या अधिक डेटा है? और यहीं बात अधिक सूक्ष्म हो जाती है। और मुझे लगता है कि यह एक स्पेक्ट्रम है। यह श्वेत-श्याम नहीं है।
Dremel क्या है, और यह BigQuery के तेज़ क्वेरी प्रदर्शन को कैसे सक्षम करता है?
क्यों पूछा जाता है: Dremel, BigQuery के अंतर्निहित क्वेरी इंजन, के बारे में आपकी जानकारी का मूल्यांकन करने के लिए, और यह कि इसका ट्री-आधारित, कॉलमनर निष्पादन मॉडल उच्च-प्रदर्शन डेटा एनालिटिक्स कैसे सक्षम करता है।
Dremel एक डिस्ट्रीब्यूटेड क्वेरी निष्पादन इंजन है जो BigQuery को शक्ति देता है। पारंपरिक डेटाबेस जो रो-आधारित प्रोसेसिंग का उपयोग करते हैं, उनसे अलग, Dremel स्पीड और दक्षता को ऑप्टिमाइज़ करने के लिए कॉलमनर स्टोरेज फ़ॉर्मेट और ट्री-आधारित क्वेरी निष्पादन मॉडल अपनाता है।
Dremel तेज़ क्वेरी कैसे सक्षम करता है:
- कॉलमनर स्टोरेज: पूरी पंक्तियाँ पढ़ने के बजाय, Dremel केवल आवश्यक कॉलम स्कैन करता है, जिससे प्रोसेस किए गए डेटा की मात्रा कम होती है।
- ट्री-आधारित निष्पादन: क्वेरीज़ को टुकड़ों में विभाजित किया जाता है और हजारों नोड्स पर समानांतर में निष्पादित किया जाता है। परिणामों को एक पदानुक्रमित ट्री संरचना में एकत्रित किया जाता है, जिससे लेटेंसी कम होती है।
- सर्वरलेस संसाधन आवंटन: Dremel क्वेरी की जटिलता के आधार पर कंप्यूट स्लॉट्स को डायनेमिक रूप से असाइन करता है, जिससे संसाधनों का कुशल उपयोग सुनिश्चित होता है।
Dremel के प्रमुख लाभ:
- पेटाबाइट-स्केल डेटासेट्स पर अत्यंत तेज़ क्वेरीज़।
- केवल प्रासंगिक कॉलम स्कैन करके किफ़ायती प्रोसेसिंग।
- बिना मैन्युअल ट्यूनिंग के बड़े वर्कलोड्स के लिए स्वचालित पैरेललाइज़ेशन।
आप Dremel के बारे में और अधिक Google के आधिकारिक दस्तावेज़ में जान सकते हैं।
BigQuery में डीनॉर्मलाइज़ेशन कैसे काम करता है, और इसे कब उपयोग करना चाहिए?
क्यों पूछा जाता है: डेटा मॉडलिंग रणनीतियों और विश्लेषणात्मक डेटाबेस में उनके क्वेरी प्रदर्शन पर प्रभाव की आपकी समझ का मूल्यांकन करने के लिए।
BigQuery में डीनॉर्मलाइज़ेशन जानबूझकर पुनरावृत्ति जोड़ता है—टेबल्स को मर्ज करके और डेटा डुप्लिकेट करके—ताकि क्वेरी प्रदर्शन ऑप्टिमाइज़ हो। नॉर्मलाइज़ेशन, जो छोटे, संबंधित टेबल्स के माध्यम से पुनरावृत्ति कम करता है, के विपरीत, डीनॉर्मलाइज़ेशन जटिल जोइन्स की आवश्यकता घटाता है, जिसके परिणामस्वरूप तेज़ रीड टाइम मिलते हैं। यह तरीका विशेष रूप से डेटा वेयरहाउसिंग और एनालिटिक्स में उपयोगी है, जहाँ राइट्स की तुलना में रीड ऑपरेशंस अधिक होते हैं। हालांकि, डीनॉर्मलाइज़ेशन स्टोरेज आवश्यकताओं को बढ़ाता है, इसलिए BigQuery नेस्टेड और रिपीटेड फ़ील्ड्स के उपयोग की सिफारिश करता है ताकि डीनॉर्मलाइज़्ड डेटा को कुशलतापूर्वक संरचित किया जा सके और स्टोरेज ओवरहेड न्यूनतम रहे।
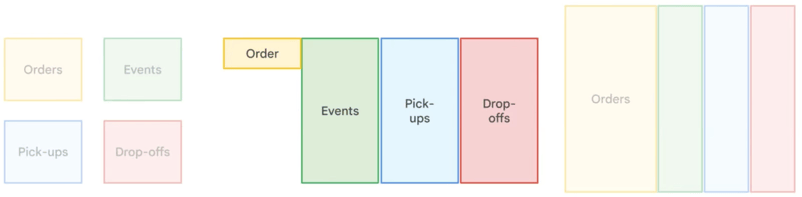
विभिन्न डेटा नॉर्मलाइज़ेशन रणनीतियों की तुलना। चित्र Google Cloud द्वारा।
SQL-विशेष प्रश्न
जब आपको BigQuery के आर्किटेक्चर और ऑप्टिमाइज़ेशन तकनीकों की अच्छी समझ हो जाती है, तो अगला महत्वपूर्ण क्षेत्र है SQL में दक्षता। BigQuery के साथ काम करने की रीढ़ SQL है, और इंटरव्यूअर अक्सर आपकी क्वेरी लिखने, ऑप्टिमाइज़ करने और ट्रबलशूट करने की क्षमता की जाँच करेंगे। बेहतर तैयारी के लिए, मैं आपको DataCamp के SQL कोर्स में नामांकन करने के लिए प्रोत्साहित करता हूँ।
आप BigQuery में JOIN ऑपरेशन कैसे करते हैं?
क्यों पूछा जाता है: एक से अधिक टेबल्स से डेटा को SQL JOIN ऑपरेशंस के माध्यम से संयोजित करने की आपकी क्षमता का आकलन करने के लिए।
BigQuery साझा कॉलम के आधार पर कई प्रकार के JOIN सपोर्ट करता है। उदाहरण के लिए, प्रोडक्ट विवरण उनके सेल्स इन्फॉर्मेशन के साथ प्राप्त करने के लिए, आप SALES TABLE और PRODUCT TABLE के बीच Product_Id पर INNER JOIN कर सकते हैं:
SELECT
s.Id AS Sales_Id,
p.Product,
p.Price,
s.Purchase_date
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id;अतिरिक्त विवरण, जैसे डिलीवरी तारीखें, पाने के लिए आप DELIVERY TABLE को जॉइन कर सकते हैं:
SELECT
s.Id AS Sales_Id,
p.Product,
p.Price,
s.Purchase_date,
d.Deliver_date
FROM sales_table s
JOIN product_table p ON s.Product_Id = p.Id
JOIN delivery_table d ON s.Id = d.Sales_Id;सबसे महंगे 10 प्रोडक्ट्स चुनने के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: डेटा को कुशलता से पुनर्प्राप्त और सॉर्ट करने की आपकी क्षमता का आकलन करने के लिए।
सबसे महंगे 10 प्रोडक्ट्स खोजने के लिए, ORDER BY का उपयोग करके कीमत को अवरोही क्रम में सॉर्ट करें और LIMIT से परिणाम सीमित करें:
SELECT
Product,
Price
FROM product_table
ORDER BY Price DESC
LIMIT 10;प्रति माह औसत बिक्री संख्या की गणना के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: समय-आधारित एग्रीगेशंस करने की आपकी क्षमता का मूल्यांकन करने के लिए।
प्रति माह औसत बिक्री संख्या निकालने के लिए EXTRACT फ़ंक्शन से बिक्री को महीने के आधार पर समूहित करें और COUNT से प्रति माह बिक्री की गणना करें:
SELECT
EXTRACT(MONTH FROM Purchase_date) AS Month,
COUNT(Id) AS Total_Sales,
AVG(COUNT(Id)) OVER () AS Average_Sales
FROM sales_table
GROUP BY Month;प्रोडक्ट के अनुसार कुल डिलीवरी की संख्या खोजने के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: GROUP BY और COUNT का उपयोग करके डेटा एग्रीगेट करने की आपकी क्षमता का आकलन करने के लिए।
प्रत्येक प्रोडक्ट के लिए डिलीवरी गिनने हेतु:
SELECT
p.Product,
COUNT(d.Id) AS Total_Deliveries
FROM delivery_table d
JOIN product_table p
ON d.Product_Id = p.Id
GROUP BY p.Product;प्रत्येक प्रोडक्ट के लिए कुल डिलीवरी की संख्या खोजने के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: समय-आधारित डेटा को फ़िल्टर करने की आपकी क्षमता का मूल्यांकन करने के लिए।
पिछले 30 दिनों की बिक्री रिकॉर्ड प्राप्त करने के लिए:
SELECT *
FROM sales_table
WHERE Purchase_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 30 DAY);पिछले हफ्ते में बेचे गए यूनिक प्रोडक्ट्स की संख्या गिनने के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: समय-आधारित डेटा पर डिस्टिंक्ट काउंट करने की आपकी क्षमता का आकलन करने के लिए।
पिछले 7 दिनों में बेचे गए डिस्टिंक्ट प्रोडक्ट्स गिनने के लिए:
SELECT COUNT(DISTINCT Product_Id) AS Unique_Products_Sold
FROM sales_table
WHERE Purchase_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY);प्रोडक्ट के अनुसार बिक्री डेटा को समूहित करें और प्रत्येक के लिए कुल राजस्व की गणना करने के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: GROUP BY का उपयोग और बिक्री का एग्रीगेशन करने की आपकी क्षमता का परीक्षण करने के लिए।
प्रति प्रोडक्ट कुल राजस्व की गणना करने के लिए:
SELECT
p.Product,
SUM(p.Price) AS Total_Revenue
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;प्रत्येक प्रोडक्ट द्वारा कुल बिक्री में योगदान का प्रतिशत निकालने के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: SQL का उपयोग करके प्रतिशत निकालने की आपकी क्षमता का मूल्यांकन करने के लिए।
प्रति प्रोडक्ट कुल बिक्री का प्रतिशत निर्धारित करने के लिए:
SELECT
p.Product,
SUM(p.Price) AS Product_Sales,
(SUM(p.Price) / (SELECT SUM(Price) FROM product_table)) * 100 AS Sales_Percentage
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;कुल बिक्री के आधार पर प्रोडक्ट्स को रैंक करने के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: रैंकिंग के लिए विंडो फ़ंक्शंस का उपयोग करने की आपकी क्षमता का आकलन करने के लिए।
कुल बिक्री के आधार पर प्रोडक्ट्स को रैंक करने के लिए:
SELECT
p.Product,
SUM(p.Price) AS Total_Sales,
RANK() OVER (ORDER BY SUM(p.Price) DESC) AS Sales_Rank
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;प्रत्येक प्रोडक्ट के लिए औसत डिलीवरी समय की गणना करने के लिए SQL क्वेरी लिखें।
क्यों पूछा जाता है: SQL में दिनांतरों के साथ काम करने की आपकी क्षमता का मूल्यांकन करने के लिए।
प्रति प्रोडक्ट औसत डिलीवरी समय निकालने के लिए:
SELECT
p.Product,
AVG(DATE_DIFF(d.Deliver_date, s.Purchase_date, DAY)) AS Avg_Delivery_Time
FROM sales_table s
JOIN delivery_table d
ON s.Id = d.Sales_Id
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;एडवांस्ड और परिदृश्य-आधारित प्रश्न
बुनियादी ज्ञान और SQL दक्षता से परे, वास्तविक दुनिया की समस्या-समाधान कौशल BigQuery पर बड़े पैमाने पर काम करने के लिए महत्वपूर्ण हैं।
एडवांस्ड इंटरव्यू प्रश्न अक्सर बड़े डेटासेट हैंडलिंग, प्रदर्शन ऑप्टिमाइज़ेशन, डेटा पाइपलाइन प्रबंधन, और प्रोडक्शन वातावरण में सामान्य चुनौतियों के ट्रबलशूटिंग पर केंद्रित होते हैं।
क्या आप BigQuery में डेटा पाइपलाइंस लागू करने के अपने अनुभव का वर्णन कर सकते हैं?
क्यों पूछा जाता है: BigQuery में डेटा पाइपलाइंस बनाने, प्रबंधित करने और ऑप्टिमाइज़ करने (इन्गेशन, ट्रांसफॉर्मेशन, ऑर्केस्ट्रेशन और मॉनिटरिंग सहित) के आपके व्यावहारिक ज्ञान का मूल्यांकन करने के लिए।
इंटरव्यूअर आपके डेटा पाइपलाइंस डिज़ाइन और इम्प्लीमेंट करने के व्यावहारिक अनुभव की झलक ढूँढ रहा है। आपको निम्न पर चर्चा करनी चाहिए:
- डेटा इन्गेशन: उपयोग की गई विधियाँ (BigQuery Data Transfer Service, Cloud Storage, स्ट्रीमिंग इन्गेशन)।
- डेटा ट्रांसफॉर्मेशन: SQL-आधारित ट्रांसफॉर्मेशन, शेड्यूल्ड क्वेरीज़, या Dataflow और dbt जैसे टूल्स का उपयोग।
- ऑर्केस्ट्रेशन: आप Cloud Composer (Apache Airflow), Cloud Functions, या Cloud Scheduler का उपयोग करके पाइपलाइन वर्कफ़्लो कैसे प्रबंधित करते हैं।
- मॉनिटरिंग और ऑप्टिमाइज़ेशन: आप पाइपलाइन प्रदर्शन को कैसे ट्रैक करते हैं, समस्याओं को कैसे डीबग करते हैं, और क्वेरी लागतों को कैसे ऑप्टिमाइज़ करते हैं।
एक सशक्त उत्तर में वास्तविक-world उदाहरण शामिल होने चाहिए—जैसे बड़े डेटासेट्स को संभालना, क्वेरी प्रदर्शन ऑप्टिमाइज़ करना, या प्रोडक्शन पाइपलाइनों में डेटा अखंडता सुनिश्चित करना—और आपने उन्हें कैसे सुलझाया।
ऐसा प्रोजेक्ट लागू करने के लिए कुछ अच्छे संसाधन हैं:
- निम्न YouTube गाइड: BigQuery का उपयोग करके ETL बैच पाइपलाइंस।
- एंड-टू-एंड पाइपलाइन का यह GitHub रेपो।
- Airflow और BigQuery के साथ यह ETL पाइपलाइन GitHub रेपो।
आप किसी बड़े BigQuery टेबल में किसी कॉलम से डुप्लीकेट रिकॉर्ड्स को टेबल का नाम यथावत रखते हुए कैसे हटाएँगे?
क्यों पूछा जाता है: टेबल संरचना बदले बिना BigQuery में डुप्लीकेट डेटा को कुशलतापूर्वक संभालने की आपकी क्षमता का आकलन करने के लिए।
जब किसी टेबल में लाखों पंक्तियाँ हों और किसी विशेष कॉलम में डुप्लीकेट वैल्यूज़ हों, तो सबसे अच्छा तरीका है ROW_NUMBER() विंडो फ़ंक्शन का उपयोग करके डुप्लीकेट्स की पहचान करना और प्रत्येक डुप्लीकेट समूह की केवल पहली एंट्री को रखना।
आप CREATE OR REPLACE TABLE स्टेटमेंट के साथ डी-डुप्लीकेटेड वर्ज़न से टेबल को ओवरराइट करके यह कर सकते हैं:
CREATE OR REPLACE TABLE tableX AS
SELECT * EXCEPT(row_number)
FROM (
SELECT *,
ROW_NUMBER() OVER (PARTITION BY troubleColumn ORDER BY someOtherColumn) AS row_number
FROM tableX
)
WHERE row_number = 1;यह ऐसे काम करता है:
-
ROW_NUMBER()प्रत्येक समानtroubleColumnमान के भीतर हर रिकॉर्ड को एक यूनिक क्रमांक देता है, जिससे प्रति डुप्लीकेट समूह केवल एक रिकॉर्ड रखा जाता है। -
PARTITION BYtroubleColumnउस कॉलम में डुप्लीकेट्स के आधार पर पंक्तियों को समूहित करता है। -
ORDER BYsomeOtherColumn(उदा.,Purchase_date) यह सुनिश्चित करता है कि कोई विशिष्ट रिकॉर्ड रखा जाए। -
बाहरी क्वेरी केवल पहली उपस्थिति को फ़िल्टर करती है (
row_number = 1), जिससे डुप्लीकेट प्रभावी रूप से हट जाते हैं। -
CREATE OR REPLACE TABLEस्टेटमेंट यह सुनिश्चित करता है कि टेबल का नाम वही रहता है, जबकि उसे क्लीन डेटा से बदला जाता है।
यह तरीका बिना नई टेबल बनाए या टेबल संरचना को प्रभावित किए डुप्लीकेट्स को कुशलतापूर्वक समाप्त कर देता है।
आप डेटा विज़ुअलाइज़ेशन और रिपोर्टिंग के लिए BigQuery का उपयोग कैसे करते हैं, और इसके लिए सबसे सामान्य टूल्स कौन से हैं?
क्यों पूछा जाता है: BigQuery को विज़ुअलाइज़ेशन टूल्स से इंटीग्रेट करने और रिपोर्टिंग के ज़रिए इनसाइट्स को प्रभावी ढंग से संप्रेषित करने की आपकी क्षमता का आकलन करने के लिए।
BigQuery डेटा विज़ुअलाइज़ेशन और रिपोर्टिंग के लिए एक शक्तिशाली बैकएंड का काम करता है, जो Google Looker Studio (पूर्व में Data Studio), Tableau और Power BI जैसे टूल्स के साथ डायरेक्ट कनेक्शन सक्षम करता है।
ये टूल्स उपयोगकर्ताओं को रियल-टाइम में डेटा क्वेरी करने और बिना मैन्युअल एक्सपोर्ट्स के कस्टम डैशबोर्ड, चार्ट्स और रिपोर्ट्स बनाने देते हैं। विज़ुअलाइज़ेशन के लिए मुख्य तकनीकों में शामिल हैं:
- विज़ुअलाइज़ेशन से पहले BigQuery में SQL का उपयोग कर डेटा को एग्रीगेट और ट्रांसफॉर्म करना।
- इंटरएक्टिव डैशबोर्ड बनाना जिनमें डायनेमिक फ़िल्टर्स और ड्रिल-डाउन क्षमताएँ हों।
- क्वेरीज़ और मैटीरियलाइज़्ड व्यूज़ को ऑप्टिमाइज़ करना ताकि डैशबोर्ड प्रदर्शन बेहतर हो।
एक सशक्त उत्तर में वास्तविक-world उपयोग मामले उजागर होने चाहिए, जैसे:
- व्यावसायिक KPI ट्रैक करना
- ट्रेंड्स की मॉनिटरिंग
- स्वचालित रिपोर्ट जनरेट करना
अपना स्वयं का डेटा विज़ुअलाइज़ेशन प्रोजेक्ट लागू करने के लिए, आप DataCamp के विशेष प्रोजेक्ट्स—BigQuery के साथ Analyzing Electric Vehicle Charging Habits और Exploring London's Travel Network—का अनुसरण कर सकते हैं।
BigQuery बेस्ट प्रैक्टिसेज और ऑप्टिमाइज़ेशन से जुड़े प्रश्न
BigQuery के साथ कुशलतापूर्वक काम करना केवल SQL क्वेरी लिखने से आगे की बात है—इसमें प्रदर्शन को ऑप्टिमाइज़ करना, लागत प्रबंधन, और सुचारू डेटा संचालन के लिए बेस्ट प्रैक्टिसेज लागू करना शामिल है। चूँकि BigQuery पे-पर-यूज़ मॉडल पर काम करता है, इसलिए डेटा स्कैन को न्यूनतम रखना, पार्टिशनिंग और क्लस्टरिंग का लाभ उठाना, और क्वेरी निष्पादन को ऑप्टिमाइज़ करना प्रदर्शन और लागत दक्षता दोनों के लिए महत्वपूर्ण है।
BigQuery लागतों का कुशल प्रबंधन करने के लिए बेस्ट प्रैक्टिसेज क्या हैं?
क्यों पूछा जाता है: BigQuery में बड़े डेटासेट्स के साथ काम करते हुए लागत दक्षता ऑप्टिमाइज़ करने की आपकी क्षमता का मूल्यांकन करने के लिए।
BigQuery लागतों का प्रभावी प्रबंधन करने के लिए आपको:
-
क्वेरीज़ ऑप्टिमाइज़ करनी चाहिए ताकि केवल आवश्यक कॉलम और पंक्तियाँ स्कैन हों,
SELECT *से बचें। -
पार्टिशन्ड और क्लस्टर्ड टेबल्स का उपयोग करें ताकि डेटा स्कैन कम हो और क्वेरी प्रदर्शन बेहतर हो।
-
लागत मॉनिटरिंग टूल्स का लाभ उठाएँ जैसे बजट, अलर्ट्स, और लागत नियंत्रण नीतियाँ Google Cloud में।
-
स्लॉट आरक्षण का लाभ लें अधिक पूर्वानुमानित प्राइसिंग और लागत बचत के लिए।
-
अनुपयोगी टेबल्स और पार्टिशन नियमित रूप से साफ करें ताकि स्टोरेज लागत ऑप्टिमाइज़ हो।
एक सुव्यवस्थित लागत प्रबंधन रणनीति खर्चों को नियंत्रित करने में मदद करती है, जबकि कुशल क्वेरी निष्पादन बनाए रखती है।
BigQuery में क्वेरी प्रदर्शन ऑप्टिमाइज़ करने के लिए बेस्ट प्रैक्टिसेज क्या हैं?
क्यों पूछा जाता है: कम समय और लागत में कुशल क्वेरी लिखने की आपकी क्षमता का आकलन करने के लिए।
BigQuery में क्वेरी प्रदर्शन ऑप्टिमाइज़ करने के लिए:
-
कुशल स्कीमा डिज़ाइन करें, उपयुक्त डेटा टाइप्स चुनें और अत्यधिक नॉर्मलाइज़ेशन से बचें।
-
पार्टिशनिंग और क्लस्टरिंग का उपयोग करें ताकि स्कैन किए जाने वाले डेटा की मात्रा कम हो।
-
SELECT *से बचें, केवल आवश्यक कॉलम्स ही प्राप्त करें। -
JOIN और GROUP BY ऑपरेशंस को ऑप्टिमाइज़ करें, यह सुनिश्चित करते हुए कि वे बड़े पैमाने की क्वेरीज़ के बेस्ट प्रैक्टिसेज़ का पालन करें।
-
कैशिंग और मैटीरियलाइज़्ड व्यूज़ का लाभ उठाएँ ताकि प्रीकंप्यूटेड परिणाम स्टोर कर प्रदर्शन बेहतर हो।
-
एप्रॉक्सिमेट एग्रीगेशन फ़ंक्शंस का उपयोग करें, जैसे
APPROX_COUNT_DISTINCT, जब सटीक परिशुद्धता आवश्यक न हो।
इन प्रथाओं का पालन करके, आप क्वेरीज़ को तेज़ कर सकते हैं, कंप्यूट लागतें घटा सकते हैं, और समग्र दक्षता बढ़ा सकते हैं।
BigQuery स्लॉट्स क्या हैं, और वे क्वेरी प्रदर्शन को कैसे प्रभावित करते हैं?
क्यों पूछा जाता है: BigQuery के कंप्यूट संसाधनों और उनके क्वेरी निष्पादन पर प्रभाव की आपकी समझ का मूल्यांकन करने के लिए।
BigQuery के स्लॉट्स SQL क्वेरीज़ प्रोसेस करने के लिए प्रयुक्त कम्प्यूटेशनल क्षमता की इकाइयाँ हैं। वर्कलोड माँग के आधार पर इन्हें डायनेमिक रूप से आवंटित किया जाता है, जिससे संसाधनों का कुशल उपयोग सुनिश्चित होता है। संगठन निम्न विकल्प चुन सकते हैं:
- ऑन-डिमांड स्लॉट्स, जो क्वेरी आवश्यकताओं के आधार पर स्वतः स्केल होते हैं।
- रिज़र्व्ड स्लॉट्स, जो लगातार वर्कलोड्स के लिए अधिक पूर्वानुमानित प्रदर्शन और लागत बचत प्रदान करते हैं।
स्लॉट्स का कुशल प्रबंधन क्वेरी निष्पादन समय घटा सकता है, संसाधन आवंटन को ऑप्टिमाइज़ कर सकता है, और समग्र लागतें कम कर सकता है।
आप BigQuery लागतों की प्रभावी मॉनिटरिंग और ऑप्टिमाइज़ेशन कैसे कर सकते हैं?
क्यों पूछा जाता है: BigQuery खर्चों को ट्रैक और नियंत्रित करने की आपकी क्षमता का आकलन करने के लिए।
BigQuery में लागत मॉनिटर और ऑप्टिमाइज़ करने के लिए:
- क्वेरी निष्पादन का विश्लेषण करें महंगी ऑपरेशंस की पहचान के लिए क्वेरी हिस्ट्री और EXPLAIN प्लान्स का उपयोग करके।
- ऑडिट लॉग्स सक्षम करें ताकि उपयोग पैटर्न ट्रैक हों और अक्षम क्वेरीज़ का पता चले।
- बजट्स और लागत अलर्ट सेट करें ताकि अप्रत्याशित खर्चे न हों।
- स्लॉट उपयोग ऑप्टिमाइज़ करें, स्थिर वर्कलोड्स के लिए रिज़र्व्ड स्लॉट्स का लाभ लेकर लागत घटाएँ।
- अनुपयोगी टेबल्स और पार्टिशन नियमित रूप से साफ करें ताकि अनावश्यक स्टोरेज फ़ीस से बचा जा सके।
इन रणनीतियों को लागू करके, आप प्रदर्शन और स्केलेबिलिटी बनाए रखते हुए लागत-कुशल डेटा प्रोसेसिंग सुनिश्चित कर सकते हैं।
अपने BigQuery इंटरव्यू में सफल होने के लिए अतिरिक्त सुझाव
यहाँ आपके आगामी BigQuery इंटरव्यू में सफल होने के कुछ अंतिम सुझाव दिए गए हैं।
बुनियाद में महारत हासिल करें। हमारे प्रारंभिक BigQuery कोर्स के साथ BigQuery के आर्किटेक्चर—सर्वरलेस डिज़ाइन, स्टोरेज-कंप्यूट पृथक्करण, और Dremel क्वेरी इंजन—को समझें। डेटा को कुशलतापूर्वक प्रबंधित और स्ट्रक्चर करने के लिए डेटासेट्स, टेबल्स, व्यूज़ और मैटीरियलाइज़्ड व्यूज़ सीखें। हमारा SQL मैटीरियलाइज़्ड व्यू ट्यूटोरियल मदद करेगा।
अपनी SQL और क्वेरी ऑप्टिमाइज़ेशन स्किल्स को धार दें। हमारे Getting Started with BigQuery कोड-अलॉन्ग के साथ जटिल क्वेरीज़ के लिए BigQuery-विशेष SQL फ़ंक्शंस (ARRAYs, STRUCTs, विंडो फ़ंक्शंस) का अभ्यास करें। Google के आधिकारिक दस्तावेज़ का पालन करते हुए लागत घटाने और प्रदर्शन सुधारने के लिए पार्टिशनिंग, क्लस्टरिंग और एप्रॉक्सिमेट फ़ंक्शंस से क्वेरीज़ ऑप्टिमाइज़ करें।
हैंड्स-ऑन अनुभव प्राप्त करें। पब्लिक डेटासेट्स का उपयोग करके वास्तविक-world प्रोजेक्ट्स पर काम करें और DataCamp प्रोजेक्ट्स के साथ Looker Studio, Tableau, या Power BI में रिपोर्ट्स बनाएं। हमारे Analyzing Electric Vehicle Charging Habits और Exploring London's Travel Network आज़माना आपकी SQL स्किल्स सुधारने के बेहतरीन तरीके हैं।

जोसेप यूरोपीय परियोजनाओं में विशेषज्ञता रखने वाले फ्रीलांस डेटा साइंटिस्ट हैं, जिन्हें डेटा स्टोरेज, प्रोसेसिंग, उन्नत एनालिटिक्स, और प्रभावशाली डेटा स्टोरीटेलिंग में महारत है।
एक शिक्षक के रूप में, वे यूनिवर्सिटी ऑफ नवार्रा के मास्टर’s प्रोग्राम में बिग डेटा पढ़ाते हैं और Medium, KDNuggets, तथा DataCamp जैसे प्लेटफ़ॉर्म पर लेखों के माध्यम से अपने विचार साझा करते हैं। जोसेप अपनी न्यूज़लेटर Databites (databites.tech) में भी डेटा और टेक के बारे में लिखते हैं।
उन्होंने पॉलिटेक्निक यूनिवर्सिटी ऑफ कैटालोनिया से इंजीनियरिंग फिजिक्स में बीएस और पॉम्पेऊ फाब्रा यूनिवर्सिटी से इंटेलिजेंट इंटरएक्टिव सिस्टम्स में एमएस किया है।
FAQs
BigQuery क्या है, और यह पारंपरिक डेटाबेस से कैसे अलग है?
BigQuery Google Cloud पर एक पूर्णतः प्रबंधित, सर्वरलेस डेटा वेयरहाउस है, जिसे बड़े पैमाने पर डेटा एनालिटिक्स के लिए डिज़ाइन किया गया है। पारंपरिक ऑन-प्रिमाइसेज़ रिलेशनल डेटाबेस, जो आमतौर पर रो-आधारित होते हैं और हार्डवेयर सीमाओं से बाधित होते हैं, के विपरीत, BigQuery क्लाउड-नेटिव, कॉलमनर स्टोरेज सिस्टम है जो लगभग असीम स्केलेबिलिटी प्रदान करता है। इसका डिस्ट्रीब्यूटेड आर्किटेक्चर और पे-एज़-यू-गो प्राइसिंग मॉडल पारंपरिक डेटाबेस की तुलना में विश्लेषणात्मक वर्कलोड्स को संभालने में अधिक कुशल बनाते हैं।
BigQuery का उपयोग करने के प्रमुख फायदे क्या हैं?
BigQuery पाँच प्रमुख फायदे प्रदान करता है: (1) स्केलेबिलिटी – संसाधन स्वतः ऊपर/नीचे स्केल होते हैं, (2) लचीलापन – इन्फ्रास्ट्रक्चर व्यवसाय की जरूरतों के अनुसार ढलता है, (3) उच्च सुरक्षा – बिल्ट-इन एन्क्रिप्शन और एक्सेस कंट्रोल, (4) किफ़ायती – पे-एज़-यू-गो प्राइसिंग, और (5) डेटा शेयरिंग और सहयोग – क्लाउड-आधारित समाधान टीमों में सहज एक्सेस की अनुमति देते हैं।
BigQuery में पार्टिशनिंग क्या है, और यह प्रदर्शन कैसे बेहतर करती है?
BigQuery में पार्टिशनिंग बड़े टेबल्स को तारीख, इन्गेशन समय, या न्यूमेरिक मानों जैसे मानदंडों के आधार पर छोटे, प्रबंधनीय हिस्सों में विभाजित करती है। इससे पूरे टेबल को स्कैन करने के बजाय केवल प्रासंगिक पार्टिशन स्कैन होते हैं, जिससे क्वेरी प्रदर्शन बेहतर होता है और लागत व निष्पादन समय घटता है। यह टाइम-सीरीज़ विश्लेषण और बड़े डेटासेट्स के लिए विशेष रूप से लाभदायक है।
BigQuery में टेबल और व्यू में क्या अंतर है?
टेबल भौतिक रूप से डेटा स्टोर करती है, जबकि व्यू एक वर्चुअल टेबल है जो प्री-डिफाइंड SQL क्वेरी के आधार पर डेटा को डायनेमिक रूप से पुनर्प्राप्त करती है। व्यूज़ जटिल क्वेरीज़ को सरल बनाने, डेटा एक्सेस नियंत्रण लागू करने, और डेटा को डुप्लिकेट किए बिना क्वेरी निष्पादन समय को सुधारने में मदद करते हैं।
BigQuery डेटा सुरक्षा को कैसे संभालता है?
BigQuery कई परतों वाली सुरक्षा अपनाता है: (1) स्थिर अवस्था और ट्रांजिट दोनों में डेटा एन्क्रिप्शन, (2) सूक्ष्म एक्सेस नियंत्रण के लिए Identity and Access Management (IAM), (3) उपयोग और अनुपालन मॉनिटरिंग के लिए ऑडिट लॉगिंग, और (4) उन्नत सुरक्षा नियंत्रण के लिए कस्टमर-मैनेज्ड एन्क्रिप्शन कीज़।
क्लाउड सेवाओं के प्रसार के साथ हाल ही में डेटा वेयरहाउसिंग तकनीक अधिक स्केलेबल और सस्ती हो गई है। सबसे सामान्य समाधानों में से एक है Google Cloud Platform का डेटा वेयरहाउस BigQuery.
Stack Overflow 2024 सर्वे इसके बढ़ते प्रचलन की पुष्टि करता है, जिसने वैश्विक क्लाउड उपयोगकर्ताओं में 24.1% अपनाने का आँकड़ा हासिल कर लिया है। विभिन्न उद्योगों में BigQuery विशेषज्ञता की मांग में उल्लेखनीय वृद्धि हुई है, जिसके चलते डेटा प्रोफेशनल्स के लिए इसके मूलभूत सिद्धांतों की समझ एक पेशेवर आवश्यकता बन गई है।
इस लेख में, आपको BigQuery से जुड़े कुछ प्रश्नों का संकलन मिलेगा जो इंटरव्यू में अक्सर पूछे जाते हैं, जिससे आप अपनी तैयारी कर सकें। यदि आप BigQuery के बारे में अभी सीखना शुरू कर रहे हैं, तो पहले मैं सुझाव दूंगा कि आप GCP पर डेटा वेयरहाउसिंग पर निम्नलिखित गाइड देखें।
बेसिक BigQuery इंटरव्यू प्रश्न
जटिल विषयों पर जाने से पहले BigQuery की बुनियादी जानकारी होना आवश्यक है। ये प्रश्न आपके मूल सिद्धांतों, आर्किटेक्चर और कार्यक्षमता की समझ का आकलन करते हैं। यदि आप निम्नलिखित प्रश्नों के उत्तर देने में सक्षम नहीं हैं, तो मैं आपको शुरुआत से शुरू करने के लिए Beginner's Guide to BigQuery देखने और हमारे प्रारंभिक BigQuery कोर्स में नामांकन करने की सलाह देता हूँ।
BigQuery क्या है, और यह पारंपरिक डेटाबेस से कैसे अलग है?
क्यों पूछा जाता है: आधुनिक डेटा वेयरहाउस और पारंपरिक डेटाबेस पर उनके लाभों की आपकी समझ को परखने के लिए।
BigQuery Google Cloud पर एक पूर्णतः प्रबंधित, सर्वरलेस डेटा वेयरहाउस है, जिसे बड़े पैमाने पर डेटा एनालिटिक्स के लिए डिज़ाइन किया गया है। यह विशाल डेटासेट्स पर हाई-स्पीड SQL क्वेरी चलाने की सुविधा देता है, जिसमें इन्फ्रास्ट्रक्चर के प्रबंधन की ज़रूरत नहीं पड़ती, और उपयोगकर्ता मेंटेनेंस के बजाय इनसाइट्स पर ध्यान केंद्रित कर सकते हैं।
पारंपरिक ऑन-प्रिमाइसेज़ रिलेशनल डेटाबेस आमतौर पर रो-आधारित होते हैं और हार्डवेयर सीमाओं से बंधे रहते हैं, जबकि BigQuery क्लाउड-नेटिव, कॉलमनर स्टोरेज सिस्टम है जो लगभग असीम स्केलेबिलिटी प्रदान करता है। इसका वितरित आर्किटेक्चर और पे-एज़-यू-गो प्राइसिंग मॉडल विश्लेषणात्मक वर्कलोड्स को संभालने में पारंपरिक डेटाबेस की तुलना में अधिक कुशल बनाते हैं।
BigQuery में डेटासेट क्या होता है?
क्यों पूछा जाता है: डेटा संगठन और BigQuery की संरचना के ज्ञान को परखने के लिए।
BigQuery में डेटासेट को शीर्ष स्तर के कंटेनर के रूप में परिभाषित किया जाता है जो टेबल्स, व्यूज़, और अन्य संसाधनों को व्यवस्थित करता है। यह एक्सेस कंट्रोल और डेटा को लोकेट करने का आधार तय करता है। डेटा को कुशलतापूर्वक संरचित करके, डेटासेट क्वेरी प्रदर्शन और एक्सेस प्रबंधन को बेहतर बनाते हैं, जिससे वे BigQuery की आर्किटेक्चर का एक बुनियादी घटक बनते हैं।
आप BigQuery में डेटा कैसे लोड करते हैं?
क्यों पूछा जाता है: विभिन्न डेटा इन्गेशन विधियों के बारे में आपके ज्ञान की जाँच के लिए।
BigQuery अलग-अलग उद्देश्यों के लिए कई डेटा इन्गेशन विधियाँ प्रदान करता है।
उन्नत ETL वर्कफ़्लो के लिए, Google Cloud Dataflow और अन्य पाइपलाइन टूल्स BigQuery में सहज डेटा मूवमेंट को संभव बनाते हैं। सबसे उपयुक्त इन्गेशन विधि का चयन डेटा वॉल्यूम, लेटेंसी और प्रोसेसिंग आवश्यकताओं पर निर्भर करता है।
BigQuery किन डेटा टाइप्स को सपोर्ट करता है?
क्यों पूछा जाता है: BigQuery की डेटा हैंडलिंग क्षमताओं के बारे में आपके ज्ञान को परखने के लिए।
BigQuery कई प्रकार के डेटा टाइप्स को सपोर्ट करता है, जिन्हें निम्न प्रकारों में वर्गीकृत किया जा सकता है:
प्रत्येक डेटा टाइप की एक परिभाषित लॉजिकल स्टोरेज साइज होती है, जो क्वेरी प्रदर्शन और लागत को प्रभावित करती है। उदाहरण के लिए, STRING की स्टोरेज UTF-8 एन्कोडेड लंबाई पर निर्भर करती है, जबकि ARRAY<INT64> में प्रति एलिमेंट 8 बाइट्स की आवश्यकता होती है। इन टाइप्स की समझ क्वेरी ऑप्टिमाइज़ेशन और लागत प्रबंधन में मदद करती है।
आप सभी समर्थित डेटा टाइप्स को निम्न तालिका में देख सकते हैं।
BigQuery के डेटा टाइप्स। चित्र साभार Google Cloud Documentation.
BigQuery का उपयोग करने के प्रमुख फायदे क्या हैं?
क्यों पूछा जाता है: यह सुनिश्चित करने के लिए कि आप BigQuery को डेटा वेयरहाउस के रूप में उपयोग करने के मुख्य लाभों को समझते हैं।
BigQuery सेवाओं का उपयोग पारंपरिक स्व-प्रबंधित समाधानों पर पाँच प्रमुख लाभ लाता है:
BigQuery के फायदे। चित्र लेखक द्वारा।
तकनीकी BigQuery इंटरव्यू प्रश्न
एक बार जब आप BigQuery की बुनियाद समझ लेते हैं, तो अब उन तकनीकी पहलुओं में गहराई से जाने का समय है जिनका इंटरव्यूअर आमतौर पर आकलन करते हैं।
ये प्रश्न बुनियादी परिभाषाओं से आगे बढ़कर आपके प्रदर्शन को ऑप्टिमाइज़ करने, लागत प्रबंधन करने, और पार्टिशनिंग, क्लस्टरिंग और सुरक्षा जैसी उन्नत सुविधाओं के साथ काम करने की क्षमता की जाँच करते हैं।
BigQuery में पार्टिशनिंग क्या है, और यह प्रदर्शन कैसे बेहतर करती है?
क्यों पूछा जाता है: डेटा संगठन तकनीकों और उनके क्वेरी दक्षता पर प्रभाव के आपके ज्ञान का आकलन करने के लिए।
BigQuery में पार्टिशनिंग बड़े टेबल्स को किसी मानदंड जैसे तारीख, इन्गेशन समय, या पूर्णांकों के मान के आधार पर छोटे-छोटे प्रबंधनीय हिस्सों में विभाजित करने की विधि है। इस तरह डेटा को पार्टिशन में विभाजित करके, BigQuery क्वेरी के दौरान स्कैन किए जाने वाले डेटा की मात्रा को सीमित कर सकता है, जिससे प्रदर्शन में वृद्धि होती है और लागत में उल्लेखनीय कमी आती है।
उदाहरण के लिए, दैनिक लेनदेन डेटा संग्रहीत करने वाली एक पार्टिशन की गई टेबल क्वेरीज़ को पूरे डेटासेट को स्कैन करने के बजाय विशेष तारीख रेंज को कुशलता से फ़िल्टर करने देती है। यह टाइम-सीरीज़ विश्लेषण और बड़े पैमाने के विश्लेषणात्मक वर्कलोड्स के लिए विशेष रूप से लाभदायक है।
BigQuery में क्लस्टरिंग क्या है, और यह क्वेरी प्रदर्शन कैसे बेहतर करती है?
क्यों पूछा जाता है: क्वेरी दक्षता और लागत को ऑप्टिमाइज़ करने वाली डेटा संगठन रणनीतियों की आपकी समझ का मूल्यांकन करने के लिए।
BigQuery में क्लस्टरिंग का अर्थ है एक या अधिक निर्दिष्ट कॉलम के मानों के आधार पर पार्टिशन के भीतर डेटा का संगठन। संबंधित पंक्तियों को मूलतः समूहित करके, BigQuery स्कैन किए जाने वाले डेटा की मात्रा को कम कर देता है, जिससे क्वेरी प्रदर्शन सुधरता है और कुल प्रोसेसिंग लागत घटती है।
यह ऑप्टिमाइज़ेशन तरीका विशेष रूप से तब प्रभावी होता है जब क्लस्टर्ड कॉलम्स के आधार पर फ़िल्टरिंग, सॉर्टिंग, या एग्रीगेशन की जाती है, जहाँ क्वेरी इंजन पूरे पार्टिशन को स्कैन करने के बजाय अप्रासंगिक डेटा को पूरी तरह से छोड़ सकता है। क्लस्टरिंग पार्टिशनिंग के साथ मिलकर सबसे अच्छा काम करती है और बड़े डेटासेट्स पर और भी अधिक प्रदर्शन लाभ देती है।
BigQuery में टेबल और व्यू में क्या अंतर है?
क्यों पूछा जाता है: BigQuery की डेटा संरचनाओं और उनके उपयोग मामलों की आपकी समझ का मूल्यांकन करने के लिए।
BigQuery में, टेबल एक संरचित स्टोरेज इकाई है जो वास्तविक डेटा रखती है, जबकि व्यू एक वर्चुअल टेबल है जो एक प्री-डिफाइंड SQL क्वेरी के आधार पर डेटा को डायनेमिक रूप से पुनर्प्राप्त करती है। मुख्य अंतर यह है कि व्यू स्वयं डेटा नहीं रखता लेकिन बड़े क्वेरी लिखने के लिए बिल्डिंग ब्लॉक के रूप में या डेटा एक्सेस के इर्द-गिर्द सुरक्षा नियम लागू करने के लिए काम करता है, जिससे डेटा को डुप्लिकेट किए बिना उसके उपसमुच्चय तक पहुँच मिलती है। व्यूज़ क्वेरी निष्पादन समय को भी बेहतर बनाते हैं क्योंकि उपयोगकर्ता डेटा को फिर से एक्सेस कर सकते हैं बिना टेबल्स को रीलोड या रीऑर्गनाइज़ किए, जो उन्हें एनालिटिक्स, डेटा एब्स्ट्रैक्शन और सुरक्षा प्रवर्तन के लिए शक्तिशाली बनाता है।
संक्षेप में:
BigQuery डेटा सुरक्षा को कैसे संभालता है?
क्यों पूछा जाता है: BigQuery सुरक्षा और संवेदनशील डेटा की सुरक्षा के बारे में आपके ज्ञान की जाँच के लिए।
BigQuery डेटा सुरक्षा के लिए एक लेयर्ड एप्रोच अपनाता है, जो डेटा जीवनचक्र के सभी स्तरों पर डेटा की सुरक्षा के लिए डिज़ाइन किए गए सुरक्षित मॉडल से शुरू होता है।
ये बिल्ट-इन सुरक्षा विशेषताएँ संगठनों को डेटा गोपनीयता, अखंडता और नियामक अनुपालन बनाए रखने में मदद करती हैं।
BigQuery Data Transfer Service क्या है, और यह डेटा इन्गेशन को कैसे सरल बनाता है?
क्यों पूछा जाता है: BigQuery के भीतर स्वचालित डेटा मूवमेंट और इंटीग्रेशन की आपकी समझ का आकलन करने के लिए।
BigQuery Data Transfer Service (BQ DTS) विभिन्न बाह्य स्रोतों से BigQuery में डेटा आयात को ऑटोमेट और शेड्यूल करता है, जिससे मैन्युअल ETL प्रक्रियाओं की आवश्यकता समाप्त हो जाती है। यह नैटिव रूप से Google सेवाओं जैसे Google Ads, YouTube, और Google Cloud Storage के साथ-साथ थर्ड-पार्टी SaaS एप्लिकेशंस के साथ इंटीग्रेट होता है।
स्वचालित, शेड्यूल्ड डेटा ट्रांसफर सक्षम करके, BQ DTS यह सुनिश्चित करता है कि विश्लेषण के लिए डेटा बिना उपयोगकर्ता हस्तक्षेप के अद्यतन बना रहे। यह सेवा विशेष रूप से उन संगठनों के लिए उपयोगी है जो बड़े पैमाने पर आवर्ती डेटा इन्गेशन वर्कफ़्लो प्रबंधित करते हैं, जिससे दक्षता बढ़ती है और ऑपरेशनल ओवरहेड कम होता है।
BigQuery में नेस्टेड और रिपीटेड फ़ील्ड्स क्या हैं, और वे क्यों उपयोगी हैं?
क्यों पूछा जाता है: BigQuery के सेमी-स्ट्रक्चर्ड डेटा समर्थन और पारंपरिक रिलेशनल मॉडलों पर इसके लाभों की आपकी समझ का मूल्यांकन करने के लिए।
BigQuery नेस्टेड और रिपीटेड फ़ील्ड्स की अनुमति देता है, जिससे पदानुक्रमित या एरे-आधारित डेटा का अधिक कुशल स्टोरेज और क्वेरींग संभव होता है। नेस्टेड फ़ील्ड्स STRUCT डेटा टाइप का उपयोग करते हैं, जिससे एक कॉलम में सबफ़ील्ड्स हो सकते हैं, जो एक JSON ऑब्जेक्ट के समान है।
रिपीटेड फ़ील्ड्स ARRAYS के रूप में काम करते हैं, जिससे एक ही कॉलम में एकाधिक मान स्टोर हो सकते हैं। ये संरचनाएँ जटिल JOIN ऑपरेशनों की आवश्यकता कम करती हैं, क्वेरी प्रदर्शन में सुधार लाती हैं, और BigQuery को सेमी-स्ट्रक्चर्ड डेटा जैसे लॉग्स, इवेंट स्ट्रीम्स और NoSQL जैसे डेटासेट्स प्रोसेस करने के लिए उपयुक्त बनाती हैं।
आप BigQuery में जॉब्स को कैसे शेड्यूल और ऑटोमेट कर सकते हैं?
क्यों पूछा जाता है: BigQuery में क्वेरी निष्पादन और वर्कफ़्लो प्रबंधन को स्वचालित करने के आपके ज्ञान का आकलन करने के लिए।
BigQuery कई तरीकों से जॉब्स को शेड्यूल और ऑटोमेट करने की सुविधा देता है, जिससे आवर्ती कार्य बिना मैन्युअल हस्तक्षेप के चलते रहें।
ये ऑटोमेशन टूल्स डेटा पाइपलाइनों को सुव्यवस्थित करने, मैन्युअल कार्यभार घटाने और एनालिटिक्स व रिपोर्टिंग के लिए समय पर डेटा प्रोसेसिंग सुनिश्चित करने में मदद करते हैं।
Big Query डेटा पार्टिशनिंग और क्लस्टरिंग को कैसे संभालता है?
क्यों पूछा जाता है: BigQuery में डेटा संगठन रणनीतियों और उनके क्वेरी प्रदर्शन व लागत दक्षता पर प्रभाव की आपकी समझ का आकलन करने के लिए।
Partitioning बड़ी टेबल्स को छोटे-छोटे खंडों में विभाजित करती है, जिससे केवल प्रासंगिक डेटा स्कैन कर क्वेरी प्रदर्शन बेहतर होता है।
टाइम-आधारित: DATE, TIMESTAMP, DATETIME द्वारा (जैसे, दैनिक sales_date पार्टिशन)।
Integer Range: INTEGER मानों द्वारा (उदा.,
user_idरेंज)।Ingestion-time: डेटा लोड टाइमस्टैम्प द्वारा (
_PARTITIONDATE)।यह टाइम-सीरीज़ डेटा के लिए सर्वोत्तम है और तारीख या न्यूमेरिक रेंज द्वारा फ़िल्टर करते समय क्वेरी लागत घटाता है।
Clustering चयनित कॉलम्स के आधार पर टेबल या पार्टिशन के भीतर डेटा को सॉर्ट करके व्यवस्थित करता है, जिससे क्वेरी तेज़ होती है।
यह अक्सर क्वेरी किए जाने वाले फ़ील्ड्स जैसे region या
user_idद्वारा फ़िल्टरिंग और एग्रीगेशन के लिए सबसे उपयुक्त है।टेबल क्लस्टर और पार्टिशन उदाहरण। चित्र Google Cloud द्वारा।
BigQuery आर्किटेक्चर इंटरव्यू प्रश्न
Google BigQuery का आर्किटेक्चर कैसे डिज़ाइन किया गया है, और इसे क्या विशिष्ट बनाता है?
क्यों पूछा जाता है: BigQuery के सर्वरलेस आर्किटेक्चर और यह पारंपरिक डेटा वेयरहाउस से कैसे भिन्न है, इसकी आपकी समझ का मूल्यांकन करने के लिए।
BigQuery में सर्वरलेस, पूर्णतः प्रबंधित आर्किटेक्चर है जो स्टोरेज और कंप्यूट को अलग करता है, जिससे वे माँग के अनुसार स्वतंत्र रूप से स्केल कर सकते हैं। पारंपरिक क्लाउड डेटा वेयरहाउस या ऑन-प्रिमाइसेज़ massively parallel processing (MPP) systems के विपरीत, यह विभाजन लचीलापन, लागत दक्षता और उच्च उपलब्धता प्रदान करता है, और उपयोगकर्ताओं को इन्फ्रास्ट्रक्चर प्रबंधन नहीं करना पड़ता। BigQuery का कंप्यूट इंजन Dremel द्वारा संचालित है, जो एक मल्टी-टेनेंट क्लस्टर है और SQL क्वेरीज़ को कुशलतापूर्वक निष्पादित करता है, जबकि डेटा Colossus, Google की ग्लोबल डिस्ट्रीब्यूटेड स्टोरेज सिस्टम, में संग्रहीत होता है। ये घटक Jupiter, Google के पेटाबिट-स्केल नेटवर्क, के माध्यम से संचार करते हैं, जो अल्ट्रा-फास्ट डेटा ट्रांसफर सुनिश्चित करता है। पूरे सिस्टम को Borg, Google का आंतरिक क्लस्टर प्रबंधन सिस्टम और Kubernetes का पूर्ववर्ती, ऑर्केस्ट्रेट करता है। यह आर्किटेक्चर उपयोगकर्ताओं को हाई-परफॉर्मेंस, स्केलेबल एनालिटिक्स विशाल डेटासेट्स पर चलाने में सक्षम बनाता है, बिना इन्फ्रास्ट्रक्चर प्रबंधन की चिंता किए।
Big Query आर्किटेक्चर। चित्र Google द्वारा।
BigQuery स्टोरेज और कंप्यूट को कैसे अलग करता है, और यह क्यों लाभदायक है?
क्यों पूछा जाता है: यह प्रश्न BigQuery के आर्किटेक्चर, विशेषकर इसके डिकपल्ड स्टोरेज और कंप्यूट मॉडल से स्केलेबिलिटी, लागत दक्षता और प्रदर्शन में कैसे सुधार होता है, इसकी आपकी समझ का आकलन करता है।
BigQuery एक सर्वरलेस, पूर्णतः प्रबंधित आर्किटेक्चर का पालन करता है जहाँ स्टोरेज और कंप्यूट पूरी तरह से अलग हैं:
स्टोरेज-कंप्यूट पृथक्करण के प्रमुख लाभ:
यह डिज़ाइन BigQuery को पेटाबाइट-स्केल क्वेरीज़ को कुशलतापूर्वक प्रोसेस करने देता है, जबकि लागत कम रखता है, जिससे यह क्लाउड-आधारित एनालिटिक्स के लिए आदर्श विकल्प बनता है।
जैसे-जैसे उद्योग का फोकस बड़े पैमाने की कंप्यूटेशनल शक्ति की ओर शिफ्ट हो रहा है, यह आर्किटेक्चरल लचीलापन महत्वपूर्ण है। DataFramed पॉडकास्ट में 2025 के डेटा रुझानों के संदर्भ में कहा गया है: