Kurs
Bulut hizmetlerinin yaygınlaşmasıyla veri ambarı teknolojileri, daha ölçeklenebilir ve daha düşük maliyetli olacak şekilde yakın zamanda konsolide edildi. En yaygın çözümlerden biri Google Cloud Platform’un veri ambarı BigQuery’dir.
Stack Overflow 2024 anketi, dünya çapındaki bulut kullanıcıları arasında %24,1 benimseme oranına ulaşarak popülaritesinin arttığını doğruluyor. BigQuery uzmanlığına olan talep çeşitli sektörlerde önemli ölçüde arttı ve temel kavramlarını anlamak veri profesyonelleri için mesleki bir gereklilik haline geldi.
Bu yazıda, mülakatlara hazırlanmanıza yardımcı olacak, iş görüşmelerinde sıkça sorulan bazı BigQuery sorularının bir derlemesini bulacaksınız. BigQuery’yi öğrenmeye yeni başlıyorsanız, öncelikle GCP’de Veri Ambarı hakkındaki şu kılavuza göz atmanızı öneririm.
Temel BigQuery Mülakat Soruları
Karmaşık konulara geçmeden önce BigQuery’nin temellerini bilmek çok önemlidir. Bu sorular, çekirdek kavramlar, mimari ve işlevsellik konusundaki hakimiyetinizi değerlendirir. Aşağıdaki soruları yanıtlayamıyorsanız, BigQuery’ye Yeni Başlayanlar Rehberini inceleyerek ve giriş seviyesi BigQuery kursumuza kaydolarak temelden başlamanızı öneririm.
BigQuery nedir ve geleneksel veritabanlarından nasıl farklıdır?
Neden sorulur: Modern veri ambarlarını ve geleneksel veritabanlarına göre avantajlarını anlama düzeyinizi değerlendirmek için.
BigQuery, büyük ölçekli veri analitiği için tasarlanmış, Google Cloud üzerinde tam yönetilen, sunucusuz bir veri ambarıdır. Devasa veri kümeleri üzerinde, altyapı yönetimi gerektirmeden yüksek hızlı SQL sorguları çalıştırır ve kullanıcıların bakımdan ziyade içgörülere odaklanmasını sağlar.
Genellikle satır tabanlı olan ve donanım sınırlamalarıyla kısıtlanan geleneksel şirket içi ilişkisel veritabanlarının aksine BigQuery, neredeyse sınırsız ölçeklenebilirlik sunan bulut-yerel, sütunlu bir depolama sistemidir. Dağıtık mimarisi ve kullandıkça öde fiyatlandırma modeli, analitik iş yüklerini yönetmede geleneksel veritabanlarına kıyasla daha verimlidir.
BigQuery’de veri kümesi (dataset) nedir?
Neden sorulur: BigQuery’de veri organizasyonu ve yapısı hakkındaki bilginizi test etmek için.
BigQuery’de bir veri kümesi, tabloları, görünümleri ve diğer kaynakları organize eden en üst düzey kapsayıcı olarak tanımlanır. Bu, erişim kontrolü ve verinin konumlandırılması için zemin hazırlar. Veriyi verimli bir şekilde yapılandırarak veri kümeleri, daha iyi sorgu performansı ve erişim yönetimi sağlar; bu da onları BigQuery mimarisinin temel bir bileşeni yapar.
BigQuery’ye veri nasıl yüklenir?
Neden sorulur: Farklı veri alma (ingestion) yöntemleri konusundaki bilginizi test etmek için.
BigQuery, farklı amaçlara yönelik çeşitli veri alma yöntemleri sunar.
- Yığın yükleme modu büyük bir geçmiş veri setini BigQuery’ye yüklemek için BigQuery web arayüzü, bq komut satırı aracı veya API çağrıları kullanılarak tercih edilir.
- Akış (streaming) alma, BigQuery Streaming API’si kullanılarak tekil kayıtların veya küçük partilerin itilmeleriyle gerçek zamanlı veri işlemeyi mümkün kılar.
- BigQuery’nin veri aktarım hizmeti Google Cloud Storage, Google Ads ve SaaS kaynaklarından zamanlanmış veri alımlarını basitleştirebilir.
Gelişmiş ETL iş akışları için Google Cloud Dataflow ve diğer boru hattı araçları, verinin BigQuery’ye sorunsuz taşınmasını kolaylaştırır. En uygun alma yönteminin seçimi, veri hacmi, gecikme ve işleme ihtiyaçlarına bağlıdır.
BigQuery hangi veri türlerini destekler?
Neden sorulur: BigQuery’nin veri işleme yetenekleri konusundaki bilginizi test etmek için.
BigQuery çeşitli veri türlerini destekler; bunlar şu şekilde kategorize edilir:
- Temel türler: BOOL, INT64, FLOAT64, STRING, BYTES, DATE, DATETIME, TIME, TIMESTAMP
- Karmaşık türler: ARRAY, STRUCT, JSON
- Uzmanlaşmış türler: NUMERIC, BIGNUMERIC, INTERVAL, GEOGRAPHY, RANGE
Her veri türünün tanımlı bir mantıksal depolama boyutu vardır; bu da sorgu performansını ve maliyeti etkiler. Örneğin STRING depolaması, UTF-8 kodlu uzunluğa bağlıyken ARRAY<INT64> her eleman için 8 bayt gerektirir. Bu türleri anlamak, sorguları optimize etmeye ve maliyetleri etkin şekilde yönetmeye yardımcı olur.
Desteklenen tüm veri türlerini aşağıdaki tabloda görebilirsiniz.
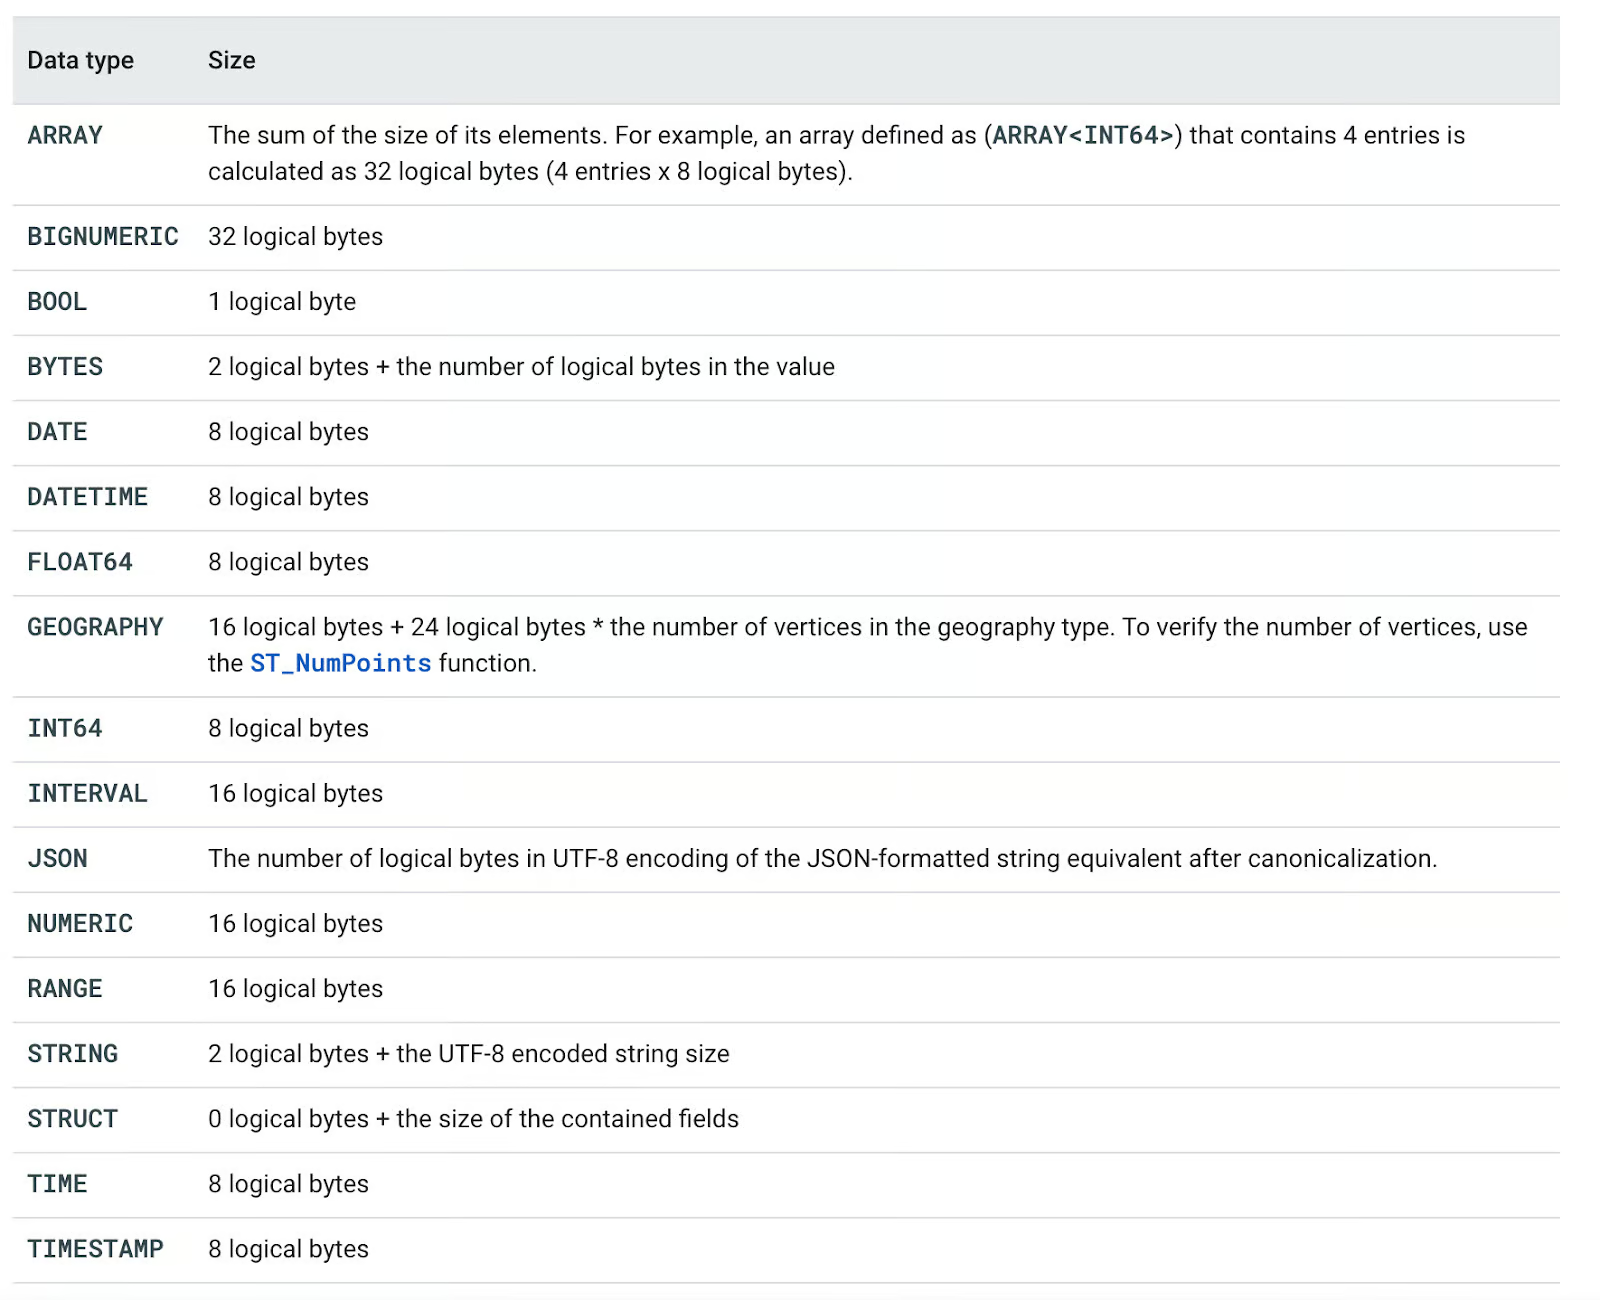
BigQuery veri türleri. Görsel kaynağı: Google Cloud Dokümantasyonu.
BigQuery kullanmanın başlıca avantajları nelerdir?
Neden sorulur: BigQuery’yi bir Veri Ambarı olarak kullanmanın temel faydalarını anladığınızdan emin olmak için.
BigQuery hizmetlerini kullanmanın, geleneksel kendi kendine yönetilen çözümlere göre beş ana faydası vardır:
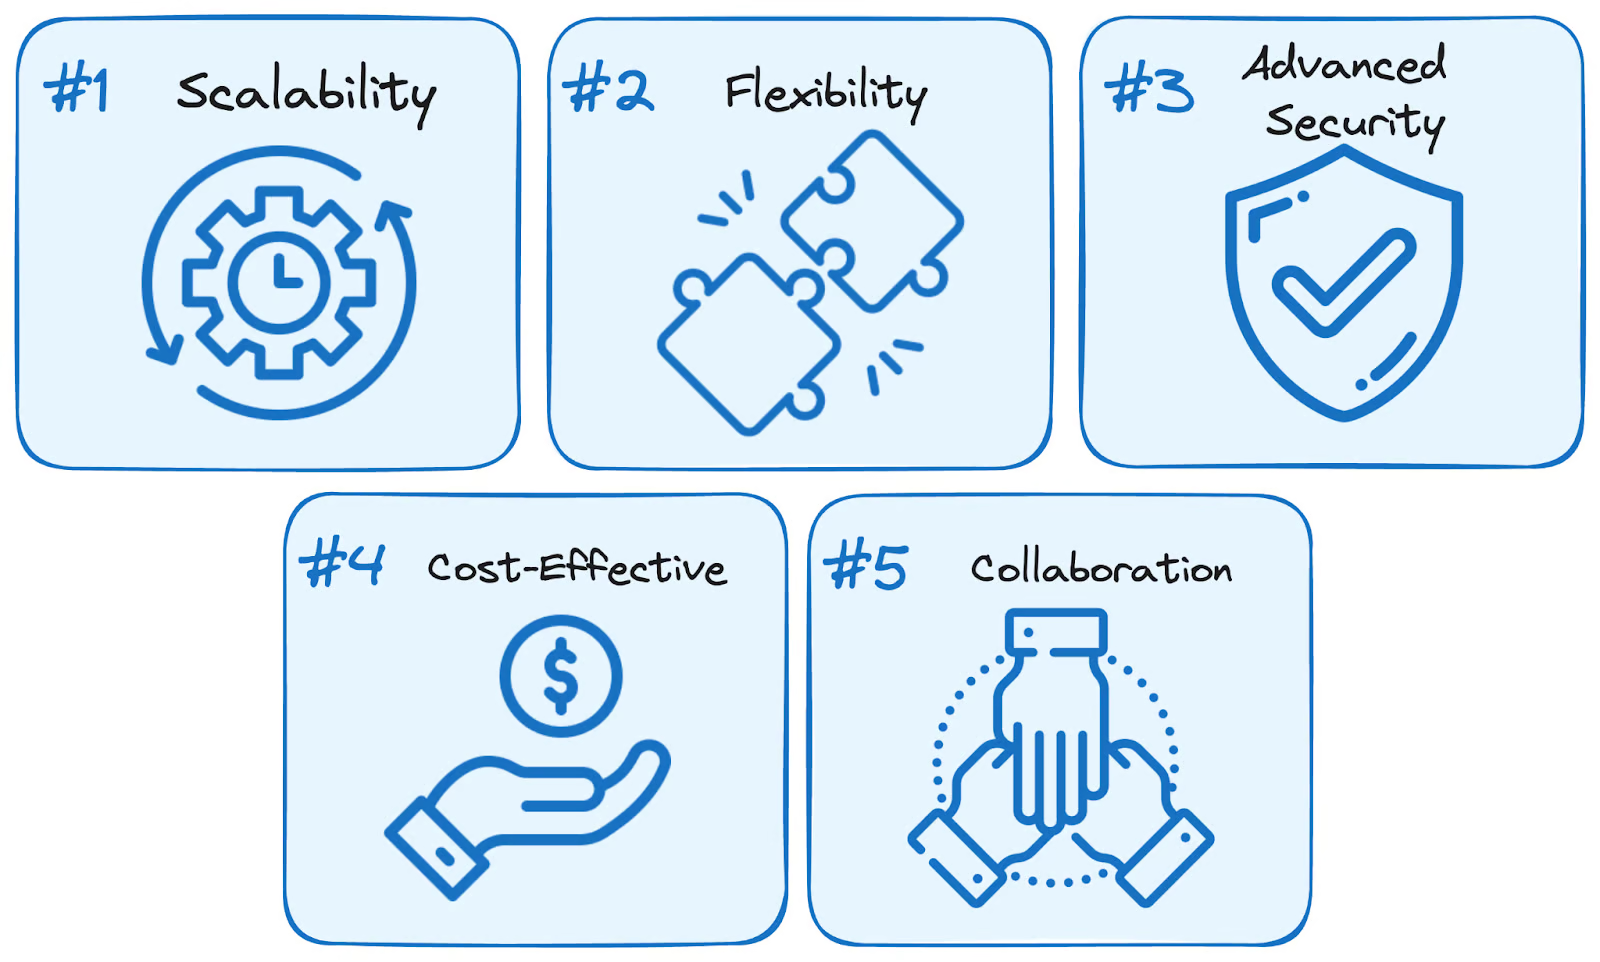
- Ölçeklenebilirlik: Donanıma yapılan tüm yatırımlar başlangıçta ertelenir. İş gereksinimlerine bağlı olarak kaynakları kolayca artırıp azaltmamıza olanak tanır.
- Esneklik: Altyapı, iş ihtiyaçlarına göre değiştirilebilir.
- Yüksek güvenlik: Otomatik yedeklemeler ve felaket kurtarma özellikleri, GCP gibi bulut çözümlerinin varsayılan özellikleridir.
- Maliyet etkinliği: Kullandıkça öde seçenekleri, müşterilerin yalnızca kullandıkları hizmetler için ödeme yapmalarını sağlar.
- Veri paylaşımı ve iş birliği: Bulut tabanlı hizmetler kullanmak veri paylaşımını ve iş birliğini teşvik eder.

BigQuery’nin Avantajları. Görsel: Yazar.
Teknik BigQuery Mülakat Soruları
BigQuery’nin temellerini kavradıktan sonra, mülakatlarda sıklıkla değerlendirilen daha teknik yönlere dalma zamanı gelir.
Bu sorular, temel tanımların ötesine geçerek performansı optimize etme, maliyetleri yönetme ve bölümleme (partitioning), kümeleme (clustering) ve güvenlik gibi gelişmiş özelliklerle çalışma becerinizi test eder.
BigQuery’de bölümleme (partitioning) nedir ve performansı nasıl artırır?
Neden sorulur: Veri organizasyon tekniklerini ve bunların sorgu verimliliğine etkisini değerlendirmek için.
BigQuery’de bölümleme, büyük tabloların tarih, alma zamanı veya tamsayı değerleri gibi belirli bir kritere göre daha yönetilebilir parçalara ayrılmasıdır. Veriyi bölümlere ayırdığından, BigQuery sorgular sırasında taranan veri miktarını kısıtlayabilir; bu da performansı artırır ve maliyetleri kayda değer ölçüde düşürür.
Örneğin, günlük işlem verilerini saklayan bölümlenmiş bir tablo, tüm veri kümesini taramak yerine belirli tarih aralıklarını verimli bir şekilde filtrelemeye olanak tanır. Bu, zaman serisi analizi ve büyük ölçekli analitik iş yükleri için bölümlemeyi özellikle faydalı kılar.
BigQuery’de kümeleme (clustering) nedir ve sorgu performansını nasıl artırır?
Neden sorulur: Sorgu verimliliğini ve maliyeti optimize eden veri organizasyon stratejilerini anlama düzeyinizi değerlendirmek için.
BigQuery’de kümeleme, bir veya daha fazla belirtilen sütunun değerlerine göre bölümler içindeki verinin düzenlenmesini ifade eder. İlgili satırlar kümelenerek birlikte gruplandığından, BigQuery taranan veri miktarını azaltır; böylece sorgu performansını iyileştirir ve genel işlem maliyetlerini düşürür.
Bu sorgu optimizasyon yöntemi, kümelenmiş sütunlar üzerinde filtreleme, sıralama veya toplama yaparken özellikle etkilidir; çünkü sorgu motoru, tüm bölümü tam tarama yapmak yerine ilgisiz veriyi tamamen atlayabilir. Kümeleme, bölümleme ile birleştirildiğinde en iyi sonucu verir ve büyük veri kümeleriyle çalışırken daha da fazla performans faydası sağlar.
BigQuery’de tablo ile görünüm (view) arasındaki fark nedir?
Neden sorulur: BigQuery’nin veri yapıları ve kullanım senaryoları konusundaki bilginizi değerlendirmek için.
BigQuery’de bir tablo, veriyi fiziksel olarak tutan yapılandırılmış bir depolama birimidir; bir görünüm ise önceden tanımlanmış bir SQL sorgusuna göre veriyi dinamik olarak getiren sanal bir tablodur. Aralarındaki temel fark, görünümlerin tek başına veri barındıramaması; büyük sorgular yazmak için yapı taşı olarak hizmet etmesi veya verinin bir alt kümesine erişim sunarak veri erişimi etrafında güvenlik kuralları uygulaması, üstelik veriyi fiilen çoğaltmadan bunu yapmasıdır. Görünümler ayrıca kullanıcıların veriye, tabloları yeniden yüklemeye veya yeniden düzenlemeye gerek kalmadan tekrar erişmesine olanak tanıyarak sorgu yürütme sürelerini iyileştirir; bu da onları analitik, veri soyutlama ve güvenlik uygulamaları için güçlü kılar.
Kısaca:
- Bir tablo veriyi fiziksel olarak tutan yapılandırılmış bir depolama birimidir
- Bir görünüm, önceden tanımlı bir SQL sorgusuna göre veriyi depolamadan dinamik olarak getiren sanal bir tablodur
BigQuery veri güvenliğini nasıl sağlar?
Neden sorulur: BigQuery güvenliği ve hassas verilerin korunması konusundaki bilginizi kontrol etmek için.
BigQuery, veri yaşam döngüsünün tüm aşamalarında veriyi korumayı amaçlayan güvenli bir modelle başlayan katmanlı bir veri güvenliği yaklaşımı uygular.
- Veri, bekleme halinde şifrelenir ve varsayılan olarak Google tarafından yönetilen şifreleme anahtarları kullanılır veya yönetimsel kontrolü elde tutmak isteyenler için müşteri tarafından yönetilen anahtarlarla şifrelenebilir.
- Veri, iletim halinde şifrelenir ve istemciler ile BigQuery arasında HTTPS/TLS üzerinden güvenli iletişim sağlanır.
- Kimlik ve Erişim Yönetimi (IAM) kullanıcı ve hizmet hesabı rollerini ve atamalarını sağlayarak ayrıntılı erişim kontrolü sunar; böylece yalnızca yetkili tarafların veriye erişebilmesi veya veriyi değiştirebilmesi sağlanır.
- Denetim günlüğü kullanıcı ve sistem etkinliklerini izlemeyi amaçlar; izleme ve uyumluluk için kullanılabilecek bir denetim izi sunar.
Bu yerleşik güvenlik özellikleri, kuruluşların veri gizliliğini, bütünlüğünü ve mevzuata uyumunu korumasına yardımcı olur.
BigQuery Veri Aktarım Hizmeti (Data Transfer Service) nedir ve veri alımını nasıl basitleştirir?
Neden sorulur: BigQuery içinde otomatik veri hareketi ve entegrasyon konusundaki anlayışınızı değerlendirmek için.
BigQuery Data Transfer Service (BQ DTS), çeşitli harici kaynaklardan BigQuery’ye veri alımını otomatikleştirir ve zamanlar; böylece manuel ETL süreçlerine olan ihtiyacı ortadan kaldırır. Google Ads, YouTube ve Google Cloud Storage gibi Google hizmetleriyle ve üçüncü taraf SaaS uygulamalarıyla yerel olarak entegre olur.
otomatik ve zamanlanmış veri aktarımı sağlayarak, BQ DTS verinin kullanıcı müdahalesi olmadan analiz için güncel kalmasını temin eder. Bu hizmet, tekrarlayan veri alma iş akışlarını ölçekli olarak yöneten kuruluşlar için özellikle faydalıdır; verimliliği artırır ve operasyonel yükü azaltır.
BigQuery’de iç içe (nested) ve yinelemeli (repeated) alanlar nelerdir ve neden kullanışlıdır?
Neden sorulur: BigQuery’nin yarı-yapılandırılmış veriyi desteklemesi ve bunun geleneksel ilişkisel modellere göre avantajlarını anlama düzeyinizi değerlendirmek için.
BigQuery, iç içe ve yinelemeli alanlara olanak tanıyarak hiyerarşik veya dizi tabanlı verilerin daha verimli depolanmasını ve sorgulanmasını sağlar. İç içe alanlar STRUCT veri türünü kullanır ve bir sütunun, bir JSON nesnesine benzer şekilde alt alanlar içermesine imkân verir.
Yinelemeli alanlar ARRAY olarak işlev görür; tek bir sütunun birden çok değeri saklamasını sağlar. Bu yapılar, karmaşık JOIN işlemlerine duyulan ihtiyacı ortadan kaldırır, sorgu performansını iyileştirir ve BigQuery’yi yarı-yapılandırılmış verileri (günlükler, olay akışları ve NoSQL benzeri veri kümeleri gibi) işlemek için oldukça uygun hale getirir.
BigQuery’de işler nasıl zamanlanır ve otomatikleştirilir?
Neden sorulur: BigQuery’de sorgu yürütmeyi ve iş akışı yönetimini otomatikleştirme bilginizi değerlendirmek için.
BigQuery, işleri zamanlamak ve otomatikleştirmek için, tekrarlayan görevlerin manuel müdahale olmadan çalışmasını sağlayan çeşitli yöntemler sunar.
- Zamanlanmış sorgular, BigQuery web arayüzü veya API üzerinden doğrudan tekrarlayan sorgu yürütmelerini tanımlamaya olanak tanır.
- Cloud Scheduler, önceden tanımlanmış aralıklarda sorguları tetikleyen, tamamen yönetilen cron benzeri bir hizmet sunar.
- Olay odaklı otomasyon için Cloud Functions, diğer Google Cloud hizmetlerinden gelen tetikleyicilere yanıt olarak BigQuery işlerini çalıştırabilir.
Bu otomasyon araçları, veri boru hatlarını kolaylaştırır, manuel iş yükünü azaltır ve analitik ile raporlama için zamanında veri işlemeyi sağlar.
Big Query veri bölümleme ve kümelemeyi nasıl ele alır?
Neden sorulur: BigQuery’de veri organizasyon stratejilerini ve bunların sorgu performansı ile maliyet verimliliğine etkisini anlama düzeyinizi değerlendirmek için.
Bölümleme büyük tabloları daha küçük segmentlere böler, yalnızca ilgili veriyi tarayarak sorgu performansını artırır.
-
Zamana dayalı: DATE, TIMESTAMP, DATETIME’a göre (ör. günlük sales_date bölümleri).
-
Tamsayı aralığı: INTEGER değerlerine göre (ör.
user_idaralıkları). -
Alım zamanına göre: Veri yükleme zaman damgasına göre (
_PARTITIONDATE).
Tarih veya sayısal aralıklara göre filtreleme yaparken zaman serisi verileri ve sorgu maliyetlerini azaltmak için en iyisidir.
Kümeleme, tablo veya bölüm içindeki veriyi seçilen sütunlara göre sıralayarak düzenler ve sorguları hızlandırır.
Sık sorgulanan bölge veya user_id gibi alanlara göre filtreleme ve toplama için en iyisidir.
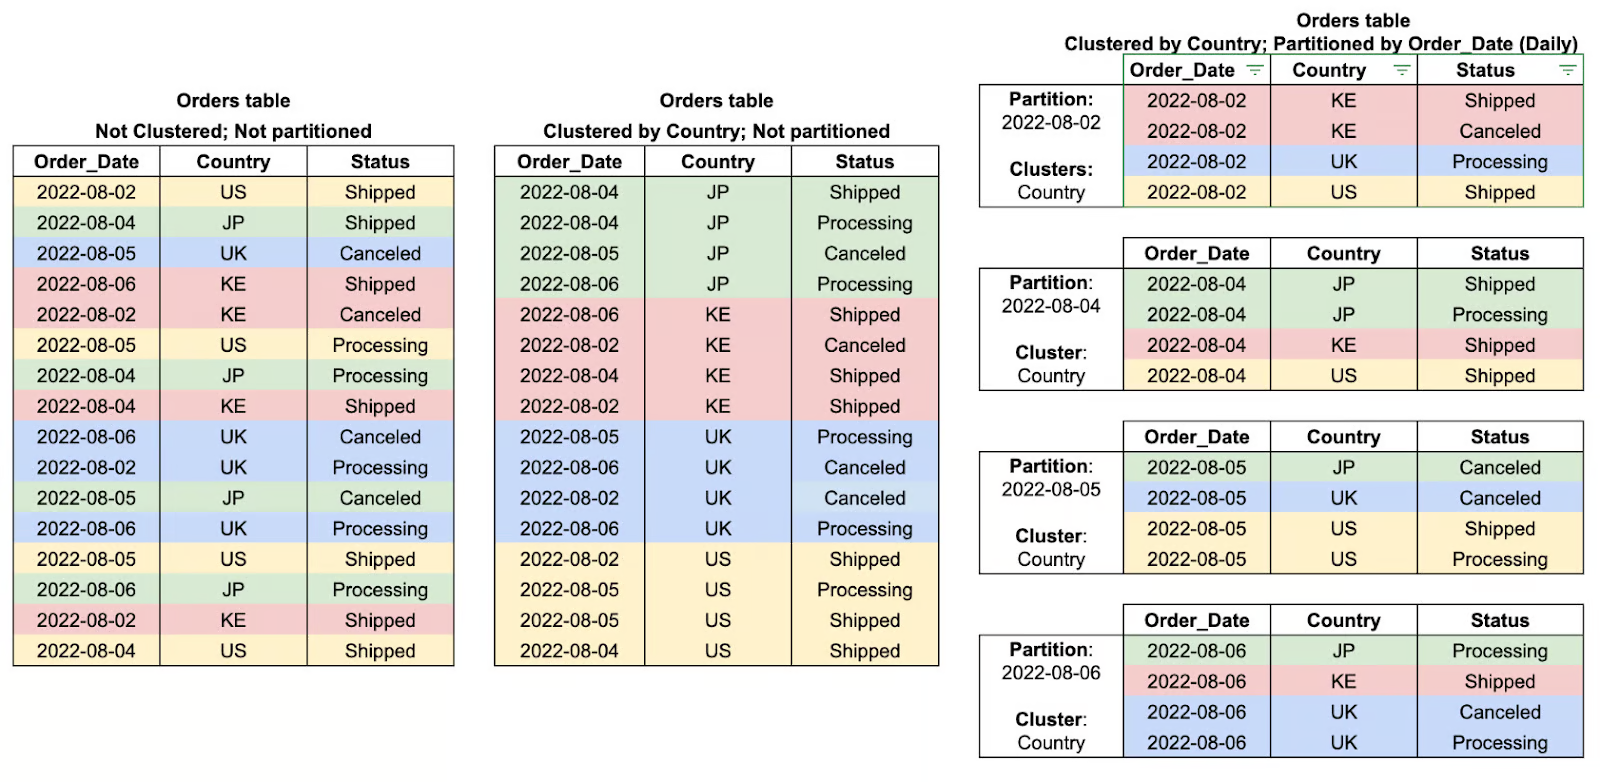
Tablo kümesi ve bölümü örnekleri. Görsel: Google Cloud.
BigQuery Mimarisine İlişkin Mülakat Soruları
Google BigQuery’nin mimarisi nasıl tasarlanmıştır ve onu benzersiz kılan nedir?
Neden sorulur: BigQuery’nin sunucusuz mimarisini ve geleneksel veri ambarlarından nasıl farklılaştığını anlama düzeyinizi değerlendirmek için.
BigQuery, sunucusuz, tam yönetilen bir mimariye sahiptir ve depolama ile işlemi birbirinden ayırır; bu sayede talebe göre bağımsız ölçeklenebilirler. Geleneksel bulut veri ambarlarından veya şirket içi kitlesel paralel işleme (MPP) sistemlerinden farklı olarak bu ayrım, kullanıcıların altyapıyı yönetmesini gerektirmeden esneklik, maliyet verimliliği ve yüksek kullanılabilirlik sağlar. BigQuery’nin işlem motoru, SQL sorgularını verimli bir şekilde çalıştıran çok kiracılı bir küme olan Dremel tarafından desteklenirken veriler, Google’ın küresel dağıtık depolama sistemi olan Colossus’ta saklanır. Bu bileşenler, Jupiter adlı petabit ölçekli ağ üzerinden iletişim kurarak ultra hızlı veri aktarımı sağlar. Sistemin tamamı, Kubernetes’in öncülü olan Google’ın dahili küme yönetim sistemi Borg tarafından orkestre edilir. Bu mimari, kullanıcıların altyapı yönetimini dert etmeden yüksek performanslı, ölçeklenebilir analitik çalıştırmasına olanak tanır.
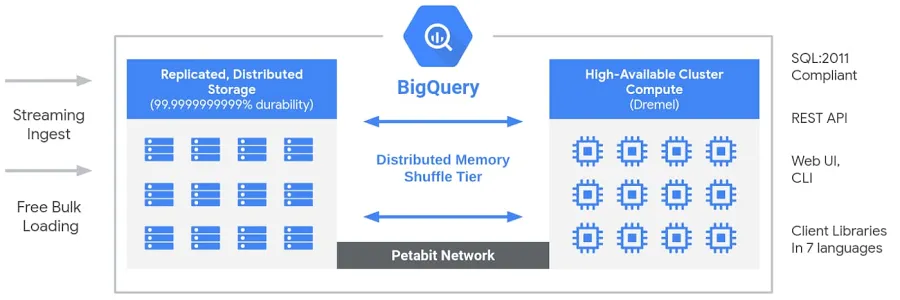
Big Query Mimarisi. Görsel: Google.
BigQuery depolama ile işlemi nasıl ayırır ve bu neden faydalıdır?
Neden sorulur: Bu soru, BigQuery’nin mimarisini; özellikle de ayrık depolama-işlem modelinin ölçeklenebilirliği, maliyet verimliliğini ve performansı nasıl iyileştirdiğini anlama düzeyinizi ölçer.
BigQuery, depolama ve işlemin tamamen ayrıldığı, sunucusuz ve tam yönetilen bir mimari izler:
- Depolama: Veriler, Google’ın küresel dağıtık depolama sistemi Colossus’ta saklanır. Bu, kullanıcıların altyapıyı yönetmesini gerektirmeden yüksek kullanılabilirlik, dayanıklılık ve neredeyse sınırsız ölçeklenebilirlik sağlar.
- İşlem: Sorgu yürütme, iş yükü talebine göre hesaplama kaynaklarını (slotları) dinamik olarak tahsis eden dağıtık sorgu motoru Dremel tarafından gerçekleştirilir.
Depolama-İşlem Ayrımının Temel Faydaları:
- Bağımsız ölçekleme: Depolamayı işlemi etkilemeden, işlemi de depolamayı etkilemeden ölçekleyebilirsiniz.
- Maliyet verimliliği: Yalnızca sorgular sırasında taranan veri için ödeme yaparsınız; gereksiz işlem maliyetlerinden kaçınırsınız.
- Optimize performans: Depolama, hesaplama için darboğaz oluşturmadığından sorgular daha hızlı çalışır.
- Çok bölgeli depolama: Veri farklı konumlarda saklanabilir ve bu durum sorgu hızını etkilemez.
Bu tasarım, BigQuery’nin petabayt ölçekli sorguları maliyetleri düşük tutarken verimli biçimde işlemesini sağlar; bu da onu bulut tabanlı analitik için ideal bir seçim yapar.
Sektör odağı devasa hesaplama gücüne doğru kayarken bu mimari esneklik kritik önem taşır. 2025’e yönelik veri trendlerine dair DataFramed podcast’inde de belirtildiği gibi:
Kesinlikle tüm büyük oyuncuların yaptığı bir bahis var. Daha fazla hesaplama gücü inşa ediyorlar ve gelecek yıl daha fazla hesaplama gücüyle ölçeklenecekler. Sonra soru şu: Peki, daha fazla veri var mı? İşte bu noktada iş daha incelikli hale geliyor. Bence bu bir spektrum; siyah-beyaz değil.
Jonathan Cornelissen, Co-founder & CEO of DataCamp
Dremel nedir ve BigQuery’nin hızlı sorgu performansını nasıl mümkün kılar?
Neden sorulur: BigQuery’nin temel sorgu motoru olan Dremel hakkında bilginizi ve ağaç tabanlı, sütunlu yürütme modelinin yüksek performanslı veri analitiğini nasıl sağladığını anlamak için.
Dremel, BigQuery’yi çalıştıran dağıtık bir sorgu yürütme motorudur. Satır tabanlı işlem yapan geleneksel veritabanlarının aksine Dremel, hız ve verimliliği optimize etmek için sütunlu depolama biçimi ve ağaç tabanlı sorgu yürütme modeli kullanır.
Dremel Hızlı Sorguları Nasıl Sağlar:
- Sütunlu Depolama: Tüm satırları okumak yerine yalnızca gerekli sütunları tarar; böylece işlenen veri miktarını azaltır.
- Ağaç Tabanlı Yürütme: Sorgular parçalara ayrılır ve binlerce düğümde paralel olarak yürütülür. Sonuçlar, gecikmeyi en aza indiren hiyerarşik bir ağaç yapısında birleştirilir.
- Sunucusuz Kaynak Tahsisi: Dremel, sorguların karmaşıklığına göre hesaplama slotlarını dinamik olarak atar ve kaynak kullanımını verimli kılar.
Dremel’in Başlıca Faydaları:
- Petabayt ölçekli veri kümelerinde son derece hızlı sorgular.
- Yalnızca ilgili sütunların taranmasıyla maliyet etkin işleme.
- Manuel ayar gerektirmeden büyük iş yükleri için otomatik paralelleştirme.
Dremel hakkında daha fazla bilgiyi Google’ın resmi dokümantasyonunda bulabilirsiniz.
BigQuery’de denormalizasyon nasıl çalışır ve ne zaman kullanılmalıdır?
Neden sorulur: Analitik veritabanlarında veri modelleme stratejilerini ve bunların sorgu performansına etkisini anlama düzeyinizi değerlendirmek için.
BigQuery’de denormalizasyon, bilerek fazlalık (redundancy) ekler; tabloları birleştirir ve veriyi çoğaltarak sorgu performansını optimize eder. Fazlalığı, ilişkili küçük tablolarla en aza indiren normalizasyonun aksine denormalizasyon, karmaşık join’lere olan ihtiyacı azaltır ve bunun sonucunda daha hızlı okuma süreleri sağlar. Bu yaklaşım, veri ambarı ve analitik bağlamlarında, yazma işlemlerine kıyasla okuma işlemlerinin daha sık olduğu senaryolarda özellikle kullanışlıdır. Ancak denormalizasyon, depolama gereksinimlerini artırır; bu nedenle BigQuery, depolama yükünü en aza indirirken denormalize veriyi verimli şekilde yapılandırmak için iç içe ve yinelemeli alanların kullanılmasını önerir.
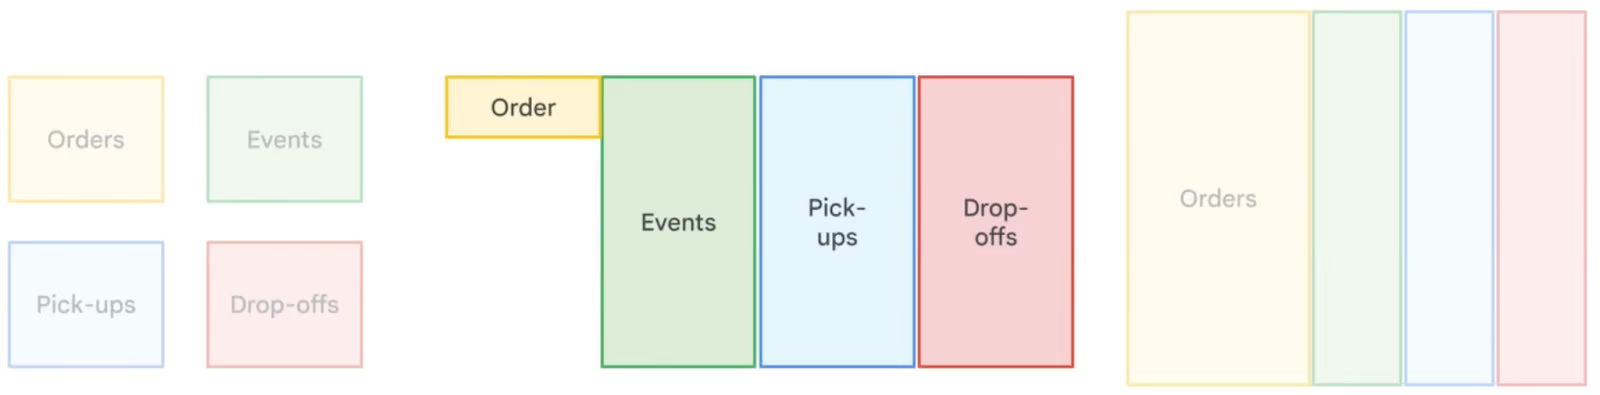
Farklı veri normalizasyon stratejilerinin karşılaştırması. Görsel: Google Cloud.
SQL’e Özel Sorular
BigQuery’nin mimarisi ve optimizasyon tekniklerine sağlam bir şekilde hakim olduktan sonra odaklanmanız gereken bir diğer kritik alan SQL yetkinliğidir. SQL, BigQuery ile çalışmanın bel kemiğidir ve mülakatlarda genellikle sorgu yazma, optimize etme ve sorun giderme becerileriniz test edilir. Daha iyi hazırlanmak için DataCamp’in SQL kurslarına kaydolmanızı öneririm.
BigQuery’de JOIN işlemi nasıl yapılır?
Neden sorulur: Birden fazla tablodan veriyi SQL JOIN işlemleriyle birleştirme becerinizi değerlendirmek için.
BigQuery, paylaşılan bir sütuna göre birden fazla tablodan veri birleştirmek için çeşitli JOIN türlerini destekler. Örneğin, ürün ayrıntılarını satış bilgileriyle birlikte getirmek için, ÜRÜN TABLOSU ile SATIŞ TABLOSU arasında Product_Id üzerinden bir INNER JOIN kullanabilirsiniz:
SELECT
s.Id AS Sales_Id,
p.Product,
p.Price,
s.Purchase_date
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id;
Teslimat tarihleri gibi ek ayrıntılar için TESLİMAT TABLOSU’nu da bağlayabilirsiniz:
SELECT
s.Id AS Sales_Id,
p.Product,
p.Price,
s.Purchase_date,
d.Deliver_date
FROM sales_table s
JOIN product_table p ON s.Product_Id = p.Id
JOIN delivery_table d ON s.Id = d.Sales_Id;
En pahalı 10 ürünü seçmek için bir SQL sorgusu yazın.
Neden sorulur: Veriyi verimli şekilde getirme ve sıralama becerinizi değerlendirmek için.
En pahalı 10 ürünü bulmak için, fiyatı azalan düzende sıralamak üzere ORDER BY ve sonucu sınırlamak için LIMIT kullanın:
SELECT
Product,
Price
FROM product_table
ORDER BY Price DESC
LIMIT 10;
Aylık ortalama satış sayısını hesaplamak için bir SQL sorgusu yazın.
Neden sorulur: Zaman temelli toplulaştırmalar yapma becerinizi değerlendirmek için.
Aylık ortalama satış sayısını hesaplamak için, satışları aya göre gruplamak üzere EXTRACT fonksiyonunu ve ay başına satış sayısını saymak için COUNT kullanın:
SELECT
EXTRACT(MONTH FROM Purchase_date) AS Month,
COUNT(Id) AS Total_Sales,
AVG(COUNT(Id)) OVER () AS Average_Sales
FROM sales_table
GROUP BY Month;
Ürün bazında toplam teslimat sayısını bulmak için bir SQL sorgusu yazın.
Neden sorulur: GROUP BY ve COUNT kullanarak veri toplulaştırma becerinizi değerlendirmek için.
Her ürün için teslimatları saymak üzere:
SELECT
p.Product,
COUNT(d.Id) AS Total_Deliveries
FROM delivery_table d
JOIN product_table p
ON d.Product_Id = p.Id
GROUP BY p.Product;
Her ürün için toplam teslimat sayısını bulmak için bir SQL sorgusu yazın.
Neden sorulur: Zaman temelli veriyi filtreleme becerinizi değerlendirmek için.
Son 30 güne ait satış kayıtlarını almak için:
SELECT *
FROM sales_table
WHERE Purchase_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 30 DAY);
Geçen hafta satılan benzersiz ürün sayısını hesaplamak için bir SQL sorgusu yazın.
Neden sorulur: Zaman temelli veriler üzerinde tekil sayımlar yapma becerinizi değerlendirmek için.
Son 7 günde satılan benzersiz ürünleri saymak için:
SELECT COUNT(DISTINCT Product_Id) AS Unique_Products_Sold
FROM sales_table
WHERE Purchase_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY);
Satış verilerini ürüne göre gruplayıp her biri için toplam geliri hesaplamak üzere bir SQL sorgusu yazın.
Neden sorulur: GROUP BY ve satışları toplama becerinizi test etmek için.
Ürün başına toplam geliri hesaplamak için:
SELECT
p.Product,
SUM(p.Price) AS Total_Revenue
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;
Her ürünün toplam satışlara katkı yüzdesini hesaplamak için bir SQL sorgusu yazın.
Neden sorulur: SQL kullanarak yüzde hesaplama becerinizi değerlendirmek için.
Ürün başına toplam satış yüzdesini belirlemek için:
SELECT
p.Product,
SUM(p.Price) AS Product_Sales,
(SUM(p.Price) / (SELECT SUM(Price) FROM product_table)) * 100 AS Sales_Percentage
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;
Ürünleri toplam satışlara göre sıralamak için bir SQL sorgusu yazın.
Neden sorulur: Sıralama için pencere (window) fonksiyonlarını kullanma becerinizi değerlendirmek için.
Ürünleri toplam satışlara göre sıralamak için:
SELECT
p.Product,
SUM(p.Price) AS Total_Sales,
RANK() OVER (ORDER BY SUM(p.Price) DESC) AS Sales_Rank
FROM sales_table s
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;
Her ürün için ortalama teslimat süresini hesaplamak üzere bir SQL sorgusu yazın.
Neden sorulur: SQL’de tarih farklarıyla çalışma becerinizi değerlendirmek için.
Ürün başına ortalama teslimat süresini hesaplamak için:
SELECT
p.Product,
AVG(DATE_DIFF(d.Deliver_date, s.Purchase_date, DAY)) AS Avg_Delivery_Time
FROM sales_table s
JOIN delivery_table d
ON s.Id = d.Sales_Id
JOIN product_table p
ON s.Product_Id = p.Id
GROUP BY p.Product;
İleri Düzey ve Senaryo Tabanlı Sorular
Temel bilgiler ve SQL yeterliliğinin ötesinde, gerçek dünyadaki problem çözme becerileri, BigQuery’yi ölçekli olarak kullanmak için kritik öneme sahiptir.
İleri düzey mülakat soruları genellikle büyük veri kümelerinin yönetimi, performans optimizasyonu, veri boru hatlarının yönetimi ve üretim ortamlarındaki yaygın zorlukların giderilmesine odaklanır.
BigQuery’de veri boru hatları (pipeline) uygulama konusundaki deneyiminizi anlatabilir misiniz?
Neden sorulur: BigQuery’de, alma, dönüşüm, orkestrasyon ve izlemeyi de kapsayan veri boru hatları oluşturma, yönetme ve optimize etme konusundaki pratik bilginizi değerlendirmek için.
Görüşmeci, BigQuery’de veri boru hatları tasarlama ve uygulama konusundaki pratik deneyiminize dair içgörüler arar. Şunlardan bahsetmelisiniz:
- Veri alma: Kullanılan yöntemler (BigQuery Data Transfer Service, Cloud Storage, akışla alma).
- Veri dönüşümü: SQL tabanlı dönüşümler, zamanlanmış sorgular veya Dataflow ve dbt gibi araçların kullanımı.
- Orkestrasyon: Cloud Composer (Apache Airflow), Cloud Functions veya Cloud Scheduler ile iş akışlarını nasıl yönettiğiniz.
- İzleme ve optimizasyon: boru hattı performansını nasıl takip ettiğiniz, sorunları nasıl ayıkladığınız ve sorgu maliyetlerini nasıl optimize ettiğiniz.
Güçlü bir yanıt, karşılaştığınız zorluklara ve bunları nasıl ele aldığınıza dair gerçek dünya örnekleri içermelidir; örneğin büyük veri kümeleriyle başa çıkma, sorgu performansını optimize etme veya üretim boru hatlarında veri bütünlüğünü sağlama gibi.
Böyle bir projeyi uygulamak için bazı iyi kaynaklar şunlardır:
- BigQuery kullanarak ETL yığın boru hatları hakkında şu YouTube rehberi: ETL batch pipelines using BigQuery.
- Uçtan uca boru hattı için şu GitHub deposu.
- Airflow ve BigQuery ile ETL boru hattı için şu GitHub deposu.
Büyük bir BigQuery tablosunda bir sütundaki yinelenen kayıtları, tablo adını koruyarak nasıl kaldırabilirsiniz?
Neden sorulur: Tablo yapısını değiştirmeden BigQuery’de yinelenen veriyi verimli şekilde ele alma becerinizi değerlendirmek için.
Milyonlarca satır ve belirli bir sütunda yinelenen değerler içeren bir tabloyla uğraşırken en iyi yaklaşım, yinelenenlerin yalnızca ilk örneğini belirleyip tutmak ve geri kalanını kaldırmak için ROW_NUMBER() pencere fonksiyonunu kullanmaktır.
Bunu, CREATE OR REPLACE TABLE ifadesiyle tablonun yinelenenlerden arındırılmış bir sürümüyle üzerine yazarak başarabilirsiniz:
CREATE OR REPLACE TABLE tableX AS
SELECT * EXCEPT(row_number)
FROM (
SELECT *,
ROW_NUMBER() OVER (PARTITION BY troubleColumn ORDER BY someOtherColumn) AS row_number
FROM tableX
)
WHERE row_number = 1;
Nasıl çalışır:
-
ROW_NUMBER(), aynıtroubleColumndeğeri içindeki her kayda benzersiz bir sıra numarası atar; böylece her yinelenen grup için yalnızca bir kayıt tutulur. -
PARTITION BYtroubleColumn, satırları bu sütundaki yinelenen değerlere göre gruplar. -
ORDER BYsomeOtherColumn(ör.Purchase_date) belirli bir kaydın tutulmasını sağlar. -
Dış sorgu, yalnızca ilk örneği filtreler (
row_number = 1) ve böylece yinelenenleri etkili biçimde kaldırır. -
CREATE OR REPLACE TABLEifadesi, tabloyu aynı ad altında tutarken temizlenmiş verilerle değiştirilmesini sağlar.
Bu yaklaşım, yeni bir tablo oluşturmadan veya genel tablo yapısını etkilemeden yinelenenleri verimli şekilde ortadan kaldırır.
BigQuery’yi veri görselleştirme ve raporlama için nasıl kullanırsınız ve en yaygın araçlar nelerdir?
Neden sorulur: BigQuery’yi görselleştirme araçlarıyla entegre etme ve içgörüleri raporlamayla etkili biçimde iletme becerinizi değerlendirmek için.
BigQuery, Google Looker Studio (eski adıyla Data Studio), Tableau ve Power BI gibi araçlarla doğrudan bağlantılar sağlayarak veri görselleştirme ve raporlama için güçlü bir arka uç görevi görür.
Bu araçlar, veriyi gerçek zamanlı sorgulamaya ve manuel veri dışa aktarımlarına gerek kalmadan özel gösterge tabloları, grafikler ve raporlar oluşturmaya olanak tanır. Görselleştirme için temel teknikler şunlardır:
- Görselleştirmeden önce veriyi BigQuery’de toplulaştırmak ve dönüştürmek için SQL kullanmak.
- Dinamik filtreler ve ayrıntıya inme (drill-down) yeteneklerine sahip etkileşimli gösterge tabloları oluşturmak
- Gösterge tablosu performansını iyileştirmek için sorguları ve malzemeleştirilmiş görünümleri optimize etmek
Güçlü bir yanıt, gerçek dünya kullanım örneklerini vurgulamalıdır; örneğin:
- İşletme KPI’larını izleme
- Trendleri takip etme
- Otomatik raporlar üretme
Kendi Veri Görselleştirme projenizi uygulamak için, DataCamp’in BigQuery ile Elektrikli Araç Şarj Alışkanlıklarını Analiz Etme ve Londra’nın Ulaşım Ağı’nı Keşfetme konulu uzmanlaşmış projelerini takip edebilirsiniz.
BigQuery En İyi Uygulamalar ve Optimizasyon Hakkında Sorular
BigQuery ile verimli çalışmak, SQL sorguları yazmanın ötesine geçer—performansı optimize etmeyi, maliyetleri yönetmeyi ve sorunsuz veri operasyonları için en iyi uygulamaları hayata geçirmeyi gerektirir. BigQuery, kullanım başına ödeme modeliyle çalıştığından, veri taramalarını en aza indirmeyi, bölümleme ve kümelemeden yararlanmayı ve sorgu yürütmeyi optimize etmeyi anlamak hem performans hem de maliyet verimliliği için kritik öneme sahiptir.
BigQuery maliyetlerini verimli bir şekilde yönetmek için en iyi uygulamalar nelerdir?
Neden sorulur: BigQuery’de büyük veri kümeleriyle çalışırken maliyet verimliliğini optimize etme becerinizi değerlendirmek için.
BigQuery maliyetlerini etkin şekilde yönetmek için şunları yapmalısınız:
-
Sorguları optimize edin; yalnızca gerekli sütun ve satırları tarayın,
SELECT *kullanımından kaçının. -
Bölümlenmiş ve kümelenmiş tablolar kullanın; veri taramasını en aza indirin ve sorgu performansını artırın.
-
Maliyet izleme araçlarından yararlanın; bütçeler, uyarılar ve maliyet kontrol politikaları gibi Google Cloud özelliklerini kullanın.
-
Slot rezervasyonlarından faydalanın; daha öngörülebilir fiyatlandırma ve tutarlı iş yüklerinde maliyet tasarrufu sağlar.
-
Kullanılmayan tabloları ve bölümleri düzenli olarak temizleyin; depolama maliyetlerini optimize edin.
İyi yapılandırılmış bir maliyet yönetimi stratejisi, verimli sorgu yürütmeyi sürdürürken giderleri kontrol altında tutmaya yardımcı olur.
BigQuery’de sorgu performansını optimize etmek için en iyi uygulamalar nelerdir?
Neden sorulur: Yürütme süresini ve maliyeti azaltan verimli sorgular yazma becerinizi değerlendirmek için.
BigQuery’de sorgu performansını optimize etmek için:
-
Verimli bir şema tasarlayın; uygun veri türlerini seçin ve aşırı normalizasyondan kaçının.
-
Bölümleme ve kümeleme kullanın; taranan veri miktarını azaltın.
-
SELECT *’tan kaçının; yalnızca gerekli sütunları getirin. -
JOIN ve GROUP BY işlemlerini optimize edin; bunların büyük ölçekli sorgular için en iyi uygulamalara uygun olduğundan emin olun.
-
Önbellekleme ve malzemeleştirilmiş görünümlerden yararlanın; önceden hesaplanmış sonuçları saklayarak performansı artırın.
-
Yaklaşık toplulaştırma fonksiyonlarını kullanın; tam hassasiyet gerekmediğinde
APPROX_COUNT_DISTINCTgibi.
Bu uygulamaları takip ederek sorguları hızlandırabilir, işlem maliyetlerini azaltabilir ve genel verimliliği artırabilirsiniz.
BigQuery slotları nedir ve sorgu performansını nasıl etkiler?
Neden sorulur: BigQuery’nin hesaplama kaynaklarını ve bunların sorgu yürütmeye etkisini anlama düzeyinizi değerlendirmek için.
BigQuery slotları, SQL sorgularını işlemek için kullanılan hesaplama kapasitesi birimleridir. İş yükü taleplerine göre dinamik olarak tahsis edilirler ve kaynak kullanımının verimli olmasını sağlarlar. Kuruluşlar şunlar arasında seçim yapabilir:
- Talep üzerine slotlar; sorgu ihtiyaçlarına göre otomatik olarak ölçeklenir.
- Ayrılmış slotlar; tutarlı iş yükleri için daha öngörülebilir performans ve maliyet tasarrufu sağlar.
Verimli slot yönetimi, sorgu yürütme süresini azaltabilir, kaynak tahsisini optimize edebilir ve genel maliyetleri düşürebilir.
BigQuery maliyetlerini etkili biçimde nasıl izler ve optimize edersiniz?
Neden sorulur: BigQuery giderlerini izleme ve kontrol etme becerinizi değerlendirmek için.
BigQuery’de maliyetleri izlemek ve optimize etmek için:
- Sorgu yürütmesini analiz edin; pahalı işlemleri belirlemek için sorgu geçmişini ve EXPLAIN planlarını kullanın.
- Denetim günlüklerini etkinleştirin; kullanım kalıplarını takip edin ve verimsiz sorguları tespit edin.
- Bütçeler ve maliyet uyarıları oluşturun; beklenmedik giderleri önleyin.
- Slot kullanımını optimize edin; maliyetleri azaltmak için istikrarlı iş yüklerinde ayrılmış slotlardan yararlanın.
- Kullanılmayan tabloları ve bölümleri düzenli olarak temizleyin; gereksiz depolama ücretlerinden kaçının.
Bu stratejileri uygulayarak, performans ve ölçeklenebilirliği korurken maliyet etkin veri işleme sağlayabilirsiniz.
BigQuery Mülakatınızı Başarıyla Geçmek için Ek İpuçları
BigQuery ile ilgili yaklaşan mülakatınızı başarıyla geçmek için bazı son ipuçları:
Temelleri öğrenin. Sunucusuz tasarım, depolama-işlem ayrımı ve Dremel sorgu motoru dahil BigQuery mimarisini giriş seviyesi BigQuery kursumuzla anlayın. Veriyi verimli şekilde yönetmek ve yapılandırmak için veri kümeleri, tablolar, görünümler ve malzemeleştirilmiş görünümleri öğrenin. SQL malzemeleştirilmiş görünüm rehberimiz yardımcı olacaktır.
SQL ve sorgu optimizasyon becerilerinizi geliştirin. Karmaşık sorgular için BigQuery’ye özgü SQL fonksiyonlarını (ARRAY’ler, STRUCT’lar, pencere fonksiyonları) BigQuery’ye Başlangıç eşli kodlama içeriğimizle uygulayın. Maliyetleri azaltmak ve performansı artırmak için bölümleme, kümeleme ve yaklaşık fonksiyonlarla sorguları Google’ın resmi dokümantasyonunu takip ederek optimize edin.
Uygulamalı deneyim kazanın. Genel veri kümelerini kullanarak gerçek dünya projelerinde çalışın ve DataCamp projeleriyle Looker Studio, Tableau veya Power BI ile raporlar oluşturun. Elektrikli Araç Şarj Alışkanlıklarını Analiz Etme ve Londra’nın Ulaşım Ağı’nı Keşfetme projelerimizi denemek SQL becerilerinizi geliştirmenin harika yollarıdır.
Josep, Avrupa projelerine odaklanan serbest bir Veri Bilimcidir; veri depolama, işleme, ileri analitik ve etkili veri hikâyeleştirme konularında uzmandır.
Eğitmen olarak Navarra Üniversitesi'nin Yüksek Lisans programında Büyük Veri dersleri vermekte ve Medium, KDNuggets ve DataCamp gibi platformlarda yayımladığı makalelerle görüşlerini paylaşmaktadır. Josep ayrıca Databites bülteninde (databites.tech) Veri ve Teknoloji üzerine yazmaktadır.
Katalonya Politeknik Üniversitesi'nden Mühendislik Fiziği lisans derecesine ve Pompeu Fabra Üniversitesi'nden Akıllı Etkileşimli Sistemler yüksek lisans derecesine sahiptir.
SSS
BigQuery nedir ve geleneksel veritabanlarından nasıl farklıdır?
BigQuery, büyük ölçekli veri analitiği için tasarlanmış, Google Cloud üzerinde tam yönetilen, sunucusuz bir veri ambarıdır. Genellikle satır tabanlı olan ve donanım sınırlamalarıyla kısıtlanan geleneksel şirket içi ilişkisel veritabanlarının aksine BigQuery, neredeyse sınırsız ölçeklenebilirlik sunan bulut-yerel, sütunlu bir depolama sistemidir. Dağıtık mimarisi ve kullandıkça öde fiyatlandırma modeli, analitik iş yüklerini yönetmede geleneksel veritabanlarına kıyasla daha verimlidir.
BigQuery kullanmanın başlıca avantajları nelerdir?
BigQuery beş temel avantaj sunar: (1) Ölçeklenebilirlik – kaynakları otomatik olarak artırır veya azaltır, (2) Esneklik – altyapı iş ihtiyaçlarına uyum sağlar, (3) Yüksek Güvenlik – yerleşik şifreleme ve erişim kontrolü, (4) Maliyet etkinliği – kullandıkça öde fiyatlandırma, ve (5) Veri paylaşımı ve iş birliği – bulut tabanlı çözümler ekipler arasında sorunsuz erişim sağlar.
BigQuery’de bölümleme (partitioning) nedir ve performansı nasıl artırır?
BigQuery’de bölümleme, büyük tabloları tarih, alma zamanı veya sayısal değerler gibi ölçütlere göre daha küçük ve yönetilebilir parçalara ayırır. Bu, tüm tabloyu taramak yerine yalnızca ilgili bölümleri tarayarak sorgu performansını artırır; sorgu maliyetlerini ve yürütme süresini azaltır. Zaman serisi analizi ve büyük veri kümeleri için özellikle faydalıdır.
BigQuery’de tablo ile görünüm (view) arasındaki fark nedir?
Bir tablo veriyi fiziksel olarak depolar; bir görünüm ise önceden tanımlı bir SQL sorgusuna göre veriyi dinamik olarak getiren sanal bir tablodur. Görünümler, karmaşık sorguları basitleştirmeye, veri erişim kontrollerini uygulamaya ve veriyi çoğaltmadan sorgu yürütme sürelerini iyileştirmeye yardımcı olur.
BigQuery veri güvenliğini nasıl sağlar?
BigQuery, birden çok güvenlik katmanı uygular: (1) Verinin beklemede ve iletimde şifrelenmesi, (2) Ayrıntılı erişim kontrolü için Kimlik ve Erişim Yönetimi (IAM), (3) Kullanım ve uyumluluğu izlemek için denetim günlüğü, ve (4) Gelişmiş güvenlik kontrolü için müşteri tarafından yönetilen şifreleme anahtarları.


