
什么是机器学习中的分类?
分类是一种有监督的机器学习方法,模型尝试为给定的输入数据预测正确的标签。在分类中,模型会先用训练数据进行完整训练,然后在测试数据上进行评估,最后用于对新的未见数据进行预测。
例如,如下图所示,某个算法可以学习预测一封邮件是否为垃圾邮件(spam)或非垃圾邮件(ham)。
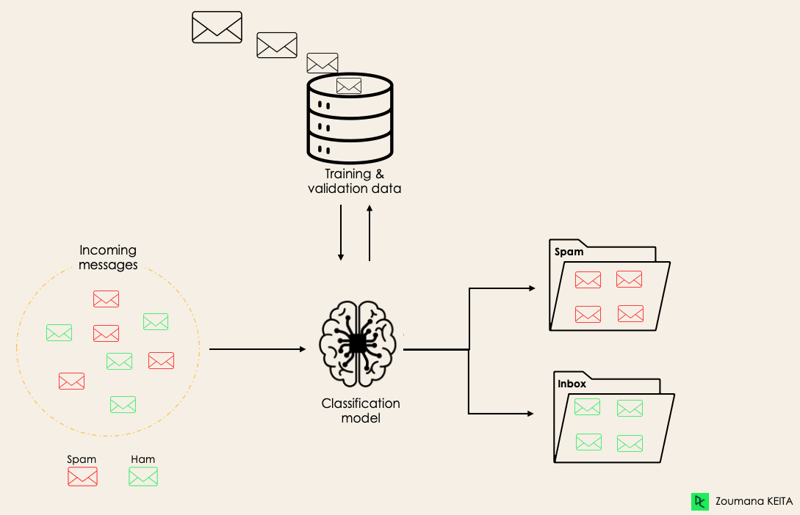 在深入分类概念之前,我们先了解分类中的两类学习器:惰性学习器与积极学习器。随后我们将澄清分类与回归的常见误解。
惰性学习器 vs. 积极学习器
在机器学习分类中有两类学习器:惰性学习器与积极学习器。
积极学习器指的是这类算法会先基于训练数据集构建模型,然后才对未来数据集进行预测。由于在训练阶段通过学习权重力求更好的泛化,它们在训练时耗时更长,但预测时所需时间较少。
大多数机器学习算法都是积极学习器,例如:
- 逻辑回归(Logistic Regression)。
- 支持向量机(Support Vector Machine)。
- 决策树(Decision Trees)。
- 人工神经网络(Artificial Neural Networks)。
惰性学习器(或实例驱动学习器)则不同,它们不会立刻基于训练数据创建任何模型,这也是“惰性”的由来。它们仅记忆训练数据,每次需要预测时,都会在整个训练集中搜索最近邻,因此在预测时较慢。例子包括:
- K 近邻(K-Nearest Neighbor)。
- 基于案例推理(Case-based reasoning)。
不过,一些算法,如BallTrees 与 KDTrees,可用于提升预测时的延迟表现。
机器学习中的分类 vs. 回归
机器学习算法主要分为四类:有监督学习、无监督学习、半监督学习与强化学习。
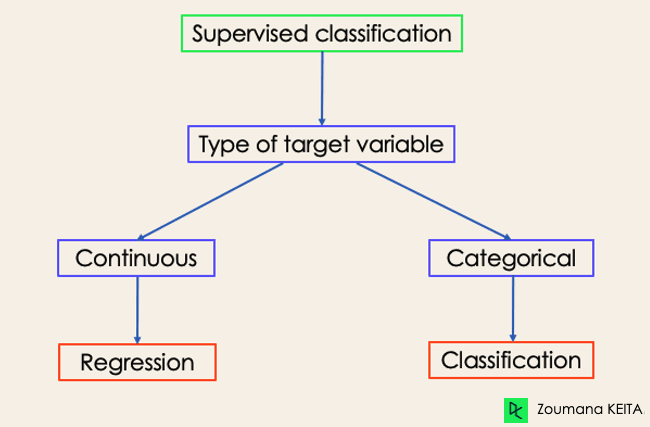
虽然分类与回归都属于有监督学习,但二者并不相同。
- 当目标变量是离散的,预测任务就是分类。例如识别一段文本的潜在情感。
- 当目标变量是连续的,预测任务就是回归。例如根据学历、过往工作经验、地理位置与资历水平预测个人薪资。
如果您想进一步了解分类,使用 scikit-learn 的有监督学习与R 语言的有监督学习(分类)可能会有所帮助。它们能加深您对各算法如何处理任务的理解,并介绍实现所需的 Python 与 R 函数。
关于回归,R 语言回归入门与Python 中使用 statsmodels 的回归入门将帮助您探索不同类型的回归模型及其在 R 与 Python 中的实现。
 机器学习分类的真实案例
有监督的机器学习分类在我们日常生活的多个领域中都有应用。以下是一些示例。
医疗健康
在历史患者数据上训练机器学习模型,可帮助医疗专家更准确地分析诊断:
- 在新冠疫情期间,机器学习模型被用于高效预测个体是否感染新冠。
- 研究人员可以利用机器学习模型预测未来更可能出现的新疾病。
教育
教育领域涉及海量文本、视频与音频数据。这些非结构化信息可借助自然语言技术进行分析,以执行如下任务:
- 按类别对文档进行分类。
- 在申请过程中自动识别学生文档所使用的底层语言。
- 分析学生对某位教授的反馈情感。
交通运输
交通运输是许多国家经济发展的关键组成部分。因此,业界会使用机器学习与深度学习模型:
- 预测哪些地理位置的交通量将会上升。
- 预测特定地点因天气状况可能发生的潜在问题。
可持续农业
农业是人类生存最重要的支柱之一。引入可持续性有助于在不破坏环境的前提下提升农民在不同层面的生产力:
- 使用分类模型预测某类土地是否适合特定种子。
- 预测天气,帮助采取恰当的预防措施。
机器学习中的不同分类任务类型
机器学习中主要有四类分类任务:二元、多类、多标签与不平衡分类。
二元分类
在二元分类任务中,目标是将输入数据划分到两个互斥的类别中。此时训练数据以二元格式标注:真/假、正/负、0/1、垃圾/非垃圾等,具体取决于问题本身。例如,我们可能想检测某张图片是卡车还是船。
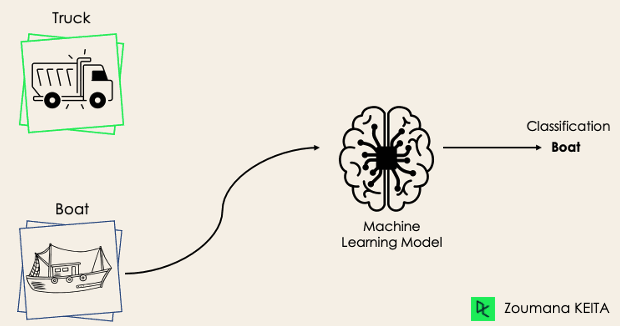
逻辑回归与支持向量机算法原生适用于二元分类。不过,K 近邻与决策树等其他算法也可用于二元分类。
多类分类
多类分类则有至少三种互斥的类别标签,目标是预测给定输入样本属于哪一类。如下图所示,模型将图片正确分类为飞机。
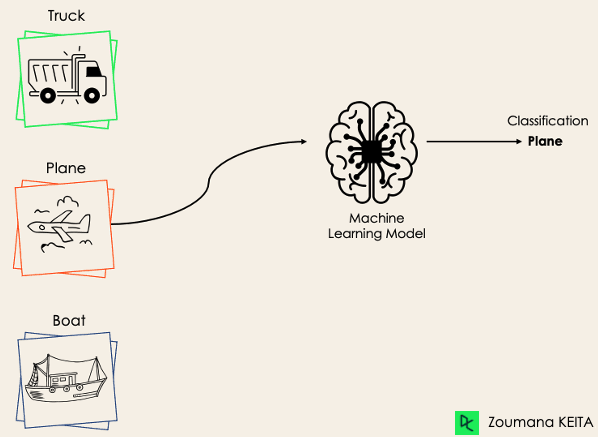
多数二元分类算法也可用于多类分类,这些算法包括但不限于:
- 随机森林
- 朴素贝叶斯
- K 近邻
- 梯度提升
- SVM
- 逻辑回归。
等等!您不是说 SVM 和逻辑回归默认不支持多类分类吗?
→ 没错。不过我们可以采用“一对一”和“一对多”等二元化策略,将原生的二元分类算法改造用于多类分类任务。
一对一(One-versus-one):为每一对标签训练一个分类器。若是三分类,我们会有三对标签,因此有三个分类器,如下图所示。
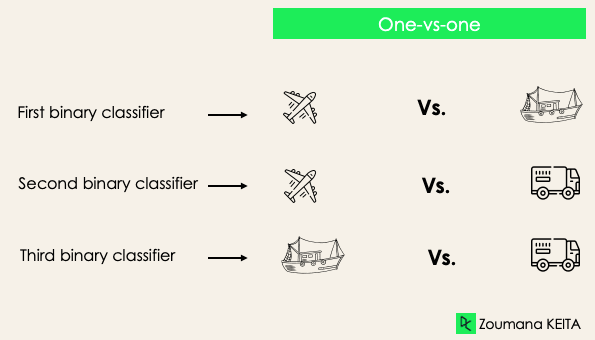
一般而言,对于 N 个标签,我们会有 N×(N-1)/2 个分类器。每个分类器都在一个二元数据集上训练,最终类别由所有分类器的多数投票决定。一对一方法对 SVM 及其他基于核的方法效果较佳。
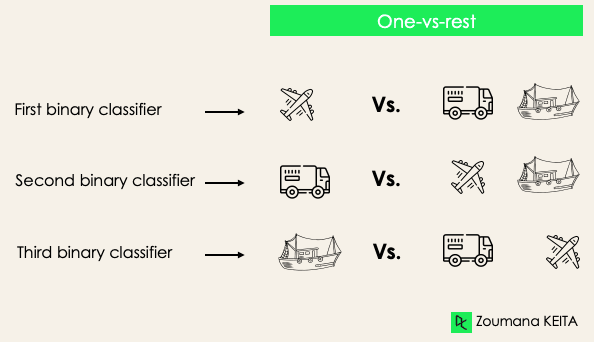
一对多(One-versus-rest):把每个标签分别视为独立的正类,将其余标签合并为一个负类。对于三分类,我们会有三个分类器。
一般而言,对于 N 个标签,我们会有N个二元分类器。
多标签分类
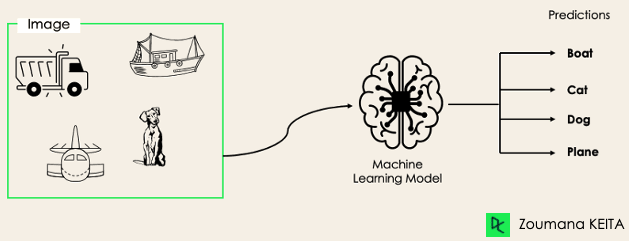
在多标签分类任务中,我们尝试为每个输入样本预测 0 个或多个类别。此时类别并不互斥,因为一个样本可以同时拥有多个标签。
这种情况在多个领域都能看到,例如自然语言处理中的自动打标签:一段文本可能包含多个主题。类似地,在计算机视觉中,一张图片可能包含多个物体,如下所示:模型预测图片包含飞机、船、卡车和狗。
无法直接用多类或二元分类模型来完成多标签分类。不过,多数用于常规分类任务的算法都有针对多标签分类的专门变体,例如:
- 多标签决策树
- 多标签梯度提升
- 多标签随机森林
不平衡分类
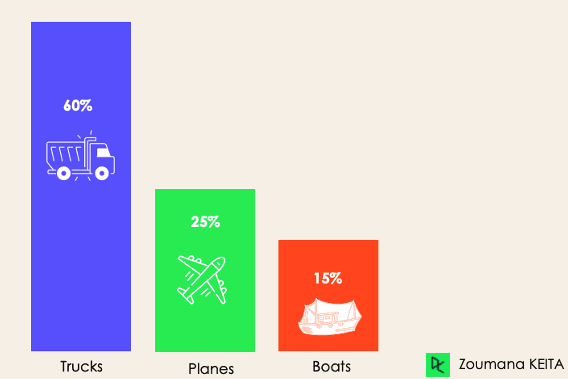
对于不平衡分类,各类别的样本数分布不均,即训练数据中某一类远多于其他类别。考虑如下三分类场景,训练数据包含:卡车占 60%、飞机占 25%、船占 15%。
不平衡分类问题常见于以下场景:
- 金融行业的欺诈交易检测
- 罕见疾病诊断
- 客户流失分析
在处理不平衡数据集时,若使用诸如决策树、逻辑回归等传统预测模型,效果可能并不理想,因为它们可能偏向于预测样本数最多的类别,而将样本较少的类别视为噪声。
这是否意味着此类问题只能搁置?
当然不是!我们可以用多种方法来解决数据集中的不平衡问题。最常用的方法包括采样技术或利用代价敏感算法的力量。
采样技术
这些技术旨在通过如下方式平衡原始分布:
- 基于聚类的过采样:
- 随机欠采样:从多数类中随机删除样本。
- SMOTE 过采样:对少数类样本进行随机合成复制。
代价敏感算法
这类算法会考虑误分类的代价,旨在最小化模型产生的总体代价。
- 代价敏感决策树。
- 代价敏感逻辑回归。
- 代价敏感支持向量机。
评估机器学习分类算法的指标
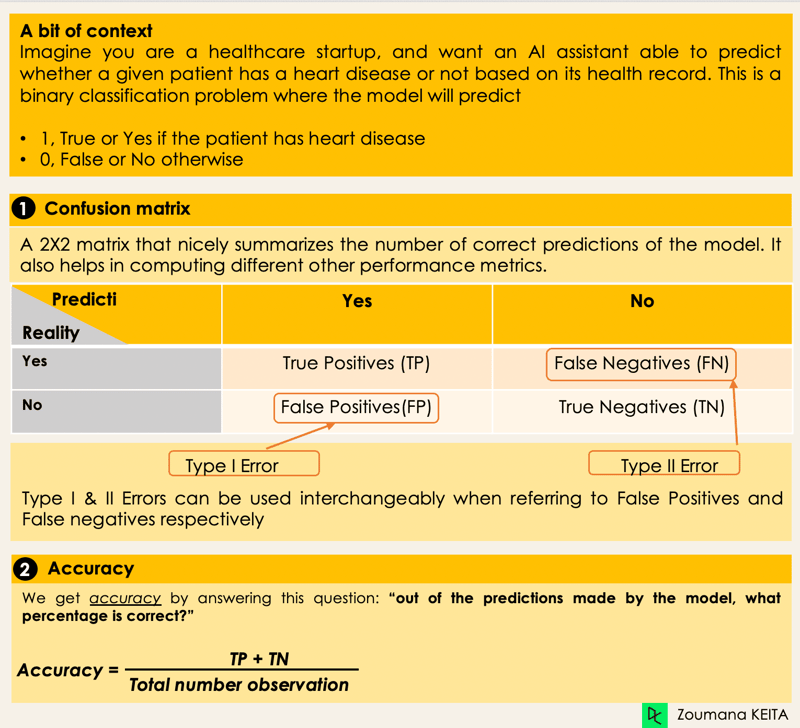
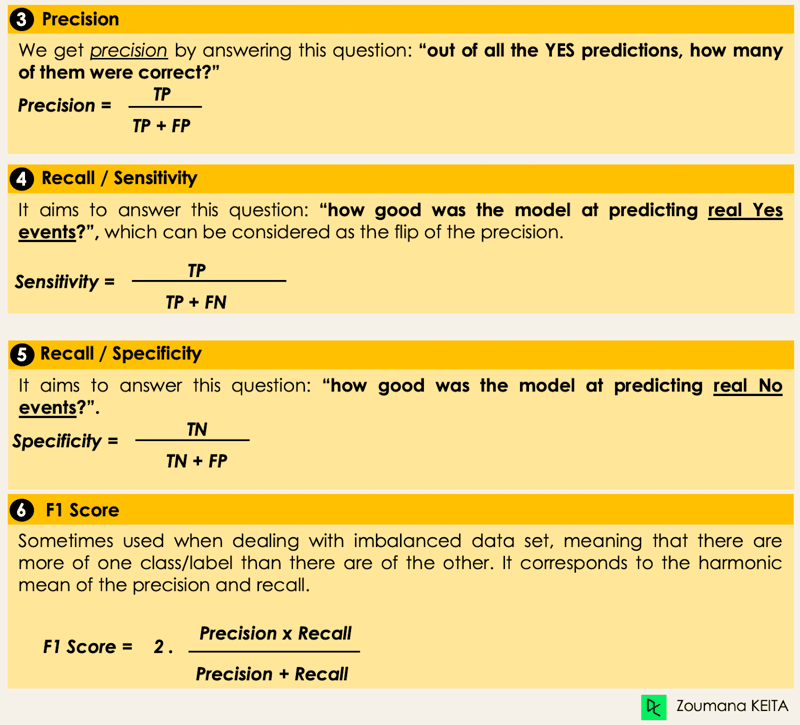
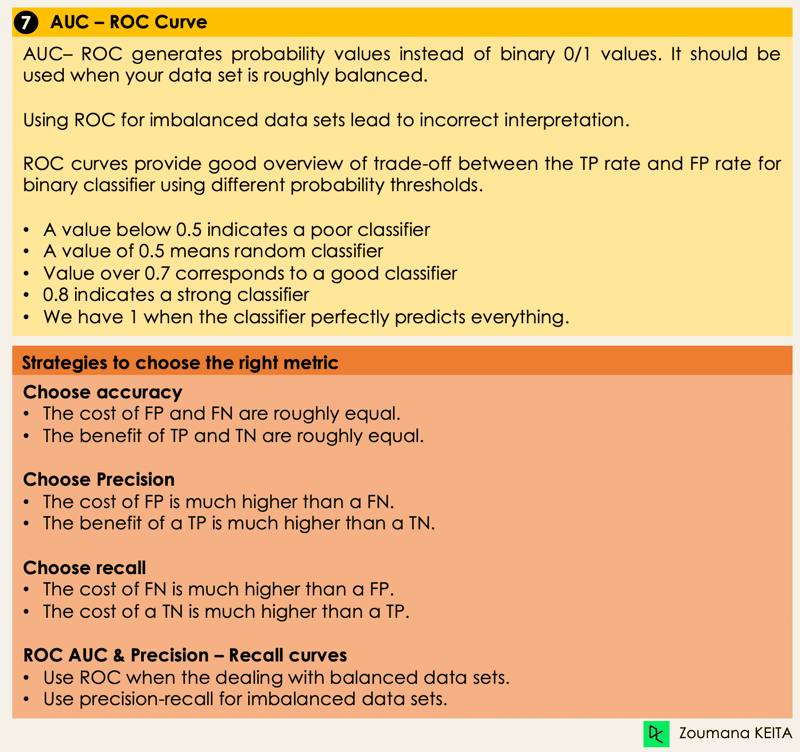
了解了不同类型的分类模型后,为这些模型选对评估指标至关重要。本节将介绍最常用的指标:准确率、精确率、召回率、F1 分数,以及 ROC 曲线(受试者工作特征曲线)与 AUC(曲线下面积)。
深入分类算法
我们已经具备继续实现部分算法所需的工具。本节将基于贷款数据集实现四种算法,以说明先前涵盖的一些概念,尤其是在二元分类任务中处理不平衡数据集。为简明起见,我们只关注四种算法。
目标并非得到最优模型,而是展示如何训练以下每种算法。源代码可在 DataLab 获取,您可一键执行全部内容。
数据集中贷款的分布
- 查看数据集的前五条观测。
import pandas as pd
loan_data = pd.read_csv("loan_data.csv")
loan_data.head()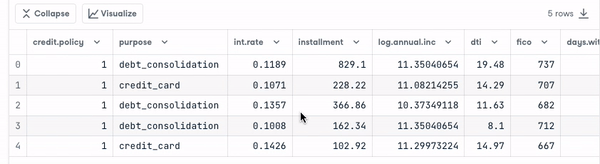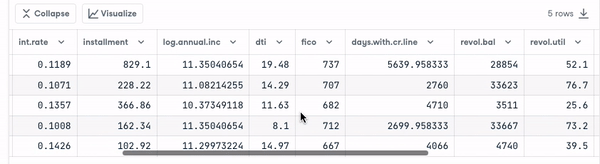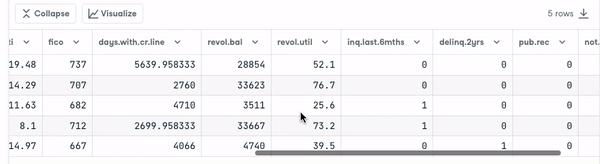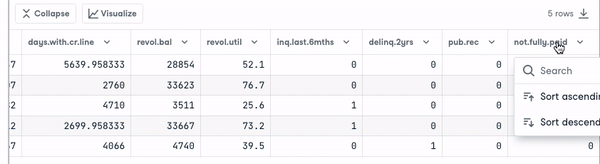
- 数据集中借款人的概况。
import matplotlib.pyplot as plt
# Helper function for data distribution
# Visualize the proportion of borrowers
def show_loan_distrib(data):
count = ""
if isinstance(data, pd.DataFrame):
count = data["not.fully.paid"].value_counts()
else:
count = data.value_counts()
count.plot(kind = 'pie', explode = [0, 0.1],
figsize = (6, 6), autopct = '%1.1f%%', shadow = True)
plt.ylabel("Loan: Fully Paid Vs. Not Fully Paid")
plt.legend(["Fully Paid", "Not Fully Paid"])
plt.show()
# Visualize the proportion of borrowers
show_loan_distrib(loan_data)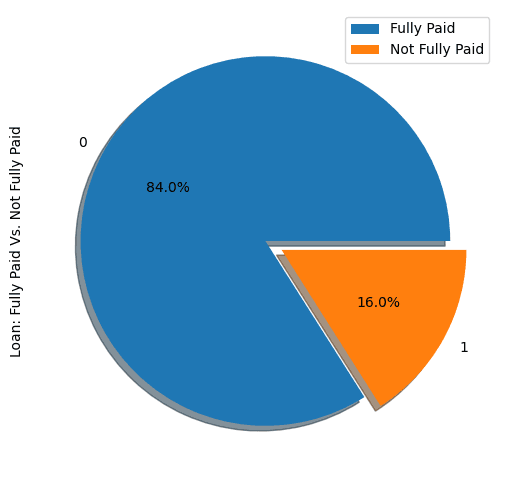
从上图可见,84% 的借款人已还清贷款,只有 16% 未还清,数据集明显不平衡。
变量类型
在继续之前,需要检查变量类型,以便对需要编码的变量进行编码。
我们注意到除 purpose 属性外,所有列都是连续变量,purpose 需要进行编码。
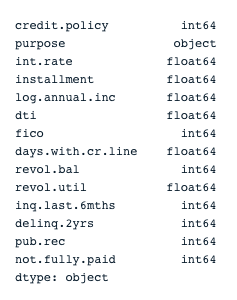
# Check column types
print(loan_data.dtypes)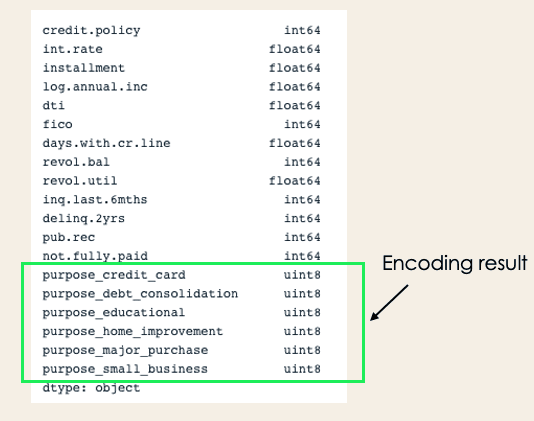
encoded_loan_data = pd.get_dummies(loan_data, prefix="purpose",
drop_first=True)
print(encoded_loan_data.dtypes)划分训练集与测试集
X = encoded_loan_data.drop('not.fully.paid', axis = 1)
y = encoded_loan_data['not.fully.paid']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.30,
stratify = y, random_state=2022)采样策略的应用
这里我们将探索两种采样策略:随机欠采样与 SMOTE 过采样。
随机欠采样
我们将对多数类进行欠采样,对应“已还清”(类别 0)。
X_train_cp = X_train.copy()
X_train_cp['not.fully.paid'] = y_train
y_0 = X_train_cp[X_train_cp['not.fully.paid'] == 0]
y_1 = X_train_cp[X_train_cp['not.fully.paid'] == 1]
y_0_undersample = y_0.sample(y_1.shape[0])
loan_data_undersample = pd.concat([y_0_undersample, y_1], axis = 0)
# Visualize the proportion of borrowers
show_loan_distrib(loan_data_undersample)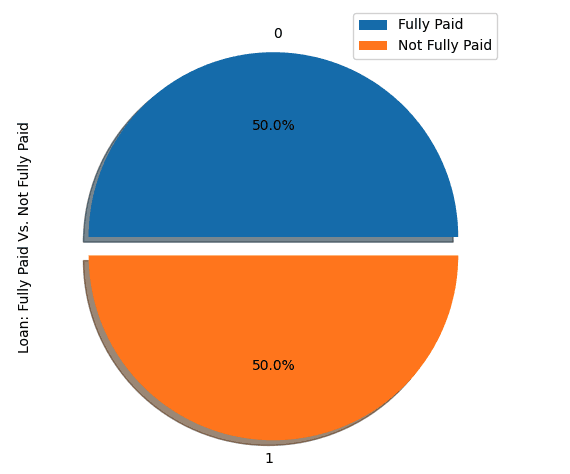
SMOTE 过采样
对少数类进行过采样
smote = SMOTE(sampling_strategy='minority')
X_train_SMOTE, y_train_SMOTE = smote.fit_resample(X_train,y_train)
# Visualize the proportion of borrowers
show_loan_distrib(y_train_SMOTE)应用采样策略后,可以看到不同类型借款人的数据分布已大致均衡。
部分机器学习分类算法的应用
本节将把这两种分类算法应用于 SMOTE 采样后的数据集。相同的训练方法也可用于欠采样数据。
逻辑回归
这是一种可解释的算法。它通过 Sigmoid 函数建模样本属于某一类别的概率,从而对数据点进行分类。
X = loan_data_undersample.drop('not.fully.paid', axis = 1)
y = loan_data_undersample['not.fully.paid']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.15, stratify = y, random_state=2022)
logistic_classifier = LogisticRegression()
logistic_classifier.fit(X_train, y_train)
y_pred = logistic_classifier.predict(X_test)
print(confusion_matrix(y_test,y_pred))
print(classification_report(y_test,y_pred))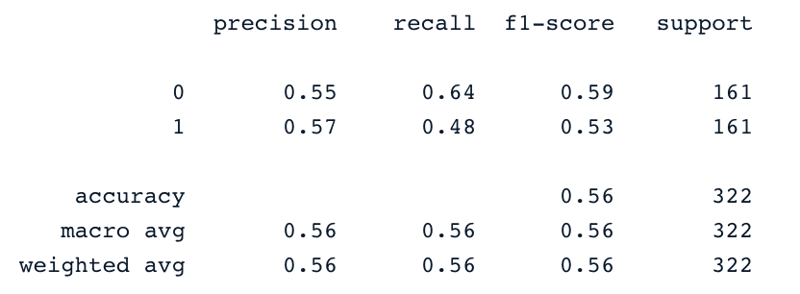
支持向量机(SVM)
该算法可用于分类与回归。它基于“最大化间隔”原则学习绘制超平面(决策边界)。该决策边界由距离边界最近的支持向量确定。
SVM 提供了称为核技巧的变换策略,可将非线性可分的数据投影到更高维空间,使之线性可分。
from sklearn.svm import SVC
svc_classifier = SVC(kernel='linear')
svc_classifier.fit(X_train, y_train)
# Make Prediction & print the result
y_pred = svc_classifier.predict(X_test)
print(classification_report(y_test,y_pred))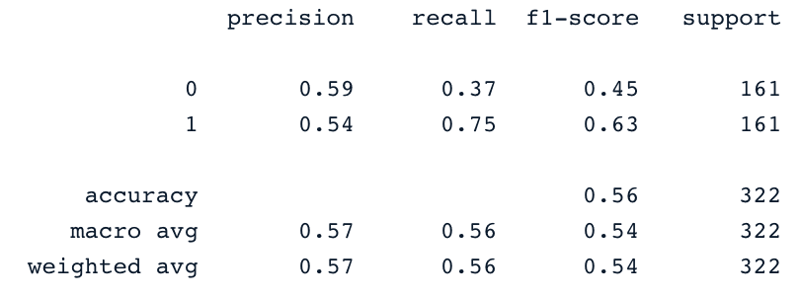
这些结果当然还可以通过更多特征工程和调参来提升,但相比直接使用原始不平衡数据,已经更好。
XGBoost
该算法是著名的梯度提升树(gradient-boosted trees)的扩展。它不仅有助于应对过拟合,还具有速度快与性能佳的优势。
为避免篇幅过长,您可参考Python 树模型机器学习与R 语言树模型机器学习课程。通过这些课程,您将学习如何在 Python 与 R 中实现树模型。
新兴的分类算法与技术
随着机器学习不断发展,新的分类算法与技术不断涌现,带来更好的性能、可扩展性与可解释性。这里我们将探讨自 2022 年以来广受关注的一些重要进展,包括 Transformer、深度集成方法,以及可解释人工智能(XAI)技术。
1. 用于分类的 Transformer
Transformer最初用于处理翻译、文本生成等自然语言处理任务,近期也被改造用于不同领域的多种分类任务。Transformer 的关键创新在于自注意力机制,它能有效衡量输入数据不同部分的重要性。
- 视觉 Transformer(ViT):ViT 将图像视作由若干图块组成的序列,类似文本中的词,从而彻底改变了图像分类方式,并在图像分类基准上取得了最先进表现。
- 表格 Transformer:这些模型在处理结构化数据方面也展现潜力,为表格分类任务提供了随机森林与梯度提升等传统方法之外的替代方案。
Transformer 擅长处理大型且复杂的数据集,已广泛应用于医疗、金融、电商等行业,用于图像识别、欺诈检测与推荐系统等任务。
2. 深度集成方法
深度集成方法通过结合多个模型的预测来提升鲁棒性、准确性与不确定性估计。借助不同模型的优势,这些方法常常能优于单一模型,尤其在复杂分类任务中。
- 堆叠与混合(stacking 与 blending):传统集成技术,通过元分类器或加权平均来结合多个基础分类器的预测。最新进展将深度学习模型整合进这些集成中,构建更强大的分类器。
- 神经网络集成:训练多个具有不同初始化或架构的神经网络,并对其预测求平均。在图像与语音分类等具有挑战性的任务中,它能有效减少过拟合、提升泛化。
- 以多样性为导向的集成:强调最大化个体模型之间的多样性,以降低错误的相关性。诸如装袋(bagging)、提升(boosting)与输出去相关等技术已被改造以适配深度学习模型,为不平衡或噪声数据集提供鲁棒解法。
3. 可解释人工智能(XAI)技术
随着机器学习模型日益复杂,对可解释性与透明度的需求与日俱增。可解释人工智能(XAI)技术被开发出来,使分类模型的决策过程更易于人类理解——这对在医疗、金融等高风险领域建立对 AI 系统的信任尤为关键。
- SHAP(Shapley 加性解释):SHAP 值为特征重要性提供统一度量,通过为预测中的每个特征分配贡献值来实现。该方法适用于各类模型(包括深度学习),有助于理解哪些特征对模型决策影响最大。
- LIME(局部可解释的与模型无关的解释):LIME 通过用一个可解释模型在局部近似原模型来解释单个预测。该方法尤其适合在分类场景中理解神经网络与梯度提升机等复杂模型。
- 反事实解释:寻找能改变分类结果的最小输入变动。这是一种提供可操作洞见的实用方法,例如在信贷评分中,用户可以了解做出哪些改变即可获得贷款批准。
这些 XAI 技术正越来越多地集成进分类模型中,不仅提升透明度,也有助于满足监管要求,例如欧洲的通用数据保护条例(GDPR)要求对自动化决策给出解释。
结论
本文以概念性方式介绍了机器学习中分类的关键方面,并给出了其在不同领域的应用示例。最后,我们在对数据进行欠采样与 SMOTE 过采样以平衡数据集后,演示了逻辑回归与支持向量机的实现。
希望本文能帮助您更好地理解机器学习中的分类主题。您可以继续通过Machine Learning Scientist with Python 学习路径深入学习,涵盖有监督、无监督与深度学习内容,并对自然语言处理、图像处理、Spark 与 Keras 做出良好介绍。
Classification FAQs
SVM 有哪些不同类型的核函数?
SVM 中常见的核函数包括线性核、多项式核、高斯核、径向基函数(RBF)、拉普拉斯 RBF 核、Sigmoid 核, Anova 核、Bessel 函数核。
我们为什么要使用分类?
分类是一种有监督的机器学习方法,用于预测给定输入数据的正确标签。
哪些算法既可用于回归也可用于分类?
我们可以使用 SVM 和神经网络。
多类分类最好的算法是哪种?
有多种算法可选,但最常见的包括 K 近邻、决策树、朴素贝叶斯、随机森林与梯度提升。
小数据集上哪种分类算法最好?
在小数据集上,逻辑回归、SVM 与朴素贝叶斯往往具有更好的泛化能力。
当下,许多行业都在处理不同类型的海量数据。手动处理这些信息既耗时,长期来看也未必有价值。为提升投资回报,人们采用了从简单自动化到机器学习等多种策略。本文将以概念性方式介绍机器学习中最重要的概念之一:分类。
我们将先定义机器学习中的分类是什么,然后澄清机器学习中两类学习器的区别以及分类与回归的差异。接着,介绍分类在现实世界中的一些应用场景。随后,我们将概述不同类型的分类任务,并深入一些分类算法的示例。最后,我们还会提供几个算法实现的动手练习。