想象您正在开发一辆自动驾驶汽车。要让汽车“看见”并理解道路,就必须学会识别行人、交通标志和其他车辆等物体。为此,汽车的机器学习系统需要成千上万——甚至数百万——张真实驾驶场景的图像。
但汽车并不能天生理解图像中的内容。它不知道红色八边形是停止标志,也不知道有人在在人行道上行走。这就是数据标注发挥作用的地方。
数据标注是为原始数据加上标签,使其对机器学习模型可理解、可使用的过程。我们稍后会更详细地解释,但请先记住这一点。
本文将探讨以下内容:
- 不同类型的数据标注
- 使用的技术
- 可用工具
- 最佳实践
- 该过程中面临的挑战
让我们开始吧!
什么是数据标注?
理解数据标注的最佳方式,是联想到您教孩子认识不同动物的情景。起初,您给他们看一张狗的图片,并说:“这是狗。”然后再给他们看一只猫,说:“这是猫。”随着时间推移,通过展示带标签的示例,孩子就能独立识别动物。数据标注对机器而言也是类似的原理。
正如孩子需要带标签的示例(注:说“这是狗”就是在打标签),机器学习模型也需要对数据进行标注,以便从中学习。因此,数据标注是对图像、文本或音频等数据进行标签或标记的过程,使机器学习算法能够识别并理解它。
标签相当于示例,教系统该关注哪些模式。比如,如果您为成千上万张图片标注“狗”或“猫”,模型就会开始识别二者的差异。
一旦从这些示例中学到规律,模型就能对新的未标注数据进行预测或分类,就像孩子最终无需您的帮助也能识别动物一样。
数据标注的类型
不同类型的数据需要采用特定的标注方法,才能为机器学习任务做好准备。根据数据的性质,标注与打标签的方法也各不相同。理解这些类型有助于确定针对各类应用训练模型的最有效方式。
下面来看看最常见的数据标注类型:
图像标注
图像标注是对图像进行标记,使机器学习模型能够识别并解读其中的物体。根据所需细节程度,图像标注可采用不同技术:
边界框
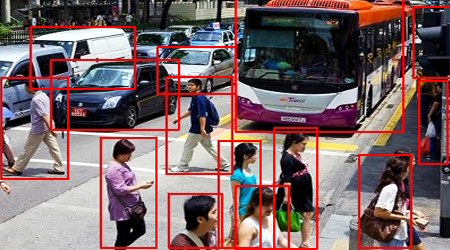
边界框。来源:Anolytics
该方法是在图像中的物体周围绘制矩形,帮助模型识别其存在与位置。边界框常用于自动驾驶技术中检测车辆、行人或标志。
语义分割
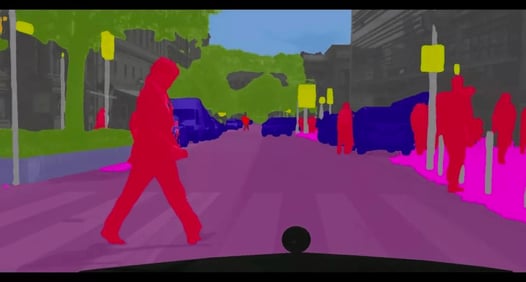
语义分割。来源: Introduction to Semantic Image Segmentation
在这里,图像中的每一个像素都会被标注,以将特定区域分配给特定物体或类别,例如识别道路、建筑或树木。该技术让模型对场景有更精细的理解。
关键点标注
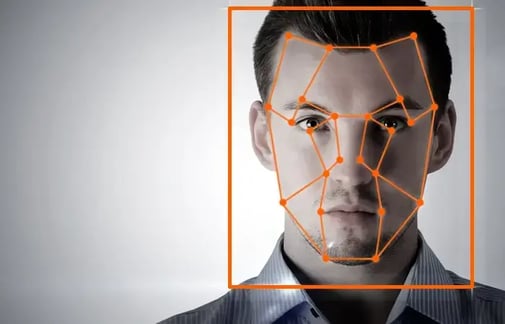
关键点标注。来源:Anolytics
该技术是在图像内标记特定的点,如面部特征或身体姿态的关键点。常用于人脸识别与人体姿态估计等应用。
文本标注
文本标注是对文本数据进行标记与打标签的过程,以便自然语言处理(NLP)模型理解、处理并分析人类语言。
常见的文本标注技术包括:
实体识别
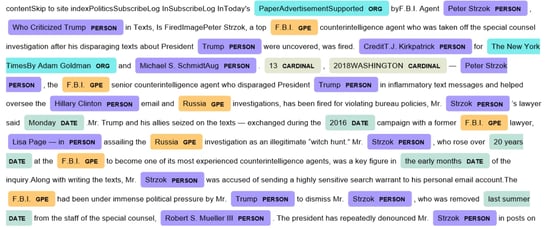
实体识别。来源:Named Entity Recognition and Classification with Scikit-Learn
这包括识别文本中的特定实体,如人名、地名或组织名。例如,在句子“Apple 在纽约开设了一家新店”中,模型会将“Apple”识别为公司,将“纽约”识别为地点。
情感标注
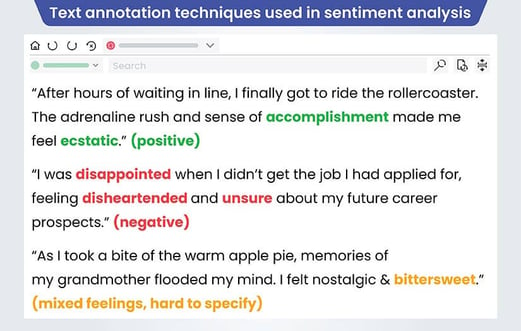
情感标注。来源:Understanding the text annotation process for Customer Sentiment Analysis
该技术为文本片段赋予情绪或观点标签,将其标注为正向、负向或中性。常用于客户评论或社交媒体监测,以了解用户对产品或服务的感受。
词性标注
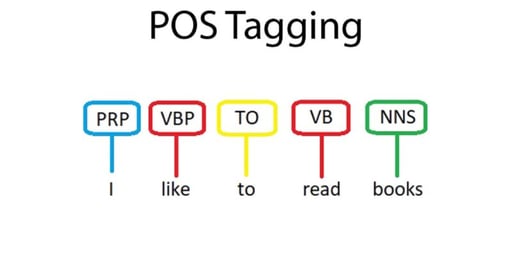
词性标注。来源:POS tagging in NLP
该方法为句子中的每个词标注其语法角色(如名词、动词、形容词),帮助模型理解语言结构,用于翻译或语音识别等任务。
音频标注
音频标注是对声音文件进行标记,以训练模型进行语音识别、音乐检测或声音分类。
常见的音频标注技术包括:
转写
将音频文件中的口语转换为书面文本,常被应用于语音转文本应用。
语音分段
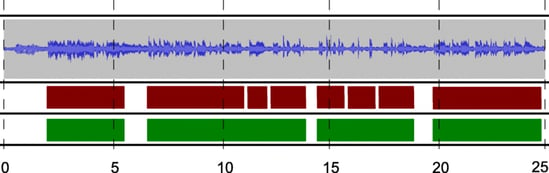
语音分段。来源:ResearchGate
即将音频文件划分为不同片段。例如,您可能希望将对话与背景噪声分离,或识别对话中的不同说话人。
声音标注
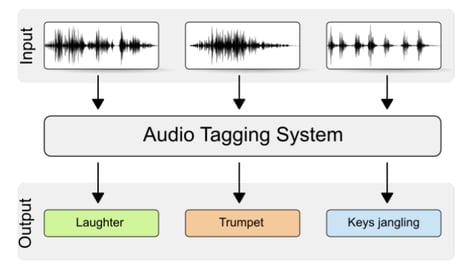
声音标注。来源:Freesound Tagging by VGGish with KNN
声音标注是指在音频文件中对特定声音(如交通噪声、动物叫声等)进行标签。
视频标注
视频标注是对视频帧中的对象或动作进行标记与打标签,帮助机器学习模型解读运动与活动。
关键的视频标注技术包括:
目标跟踪
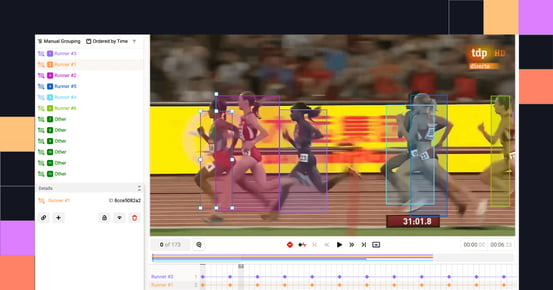
目标跟踪。来源:Label Studio
目标跟踪是指在多个帧中持续为对象打标签,以跟踪其运动。例如,在自动驾驶场景中,可以使用目标跟踪来跟随一辆车穿越繁忙路口。
活动标注
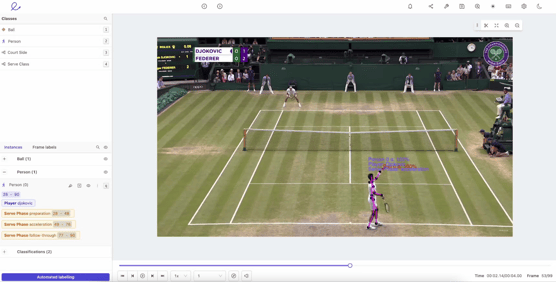
活动标注。来源:Encord
即为特定动作分配标签,比如视频中有人在走路、跑步或坐下等。这有助于模型理解人类行为,适用于安防监控或体育分析等应用。
逐帧标注
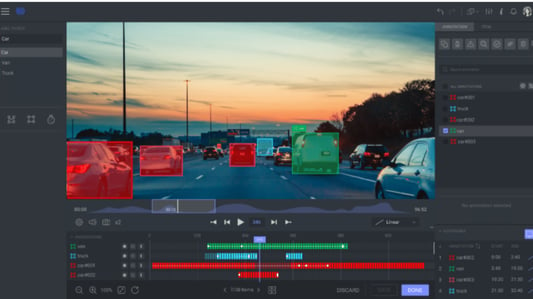
逐帧标注。来源:dataloop
当对视频的每一帧进行标注以捕捉细微细节时,这被称为逐帧检测。它常用于需要高精度的任务,如物理治疗中的身体动作分析。
数据标注的技术路径
用于标注数据的方法会因多种因素而异,例如:
换言之,有些任务需要人工标注员的高准确度,而有些任务则可借助自动化来节省时间并扩展规模。下文将介绍各种方法,帮助您了解各自适用的情境。
人工标注
人工标注是由标注员手动为数据添加标签。在这种方式中,经过训练的标注员会仔细审阅每条数据并应用所需的标签或标记。
人工标注的最大优势在于准确性。由于人类对上下文、细微差别和复杂模式的理解能力优于机器,能确保数据被精确标注。这种准确度对需要高质量、细粒度标注的项目尤为重要,如医学影像标注或复杂的自然语言任务。
不过,人工标注也面临显著挑战:
- 耗时: 对大型数据集进行人工标注非常耗时,尤其当数据复杂或数量庞大时。例如,为成千上万张图像进行计算机视觉项目的标注可能需要数周甚至数月。
- 成本高: 人工标注劳动密集,成本往往较高,尤其当需要专业或专家级标注员(如医疗或法律数据)时。
尽管有这些挑战,对于对精度要求极高的项目,人工标注仍然必不可少,但企业通常会寻求在质量、时间与成本之间取得平衡。
半自动标注
半自动标注将人工专业能力与机器学习辅助相结合。在这种方式中,机器学习模型会通过预标注或提供建议来协助人工标注员。随后,人工标注员会审阅并完善标签以确保准确性。
半自动标注的优势在于加快进度的同时保持较高准确度。机器可以处理重复或简单的任务,让人工标注员专注于更复杂或更含糊的数据点。对于规模较大的项目而言,这种方式理想,因为它在时间效率与质量控制之间取得了平衡。
但它也面临一些挑战:
- 模型建议不准: 机器生成的标签并非总是准确,人工标注员需要花额外时间审查并纠错。
- 持续的人为参与: 尽管有自动化,仍需要人工监督,尤其对复杂数据而言,这可能会放缓进程。
- 前期搭建耗时: 为了让模型能提供有用建议,需要进行设置与训练,这可能耗时,且初期效果不佳会降低自动化带来的益处。
半自动标注最适合需要在质量与速度之间权衡的项目:数据足够复杂,值得人工复核;规模又足够大,需要机器协助。
自动标注
自动标注使用机器学习算法在无人参与的情况下对数据打标签。在这种方式中,预训练模型或 AI 工具会自动为大型数据集加注。这使得流程比人工或半自动方法更快速、更易扩展。
自动标注的主要优势是高效率。它能在人工标注员所需时间的一小部分内处理海量数据。因此,自动标注非常适合数据量巨大的项目,如为计算机视觉模型标注数百万张图片,或为语音识别转录海量音频。
但依赖机器也有以下缺点:
- 准确度较低: 自动系统会出错,尤其在存在歧义、噪声或高度变化的数据上。与人工标注数据相比,质量可能较低。
- 前期成本高: 开发或采购 AI 工具并对其进行训练以实现准确标注,往往需要在成本与时间上投入大量资源。
- 处理复杂数据的局限: 自动标注难以胜任需要理解上下文或细微差别的任务,如判断文本的情绪基调,或识别图像中的细致视觉细节。
自动标注最适用于需要速度与可扩展性的项目,且可容忍一定误差,或后续可借助人工复核进行完善的场景。
众包
众包是将数据标注任务分发给大量参与者,使用平台如Amazon Mechanical Turk或Appen。这种方法通过利用全球劳动力,帮助企业快速且具成本效益地完成大规模数据标注。
众包的主要优势之一是可扩展性。将任务分发给众多参与者,使企业能够高效处理大量数据。例如,需要成千上万张图片或转写的项目,可以在数天内完成,而非数周或数月。
这种方法的不足包括:
- 质量不一致: 由于参与者技能与细致程度不同,标注质量可能参差不齐。企业可能需要采用质量控制措施,如多人标注同一数据或抽样复核以确保准确性。
- 仅适用于较简单任务: 众包最适用于不需要深厚专业知识的基础标注任务。复杂任务(如医学影像或法律文本的标注)往往超出非专业人员的能力范围。
- 协作与管理成本: 管理大量参与者并不容易。确保一致性、制定清晰规范、维护数据隐私在众包场景下尤为关键且具有挑战性。
众包非常适合需要快速、具成本效益的大规模项目,但要想保持高质量成果,就需要强有力的监督与任务管理。
数据标注工具
用于数据标注的工具非常多样,从开源平台到全面的商业解决方案不等,各自面向不同的项目需求而设计。
例如,开源工具通常可定制且免费,适合较小项目或具备技术能力的团队。另一方面,商业方案提供更高级的功能,包括自动化、协作与质量控制,更适合大型项目或希望简化流程的企业。
本节将介绍一些流行的数据标注工具,以及它们如何支持不同类型的数据:
Labelbox
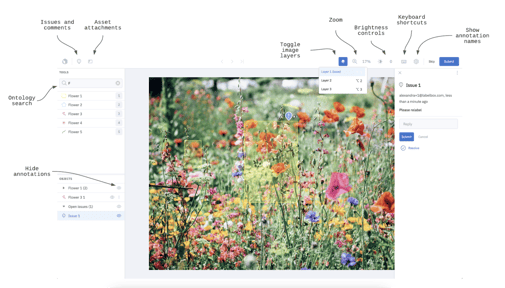
来源:Labelbox Docs
Labelbox 是一款广泛使用的商业平台,致力于简化数据标注流程,侧重协作与质量控制。它由 Manu Sharma、Brian Rieger 和 Peter Welinder 于 2018 年创立,使命是“打造与人工智能高度一致的最佳产品。”
Labelbox 提供直观界面,团队可在其中协作标注数据、跟踪进展并保持高标准的标注质量。它还支持多种数据类型(如图像、视频和文本),使其在不同机器学习项目中极具适用性。
其一大特色是内置质量控制机制,使团队能够审阅与批准标注——从而确保结果一致而准确。
Labelbox 适合希望借助集成的项目管理与自动化功能来扩展标注工作的组织。
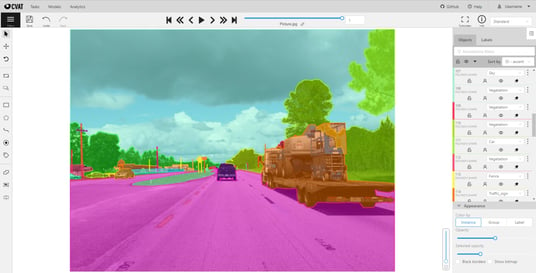
来源:CVAT Wikipedia page
CVAT 是一款专为图像与视频数据集标注而设计的开源工具。由英特尔开发,CVAT 可高度定制,并提供广泛的标注技术(如边界框、多边形与关键点标注)。其灵活性使之适用于从目标检测到人脸识别的各类项目。
作为开源工具,CVAT 免费可用,且可按需定制以满足特定项目需求。这使其成为研究人员与小型团队的热门之选,他们需要强大的标注工具而不愿承担商业软件的成本。
Prodigy
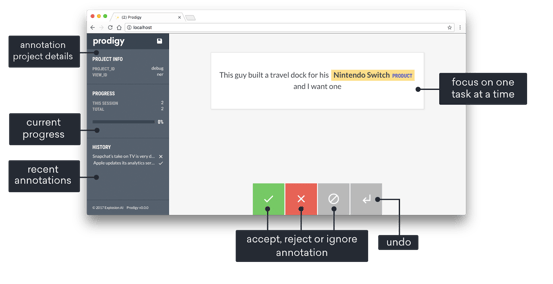
来源:Prodigy Docs
Prodigy 是由 Explosion AI 开发的高级标注工具,利用主动学习提升效率,尤其适用于自然语言处理(NLP)任务。在 Prodigy 中,机器学习模型会根据预测向标注员建议标签,随后由人工复核确认或纠正。
这种交互式方式在加速标注流程的同时,确保标注数据高质量。尽管是商业工具,Prodigy 仍具有高度可定制性,例如可自定义标注工作流。以上特点使 Prodigy 非常适合从事情感分析、实体识别或文本分类等特定 NLP 项目的团队。
Amazon SageMaker Ground Truth
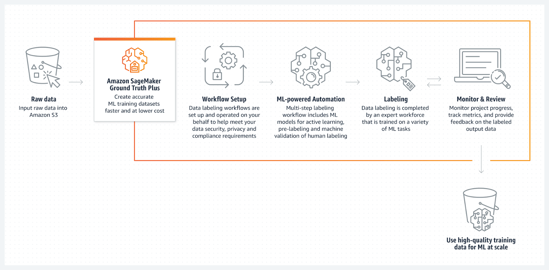
来源: Amazon SageMaker Ground Truth
亚马Amazon SageMaker Ground Truth 是一项完全托管的数据标注服务,可与 AWS 无缝集成。它提供手动与自动化的数据标注工具,使用户能够快速且准确地完成标注。
SageMaker Ground Truth 使用机器学习来辅助人工标注,通过预标注加速流程并降低成本。该服务支持多种数据类型,包括图像、文本与视频,是一项在不同机器学习任务中极具通用性的选择。
此外,它具备良好的可扩展性,对需要在 AWS 生态内开展大规模标注能力的企业而言,是一个强有力的选项。
其他可考虑的工具
- LabelImg: 一款专注于图像标注的开源工具。支持为目标检测创建与编辑边界框。
- VGG Image Annotator(VIA): 轻量、易用的图像与视频标注工具,非常适合需要基础标注功能的研究人员或小型项目。
- Dataloop: 商业平台,结合了标注工具与数据管理、自动化功能,适合需要可扩展标注工作流并集成 AI 能力的团队。
数据标注的最佳实践
高效的数据标注对机器学习模型的成功至关重要,因为带标签数据的质量会直接影响模型的预测与分类准确性。遵循最佳实践有助于确保标注过程高效且可靠。
本节将介绍提升数据标注质量与一致性的关键做法,并探讨标注过程中可能面临的挑战。
制定清晰的标注规范
数据标注过程中最重要的步骤之一,是制定清晰、明确的规范。规范应明确说明数据如何标注,以及标注员应遵循哪些标准以保持一致性。
清晰的规范有助于:
对于复杂或主观性较强的数据(如存在多种解释的图像或文本),制定统一规则尤为关键。
质量保障
质量对于保持标注数据的准确性与可靠性至关重要。因此,应定期审查已标注数据,确保其达到所需标准。可通过随机抽查、同一任务由多名标注员完成(用于结果对比)或交叉核对等方式来实施,具体取决于项目情况。
核心要点是,务必实施健全的数据质量保障流程,帮助您尽早发现错误、降低数据偏差,并确保标注数据适合用于训练高性能的机器学习模型。
利用主动学习
主动学习是一种机器学习技术,允许算法选择最具信息量的数据样本进行标注,从而提升模型表现。该技术能显著提高标注效率:让标注员将时间与精力集中于最具挑战、最有价值的数据点,其余由算法给出建议。
这种方法减少了在简单或重复样本上的标注时间,加快整体进度,并提升用于训练的关键样本占比,从而提高模型预测的有效性。
确保标注员培训
为确保标注过程准确无误,应为标注员提供适当培训。培训能帮助标注员理解任务的具体要求,并正确应用标注规范。
受过良好训练的标注员更可能产出高质量的带标签数据,最终提升所支持机器学习模型的性能。定期的培训与反馈机制还能不断打磨标注员技能,进一步优化数据标注流程。
数据标注的挑战
尽管数据标注是训练高精度机器学习模型的关键步骤,但这一过程本身也面临诸多挑战。本节将讨论数据标注中最常见的一些难点。
成本与时间限制
人工数据标注 往往劳动密集。为所有样本完成标注需要大量时间与资金投入,尤其在数据集庞大时。数据越复杂(如视频或结构精细的图像),标注就越耗时。还需要聘请熟练标注员,从而增加成本。
为克服这一挑战,组织可以使用半自动标注工具,由机器学习模型提供标签建议,再由人工确认。这样在不牺牲准确性的情况下加快进度。
主动学习也能提供帮助:将人力聚焦于信息量最大的样本,减少需要人工标注的数据总量。此外,使用如 Amazon Mechanical Turk 等众包平台,可让多人同步作业,从而以更低成本、更高效率完成大规模标注。
主观性与偏差
另一个关键挑战是标注过程中的主观性与偏差。不同标注员可能对同一数据有不同解读。这在文本情绪标注或复杂图像中的目标识别任务中尤为常见。问题在于,主观性会将偏差引入带标签数据,进而导致模型预测出现偏差。
为降低主观性与偏差,应制定清晰、详尽的标注规范,确保所有标注员遵循相同标准。另一种做法是对同一数据采用多名标注员进行标注,通过交叉核对发现并纠正有偏或不一致的标注。
数据隐私问题
可能暴露身份信息的标注会违反保护个人数据的隐私法规。尤其在外包标注任务或使用众包平台时,众多参与者将接触数据,此问题更为突出。
通过匿名化(移除可识别个人身份的信息)以及使用安全、加密的平台进行标注等措施,可以帮助降低这些风险。
数据标注的真实应用
本节将探讨数据标注的真实世界应用。开始吧!
自动驾驶
在自动驾驶中,数据标注是让 AI 安全导航现实世界的基石。自动驾驶汽车依赖标注数据来识别对象。
例如,标注员会通过为车辆绘制边界框或标记车道边界来进行车道线检测。这些标注帮助 AI 学会如何识别并应对各类道路场景,如为行人停车或保持在正确车道内行驶。
医疗健康
AI 模型需要带标签的医学影像来学习如何检测异常。例如,熟练的标注员会在图像上勾勒特定区域,以标记早期癌症迹象。这使得 AI 能够比传统方法更快、更准确地发现癌症,从而改善患者预后并减轻医务人员的工作负担。
客服聊天机器人
对于客服聊天机器人而言,文本标注对于教会 AI 理解人类语言至关重要。
例如,标注员可能为文本打标签,以帮助机器人识别用户意图。随后,机器人会分析这些带标签的交互,学习如何给出恰当的回应。借此,组织能够更快、更准确地提供帮助,提升客户体验。
情感分析
在情感分析中,文本标注用于衡量客户对某些事物(如品牌、产品或事件)的感受。其工作方式是,标注员将短语或句子标注为正向、负向或中性,然后将这些数据交给 AI 学习其中的情感。企业随后可部署该模型来监测客户对新品发布的反馈。
结语
数据标注是为数据加上标签,使其可被机器学习模型识别与使用的过程。它是构建能够准确解读并响应现实世界数据的 AI 系统的关键步骤。原因在于:标注数据的质量与准确性将直接影响 AI 模型的性能与效果。
归根结底,数据标注是打造智能、可靠 AI 系统的基础,这些系统能够推动各行业的创新。因此,它是机器学习开发中不可或缺的一部分。
若要继续学习,请查看以下资源:


想象您正在开发一辆自动驾驶汽车。要让汽车“看见”并理解道路,就必须学会识别行人、交通标志和其他车辆等物体。为此,汽车的机器学习系统需要成千上万——甚至数百万——张真实驾驶场景的图像。
但汽车并不能天生理解图像中的内容。它不知道红色八边形是停止标志,也不知道有人在在人行道上行走。这就是数据标注发挥作用的地方。
数据标注是为原始数据加上标签,使其对机器学习模型可理解、可使用的过程。我们稍后会更详细地解释,但请先记住这一点。
本文将探讨以下内容:
让我们开始吧!
什么是数据标注?
理解数据标注的最佳方式,是联想到您教孩子认识不同动物的情景。起初,您给他们看一张狗的图片,并说:“这是狗。”然后再给他们看一只猫,说:“这是猫。”随着时间推移,通过展示带标签的示例,孩子就能独立识别动物。数据标注对机器而言也是类似的原理。
正如孩子需要带标签的示例(注:说“这是狗”就是在打标签),机器学习模型也需要对数据进行标注,以便从中学习。因此,数据标注是对图像、文本或音频等数据进行标签或标记的过程,使机器学习算法能够识别并理解它。
标签相当于示例,教系统该关注哪些模式。比如,如果您为成千上万张图片标注“狗”或“猫”,模型就会开始识别二者的差异。
一旦从这些示例中学到规律,模型就能对新的未标注数据进行预测或分类,就像孩子最终无需您的帮助也能识别动物一样。
数据标注的类型
不同类型的数据需要采用特定的标注方法,才能为机器学习任务做好准备。根据数据的性质,标注与打标签的方法也各不相同。理解这些类型有助于确定针对各类应用训练模型的最有效方式。
下面来看看最常见的数据标注类型:
图像标注
图像标注是对图像进行标记,使机器学习模型能够识别并解读其中的物体。根据所需细节程度,图像标注可采用不同技术:
边界框
边界框。来源:Anolytics
该方法是在图像中的物体周围绘制矩形,帮助模型识别其存在与位置。边界框常用于自动驾驶技术中检测车辆、行人或标志。
语义分割
语义分割。来源: Introduction to Semantic Image Segmentation
在这里,图像中的每一个像素都会被标注,以将特定区域分配给特定物体或类别,例如识别道路、建筑或树木。该技术让模型对场景有更精细的理解。
关键点标注
关键点标注。来源:Anolytics
该技术是在图像内标记特定的点,如面部特征或身体姿态的关键点。常用于人脸识别与人体姿态估计等应用。
文本标注
文本标注是对文本数据进行标记与打标签的过程,以便自然语言处理(NLP)模型理解、处理并分析人类语言。
常见的文本标注技术包括:
实体识别
实体识别。来源:Named Entity Recognition and Classification with Scikit-Learn
这包括识别文本中的特定实体,如人名、地名或组织名。例如,在句子“Apple 在纽约开设了一家新店”中,模型会将“Apple”识别为公司,将“纽约”识别为地点。
情感标注
情感标注。来源:Understanding the text annotation process for Customer Sentiment Analysis
该技术为文本片段赋予情绪或观点标签,将其标注为正向、负向或中性。常用于客户评论或社交媒体监测,以了解用户对产品或服务的感受。
词性标注
词性标注。来源:POS tagging in NLP
该方法为句子中的每个词标注其语法角色(如名词、动词、形容词),帮助模型理解语言结构,用于翻译或语音识别等任务。
音频标注
音频标注是对声音文件进行标记,以训练模型进行语音识别、音乐检测或声音分类。
常见的音频标注技术包括:
转写
将音频文件中的口语转换为书面文本,常被应用于语音转文本应用。
语音分段
语音分段。来源:ResearchGate
即将音频文件划分为不同片段。例如,您可能希望将对话与背景噪声分离,或识别对话中的不同说话人。
声音标注
声音标注。来源:Freesound Tagging by VGGish with KNN
声音标注是指在音频文件中对特定声音(如交通噪声、动物叫声等)进行标签。
视频标注
视频标注是对视频帧中的对象或动作进行标记与打标签,帮助机器学习模型解读运动与活动。
关键的视频标注技术包括:
目标跟踪
目标跟踪。来源:Label Studio
目标跟踪是指在多个帧中持续为对象打标签,以跟踪其运动。例如,在自动驾驶场景中,可以使用目标跟踪来跟随一辆车穿越繁忙路口。
活动标注
活动标注。来源:Encord
即为特定动作分配标签,比如视频中有人在走路、跑步或坐下等。这有助于模型理解人类行为,适用于安防监控或体育分析等应用。
逐帧标注
逐帧标注。来源:dataloop
当对视频的每一帧进行标注以捕捉细微细节时,这被称为逐帧检测。它常用于需要高精度的任务,如物理治疗中的身体动作分析。
数据标注的技术路径
用于标注数据的方法会因多种因素而异,例如:
换言之,有些任务需要人工标注员的高准确度,而有些任务则可借助自动化来节省时间并扩展规模。下文将介绍各种方法,帮助您了解各自适用的情境。
人工标注
人工标注是由标注员手动为数据添加标签。在这种方式中,经过训练的标注员会仔细审阅每条数据并应用所需的标签或标记。
人工标注的最大优势在于准确性。由于人类对上下文、细微差别和复杂模式的理解能力优于机器,能确保数据被精确标注。这种准确度对需要高质量、细粒度标注的项目尤为重要,如医学影像标注或复杂的自然语言任务。
不过,人工标注也面临显著挑战:
尽管有这些挑战,对于对精度要求极高的项目,人工标注仍然必不可少,但企业通常会寻求在质量、时间与成本之间取得平衡。
半自动标注
半自动标注将人工专业能力与机器学习辅助相结合。在这种方式中,机器学习模型会通过预标注或提供建议来协助人工标注员。随后,人工标注员会审阅并完善标签以确保准确性。
半自动标注的优势在于加快进度的同时保持较高准确度。机器可以处理重复或简单的任务,让人工标注员专注于更复杂或更含糊的数据点。对于规模较大的项目而言,这种方式理想,因为它在时间效率与质量控制之间取得了平衡。
但它也面临一些挑战:
半自动标注最适合需要在质量与速度之间权衡的项目:数据足够复杂,值得人工复核;规模又足够大,需要机器协助。
自动标注
自动标注使用机器学习算法在无人参与的情况下对数据打标签。在这种方式中,预训练模型或 AI 工具会自动为大型数据集加注。这使得流程比人工或半自动方法更快速、更易扩展。
自动标注的主要优势是高效率。它能在人工标注员所需时间的一小部分内处理海量数据。因此,自动标注非常适合数据量巨大的项目,如为计算机视觉模型标注数百万张图片,或为语音识别转录海量音频。
但依赖机器也有以下缺点:
自动标注最适用于需要速度与可扩展性的项目,且可容忍一定误差,或后续可借助人工复核进行完善的场景。
众包
众包是将数据标注任务分发给大量参与者,使用平台如Amazon Mechanical Turk或Appen。这种方法通过利用全球劳动力,帮助企业快速且具成本效益地完成大规模数据标注。
众包的主要优势之一是可扩展性。将任务分发给众多参与者,使企业能够高效处理大量数据。例如,需要成千上万张图片或转写的项目,可以在数天内完成,而非数周或数月。
这种方法的不足包括:
众包非常适合需要快速、具成本效益的大规模项目,但要想保持高质量成果,就需要强有力的监督与任务管理。
数据标注工具
用于数据标注的工具非常多样,从开源平台到全面的商业解决方案不等,各自面向不同的项目需求而设计。
例如,开源工具通常可定制且免费,适合较小项目或具备技术能力的团队。另一方面,商业方案提供更高级的功能,包括自动化、协作与质量控制,更适合大型项目或希望简化流程的企业。
本节将介绍一些流行的数据标注工具,以及它们如何支持不同类型的数据:
Labelbox
来源:Labelbox Docs
Labelbox 是一款广泛使用的商业平台,致力于简化数据标注流程,侧重协作与质量控制。它由 Manu Sharma、Brian Rieger 和 Peter Welinder 于 2018 年创立,使命是“打造与人工智能高度一致的最佳产品。”
Labelbox 提供直观界面,团队可在其中协作标注数据、跟踪进展并保持高标准的标注质量。它还支持多种数据类型(如图像、视频和文本),使其在不同机器学习项目中极具适用性。
其一大特色是内置质量控制机制,使团队能够审阅与批准标注——从而确保结果一致而准确。
Labelbox 适合希望借助集成的项目管理与自动化功能来扩展标注工作的组织。
CVAT(Computer Vision Annotation Tool)
来源:CVAT Wikipedia page
CVAT 是一款专为图像与视频数据集标注而设计的开源工具。由英特尔开发,CVAT 可高度定制,并提供广泛的标注技术(如边界框、多边形与关键点标注)。其灵活性使之适用于从目标检测到人脸识别的各类项目。
作为开源工具,CVAT 免费可用,且可按需定制以满足特定项目需求。这使其成为研究人员与小型团队的热门之选,他们需要强大的标注工具而不愿承担商业软件的成本。
Prodigy
来源:Prodigy Docs
Prodigy 是由 Explosion AI 开发的高级标注工具,利用主动学习提升效率,尤其适用于自然语言处理(NLP)任务。在 Prodigy 中,机器学习模型会根据预测向标注员建议标签,随后由人工复核确认或纠正。
这种交互式方式在加速标注流程的同时,确保标注数据高质量。尽管是商业工具,Prodigy 仍具有高度可定制性,例如可自定义标注工作流。以上特点使 Prodigy 非常适合从事情感分析、实体识别或文本分类等特定 NLP 项目的团队。
Amazon SageMaker Ground Truth
来源: Amazon SageMaker Ground Truth
亚马Amazon SageMaker Ground Truth 是一项完全托管的数据标注服务,可与 AWS 无缝集成。它提供手动与自动化的数据标注工具,使用户能够快速且准确地完成标注。
SageMaker Ground Truth 使用机器学习来辅助人工标注,通过预标注加速流程并降低成本。该服务支持多种数据类型,包括图像、文本与视频,是一项在不同机器学习任务中极具通用性的选择。
此外,它具备良好的可扩展性,对需要在 AWS 生态内开展大规模标注能力的企业而言,是一个强有力的选项。
其他可考虑的工具
数据标注的最佳实践
高效的数据标注对机器学习模型的成功至关重要,因为带标签数据的质量会直接影响模型的预测与分类准确性。遵循最佳实践有助于确保标注过程高效且可靠。
本节将介绍提升数据标注质量与一致性的关键做法,并探讨标注过程中可能面临的挑战。
制定清晰的标注规范
数据标注过程中最重要的步骤之一,是制定清晰、明确的规范。规范应明确说明数据如何标注,以及标注员应遵循哪些标准以保持一致性。
清晰的规范有助于:
对于复杂或主观性较强的数据(如存在多种解释的图像或文本),制定统一规则尤为关键。
质量保障
质量对于保持标注数据的准确性与可靠性至关重要。因此,应定期审查已标注数据,确保其达到所需标准。可通过随机抽查、同一任务由多名标注员完成(用于结果对比)或交叉核对等方式来实施,具体取决于项目情况。
核心要点是,务必实施健全的数据质量保障流程,帮助您尽早发现错误、降低数据偏差,并确保标注数据适合用于训练高性能的机器学习模型。
利用主动学习
主动学习是一种机器学习技术,允许算法选择最具信息量的数据样本进行标注,从而提升模型表现。该技术能显著提高标注效率:让标注员将时间与精力集中于最具挑战、最有价值的数据点,其余由算法给出建议。
这种方法减少了在简单或重复样本上的标注时间,加快整体进度,并提升用于训练的关键样本占比,从而提高模型预测的有效性。
确保标注员培训
为确保标注过程准确无误,应为标注员提供适当培训。培训能帮助标注员理解任务的具体要求,并正确应用标注规范。
受过良好训练的标注员更可能产出高质量的带标签数据,最终提升所支持机器学习模型的性能。定期的培训与反馈机制还能不断打磨标注员技能,进一步优化数据标注流程。
数据标注的挑战
尽管数据标注是训练高精度机器学习模型的关键步骤,但这一过程本身也面临诸多挑战。本节将讨论数据标注中最常见的一些难点。
成本与时间限制
人工数据标注 往往劳动密集。为所有样本完成标注需要大量时间与资金投入,尤其在数据集庞大时。数据越复杂(如视频或结构精细的图像),标注就越耗时。还需要聘请熟练标注员,从而增加成本。
为克服这一挑战,组织可以使用半自动标注工具,由机器学习模型提供标签建议,再由人工确认。这样在不牺牲准确性的情况下加快进度。
主动学习也能提供帮助:将人力聚焦于信息量最大的样本,减少需要人工标注的数据总量。此外,使用如 Amazon Mechanical Turk 等众包平台,可让多人同步作业,从而以更低成本、更高效率完成大规模标注。
主观性与偏差
另一个关键挑战是标注过程中的主观性与偏差。不同标注员可能对同一数据有不同解读。这在文本情绪标注或复杂图像中的目标识别任务中尤为常见。问题在于,主观性会将偏差引入带标签数据,进而导致模型预测出现偏差。
为降低主观性与偏差,应制定清晰、详尽的标注规范,确保所有标注员遵循相同标准。另一种做法是对同一数据采用多名标注员进行标注,通过交叉核对发现并纠正有偏或不一致的标注。
数据隐私问题
可能暴露身份信息的标注会违反保护个人数据的隐私法规。尤其在外包标注任务或使用众包平台时,众多参与者将接触数据,此问题更为突出。
通过匿名化(移除可识别个人身份的信息)以及使用安全、加密的平台进行标注等措施,可以帮助降低这些风险。
数据标注的真实应用
本节将探讨数据标注的真实世界应用。开始吧!
自动驾驶
在自动驾驶中,数据标注是让 AI 安全导航现实世界的基石。自动驾驶汽车依赖标注数据来识别对象。
例如,标注员会通过为车辆绘制边界框或标记车道边界来进行车道线检测。这些标注帮助 AI 学会如何识别并应对各类道路场景,如为行人停车或保持在正确车道内行驶。
医疗健康
AI 模型需要带标签的医学影像来学习如何检测异常。例如,熟练的标注员会在图像上勾勒特定区域,以标记早期癌症迹象。这使得 AI 能够比传统方法更快、更准确地发现癌症,从而改善患者预后并减轻医务人员的工作负担。
客服聊天机器人
对于客服聊天机器人而言,文本标注对于教会 AI 理解人类语言至关重要。
例如,标注员可能为文本打标签,以帮助机器人识别用户意图。随后,机器人会分析这些带标签的交互,学习如何给出恰当的回应。借此,组织能够更快、更准确地提供帮助,提升客户体验。
情感分析
在情感分析中,文本标注用于衡量客户对某些事物(如品牌、产品或事件)的感受。其工作方式是,标注员将短语或句子标注为正向、负向或中性,然后将这些数据交给 AI 学习其中的情感。企业随后可部署该模型来监测客户对新品发布的反馈。
结语
数据标注是为数据加上标签,使其可被机器学习模型识别与使用的过程。它是构建能够准确解读并响应现实世界数据的 AI 系统的关键步骤。原因在于:标注数据的质量与准确性将直接影响 AI 模型的性能与效果。
归根结底,数据标注是打造智能、可靠 AI 系统的基础,这些系统能够推动各行业的创新。因此,它是机器学习开发中不可或缺的一部分。
若要继续学习,请查看以下资源: