
Last chance! 50% off DataCamp Premium
Sale ends in
Bayangkan Anda sedang mengembangkan mobil tanpa pengemudi. Agar mobil dapat "melihat" dan memahami jalan, ia harus belajar mengenali objek seperti pejalan kaki, rambu lalu lintas, dan kendaraan lain. Untuk mewujudkannya, sistem machine learning mobil memerlukan ribuan—bahkan jutaan—gambar dari skenario berkendara di dunia nyata.
Namun mobil tidak secara bawaan memahami apa yang ada di dalam gambar. Ia tidak tahu bahwa segi delapan merah adalah tanda berhenti atau bahwa seseorang sedang berjalan di trotoar. Di sinilah data annotation berperan.
Data annotation adalah proses memberi label pada data mentah agar dapat dipahami dan digunakan oleh model machine learning. Kami akan menjelaskannya lebih dalam nanti, tetapi ingatlah hal ini.
Berikut yang akan kita bahas dalam artikel ini:
Mari kita mulai!
Cara terbaik memahami data annotation adalah membayangkan saat Anda mengajari anak-anak tentang berbagai hewan. Pada awalnya, Anda menunjukkan gambar anjing dan berkata, “Ini anjing.” Lalu Anda menunjukkan kucing dan berkata, “Ini kucing.” Seiring waktu, dengan menunjukkan contoh berlabel, anak akan belajar mengidentifikasi hewan secara mandiri. Data annotation bekerja dengan cara serupa untuk mesin.
Sama seperti anak membutuhkan contoh berlabel (catatan: mengatakan “Ini anjing” adalah pelabelan), model machine learning memerlukan data yang dianotasi untuk dipelajari. Jadi, data annotation adalah proses memberi label atau tag pada data, seperti gambar, teks, atau audio, agar algoritma machine learning dapat mengenali dan memahaminya.
Label berfungsi sebagai contoh yang mengajarkan sistem pola apa yang harus dicari. Misalnya, jika Anda memberi anotasi ribuan gambar dengan label "anjing" atau "kucing", model akan mulai mengenali perbedaan di antara keduanya.
Setelah belajar dari contoh-contoh ini, model kemudian dapat membuat prediksi atau mengklasifikasikan data tanpa label yang baru, sebagaimana anak tersebut akhirnya mengenali hewan tanpa bantuan Anda.
Jenis data yang berbeda memerlukan metode anotasi khusus untuk mempersiapkannya bagi tugas machine learning. Bergantung pada sifat datanya, ada pendekatan unik untuk pelabelan dan penandaan. Memahami jenis-jenis ini membantu menentukan cara paling efektif untuk melatih model untuk berbagai aplikasi.
Mari telusuri jenis data annotation yang paling umum:
Image annotation melibatkan pelabelan gambar agar model machine learning dapat mengidentifikasi dan menafsirkan objek di dalamnya. Berbagai teknik digunakan dalam image annotation, bergantung pada tingkat detail yang dibutuhkan:
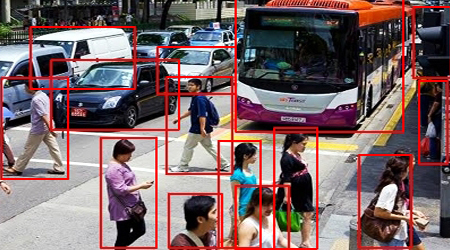
Bounding boxes. Sumber: Anolytics
Metode ini melibatkan menggambar persegi panjang di sekitar objek dalam gambar untuk membantu model mengenali keberadaan dan lokasinya. Bounding boxes umum digunakan untuk mendeteksi mobil, pejalan kaki, atau rambu pada teknologi mobil otonom.
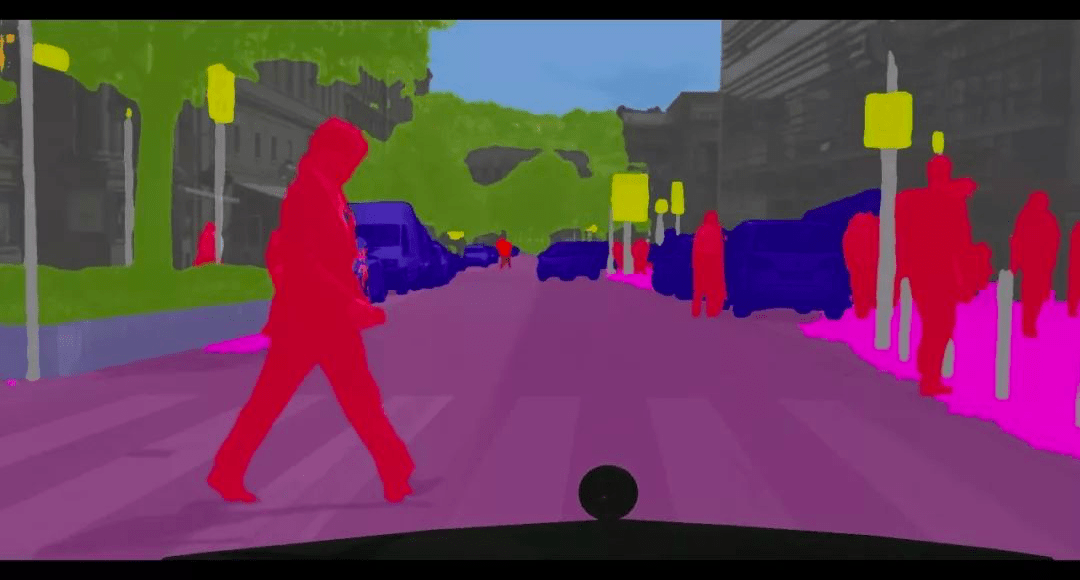
Semantic segmentation. Sumber: Introduction to Semantic Image Segmentation
Di sini, setiap piksel dalam gambar diberi label untuk menetapkan area tertentu ke objek atau kategori tertentu, seperti mengidentifikasi jalan, bangunan, atau pohon. Teknik ini memberi model pemahaman yang lebih mendetail tentang suatu adegan.
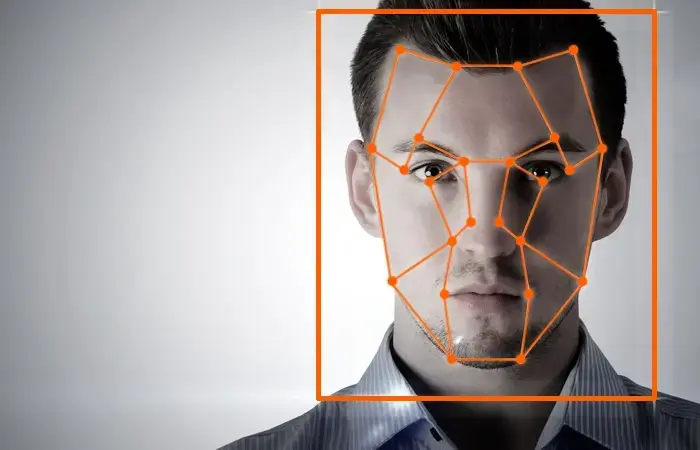
Landmark annotation. Sumber: Anolytics
Teknik ini melibatkan penandaan titik-titik tertentu dalam gambar, seperti fitur wajah atau titik kunci pada postur tubuh. Ini digunakan pada aplikasi seperti pengenalan wajah dan estimasi pose manusia.
Text annotation adalah proses pelabelan dan penandaan data teks agar dapat dipahami oleh natural language processing (NLP). Ini memungkinkan mesin memahami, memproses, dan menganalisis bahasa manusia.
Ada beberapa teknik umum yang digunakan dalam text annotation:
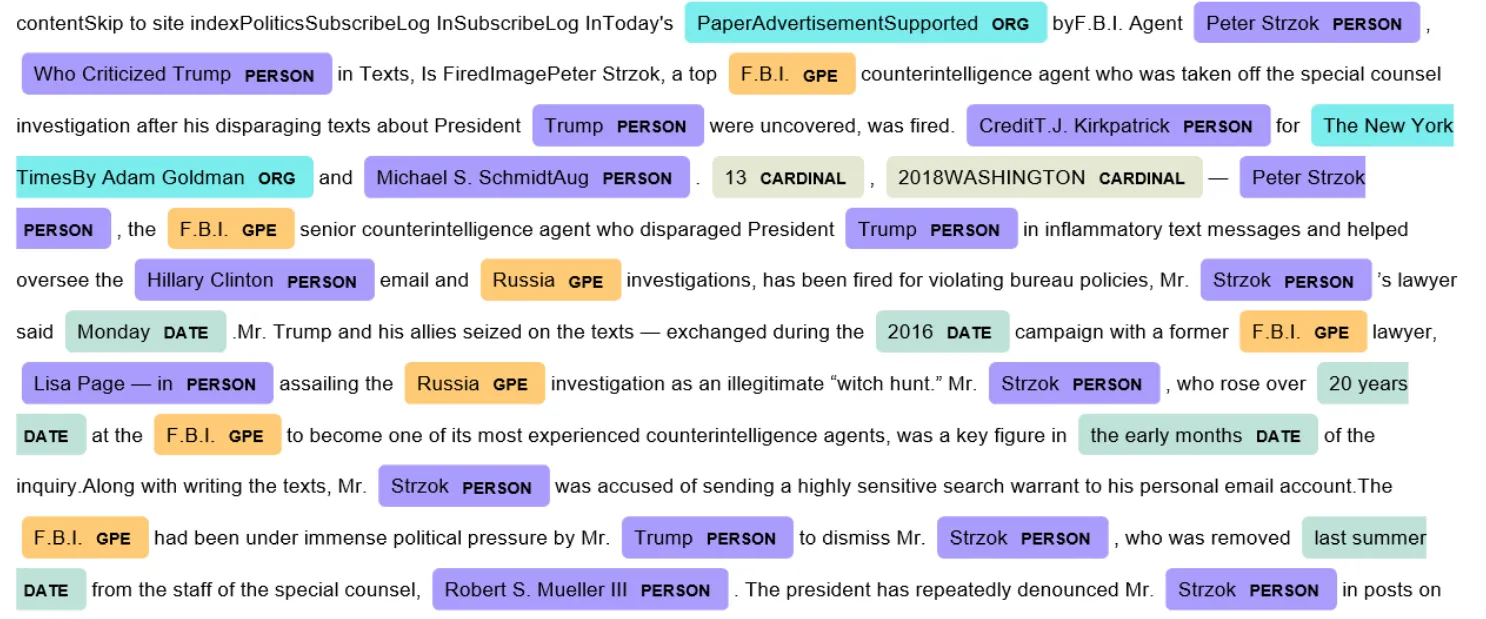
Entity recognition. Sumber: Named Entity Recognition and Classification with Scikit-Learn
Ini melibatkan identifikasi entitas tertentu dalam teks, seperti nama orang, tempat, atau organisasi. Misalnya, dalam kalimat "Apple membuka toko baru di New York," model akan mengenali "Apple" sebagai perusahaan dan "New York" sebagai lokasi.
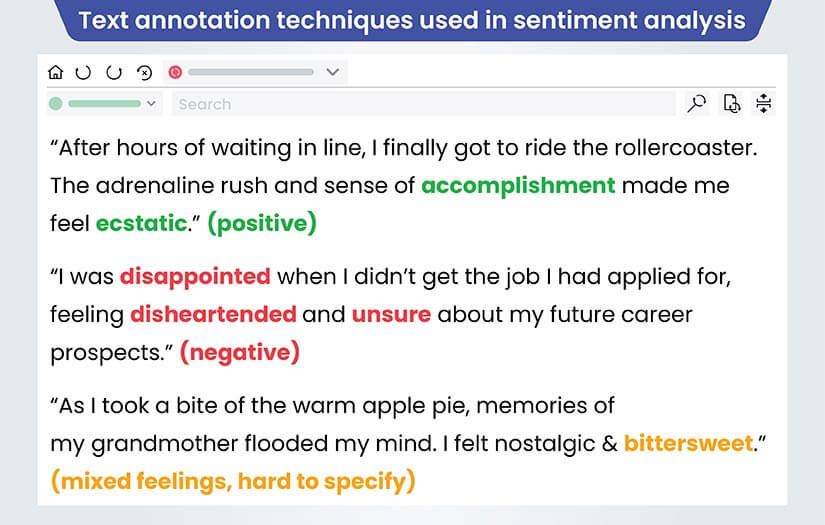
Sentiment tagging. Sumber: Understanding the text annotation process for Customer Sentiment Analysis
Teknik ini menetapkan emosi atau opini pada potongan teks, melabelinya sebagai positif, negatif, atau netral. Ini sering digunakan pada ulasan pelanggan atau pemantauan media sosial untuk memahami bagaimana pengguna merasakan suatu produk atau layanan.
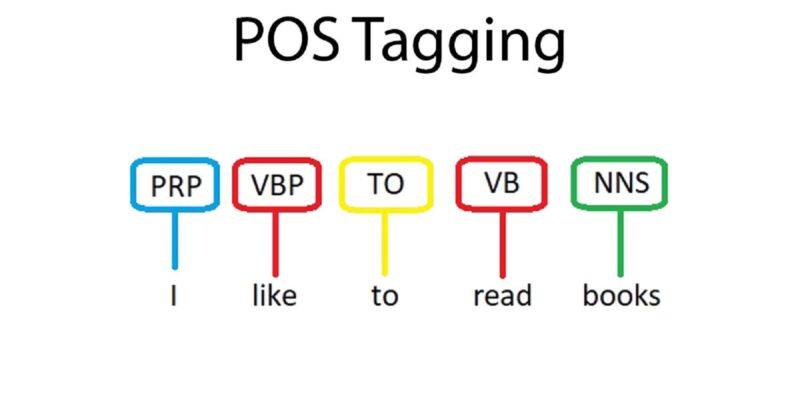
POS tagging. Sumber: POS tagging in NLP
Metode ini memberi label pada setiap kata dalam sebuah kalimat dengan peran gramatikalnya (misalnya, nomina, verba, adjektiva), membantu model memahami struktur bahasa untuk tugas seperti penerjemahan atau pengenalan suara.
Audio annotation melibatkan pelabelan berkas suara untuk melatih model pengenalan ucapan, deteksi musik, atau klasifikasi bunyi.
Beberapa teknik audio annotation yang umum meliputi:
Mengonversi kata-kata yang diucapkan dalam berkas audio menjadi teks tertulis sering digunakan dalam aplikasi speech-to-text.
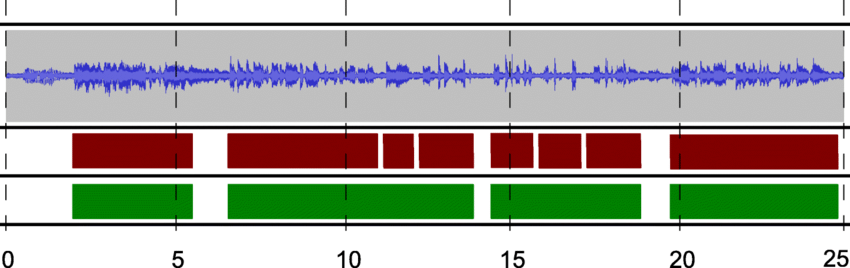
Speech segmentation. Sumber: ResearchGate
Ini melibatkan pembagian berkas audio menjadi bagian-bagian berbeda. Misalnya, Anda mungkin ingin memisahkan dialog dari kebisingan latar belakang atau mengidentifikasi pembicara individual dalam sebuah percakapan.
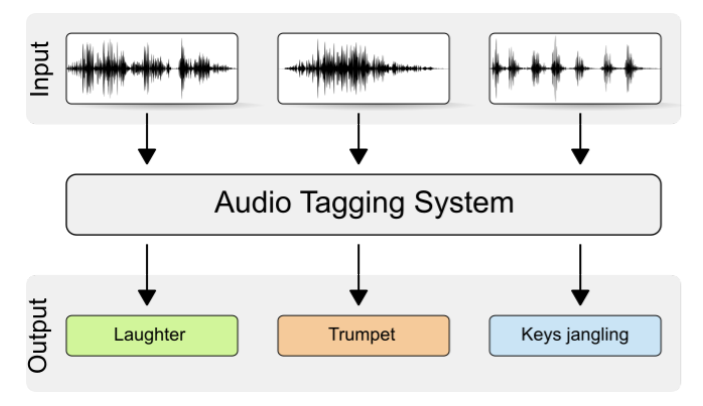
Sound tagging. Sumber: Freesound Tagging by VGGish with KNN
Sound tagging adalah ketika suara tertentu (misalnya, kebisingan lalu lintas, suara hewan, dan sebagainya) diberi label dalam sebuah berkas audio.
Video annotation melibatkan pelabelan dan penandaan objek atau tindakan dalam frame video untuk membantu model machine learning menafsirkan gerakan dan aktivitas.
Teknik utama dalam video annotation meliputi:
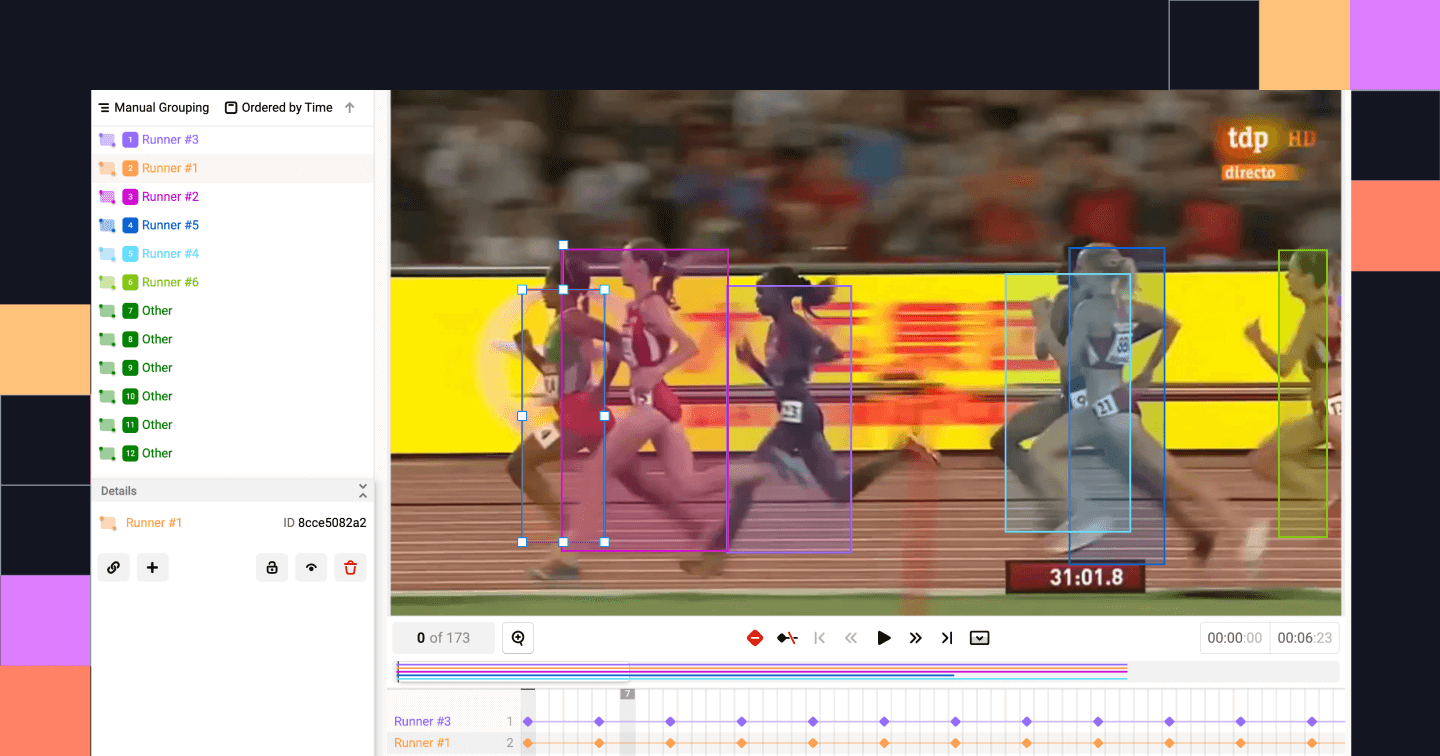
Object tracking. Sumber: Label Studio
Object tracking melibatkan pelabelan objek secara berkelanjutan di beberapa frame untuk melacak pergerakannya. Dalam skenario berkendara otonom, misalnya, object tracking dapat digunakan untuk mengikuti kendaraan di persimpangan yang ramai.
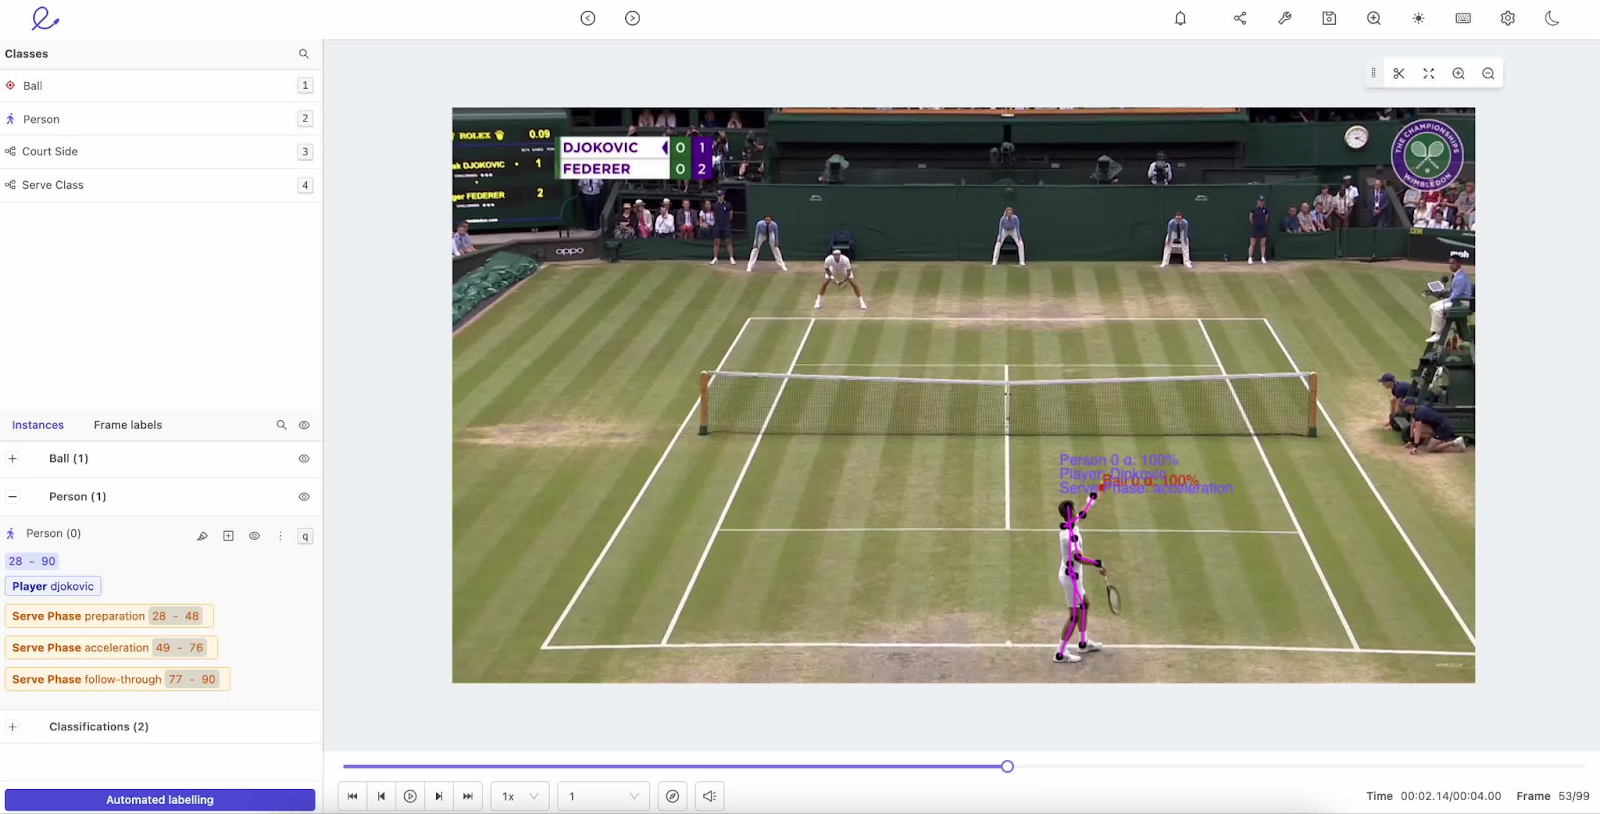
Activity labeling. Sumber: Encord
Ini adalah ketika label ditetapkan pada tindakan tertentu, seperti seseorang berjalan, berlari, atau duduk dalam video. Ini membantu model memahami perilaku manusia pada aplikasi seperti pemantauan keamanan atau analitik olahraga.
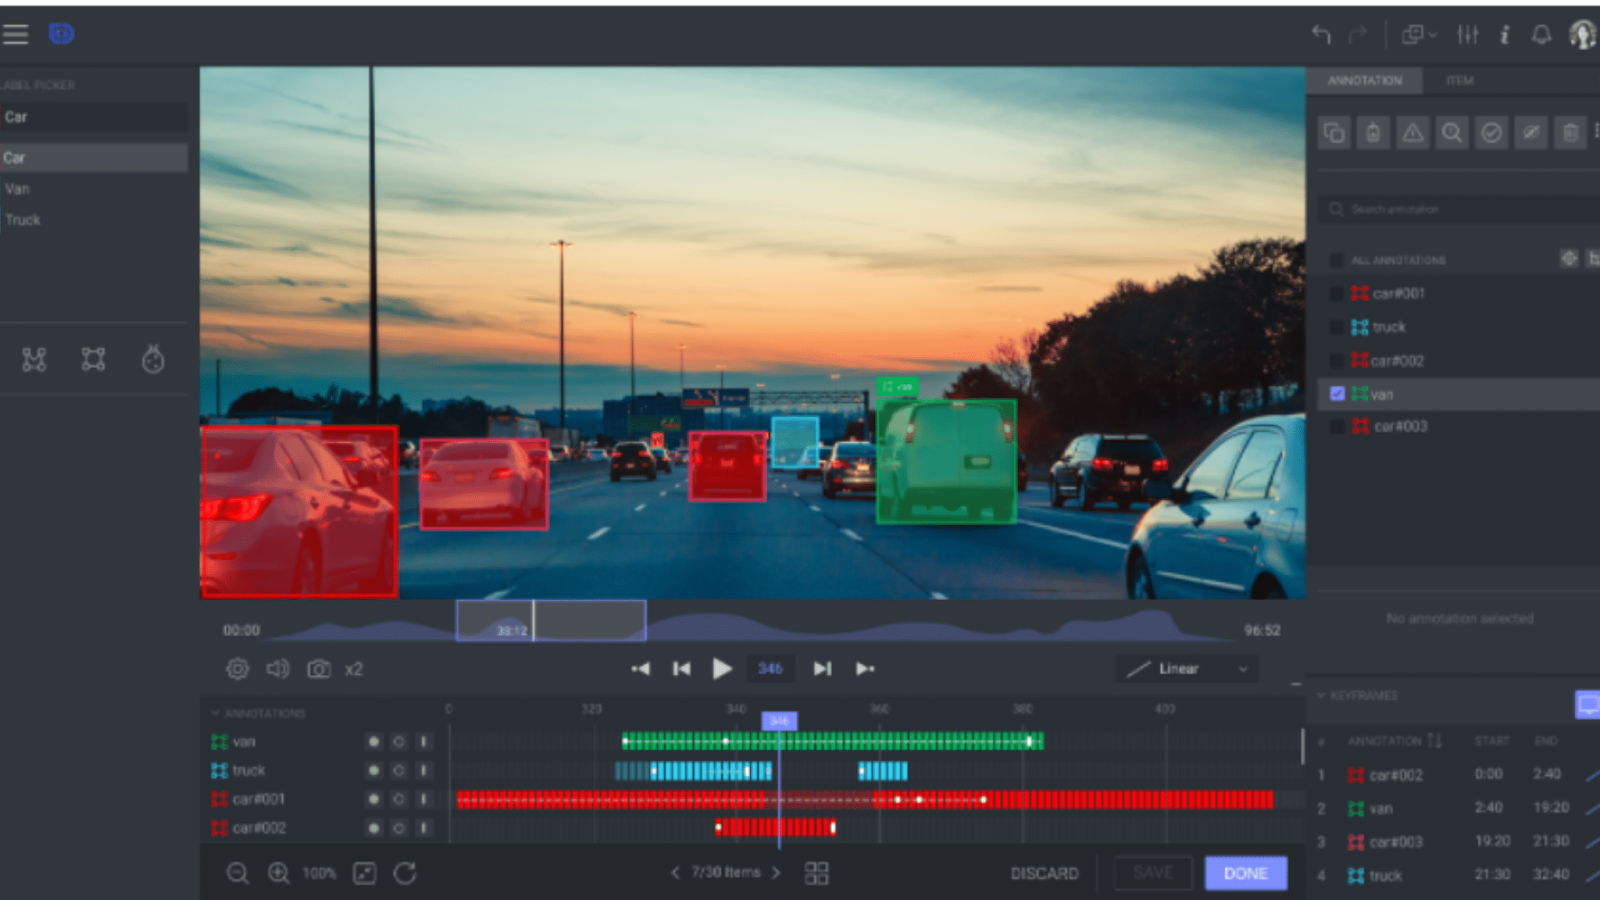
Frame-by-frame annotation. Sumber: dataloop
Ketika setiap frame individu dari video diberi label untuk menangkap detail yang sangat kecil, ini disebut deteksi frame-by-frame. Ini sering digunakan untuk tugas yang memerlukan presisi tinggi, seperti menganalisis gerakan tubuh dalam terapi fisik.
Metode yang digunakan untuk memberi anotasi data dapat bervariasi bergantung pada beberapa faktor, seperti:
Dengan kata lain, beberapa tugas memerlukan ketelitian anotator manusia, sementara yang lain dapat memanfaatkan otomatisasi untuk menghemat waktu dan meningkatkan skala proses. Di bawah ini, kita akan mengeksplorasi berbagai pendekatan untuk memberi Anda wawasan lebih baik tentang situasi kapan masing-masing sebaiknya digunakan.
Manual annotation adalah ketika anotator manusia memberi label data secara manual. Dalam pendekatan ini, anotator terlatih meninjau setiap potongan data dengan cermat dan menerapkan label atau tag yang diperlukan.
Keunggulan terbesar dari manual annotation adalah akurasinya. Karena manusia dapat memahami konteks, nuansa, dan pola kompleks lebih baik daripada mesin, mereka dapat memastikan data diberi label secara presisi. Tingkat akurasi ini sangat penting untuk proyek yang memerlukan anotasi berkualitas tinggi dan terperinci, seperti pelabelan citra medis atau tugas pemrosesan bahasa alami yang kompleks.
Namun, manual annotation juga memiliki tantangan signifikan:
Terlepas dari tantangan ini, manual annotation tetap penting untuk proyek yang menuntut ketelitian tinggi, meski bisnis sering mencari cara untuk menyeimbangkan kualitas dengan efisiensi waktu dan biaya.
Semi-automated annotation menggabungkan keahlian manusia dengan bantuan machine learning. Dalam pendekatan ini, model machine learning membantu anotator manusia dengan pra-pelabelan data atau memberikan saran. Anotator manusia kemudian meninjau dan menyempurnakan label untuk memastikan akurasi.
Keuntungannya adalah mempercepat proses sembari tetap mempertahankan tingkat akurasi yang tinggi. Mesin dapat menangani tugas berulang atau sederhana, sehingga anotator manusia dapat fokus pada titik data yang lebih kompleks atau ambigu. Pendekatan ini ideal untuk proyek besar di mana anotasi sepenuhnya manual akan terlalu lambat atau mahal karena menyeimbangkan efisiensi waktu dan kendali kualitas.
Namun, pendekatan ini menghadapi beberapa tantangan:
Semi-automated annotation paling cocok untuk proyek yang perlu menyeimbangkan kualitas dengan kecepatan, di mana data cukup kompleks untuk mendapat manfaat dari tinjauan manusia tetapi cukup besar untuk memerlukan bantuan mesin.
Automated annotation menggunakan algoritma machine learning untuk memberi label data tanpa keterlibatan manusia. Dalam pendekatan ini, model pra-latih atau alat berbasis AI secara otomatis memberi anotasi pada dataset besar. Ini membuat proses lebih cepat dan lebih mudah diskalakan dibanding metode manual atau semi-otomatis.
Keunggulan utama automated annotation adalah efisiensinya. Ini dapat memproses sejumlah besar data dalam sebagian kecil waktu yang dibutuhkan anotator manusia. Akibatnya, automated annotation menjadi solusi ideal untuk proyek dengan dataset sangat besar, seperti memberi tag jutaan gambar untuk model computer vision atau mentranskripsikan volume besar audio untuk pengenalan ucapan.
Namun, kelemahan mengandalkan mesin adalah sebagai berikut:
Automated annotation paling cocok untuk proyek yang membutuhkan kecepatan dan skalabilitas tetapi masih dapat mentoleransi margin kesalahan tertentu atau ketika tinjauan manusia dapat digunakan kemudian untuk menyempurnakan hasil.
Crowdsourcing melibatkan pendistribusian tugas pelabelan data kepada banyak kontributor menggunakan platform seperti Amazon Mechanical Turk atau Appen. Metode ini memungkinkan bisnis memberi anotasi pada dataset besar dengan cepat dan hemat biaya dengan memanfaatkan tenaga kerja global.
Salah satu keunggulan utama crowdsourcing adalah skalabilitas. Mendistribusikan tugas kepada banyak kontributor memungkinkan perusahaan menangani volume data besar secara efisien. Misalnya, proyek yang memerlukan ribuan gambar berlabel atau transkripsi dapat diselesaikan dalam hitungan hari, bukan minggu atau bulan.
Kekurangan pendekatan ini adalah sebagai berikut:
Crowdsourcing ideal untuk proyek skala besar yang memerlukan anotasi cepat dan hemat biaya. Namun, mempertahankan hasil berkualitas tinggi memerlukan pengawasan dan manajemen tugas yang kuat.
Ada beragam alat yang tersedia untuk data annotation. Alat-alat ini berkisar dari platform open-source hingga solusi komersial komprehensif yang masing-masing dirancang untuk memenuhi kebutuhan proyek yang berbeda.
Misalnya, alat open-source sering dapat dikustomisasi dan gratis digunakan. Ini menjadikannya ideal untuk proyek yang lebih kecil atau tim dengan keahlian teknis. Di sisi lain, opsi komersial menyediakan fitur yang lebih canggih, termasuk otomatisasi, alat kolaborasi, dan kontrol kualitas, yang membuatnya lebih cocok untuk proyek skala besar atau perusahaan yang menginginkan alur kerja yang lebih efisien.
Pada bagian ini, kita akan membahas beberapa alat paling populer yang tersedia untuk data annotation dan bagaimana alat-alat tersebut dapat membantu pada berbagai jenis data:
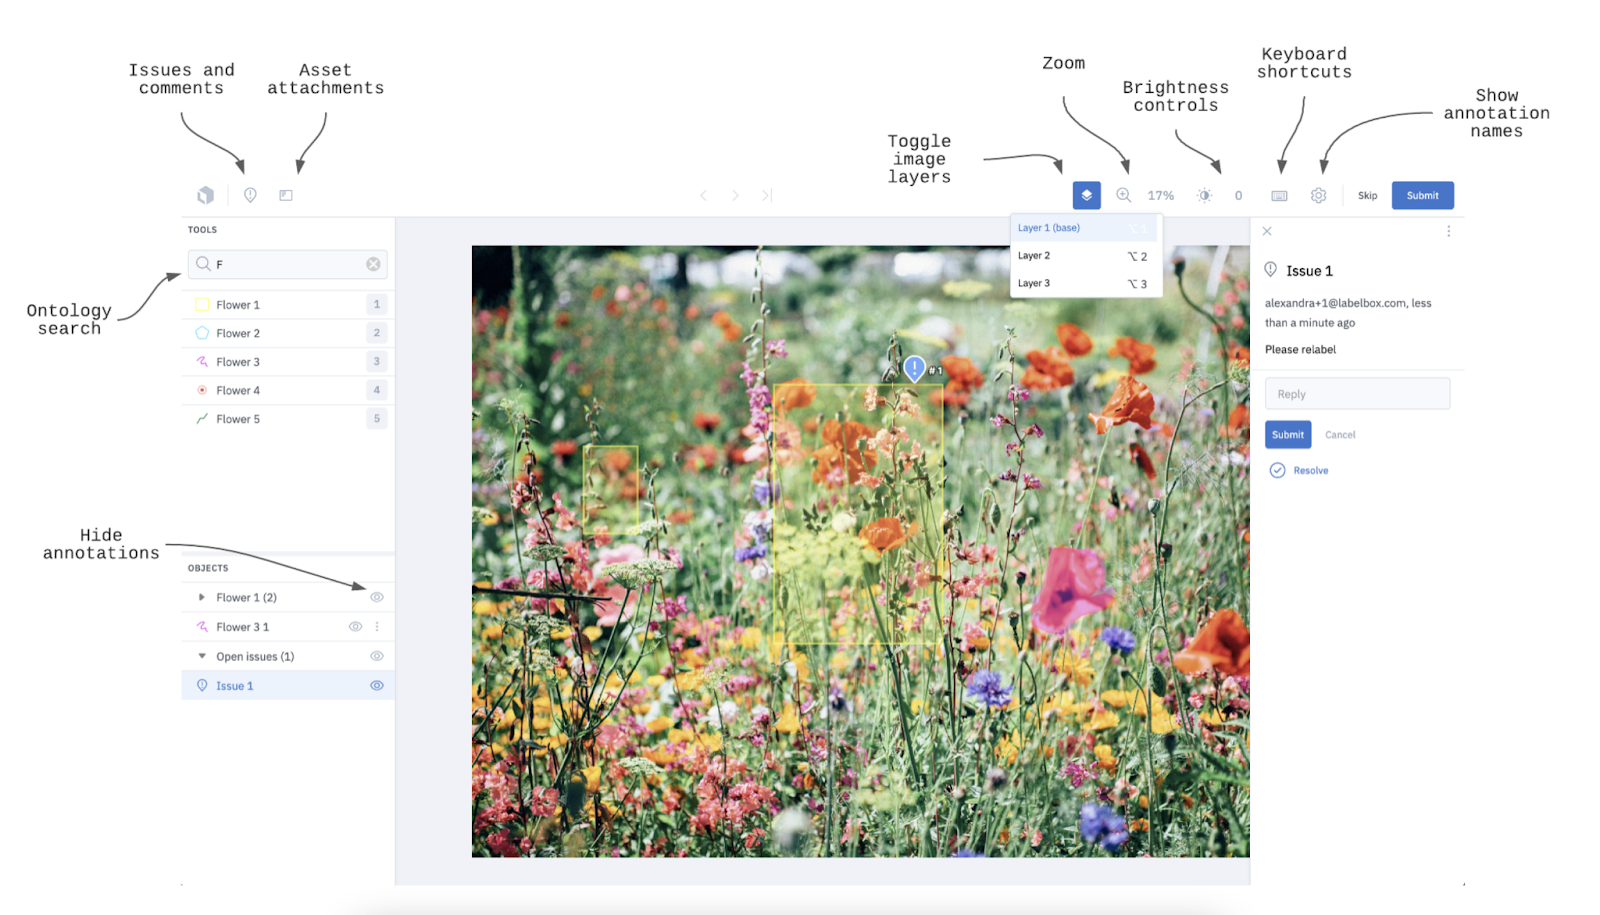
Sumber: Labelbox Docs
Labelbox adalah sebuah platform komersial yang banyak digunakan dan dirancang untuk menyederhanakan proses data annotation, dengan fokus pada kolaborasi dan kontrol kualitas. Didirikan pada 2018 oleh Manu Sharma, Brian Rieger, dan Peter Welinder, dengan misi “membangun produk terbaik untuk selaras dengan kecerdasan buatan.”
Platform Labelbox menyediakan antarmuka intuitif tempat tim dapat berkolaborasi untuk memberi anotasi data, melacak kemajuan, dan mempertahankan standar anotasi yang tinggi. Ini juga mendukung berbagai jenis data (misalnya, gambar, video, dan teks), yang membuat platform ini sangat serbaguna untuk berbagai proyek machine learning.
Salah satu fitur utamanya adalah mekanisme kontrol kualitas bawaan, yang memungkinkan tim meninjau dan menyetujui anotasi—ini memastikan hasil yang konsisten dan akurat.
Labelbox ideal untuk organisasi yang ingin meningkatkan skala upaya anotasi mereka dengan manajemen proyek dan fitur otomatisasi yang terintegrasi.
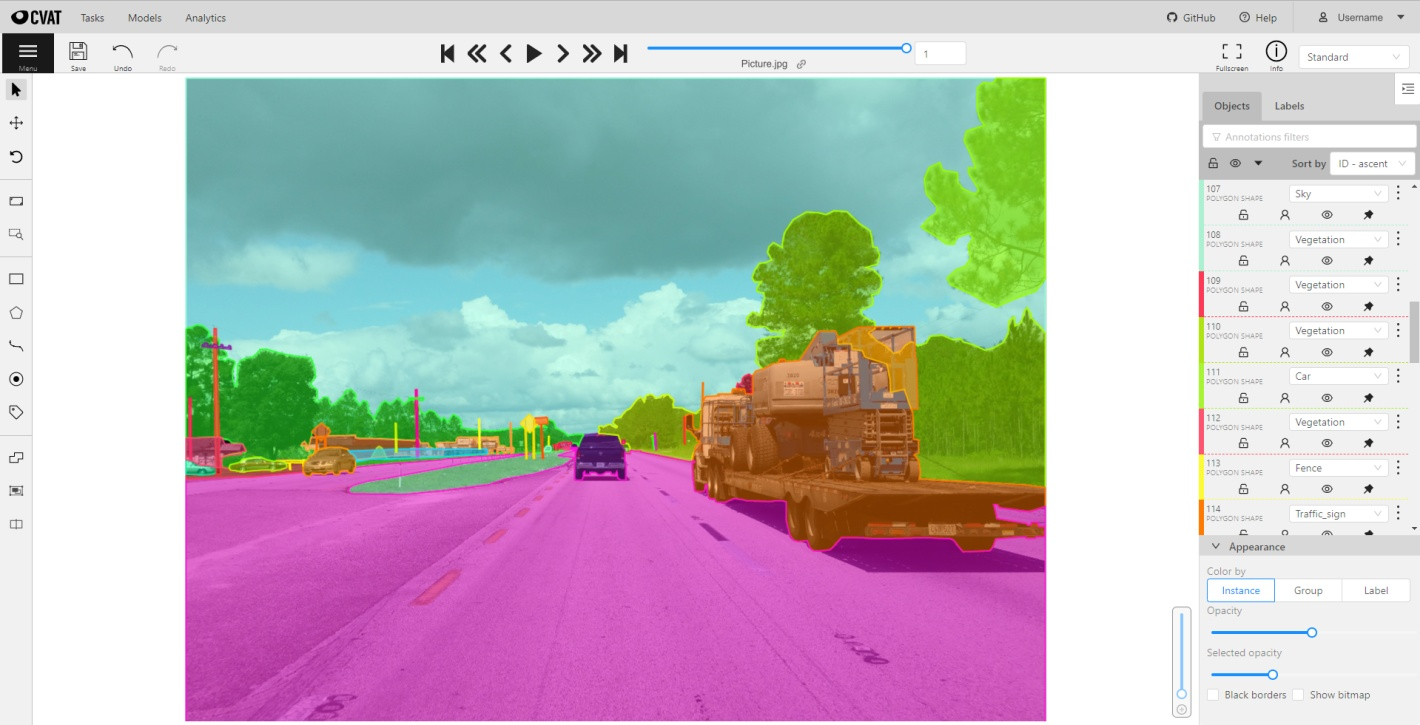
Sumber: Halaman Wikipedia CVAT
CVAT adalah alat open-source yang dirancang khusus untuk memberi anotasi pada dataset gambar dan video. Dikembangkan oleh Intel, CVAT sangat dapat dikustomisasi dan menawarkan berbagai teknik anotasi (misalnya, bounding boxes, poligon, dan anotasi keypoint). Fleksibilitasnya membuatnya cocok untuk proyek mulai dari deteksi objek hingga pengenalan wajah.
Karena bersifat open-source, CVAT gratis digunakan dan dapat disesuaikan untuk memenuhi kebutuhan proyek tertentu. Ini menjadikannya pilihan populer bagi peneliti dan tim kecil yang membutuhkan alat anotasi kuat tanpa biaya perangkat lunak komersial.
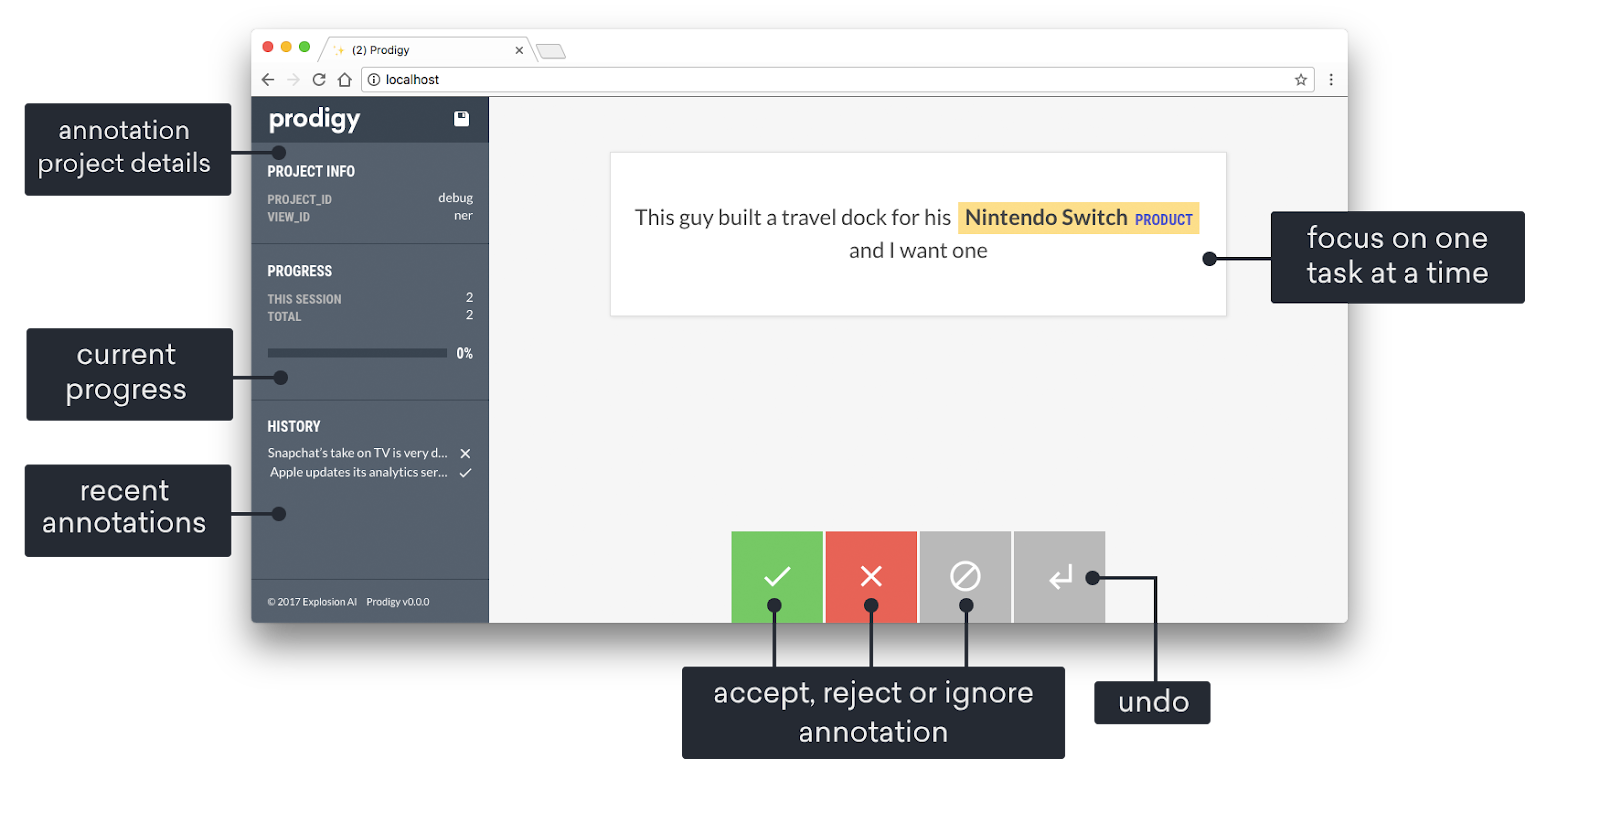
Sumber: Prodigy Docs
Prodigy adalah alat anotasi canggih yang dikembangkan oleh Explosion AI dan menggunakan active learning untuk meningkatkan efisiensi, khususnya pada tugas natural language processing (NLP). Dengan Prodigy, model machine learning membantu anotator dengan menyarankan label berdasarkan prediksinya, yang kemudian dikonfirmasi atau dikoreksi oleh peninjau manusia.
Pendekatan interaktif ini mempercepat proses anotasi sekaligus memastikan data berlabel berkualitas tinggi. Meski merupakan alat komersial, Prodigy sangat dapat disesuaikan; misalnya, memungkinkan pengguna membuat alur kerja anotasi sendiri. Faktor-faktor ini membuat Prodigy sangat cocok untuk tim yang mengerjakan proyek NLP khusus seperti analisis sentimen, entity recognition, atau klasifikasi teks.
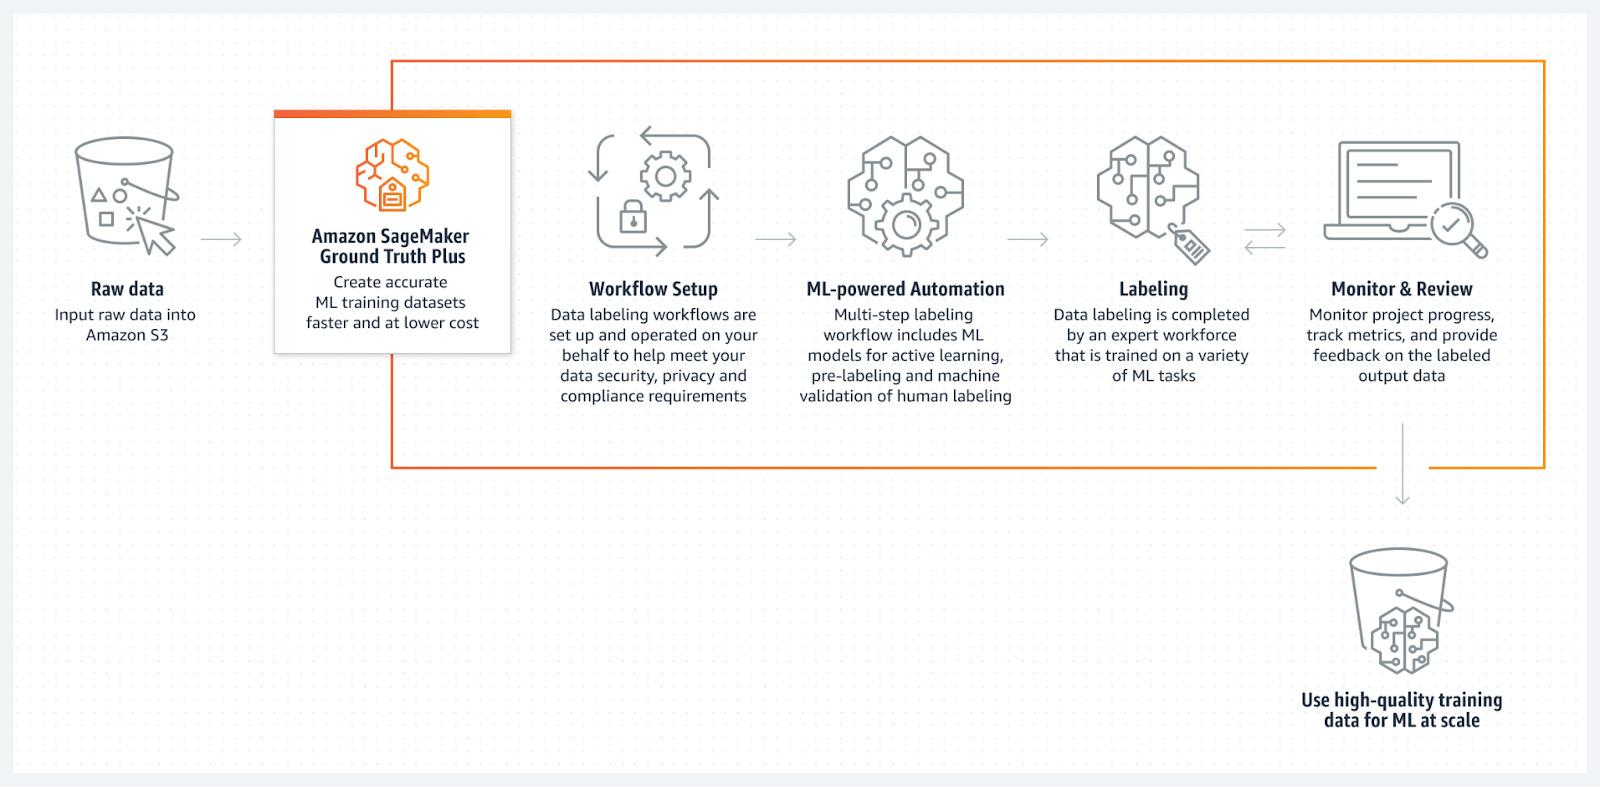
Sumber: Amazon SageMaker Ground Truth
Amazon SageMaker Ground Truth adalah layanan pelabelan data terkelola penuh yang terintegrasi mulus dengan AWS. Ini menyediakan alat untuk anotasi data manual dan otomatis yang memungkinkan pengguna memberi label data dengan cepat dan akurat.
SageMaker Ground Truth menggunakan machine learning untuk membantu anotator manusia dengan pra-pelabelan data, yang mempercepat proses dan mengurangi biaya. Layanan ini juga sangat serbaguna untuk berbagai tugas machine learning karena mendukung beragam jenis data, termasuk gambar, teks, dan video.
Selain itu, layanan ini dibangun untuk skala, sehingga menjadi opsi kuat bagi perusahaan yang memerlukan kemampuan anotasi skala besar dalam ekosistem AWS.
Data annotation yang efektif sangat penting bagi keberhasilan model machine learning, karena kualitas data berlabel berdampak langsung pada akurasi prediksi dan klasifikasi. Mengikuti praktik terbaik dapat membantu memastikan proses anotasi efisien dan andal.
Pada bagian ini, kita akan membahas praktik-praktik penting yang dapat meningkatkan kualitas dan konsistensi data annotation sekaligus mengatasi tantangan yang mungkin dihadapi dalam proses pelabelan.
Salah satu langkah terpenting dalam proses data annotation adalah membuat pedoman yang jelas dan terdefinisi dengan baik. Pedoman ini harus menjelaskan secara tepat bagaimana data harus diberi label dan kriteria apa yang harus diikuti anotator untuk konsistensi.
Pedoman yang jelas membantu untuk:
Memiliki aturan baku sangat krusial untuk data yang kompleks atau subjektif, seperti gambar atau teks dengan banyak kemungkinan interpretasi.
Kualitas perlu dijaga untuk mempertahankan akurasi dan keandalan data yang dianotasi. Karena itu, data yang dianotasi harus ditinjau secara berkala untuk memastikan memenuhi standar yang dipersyaratkan. Proses ini dapat dilakukan melalui audit acak, menggunakan beberapa anotator untuk tugas yang sama (untuk membandingkan hasil), atau pemeriksaan silang anotasi, bergantung pada proyek.
Intinya adalah penting untuk mengimplementasikan proses quality assurance yang kuat agar Anda dapat menangkap kesalahan lebih awal, mengurangi bias dalam data, dan memastikan data berlabel layak untuk melatih model machine learning berkinerja tinggi.
Active learning adalah teknik machine learning yang memungkinkan algoritma memilih sampel data paling informatif untuk diberi label, yang meningkatkan kinerja model. Teknik ini dapat sangat meningkatkan efisiensi proses anotasi. Ini memungkinkan anotator memfokuskan waktu dan energi pada titik data yang paling menantang dan berharga, sementara algoritma machine learning menyarankan sisanya.
Pendekatan ini mengurangi waktu yang dihabiskan untuk memberi label pada sampel yang mudah atau berulang, dan mempercepat proses anotasi secara keseluruhan. Jadi, ini meningkatkan peluang model machine learning yang digunakan untuk membuat prediksi dilatih pada contoh-contoh yang paling krusial.
Untuk memastikan proses anotasi dilakukan secara akurat, anotator harus menerima pelatihan yang memadai. Pelatihan membantu anotator memahami persyaratan khusus tugas dan bagaimana menerapkan pedoman anotasi dengan benar.
Anotator yang terlatih baik lebih mungkin menghasilkan data berlabel berkualitas tinggi, yang pada akhirnya meningkatkan kinerja model machine learning yang mereka dukung. Sesi pelatihan rutin dan mekanisme umpan balik juga dapat membantu menyempurnakan keterampilan anotator seiring waktu, sehingga semakin meningkatkan proses data annotation.
Meskipun data annotation sangat penting untuk melatih model machine learning yang akurat, prosesnya memiliki berbagai tantangan. Pada bagian ini, kita akan membahas beberapa tantangan paling umum dalam data annotation.
Data annotation manual sering kali padat karya. Diperlukan banyak waktu dan sumber daya finansial untuk memberi anotasi pada semua instance, terutama ketika dataset besar. Semakin kompleks data (seperti video atau gambar yang rumit), semakin memakan waktu proses anotasinya. Anotator terampil harus direkrut, yang meningkatkan biaya.
Untuk mengatasi tantangan ini, organisasi dapat menggunakan alat anotasi semi-otomatis, di mana model machine learning menyarankan label dan manusia memverifikasinya. Ini mempercepat proses tanpa mengorbankan akurasi.
Active learning juga dapat membantu dengan memfokuskan upaya manusia pada data yang paling informatif, sehingga mengurangi total data yang harus diberi label secara manual. Selain itu, menggunakan platform crowdsourcing seperti Amazon Mechanical Turk memungkinkan banyak kontributor bekerja secara simultan, yang berarti anotasi skala besar bisa lebih terjangkau dan efisien.
Tantangan kunci lainnya adalah menangani subjektivitas dan bias dalam proses anotasi. Anotator yang berbeda mungkin menafsirkan data yang sama dengan cara berbeda. Ini sangat umum untuk tugas seperti memberi label emosi dalam teks atau mengidentifikasi objek pada gambar yang kompleks. Masalahnya adalah subjektivitas dapat memperkenalkan bias ke dalam data berlabel, yang pada gilirannya dapat menyebabkan prediksi model menjadi bias.
Untuk mengurangi subjektivitas dan bias, organisasi harus membuat pedoman anotasi yang jelas dan terperinci agar semua anotator mengikuti kriteria yang sama. Solusi lain adalah menggunakan beberapa anotator untuk data yang sama, yang memungkinkan pemeriksaan silang dan membantu mengidentifikasi serta memperbaiki anotasi yang bias atau tidak konsisten.
Anotasi yang mengungkapkan informasi identitas dapat melanggar peraturan privasi yang melindungi data pribadi. Tantangan ini sangat signifikan saat mengalihdayakan tugas anotasi atau menggunakan platform crowdsourcing, di mana banyak kontributor memiliki akses ke data.
Solusi seperti anonimisasi (menghapus informasi yang dapat diidentifikasi secara pribadi) dan menggunakan platform anotasi yang aman serta terenkripsi dapat membantu mengurangi risiko ini.
Pada bagian ini, kita akan membahas penerapan data annotation di dunia nyata. Mari kita mulai!
Pada kendaraan otonom, data annotation menjadi fondasi untuk mengajarkan AI bernavigasi dengan aman di dunia nyata. Mobil tanpa pengemudi bergantung pada data beranotasi untuk mengidentifikasi objek.
Misalnya, anotator memberi label pada gambar atau frame video dengan menggambar bounding boxes di sekitar mobil atau menandai batas jalan untuk deteksi lajur. Anotasi ini membantu AI belajar bagaimana mengenali dan bereaksi terhadap berbagai skenario jalan, seperti berhenti untuk pejalan kaki atau tetap berada di lajur yang benar.
Model AI memerlukan citra medis berlabel untuk belajar mendeteksi kelainan. Misalnya, anotator terampil akan menggarisbawahi area tertentu pada gambar untuk menandai wilayah yang menunjukkan tanda-tanda awal kanker. Ini memungkinkan AI mendeteksi kanker dengan cepat dan akurat lebih awal daripada metode tradisional, yang meningkatkan hasil pasien dan mengurangi beban kerja tenaga medis.
Untuk chatbot layanan pelanggan, text annotation sangat penting untuk mengajarkan AI memahami bahasa manusia.
Misalnya, anotator dapat memberi label teks untuk membantu chatbot mengenali niat pengguna. Chatbot kemudian menganalisis interaksi berlabel tersebut untuk membantu mereka belajar memberikan respons yang sesuai. Ini memungkinkan organisasi menawarkan bantuan yang lebih cepat dan akurat serta meningkatkan pengalaman pelanggan.
Dalam analisis sentimen, anotasi teks digunakan untuk mengukur bagaimana perasaan pelanggan tentang hal-hal tertentu (misalnya, merek, produk, atau acara). Caranya adalah anotator menandai frasa atau kalimat sebagai positif, negatif, atau netral, lalu data ini diberikan kepada AI untuk mempelajari sentimen yang mendasarinya. Perusahaan kemudian dapat menerapkannya untuk memantau bagaimana pelanggan menyambut peluncuran produk baru.
Data annotation adalah proses memberi label pada data agar dapat dikenali dan digunakan oleh model machine learning. Ini adalah langkah krusial dalam mengembangkan sistem AI yang dapat menafsirkan dan merespons data dunia nyata secara akurat. Mengapa? Karena kualitas dan akurasi data beranotasi berdampak langsung pada kinerja dan efektivitas model AI.
Pada akhirnya, data annotation berfungsi sebagai fondasi untuk membangun sistem AI yang cerdas dan andal yang dapat mendorong inovasi di berbagai industri. Ini menjadikannya bagian yang tak tergantikan dari pengembangan machine learning.
Untuk melanjutkan pembelajaran Anda, lihat sumber daya berikut:
Pelajari lebih lanjut tentang machine learning dan AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



