
Last chance! 50% off DataCamp Premium
Sale ends in
Immagina di sviluppare un’auto a guida autonoma. Per farla “vedere” e capire la strada, deve imparare a riconoscere oggetti come pedoni, segnali stradali e altri veicoli. Perché ciò accada, il sistema di machine learning dell’auto richiede migliaia—se non milioni—di immagini tratte da scenari di guida nel mondo reale.
Ma l’auto, di per sé, non capisce cosa c’è nelle immagini. Non sa che un ottagono rosso è un segnale di stop o che una persona sta camminando sul marciapiede. È qui che entra in gioco l’annotazione dei dati.
L’annotazione dei dati è il processo di etichettare dati grezzi per renderli comprensibili e utilizzabili dai modelli di machine learning. Ne parleremo più nel dettaglio tra poco, ma tienilo a mente.
Ecco cosa esploreremo in questo articolo:
Entriamo nel vivo!
Il modo migliore per pensare all’annotazione dei dati è immaginare come si insegna ai bambini a riconoscere gli animali. All’inizio mostri loro la foto di un cane e dici: “Questo è un cane”. Poi mostri un gatto e dici: “Questo è un gatto”. Col tempo, mostrando esempi etichettati, il bambino impara a identificare gli animali da solo. L’annotazione dei dati funziona in modo simile per le macchine.
Così come un bambino ha bisogno di esempi etichettati (nota: dire “Questo è un cane” è l’etichettatura), i modelli di machine learning richiedono che i dati siano annotati per poter imparare. Dunque, l’annotazione dei dati è il processo di etichettare o taggare dati, come immagini, testo o audio, affinché gli algoritmi di machine learning possano riconoscerli e comprenderli.
Le etichette fungono da esempi che insegnano al sistema quali schemi cercare. Per esempio, se annoti migliaia di immagini con etichette “cane” o “gatto”, il modello inizierà a riconoscere le differenze tra i due.
Una volta appresi questi esempi, il modello può poi fare previsioni o classificare nuovi dati non etichettati, proprio come il bambino finisce per riconoscere gli animali senza il tuo aiuto.
Tipi diversi di dati richiedono metodi di annotazione specifici per prepararli ai compiti di machine learning. A seconda della natura dei dati, esistono approcci unici per etichettare e taggare. Comprendere questi tipi aiuta a determinare il modo più efficace per addestrare i modelli per una varietà di applicazioni.
Esploriamo i tipi più comuni di annotazione dei dati:
L’annotazione di immagini consiste nell’etichettare le immagini affinché i modelli di machine learning possano identificare e interpretare gli oggetti al loro interno. Nell’annotazione di immagini si usano tecniche diverse in base al livello di dettaglio richiesto:
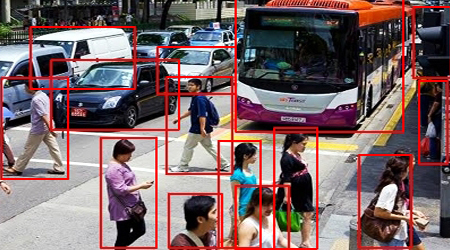
Bounding box. Fonte: Anolytics
Questo metodo prevede di disegnare rettangoli attorno agli oggetti in un’immagine per aiutare il modello a riconoscerne presenza e posizione. Le bounding box sono comunemente usate per rilevare auto, pedoni o segnali nella tecnologia per la guida autonoma.
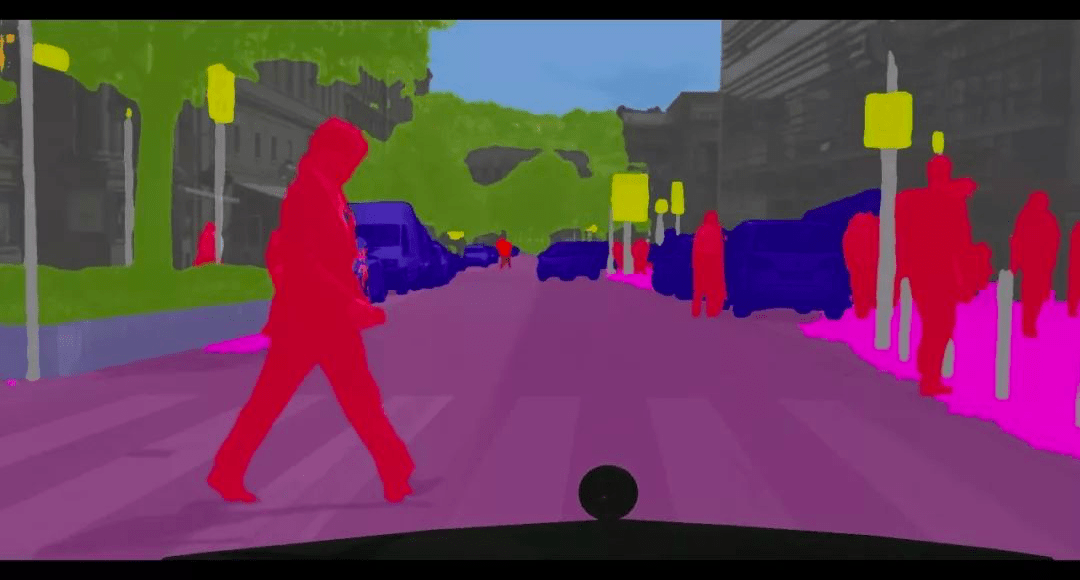
Segmentazione semantica. Fonte: Introduction to Semantic Image Segmentation
Qui, ogni pixel di un’immagine viene etichettato per assegnare regioni specifiche a particolari oggetti o categorie, come identificare strade, edifici o alberi. Questa tecnica offre al modello una comprensione più granulare della scena.
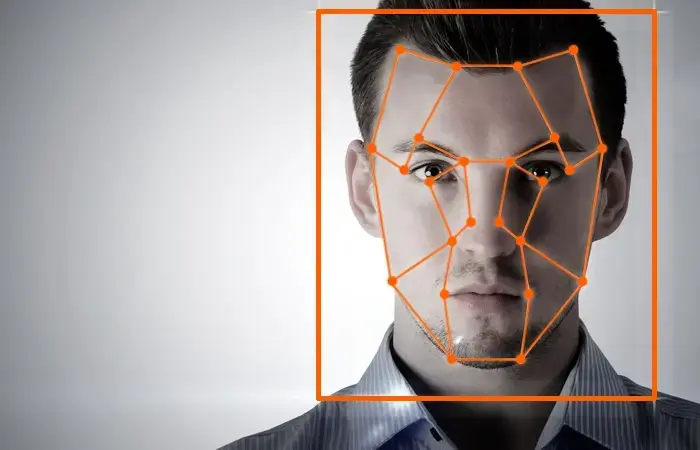
Annotazione di landmark. Fonte: Anolytics
Questa tecnica prevede di marcare punti specifici all’interno di un’immagine, come tratti del viso o punti chiave della postura. Si usa in applicazioni come il riconoscimento facciale e la stima della posa umana.
L’annotazione di testo è il processo di etichettare e taggare dati testuali per renderli comprensibili ai modelli di elaborazione del linguaggio naturale (NLP). Consente alle macchine di comprendere, elaborare e analizzare il linguaggio umano.
Esistono diverse tecniche comuni usate nell’annotazione di testo:
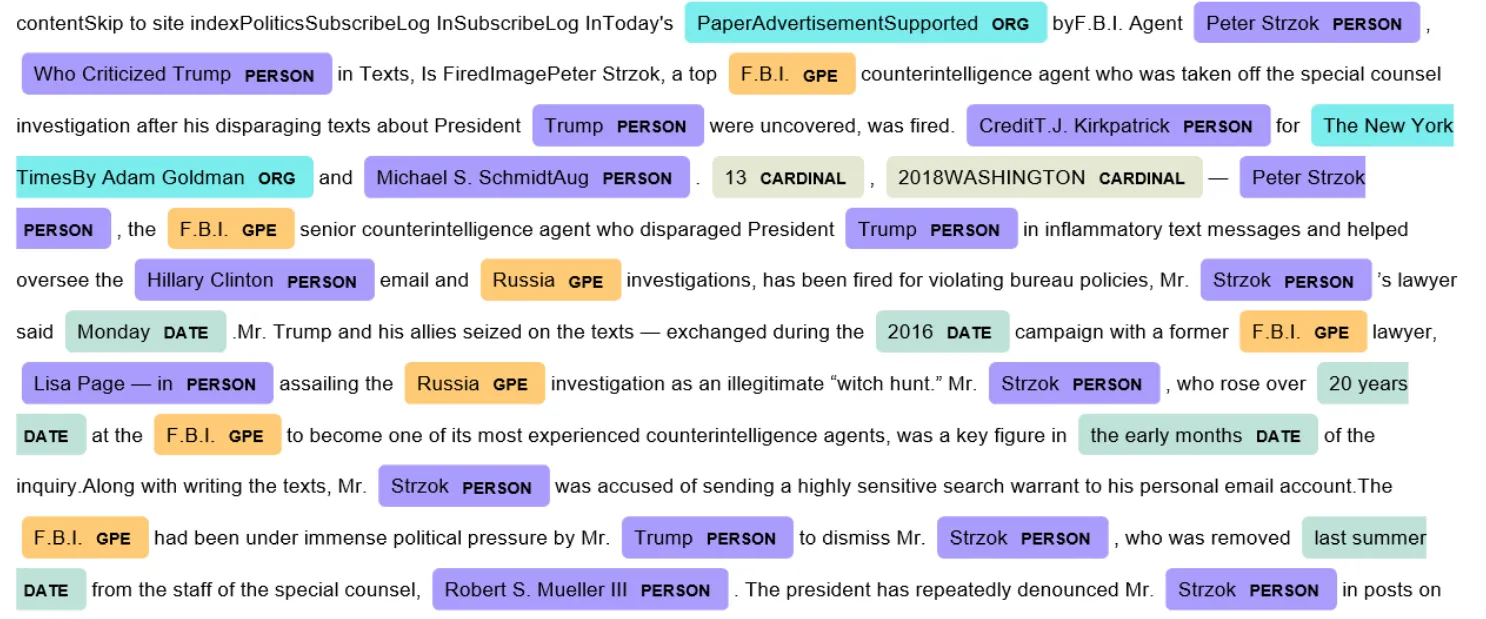
Riconoscimento di entità. Fonte: Named Entity Recognition and Classification with Scikit-Learn
Consiste nell’identificare entità specifiche nel testo, come nomi di persone, luoghi o organizzazioni. Ad esempio, nella frase “Apple ha aperto un nuovo negozio a New York”, il modello riconoscerebbe “Apple” come azienda e “New York” come località.
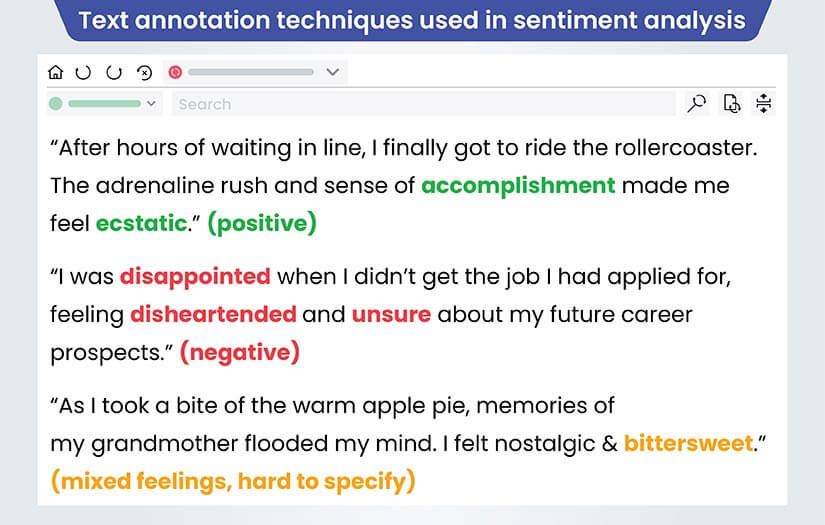
Etichettatura del sentiment. Fonte: Understanding the text annotation process for Customer Sentiment Analysis
Questa tecnica assegna emozioni o opinioni a parti di testo, etichettandole come positive, negative o neutre. Viene spesso usata nelle recensioni dei clienti o nel monitoraggio dei social media per capire come gli utenti percepiscono un prodotto o un servizio.
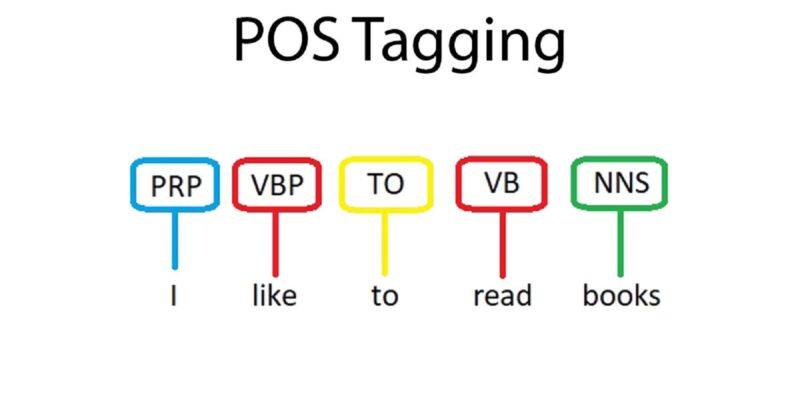
POS tagging. Fonte: POS tagging in NLP
Questo metodo etichetta ogni parola in una frase con il suo ruolo grammaticale (ad es., nome, verbo, aggettivo), aiutando i modelli a comprendere la struttura del linguaggio per compiti come traduzione o riconoscimento vocale.
L’annotazione audio consiste nell’etichettare file sonori per addestrare modelli al riconoscimento vocale, al rilevamento di musica o alla classificazione dei suoni.
Alcune tecniche comuni di annotazione audio includono:
Convertire le parole pronunciate in un file audio in testo scritto è spesso utilizzato nelle applicazioni speech-to-text.
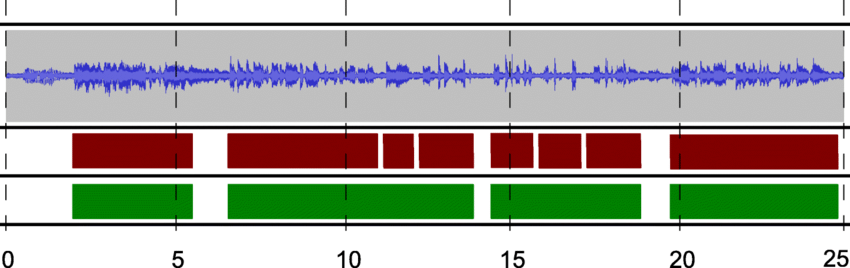
Segmentazione del parlato. Fonte: ResearchGate
Consiste nel dividere un file audio in sezioni diverse. Per esempio, potresti voler separare il dialogo dal rumore di fondo o identificare i singoli parlanti in una conversazione.
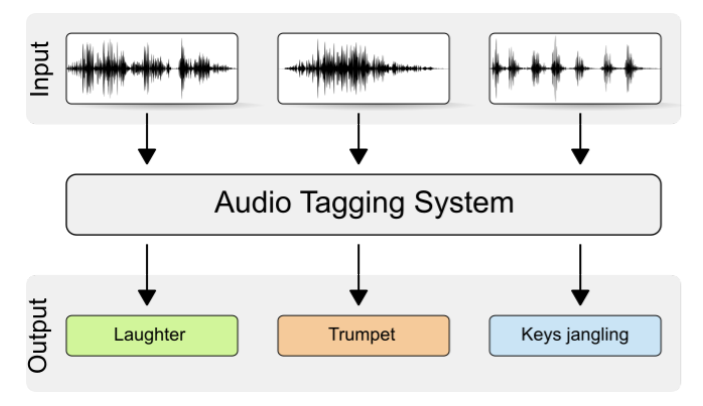
Tagging dei suoni. Fonte: Freesound Tagging by VGGish with KNN
Il tagging dei suoni avviene quando suoni specifici (ad es., rumore del traffico, versi di animali, ecc.) vengono etichettati all’interno di un file audio.
L’annotazione video consiste nell’etichettare e taggare oggetti o azioni nei fotogrammi di un video per aiutare i modelli di machine learning a interpretare movimenti e attività.
Le tecniche principali di annotazione video includono:
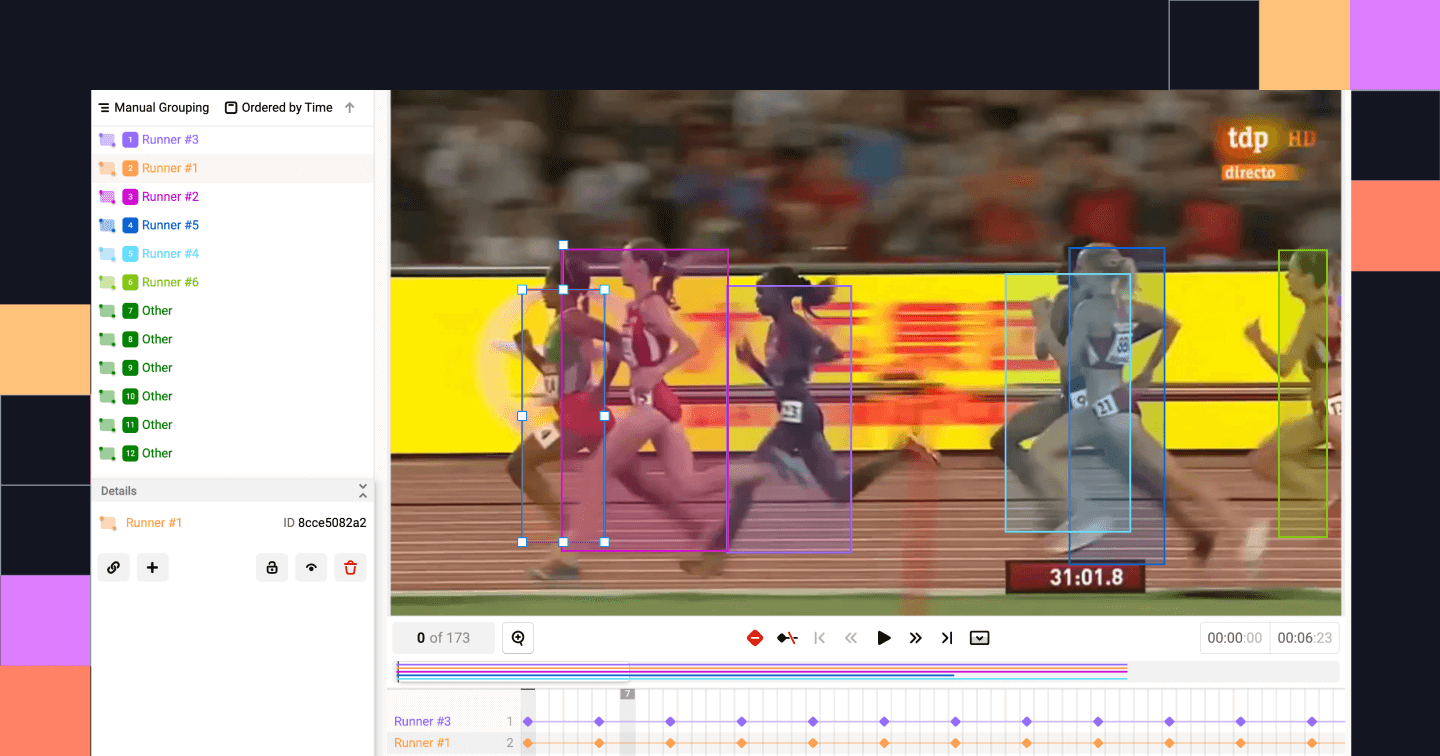
Tracciamento degli oggetti. Fonte: Label Studio
Il tracciamento degli oggetti prevede l’etichettatura continua degli oggetti su più fotogrammi per seguirne il movimento. Negli scenari di guida autonoma, per esempio, si può usare il tracciamento per seguire un veicolo attraverso un incrocio affollato.
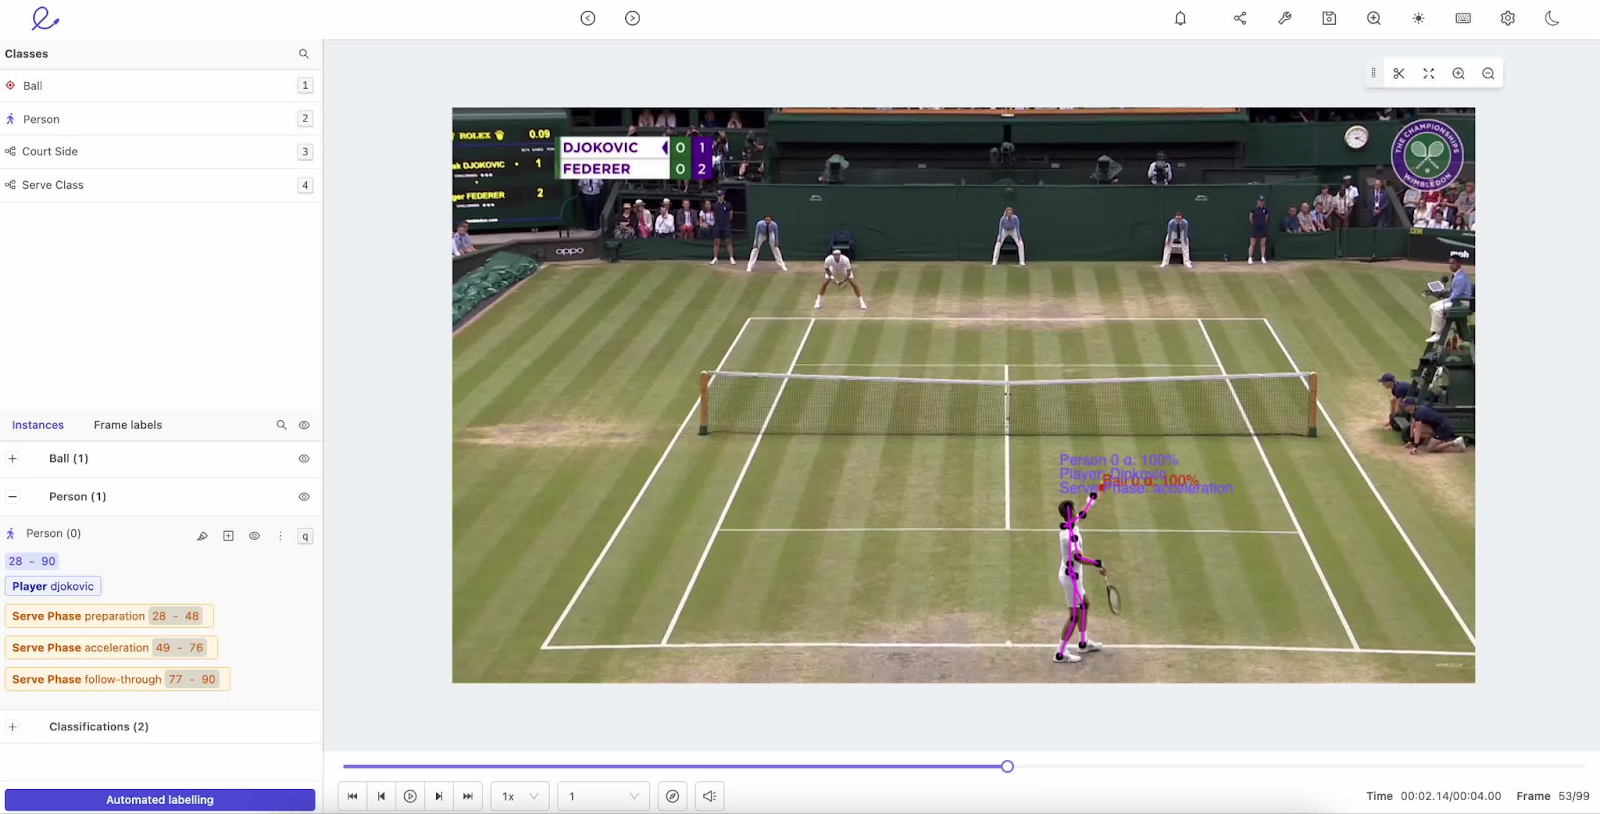
Etichettatura delle attività. Fonte: Encord
Qui le etichette vengono assegnate ad azioni specifiche, come qualcuno che cammina, corre o si siede in un video. Questo aiuta i modelli a comprendere il comportamento umano in applicazioni come il monitoraggio della sicurezza o l’analisi sportiva.
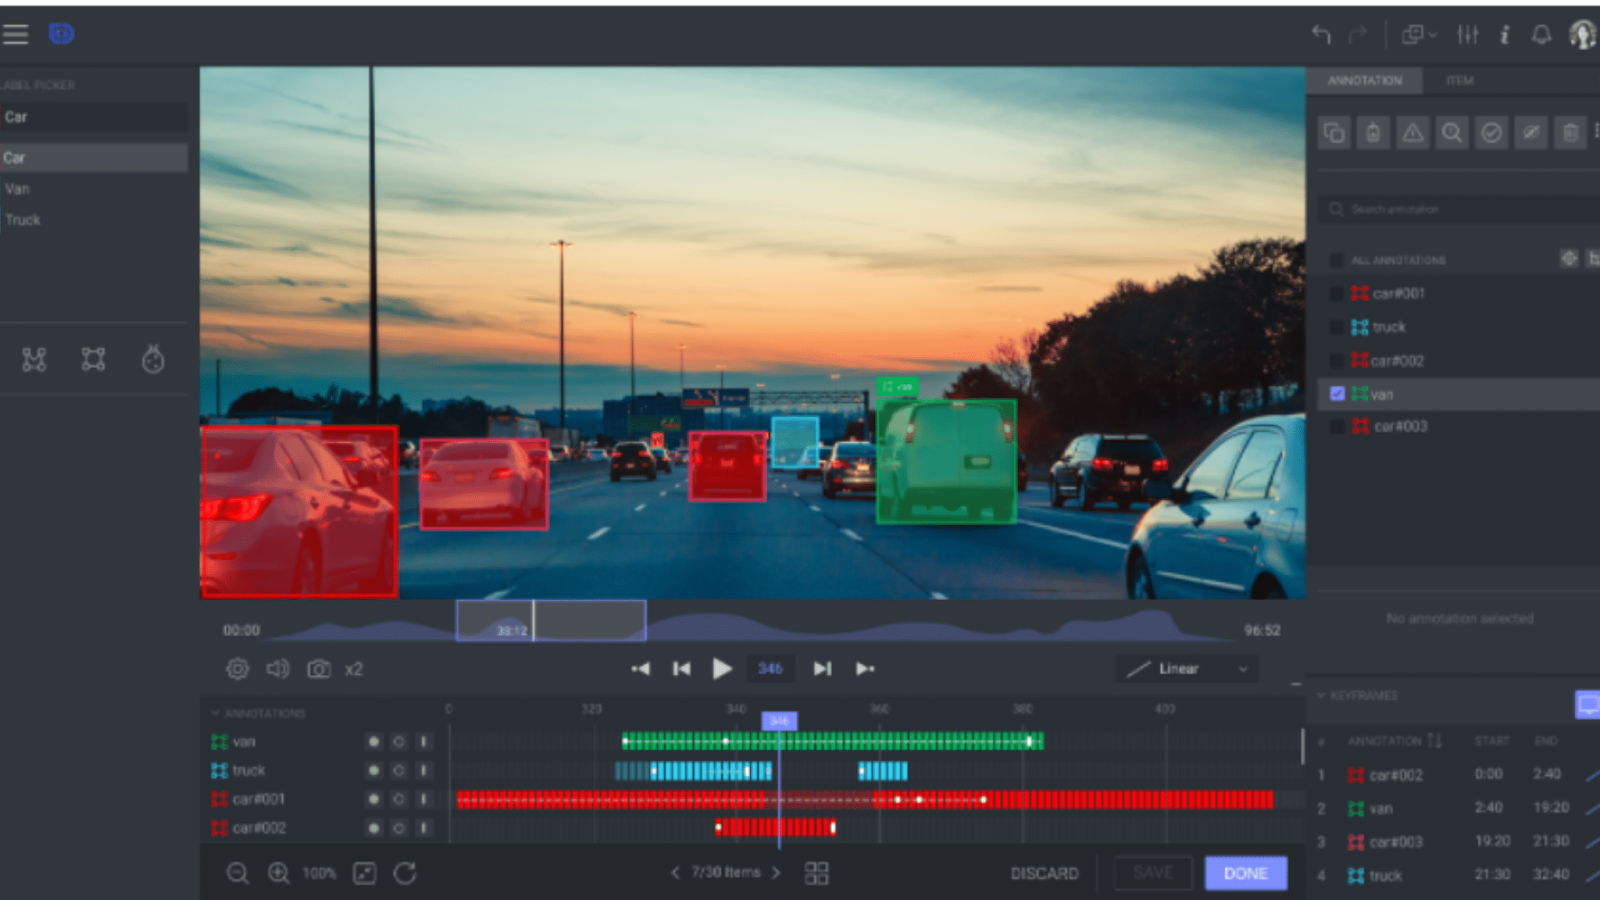
Annotazione frame-by-frame. Fonte: dataloop
Quando ogni singolo fotogramma di un video viene etichettato per cogliere dettagli minuziosi, si parla di rilevamento frame-by-frame. È spesso usato per compiti che richiedono alta precisione, come analizzare i movimenti del corpo in fisioterapia.
Il metodo usato per annotare i dati può variare in base a diversi fattori, come:
In altre parole, alcuni compiti richiedono l’accuratezza degli annotatori umani, mentre altri possono beneficiare dell’automazione per risparmiare tempo e scalare il processo. Di seguito esploreremo i vari approcci per darti un’idea più chiara di quando usare ciascuno di essi.
L’annotazione manuale avviene quando gli annotatori umani etichettano i dati a mano. In questo approccio, annotatori formati esaminano con cura ogni dato e applicano le etichette o i tag necessari.
Il vantaggio maggiore dell’annotazione manuale è l’accuratezza. Poiché gli esseri umani comprendono contesto, sfumature e schemi complessi meglio delle macchine, possono garantire che i dati siano etichettati con precisione. Questo livello di accuratezza è particolarmente importante per progetti che richiedono annotazioni di alta qualità e dettagliate, come l’etichettatura di immagini mediche o compiti complessi di linguaggio naturale.
Tuttavia, l’annotazione manuale presenta anche sfide significative:
Nonostante queste sfide, l’annotazione manuale rimane essenziale per progetti in cui la precisione è cruciale, anche se le aziende cercano spesso modi per bilanciare qualità con efficienza in termini di tempo e costi.
L’annotazione semi-automatica combina l’esperienza umana con l’assistenza del machine learning. In questo approccio, un modello di machine learning aiuta gli annotatori umani pre-etichettando i dati o offrendo suggerimenti. Gli annotatori umani poi rivedono e affinano le etichette per garantire l’accuratezza.
Il vantaggio dell’annotazione semi-automatica è che accelera il processo mantenendo comunque un alto livello di accuratezza. La macchina può gestire compiti ripetitivi o semplici, consentendo agli annotatori di concentrarsi su punti dati più complessi o ambigui. Questo approccio è ideale per progetti di grandi dimensioni in cui un’annotazione completamente manuale sarebbe troppo lenta o costosa, perché trova un equilibrio tra rapidità ed elementi di controllo qualità.
Tuttavia, presenta alcune sfide:
L’annotazione semi-automatica funziona meglio per progetti che devono bilanciare qualità e velocità, in cui i dati sono abbastanza complessi da richiedere una revisione umana ma abbastanza grandi da necessitare assistenza automatica.
L’annotazione automatica usa algoritmi di machine learning per etichettare i dati senza intervento umano. In questo approccio, modelli pre-addestrati o strumenti basati su IA annotano automaticamente grandi dataset. Il processo è così più rapido e scalabile rispetto ai metodi manuali o semi-automatici.
Il principale vantaggio dell’annotazione automatica è l’efficienza. Può elaborare enormi quantità di dati in una frazione del tempo necessario a un annotatore umano. Di conseguenza, è una soluzione ideale per progetti con dataset vastissimi, come taggare milioni di immagini per un modello di computer vision o trascrivere grandi volumi di audio per il riconoscimento vocale.
Ma i limiti dell’affidarsi alle macchine sono i seguenti:
L’annotazione automatica è più adatta a progetti che richiedono velocità e scalabilità ma in cui è accettabile un certo margine di errore, o quando una revisione umana può essere utilizzata successivamente per affinare i risultati.
Il crowdsourcing prevede la distribuzione dei compiti di etichettatura a un gran numero di collaboratori tramite piattaforme come Amazon Mechanical Turk o Appen. Questo metodo permette alle aziende di annotare grandi dataset in modo rapido ed economico, attingendo a una platea globale di lavoratori.
Uno dei principali vantaggi del crowdsourcing è la scalabilità. Distribuire i compiti a molti collaboratori consente di gestire grandi volumi di dati in modo efficiente. Per esempio, un progetto che richiede migliaia di immagini etichettate o trascrizioni può essere completato in giorni anziché settimane o mesi.
Gli svantaggi di questo approccio sono i seguenti:
Il crowdsourcing è ideale per progetti su larga scala che richiedono annotazioni rapide ed economiche. Tuttavia, per mantenere alta qualità servono una forte supervisione e una gestione accurata dei compiti.
Sono disponibili numerosi strumenti per l’annotazione dei dati. Vanno da piattaforme open source a soluzioni commerciali complete, ciascuna progettata per soddisfare esigenze progettuali diverse.
Per esempio, gli strumenti open source sono spesso personalizzabili e gratuiti. Questo li rende ideali per progetti più piccoli o team con competenze tecniche. Le opzioni commerciali, invece, offrono funzionalità più avanzate, tra cui automazione, strumenti di collaborazione e controllo qualità, risultando quindi più adatte a progetti su larga scala o a imprese che cercano un flusso di lavoro ottimizzato.
In questa sezione esploreremo alcuni degli strumenti più popolari per l’annotazione dei dati e come possano aiutare con diversi tipi di dati:
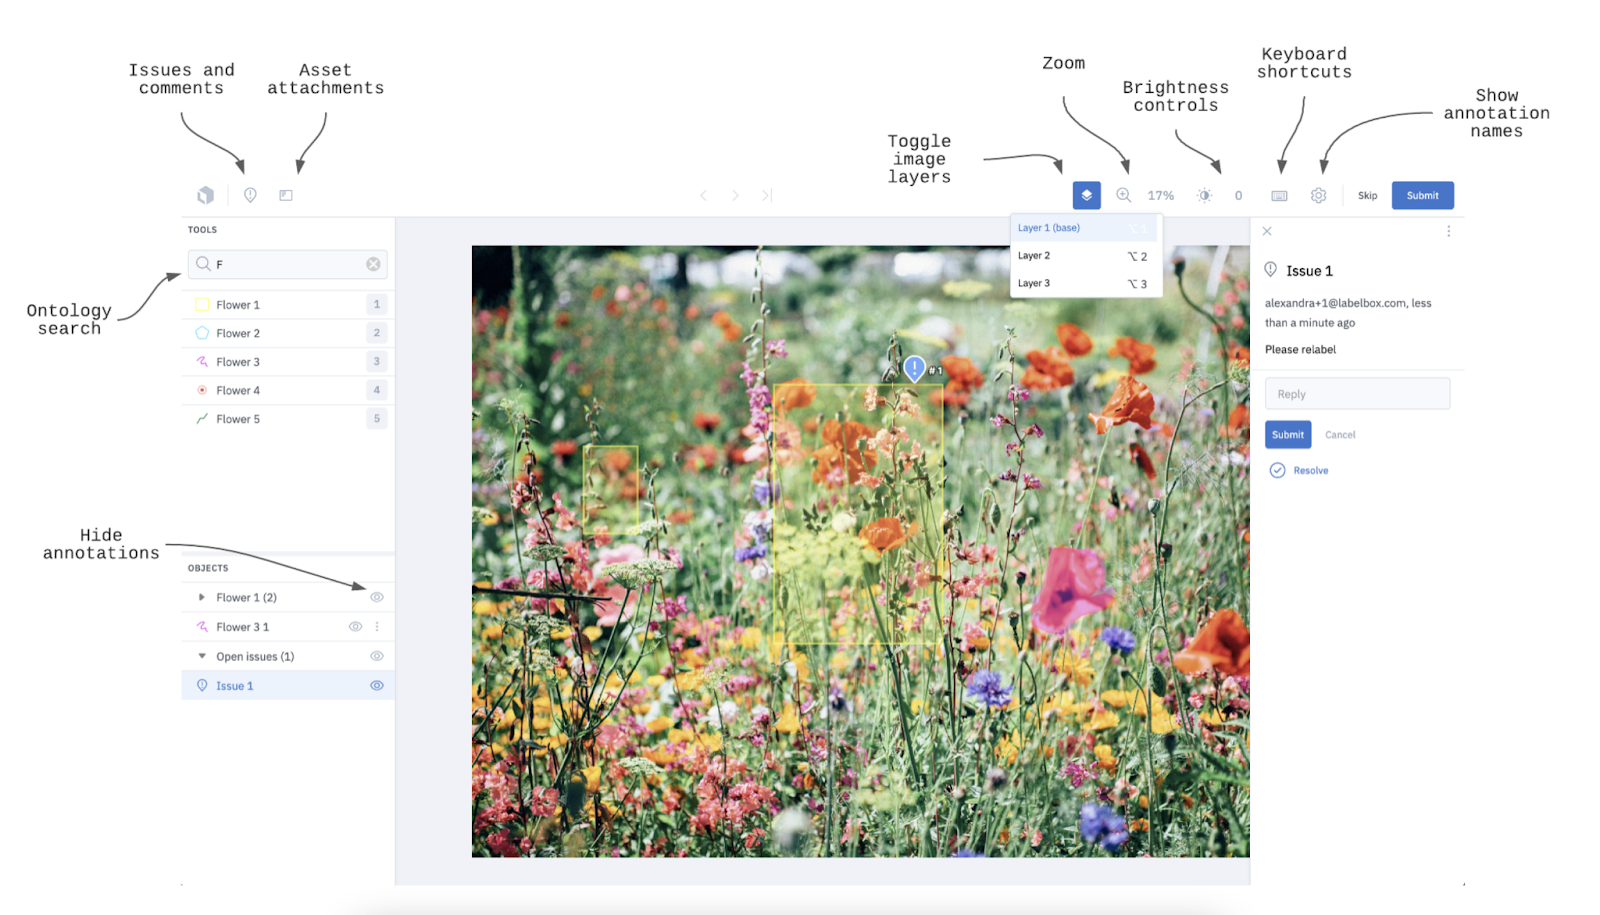
Fonte: Labelbox Docs
Labelbox è una piattaforma commerciale ampiamente utilizzata, progettata per semplificare il processo di annotazione dei dati, con un focus su collaborazione e controllo qualità. È stata fondata nel 2018 da Manu Sharma, Brian Rieger e Peter Welinder, con la missione “costruire i migliori prodotti per allinearsi con l’intelligenza artificiale.”
La piattaforma Labelbox offre un’interfaccia intuitiva in cui i team possono collaborare per annotare i dati, monitorare i progressi e mantenere standard elevati di annotazione. Supporta anche una varietà di tipi di dati (ad es., immagini, video e testo), rendendola estremamente versatile per diversi progetti di machine learning.
Una delle sue caratteristiche chiave sono i meccanismi di controllo qualità integrati, che permettono ai team di rivedere e approvare le annotazioni—garantendo risultati coerenti e accurati.
Labelbox è ideale per le organizzazioni che vogliono scalare gli sforzi di annotazione con funzionalità integrate di project management e automazione.
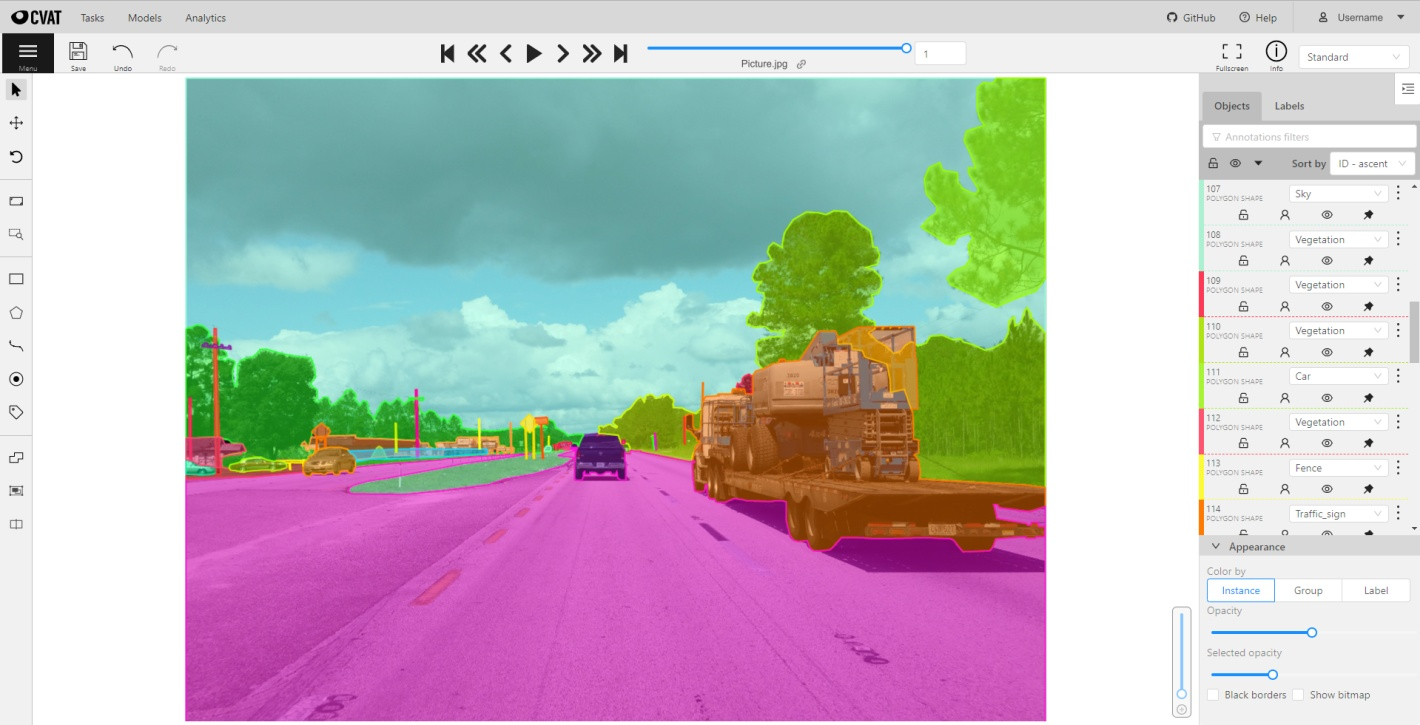
Fonte: Pagina Wikipedia di CVAT
CVAT è uno strumento open source specificamente progettato per annotare dataset di immagini e video. Sviluppato da Intel, CVAT è altamente personalizzabile e offre un’ampia gamma di tecniche di annotazione (ad es., bounding box, poligoni e annotazioni di punti chiave). La sua flessibilità lo rende adatto a progetti che vanno dal rilevamento di oggetti al riconoscimento facciale.
Essendo open source, CVAT è gratuito e può essere adattato a esigenze specifiche. Questo lo rende una scelta popolare per ricercatori e team più piccoli che necessitano di strumenti potenti senza i costi del software commerciale.
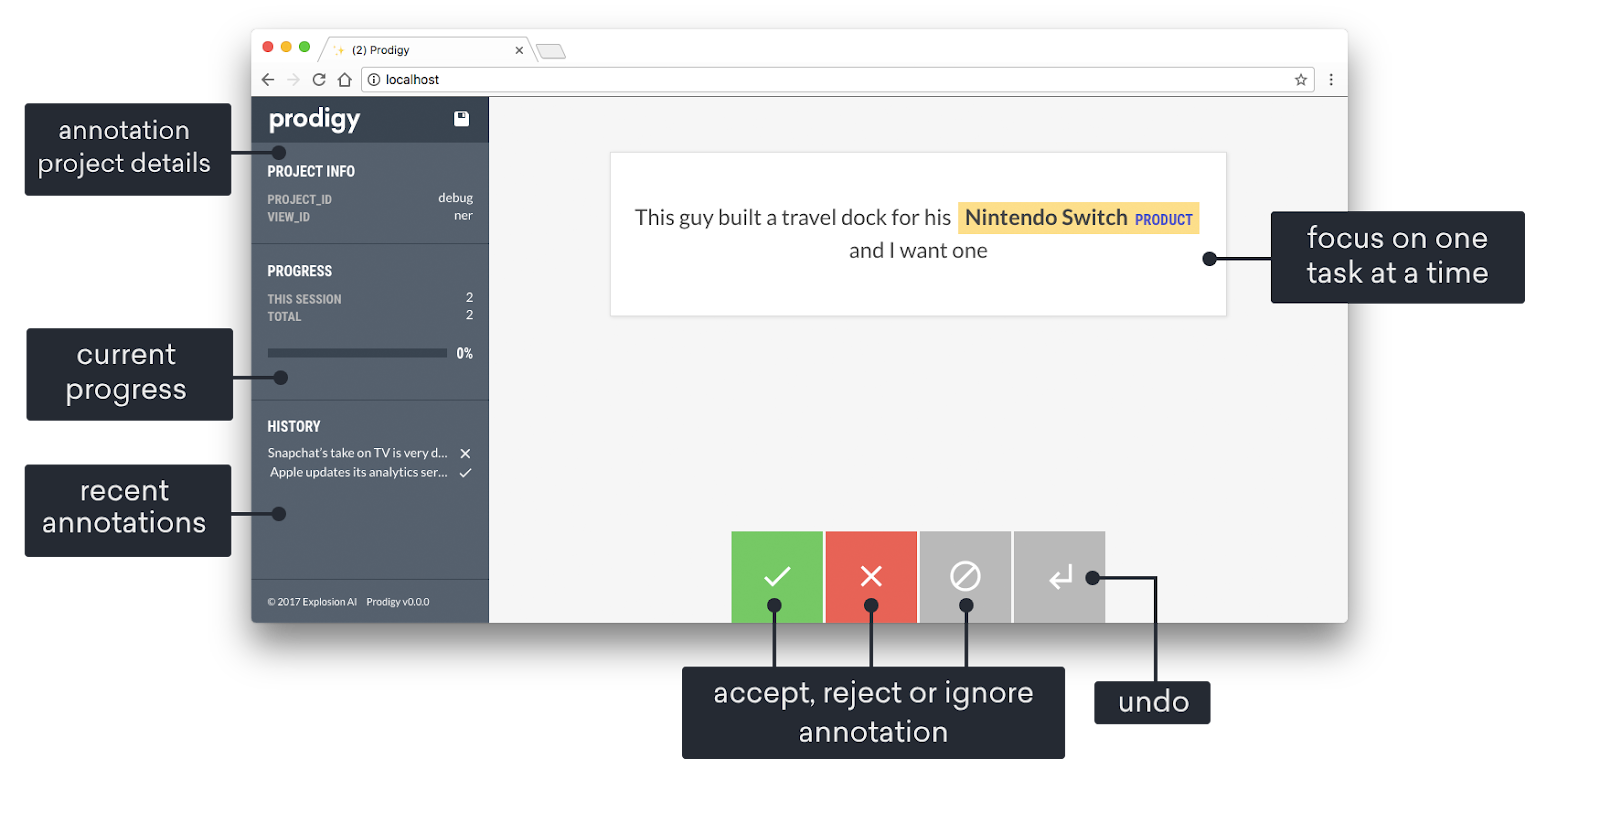
Fonte: Prodigy Docs
Prodigy è uno strumento di annotazione avanzato sviluppato da Explosion AI che utilizza l’active learning per migliorare l’efficienza, in particolare nei compiti di elaborazione del linguaggio naturale (NLP). Con Prodigy, un modello di machine learning assiste gli annotatori suggerendo etichette basate sulle proprie previsioni, che vengono poi confermate o corrette dai revisori umani.
Questo approccio interattivo accelera il processo di annotazione garantendo al contempo che i dati etichettati siano di alta qualità. Pur essendo uno strumento commerciale, Prodigy è altamente personalizzabile; per esempio, consente di creare flussi di lavoro di annotazione propri. Questi elementi rendono Prodigy molto adatto a team che lavorano su progetti NLP specializzati come analisi del sentiment, riconoscimento di entità o classificazione del testo.
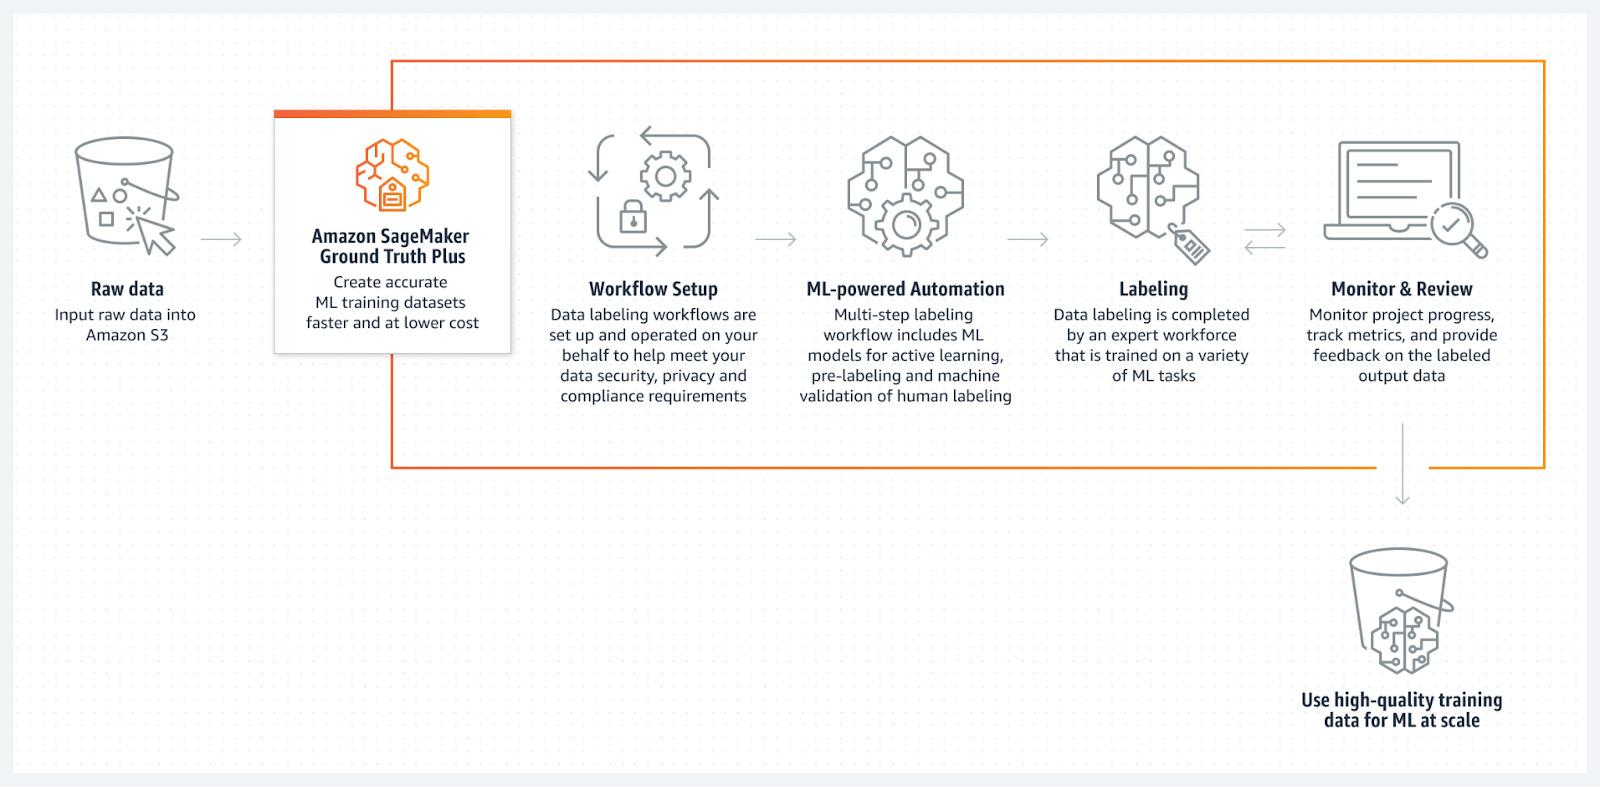
Fonte: Amazon SageMaker Ground Truth
Amazon SageMaker Ground Truth è un servizio di etichettatura dei dati completamente gestito che si integra perfettamente con AWS. Fornisce strumenti per l’annotazione manuale e automatica che consentono di etichettare i dati in modo rapido e accurato.
SageMaker Ground Truth utilizza il machine learning per assistere gli annotatori umani pre-etichettando i dati, accelerando il processo e riducendo i costi. Il servizio è anche estremamente versatile per diversi compiti di machine learning, poiché supporta una vasta gamma di tipi di dati, inclusi immagini, testo e video.
Inoltre, è costruito per scalare, il che lo rende una scelta forte per le imprese che richiedono capacità di annotazione su larga scala all’interno dell’ecosistema AWS.
Un’annotazione efficace è fondamentale per il successo dei modelli di machine learning, poiché la qualità dei dati etichettati influisce direttamente sull’accuratezza di previsioni e classificazioni. Seguire le best practice può aiutare a garantire che il processo di annotazione sia efficiente e affidabile.
In questa sezione esploreremo pratiche essenziali che possono migliorare qualità e coerenza dell’annotazione dei dati, affrontando al contempo le sfide che si possono incontrare nel processo di etichettatura.
Uno dei passaggi più importanti nel processo di annotazione è creare linee guida chiare e ben definite. Queste dovrebbero specificare esattamente come etichettare i dati e quali criteri seguire per garantire coerenza tra gli annotatori.
Linee guida chiare aiutano a:
Disporre di regole standardizzate è particolarmente cruciale per dati complessi o soggettivi, come immagini o testi con più possibili interpretazioni.
La qualità è necessaria per mantenere accuratezza e affidabilità dei dati annotati. Pertanto, i dati annotati devono essere periodicamente rivisti per verificare che rispettino gli standard richiesti. Questo processo può essere condotto tramite audit casuali, l’uso di più annotatori per gli stessi compiti (per confrontare i risultati) o il cross-checking delle annotazioni, a seconda del progetto.
In sostanza, è fondamentale implementare un solido processo di assicurazione della qualità per intercettare presto gli errori, ridurre i bias nei dati e garantire che i dati etichettati siano adeguati ad addestrare modelli di machine learning ad alte prestazioni.
L’active learning è una tecnica di machine learning che consente a un algoritmo di selezionare i campioni di dati più informativi da etichettare, migliorando le prestazioni del modello. Questa tecnica può aumentare significativamente l’efficienza del processo di annotazione. Permette agli annotatori di concentrare tempo ed energie sui punti dati più impegnativi e di maggior valore, mentre l’algoritmo suggerisce il resto.
Questo approccio riduce il tempo speso a etichettare esempi facili o ripetitivi e accelera l’intero processo di annotazione. Aumenta quindi le probabilità che il modello di machine learning usato per fare previsioni sia addestrato sugli esempi più critici.
Per assicurare che l’annotazione venga svolta con accuratezza, gli annotatori dovrebbero ricevere una formazione adeguata. La formazione li aiuta a comprendere i requisiti specifici del compito e come applicare correttamente le linee guida.
Annotatori ben formati sono più propensi a produrre dati etichettati di alta qualità, migliorando in definitiva le prestazioni dei modelli di machine learning che supportano. Sessioni di formazione regolari e cicli di feedback possono anche affinare le competenze degli annotatori nel tempo, migliorando ulteriormente il processo di annotazione.
Sebbene l’annotazione dei dati sia essenziale per addestrare modelli accurati di machine learning, il processo porta con sé una serie di sfide. In questa sezione discuteremo alcune delle più comuni.
L’annotazione manuale dei dati è spesso laboriosa. Annotare tutte le istanze richiede molto tempo e risorse economiche, soprattutto quando il dataset è ampio. Più i dati sono complessi (come video o immagini intricate), più l’annotazione diventa dispendiosa in termini di tempo. Occorre assumere annotatori qualificati, il che aumenta i costi.
Per superare questa sfida, le organizzazioni possono usare strumenti di annotazione semi-automatica, in cui i modelli di machine learning suggeriscono le etichette e gli umani le verificano. Questo velocizza il processo senza sacrificare l’accuratezza.
Anche l’active learning può aiutare concentrando lo sforzo umano sui dati più informativi, riducendo la quantità complessiva da etichettare manualmente. Inoltre, usare piattaforme di crowdsourcing come Amazon Mechanical Turk consente a più collaboratori di lavorare in parallelo, rendendo l’annotazione su larga scala più accessibile ed efficiente.
Un’altra sfida chiave è gestire soggettività e bias nel processo di annotazione. Annotatori diversi possono interpretare gli stessi dati in modi differenti. Questo è molto comune in compiti come etichettare emozioni nel testo o identificare oggetti in immagini complesse. Il problema è che la soggettività può introdurre bias nei dati etichettati, che a sua volta può portare a previsioni distorte del modello.
Per ridurre soggettività e bias, le organizzazioni dovrebbero creare linee guida di annotazione chiare e dettagliate che garantiscano che tutti gli annotatori seguano gli stessi criteri. Un’altra soluzione è usare più annotatori per gli stessi dati, consentendo il confronto incrociato e aiutando a individuare e correggere annotazioni distorte o incoerenti.
Annotazioni che rivelano informazioni identificative possono violare normative sulla privacy che proteggono i dati personali. Questa sfida è particolarmente rilevante quando si esternalizzano i compiti di annotazione o si usano piattaforme di crowdsourcing, dove molti collaboratori hanno accesso ai dati.
Soluzioni come l’anonimizzazione (rimozione delle informazioni personali identificabili) e l’uso di piattaforme sicure e crittografate per l’annotazione possono aiutare a mitigare questi rischi.
In questa sezione esploreremo le applicazioni reali dell’annotazione dei dati. Andiamo!
Nei veicoli autonomi, l’annotazione dei dati è la base per insegnare all’IA a muoversi in sicurezza nel mondo reale. Le auto a guida autonoma si affidano a dati annotati per identificare gli oggetti.
Per esempio, gli annotatori etichettano immagini o fotogrammi video disegnando bounding box attorno alle auto o marcando i confini della strada per il rilevamento delle corsie. Queste annotazioni aiutano l’IA a imparare come riconoscere e reagire a vari scenari stradali, come fermarsi per i pedoni o mantenere la corsia corretta.
I modelli di IA richiedono immagini mediche etichettate per imparare a rilevare anomalie. Ad esempio, annotatori esperti delineano aree specifiche nelle immagini per contrassegnare regioni che mostrano segni precoci di cancro. Questo consente all’IA di rilevare il cancro in modo rapido e accurato prima dei metodi tradizionali, migliorando gli esiti per i pazienti e riducendo il carico di lavoro per i professionisti sanitari.
Per i chatbot di assistenza clienti, l’annotazione del testo è fondamentale per insegnare all’IA a comprendere il linguaggio umano.
Per esempio, gli annotatori possono etichettare il testo per aiutare i chatbot a riconoscere l’intento dell’utente. I chatbot analizzano poi le interazioni etichettate per imparare a fornire le risposte appropriate. Questo consente alle organizzazioni di offrire assistenza più rapida e accurata e migliorare l’esperienza cliente.
Nell’analisi del sentiment, l’annotazione del testo viene usata per valutare come i clienti si sentono riguardo a certe cose (ad es., il brand, i prodotti o gli eventi). Funziona così: gli annotatori taggano frasi o periodi come positivi, negativi o neutri, e poi questi dati vengono passati all’IA per apprendere il sentimento sottostante. Un’azienda può quindi usarla per monitorare come viene accolto il lancio di un nuovo prodotto.
L’annotazione dei dati è il processo di etichettare i dati per renderli riconoscibili e utilizzabili dai modelli di machine learning. È un passaggio cruciale nello sviluppo di sistemi di IA in grado di interpretare e rispondere correttamente ai dati del mondo reale. Perché? Perché la qualità e l’accuratezza dei dati annotati influiscono direttamente sulle prestazioni e sull’efficacia dei modelli di IA.
In definitiva, l’annotazione dei dati è la base per costruire sistemi di IA intelligenti e affidabili che possano alimentare l’innovazione in vari settori. Questo la rende una parte imprescindibile dello sviluppo del machine learning.
Per proseguire il tuo apprendimento, dai un’occhiata alle seguenti risorse:
Approfondisci machine learning e IA con questi corsi!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min




