Hãy tưởng tượng bạn đang phát triển một chiếc xe tự lái. Để chiếc xe có thể "nhìn" và hiểu con đường, nó phải học cách nhận diện các đối tượng như người đi bộ, biển báo giao thông và các phương tiện khác. Để làm được điều này, hệ thống học máy của xe cần hàng nghìn—nếu không muốn nói là hàng triệu—hình ảnh từ các tình huống lái xe trong thế giới thực.
Nhưng bản thân chiếc xe không thể tự hiểu có gì trong ảnh. Nó không biết một hình bát giác màu đỏ là biển dừng hay một người đang đi trên vỉa hè. Đây chính là lúc gắn nhãn dữ liệu xuất hiện.
Gắn nhãn dữ liệu là quy trình gắn nhãn dữ liệu thô để giúp các mô hình học máy hiểu và sử dụng được. Chúng tôi sẽ giải thích sâu hơn sau, nhưng hãy ghi nhớ điều này.
Dưới đây là những gì chúng ta sẽ khám phá trong bài viết này:
- Các loại gắn nhãn dữ liệu khác nhau
- Các kỹ thuật được sử dụng
- Công cụ hiện có
- Thực tiễn tốt nhất
- Những thách thức trong quy trình này
Cùng bắt đầu nhé!
Gắn nhãn dữ liệu là gì?
Cách tốt nhất để hình dung về gắn nhãn dữ liệu là nghĩ đến việc dạy trẻ em về các loài động vật khác nhau. Lúc đầu, bạn cho chúng xem một bức ảnh con chó và nói, “Đây là con chó.” Rồi bạn cho xem một con mèo và nói, “Đây là con mèo.” Theo thời gian, bằng cách cho xem các ví dụ có gắn nhãn, đứa trẻ sẽ tự nhận biết được các loài vật. Gắn nhãn dữ liệu hoạt động tương tự đối với máy móc.
Cũng như một đứa trẻ cần các ví dụ có gắn nhãn (lưu ý: nói “Đây là con chó” chính là gắn nhãn), các mô hình học máy cần dữ liệu được gắn nhãn để học từ đó. Vì thế, gắn nhãn dữ liệu là quá trình gắn nhãn hoặc gắn thẻ cho dữ liệu như hình ảnh, văn bản hoặc âm thanh, để các thuật toán học máy có thể nhận biết và hiểu được.
Các nhãn đóng vai trò là ví dụ dạy hệ thống biết cần tìm mẫu nào. Chẳng hạn, nếu bạn gắn nhãn hàng nghìn hình ảnh với nhãn "chó" hoặc "mèo", mô hình sẽ bắt đầu nhận ra sự khác biệt giữa hai loài.
Sau khi học từ các ví dụ này, mô hình có thể đưa ra dự đoán hoặc phân loại dữ liệu chưa gắn nhãn mới, giống như đứa trẻ cuối cùng tự nhận ra loài vật mà không cần bạn giúp.
Các loại gắn nhãn dữ liệu
Những loại dữ liệu khác nhau cần các phương pháp gắn nhãn cụ thể để chuẩn bị cho các tác vụ học máy. Tùy theo bản chất dữ liệu, có những cách tiếp cận riêng để gắn nhãn và gắn thẻ. Hiểu các loại này giúp xác định cách hiệu quả nhất để huấn luyện mô hình cho nhiều ứng dụng khác nhau.
Hãy cùng khám phá các loại gắn nhãn dữ liệu phổ biến nhất:
Gắn nhãn hình ảnh
Gắn nhãn hình ảnh là gắn nhãn cho ảnh để các mô hình học máy có thể nhận diện và diễn giải các đối tượng trong đó. Có nhiều kỹ thuật khác nhau trong gắn nhãn hình ảnh, tùy mức độ chi tiết yêu cầu:
Hộp giới hạn (Bounding boxes)
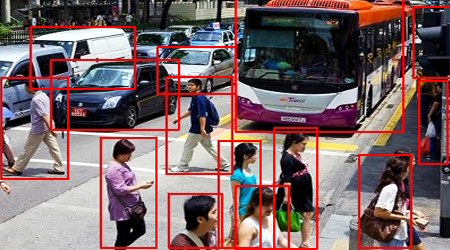
Hộp giới hạn. Nguồn: Anolytics
Phương pháp này vẽ các hình chữ nhật quanh đối tượng trong ảnh để giúp mô hình nhận diện sự hiện diện và vị trí của chúng. Hộp giới hạn thường dùng để phát hiện ô tô, người đi bộ hoặc biển báo trong công nghệ xe tự lái.
Phân đoạn ngữ nghĩa (Semantic segmentation)
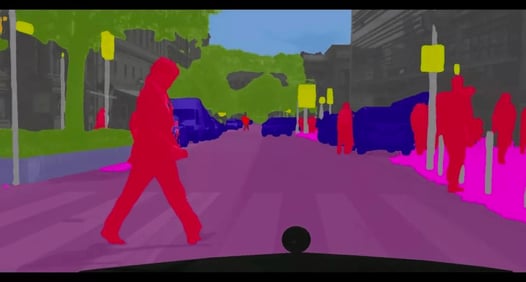
Phân đoạn ngữ nghĩa. Nguồn: Introduction to Semantic Image Segmentation
Ở đây, mỗi điểm ảnh trong một bức ảnh được gắn nhãn để gán các vùng cụ thể cho những đối tượng hoặc danh mục nhất định, như xác định đường, tòa nhà hoặc cây cối. Kỹ thuật này mang lại cho mô hình hiểu biết chi tiết hơn về khung cảnh.
Gắn mốc (Landmark annotation)
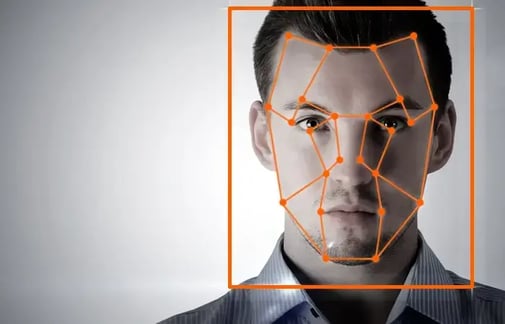
Gắn mốc. Nguồn: Anolytics
Kỹ thuật này đánh dấu các điểm cụ thể trong ảnh, chẳng hạn các đặc điểm khuôn mặt hoặc điểm chính trong tư thế cơ thể. Nó được dùng trong các ứng dụng như nhận diện khuôn mặt và ước lượng tư thế người.
Gắn nhãn văn bản
Gắn nhãn văn bản là quá trình gắn nhãn và gắn thẻ dữ liệu văn bản để trở nên dễ hiểu cho các mô hình xử lý ngôn ngữ tự nhiên (NLP). Nó giúp máy móc hiểu, xử lý và phân tích ngôn ngữ con người.
Có một số kỹ thuật phổ biến trong gắn nhãn văn bản:
Nhận diện thực thể (Entity recognition)
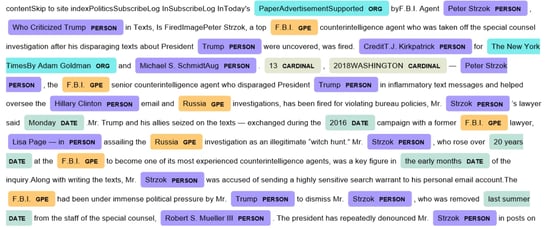
Nhận diện thực thể. Nguồn: Named Entity Recognition and Classification with Scikit-Learn
Bao gồm việc xác định các thực thể cụ thể trong văn bản, như tên người, địa điểm hoặc tổ chức. Ví dụ, trong câu "Apple mở một cửa hàng mới ở New York," mô hình sẽ nhận ra "Apple" là công ty và "New York" là địa điểm.
Gắn thẻ cảm xúc (Sentiment tagging)
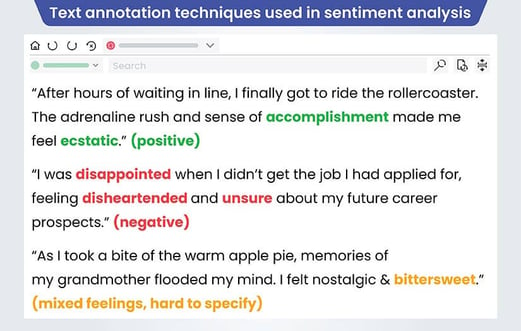
Gắn thẻ cảm xúc. Nguồn: Understanding the text annotation process for Customer Sentiment Analysis
Kỹ thuật này gán cảm xúc hoặc quan điểm cho các đoạn văn bản, gắn nhãn chúng là tích cực, tiêu cực hoặc trung tính. Thường được sử dụng trong đánh giá khách hàng hoặc giám sát mạng xã hội để hiểu người dùng cảm nhận thế nào về sản phẩm hoặc dịch vụ.
Gắn thẻ từ loại (Part-of-speech tagging)
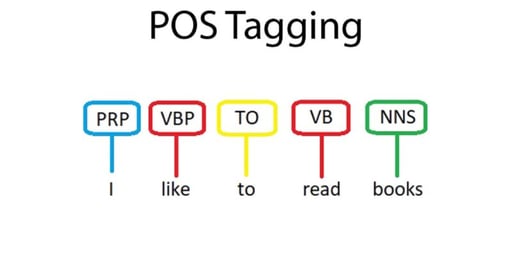
Gắn thẻ từ loại. Nguồn: POS tagging in NLP
Phương pháp này gắn nhãn cho từng từ trong câu theo vai trò ngữ pháp (ví dụ: danh từ, động từ, tính từ), giúp mô hình hiểu cấu trúc ngôn ngữ cho các tác vụ như dịch hoặc nhận dạng giọng nói.
Gắn nhãn âm thanh
Gắn nhãn âm thanh là gắn nhãn các tệp âm thanh để huấn luyện mô hình cho nhận dạng giọng nói, nhận diện nhạc hoặc phân loại âm thanh.
Một số kỹ thuật gắn nhãn âm thanh phổ biến gồm:
Phiên âm (Transcription)
Chuyển lời nói trong một tệp âm thanh thành văn bản viết thường được sử dụng trong các ứng dụng chuyển giọng nói thành văn bản.
Phân đoạn lời nói (Speech segmentation)
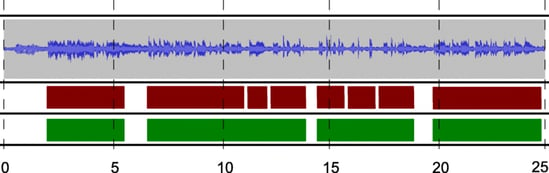
Phân đoạn lời nói. Nguồn: ResearchGate
Chia một tệp âm thanh thành các phần khác nhau. Ví dụ, bạn có thể muốn tách đối thoại khỏi tiếng ồn nền hoặc xác định từng người nói trong một cuộc trò chuyện.
Gắn thẻ âm thanh (Sound tagging)
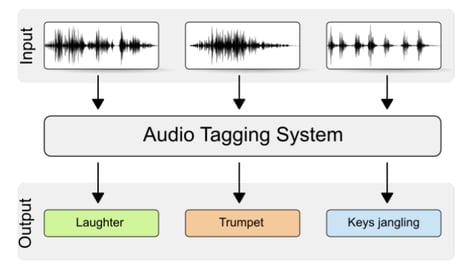
Gắn thẻ âm thanh. Nguồn: Freesound Tagging by VGGish with KNN
Gắn thẻ âm thanh là khi các âm thanh cụ thể (ví dụ: tiếng xe cộ, tiếng động vật, v.v.) được gắn nhãn trong một tệp âm thanh.
Gắn nhãn video
Gắn nhãn video là gắn nhãn và gắn thẻ các đối tượng hoặc hành động trong các khung hình video để giúp mô hình học máy diễn giải chuyển động và hoạt động.
Các kỹ thuật gắn nhãn video then chốt gồm:
Theo dõi đối tượng (Object tracking)
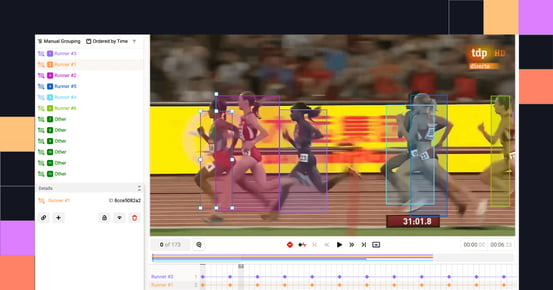
Theo dõi đối tượng. Nguồn: Label Studio
Theo dõi đối tượng là liên tục gắn nhãn đối tượng qua nhiều khung hình để theo dõi chuyển động của chúng. Ví dụ, trong bối cảnh lái xe tự hành, bạn có thể dùng theo dõi đối tượng để bám theo một chiếc xe đi qua ngã tư đông đúc.
Gắn nhãn hoạt động (Activity labeling)
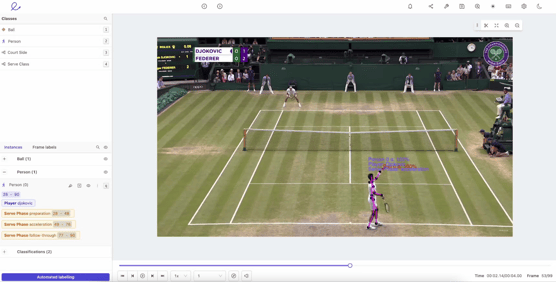
Gắn nhãn hoạt động. Nguồn: Encord
Là khi gán nhãn cho các hành động cụ thể, như ai đó đang đi bộ, chạy hay ngồi xuống trong video. Điều này giúp mô hình hiểu hành vi con người trong các ứng dụng như giám sát an ninh hoặc phân tích thể thao.
Gắn nhãn từng khung hình (Frame-by-frame annotation)
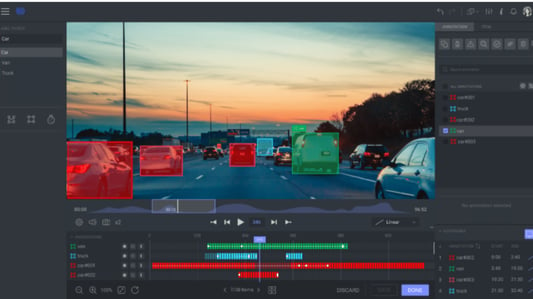
Gắn nhãn từng khung hình. Nguồn: dataloop
Khi từng khung hình của video được gắn nhãn để nắm bắt các chi tiết rất nhỏ, đó là phát hiện theo từng khung. Thường dùng cho các tác vụ đòi hỏi độ chính xác cao, như phân tích chuyển động cơ thể trong vật lý trị liệu.
Kỹ thuật gắn nhãn dữ liệu
Phương pháp dùng để gắn nhãn dữ liệu có thể khác nhau tùy thuộc vào một số yếu tố, chẳng hạn:
- Độ phức tạp của dự án
- Kích thước tập dữ liệu
- Mức độ chính xác cần thiết
Nói cách khác, một số tác vụ cần độ chính xác của người gắn nhãn, trong khi các tác vụ khác có thể hưởng lợi từ tự động hóa để tiết kiệm thời gian và mở rộng quy mô. Bên dưới, chúng tôi sẽ khám phá các cách tiếp cận khác nhau để bạn hiểu rõ hơn nên dùng cách nào trong tình huống nào.
Gắn nhãn thủ công
Gắn nhãn thủ công là khi con người tự tay gắn nhãn dữ liệu. Trong cách tiếp cận này, các nhân sự được đào tạo sẽ xem xét cẩn thận từng mẫu dữ liệu và áp dụng nhãn hoặc thẻ cần thiết.
Ưu điểm lớn nhất của gắn nhãn thủ công là độ chính xác. Vì con người hiểu ngữ cảnh, sắc thái và các mẫu phức tạp tốt hơn máy móc, họ có thể đảm bảo dữ liệu được gắn nhãn chính xác. Mức độ chính xác này đặc biệt quan trọng cho các dự án yêu cầu gắn nhãn chi tiết, chất lượng cao, như gắn nhãn ảnh y khoa hoặc các tác vụ ngôn ngữ tự nhiên phức tạp.
Tuy nhiên, gắn nhãn thủ công cũng có những thách thức đáng kể:
- Tốn thời gian: Gắn nhãn thủ công cho các tập dữ liệu lớn mất rất nhiều thời gian, đặc biệt khi dữ liệu phức tạp hoặc đồ sộ. Ví dụ, gắn nhãn hàng nghìn hình ảnh cho một dự án thị giác máy tính có thể mất hàng tuần hoặc hàng tháng.
- Tốn kém: Gắn nhãn thủ công đòi hỏi nhiều nhân lực và thường tốn chi phí cao, đặc biệt khi cần các chuyên gia, như với dữ liệu y tế hoặc pháp lý.
Bất chấp các thách thức này, gắn nhãn thủ công vẫn là thiết yếu cho những dự án mà độ chính xác là tối quan trọng, dù các doanh nghiệp thường tìm cách cân bằng chất lượng với hiệu quả thời gian và chi phí.
Gắn nhãn bán tự động
Gắn nhãn bán tự động kết hợp chuyên môn của con người với sự hỗ trợ của học máy. Trong cách này, một mô hình học máy hỗ trợ người gắn nhãn bằng cách gắn nhãn trước dữ liệu hoặc đưa ra gợi ý. Người gắn nhãn sau đó sẽ xem xét và tinh chỉnh nhãn để đảm bảo độ chính xác.
Lợi ích của gắn nhãn bán tự động là tăng tốc quy trình trong khi vẫn giữ mức độ chính xác cao. Máy có thể xử lý các tác vụ lặp đi lặp lại hoặc đơn giản, cho phép người gắn nhãn tập trung vào các điểm dữ liệu phức tạp hoặc mơ hồ hơn. Cách tiếp cận này lý tưởng cho các dự án lớn mà nếu gắn nhãn hoàn toàn thủ công sẽ quá chậm hoặc tốn kém, vì nó cân bằng giữa hiệu quả thời gian và kiểm soát chất lượng.
Tuy nhiên, nó cũng đối mặt với một số thách thức:
- Gợi ý của mô hình có thể không chính xác: Nhãn do máy tạo ra không phải lúc nào cũng đúng, buộc người gắn nhãn phải tốn thêm thời gian để rà soát và sửa lỗi.
- Cần con người tham gia liên tục: Dù có tự động hóa, giám sát của con người vẫn cần thiết, có thể làm chậm quá trình, đặc biệt với dữ liệu phức tạp.
- Thời gian thiết lập ban đầu: Việc thiết lập và huấn luyện mô hình để đưa ra gợi ý hữu ích có thể mất thời gian, và kết quả ban đầu kém có thể làm giảm lợi ích của tự động hóa ở giai đoạn đầu.
Gắn nhãn bán tự động phù hợp nhất với các dự án cần cân bằng chất lượng với tốc độ, nơi dữ liệu đủ phức tạp để hưởng lợi từ việc con người xem xét, nhưng cũng đủ lớn để cần sự hỗ trợ của máy.
Gắn nhãn tự động
Gắn nhãn tự động sử dụng các thuật toán học máy để gắn nhãn dữ liệu mà không cần con người tham gia. Trong cách này, các mô hình được huấn luyện sẵn hoặc công cụ do AI điều khiển sẽ tự động gắn nhãn cho các tập dữ liệu lớn. Điều này làm cho quy trình nhanh hơn và dễ mở rộng hơn so với phương pháp thủ công hoặc bán tự động.
Ưu điểm chính của gắn nhãn tự động là hiệu suất. Nó có thể xử lý lượng dữ liệu khổng lồ trong một phần thời gian so với người gắn nhãn. Do đó, gắn nhãn tự động là giải pháp lý tưởng cho các dự án có tập dữ liệu khổng lồ, như gắn thẻ hàng triệu hình ảnh cho mô hình thị giác máy tính hoặc phiên âm lượng lớn âm thanh cho nhận dạng giọng nói.
Nhưng những hạn chế khi phụ thuộc vào máy như sau:
- Độ chính xác thấp hơn: Hệ thống tự động có thể mắc lỗi, đặc biệt với dữ liệu mơ hồ, nhiễu hoặc biến thiên cao. Điều này dẫn đến chất lượng gắn nhãn thấp hơn so với dữ liệu do con người gắn.
- Chi phí thiết lập cao: Phát triển hoặc mua công cụ do AI điều khiển và huấn luyện chúng để gắn nhãn chính xác thường đòi hỏi đầu tư đáng kể cả về chi phí lẫn thời gian.
- Hạn chế khi xử lý dữ liệu phức tạp: Gắn nhãn tự động gặp khó với các tác vụ cần hiểu ngữ cảnh hoặc sắc thái, như diễn giải sắc thái cảm xúc trong văn bản hoặc xác định chi tiết hình ảnh tinh vi.
Gắn nhãn tự động phù hợp nhất với các dự án yêu cầu tốc độ và khả năng mở rộng, nơi có thể chấp nhận một mức sai số nhất định hoặc có thể dùng con người rà soát sau để tinh chỉnh kết quả.
Nguồn lực cộng đồng (Crowdsourcing)
Nguồn lực cộng đồng là phân phối các tác vụ gắn nhãn dữ liệu cho số lượng lớn cộng tác viên thông qua các nền tảng như Amazon Mechanical Turk hoặc Appen. Cách này giúp doanh nghiệp nhanh chóng và tiết kiệm chi phí khi gắn nhãn các tập dữ liệu lớn bằng cách tận dụng lực lượng lao động toàn cầu.
Một trong những lợi thế chính của nguồn lực cộng đồng là khả năng mở rộng. Việc phân phối tác vụ cho nhiều cộng tác viên cho phép các công ty xử lý hiệu quả khối lượng dữ liệu lớn. Chẳng hạn, một dự án yêu cầu hàng nghìn hình ảnh gắn nhãn hoặc phiên âm có thể hoàn thành trong vài ngày thay vì vài tuần hay vài tháng.
Những điểm bất lợi của cách này như sau:
- Chất lượng không đồng đều: Do cộng tác viên có trình độ và mức độ chú ý khác nhau, chất lượng gắn nhãn có thể dao động. Doanh nghiệp có thể cần áp dụng các biện pháp kiểm soát chất lượng, như để nhiều người cùng gắn nhãn một dữ liệu hoặc rà soát một phần công việc để đảm bảo độ chính xác.
- Giới hạn ở tác vụ đơn giản: Nguồn lực cộng đồng hiệu quả nhất với các tác vụ gắn nhãn đơn giản, không đòi hỏi chuyên môn sâu. Những tác vụ phức tạp như gắn nhãn ảnh y tế hoặc văn bản pháp lý có thể vượt quá khả năng của người không chuyên.
- Điều phối và quản lý: Quản lý số lượng lớn cộng tác viên có thể khó khăn. Đảm bảo tính nhất quán, đặt hướng dẫn rõ ràng và duy trì quyền riêng tư dữ liệu là điều thiết yếu nhưng thách thức khi làm việc với lao động cộng đồng.
Nguồn lực cộng đồng lý tưởng cho các dự án quy mô lớn cần gắn nhãn nhanh và tiết kiệm chi phí. Tuy nhiên, để duy trì chất lượng cao cần có giám sát và quản trị tác vụ chặt chẽ.
Công cụ gắn nhãn dữ liệu
Có rất nhiều công cụ dành cho gắn nhãn dữ liệu. Chúng trải dài từ nền tảng mã nguồn mở đến các giải pháp thương mại toàn diện, mỗi loại được thiết kế để đáp ứng nhu cầu dự án khác nhau.
Ví dụ, các công cụ mã nguồn mở thường có thể tùy chỉnh và miễn phí sử dụng. Điều này khiến chúng phù hợp cho các dự án nhỏ hơn hoặc đội ngũ có chuyên môn kỹ thuật. Mặt khác, các lựa chọn thương mại cung cấp nhiều tính năng nâng cao, bao gồm tự động hóa, công cụ cộng tác và kiểm soát chất lượng, phù hợp hơn với các dự án quy mô lớn hoặc doanh nghiệp muốn có quy trình làm việc tinh gọn.
Trong phần này, chúng ta sẽ xem xét một số công cụ phổ biến nhất dành cho gắn nhãn dữ liệu và cách chúng hỗ trợ các loại dữ liệu khác nhau:
Labelbox
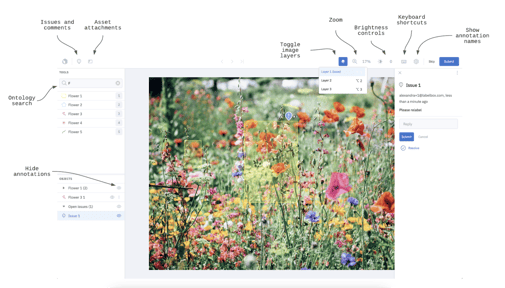
Nguồn: Labelbox Docs
Labelbox là một nền tảng thương mại được sử dụng rộng rãi, thiết kế để tinh gọn quy trình gắn nhãn dữ liệu, tập trung vào cộng tác và kiểm soát chất lượng. Nó được thành lập năm 2018 bởi Manu Sharma, Brian Rieger và Peter Welinder, với sứ mệnh “xây dựng những sản phẩm tốt nhất để phù hợp với trí tuệ nhân tạo.”
Nền tảng Labelbox cung cấp giao diện trực quan nơi các nhóm có thể cộng tác để gắn nhãn dữ liệu, theo dõi tiến độ và duy trì tiêu chuẩn gắn nhãn cao. Nó cũng hỗ trợ nhiều loại dữ liệu (ví dụ: hình ảnh, video và văn bản), khiến nền tảng trở nên cực kỳ linh hoạt cho các dự án học máy khác nhau.
Một trong những tính năng chính là cơ chế kiểm soát chất lượng tích hợp, cho phép các nhóm rà soát và phê duyệt nhãn—đảm bảo kết quả nhất quán và chính xác.
Labelbox phù hợp cho các tổ chức muốn mở rộng nỗ lực gắn nhãn với khả năng quản lý dự án và tự động hóa tích hợp.
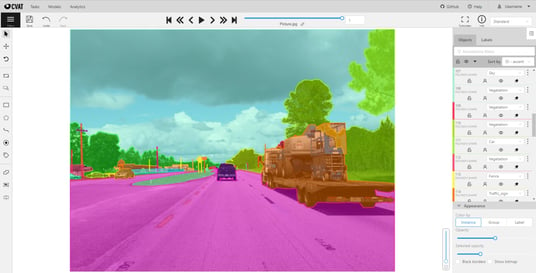
Nguồn: Trang Wikipedia CVAT
CVAT là một công cụ mã nguồn mở được thiết kế đặc thù để gắn nhãn tập dữ liệu hình ảnh và video. Phát triển bởi Intel, CVAT có khả năng tùy biến cao và cung cấp nhiều kỹ thuật gắn nhãn (ví dụ: hộp giới hạn, đa giác, và gắn điểm chính). Tính linh hoạt của nó phù hợp cho các dự án từ phát hiện đối tượng đến nhận diện khuôn mặt.
Vì là mã nguồn mở, CVAT miễn phí sử dụng và có thể điều chỉnh để đáp ứng nhu cầu dự án cụ thể. Điều này khiến nó trở thành lựa chọn phổ biến cho các nhà nghiên cứu và đội ngũ nhỏ cần công cụ gắn nhãn mạnh mà không tốn chi phí phần mềm thương mại.
Prodigy
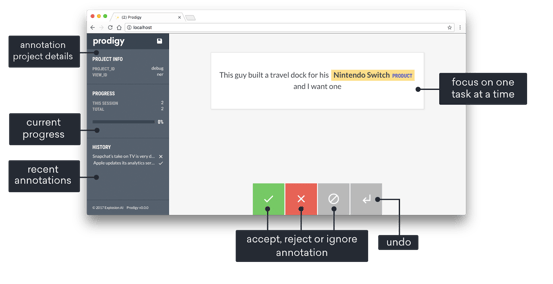
Nguồn: Prodigy Docs
Prodigy là một công cụ gắn nhãn nâng cao do Explosion AI phát triển, sử dụng học chủ động để tăng hiệu suất, đặc biệt trong các tác vụ xử lý ngôn ngữ tự nhiên (NLP). Với Prodigy, mô hình học máy hỗ trợ người gắn nhãn bằng cách đề xuất nhãn dựa trên dự đoán của nó, sau đó được người rà soát xác nhận hoặc chỉnh sửa.
Cách tiếp cận tương tác này tăng tốc quá trình gắn nhãn đồng thời đảm bảo dữ liệu được gắn nhãn có chất lượng cao. Dù là công cụ thương mại, Prodigy vẫn có khả năng tùy biến cao; ví dụ, cho phép người dùng tạo quy trình gắn nhãn riêng. Những yếu tố này khiến Prodigy rất phù hợp cho các đội ngũ làm dự án NLP chuyên biệt như phân tích cảm xúc, nhận diện thực thể, hoặc phân loại văn bản.
Amazon SageMaker Ground Truth
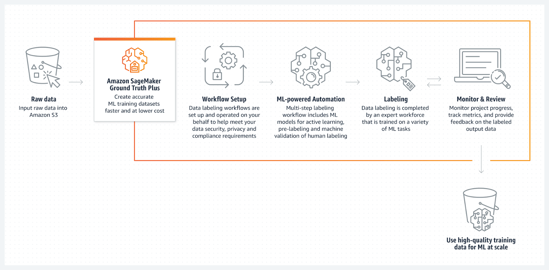
Nguồn: Amazon SageMaker Ground Truth
Amazon SageMaker Ground Truth là một dịch vụ gắn nhãn dữ liệu được quản lý hoàn toàn, tích hợp liền mạch với AWS. Nó cung cấp các công cụ gắn nhãn dữ liệu thủ công và tự động, cho phép người dùng gắn nhãn nhanh và chính xác.
SageMaker Ground Truth sử dụng học máy để hỗ trợ người gắn nhãn bằng cách gắn nhãn trước dữ liệu, giúp tăng tốc quy trình và giảm chi phí. Dịch vụ này cũng cực kỳ linh hoạt cho các tác vụ học máy khác nhau vì hỗ trợ đa dạng loại dữ liệu, bao gồm hình ảnh, văn bản và video.
Ngoài ra, nó được xây dựng để mở rộng quy mô, nghĩa là là lựa chọn mạnh mẽ cho doanh nghiệp cần khả năng gắn nhãn quy mô lớn trong hệ sinh thái AWS.
Các công cụ khác nên cân nhắc
- LabelImg: Một công cụ mã nguồn mở dành riêng cho gắn nhãn hình ảnh. Cho phép người dùng tạo và chỉnh sửa hộp giới hạn để phát hiện đối tượng.
- VGG Image Annotator (VIA): Công cụ nhẹ và dễ sử dụng để gắn nhãn hình ảnh và video, lý tưởng cho nhà nghiên cứu hoặc dự án nhỏ cần chức năng gắn nhãn cơ bản.
- Dataloop: Một nền tảng thương mại kết hợp công cụ gắn nhãn với quản lý dữ liệu và tính năng tự động hóa, phù hợp cho các đội cần quy trình gắn nhãn có thể mở rộng với khả năng AI tích hợp.
Thực tiễn tốt nhất cho gắn nhãn dữ liệu
Gắn nhãn dữ liệu hiệu quả là yếu tố then chốt cho thành công của các mô hình học máy, vì chất lượng dữ liệu được gắn nhãn tác động trực tiếp đến độ chính xác của dự đoán và phân loại. Tuân thủ các thực tiễn tốt nhất có thể giúp đảm bảo quy trình gắn nhãn vừa hiệu quả vừa đáng tin cậy.
Trong phần này, chúng ta sẽ khám phá các thực tiễn thiết yếu có thể nâng cao chất lượng và tính nhất quán của gắn nhãn dữ liệu, đồng thời giải quyết những thách thức có thể gặp trong quá trình gắn nhãn.
Xây dựng hướng dẫn gắn nhãn rõ ràng
Một trong những bước quan trọng nhất trong quy trình gắn nhãn dữ liệu là tạo ra các hướng dẫn rõ ràng, được định nghĩa tốt. Các hướng dẫn này nên chỉ rõ chính xác cách dữ liệu cần được gắn nhãn và tiêu chí nào người gắn nhãn phải tuân theo để đảm bảo nhất quán.
Hướng dẫn rõ ràng giúp:
- Giảm mơ hồ
- Giảm lỗi
- Đảm bảo tất cả người gắn nhãn hiểu thống nhất
Việc có các quy tắc tiêu chuẩn hóa đặc biệt quan trọng với dữ liệu phức tạp hoặc mang tính chủ quan, như hình ảnh hay văn bản có nhiều cách diễn giải.
Đảm bảo chất lượng
Chất lượng là điều cần thiết để duy trì độ chính xác và độ tin cậy của dữ liệu đã gắn nhãn. Do đó, dữ liệu đã gắn nhãn phải được rà soát định kỳ để đảm bảo đáp ứng tiêu chuẩn yêu cầu. Quy trình này có thể được thực hiện thông qua kiểm tra ngẫu nhiên, dùng nhiều người gắn nhãn cho cùng một tác vụ (để so sánh kết quả), hoặc đối chiếu nhãn, tùy vào dự án.
Cốt lõi là cần triển khai một quy trình đảm bảo chất lượng vững chắc để giúp bạn phát hiện lỗi sớm, giảm thiên lệch trong dữ liệu và đảm bảo dữ liệu đã gắn nhãn phù hợp để huấn luyện các mô hình học máy hiệu năng cao.
Tận dụng học chủ động (Active learning)
Học chủ động là một kỹ thuật học máy cho phép thuật toán chọn các mẫu dữ liệu mang tính thông tin nhất để gắn nhãn, từ đó cải thiện hiệu suất mô hình. Kỹ thuật này có thể cải thiện đáng kể hiệu quả của quy trình gắn nhãn. Nó cho phép người gắn nhãn tập trung thời gian và công sức vào các điểm dữ liệu thách thức và giá trị nhất, trong khi thuật toán học máy gợi ý phần còn lại.
Cách tiếp cận này giúp giảm thời gian gắn nhãn các mẫu dễ hoặc lặp lại, và tăng tốc tổng thể quá trình gắn nhãn. Nhờ vậy, tăng khả năng mô hình học máy dùng để dự đoán được huấn luyện trên những ví dụ quan trọng nhất.
Đảm bảo đào tạo người gắn nhãn
Để đảm bảo quy trình gắn nhãn được thực hiện chính xác, người gắn nhãn cần được đào tạo bài bản. Đào tạo giúp họ hiểu các yêu cầu cụ thể của tác vụ và cách áp dụng đúng các hướng dẫn gắn nhãn.
Người gắn nhãn được đào tạo tốt có nhiều khả năng tạo ra dữ liệu được gắn nhãn chất lượng cao, từ đó cải thiện hiệu năng của các mô hình học máy mà họ đang hỗ trợ. Các buổi đào tạo định kỳ và vòng phản hồi cũng có thể giúp cải thiện kỹ năng người gắn nhãn theo thời gian, tiếp tục nâng cao quy trình gắn nhãn dữ liệu.
Thách thức trong gắn nhãn dữ liệu
Mặc dù gắn nhãn dữ liệu là thiết yếu để huấn luyện các mô hình học máy chính xác, quy trình này đi kèm một số thách thức riêng. Trong phần này, chúng ta sẽ thảo luận một số thách thức phổ biến nhất.
Hạn chế về chi phí và thời gian
Gắn nhãn dữ liệu thủ công thường tốn nhiều nhân lực. Cần một lượng đáng kể thời gian và nguồn lực tài chính để gắn nhãn tất cả các mẫu, đặc biệt khi tập dữ liệu lớn. Dữ liệu càng phức tạp (chẳng hạn video hoặc hình ảnh tinh vi), quy trình gắn nhãn càng tốn thời gian. Phải thuê người gắn nhãn có kỹ năng, làm tăng chi phí.
Để vượt qua thách thức này, các tổ chức có thể dùng công cụ gắn nhãn bán tự động, trong đó mô hình học máy đề xuất nhãn và con người xác minh. Điều này giúp tăng tốc quy trình mà không hi sinh độ chính xác.
Học chủ động cũng có thể giúp tập trung nỗ lực của con người vào dữ liệu mang tính thông tin nhất, giảm tổng lượng dữ liệu cần gắn nhãn thủ công. Bên cạnh đó, sử dụng các nền tảng nguồn lực cộng đồng như Amazon Mechanical Turk cho phép nhiều người đóng góp đồng thời, nhờ vậy gắn nhãn quy mô lớn có thể hợp lý về chi phí và hiệu quả hơn.
Tính chủ quan và thiên lệch
Một thách thức quan trọng khác là xử lý tính chủ quan và thiên lệch trong quá trình gắn nhãn. Những người gắn nhãn khác nhau có thể diễn giải cùng một dữ liệu theo các cách khác nhau. Điều này rất phổ biến với các tác vụ như gắn nhãn cảm xúc trong văn bản hoặc xác định đối tượng trong hình ảnh phức tạp. Vấn đề là tính chủ quan có thể đưa thiên lệch vào dữ liệu đã gắn nhãn, từ đó dẫn đến dự đoán thiên lệch của mô hình.
Để giảm chủ quan và thiên lệch, các tổ chức nên xây dựng hướng dẫn gắn nhãn rõ ràng, chi tiết để đảm bảo tất cả người gắn nhãn tuân theo cùng tiêu chí. Một giải pháp khác là dùng nhiều người gắn nhãn cho cùng dữ liệu, cho phép đối chiếu và giúp phát hiện, sửa các nhãn thiên lệch hoặc không nhất quán.
Quan ngại về quyền riêng tư dữ liệu
Các chú thích tiết lộ thông tin nhận dạng có thể vi phạm các quy định bảo vệ dữ liệu cá nhân. Thách thức này đặc biệt đáng kể khi thuê ngoài tác vụ gắn nhãn hoặc dùng nền tảng nguồn lực cộng đồng, nơi nhiều người đóng góp có quyền truy cập dữ liệu.
Các giải pháp như ẩn danh hóa (loại bỏ thông tin nhận dạng cá nhân) và sử dụng nền tảng gắn nhãn an toàn, được mã hóa có thể giúp giảm thiểu rủi ro này.
Ứng dụng thực tế của gắn nhãn dữ liệu
Trong phần này, chúng ta sẽ khám phá các ứng dụng thực tế của gắn nhãn dữ liệu. Cùng bắt đầu nhé!
Xe tự hành
Trong xe tự hành, gắn nhãn dữ liệu là nền tảng để dạy AI điều hướng an toàn trong thế giới thực. Xe tự lái dựa vào dữ liệu đã gắn nhãn để nhận diện đối tượng.
Ví dụ, người gắn nhãn sẽ gắn hộp giới hạn quanh các xe hơi hoặc đánh dấu ranh giới làn đường trên ảnh hoặc khung hình video. Những nhãn này giúp AI học cách nhận biết và phản ứng với các tình huống đường xá khác nhau, như dừng cho người đi bộ hoặc giữ đúng làn.
Y tế
Các mô hình AI cần hình ảnh y khoa đã gắn nhãn để học cách phát hiện bất thường. Ví dụ, người gắn nhãn có kỹ năng sẽ khoanh vùng các khu vực trên ảnh để đánh dấu vùng có dấu hiệu sớm của ung thư. Điều này cho phép AI phát hiện ung thư nhanh và chính xác hơn so với phương pháp truyền thống, cải thiện kết quả cho bệnh nhân và giảm khối lượng công việc cho nhân viên y tế.
Chatbot chăm sóc khách hàng
Với chatbot chăm sóc khách hàng, gắn nhãn văn bản rất quan trọng để dạy AI hiểu ngôn ngữ con người.
Ví dụ, người gắn nhãn có thể gắn nhãn văn bản để giúp chatbot nhận diện ý định của người dùng. Chatbot sau đó sẽ phân tích các tương tác đã gắn nhãn để học cách đưa ra phản hồi phù hợp. Điều này cho phép tổ chức cung cấp hỗ trợ nhanh hơn và chính xác hơn, cải thiện trải nghiệm khách hàng.
Phân tích cảm xúc
Trong phân tích cảm xúc, gắn nhãn văn bản được dùng để đo lường cảm nhận của khách hàng về một số điều (ví dụ: thương hiệu, sản phẩm hoặc sự kiện). Cách hoạt động là người gắn nhãn sẽ gắn thẻ cụm từ hoặc câu là tích cực, tiêu cực hoặc trung tính, rồi dữ liệu này được đưa cho AI để học cảm xúc tiềm ẩn. Một công ty sau đó có thể triển khai để theo dõi việc ra mắt sản phẩm mới được khách hàng đón nhận thế nào.
Kết luận
Gắn nhãn dữ liệu là quá trình gắn nhãn dữ liệu để mô hình học máy có thể nhận biết và sử dụng. Đây là bước quan trọng trong phát triển các hệ thống AI có thể diễn giải và phản hồi chính xác dữ liệu thế giới thực. Tại sao? Vì chất lượng và độ chính xác của dữ liệu đã gắn nhãn tác động trực tiếp đến hiệu năng và hiệu quả của các mô hình AI.
Suy cho cùng, gắn nhãn dữ liệu là nền tảng để xây dựng các hệ thống AI thông minh, đáng tin cậy, có thể thúc đẩy đổi mới trên nhiều ngành. Điều này khiến nó trở thành phần không thể thiếu của phát triển học máy.
Để tiếp tục hành trình học tập của bạn, hãy xem các tài nguyên sau:


Hãy tưởng tượng bạn đang phát triển một chiếc xe tự lái. Để chiếc xe có thể "nhìn" và hiểu con đường, nó phải học cách nhận diện các đối tượng như người đi bộ, biển báo giao thông và các phương tiện khác. Để làm được điều này, hệ thống học máy của xe cần hàng nghìn—nếu không muốn nói là hàng triệu—hình ảnh từ các tình huống lái xe trong thế giới thực.
Nhưng bản thân chiếc xe không thể tự hiểu có gì trong ảnh. Nó không biết một hình bát giác màu đỏ là biển dừng hay một người đang đi trên vỉa hè. Đây chính là lúc gắn nhãn dữ liệu xuất hiện.
Gắn nhãn dữ liệu là quy trình gắn nhãn dữ liệu thô để giúp các mô hình học máy hiểu và sử dụng được. Chúng tôi sẽ giải thích sâu hơn sau, nhưng hãy ghi nhớ điều này.
Dưới đây là những gì chúng ta sẽ khám phá trong bài viết này:
Cùng bắt đầu nhé!
Gắn nhãn dữ liệu là gì?
Cách tốt nhất để hình dung về gắn nhãn dữ liệu là nghĩ đến việc dạy trẻ em về các loài động vật khác nhau. Lúc đầu, bạn cho chúng xem một bức ảnh con chó và nói, “Đây là con chó.” Rồi bạn cho xem một con mèo và nói, “Đây là con mèo.” Theo thời gian, bằng cách cho xem các ví dụ có gắn nhãn, đứa trẻ sẽ tự nhận biết được các loài vật. Gắn nhãn dữ liệu hoạt động tương tự đối với máy móc.
Cũng như một đứa trẻ cần các ví dụ có gắn nhãn (lưu ý: nói “Đây là con chó” chính là gắn nhãn), các mô hình học máy cần dữ liệu được gắn nhãn để học từ đó. Vì thế, gắn nhãn dữ liệu là quá trình gắn nhãn hoặc gắn thẻ cho dữ liệu như hình ảnh, văn bản hoặc âm thanh, để các thuật toán học máy có thể nhận biết và hiểu được.
Các nhãn đóng vai trò là ví dụ dạy hệ thống biết cần tìm mẫu nào. Chẳng hạn, nếu bạn gắn nhãn hàng nghìn hình ảnh với nhãn "chó" hoặc "mèo", mô hình sẽ bắt đầu nhận ra sự khác biệt giữa hai loài.
Sau khi học từ các ví dụ này, mô hình có thể đưa ra dự đoán hoặc phân loại dữ liệu chưa gắn nhãn mới, giống như đứa trẻ cuối cùng tự nhận ra loài vật mà không cần bạn giúp.
Các loại gắn nhãn dữ liệu
Những loại dữ liệu khác nhau cần các phương pháp gắn nhãn cụ thể để chuẩn bị cho các tác vụ học máy. Tùy theo bản chất dữ liệu, có những cách tiếp cận riêng để gắn nhãn và gắn thẻ. Hiểu các loại này giúp xác định cách hiệu quả nhất để huấn luyện mô hình cho nhiều ứng dụng khác nhau.
Hãy cùng khám phá các loại gắn nhãn dữ liệu phổ biến nhất:
Gắn nhãn hình ảnh
Gắn nhãn hình ảnh là gắn nhãn cho ảnh để các mô hình học máy có thể nhận diện và diễn giải các đối tượng trong đó. Có nhiều kỹ thuật khác nhau trong gắn nhãn hình ảnh, tùy mức độ chi tiết yêu cầu:
Hộp giới hạn (Bounding boxes)
Hộp giới hạn. Nguồn: Anolytics
Phương pháp này vẽ các hình chữ nhật quanh đối tượng trong ảnh để giúp mô hình nhận diện sự hiện diện và vị trí của chúng. Hộp giới hạn thường dùng để phát hiện ô tô, người đi bộ hoặc biển báo trong công nghệ xe tự lái.
Phân đoạn ngữ nghĩa (Semantic segmentation)
Phân đoạn ngữ nghĩa. Nguồn: Introduction to Semantic Image Segmentation
Ở đây, mỗi điểm ảnh trong một bức ảnh được gắn nhãn để gán các vùng cụ thể cho những đối tượng hoặc danh mục nhất định, như xác định đường, tòa nhà hoặc cây cối. Kỹ thuật này mang lại cho mô hình hiểu biết chi tiết hơn về khung cảnh.
Gắn mốc (Landmark annotation)
Gắn mốc. Nguồn: Anolytics
Kỹ thuật này đánh dấu các điểm cụ thể trong ảnh, chẳng hạn các đặc điểm khuôn mặt hoặc điểm chính trong tư thế cơ thể. Nó được dùng trong các ứng dụng như nhận diện khuôn mặt và ước lượng tư thế người.
Gắn nhãn văn bản
Gắn nhãn văn bản là quá trình gắn nhãn và gắn thẻ dữ liệu văn bản để trở nên dễ hiểu cho các mô hình xử lý ngôn ngữ tự nhiên (NLP). Nó giúp máy móc hiểu, xử lý và phân tích ngôn ngữ con người.
Có một số kỹ thuật phổ biến trong gắn nhãn văn bản:
Nhận diện thực thể (Entity recognition)
Nhận diện thực thể. Nguồn: Named Entity Recognition and Classification with Scikit-Learn
Bao gồm việc xác định các thực thể cụ thể trong văn bản, như tên người, địa điểm hoặc tổ chức. Ví dụ, trong câu "Apple mở một cửa hàng mới ở New York," mô hình sẽ nhận ra "Apple" là công ty và "New York" là địa điểm.
Gắn thẻ cảm xúc (Sentiment tagging)
Gắn thẻ cảm xúc. Nguồn: Understanding the text annotation process for Customer Sentiment Analysis
Kỹ thuật này gán cảm xúc hoặc quan điểm cho các đoạn văn bản, gắn nhãn chúng là tích cực, tiêu cực hoặc trung tính. Thường được sử dụng trong đánh giá khách hàng hoặc giám sát mạng xã hội để hiểu người dùng cảm nhận thế nào về sản phẩm hoặc dịch vụ.
Gắn thẻ từ loại (Part-of-speech tagging)
Gắn thẻ từ loại. Nguồn: POS tagging in NLP
Phương pháp này gắn nhãn cho từng từ trong câu theo vai trò ngữ pháp (ví dụ: danh từ, động từ, tính từ), giúp mô hình hiểu cấu trúc ngôn ngữ cho các tác vụ như dịch hoặc nhận dạng giọng nói.
Gắn nhãn âm thanh
Gắn nhãn âm thanh là gắn nhãn các tệp âm thanh để huấn luyện mô hình cho nhận dạng giọng nói, nhận diện nhạc hoặc phân loại âm thanh.
Một số kỹ thuật gắn nhãn âm thanh phổ biến gồm:
Phiên âm (Transcription)
Chuyển lời nói trong một tệp âm thanh thành văn bản viết thường được sử dụng trong các ứng dụng chuyển giọng nói thành văn bản.
Phân đoạn lời nói (Speech segmentation)
Phân đoạn lời nói. Nguồn: ResearchGate
Chia một tệp âm thanh thành các phần khác nhau. Ví dụ, bạn có thể muốn tách đối thoại khỏi tiếng ồn nền hoặc xác định từng người nói trong một cuộc trò chuyện.
Gắn thẻ âm thanh (Sound tagging)
Gắn thẻ âm thanh. Nguồn: Freesound Tagging by VGGish with KNN
Gắn thẻ âm thanh là khi các âm thanh cụ thể (ví dụ: tiếng xe cộ, tiếng động vật, v.v.) được gắn nhãn trong một tệp âm thanh.
Gắn nhãn video
Gắn nhãn video là gắn nhãn và gắn thẻ các đối tượng hoặc hành động trong các khung hình video để giúp mô hình học máy diễn giải chuyển động và hoạt động.
Các kỹ thuật gắn nhãn video then chốt gồm:
Theo dõi đối tượng (Object tracking)
Theo dõi đối tượng. Nguồn: Label Studio
Theo dõi đối tượng là liên tục gắn nhãn đối tượng qua nhiều khung hình để theo dõi chuyển động của chúng. Ví dụ, trong bối cảnh lái xe tự hành, bạn có thể dùng theo dõi đối tượng để bám theo một chiếc xe đi qua ngã tư đông đúc.
Gắn nhãn hoạt động (Activity labeling)
Gắn nhãn hoạt động. Nguồn: Encord
Là khi gán nhãn cho các hành động cụ thể, như ai đó đang đi bộ, chạy hay ngồi xuống trong video. Điều này giúp mô hình hiểu hành vi con người trong các ứng dụng như giám sát an ninh hoặc phân tích thể thao.
Gắn nhãn từng khung hình (Frame-by-frame annotation)
Gắn nhãn từng khung hình. Nguồn: dataloop
Khi từng khung hình của video được gắn nhãn để nắm bắt các chi tiết rất nhỏ, đó là phát hiện theo từng khung. Thường dùng cho các tác vụ đòi hỏi độ chính xác cao, như phân tích chuyển động cơ thể trong vật lý trị liệu.
Kỹ thuật gắn nhãn dữ liệu
Phương pháp dùng để gắn nhãn dữ liệu có thể khác nhau tùy thuộc vào một số yếu tố, chẳng hạn:
Nói cách khác, một số tác vụ cần độ chính xác của người gắn nhãn, trong khi các tác vụ khác có thể hưởng lợi từ tự động hóa để tiết kiệm thời gian và mở rộng quy mô. Bên dưới, chúng tôi sẽ khám phá các cách tiếp cận khác nhau để bạn hiểu rõ hơn nên dùng cách nào trong tình huống nào.
Gắn nhãn thủ công
Gắn nhãn thủ công là khi con người tự tay gắn nhãn dữ liệu. Trong cách tiếp cận này, các nhân sự được đào tạo sẽ xem xét cẩn thận từng mẫu dữ liệu và áp dụng nhãn hoặc thẻ cần thiết.
Ưu điểm lớn nhất của gắn nhãn thủ công là độ chính xác. Vì con người hiểu ngữ cảnh, sắc thái và các mẫu phức tạp tốt hơn máy móc, họ có thể đảm bảo dữ liệu được gắn nhãn chính xác. Mức độ chính xác này đặc biệt quan trọng cho các dự án yêu cầu gắn nhãn chi tiết, chất lượng cao, như gắn nhãn ảnh y khoa hoặc các tác vụ ngôn ngữ tự nhiên phức tạp.
Tuy nhiên, gắn nhãn thủ công cũng có những thách thức đáng kể:
Bất chấp các thách thức này, gắn nhãn thủ công vẫn là thiết yếu cho những dự án mà độ chính xác là tối quan trọng, dù các doanh nghiệp thường tìm cách cân bằng chất lượng với hiệu quả thời gian và chi phí.
Gắn nhãn bán tự động
Gắn nhãn bán tự động kết hợp chuyên môn của con người với sự hỗ trợ của học máy. Trong cách này, một mô hình học máy hỗ trợ người gắn nhãn bằng cách gắn nhãn trước dữ liệu hoặc đưa ra gợi ý. Người gắn nhãn sau đó sẽ xem xét và tinh chỉnh nhãn để đảm bảo độ chính xác.
Lợi ích của gắn nhãn bán tự động là tăng tốc quy trình trong khi vẫn giữ mức độ chính xác cao. Máy có thể xử lý các tác vụ lặp đi lặp lại hoặc đơn giản, cho phép người gắn nhãn tập trung vào các điểm dữ liệu phức tạp hoặc mơ hồ hơn. Cách tiếp cận này lý tưởng cho các dự án lớn mà nếu gắn nhãn hoàn toàn thủ công sẽ quá chậm hoặc tốn kém, vì nó cân bằng giữa hiệu quả thời gian và kiểm soát chất lượng.
Tuy nhiên, nó cũng đối mặt với một số thách thức:
Gắn nhãn bán tự động phù hợp nhất với các dự án cần cân bằng chất lượng với tốc độ, nơi dữ liệu đủ phức tạp để hưởng lợi từ việc con người xem xét, nhưng cũng đủ lớn để cần sự hỗ trợ của máy.
Gắn nhãn tự động
Gắn nhãn tự động sử dụng các thuật toán học máy để gắn nhãn dữ liệu mà không cần con người tham gia. Trong cách này, các mô hình được huấn luyện sẵn hoặc công cụ do AI điều khiển sẽ tự động gắn nhãn cho các tập dữ liệu lớn. Điều này làm cho quy trình nhanh hơn và dễ mở rộng hơn so với phương pháp thủ công hoặc bán tự động.
Ưu điểm chính của gắn nhãn tự động là hiệu suất. Nó có thể xử lý lượng dữ liệu khổng lồ trong một phần thời gian so với người gắn nhãn. Do đó, gắn nhãn tự động là giải pháp lý tưởng cho các dự án có tập dữ liệu khổng lồ, như gắn thẻ hàng triệu hình ảnh cho mô hình thị giác máy tính hoặc phiên âm lượng lớn âm thanh cho nhận dạng giọng nói.
Nhưng những hạn chế khi phụ thuộc vào máy như sau:
Gắn nhãn tự động phù hợp nhất với các dự án yêu cầu tốc độ và khả năng mở rộng, nơi có thể chấp nhận một mức sai số nhất định hoặc có thể dùng con người rà soát sau để tinh chỉnh kết quả.
Nguồn lực cộng đồng (Crowdsourcing)
Nguồn lực cộng đồng là phân phối các tác vụ gắn nhãn dữ liệu cho số lượng lớn cộng tác viên thông qua các nền tảng như Amazon Mechanical Turk hoặc Appen. Cách này giúp doanh nghiệp nhanh chóng và tiết kiệm chi phí khi gắn nhãn các tập dữ liệu lớn bằng cách tận dụng lực lượng lao động toàn cầu.
Một trong những lợi thế chính của nguồn lực cộng đồng là khả năng mở rộng. Việc phân phối tác vụ cho nhiều cộng tác viên cho phép các công ty xử lý hiệu quả khối lượng dữ liệu lớn. Chẳng hạn, một dự án yêu cầu hàng nghìn hình ảnh gắn nhãn hoặc phiên âm có thể hoàn thành trong vài ngày thay vì vài tuần hay vài tháng.
Những điểm bất lợi của cách này như sau:
Nguồn lực cộng đồng lý tưởng cho các dự án quy mô lớn cần gắn nhãn nhanh và tiết kiệm chi phí. Tuy nhiên, để duy trì chất lượng cao cần có giám sát và quản trị tác vụ chặt chẽ.
Công cụ gắn nhãn dữ liệu
Có rất nhiều công cụ dành cho gắn nhãn dữ liệu. Chúng trải dài từ nền tảng mã nguồn mở đến các giải pháp thương mại toàn diện, mỗi loại được thiết kế để đáp ứng nhu cầu dự án khác nhau.
Ví dụ, các công cụ mã nguồn mở thường có thể tùy chỉnh và miễn phí sử dụng. Điều này khiến chúng phù hợp cho các dự án nhỏ hơn hoặc đội ngũ có chuyên môn kỹ thuật. Mặt khác, các lựa chọn thương mại cung cấp nhiều tính năng nâng cao, bao gồm tự động hóa, công cụ cộng tác và kiểm soát chất lượng, phù hợp hơn với các dự án quy mô lớn hoặc doanh nghiệp muốn có quy trình làm việc tinh gọn.
Trong phần này, chúng ta sẽ xem xét một số công cụ phổ biến nhất dành cho gắn nhãn dữ liệu và cách chúng hỗ trợ các loại dữ liệu khác nhau:
Labelbox
Nguồn: Labelbox Docs
Labelbox là một nền tảng thương mại được sử dụng rộng rãi, thiết kế để tinh gọn quy trình gắn nhãn dữ liệu, tập trung vào cộng tác và kiểm soát chất lượng. Nó được thành lập năm 2018 bởi Manu Sharma, Brian Rieger và Peter Welinder, với sứ mệnh “xây dựng những sản phẩm tốt nhất để phù hợp với trí tuệ nhân tạo.”
Nền tảng Labelbox cung cấp giao diện trực quan nơi các nhóm có thể cộng tác để gắn nhãn dữ liệu, theo dõi tiến độ và duy trì tiêu chuẩn gắn nhãn cao. Nó cũng hỗ trợ nhiều loại dữ liệu (ví dụ: hình ảnh, video và văn bản), khiến nền tảng trở nên cực kỳ linh hoạt cho các dự án học máy khác nhau.
Một trong những tính năng chính là cơ chế kiểm soát chất lượng tích hợp, cho phép các nhóm rà soát và phê duyệt nhãn—đảm bảo kết quả nhất quán và chính xác.
Labelbox phù hợp cho các tổ chức muốn mở rộng nỗ lực gắn nhãn với khả năng quản lý dự án và tự động hóa tích hợp.
CVAT (Computer Vision Annotation Tool)
Nguồn: Trang Wikipedia CVAT
CVAT là một công cụ mã nguồn mở được thiết kế đặc thù để gắn nhãn tập dữ liệu hình ảnh và video. Phát triển bởi Intel, CVAT có khả năng tùy biến cao và cung cấp nhiều kỹ thuật gắn nhãn (ví dụ: hộp giới hạn, đa giác, và gắn điểm chính). Tính linh hoạt của nó phù hợp cho các dự án từ phát hiện đối tượng đến nhận diện khuôn mặt.
Vì là mã nguồn mở, CVAT miễn phí sử dụng và có thể điều chỉnh để đáp ứng nhu cầu dự án cụ thể. Điều này khiến nó trở thành lựa chọn phổ biến cho các nhà nghiên cứu và đội ngũ nhỏ cần công cụ gắn nhãn mạnh mà không tốn chi phí phần mềm thương mại.
Prodigy
Nguồn: Prodigy Docs
Prodigy là một công cụ gắn nhãn nâng cao do Explosion AI phát triển, sử dụng học chủ động để tăng hiệu suất, đặc biệt trong các tác vụ xử lý ngôn ngữ tự nhiên (NLP). Với Prodigy, mô hình học máy hỗ trợ người gắn nhãn bằng cách đề xuất nhãn dựa trên dự đoán của nó, sau đó được người rà soát xác nhận hoặc chỉnh sửa.
Cách tiếp cận tương tác này tăng tốc quá trình gắn nhãn đồng thời đảm bảo dữ liệu được gắn nhãn có chất lượng cao. Dù là công cụ thương mại, Prodigy vẫn có khả năng tùy biến cao; ví dụ, cho phép người dùng tạo quy trình gắn nhãn riêng. Những yếu tố này khiến Prodigy rất phù hợp cho các đội ngũ làm dự án NLP chuyên biệt như phân tích cảm xúc, nhận diện thực thể, hoặc phân loại văn bản.
Amazon SageMaker Ground Truth
Nguồn: Amazon SageMaker Ground Truth
Amazon SageMaker Ground Truth là một dịch vụ gắn nhãn dữ liệu được quản lý hoàn toàn, tích hợp liền mạch với AWS. Nó cung cấp các công cụ gắn nhãn dữ liệu thủ công và tự động, cho phép người dùng gắn nhãn nhanh và chính xác.
SageMaker Ground Truth sử dụng học máy để hỗ trợ người gắn nhãn bằng cách gắn nhãn trước dữ liệu, giúp tăng tốc quy trình và giảm chi phí. Dịch vụ này cũng cực kỳ linh hoạt cho các tác vụ học máy khác nhau vì hỗ trợ đa dạng loại dữ liệu, bao gồm hình ảnh, văn bản và video.
Ngoài ra, nó được xây dựng để mở rộng quy mô, nghĩa là là lựa chọn mạnh mẽ cho doanh nghiệp cần khả năng gắn nhãn quy mô lớn trong hệ sinh thái AWS.
Các công cụ khác nên cân nhắc
Thực tiễn tốt nhất cho gắn nhãn dữ liệu
Gắn nhãn dữ liệu hiệu quả là yếu tố then chốt cho thành công của các mô hình học máy, vì chất lượng dữ liệu được gắn nhãn tác động trực tiếp đến độ chính xác của dự đoán và phân loại. Tuân thủ các thực tiễn tốt nhất có thể giúp đảm bảo quy trình gắn nhãn vừa hiệu quả vừa đáng tin cậy.
Trong phần này, chúng ta sẽ khám phá các thực tiễn thiết yếu có thể nâng cao chất lượng và tính nhất quán của gắn nhãn dữ liệu, đồng thời giải quyết những thách thức có thể gặp trong quá trình gắn nhãn.
Xây dựng hướng dẫn gắn nhãn rõ ràng
Một trong những bước quan trọng nhất trong quy trình gắn nhãn dữ liệu là tạo ra các hướng dẫn rõ ràng, được định nghĩa tốt. Các hướng dẫn này nên chỉ rõ chính xác cách dữ liệu cần được gắn nhãn và tiêu chí nào người gắn nhãn phải tuân theo để đảm bảo nhất quán.
Hướng dẫn rõ ràng giúp:
Việc có các quy tắc tiêu chuẩn hóa đặc biệt quan trọng với dữ liệu phức tạp hoặc mang tính chủ quan, như hình ảnh hay văn bản có nhiều cách diễn giải.
Đảm bảo chất lượng
Chất lượng là điều cần thiết để duy trì độ chính xác và độ tin cậy của dữ liệu đã gắn nhãn. Do đó, dữ liệu đã gắn nhãn phải được rà soát định kỳ để đảm bảo đáp ứng tiêu chuẩn yêu cầu. Quy trình này có thể được thực hiện thông qua kiểm tra ngẫu nhiên, dùng nhiều người gắn nhãn cho cùng một tác vụ (để so sánh kết quả), hoặc đối chiếu nhãn, tùy vào dự án.
Cốt lõi là cần triển khai một quy trình đảm bảo chất lượng vững chắc để giúp bạn phát hiện lỗi sớm, giảm thiên lệch trong dữ liệu và đảm bảo dữ liệu đã gắn nhãn phù hợp để huấn luyện các mô hình học máy hiệu năng cao.
Tận dụng học chủ động (Active learning)
Học chủ động là một kỹ thuật học máy cho phép thuật toán chọn các mẫu dữ liệu mang tính thông tin nhất để gắn nhãn, từ đó cải thiện hiệu suất mô hình. Kỹ thuật này có thể cải thiện đáng kể hiệu quả của quy trình gắn nhãn. Nó cho phép người gắn nhãn tập trung thời gian và công sức vào các điểm dữ liệu thách thức và giá trị nhất, trong khi thuật toán học máy gợi ý phần còn lại.
Cách tiếp cận này giúp giảm thời gian gắn nhãn các mẫu dễ hoặc lặp lại, và tăng tốc tổng thể quá trình gắn nhãn. Nhờ vậy, tăng khả năng mô hình học máy dùng để dự đoán được huấn luyện trên những ví dụ quan trọng nhất.
Đảm bảo đào tạo người gắn nhãn
Để đảm bảo quy trình gắn nhãn được thực hiện chính xác, người gắn nhãn cần được đào tạo bài bản. Đào tạo giúp họ hiểu các yêu cầu cụ thể của tác vụ và cách áp dụng đúng các hướng dẫn gắn nhãn.
Người gắn nhãn được đào tạo tốt có nhiều khả năng tạo ra dữ liệu được gắn nhãn chất lượng cao, từ đó cải thiện hiệu năng của các mô hình học máy mà họ đang hỗ trợ. Các buổi đào tạo định kỳ và vòng phản hồi cũng có thể giúp cải thiện kỹ năng người gắn nhãn theo thời gian, tiếp tục nâng cao quy trình gắn nhãn dữ liệu.
Thách thức trong gắn nhãn dữ liệu
Mặc dù gắn nhãn dữ liệu là thiết yếu để huấn luyện các mô hình học máy chính xác, quy trình này đi kèm một số thách thức riêng. Trong phần này, chúng ta sẽ thảo luận một số thách thức phổ biến nhất.
Hạn chế về chi phí và thời gian
Gắn nhãn dữ liệu thủ công thường tốn nhiều nhân lực. Cần một lượng đáng kể thời gian và nguồn lực tài chính để gắn nhãn tất cả các mẫu, đặc biệt khi tập dữ liệu lớn. Dữ liệu càng phức tạp (chẳng hạn video hoặc hình ảnh tinh vi), quy trình gắn nhãn càng tốn thời gian. Phải thuê người gắn nhãn có kỹ năng, làm tăng chi phí.
Để vượt qua thách thức này, các tổ chức có thể dùng công cụ gắn nhãn bán tự động, trong đó mô hình học máy đề xuất nhãn và con người xác minh. Điều này giúp tăng tốc quy trình mà không hi sinh độ chính xác.
Học chủ động cũng có thể giúp tập trung nỗ lực của con người vào dữ liệu mang tính thông tin nhất, giảm tổng lượng dữ liệu cần gắn nhãn thủ công. Bên cạnh đó, sử dụng các nền tảng nguồn lực cộng đồng như Amazon Mechanical Turk cho phép nhiều người đóng góp đồng thời, nhờ vậy gắn nhãn quy mô lớn có thể hợp lý về chi phí và hiệu quả hơn.
Tính chủ quan và thiên lệch
Một thách thức quan trọng khác là xử lý tính chủ quan và thiên lệch trong quá trình gắn nhãn. Những người gắn nhãn khác nhau có thể diễn giải cùng một dữ liệu theo các cách khác nhau. Điều này rất phổ biến với các tác vụ như gắn nhãn cảm xúc trong văn bản hoặc xác định đối tượng trong hình ảnh phức tạp. Vấn đề là tính chủ quan có thể đưa thiên lệch vào dữ liệu đã gắn nhãn, từ đó dẫn đến dự đoán thiên lệch của mô hình.
Để giảm chủ quan và thiên lệch, các tổ chức nên xây dựng hướng dẫn gắn nhãn rõ ràng, chi tiết để đảm bảo tất cả người gắn nhãn tuân theo cùng tiêu chí. Một giải pháp khác là dùng nhiều người gắn nhãn cho cùng dữ liệu, cho phép đối chiếu và giúp phát hiện, sửa các nhãn thiên lệch hoặc không nhất quán.
Quan ngại về quyền riêng tư dữ liệu
Các chú thích tiết lộ thông tin nhận dạng có thể vi phạm các quy định bảo vệ dữ liệu cá nhân. Thách thức này đặc biệt đáng kể khi thuê ngoài tác vụ gắn nhãn hoặc dùng nền tảng nguồn lực cộng đồng, nơi nhiều người đóng góp có quyền truy cập dữ liệu.
Các giải pháp như ẩn danh hóa (loại bỏ thông tin nhận dạng cá nhân) và sử dụng nền tảng gắn nhãn an toàn, được mã hóa có thể giúp giảm thiểu rủi ro này.
Ứng dụng thực tế của gắn nhãn dữ liệu
Trong phần này, chúng ta sẽ khám phá các ứng dụng thực tế của gắn nhãn dữ liệu. Cùng bắt đầu nhé!
Xe tự hành
Trong xe tự hành, gắn nhãn dữ liệu là nền tảng để dạy AI điều hướng an toàn trong thế giới thực. Xe tự lái dựa vào dữ liệu đã gắn nhãn để nhận diện đối tượng.
Ví dụ, người gắn nhãn sẽ gắn hộp giới hạn quanh các xe hơi hoặc đánh dấu ranh giới làn đường trên ảnh hoặc khung hình video. Những nhãn này giúp AI học cách nhận biết và phản ứng với các tình huống đường xá khác nhau, như dừng cho người đi bộ hoặc giữ đúng làn.
Y tế
Các mô hình AI cần hình ảnh y khoa đã gắn nhãn để học cách phát hiện bất thường. Ví dụ, người gắn nhãn có kỹ năng sẽ khoanh vùng các khu vực trên ảnh để đánh dấu vùng có dấu hiệu sớm của ung thư. Điều này cho phép AI phát hiện ung thư nhanh và chính xác hơn so với phương pháp truyền thống, cải thiện kết quả cho bệnh nhân và giảm khối lượng công việc cho nhân viên y tế.
Chatbot chăm sóc khách hàng
Với chatbot chăm sóc khách hàng, gắn nhãn văn bản rất quan trọng để dạy AI hiểu ngôn ngữ con người.
Ví dụ, người gắn nhãn có thể gắn nhãn văn bản để giúp chatbot nhận diện ý định của người dùng. Chatbot sau đó sẽ phân tích các tương tác đã gắn nhãn để học cách đưa ra phản hồi phù hợp. Điều này cho phép tổ chức cung cấp hỗ trợ nhanh hơn và chính xác hơn, cải thiện trải nghiệm khách hàng.
Phân tích cảm xúc
Trong phân tích cảm xúc, gắn nhãn văn bản được dùng để đo lường cảm nhận của khách hàng về một số điều (ví dụ: thương hiệu, sản phẩm hoặc sự kiện). Cách hoạt động là người gắn nhãn sẽ gắn thẻ cụm từ hoặc câu là tích cực, tiêu cực hoặc trung tính, rồi dữ liệu này được đưa cho AI để học cảm xúc tiềm ẩn. Một công ty sau đó có thể triển khai để theo dõi việc ra mắt sản phẩm mới được khách hàng đón nhận thế nào.
Kết luận
Gắn nhãn dữ liệu là quá trình gắn nhãn dữ liệu để mô hình học máy có thể nhận biết và sử dụng. Đây là bước quan trọng trong phát triển các hệ thống AI có thể diễn giải và phản hồi chính xác dữ liệu thế giới thực. Tại sao? Vì chất lượng và độ chính xác của dữ liệu đã gắn nhãn tác động trực tiếp đến hiệu năng và hiệu quả của các mô hình AI.
Suy cho cùng, gắn nhãn dữ liệu là nền tảng để xây dựng các hệ thống AI thông minh, đáng tin cậy, có thể thúc đẩy đổi mới trên nhiều ngành. Điều này khiến nó trở thành phần không thể thiếu của phát triển học máy.
Để tiếp tục hành trình học tập của bạn, hãy xem các tài nguyên sau: