
Cursus
Inzicht in Machine Learning
2 uur
311.3K
Stel je voor dat je een zelfrijdende auto ontwikkelt. Om de auto te laten "zien" en de weg te begrijpen, moet hij leren objecten te herkennen, zoals voetgangers, verkeersborden en andere voertuigen. Daarvoor heeft het ML-’s machine learning-systeem duizenden—zo niet miljoenen—beelden nodig uit rijsituaties in de echte wereld.
Maar de auto begrijpt niet van nature wat er op de beelden staat. Hij weet niet dat een rode achthoek een stopbord is of dat er iemand op de stoep loopt. Dit is waar data-annotatie om de hoek komt kijken.
Data-annotatie is het proces waarbij ruwe data wordt gelabeld, zodat deze begrijpelijk en bruikbaar wordt voor machinelearningmodellen. We leggen het later uitgebreider uit, maar onthoud dit alvast.
Dit is wat we in dit artikel gaan verkennen:
Laten we beginnen!
De beste manier om data-annotatie te begrijpen, is door te denken aan hoe je kinderen verschillende dieren leert kennen. Eerst laat je een plaatje van een hond zien en zeg je: “Dit is een hond.” Daarna laat je een kat zien en zeg je: “Dit is een kat.” Na verloop van tijd leert het kind door gelabelde voorbeelden te laten zien, zelfstandig dieren herkennen. Voor machines werkt data-annotatie vergelijkbaar.
Net zoals een kind gelabelde voorbeelden nodig heeft (let op: zeggen “Dit is een hond” ís het labelen), hebben machinelearningmodellen geannoteerde data nodig om ervan te leren. Data-annotatie is dus het proces van het labelen of taggen van data, zoals afbeeldingen, tekst of audio, zodat machinelearningalgoritmen deze kunnen herkennen en begrijpen.
De labels dienen als voorbeelden die het systeem leren naar welke patronen het moet zoeken. Als je bijvoorbeeld duizenden afbeeldingen annoteert met labels als "hond" of "kat", zal het model de verschillen tussen beide leren herkennen.
Zodra het van deze voorbeelden heeft geleerd, kan het model voorspellingen doen of nieuwe ongeannoteerde data classificeren, net zoals het kind uiteindelijk dieren zonder jouw hulp herkent.
Verschillende soorten data vereisen specifieke annotatiemethoden om ze voor te bereiden op machinelearningtaken. Afhankelijk van de aard van de data zijn er unieke benaderingen voor labelen en taggen. Inzicht in deze typen helpt om de meest effectieve manier te bepalen om modellen te trainen voor uiteenlopende toepassingen.
Laten we de meest voorkomende vormen van data-annotatie verkennen:
Beeldannotatie houdt in dat afbeeldingen worden gelabeld zodat machinelearningmodellen objecten erin kunnen identificeren en interpreteren. Afhankelijk van het vereiste detailniveau worden verschillende technieken gebruikt:
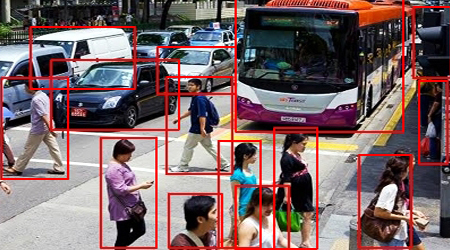
Bounding boxes. Bron: Anolytics
Deze methode houdt in dat rechthoeken om objecten in een afbeelding worden getekend, zodat het model hun aanwezigheid en locatie kan herkennen. Grenskaders worden veel gebruikt om auto’s, voetgangers of borden te detecteren bij zelfrijdende technologie.
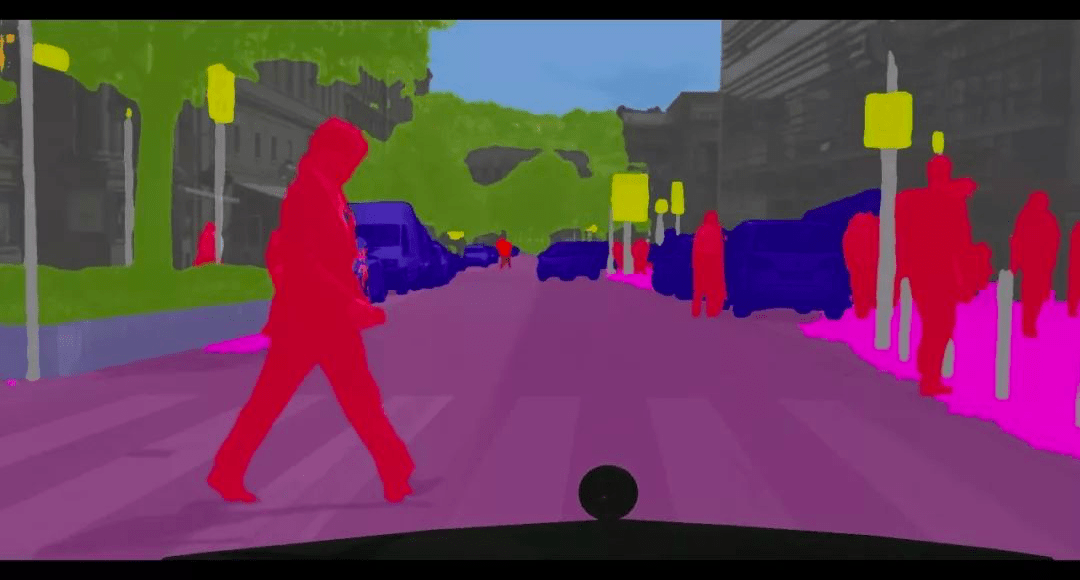
Semantische segmentatie. Bron: Introduction to Semantic Image Segmentation
Hierbij wordt elke pixel in een afbeelding gelabeld om specifieke regio’s toe te wijzen aan bepaalde objecten of categorieën, zoals wegen, gebouwen of bomen. Deze techniek geeft het model een meer gedetailleerd begrip van de scène.
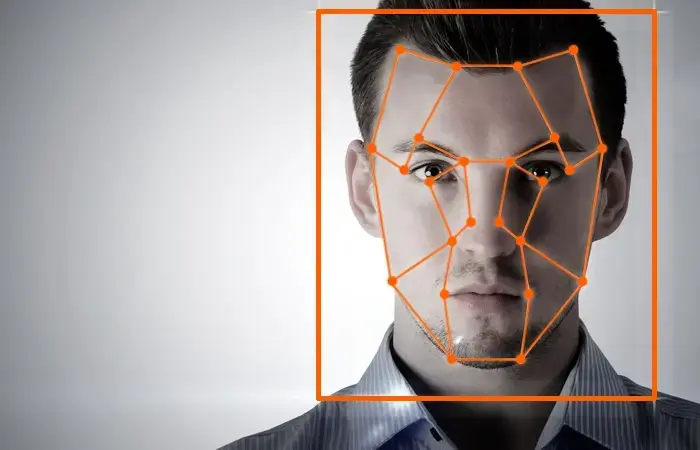
Landmark-annotatie. Bron: Anolytics
Deze techniek houdt in dat specifieke punten in een afbeelding worden gemarkeerd, zoals gelaatskenmerken of sleutelpunten in lichaamshouding. Het wordt gebruikt in toepassingen zoals gezichtsherkenning en het schatten van lichaamshoudingen.
Tekstannotatie is het proces waarbij tekstdata wordt gelabeld en getagd om deze begrijpelijk te maken voor natural language processing (NLP)-modellen. Het stelt machines in staat menselijke taal te begrijpen, verwerken en analyseren.
Er zijn verschillende gangbare technieken voor tekstannotatie:
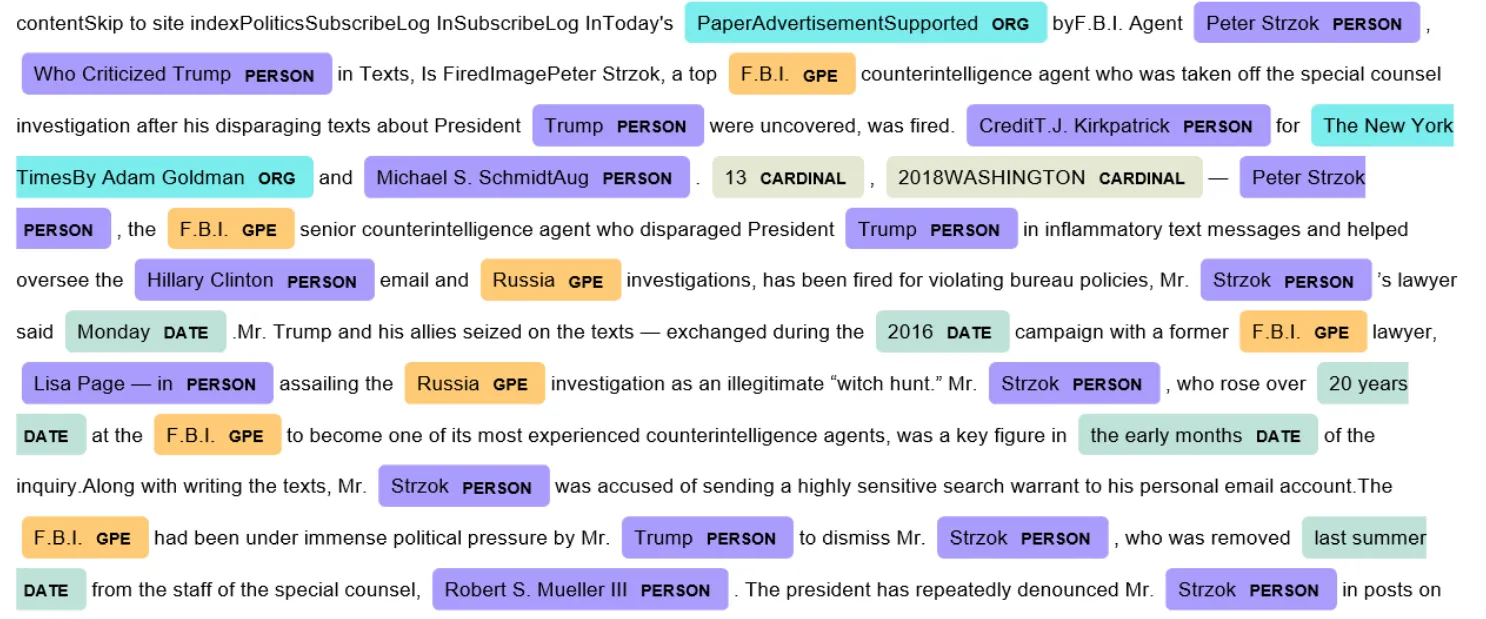
Entity recognition. Bron: Named Entity Recognition and Classification with Scikit-Learn
Dit houdt in dat specifieke entiteiten in tekst worden geïdentificeerd, zoals namen van personen, plaatsen of organisaties. In de zin "Apple opende een nieuwe winkel in New York" zou het model bijvoorbeeld "Apple" herkennen als bedrijf en "New York" als locatie.
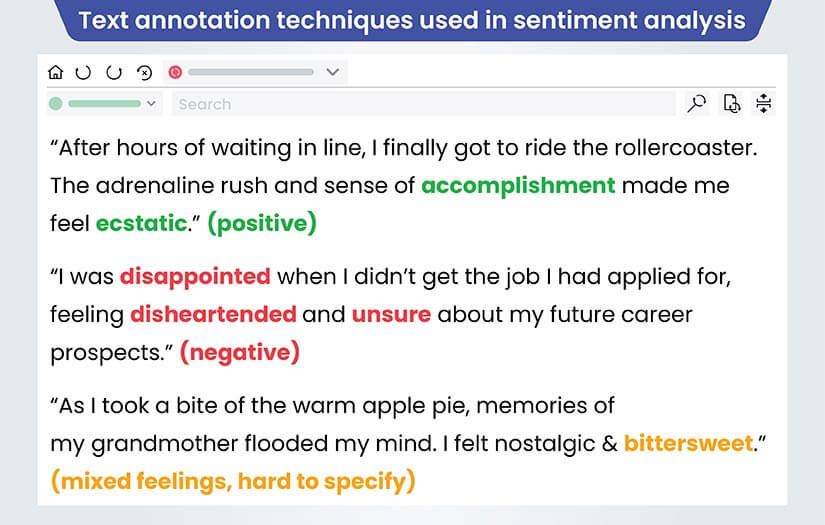
Sentimenttagging. Bron: Understanding the text annotation process for Customer Sentiment Analysis
Deze techniek kent emoties of meningen toe aan stukjes tekst, met labels als positief, negatief of neutraal. Het wordt vaak gebruikt bij klantreviews of socialmediamonitoring om te begrijpen hoe gebruikers over een product of dienst denken.
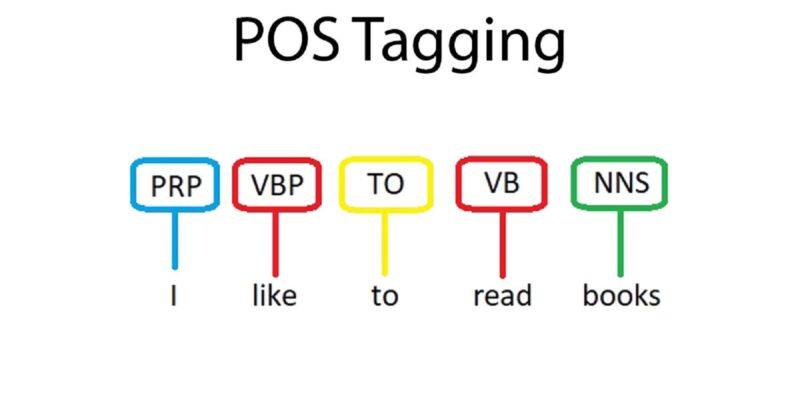
POS-tagging. Bron: POS tagging in NLP
Deze methode labelt elk woord in een zin met zijn grammaticale rol (bijv. zelfstandig naamwoord, werkwoord, bijvoeglijk naamwoord), wat modellen helpt de taalstructuur te begrijpen voor taken zoals vertaling of spraakherkenning.
Audio-annotatie houdt in dat geluidsbestanden worden gelabeld om modellen te trainen voor spraakherkenning, muziekdtectie of geluidsclassificatie.
Enkele veelvoorkomende audio-annotatietechnieken zijn:
Het omzetten van gesproken woorden in een audiobestand naar geschreven tekst wordt vaak gebruikt in spraak-naar-teksttoepassingen.
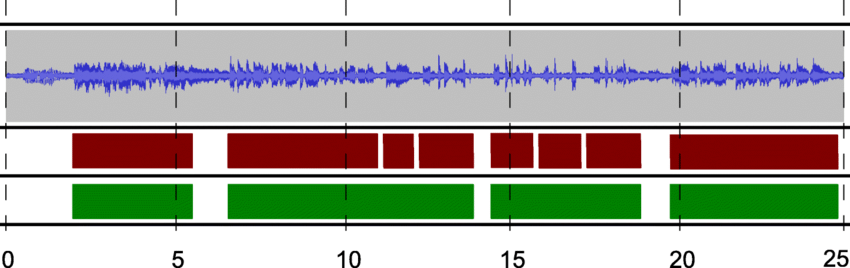
Spraaksegmentatie. Bron: ResearchGate
Dit houdt in dat een audiobestand in verschillende secties wordt opgedeeld. Je kunt bijvoorbeeld dialoog scheiden van achtergrondgeluid of individuele sprekers in een gesprek identificeren.
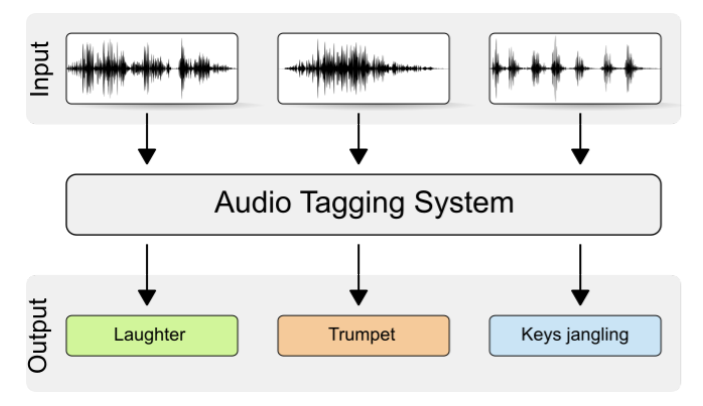
Geluidslabeling. Bron: Freesound Tagging by VGGish with KNN
Geluidslabeling is wanneer specifieke geluiden (bijv. verkeerslawaai, dierengeluiden, enz.) binnen een audiobestand worden gelabeld.
Video-annotatie houdt in dat objecten of acties in videoframes worden gelabeld en getagd, zodat machinelearningmodellen beweging en activiteiten kunnen interpreteren.
Belangrijke video-annotatietechnieken zijn onder meer:
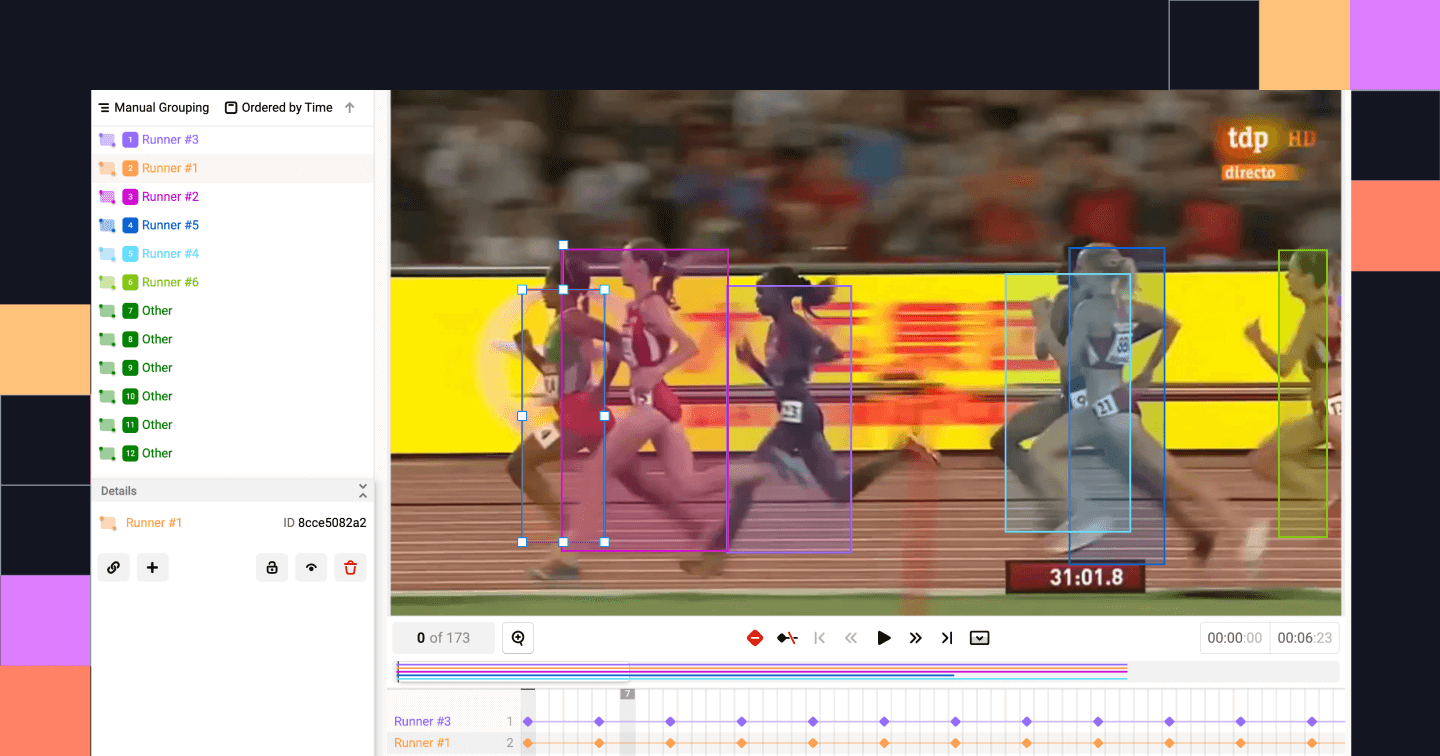
Objecttracking. Bron: Label Studio
Objecttracking houdt in dat objecten continu over meerdere frames worden gelabeld om hun beweging te volgen. In scenario’s met autonoom rijden kun je bijvoorbeeld objecttracking gebruiken om een voertuig door een druk kruispunt te volgen.
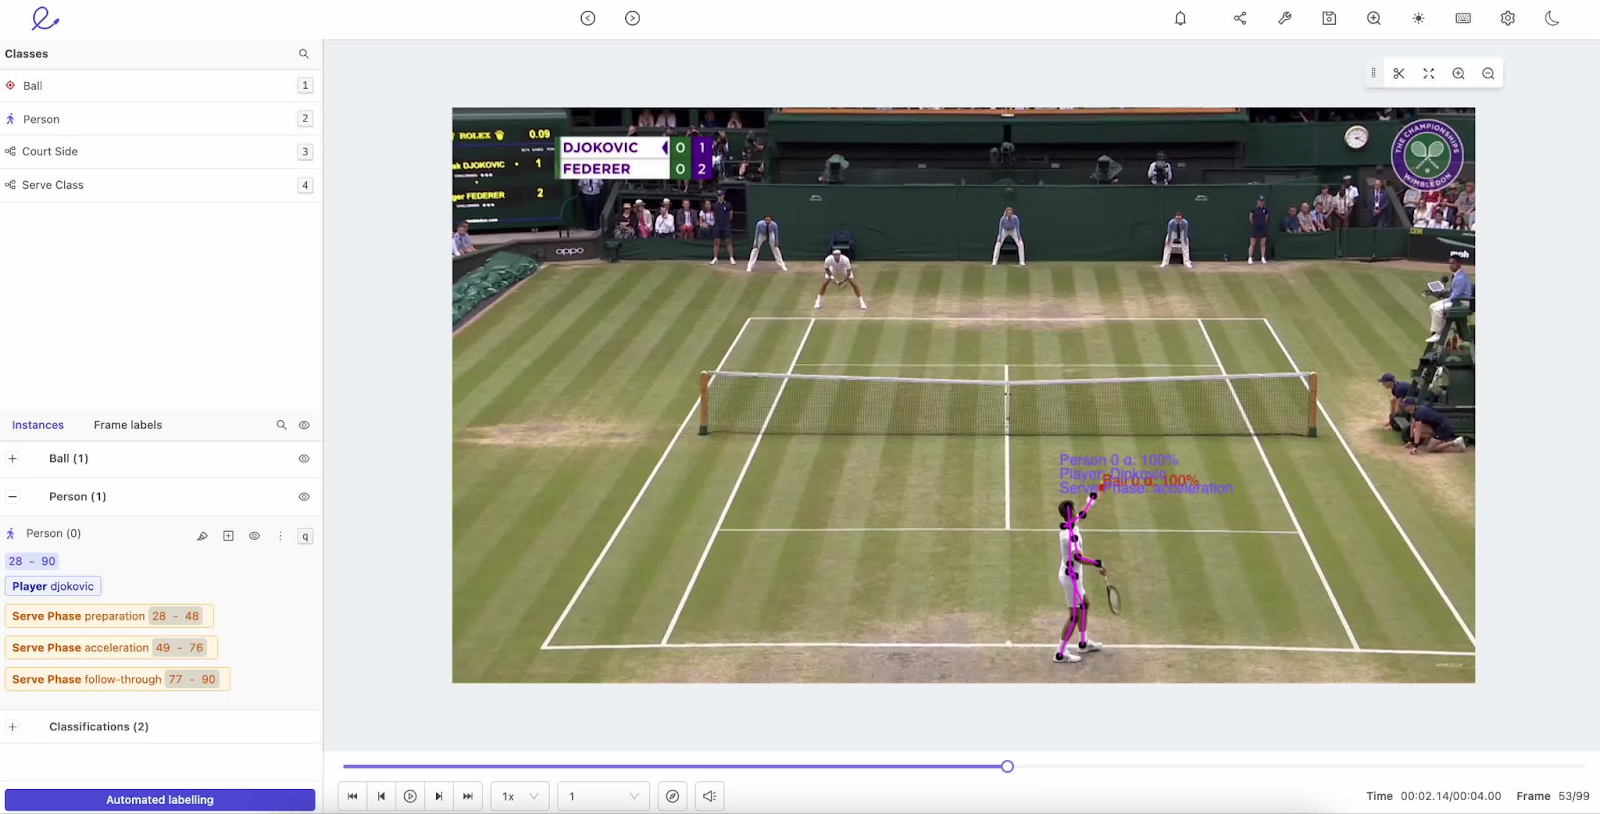
Activiteitslabeling. Bron: Encord
Dit is wanneer labels worden toegekend aan specifieke acties, zoals iemand die loopt, rent of gaat zitten in een video. Dit helpt modellen menselijk gedrag te begrijpen in toepassingen zoals beveiligingsmonitoring of sportanalyse.
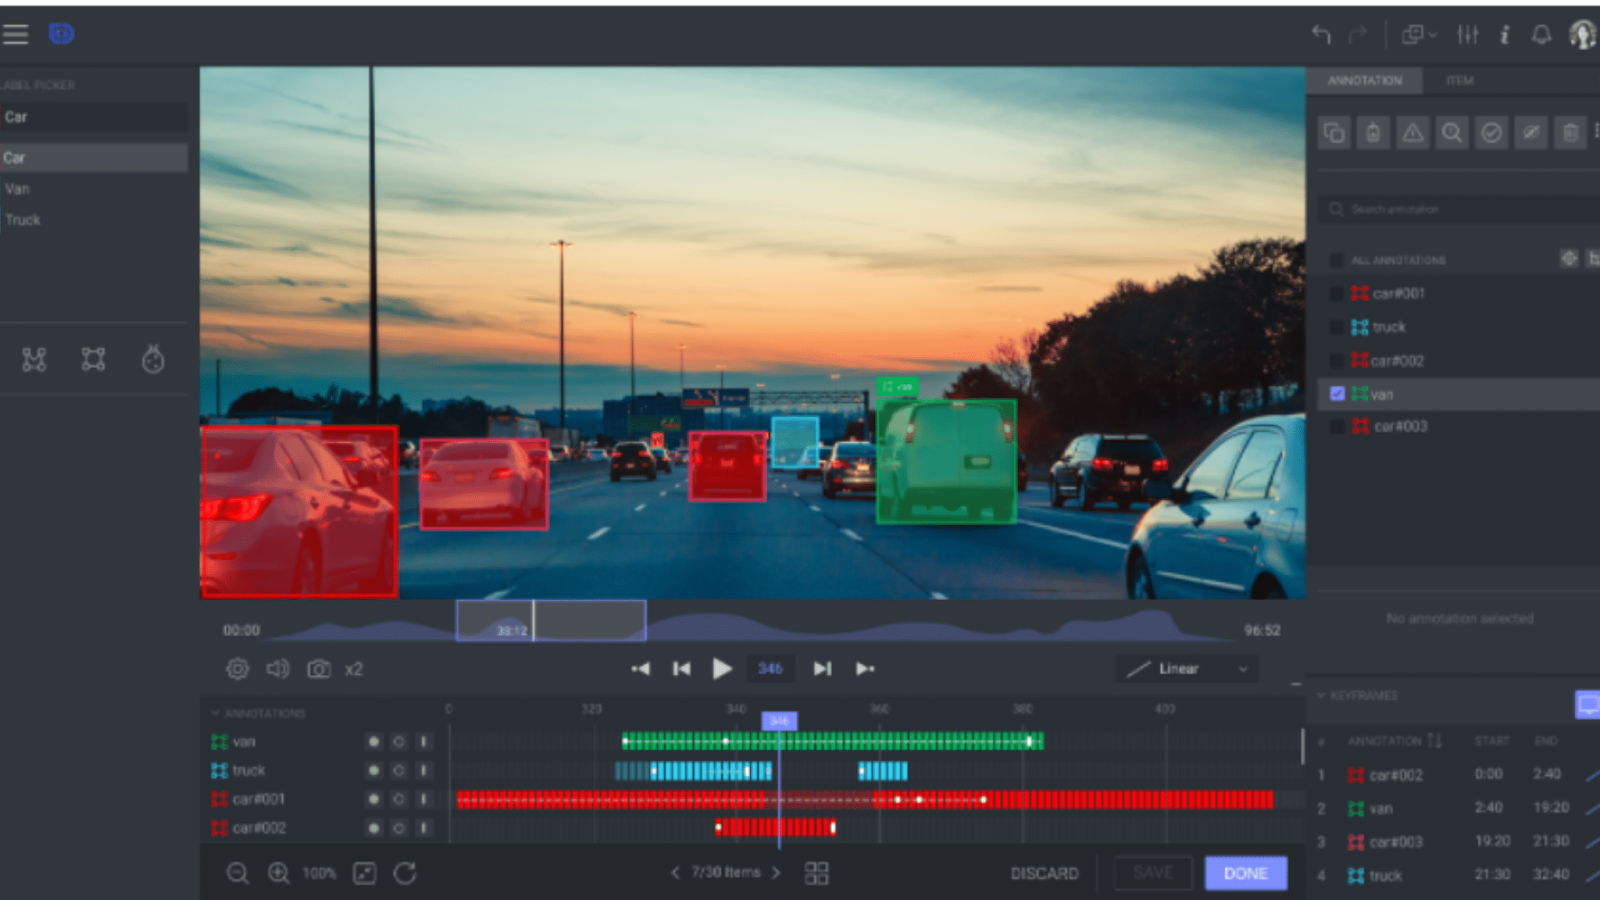
Frame-voor-frame-annotatie. Bron: dataloop
Wanneer elk afzonderlijk frame van een video wordt gelabeld om zeer kleine details vast te leggen, heet dat detectie frame-voor-frame. Dit wordt vaak gebruikt voor taken die hoge nauwkeurigheid vereisen, zoals het analyseren van lichaamsbewegingen in fysiotherapie.
De methode die wordt gebruikt om data te annoteren kan variëren afhankelijk van verschillende factoren, zoals:
Met andere woorden: sommige taken vereisen de nauwkeurigheid van menselijke annotators, terwijl andere kunnen profiteren van automatisering om tijd te besparen en het proces op te schalen. Hieronder verkennen we de verschillende benaderingen, zodat je beter begrijpt in welke situatie je welke methode gebruikt.
Handmatige annotatie is wanneer menselijke annotators data met de hand labelen. In deze aanpak beoordelen getrainde annotators elk datapunt zorgvuldig en passen ze de benodigde labels of tags toe.
Het grootste voordeel van handmatige annotatie is nauwkeurigheid. Omdat mensen context, nuance en complexe patronen beter kunnen begrijpen dan machines, kunnen ze zorgen voor precieze labels. Dit nauwkeurigheidsniveau is vooral belangrijk voor projecten die hoogwaardige, gedetailleerde annotaties vereisen, zoals medische beeldlabeling of complexe natuurlijke-taaltaken.
Toch brengt handmatige annotatie ook aanzienlijke uitdagingen met zich mee:
Ondanks deze uitdagingen blijft handmatige annotatie essentieel voor projecten waar precisie cruciaal is, al zoeken organisaties vaak naar manieren om kwaliteit te balanceren met tijd- en kostenefficiëntie.
Semi-geautomatiseerde annotatie combineert menselijke expertise met hulp van machine learning. Bij deze aanpak helpt een machinelearningmodel menselijke annotators door de data voor te labelen of suggesties te doen. De menselijke annotators beoordelen en verfijnen vervolgens de labels om de nauwkeurigheid te waarborgen.
Het voordeel van semi-geautomatiseerde annotatie is dat het proces versnelt, terwijl een hoog nauwkeurigheidsniveau behouden blijft. De machine kan repetitieve of eenvoudige taken afhandelen, waardoor menselijke annotators zich kunnen richten op complexere of ambiguere datapunten. Deze aanpak is ideaal voor grote projecten waarbij volledig handmatig annoteren te traag of te duur zou zijn, omdat het een balans biedt tussen tijdefficiëntie en kwaliteitscontrole.
Toch zijn er uitdagingen:
Semi-geautomatiseerde annotatie werkt het best voor projecten die kwaliteit en snelheid moeten balanceren, waar de data complex genoeg is om te profiteren van menselijke review maar groot genoeg om machinehulp nodig te hebben.
Geautomatiseerde annotatie gebruikt machinelearningalgoritmen om data te labelen zonder menselijke betrokkenheid. In deze aanpak annoteren voorgetrainde modellen of AI-tools automatisch grote datasets. Dit maakt het proces sneller en beter schaalbaar dan handmatige of semi-geautomatiseerde methoden.
Het grootste voordeel van geautomatiseerde annotatie is efficiëntie. Het kan enorme hoeveelheden data verwerken in een fractie van de tijd die een menselijke annotator nodig heeft. Daardoor is geautomatiseerde annotatie ideaal voor projecten met enorme datasets, zoals het taggen van miljoenen afbeeldingen voor een computervisiemodel of het transcriberen van grote hoeveelheden audio voor spraakherkenning.
Maar er zijn ook nadelen aan het vertrouwen op machines:
Geautomatiseerde annotatie is het meest geschikt voor projecten die snelheid en schaalbaarheid vereisen, maar waar een bepaalde foutmarge acceptabel is of waar later menselijke review kan worden gebruikt om de resultaten te verfijnen.
Crowdsourcing houdt in dat data-labelingtaken worden verdeeld over een groot aantal bijdragers via platforms als Amazon Mechanical Turk of Appen. Deze methode stelt bedrijven in staat om snel en kosteneffectief grote datasets te annoteren door gebruik te maken van een wereldwijd netwerk van werkers.
Een van de belangrijkste voordelen van crowdsourcing is schaalbaarheid. Door taken te verdelen over veel bijdragers kunnen bedrijven grote hoeveelheden data efficiënt verwerken. Een project met duizenden gelabelde afbeeldingen of transcripties kan bijvoorbeeld in dagen in plaats van weken of maanden worden afgerond.
De nadelen van deze aanpak zijn als volgt:
Crowdsourcing is ideaal voor grootschalige projecten die snelle en betaalbare annotatie vereisen. Het behouden van hoge kwaliteit vraagt echter om sterk toezicht en taakbeheer.
Er is een breed scala aan tools beschikbaar voor data-annotatie. Deze tools variëren van open source-platforms tot uitgebreide commerciële oplossingen, elk ontworpen voor verschillende projectbehoeften.
Openbrontools zijn bijvoorbeeld vaak aanpasbaar en gratis te gebruiken. Dit maakt ze ideaal voor kleinere projecten of teams met technische expertise. Commerciële opties bieden daarentegen geavanceerdere functies, waaronder automatisering, samenwerkingsmogelijkheden en kwaliteitscontrole, waardoor ze beter geschikt zijn voor grootschalige projecten of ondernemingen die een gestroomlijnde workflow zoeken.
In dit onderdeel bekijken we enkele van de populairste tools voor data-annotatie en hoe ze helpen bij verschillende datatypen:
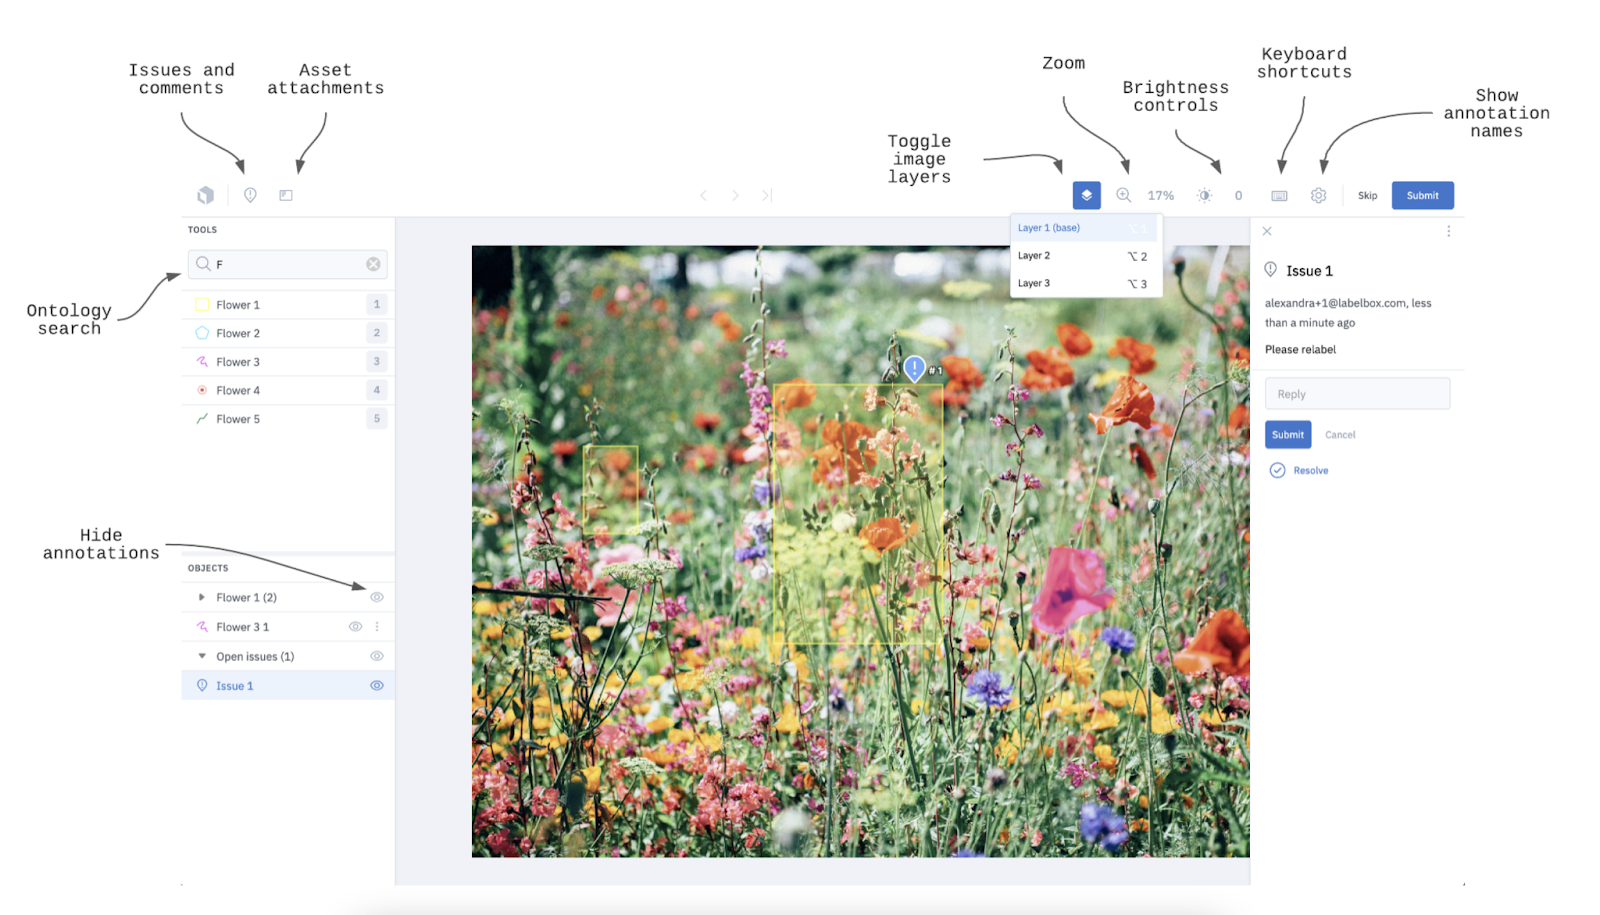
Bron: Labelbox Docs
Labelbox is een veelgebruikte commerciële platform dat het data-annotatieproces stroomlijnt, met focus op samenwerking en kwaliteitscontrole. Het is in 2018 opgericht door Manu Sharma, Brian Rieger en Peter Welinder, met als missie “de beste producten te bouwen die aansluiten op kunstmatige intelligentie.”
Het Labelbox-platform biedt een intuïtieve interface waar teams kunnen samenwerken om data te annoteren, voortgang te volgen en hoge annotatiestandaarden te handhaven. Het ondersteunt ook diverse datatypen (bijv. afbeeldingen, video en tekst), waardoor het platform zeer veelzijdig is voor verschillende machinelearningprojecten.
Een van de belangrijkste functies is de ingebouwde kwaliteitscontrole, waarmee teams annotaties kunnen reviewen en goedkeuren—dit zorgt voor consistente en nauwkeurige resultaten.
Labelbox is ideaal voor organisaties die hun annotatie-inspanningen willen opschalen met geïntegreerd projectmanagement en automatiseringsfuncties.
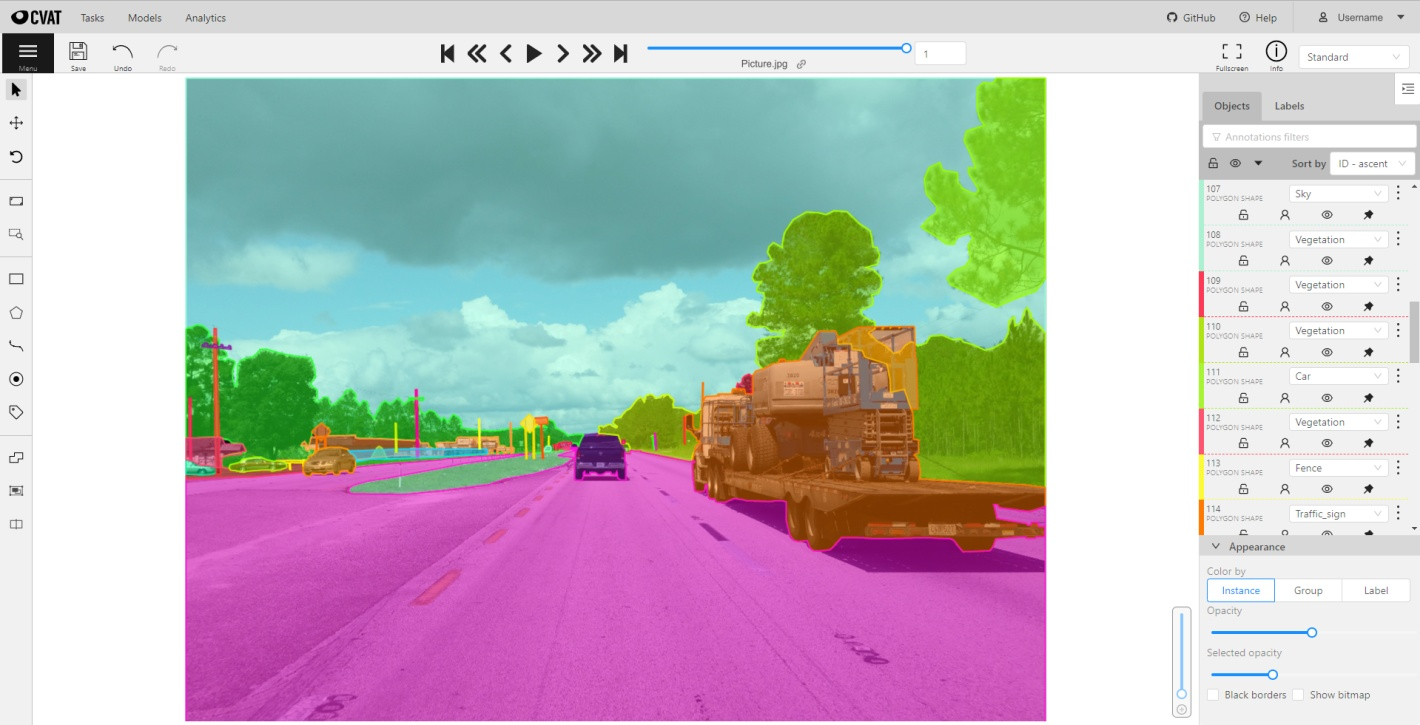
Bron: CVAT Wikipedia page
CVAT is een openbrontool die specifiek is ontworpen voor het annoteren van beeld- en videodatasets. Ontwikkeld door Intel, is CVAT sterk aanpasbaar en biedt het een breed scala aan annotatietechnieken (bijv. bounding boxes, polygonen en keypoint-annotaties). Door de flexibiliteit is het geschikt voor projecten variërend van objectdetectie tot gezichtsherkenning.
Omdat het open source is, is CVAT gratis te gebruiken en kan het worden afgestemd op specifieke projectbehoeften. Dit maakt het een populaire keuze voor onderzoekers en kleinere teams die krachtige annotatietools nodig hebben zonder de kosten van commerciële software.
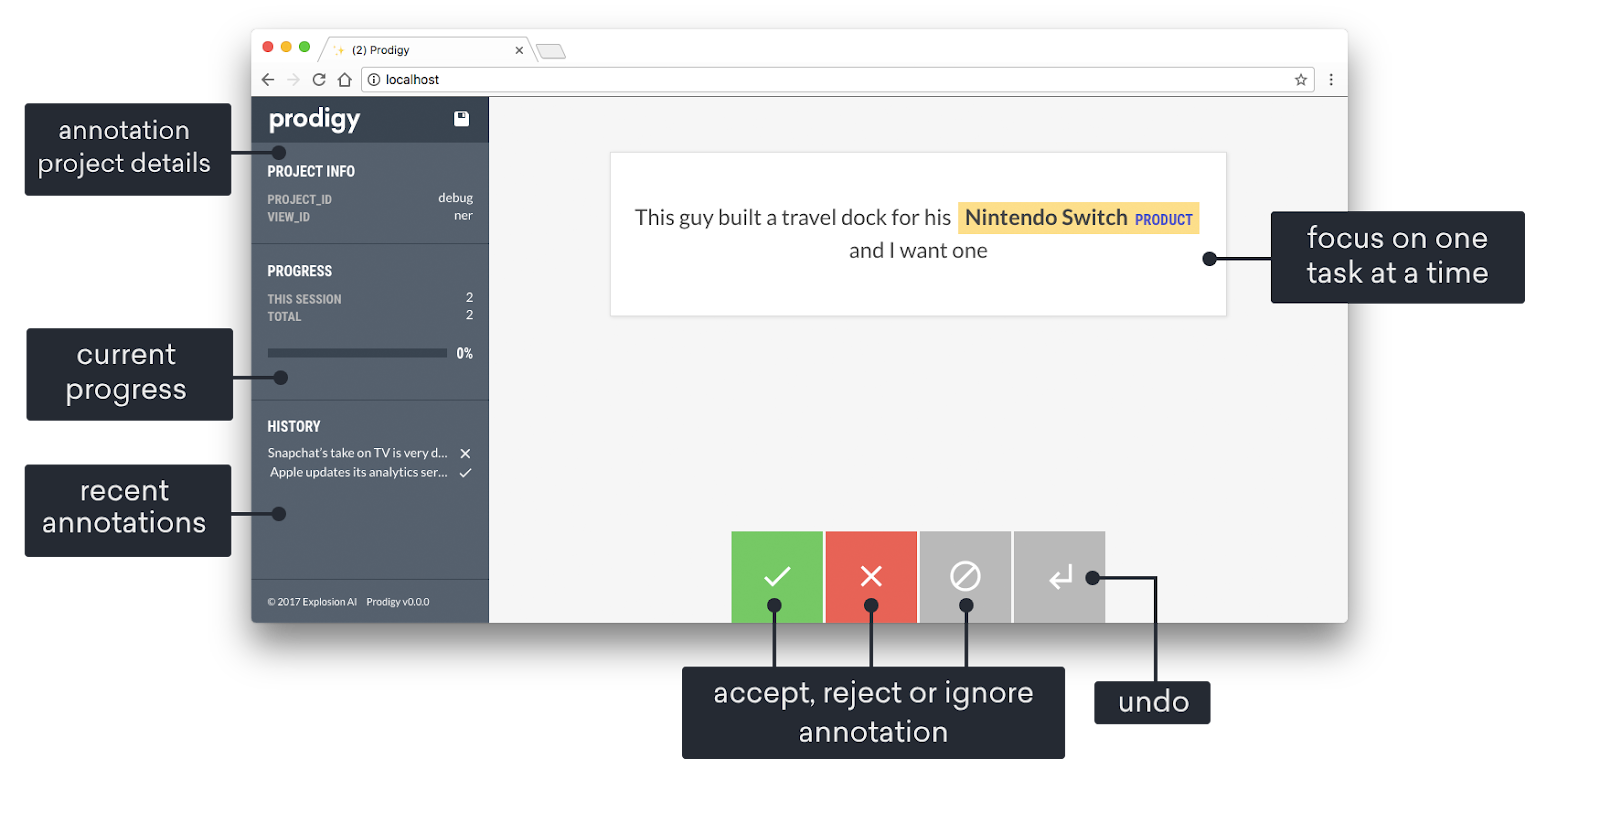
Bron: Prodigy Docs
Prodigy is een geavanceerde annotatietool ontwikkeld door Explosion AI die active learning gebruikt om de efficiëntie te vergroten, met name bij natural language processing (NLP)-taken. Met Prodigy helpt een machinelearningmodel annotators door labels te suggereren op basis van voorspellingen, die vervolgens worden bevestigd of gecorrigeerd door menselijke reviewers.
Deze interactieve aanpak versnelt het annotatieproces en zorgt tegelijk voor hoogwaardige gelabelde data. Ondanks dat het een commerciële tool is, is Prodigy sterk aanpasbaar; zo kun je eigen annotatieworkflows creëren. Deze factoren maken Prodigy zeer geschikt voor teams die werken aan gespecialiseerde NLP-projecten zoals sentimentanalyse, entiteitsherkenning of tekstclassificatie.
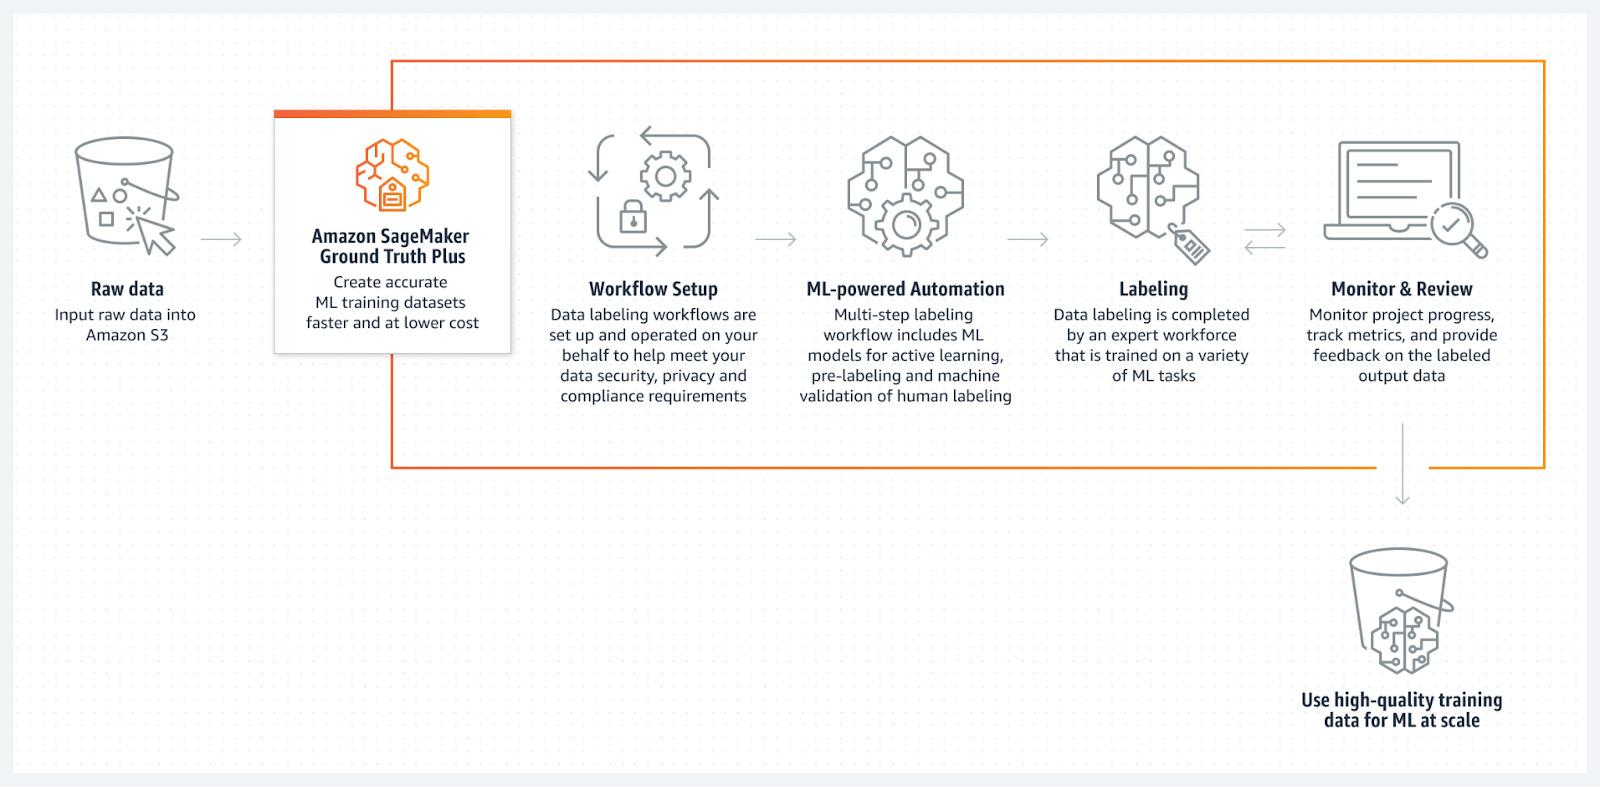
Bron: Amazon SageMaker Ground Truth
Amazon SageMaker Ground Truth is een volledig beheerde datalabelservice die naadloos integreert met AWS. Het biedt tools voor handmatige en geautomatiseerde data-annotatie waarmee gebruikers snel en nauwkeurig kunnen labelen.
SageMaker Ground Truth gebruikt machine learning om menselijke annotators te assisteren door data vooraf te labelen, wat het proces versnelt en de kosten verlaagt. De service is bovendien zeer veelzijdig voor verschillende machinelearningtaken, omdat het een breed scala aan datatypen ondersteunt, waaronder afbeeldingen, tekst en video’s.
Daarnaast is het ontworpen om op te schalen, wat het een sterke optie maakt voor ondernemingen die grootschalige annotatie binnen het AWS-ecosysteem nodig hebben.
Effectieve data-annotatie is cruciaal voor het succes van machinelearningmodellen, omdat de kwaliteit van gelabelde data direct van invloed is op de nauwkeurigheid van voorspellingen en classificaties. Het volgen van best practices helpt om het annotatieproces zowel efficiënt als betrouwbaar te maken.
In dit onderdeel bespreken we essentiële praktijken die de kwaliteit en consistentie van data-annotatie verbeteren en tegelijkertijd uitdagingen in het labelproces aanpakken.
Een van de belangrijkste stappen in het data-annotatieproces is het opstellen van duidelijke, goed gedefinieerde richtlijnen. Deze richtlijnen moeten precies specificeren hoe data gelabeld moet worden en welke criteria annotators moeten volgen voor consistentie.
Heldere richtlijnen helpen om:
Gestandaardiseerde regels zijn vooral cruciaal voor complexe of subjectieve data, zoals beelden of teksten met meerdere mogelijke interpretaties.
Kwaliteit is noodzakelijk om de nauwkeurigheid en betrouwbaarheid van geannoteerde data te behouden. Daarom moet geannoteerde data periodiek worden beoordeeld om te garanderen dat deze aan de vereiste standaarden voldoet. Dit kan via willekeurige audits, meerdere annotators voor dezelfde taken (om resultaten te vergelijken) of kruiscontroles, afhankelijk van het project.
De kern is dat het vitaal is om een robuust kwaliteitsborgingsproces te implementeren, zodat je fouten vroegtijdig opspoort, bias in je data vermindert en zorgt dat de gelabelde data geschikt is voor het trainen van goed presterende machinelearningmodellen.
Active learning is een machinelearningtechniek waarmee een algoritme de meest informatieve datasamples kan selecteren om te labelen, wat de modelprestatie verbetert. Deze techniek kan de efficiëntie van het annotatieproces aanzienlijk verhogen. Annotators kunnen hun tijd en energie richten op de meest uitdagende en waardevolle datapunten, terwijl het machinelearningalgoritme de rest suggereert.
Deze aanpak vermindert de tijd die wordt besteed aan het labelen van eenvoudige of repetitieve voorbeelden en versnelt het totale annotatieproces. Zo vergroot je de kans dat het gebruikte machinelearningmodel wordt getraind op de meest cruciale voorbeelden.
Om te zorgen dat het annotatieproces nauwkeurig wordt uitgevoerd, moeten annotators goede training krijgen. Training helpt hen de specifieke vereisten van de taak te begrijpen en de annotatierichtlijnen correct toe te passen.
Goed getrainde annotators leveren eerder hoogwaardige gelabelde data op, wat uiteindelijk de prestaties van de machinelearningmodellen verbetert die zij ondersteunen. Regelmatige trainingssessies en feedbackloops helpen bovendien de vaardigheden van annotators in de loop van de tijd te verfijnen, wat het data-annotatieproces verder versterkt.
Hoewel data-annotatie essentieel is voor het trainen van nauwkeurige machinelearningmodellen, kent het proces ook de nodige uitdagingen. In dit onderdeel bespreken we enkele van de meest voorkomende problemen bij data-annotatie.
Handmatige data-annotatie is vaak arbeidsintensief. Het annoteren van alle instanties kost veel tijd en financiële middelen, zeker bij grote datasets. Hoe complexer de data (zoals video of gedetailleerde afbeeldingen), hoe tijdrovender het annotatieproces wordt. Er moeten vaardige annotators worden ingehuurd, wat de kosten verhoogt.
Om deze uitdaging te overwinnen, kunnen organisaties semi-geautomatiseerde annotatietools gebruiken, waarbij machinelearningmodellen labels voorstellen en mensen ze verifiëren. Dit versnelt het proces zonder aan nauwkeurigheid in te boeten.
Active learning kan ook helpen door menselijke inzet te richten op de meest informatieve data, wat de totale hoeveelheid handmatig te labelen data vermindert. Daarnaast maken crowdsourcingplatforms zoals Amazon Mechanical Turk het mogelijk dat meerdere bijdragers tegelijk werken, waardoor grootschalige annotatie betaalbaarder en efficiënter wordt.
Een andere belangrijke uitdaging is omgaan met subjectiviteit en bias in het annotatieproces. Verschillende annotators kunnen dezelfde data op uiteenlopende manieren interpreteren. Dit komt vaak voor bij taken als het labelen van emoties in tekst of het identificeren van objecten in complexe beelden. Het probleem is dat subjectiviteit bias kan introduceren in de gelabelde data, wat vervolgens kan leiden tot bevooroordeelde modelvoorspellingen.
Om subjectiviteit en bias te verminderen, moeten organisaties duidelijke, gedetailleerde annotatierichtlijnen opstellen die ervoor zorgen dat alle annotators dezelfde criteria volgen. Een andere oplossing is meerdere annotators op dezelfde data in te zetten, zodat kruiscontrole mogelijk is en bevooroordeelde of inconsistente annotaties kunnen worden opgespoord en gecorrigeerd.
Annotaties die identificerende informatie onthullen, kunnen in strijd zijn met privacyregels die persoonsgegevens beschermen. Deze uitdaging is vooral groot bij het uitbesteden van annotatietaken of het gebruik van crowdsourcingplatforms, waar veel bijdragers toegang hebben tot de data.
Oplossingen zoals anonimisering (het verwijderen van persoonlijk identificeerbare informatie) en het gebruik van veilige, versleutelde platforms voor annotatie kunnen deze risico’s helpen beperken.
In dit onderdeel bekijken we toepassingen van data-annotatie in de echte wereld. Laten we erin duiken!
Bij autonome voertuigen vormt data-annotatie de basis om AI veilig door de echte wereld te laten navigeren. Zelfrijdende auto’s vertrouwen op geannoteerde data om objecten te identificeren.
Zo labelen annotators afbeeldingen of videoframes door bounding boxes rond auto’s te tekenen of weggrenzen te markeren voor rijstrookdetectie. Deze annotaties helpen de AI te leren hoe te reageren op verschillende verkeerssituaties, zoals stoppen voor voetgangers of in de juiste rijstrook blijven.
AI-modellen hebben gelabelde medische beelden nodig om afwijkingen te leren detecteren. Zo zouden vaardige annotators specifieke gebieden in beelden markeren om regio’s aan te geven die vroege tekenen van kanker vertonen. Dit stelt AI in staat kanker sneller en nauwkeuriger te detecteren dan traditionele methoden, wat de patiëntuitkomsten verbetert en de werkdruk voor zorgprofessionals vermindert.
Voor klantenservice-chatbots is tekstannotatie cruciaal om AI te leren menselijke taal te begrijpen.
Annotators kunnen bijvoorbeeld tekst labelen om chatbots te helpen gebruikersintentie te herkennen. De chatbots analyseren vervolgens de gelabelde interacties om te leren hoe ze passende antwoorden kunnen geven. Dit stelt organisaties in staat sneller en nauwkeuriger hulp te bieden en de klantervaring te verbeteren.
Bij sentimentanalyse wordt tekstannotatie gebruikt om te peilen hoe klanten zich voelen over bepaalde zaken (bijv. het merk, producten of evenementen). Dit werkt zo dat annotators zinnen of zinsdelen taggen als positief, negatief of neutraal, waarna deze data aan AI wordt doorgegeven om het onderliggende sentiment te leren. Een bedrijf kan dit daarna inzetten om te monitoren hoe klanten een nieuwe productlancering ontvangen.
Data-annotatie is het proces waarbij data wordt gelabeld zodat deze herkenbaar en bruikbaar is voor machinelearningmodellen. Het is een cruciale stap in het ontwikkelen van AI-systemen die data uit de echte wereld accuraat kunnen interpreteren en erop kunnen reageren. Waarom? Omdat de kwaliteit en nauwkeurigheid van geannoteerde data direct invloed hebben op de prestaties en effectiviteit van AI-modellen.
Uiteindelijk vormt data-annotatie de basis voor het bouwen van intelligente, betrouwbare AI-systemen die innovatie in uiteenlopende sectoren kunnen aandrijven. Het is daarmee een onmisbaar onderdeel van machinelearningontwikkeling.
Om je leertraject verder te zetten, bekijk je de volgende bronnen:
Leer meer over machine learning en AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

