
{count, plural, one {Kurs} other {Kurs}}
Machine Learning'i Anlamak
{hours} sa
312K
Kendi kendine giden bir araba geliştirdiğinizi hayal edin. Arabanın yolu "görmesi" ve anlaması için yayalar, trafik işaretleri ve diğer araçlar gibi nesneleri tanımayı öğrenmesi gerekir. Bunun olabilmesi için aranın makine öğrenimi sisteminin gerçek dünyadaki sürüş senaryolarından binlerce—hatta milyonlarca—görüntüye ihtiyacı vardır.
Ancak araba, görüntülerde ne olduğunu doğası gereği anlayamaz. Kırmızı bir sekizgenin dur işareti olduğunu ya da birinin kaldırımda yürüdüğünü bilmez. İşte veri açıklamasının devreye girdiği yer burasıdır.
Veri açıklaması, ham verilerin makine öğrenimi modelleri için anlaşılır ve kullanılabilir hâle getirilmesi amacıyla etiketlenmesi sürecidir. Bunu daha sonra daha ayrıntılı açıklayacağız, ancak şimdilik aklınızda bulundurun.
Bu yazıda aşağıdakileri inceleyeceğiz:
Hadi başlayalım!
Veri açıklamasını düşünmenin en iyi yolu, çocuklara farklı hayvanları öğretmeyi düşünmektir. İlk başta, onlara bir köpek resmi gösterip “Bu bir köpek.” dersiniz. Sonra bir kedi gösterip “Bu bir kedi.” dersiniz. Zamanla, onlara etiketli örnekler göstererek çocuk, hayvanları kendi başına tanımayı öğrenir. Veri açıklaması makineler için de benzer şekilde çalışır.
Nasıl ki bir çocuğun etiketli örneklere ihtiyacı varsa (not: “Bu bir köpek” demek etikettir), makine öğrenimi modellerinin de ondan öğrenebilmesi için verilerin açıklanması gerekir. Dolayısıyla veri açıklaması, makine öğrenimi algoritmalarının verileri tanıyıp anlayabilmesi için görüntü, metin ya da ses gibi verilerin etiketlenmesi ya da işaretlenmesi sürecidir.
Etiketler, sisteme hangi kalıpları araması gerektiğini öğreten örnekler işlevi görür. Örneğin, binlerce görüntüyü “köpek” veya “kedi” etiketleriyle açıklarsanız, model ikisi arasındaki farkları ayırt etmeye başlar.
Bu örneklerden öğrendikten sonra, model yeni etiketsiz verileri sınıflandırabilir ya da tahminlerde bulunabilir; tıpkı çocuğun sonunda hayvanları sizin yardımınız olmadan tanıması gibi.
Farklı veri türleri, makine öğrenimi görevlerine hazırlanmaları için özel açıklama yöntemleri gerektirir. Verinin doğasına bağlı olarak etiketleme ve işaretleme için farklı yaklaşımlar vardır. Bu türleri anlamak, çok çeşitli uygulamalar için modelleri eğitmenin en etkili yolunu belirlemeye yardımcı olur.
En yaygın veri açıklama türlerini inceleyelim:
Görüntü açıklaması, makine öğrenimi modellerinin görüntülerdeki nesneleri tanıyıp yorumlayabilmesi için görüntülerin etiketlenmesini içerir. Gerekli ayrıntı düzeyine bağlı olarak görüntü açıklamada farklı teknikler kullanılır:
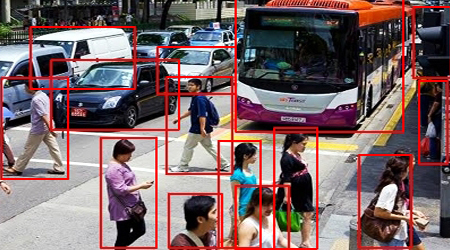
Sınırlayıcı kutular. Kaynak: Anolytics
Bu yöntemde, bir görüntüdeki nesnelerin etrafına dikdörtgenler çizilerek modelin bu nesnelerin varlığını ve konumunu tanıması sağlanır. Sınırlayıcı kutular, otonom sürüş teknolojisinde araçları, yayaları veya işaretleri tespit etmek için yaygın olarak kullanılır.
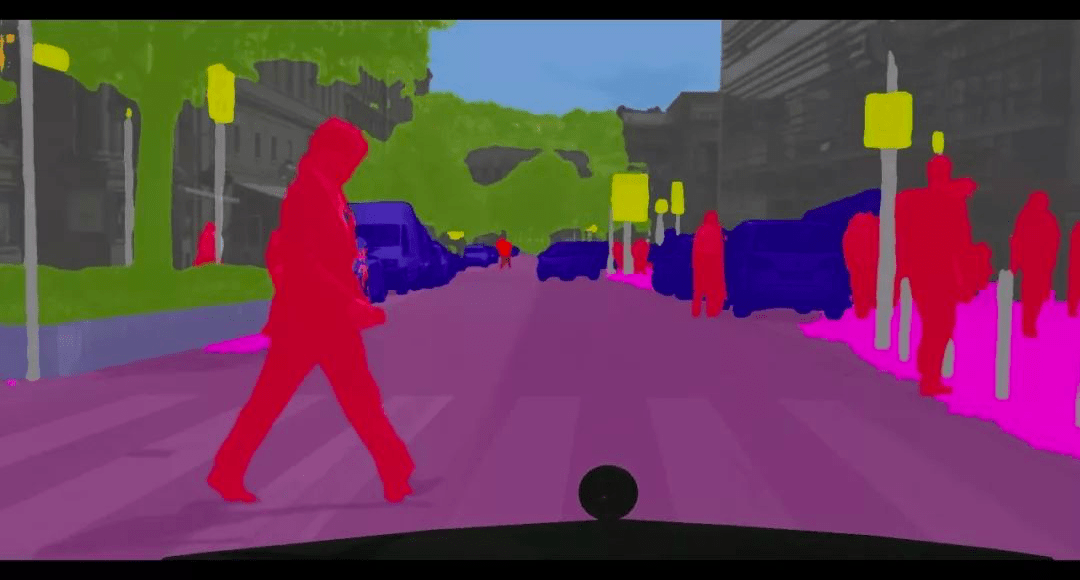
Anlamsal bölütleme. Kaynak: Introduction to Semantic Image Segmentation
Burada, görüntüdeki her piksel belirli nesnelere veya kategorilere (ör. yollar, binalar veya ağaçlar) atanacak şekilde etiketlenir. Bu teknik, modele sahnenin daha ayrıntılı bir anlaşılmasını sağlar.
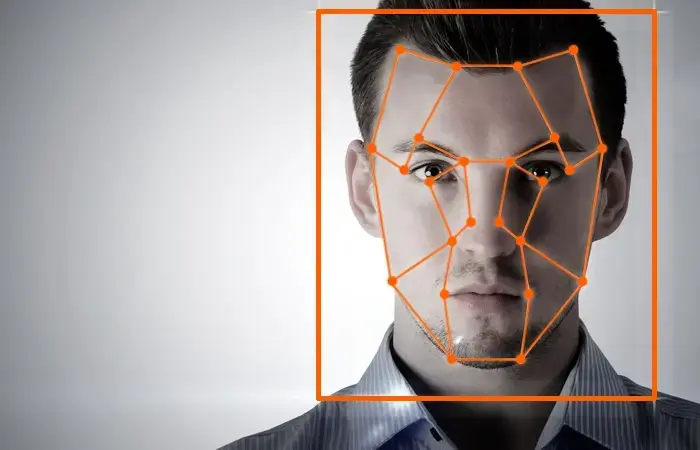
İşaret noktası açıklaması. Kaynak: Anolytics
Bu teknik, yüz özellikleri veya vücut duruşundaki kilit noktalar gibi bir görüntü içindeki belirli noktaların işaretlenmesini içerir. Yüz tanıma ve insan pozu kestirimi gibi uygulamalarda kullanılır.
Metin açıklaması, metin verilerinin etiketlenip işaretlenerek doğal dil işleme (NDİ) modelleri için anlaşılır hâle getirilmesi sürecidir. Makinelerin insan dilini anlamasını, işlemesini ve analiz etmesini sağlar.
Metin açıklamasında kullanılan birkaç yaygın teknik vardır:
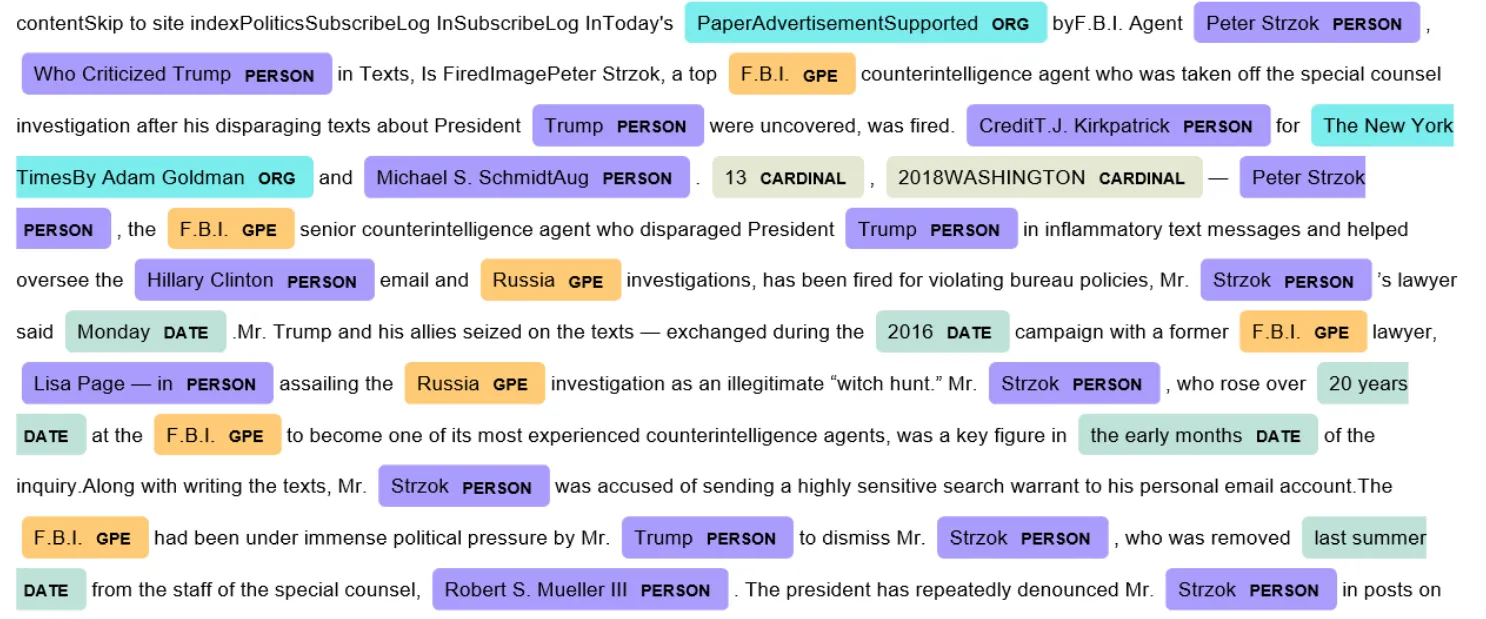
Varlık tanıma. Kaynak: Named Entity Recognition and Classification with Scikit-Learn
Bu, metindeki belirli varlıkların (kişi, yer veya kuruluş adları gibi) belirlenmesini içerir. Örneğin “Apple New York’ta yeni bir mağaza açtı.” cümlesinde model “Apple”ı bir şirket, “New York”u bir konum olarak tanıyacaktır.
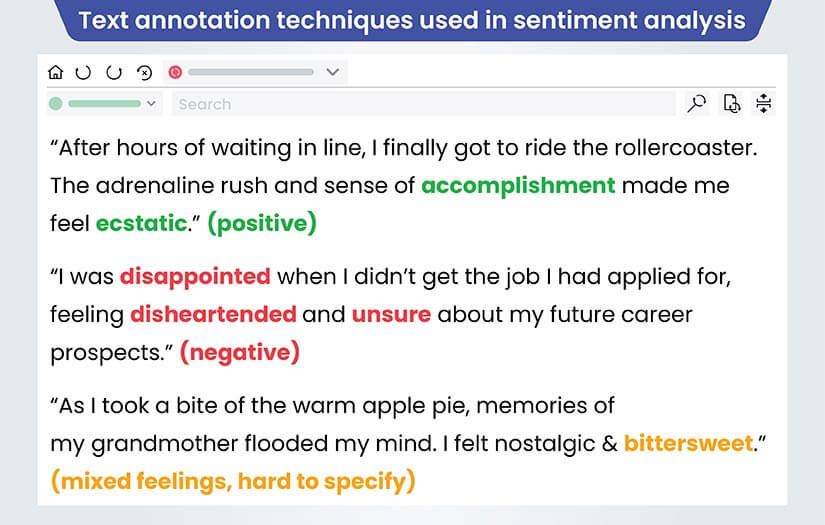
Duygu etiketleme. Kaynak: Understanding the text annotation process for Customer Sentiment Analysis
Bu teknik, metin parçalarına duyguların veya görüşlerin atanmasını ve pozitif, negatif ya da nötr olarak etiketlenmesini içerir. Ürün yorumlarında veya sosyal medya takibinde kullanıcıların bir ürün ya da hizmet hakkında ne hissettiğini anlamak için sıklıkla kullanılır.
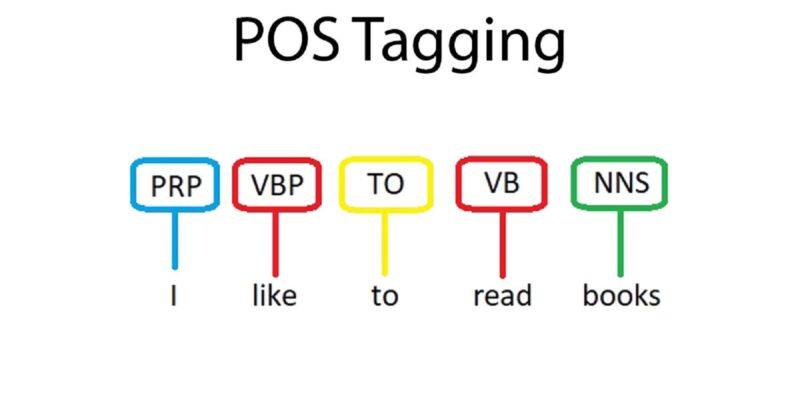
Sözcük türü etiketleme. Kaynak: POS tagging in NLP
Bu yöntem, bir cümledeki her kelimeyi dilbilgisel rolüyle (ör. isim, fiil, sıfat) etiketleyerek modellerin çeviri veya konuşma tanıma gibi görevler için dil yapısını anlamasına yardımcı olur.
Ses açıklaması, konuşma tanıma, müzik tespiti veya ses sınıflandırma için modelleri eğitmek üzere ses dosyalarının etiketlenmesini içerir.
Bazı yaygın ses açıklama teknikleri şunlardır:
Bir ses dosyasındaki konuşulan kelimelerin yazılı metne dönüştürülmesi, çoğu zaman konuşmadan metne uygulamalarında kullanılır.
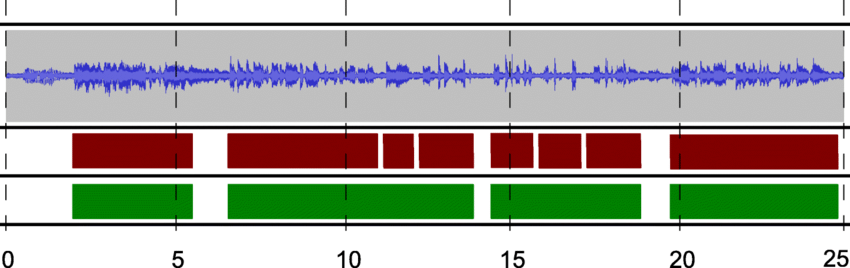
Konuşma bölütleme. Kaynak: ResearchGate
Bu, bir ses dosyasının farklı bölümlere ayrılmasını içerir. Örneğin, diyalogu arka plan gürültüsünden ayırmak ya da bir konuşmadaki farklı konuşmacıları belirlemek isteyebilirsiniz.
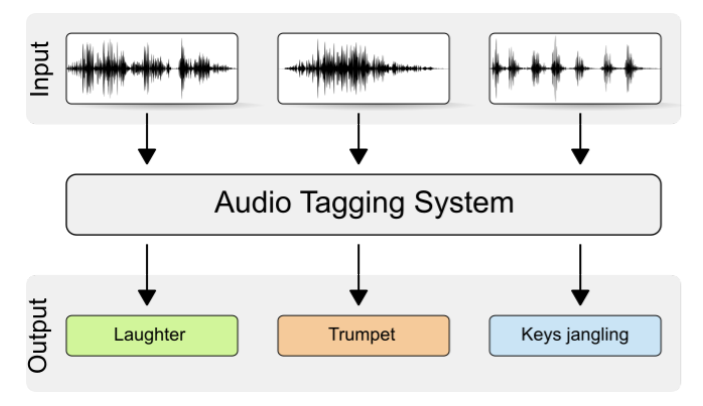
Ses etiketleme. Kaynak: Freesound Tagging by VGGish with KNN
Ses etiketleme, bir ses dosyası içinde belirli seslerin (ör. trafik gürültüsü, hayvan sesleri vb.) işaretlenmesidir.
Video açıklaması, makine öğrenimi modellerinin hareketi ve etkinlikleri yorumlamasına yardımcı olmak için video karelerindeki nesne veya eylemlerin etiketlenip işaretlenmesini içerir.
Temel video açıklama teknikleri şunlardır:
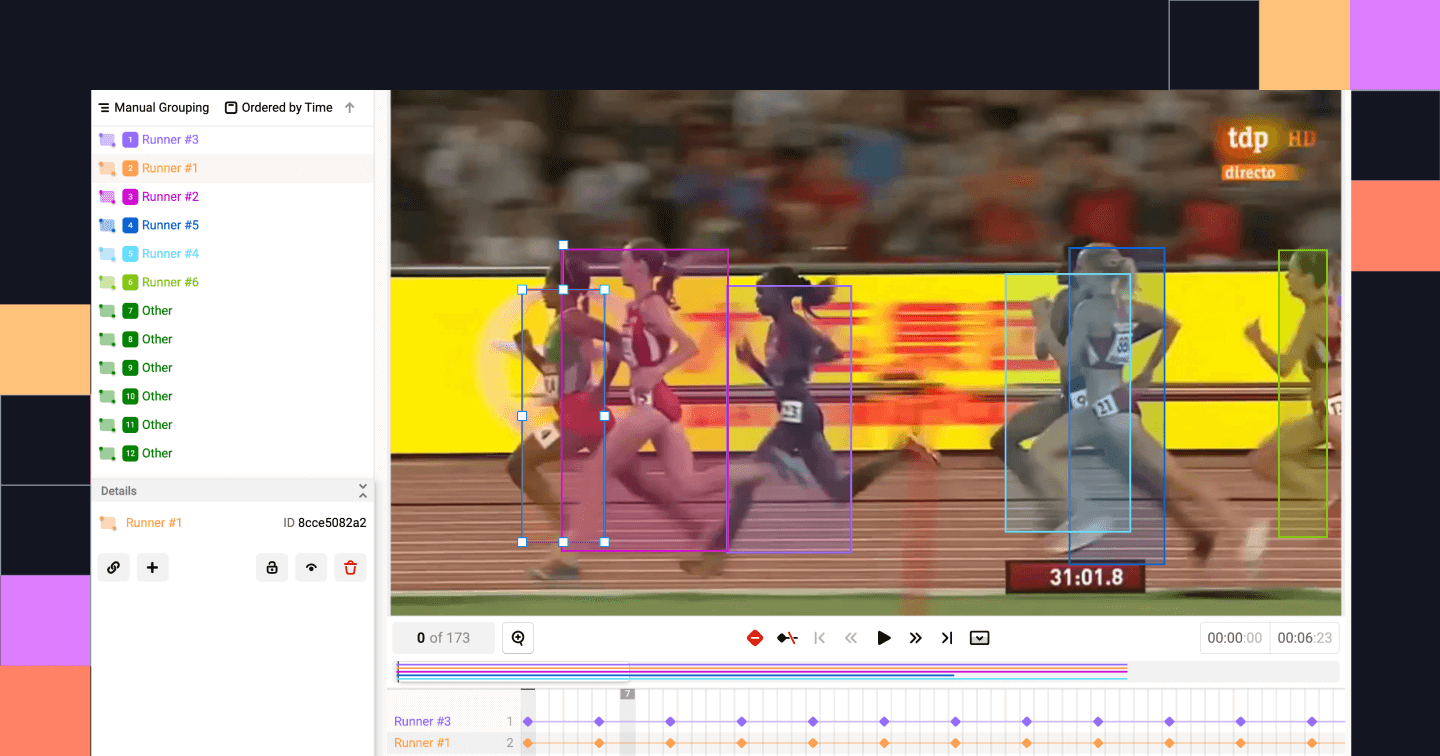
Nesne takibi. Kaynak: Label Studio
Nesne takibi, hareketlerini izlemek için nesnelerin birden çok kare boyunca sürekli olarak etiketlenmesini içerir. Örneğin, otonom sürüş senaryolarında yoğun bir kavşaktan geçen bir aracı takip etmek için nesne takibi kullanılabilir.
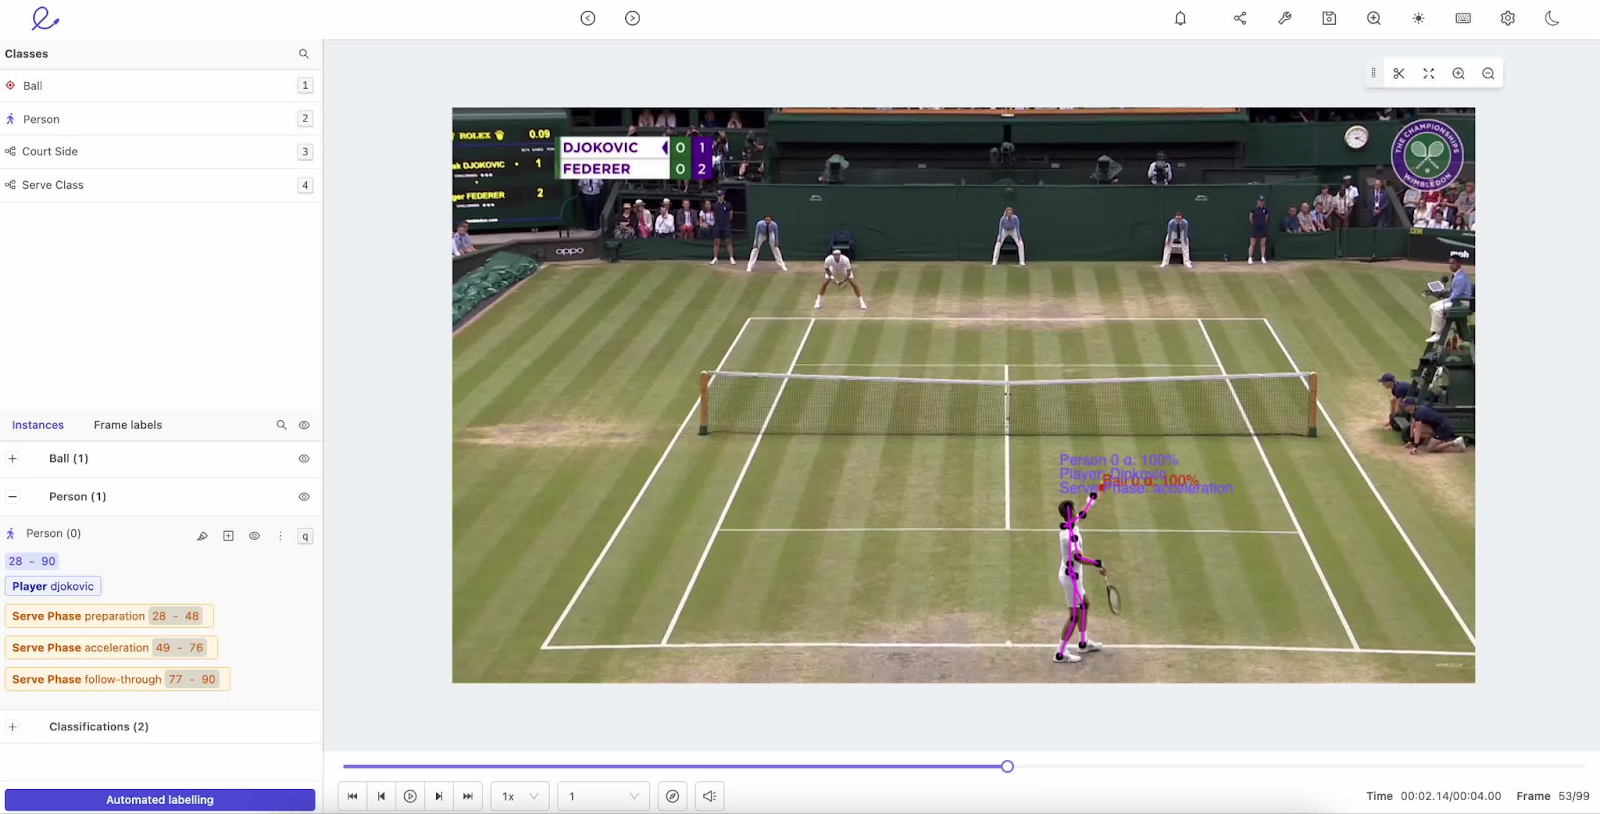
Etkinlik etiketleme. Kaynak: Encord
Bu, videoda birinin yürümesi, koşması veya oturması gibi belirli eylemlere etiket atanmasıdır. Güvenlik izleme veya spor analitiği gibi uygulamalarda modellerin insan davranışını anlamasına yardımcı olur.
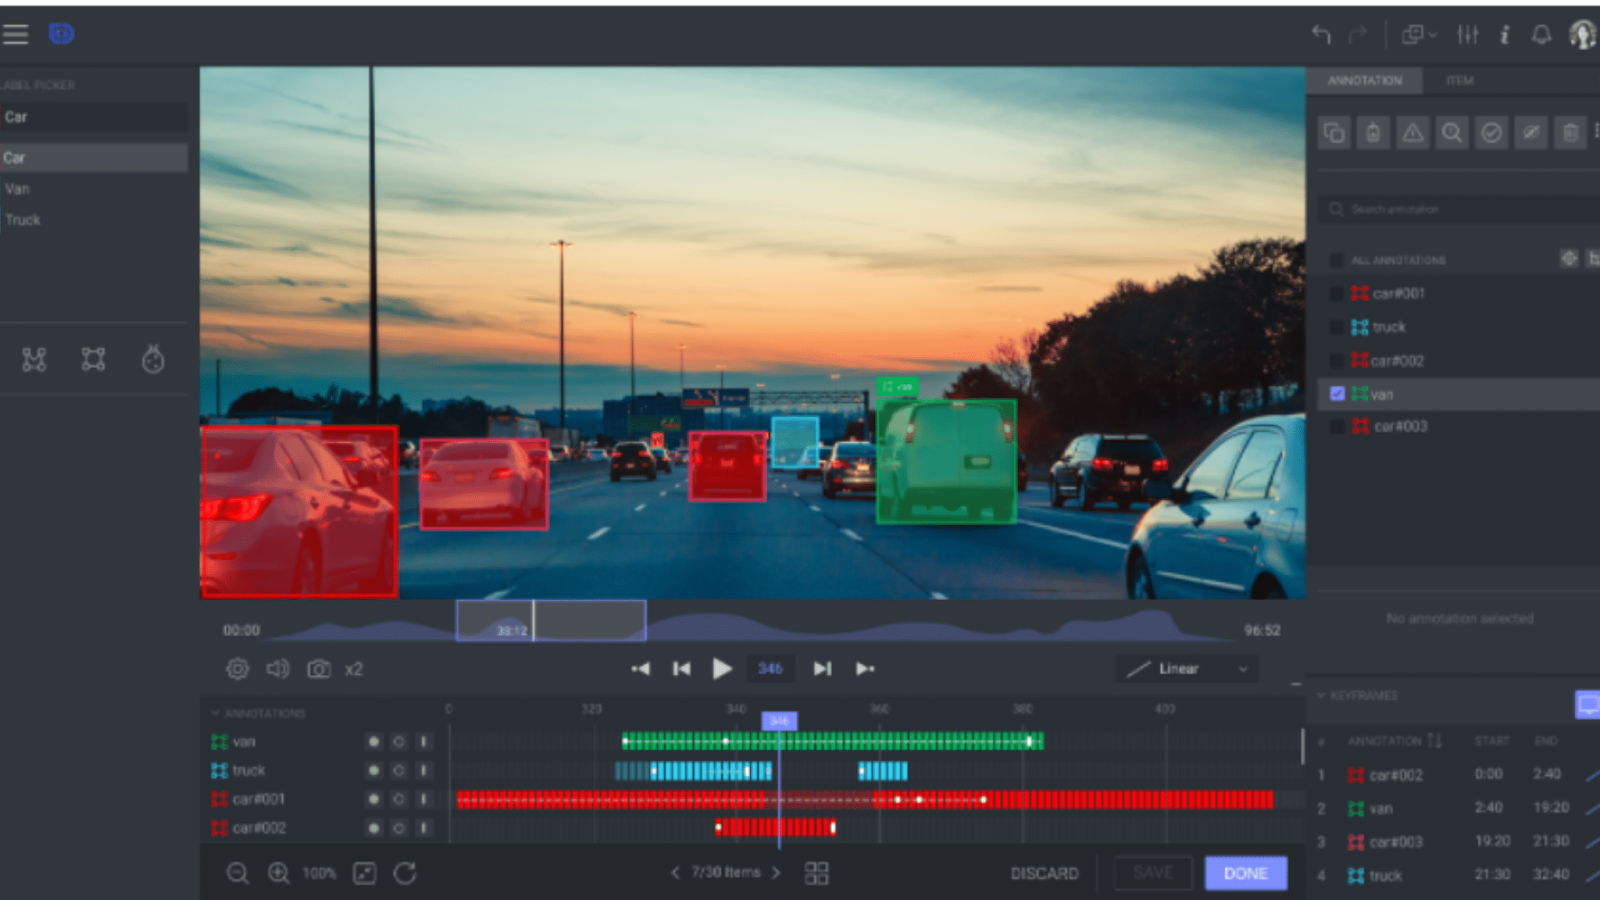
Kare kare açıklama. Kaynak: dataloop
Videonun her bir karesi küçük ayrıntıları yakalamak için etiketlendiğinde buna kare kare tespit denir. Fizik tedavide vücut hareketlerini analiz etmek gibi yüksek hassasiyet gerektiren görevlerde sıklıkla kullanılır.
Verileri açıklamak için kullanılan yöntem, aşağıdaki gibi çeşitli faktörlere bağlı olarak değişebilir:
Başka bir deyişle, bazı görevler insan açıklayıcıların doğruluğunu gerektirirken, diğerleri zamanı kazanmak ve süreci ölçeklendirmek için otomasyondan fayda sağlayabilir. Aşağıda, her bir yaklaşımın hangi durumda kullanılması gerektiğine dair daha iyi bir fikir vermek için çeşitli yöntemleri inceleyeceğiz.
Manuel açıklama, insan açıklayıcıların verileri elle etiketlemesidir. Bu yaklaşımda, eğitimli açıklayıcılar her bir veri parçasını dikkatle inceler ve gerekli etiketleri ya da işaretleri uygular.
Manuel açıklamanın en büyük avantajı doğruluktur. İnsanlar bağlamı, nüansı ve karmaşık kalıpları makinelerden daha iyi anlayabildiği için verilerin hassas biçimde etiketlenmesini sağlayabilirler. Bu düzeyde doğruluk, tıbbi görüntü etiketleme veya karmaşık doğal dil görevleri gibi yüksek kaliteli, ayrıntılı açıklamalar gerektiren projeler için özellikle önemlidir.
Bununla birlikte manuel açıklama önemli zorluklar da içerir:
Bu zorluklara rağmen, işletmeler kaliteyi zaman ve maliyet verimliliğiyle dengelemenin yollarını arasa da, hassasiyetin kritik olduğu projeler için manuel açıklama vazgeçilmezdir.
Yarı otomatik açıklama, insan uzmanlığını makine öğrenimi desteğiyle birleştirir. Bu yaklaşımda, bir makine öğrenimi modeli verileri önceden etiketleyerek ya da öneriler sunarak insan açıklayıcılara yardımcı olur. Ardından insan açıklayıcılar doğruluğu sağlamak için etiketleri gözden geçirip iyileştirir.
Yarı otomatik açıklamanın faydası, süreci hızlandırırken yüksek bir doğruluk seviyesini korumasıdır. Makine tekrarlı ya da basit görevleri üstlenebilir; böylece insan açıklayıcılar daha karmaşık veya belirsiz veri noktalarına odaklanabilir. Bu yaklaşım, tam manuel açıklamanın çok yavaş ya da pahalı olacağı büyük projeler için idealdir; çünkü zaman verimliliği ile kalite kontrolü arasında denge kurar.
Ancak bazı zorluklarla karşılaşır:
Yarı otomatik açıklama, kalitenin hızla dengelenmesi gereken; verilerin insan incelemesinden fayda sağlayacak kadar karmaşık, ancak makine desteği gerektirecek kadar büyük olduğu projeler için en iyi sonucu verir.
Otomatik açıklama, verileri insan müdahalesi olmadan etiketlemek için makine öğrenimi algoritmalarını kullanır. Bu yaklaşımda, önceden eğitilmiş modeller veya yapay zekâ destekli araçlar büyük veri kümelerini otomatik olarak açıklar. Bu, süreci manuel veya yarı otomatik yöntemlere göre daha hızlı ve daha ölçeklenebilir hâle getirir.
Otomatik açıklamanın temel avantajı verimliliktir. Bir insan açıklayıcının harcayacağı sürenin çok küçük bir kısmında çok büyük miktarlarda veriyi işleyebilir. Bu nedenle, milyonlarca görüntünün bir bilgisayarla görme modeli için etiketlenmesi ya da konuşma tanıma için büyük miktarda sesin yazıya dökülmesi gibi dev veri kümelerine sahip projeler için ideal bir çözümdür.
Ancak makinelere güvenmenin bazı sakıncaları şunlardır:
Otomatik açıklama, hız ve ölçeklenebilirliğin gerektiği ancak belirli bir hata payının kabul edilebilir olduğu ya da sonuçların daha sonra insan incelemesiyle iyileştirilebileceği projeler için en uygunudur.
Kitle kaynak kullanımı, veri etiketleme görevlerinin çok sayıda katılımcıya dağıtılmasını içerir ve şu platformlar üzerinden yapılabilir: Amazon Mechanical Turk veya Appen. Bu yöntem, küresel bir çalışan havuzundan yararlanarak işletmelerin büyük veri kümelerini hızlı ve uygun maliyetle açıklamasını sağlar.
Kitle kaynak kullanımının başlıca avantajlarından biri ölçeklenebilirliktir. Görevlerin birçok katılımcıya dağıtılması, şirketlerin büyük veri hacimlerini verimli bir şekilde ele almasını sağlar. Örneğin, binlerce etiketli görüntü veya deşifre gerektiren bir proje haftalar ya da aylar yerine günler içinde tamamlanabilir.
Bu yaklaşımın dezavantajları ise şunlardır:
Kitle kaynak kullanımı, hızlı ve uygun maliyetli açıklama gerektiren büyük ölçekli projeler için idealdir. Ancak yüksek kaliteli sonuçlar için güçlü bir gözetim ve görev yönetimi şarttır.
Veri açıklaması için çok çeşitli araçlar mevcuttur. Bu araçlar, açık kaynaklı platformlardan kapsamlı ticari çözümlere kadar uzanır ve her biri farklı proje ihtiyaçlarını karşılamak üzere tasarlanmıştır.
Örneğin, açık kaynak araçlar genellikle özelleştirilebilir ve ücretsizdir. Bu da onları daha küçük projeler veya teknik uzmanlığa sahip ekipler için ideal kılar. Öte yandan ticari seçenekler, otomasyon, iş birliği araçları ve kalite kontrol gibi daha gelişmiş özellikler sunar; bu da onları, iş akışını sadeleştirmek isteyen büyük ölçekli projeler veya işletmeler için daha uygun hâle getirir.
Bu bölümde, veri açıklaması için mevcut en popüler araçlardan bazılarını ve farklı veri türlerinde nasıl yardımcı olabileceklerini inceleyeceğiz:
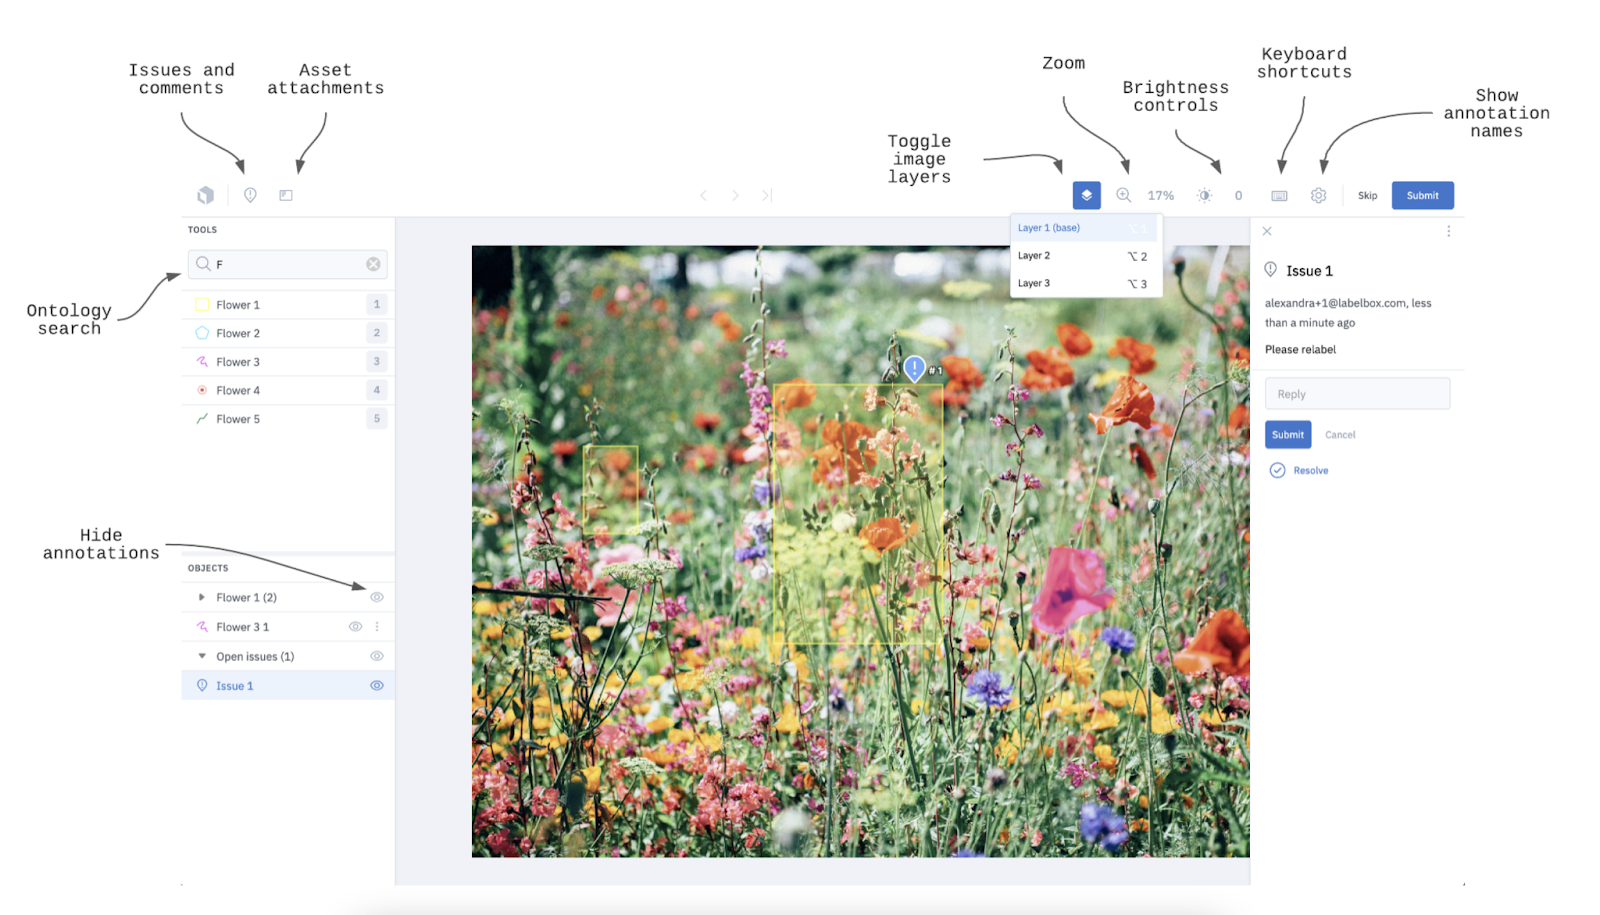
Kaynak: Labelbox Docs
Labelbox, veri açıklama sürecini iş birliği ve kalite kontrollerine odaklanarak kolaylaştırmak üzere tasarlanmış yaygın olarak kullanılan bir ticari platformdur. 2018’de Manu Sharma, Brian Rieger ve Peter Welinder tarafından kuruldu; misyonları “yapay zekâ ile uyumlu en iyi ürünleri inşa etmek.”
Labelbox, ekiplerin verileri açıklamak, ilerlemeyi takip etmek ve yüksek açıklama standartlarını korumak için birlikte çalışabileceği sezgisel bir arayüz sunar. Görüntüler, video ve metin gibi çeşitli veri türlerini de destekleyerek farklı makine öğrenimi projeleri için son derece esnek bir platform hâline gelir.
Önemli özelliklerinden biri, yerleşik kalite kontrol mekanizmalarıdır; ekiplerin açıklamaları gözden geçirip onaylamasını sağlar—bu da tutarlı ve doğru sonuçlar elde edilmesine yardımcı olur.
Labelbox, proje yönetimi ve otomasyon özellikleri entegre edilmiş şekilde açıklama çalışmalarını ölçeklendirmek isteyen kuruluşlar için idealdir.
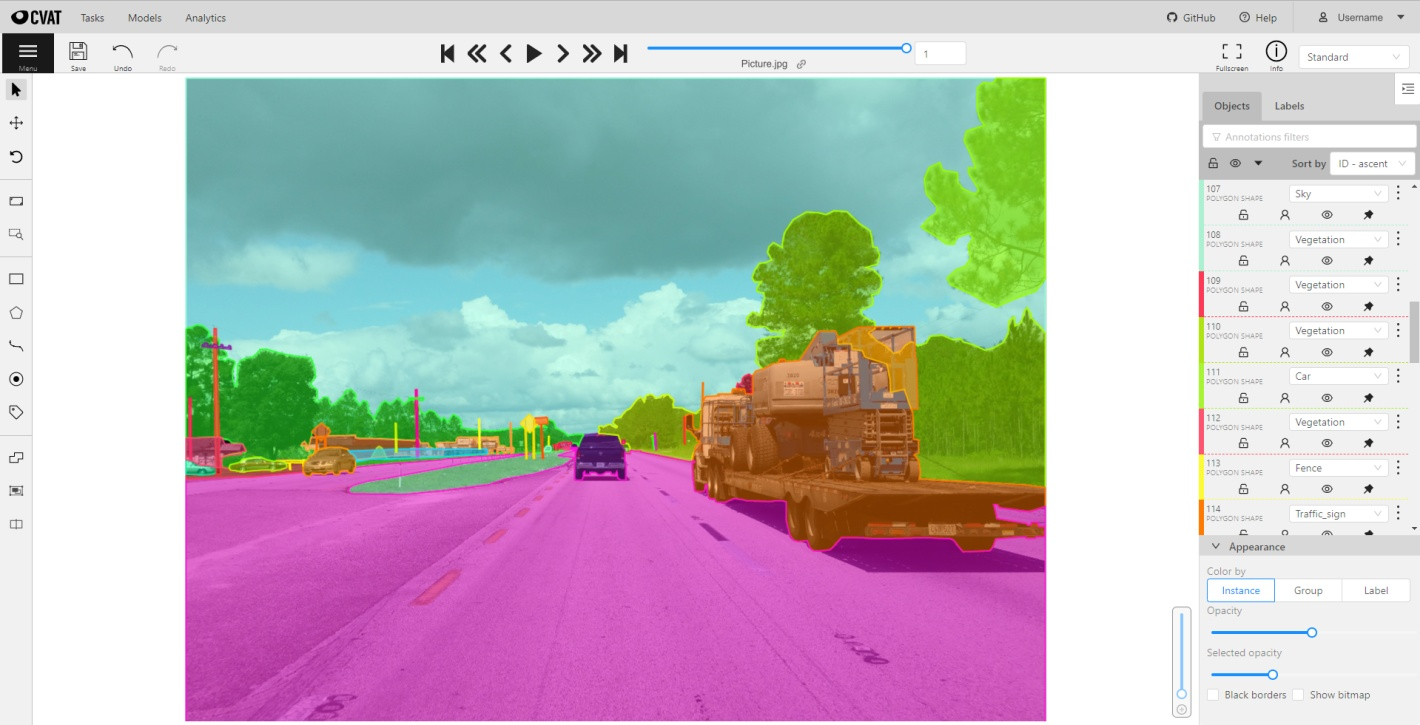
Kaynak: CVAT Wikipedia page
CVAT, İntel tarafından geliştirilen ve özellikle görüntü ile video veri kümelerinin açıklanması için tasarlanmış açık kaynaklı bir araçtır. Son derece özelleştirilebilir olup sınırlayıcı kutular, poligonlar ve kilit nokta açıklamaları gibi çok çeşitli açıklama teknikleri sunar. Esnekliği, onu nesne tespitinden yüz tanımaya kadar uzanan projeler için uygun kılar.
Açık kaynak olduğundan CVAT ücretsizdir ve belirli proje ihtiyaçlarına göre uyarlanabilir. Bu da, ticari yazılım maliyetine katlanmadan güçlü açıklama araçlarına ihtiyaç duyan araştırmacılar ve küçük ekipler için popüler bir seçenek olmasını sağlar.
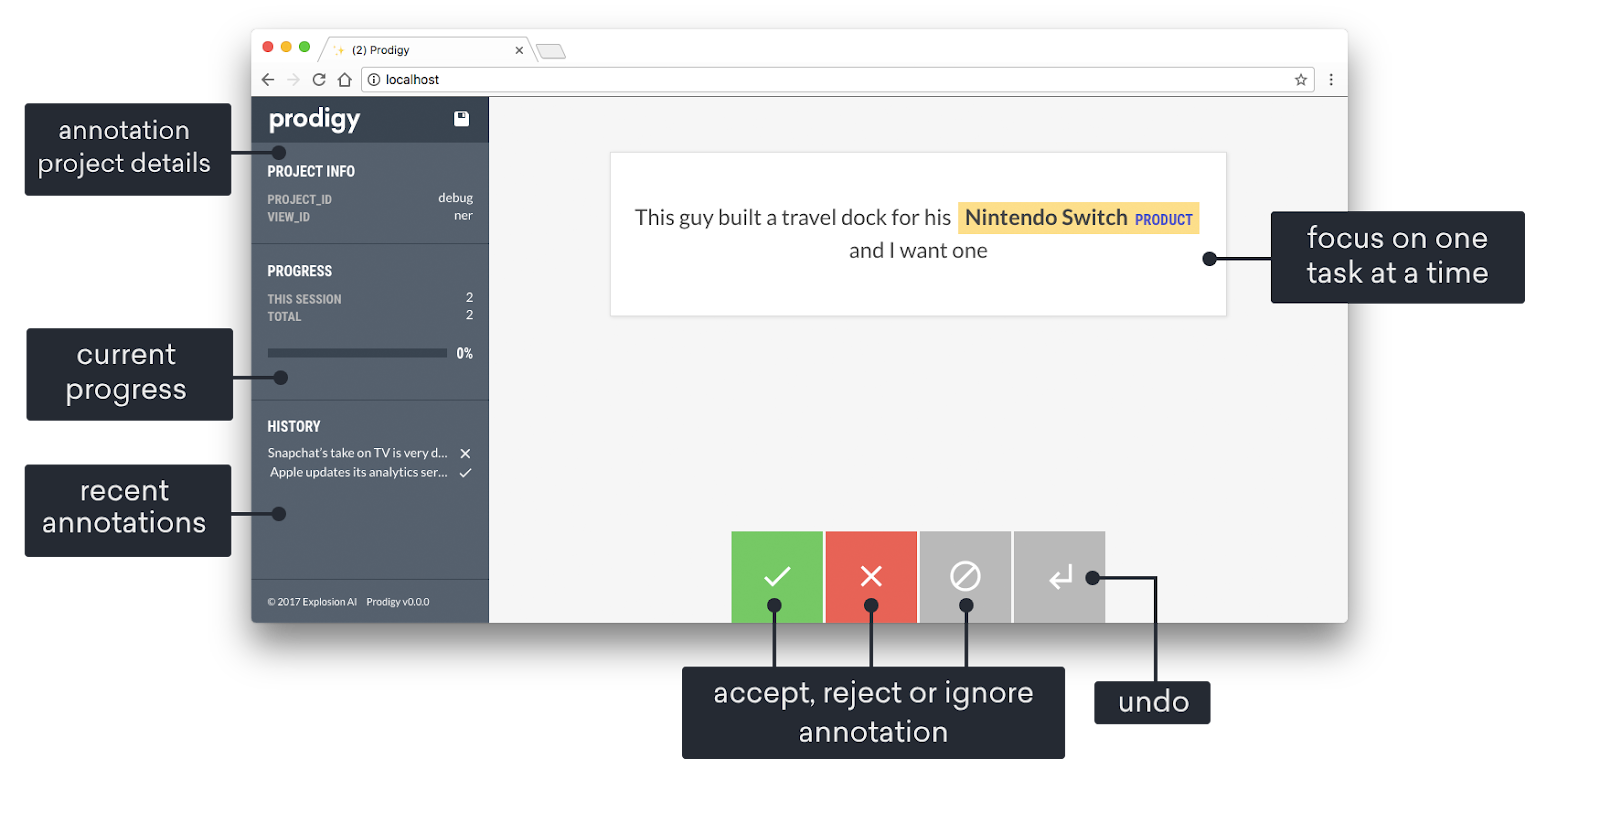
Kaynak: Prodigy Docs
Prodigy, özellikle doğal dil işleme (NLP) görevlerinde verimliliği artırmak için etkin öğrenme kullanan, Explosion AI tarafından geliştirilen gelişmiş bir açıklama aracıdır. Prodigy ile bir makine öğrenimi modeli, tahminlerine dayanarak etiketler önerir; bu etiketler daha sonra insan değerlendiriciler tarafından onaylanır veya düzeltilir.
Bu etkileşimli yaklaşım, açıklama sürecini hızlandırırken aynı zamanda etiketli verilerin yüksek kalitede olmasını sağlar. Ticari bir araç olmasına rağmen Prodigy son derece özelleştirilebilirdir; örneğin kullanıcıların kendi açıklama iş akışlarını oluşturmalarına imkân tanır. Bu etkenler, duygu analizi, varlık tanıma veya metin sınıflandırma gibi özel NLP projeleri üzerinde çalışan ekipler için Prodigy’yi oldukça uygun kılar.
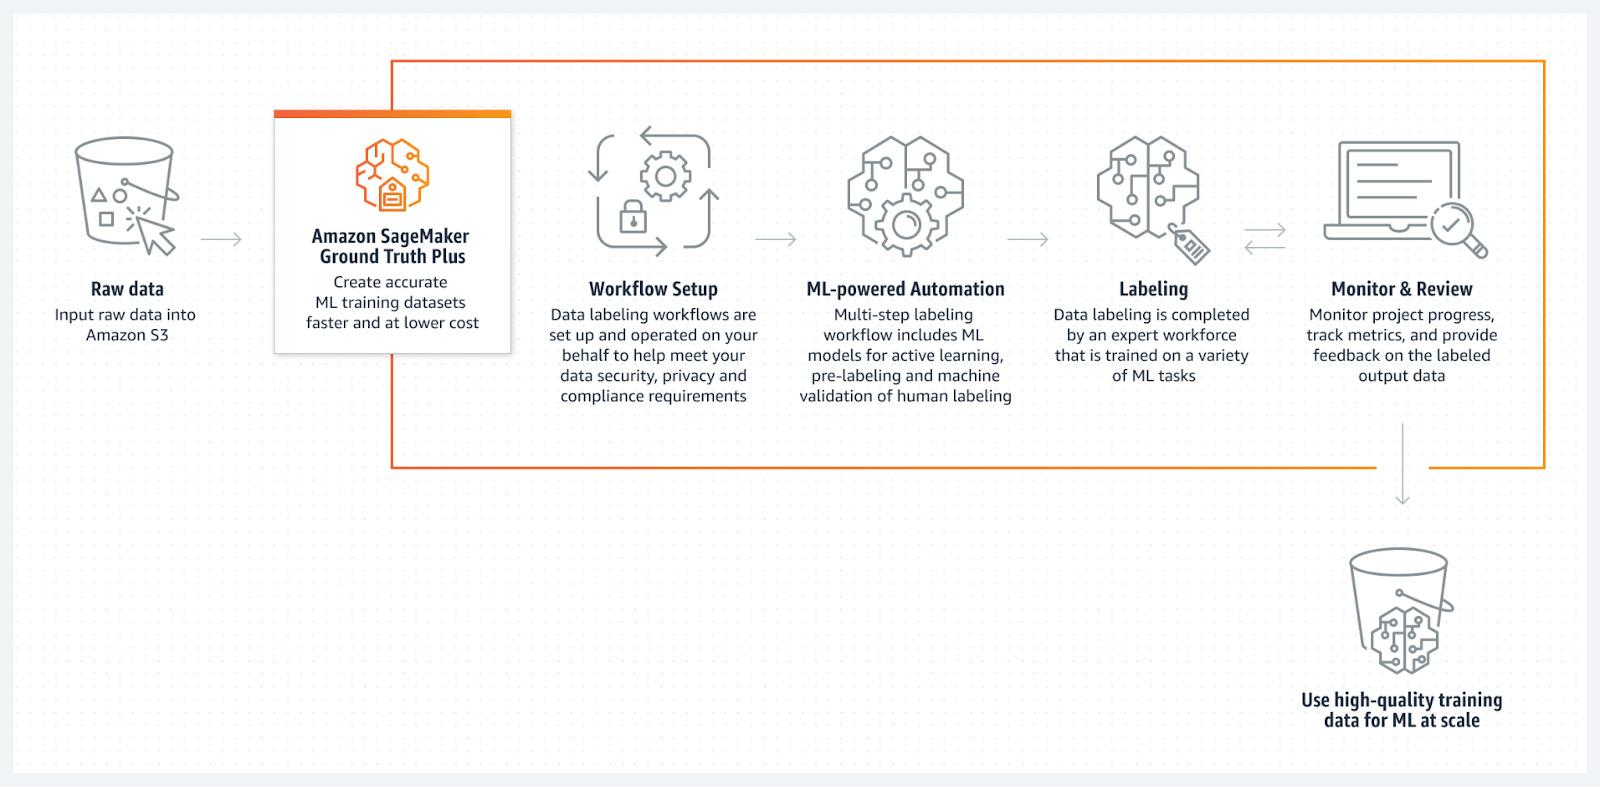
Kaynak: Amazon SageMaker Ground Truth
Amazon SageMaker Ground Truth, AWS ile sorunsuz şekilde entegre olan, tamamen yönetilen bir veri etiketleme hizmetidir. Kullanıcıların verileri hızlı ve doğru şekilde etiketlemesine olanak tanıyan manuel ve otomatik veri açıklama araçları sunar.
SageMaker Ground Truth, verileri önceden etiketleyerek insan açıklayıcılara yardımcı olmak için makine öğrenimini kullanır; bu da süreci hızlandırır ve maliyetleri düşürür. Görüntüler, metinler ve videolar dâhil çok çeşitli veri türlerini desteklediği için farklı makine öğrenimi görevleri için son derece esnek bir seçenektir.
Ayrıca ölçeklenebilir olacak şekilde tasarlanmıştır; bu nedenle AWS ekosistemi içinde büyük ölçekli açıklama yeteneklerine ihtiyaç duyan işletmeler için güçlü bir seçenektir.
Etkili veri açıklaması, makine öğrenimi modellerinin başarısı için kritik önemdedir; çünkü etiketli verilerin kalitesi, tahmin ve sınıflandırmaların doğruluğunu doğrudan etkiler. En iyi uygulamaları takip etmek, açıklama sürecinin hem verimli hem de güvenilir olmasını sağlar.
Bu bölümde, etiketleme sürecinde karşılaşılabilecek zorluklara da değinirken, veri açıklamasının kalitesini ve tutarlılığını artırabilecek temel uygulamaları inceleyeceğiz.
Veri açıklama sürecindeki en önemli adımlardan biri, net ve iyi tanımlanmış yönergeler oluşturmaktır. Bu yönergeler, verilerin tam olarak nasıl etiketleneceğini ve tutarlılığı sağlamak için açıklayıcıların hangi kriterleri izlemesi gerektiğini belirtmelidir.
Net yönergeler şunlara yardımcı olur:
Standart kuralların olması, özellikle birden fazla yoruma açık karmaşık veya öznel görüntü ve metin verileri için hayati önem taşır.
Kalite, açıklanan verilerin doğruluğunu ve güvenilirliğini korumak için gereklidir. Bu nedenle, açıklanan verilerin belirli aralıklarla gözden geçirilerek gereken standartları karşıladığından emin olunmalıdır. Bu süreç, projeye bağlı olarak rastgele denetimler, aynı görevler için birden fazla açıklayıcı kullanma (sonuçları karşılaştırmak için) veya çapraz kontrol yoluyla yürütülebilir.
Özetle, hataları erken yakalamaya, verilerinizdeki önyargıyı azaltmaya ve etiketli verilerin yüksek performanslı makine öğrenimi modellerini eğitmeye uygun olmasını sağlamaya yardımcı olacak sağlam bir kalite güvencesi süreci uygulamak çok önemlidir.
Etkin öğrenme, bir algoritmanın etiketleme için en bilgilendirici veri örneklerini seçmesine olanak tanıyan ve modelin performansını artıran bir makine öğrenimi tekniğidir. Bu teknik, açıklama sürecinin verimliliğini önemli ölçüde artırabilir. Açıklayıcıların zaman ve enerjilerini en zor ve en değerli veri noktalarına odaklamasına olanak tanırken, geri kalanını makine öğrenimi algoritması önerir.
Bu yaklaşım, kolay ya da tekrarlayan örneklerin etiketlenmesine harcanan zamanı azaltır ve genel açıklama sürecini hızlandırır. Böylece, tahminlerde bulunmak için kullanılan makine öğrenimi modelinin en kritik örnekler üzerinde eğitilme olasılığı artar.
Açıklama sürecinin doğru bir şekilde yürütülmesini sağlamak için açıklayıcıların uygun eğitim alması gerekir. Eğitim, açıklayıcıların görevin özel gerekliliklerini ve açıklama yönergelerinin nasıl doğru uygulanacağını anlamalarına yardımcı olur.
İyi eğitilmiş açıklayıcılar, nihayetinde destekledikleri makine öğrenimi modellerinin performansını iyileştiren, yüksek kaliteli etiketli veriler üretme olasılığı daha yüksek olan kişilerdir. Düzenli eğitim oturumları ve geri bildirim döngüleri, zaman içinde açıklayıcıların becerilerini geliştirerek veri açıklama sürecini daha da iyileştirebilir.
Veri açıklaması, doğru makine öğrenimi modellerini eğitmek için gerekli olsa da, sürecin kendine özgü zorlukları vardır. Bu bölümde, veri açıklamadaki en yaygın zorluklardan bazılarını tartışacağız.
Manuel veri açıklaması genellikle emek yoğundur. Tüm örneklerin açıklanması için, özellikle veri kümesi büyük olduğunda, ciddi miktarda zaman ve mali kaynak gerekir. Veri ne kadar karmaşıksa (örneğin video veya detaylı görüntüler), açıklama süreci o kadar zaman alıcı olur. Yetenekli açıklayıcıların istihdam edilmesi gerekir; bu da maliyetleri artırır.
Bu zorluğun üstesinden gelmek için kuruluşlar, makine öğrenimi modellerinin etiket önerdiği ve insanların bunları doğruladığı yarı otomatik açıklama araçlarını kullanabilir. Bu, doğruluktan ödün vermeden süreci hızlandırır.
Etkin öğrenme de insan çabasını en bilgilendirici verilere odaklayarak yardımcı olabilir; bu da manuel olarak etiketlenmesi gereken toplam veri miktarını azaltır. Ayrıca Amazon Mechanical Turk gibi kitle kaynak platformlarını kullanmak, birden fazla katılımcının eşzamanlı çalışmasına olanak tanıyarak büyük ölçekli açıklamayı daha uygun maliyetli ve verimli hâle getirebilir.
Bir diğer önemli zorluk, açıklama sürecindeki öznelik ve önyargıyla başa çıkmaktır. Farklı açıklayıcılar aynı veriyi farklı şekillerde yorumlayabilir. Bu durum, metindeki duyguların etiketlenmesi veya karmaşık görüntülerdeki nesnelerin belirlenmesi gibi görevlerde son derece yaygındır. Sorun şu ki, öznellik etiketli verilere önyargı katabilir; bu da önyargılı model tahminlerine yol açabilir.
Öznelik ve önyargıyı azaltmak için kuruluşlar, tüm açıklayıcıların aynı kriterleri izlemesini sağlayacak net ve ayrıntılı açıklama yönergeleri oluşturmalıdır. Bir diğer çözüm, aynı veri için birden fazla açıklayıcı kullanmaktır; bu, çapraz kontrol yapılmasına ve önyargılı ya da tutarsız açıklamaların belirlenip düzeltilmesine yardımcı olur.
Kimlik bilgilerini açığa çıkaran açıklamalar, kişisel verileri koruyan gizlilik düzenlemelerini ihlal edebilir. Bu zorluk, açıklama görevlerinin dışarıya verilmesi ya da kitle kaynak platformlarının kullanılması ve veriye birçok katılımcının erişmesi durumlarında özellikle önemlidir.
Anonimleştirme (kişisel olarak tanımlanabilir bilgilerin kaldırılması) ve güvenli, şifreli açıklama platformlarının kullanılması gibi çözümler bu riskleri azaltmaya yardımcı olabilir.
Bu bölümde, veri açıklamasının gerçek dünya uygulamalarını inceleyeceğiz. Hadi başlayalım!
Otonom araçlarda veri açıklaması, yapay zekâya gerçek dünyada güvenle gezinmeyi öğretmenin temelidir. Sürücüsüz arabalar, nesneleri tanımlamak için açıklanmış verilere güvenir.
Örneğin, açıklayıcılar görüntülere veya video karelerine araçların etrafına sınırlayıcı kutular çizerek ya da şerit tespiti için yol sınırlarını işaretleyerek etiketler ekler. Bu açıklamalar, yapay zekânın yayalar için durmak ya da doğru şeritte kalmak gibi çeşitli yol senaryolarını tanıyıp tepki vermeyi öğrenmesine yardımcı olur.
Yapay zekâ modellerinin anormallikleri tespit etmeyi öğrenmesi için etiketli tıbbi görüntülere ihtiyacı vardır. Örneğin, yetenekli açıklayıcılar, kanserin erken belirtilerini gösteren bölgeleri işaretlemek için görüntüler üzerindeki belirli alanları çizer. Bu, yapay zekânın kanseri geleneksel yöntemlerden daha hızlı ve doğru şekilde tespit etmesini sağlayarak hasta sonuçlarını iyileştirir ve sağlık profesyonellerinin iş yükünü azaltır.
Müşteri hizmetleri sohbet robotlarında, yapay zekâya insan dilini anlamayı öğretmek için metin açıklaması kritik öneme sahiptir.
Örneğin, açıklayıcılar, sohbet robotlarının kullanıcı niyetini tanımasına yardımcı olmak için metni etiketleyebilir. Sohbet robotları daha sonra uygun yanıtları nasıl vereceklerini öğrenmek için etiketli etkileşimleri analiz eder. Bu, kuruluşların daha hızlı ve daha doğru destek sunmasını ve müşteri deneyimini iyileştirmesini sağlar.
Duygu analizinde, metin açıklaması, müşterilerin belirli konular (ör. marka, ürünler veya etkinlikler) hakkında ne hissettiğini ölçmek için kullanılır. İşleyiş şu şekildedir: Açıklayıcılar, ifadeleri veya cümleleri pozitif, negatif ya da nötr olarak etiketler; ardından bu veriler, alttaki duyguyu öğrenmesi için yapay zekâya aktarılır. Bir şirket daha sonra bunu, yeni bir ürün lansmanının müşteriler tarafından nasıl karşılandığını izlemek için devreye alabilir.
Veri açıklaması, verilerin makine öğrenimi modelleri tarafından tanınabilir ve kullanılabilir hâle getirilmesi için etiketlenmesi sürecidir. Gerçek dünya verilerini doğru biçimde yorumlayıp yanıtlayabilen yapay zekâ sistemleri geliştirmede kritik bir adımdır. Neden? Çünkü açıklanan verilerin kalitesi ve doğruluğu, yapay zekâ modellerinin performansını ve etkinliğini doğrudan etkiler.
Sonuç olarak, veri açıklaması; çeşitli sektörlerde yeniliği destekleyebilen, akıllı ve güvenilir yapay zekâ sistemlerinin inşası için temel görevi görür. Bu da onu makine öğrenimi geliştirme sürecinin vazgeçilmez bir parçası yapar.
Öğrenmeye devam etmek için aşağıdaki kaynaklara göz atın:
Bu kurslarla makine öğrenimi ve yapay zekâ hakkında daha fazla bilgi edinin!
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme



