
कोर्स
Understanding Machine Learning
2 घंटा
311.4K
कल्पना कीजिए कि आप एक स्वचालित कार विकसित कर रहे हैं। कार को सड़क को "देखने" और समझने के लिए, उसे पैदल यात्रियों, ट्रैफिक संकेतों और अन्य वाहनों जैसे ऑब्जेक्ट्स को पहचानना सीखना होगा। ऐसा होने के लिए, कार के मशीन लर्निंग सिस्टम को वास्तविक दुनिया के ड्राइविंग परिदृश्यों की हजारों—अगर लाखों नहीं—तस्वीरों की जरूरत होती है।
लेकिन कार स्वभावतः तस्वीरों में क्या है, यह नहीं समझ सकती। उसे यह नहीं पता कि लाल अष्टभुज एक स्टॉप साइन है या कोई व्यक्ति फुटपाथ पर चल रहा है। यहीं पर डेटा एनोटेशन काम आता है।
डेटा एनोटेशन कच्चे डेटा को लेबल करने की प्रक्रिया है ताकि वह मशीन लर्निंग मॉडलों के लिए समझने योग्य और उपयोगी बन सके। हम इसे आगे विस्तार से समझाएंगे, पर इतना ध्यान में रखें।
इस लेख में हम यह खोजेंगे:
चलिए शुरू करते हैं!
डेटा एनोटेशन को समझने का सबसे अच्छा तरीका है बच्चों को अलग-अलग जानवर सिखाने जैसा सोचना। शुरू में, आप उन्हें कुत्ते की तस्वीर दिखाते हैं और कहते हैं, “यह कुत्ता है।” फिर आप उन्हें बिल्ली दिखाते हैं और कहते हैं, “यह बिल्ली है।” समय के साथ, लेबल किए गए उदाहरणों को दिखाकर, बच्चा खुद से जानवरों की पहचान करना सीख लेता है। मशीनों के लिए डेटा एनोटेशन भी इसी तरह काम करता है।
जैसे बच्चे को लेबल किए गए उदाहरणों की जरूरत होती है (ध्यान दें: “यह कुत्ता है” कहना लेबलिंग है), वैसे ही मशीन लर्निंग मॉडलों के लिए डेटा का एनोटेट होना जरूरी है ताकि वे उससे सीख सकें। अतः, डेटा एनोटेशन छवियों, पाठ या ऑडियो जैसे डेटा को लेबल या टैग करने की प्रक्रिया है ताकि मशीन लर्निंग एल्गोरिद्म उसे पहचान और समझ सकें।
ये लेबल उदाहरण के रूप में काम करते हैं जो सिस्टम को बताते हैं कि किन पैटर्न पर ध्यान देना है। उदाहरण के लिए, यदि आप हजारों तस्वीरों को "कुत्ता" या "बिल्ली" के लेबल से एनोटेट करते हैं, तो मॉडल दोनों के बीच के अंतर को पहचानना शुरू कर देगा।
एक बार जब वह इन उदाहरणों से सीख लेता है, तो मॉडल नए अनलेबल्ड डेटा को भविष्यवाणी या वर्गीकृत कर सकता है, ठीक वैसे ही जैसे बच्चा अंततः बिना आपकी मदद के जानवरों को पहचान लेता है।
विभिन्न प्रकार के डेटा को मशीन लर्निंग कार्यों के लिए तैयार करने हेतु विशिष्ट एनोटेशन विधियों की आवश्यकता होती है। डेटा की प्रकृति के आधार पर, लेबलिंग और टैगिंग के लिए अलग-अलग तरीके अपनाए जाते हैं। इन प्रकारों को समझना विविध अनुप्रयोगों के लिए मॉडलों को प्रशिक्षित करने का सबसे प्रभावी तरीका तय करने में मदद करता है।
आइए डेटा एनोटेशन के सबसे आम प्रकारों को देखें:
इमेज एनोटेशन में तस्वीरों को इस तरह लेबल करना शामिल है कि मशीन लर्निंग मॉडल उनके भीतर मौजूद ऑब्जेक्ट्स की पहचान और व्याख्या कर सकें। विस्तार स्तर के अनुसार इमेज एनोटेशन में विभिन्न तकनीकों का उपयोग किया जाता है:
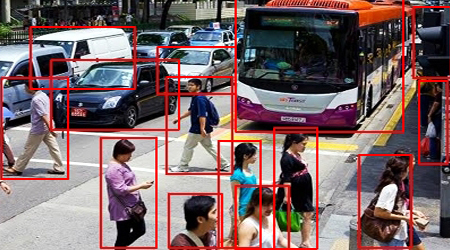
बाउंडिंग बॉक्सेज़। सोर्स: Anolytics
इस विधि में तस्वीर में ऑब्जेक्ट्स के चारों ओर आयत खींचे जाते हैं ताकि मॉडल उनकी उपस्थिति और स्थान को पहचान सके। स्वचालित ड्राइविंग तकनीक में कारों, पैदल यात्रियों या संकेतों का पता लगाने के लिए बाउंडिंग बॉक्सेज़ का आमतौर पर उपयोग होता है।
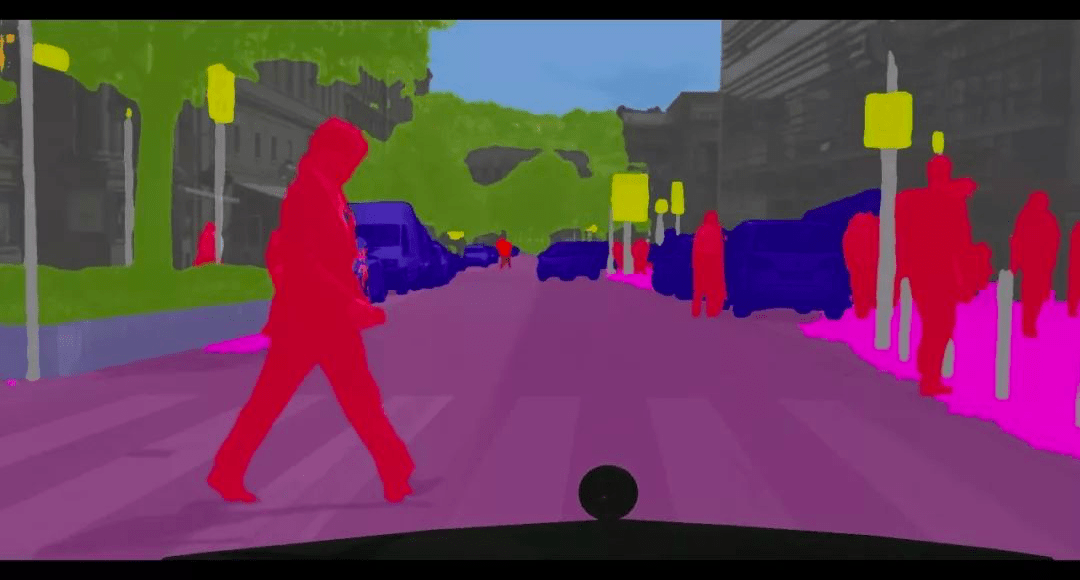
सेमांटिक सेगमेंटेशन। स्रोत: Introduction to Semantic Image Segmentation
यहाँ, तस्वीर के प्रत्येक पिक्सेल को लेबल किया जाता है ताकि विशिष्ट क्षेत्रों को खास ऑब्जेक्ट्स या श्रेणियों, जैसे सड़कें, इमारतें या पेड़, सौंपे जा सकें। यह तकनीक मॉडल को दृश्य का अधिक सूक्ष्म समझ प्रदान करती है।
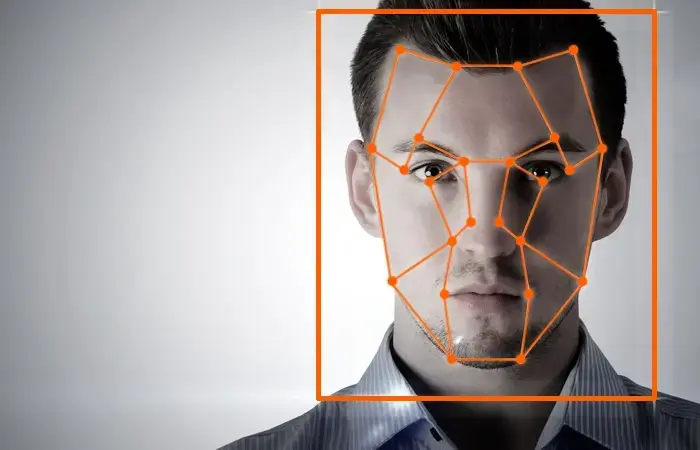
लैंडमार्क एनोटेशन। सोर्स: Anolytics
इस तकनीक में तस्वीर के भीतर विशिष्ट बिंदुओं को चिह्नित किया जाता है, जैसे चेहरे की विशेषताएँ या शरीर की मुद्रा के प्रमुख बिंदु। इसका उपयोग फेसियल रिकग्निशन और ह्यूमन पोज़ एस्टीमेशन जैसे अनुप्रयोगों में होता है।
टेक्स्ट एनोटेशन में पाठ्य डेटा को लेबल और टैग करना शामिल है ताकि वह नेचुरल लैंग्वेज प्रोसेसिंग (एनएलपी) मॉडलों के लिए समझने योग्य बने। यह मशीनों को मानव भाषा को समझने, प्रोसेस करने और विश्लेषित करने में सक्षम बनाता है।
टेक्स्ट एनोटेशन में कई आम तकनीकें उपयोग होती हैं:
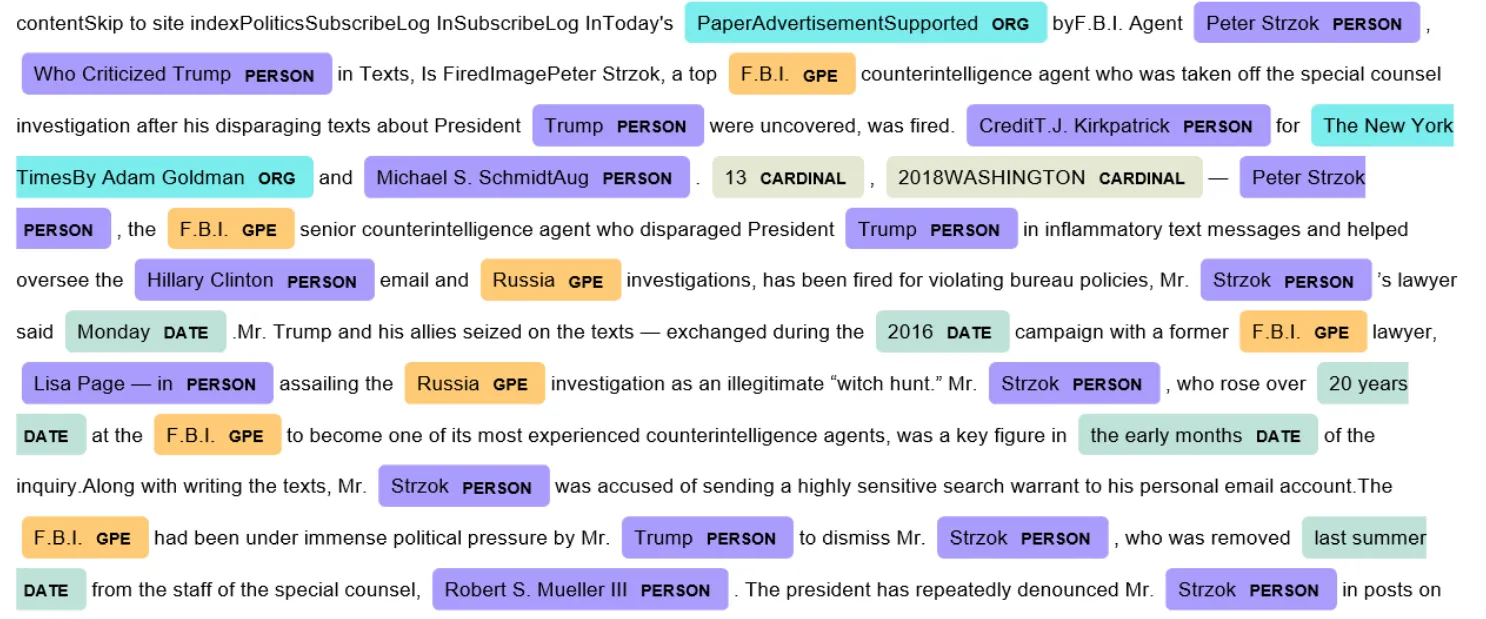
एंटिटी रिकग्निशन। सोर्स: Named Entity Recognition and Classification with Scikit-Learn
इसमें पाठ में विशेष इकाइयों की पहचान करना शामिल है, जैसे व्यक्तियों, स्थानों या संगठनों के नाम। उदाहरण के लिए, वाक्य "Apple opened a new store in New York" में, मॉडल "Apple" को एक कंपनी और "New York" को एक स्थान के रूप में पहचानेगा।
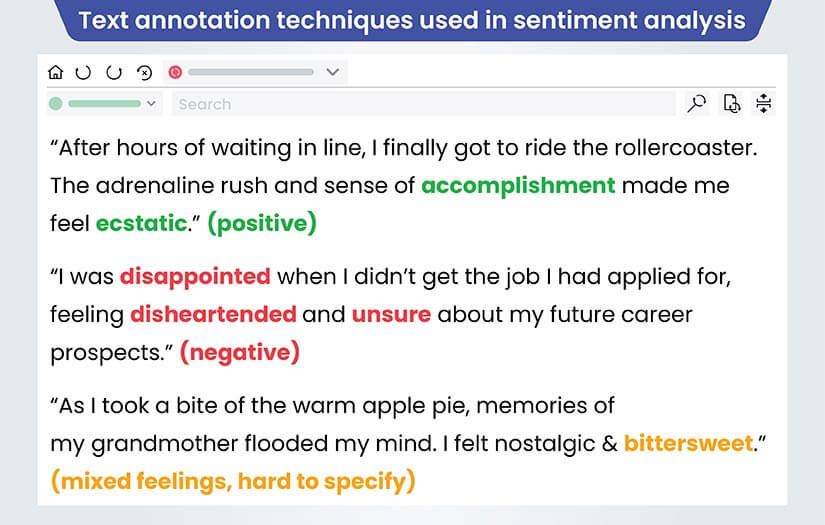
सेंटिमेंट टैगिंग। सोर्स: Understanding the text annotation process for Customer Sentiment Analysis
यह तकनीक पाठ के हिस्सों को भावनाओं या राय के अनुसार सकारात्मक, नकारात्मक या तटस्थ के रूप में लेबल करती है। इसे अक्सर ग्राहक समीक्षाओं या सोशल मीडिया मॉनिटरिंग में उपयोग किया जाता है ताकि यह समझा जा सके कि उपयोगकर्ता किसी उत्पाद या सेवा के बारे में कैसा महसूस कर रहे हैं।
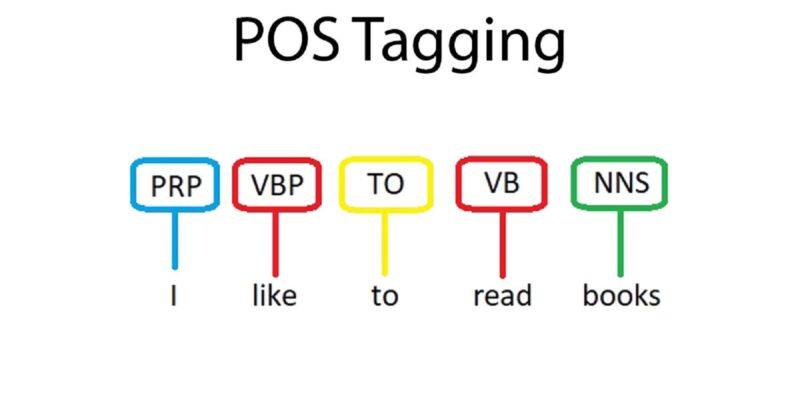
पीओएस टैगिंग। सोर्स: POS tagging in NLP
इस विधि में वाक्य के प्रत्येक शब्द को उसके व्याकरणिक भूमिका (जैसे, संज्ञा, क्रिया, विशेषण) के लेबल से चिह्नित किया जाता है, जो अनुवाद या भाषण पहचान जैसे कार्यों के लिए भाषा संरचना को समझने में मदद करता है।
ऑडियो एनोटेशन में साउंड फाइलों को लेबल करना शामिल है ताकि मॉडल स्पीच रिकग्निशन, म्यूज़िक डिटेक्शन या साउंड क्लासिफिकेशन के लिए प्रशिक्षित किए जा सकें।
कुछ सामान्य ऑडियो एनोटेशन तकनीकें हैं:
ऑडियो फाइल में बोले गए शब्दों को लिखित पाठ में बदलना अक्सर स्पीच-टू-टेक्स्ट अनुप्रयोगों में किया जाता है।
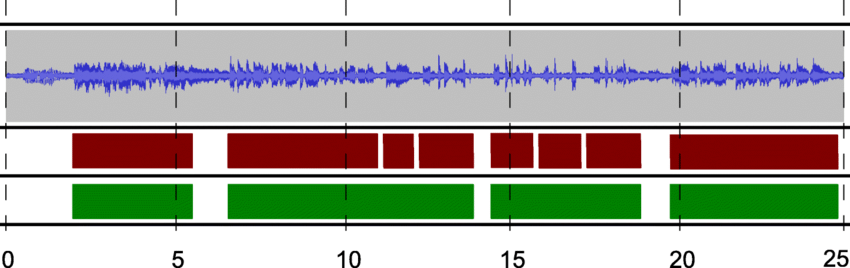
स्पीच सेगमेंटेशन। सोर्स: ResearchGate
इसमें ऑडियो फाइल को अलग-अलग खंडों में बाँटना शामिल है। उदाहरण के लिए, आप संवाद को बैकग्राउंड शोर से अलग करना चाह सकते हैं या बातचीत में अलग-अलग वक्ताओं की पहचान करना चाह सकते हैं।
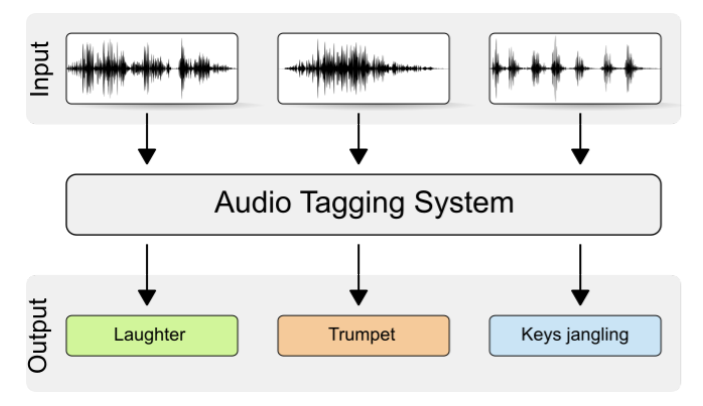
साउंड टैगिंग। सोर्स: Freesound Tagging by VGGish with KNN
साउंड टैगिंग तब होती है जब किसी ऑडियो फाइल में विशिष्ट ध्वनियों (जैसे, ट्रैफिक शोर, जानवरों की आवाज़ें, आदि) को लेबल किया जाता है।
वीडियो एनोटेशन में मशीन लर्निंग मॉडलों को गति और गतिविधियों की व्याख्या करने में मदद के लिए वीडियो फ्रेम्स में ऑब्जेक्ट्स या क्रियाओं को लेबल और टैग करना शामिल है।
मुख्य वीडियो एनोटेशन तकनीकें शामिल हैं:
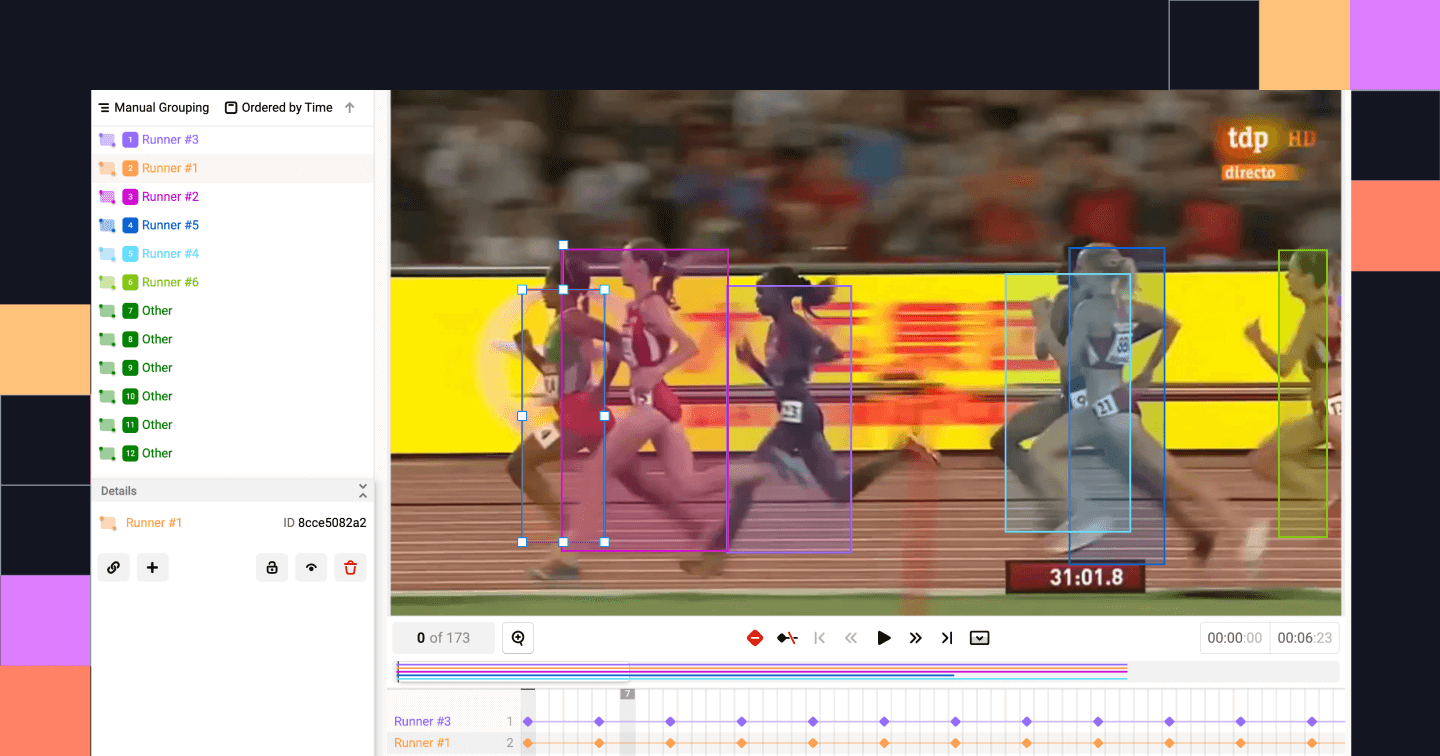
ऑब्जेक्ट ट्रैकिंग। स्रोत: Label Studio
ऑब्जेक्ट ट्रैकिंग में कई फ्रेम्स में लगातार ऑब्जेक्ट्स को लेबल करना शामिल है ताकि उनकी गति का पता लगाया जा सके। उदाहरण के लिए, स्वायत्त ड्राइविंग परिदृश्यों में, किसी व्यस्त चौराहे से गुजरते वाहन को ट्रैक करने के लिए ऑब्जेक्ट ट्रैकिंग का उपयोग किया जा सकता है।
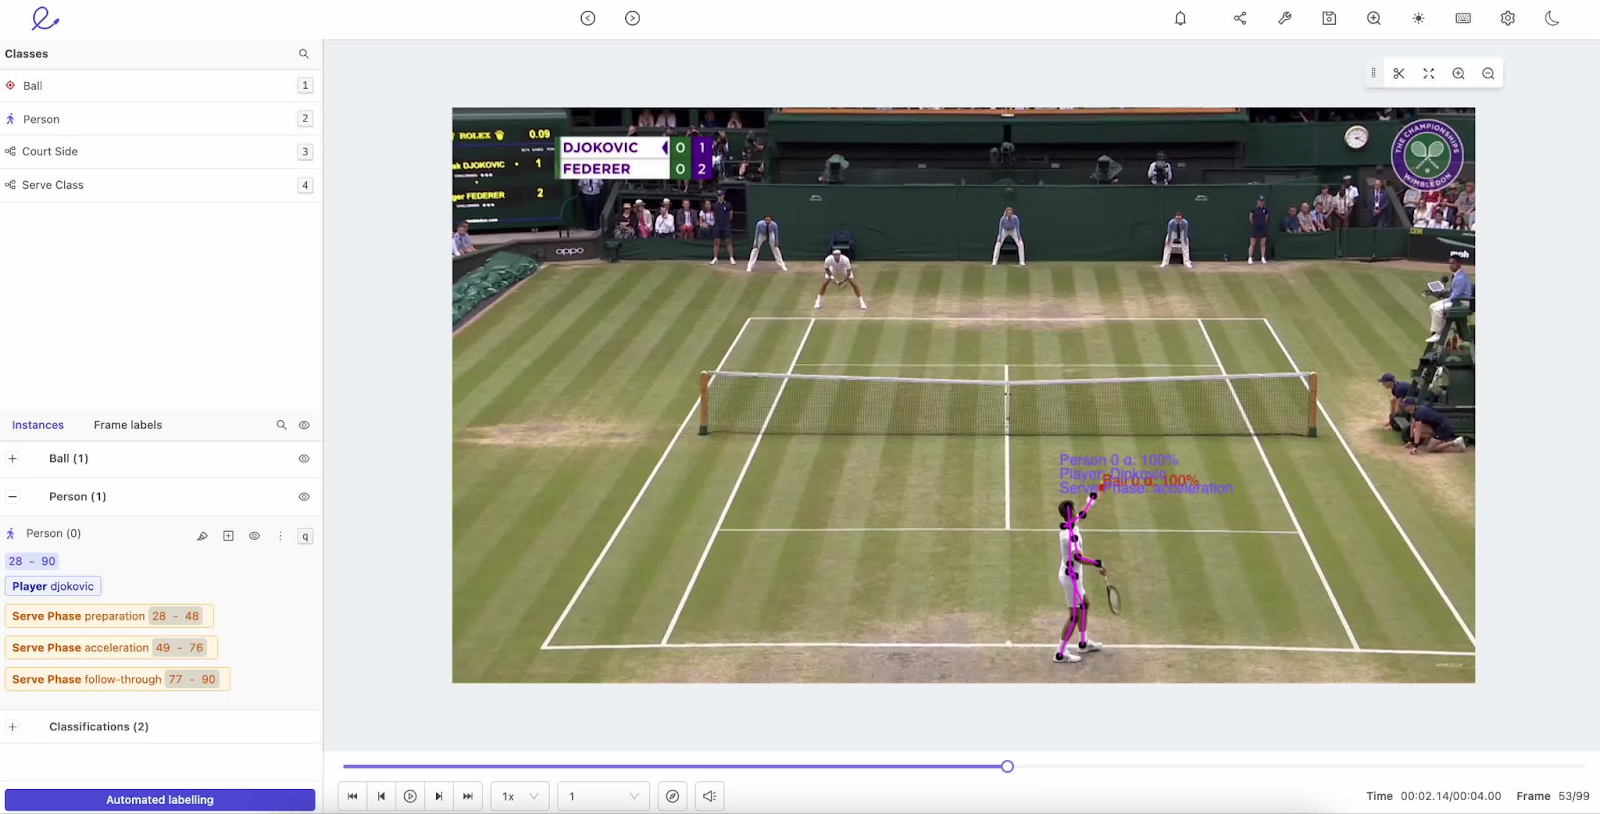
एक्टिविटी लेबलिंग। सोर्स: Encord
यह वह स्थिति है जब वीडियो में किसी के चलने, दौड़ने या बैठने जैसी क्रियाओं को लेबल सौंपे जाते हैं। यह सुरक्षा मॉनिटरिंग या खेल विश्लेषण जैसे अनुप्रयोगों में मानव व्यवहार को समझने में मॉडलों की मदद करता है।
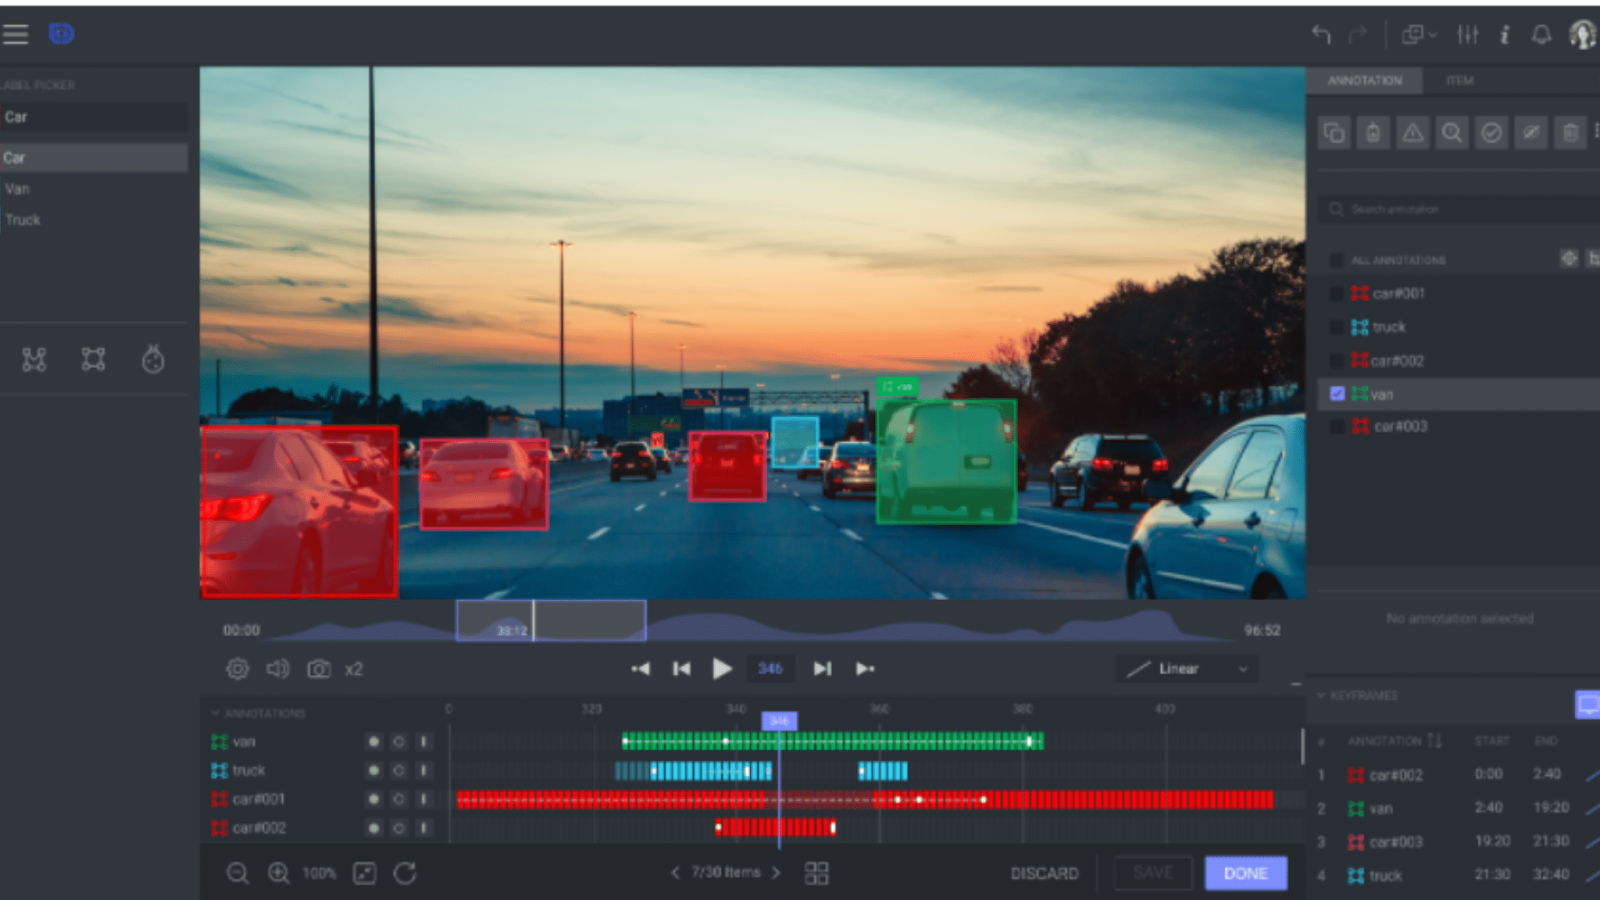
फ्रेम-बाय-फ्रेम एनोटेशन। सोर्स: dataloop
जब किसी वीडियो के प्रत्येक फ्रेम को सूक्ष्म विवरणों को कैप्चर करने के लिए लेबल किया जाता है, तो इसे फ्रेम-बाय-फ्रेम डिटेक्शन कहा जाता है। इसका उपयोग अक्सर उन कार्यों में होता है जिन्हें उच्च परिशुद्धता की आवश्यकता होती है, जैसे फिजिकल थेरेपी में शारीरिक गतियों का विश्लेषण।
डेटा को एनोटेट करने के लिए उपयोग की जाने वाली विधि कई कारकों पर निर्भर कर सकती है, जैसे:
दूसरे शब्दों में, कुछ कार्यों के लिए मानव एनोटेटरों की सटीकता जरूरी होती है, जबकि अन्य स्वचालन से समय बचाने और प्रक्रिया को स्केल करने का लाभ उठा सकते हैं। नीचे, हम विभिन्न तरीकों की पड़ताल करेंगे ताकि आपको यह बेहतर समझ मिल सके कि किस स्थिति में किसका उपयोग करना चाहिए।
मैनुअल एनोटेशन तब होता है जब मानव एनोटेटर डेटा को हाथ से लेबल करते हैं। इस दृष्टिकोण में, प्रशिक्षित एनोटेटर प्रत्येक डेटा पीस की सावधानीपूर्वक समीक्षा करते हैं और आवश्यक लेबल या टैग लागू करते हैं।
मैनुअल एनोटेशन का सबसे बड़ा लाभ सटीकता है। चूँकि मनुष्य संदर्भ, सूक्ष्मताओं और जटिल पैटर्न को मशीनों की तुलना में बेहतर समझ सकते हैं, वे सुनिश्चित कर सकते हैं कि डेटा सटीक रूप से लेबल किया गया है। यह सटीकता स्तर विशेष रूप से उन प्रोजेक्ट्स के लिए महत्वपूर्ण है जिन्हें उच्च-गुणवत्ता, विस्तृत एनोटेशन की आवश्यकता होती है, जैसे चिकित्सा छवि लेबलिंग या जटिल प्राकृतिक भाषा कार्य।
हालाँकि, मैनुअल एनोटेशन में महत्वपूर्ण चुनौतियाँ भी हैं:
इन चुनौतियों के बावजूद, मैनुअल एनोटेशन उन प्रोजेक्ट्स के लिए आवश्यक बना रहता है जहाँ सटीकता महत्वपूर्ण है, भले ही व्यवसाय अक्सर गुणवत्ता को समय और लागत दक्षता के साथ संतुलित करने के तरीके खोजते हों।
अर्ध-स्वचालित एनोटेशन मानव विशेषज्ञता को मशीन लर्निंग की सहायता के साथ जोड़ता है। इस दृष्टिकोण में, एक मशीन लर्निंग मॉडल डेटा को पहले से लेबल करके या सुझाव देकर मानव एनोटेटरों की मदद करता है। इसके बाद मानव एनोटेटर लेबल्स की समीक्षा और परिशोधन करते हैं ताकि सटीकता सुनिश्चित हो सके।
अर्ध-स्वचालित एनोटेशन का लाभ यह है कि यह प्रक्रिया को तेज़ कर देता है जबकि उच्च स्तर की सटीकता बनाए रखता है। मशीन दोहराए जाने वाले या सरल कार्यों को संभाल सकती है, जिससे मानव एनोटेटर अधिक जटिल या संदिग्ध डेटा बिंदुओं पर ध्यान केंद्रित कर सकते हैं। यह दृष्टिकोण बड़े प्रोजेक्ट्स के लिए आदर्श है जहाँ पूर्ण मैनुअल एनोटेशन बहुत धीमा या महँगा होगा, क्योंकि यह समय दक्षता और गुणवत्ता नियंत्रण के बीच संतुलन स्थापित करता है।
फिर भी, इसमें कुछ चुनौतियाँ होती हैं:
अर्ध-स्वचालित एनोटेशन उन प्रोजेक्ट्स के लिए सबसे अच्छा काम करता है जिन्हें गुणवत्ता और गति के बीच संतुलन चाहिए, जहाँ डेटा इतना जटिल हो कि मानवीय समीक्षा से लाभ हो सके, लेकिन इतना बड़ा भी हो कि मशीन सहायता आवश्यक हो।
स्वचालित एनोटेशन मशीन लर्निंग एल्गोरिद्म का उपयोग करता है ताकि बिना मानवीय भागीदारी के डेटा को लेबल किया जा सके। इस दृष्टिकोण में, प्री-ट्रेंड मॉडल या AI-चालित टूल्स बड़े डेटासेट्स को स्वतः एनोटेट करते हैं। यह प्रक्रिया को मैनुअल या अर्ध-स्वचालित तरीकों की तुलना में तेज़ और अधिक स्केलेबल बनाता है।
स्वचालित एनोटेशन का मुख्य लाभ दक्षता है। यह उस समय के एक अंश में विशाल मात्रा में डेटा प्रोसेस कर सकता है जितना एक मानव एनोटेटर लेगा। नतीजतन, स्वचालित एनोटेशन उन प्रोजेक्ट्स के लिए आदर्श समाधान है जिनमें बहुत बड़े डेटासेट्स होते हैं, जैसे कंप्यूटर विज़न मॉडल के लिए लाखों छवियों को टैग करना या स्पीच रिकग्निशन के लिए बड़े पैमाने पर ऑडियो का ट्रांसक्रिप्शन।
लेकिन मशीनों पर निर्भरता की खामियाँ इस प्रकार हैं:
स्वचालित एनोटेशन उन प्रोजेक्ट्स के लिए सबसे उपयुक्त है जिन्हें गति और स्केलेबिलिटी चाहिए, लेकिन जहाँ कुछ त्रुटि-सीमा स्वीकार्य हो या बाद में मानवीय समीक्षा से परिणामों को परिष्कृत किया जा सके।
क्राउडसोर्सिंग में डेटा लेबलिंग कार्यों को बड़ी संख्या में योगदानकर्ताओं में बाँटना शामिल है, प्लेटफॉर्म्स जैसे Amazon Mechanical Turk या Appen का उपयोग करके। यह विधि व्यवसायों को वैश्विक कार्यबल का लाभ उठाकर बड़े डेटासेट्स को तेज़ी और किफायती तरीके से एनोटेट करने में सक्षम बनाती है।
क्राउडसोर्सिंग के मुख्य लाभों में से एक स्केलेबिलिटी है। कार्यों को कई योगदानकर्ताओं में बाँटने से कंपनियाँ बड़े पैमाने के डेटा को कुशलतापूर्वक संभाल सकती हैं। उदाहरण के लिए, हजारों लेबल्ड छवियों या ट्रांसक्रिप्शंस की आवश्यकता वाले प्रोजेक्ट्स सप्ताहों या महीनों के बजाय दिनों में पूरे हो सकते हैं।
इस दृष्टिकोण की कमियाँ इस प्रकार हैं:
क्राउडसोर्सिंग बड़े पैमाने के प्रोजेक्ट्स के लिए आदर्श है जिन्हें तेज़ और किफायती एनोटेशन की आवश्यकता होती है। हालाँकि, उच्च-गुणवत्ता के परिणाम बनाए रखने के लिए मज़बूत निगरानी और कार्य-प्रबंधन आवश्यक है।
डेटा एनोटेशन के लिए कई तरह के टूल्स उपलब्ध हैं। ये टूल्स ओपन-सोर्स प्लेटफ़ॉर्म से लेकर व्यापक कमर्शियल समाधानों तक फैले हुए हैं, जो प्रत्येक अलग-अलग प्रोजेक्ट आवश्यकताओं को पूरा करने के लिए बनाए गए हैं।
उदाहरण के लिए, ओपन-सोर्स टूल्स अक्सर कस्टमाइजेबल और मुफ़्त होते हैं। यह उन्हें छोटे प्रोजेक्ट्स या तकनीकी विशेषज्ञता वाली टीमों के लिए आदर्श बनाता है। दूसरी ओर, कमर्शियल विकल्प अधिक उन्नत सुविधाएँ प्रदान करते हैं, जिनमें ऑटोमेशन, सहयोग टूल्स और गुणवत्ता नियंत्रण शामिल हैं, जो उन्हें बड़े पैमाने के प्रोजेक्ट्स या सुव्यवस्थित वर्कफ़्लो चाहने वाले एंटरप्राइज़ के लिए अधिक उपयुक्त बनाते हैं।
इस अनुभाग में, हम डेटा एनोटेशन के लिए उपलब्ध कुछ सबसे लोकप्रिय टूल्स और वे विभिन्न प्रकार के डेटा में कैसे मदद कर सकते हैं, की पड़ताल करेंगे:
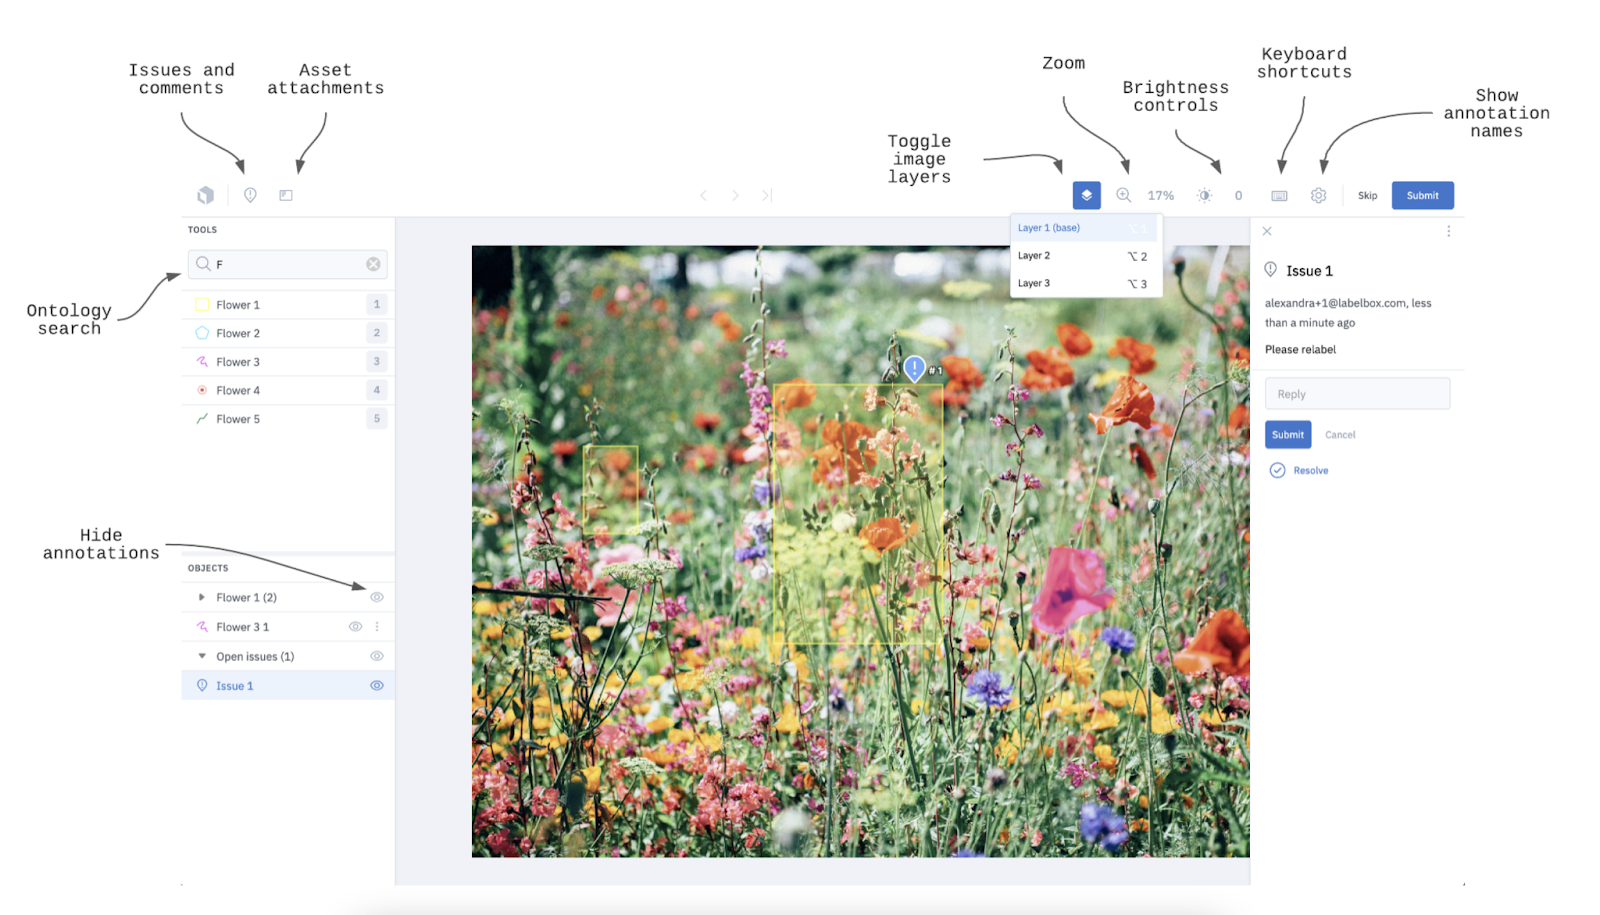
सोर्स: Labelbox Docs
Labelbox एक व्यापक रूप से प्रयुक्त कमर्शियल प्लेटफ़ॉर्म है जिसे डेटा एनोटेशन प्रक्रिया को सुव्यवस्थित करने के लिए डिज़ाइन किया गया है, जिसमें सहयोग और गुणवत्ता नियंत्रण पर ध्यान केंद्रित है। इसकी स्थापना 2018 में Manu Sharma, Brian Rieger, और Peter Welinder ने की थी, जिनका मिशन है “कृत्रिम बुद्धिमत्ता के साथ अनुरूप सर्वोत्तम उत्पाद बनाना।”
Labelbox प्लेटफ़ॉर्म एक सहज इंटरफ़ेस प्रदान करता है जहाँ टीमें डेटा को एनोटेट करने, प्रगति को ट्रैक करने और उच्च एनोटेशन मानकों को बनाए रखने के लिए सहयोग कर सकती हैं। यह विभिन्न डेटा प्रकारों (जैसे, इमेज, वीडियो और टेक्स्ट) का समर्थन भी करता है, जो अलग-अलग मशीन लर्निंग प्रोजेक्ट्स के लिए प्लेटफ़ॉर्म को अत्यंत बहुमुखी बनाता है।
इसकी प्रमुख विशेषताओं में बिल्ट-इन गुणवत्ता नियंत्रण मैकेनिज्म शामिल हैं, जो टीमों को एनोटेशन की समीक्षा और अनुमोदन करने में सक्षम बनाते हैं—इससे निरंतर और सटीक परिणाम सुनिश्चित होते हैं।
Labelbox उन संगठनों के लिए आदर्श है जो एकीकृत प्रोजेक्ट मैनेजमेंट और ऑटोमेशन सुविधाओं के साथ अपने एनोटेशन प्रयासों को स्केल करना चाहते हैं।
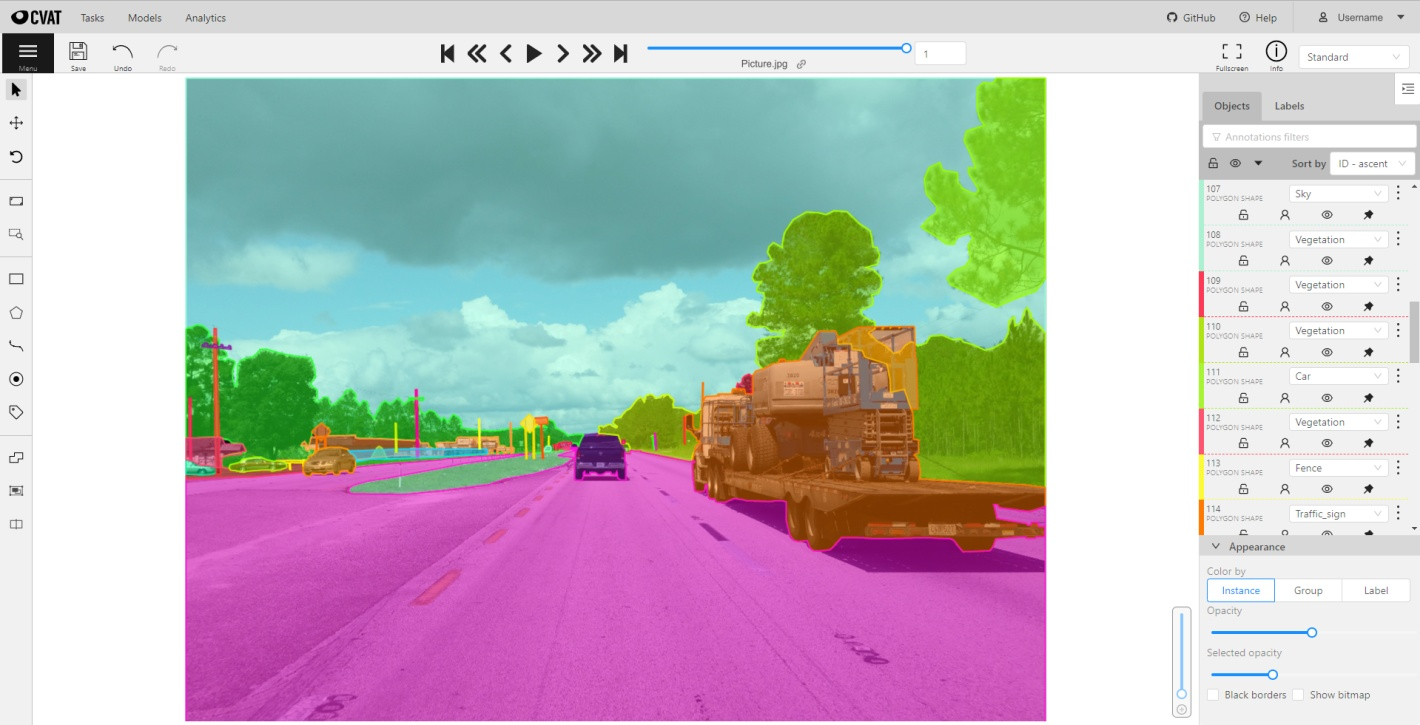
सोर्स: CVAT Wikipedia page
CVAT एक ओपन-सोर्स टूल है, जिसे विशेष रूप से इमेज और वीडियो डेटासेट्स को एनोटेट करने के लिए डिज़ाइन किया गया है। Intel द्वारा विकसित, CVAT अत्यधिक कस्टमाइजेबल है और एनोटेशन की व्यापक तकनीकें (जैसे, बाउंडिंग बॉक्स, पॉलीगॉन्स और कीपॉइंट एनोटेशन) प्रदान करता है। इसकी लचीलापन इसे ऑब्जेक्ट डिटेक्शन से लेकर फेस रिकग्निशन तक के प्रोजेक्ट्स के लिए उपयुक्त बनाता है।
क्योंकि यह ओपन-सोर्स है, CVAT उपयोग के लिए मुफ़्त है और विशिष्ट प्रोजेक्ट आवश्यकताओं को पूरा करने के लिए अनुकूलित किया जा सकता है। इससे यह शोधकर्ताओं और छोटी टीमों के बीच लोकप्रिय विकल्प है जिन्हें कमर्शियल सॉफ़्टवेयर की लागत के बिना शक्तिशाली एनोटेशन टूल्स चाहिए।
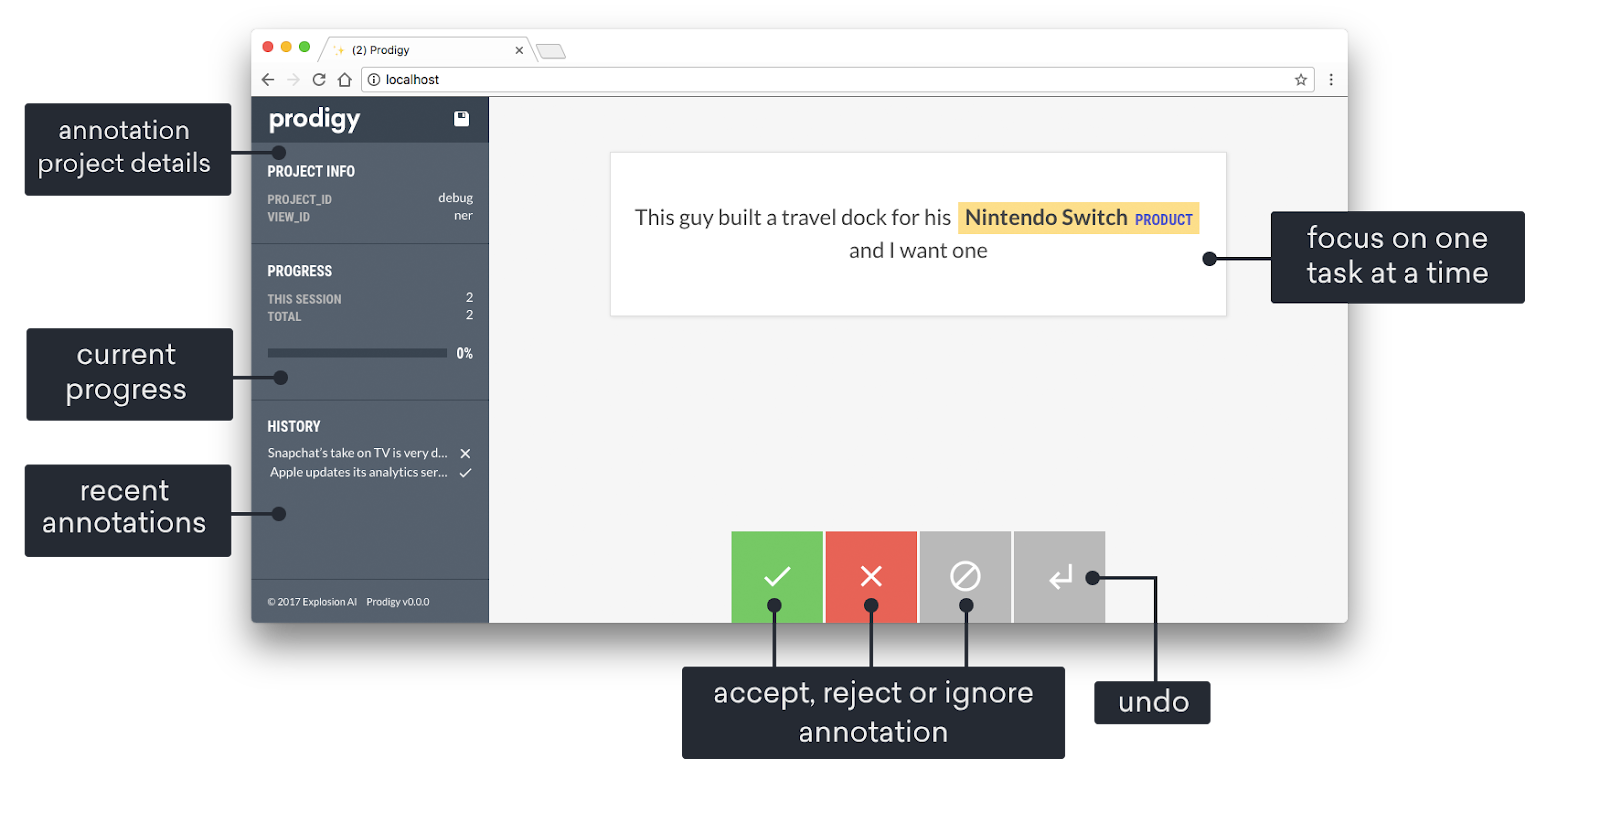
सोर्स: Prodigy Docs
Prodigy एक उन्नत एनोटेशन टूल है जिसे Explosion AI ने विकसित किया है और जो विशेष रूप से नेचुरल लैंग्वेज प्रोसेसिंग (NLP) कार्यों में दक्षता बढ़ाने के लिए एक्टिव लर्निंग का उपयोग करता है। Prodigy में, एक मशीन लर्निंग मॉडल अपनी भविष्यवाणियों के आधार पर लेबल सुझाकर एनोटेटरों की मदद करता है, जिन्हें बाद में मानव समीक्षक पुष्टि या सुधारते हैं।
यह इंटरएक्टिव दृष्टिकोण एनोटेशन प्रक्रिया को तेज़ करने के साथ-साथ यह सुनिश्चित करता है कि लेबल्ड डेटा उच्च गुणवत्ता का हो। कमर्शियल टूल होने के बावजूद, Prodigy अत्यधिक कस्टमाइजेबल है; उदाहरण के लिए, यह उपयोगकर्ताओं को अपने स्वयं के एनोटेशन वर्कफ़्लो बनाने की अनुमति देता है। ये कारक Prodigy को सेंटिमेंट एनालिसिस, एंटिटी रिकग्निशन या टेक्स्ट क्लासिफिकेशन जैसे विशिष्ट NLP प्रोजेक्ट्स पर काम करने वाली टीमों के लिए अत्यधिक उपयुक्त बनाते हैं।
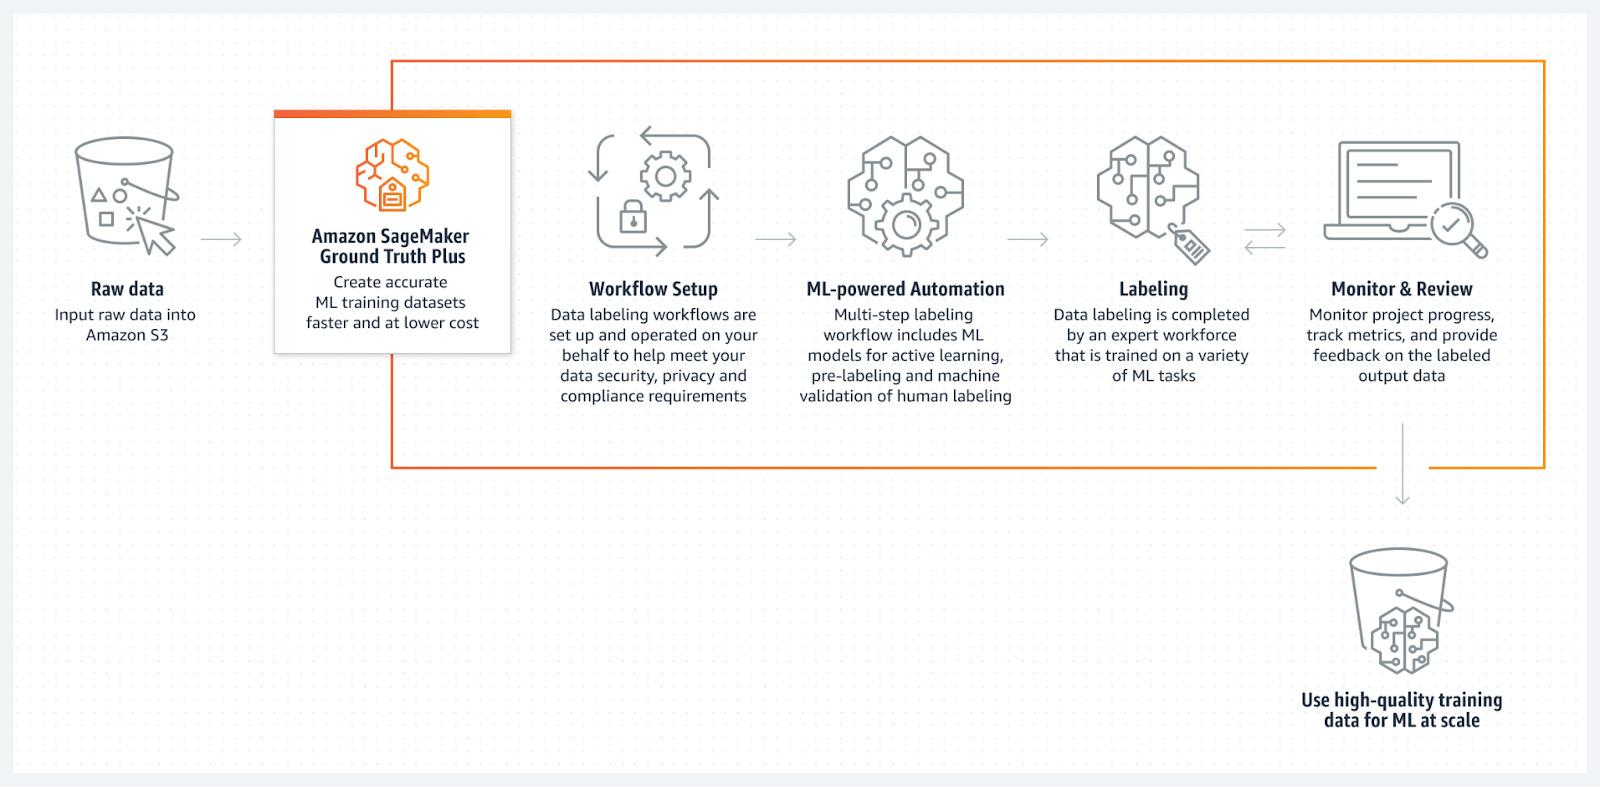
स्रोत: Amazon SageMaker Ground Truth
अमैज़न SageMaker Ground Truth एक पूर्णतः प्रबंधित डेटा लेबलिंग सेवा है जो AWS के साथ सहजता से इंटीग्रेट होती है। यह मैनुअल और स्वचालित डेटा एनोटेशन के लिए टूल्स प्रदान करती है जो उपयोगकर्ताओं को डेटा को तेज़ी और सटीकता से लेबल करने में सक्षम बनाती है।
SageMaker Ground Truth मानव एनोटेटरों की मदद के लिए मशीन लर्निंग का उपयोग करता है और डेटा को पहले से लेबल करता है, जिससे प्रक्रिया तेज़ होती है और लागत कम होती है। यह सेवा विभिन्न मशीन लर्निंग कार्यों के लिए अत्यंत बहुमुखी विकल्प है क्योंकि यह इमेज, टेक्स्ट और वीडियो सहित कई डेटा प्रकारों का समर्थन करती है।
इसके अतिरिक्त, यह स्केल के लिए बनाई गई है, जिसका अर्थ है कि AWS इकोसिस्टम के भीतर बड़े पैमाने पर एनोटेशन क्षमताएँ चाहने वाले एंटरप्राइज़ के लिए यह एक मज़बूत विकल्प है।
प्रभावी डेटा एनोटेशन मशीन लर्निंग मॉडलों की सफलता के लिए महत्वपूर्ण है, क्योंकि लेबल्ड डेटा की गुणवत्ता सीधे भविष्यवाणियों और वर्गीकरणों की सटीकता को प्रभावित करती है। श्रेष्ठ प्रथाओं का पालन करने से यह सुनिश्चित करने में मदद मिलती है कि एनोटेशन प्रक्रिया कुशल और विश्वसनीय हो।
इस अनुभाग में, हम आवश्यक प्रथाओं की पड़ताल करेंगे जो डेटा एनोटेशन की गुणवत्ता और स्थिरता को बढ़ा सकती हैं, साथ ही लेबलिंग प्रक्रिया में आने वाली चुनौतियों का समाधान भी कर सकती हैं।
डेटा एनोटेशन प्रक्रिया के सबसे महत्वपूर्ण चरणों में से एक स्पष्ट, सुव्यवस्थित दिशानिर्देश बनाना है। इन दिशानिर्देशों में यह स्पष्ट होना चाहिए कि डेटा को कैसे लेबल किया जाए और स्थिरता के लिए एनोटेटरों को किन मानदंडों का पालन करना चाहिए।
स्पष्ट दिशानिर्देश मदद करते हैं:
मानकीकृत नियमों का होना विशेष रूप से जटिल या व्यक्तिपरक डेटा, जैसे कई संभावित व्याख्याओं वाली छवियाँ या टेक्स्ट, के लिए महत्वपूर्ण है।
एनोटेटेड डेटा की सटीकता और विश्वसनीयता बनाए रखने के लिए गुणवत्ता आवश्यक है। अतः, एनोटेटेड डेटा की समय-समय पर समीक्षा की जानी चाहिए ताकि यह सुनिश्चित किया जा सके कि वह आवश्यक मानकों को पूरा करता है। यह प्रक्रिया प्रोजेक्ट के अनुसार रैंडम ऑडिट्स, समान कार्यों के लिए कई एनोटेटरों का उपयोग (परिणामों की तुलना हेतु) या क्रॉस-चेकिंग के माध्यम से संचालित की जा सकती है।
मूल बात यह है कि एक मज़बूत गुणवत्ता आश्वासन प्रक्रिया लागू करना महत्वपूर्ण है ताकि आप त्रुटियों को शुरुआती चरण में पकड़ सकें, अपने डेटा में पूर्वाग्रह को कम कर सकें और यह सुनिश्चित कर सकें कि लेबल्ड डेटा उच्च-प्रदर्शन वाले मशीन लर्निंग मॉडलों के प्रशिक्षण के लिए उपयुक्त है।
एक्टिव लर्निंग एक मशीन लर्निंग तकनीक है जो एल्गोरिद्म को लेबलिंग के लिए सबसे अधिक जानकारीपूर्ण डेटा सैंपल चुनने की अनुमति देती है, जिससे मॉडल का प्रदर्शन बेहतर होता है। यह तकनीक एनोटेशन प्रक्रिया की दक्षता को काफी बढ़ा सकती है। यह एनोटेटरों को अपना समय और ऊर्जा सबसे चुनौतीपूर्ण और मूल्यवान डेटा बिंदुओं पर केंद्रित करने देती है, जबकि मशीन लर्निंग एल्गोरिद्म बाकी के लिए सुझाव देता है।
यह दृष्टिकोण आसान या दोहराए जाने वाले सैंपल्स पर खर्च समय को कम करता है और समग्र एनोटेशन प्रक्रिया को तेज़ करता है। इस प्रकार, उस मशीन लर्निंग मॉडल के सबसे महत्वपूर्ण उदाहरणों पर प्रशिक्षित होने की संभावना बढ़ जाती है जिसका उपयोग भविष्यवाणियाँ करने के लिए किया जा रहा है।
यह सुनिश्चित करने के लिए कि एनोटेशन प्रक्रिया सटीकता से की जाए, एनोटेटरों को उचित प्रशिक्षण मिलना चाहिए। प्रशिक्षण एनोटेटरों को कार्य की विशिष्ट आवश्यकताओं और एनोटेशन दिशानिर्देशों को सही ढंग से लागू करने का तरीका समझने में मदद करता है।
अच्छे से प्रशिक्षित एनोटेटर उच्च-गुणवत्ता वाला लेबल्ड डेटा उत्पन्न करने की अधिक संभावना रखते हैं, जो अंततः उन मशीन लर्निंग मॉडलों के प्रदर्शन में सुधार करता है जिन्हें वे समर्थन दे रहे हैं। नियमित प्रशिक्षण सत्र और फीडबैक लूप्स समय के साथ एनोटेटर कौशल को परिष्कृत करने में भी मदद कर सकते हैं, जिससे डेटा एनोटेशन प्रक्रिया और बेहतर होती है।
हालाँकि सटीक मशीन लर्निंग मॉडलों के प्रशिक्षण के लिए डेटा एनोटेशन आवश्यक है, यह प्रक्रिया अपनी चुनौतियों के साथ आती है। इस अनुभाग में, हम डेटा एनोटेशन की कुछ सबसे आम चुनौतियों पर चर्चा करेंगे।
मैनुअल डेटा एनोटेशन अक्सर श्रम-सघन होता है। सभी उदाहरणों को एनोटेट करने में, विशेषकर जब डेटासेट बड़ा हो, पर्याप्त समय और वित्तीय संसाधनों की आवश्यकता होती है। डेटा जितना जटिल होगा (जैसे वीडियो या जटिल छवियाँ), एनोटेशन प्रक्रिया उतनी ही समय-साध्य हो जाएगी। कुशल एनोटेटरों को नियुक्त करना पड़ता है, जिससे लागत बढ़ती है।
इस चुनौती को दूर करने के लिए, संगठन अर्ध-स्वचालित एनोटेशन टूल्स का उपयोग कर सकते हैं, जहाँ मशीन लर्निंग मॉडल लेबल सुझाते हैं और मनुष्य उन्हें सत्यापित करते हैं। यह प्रक्रिया को तेज़ करता है बिना सटीकता से समझौता किए।
एक्टिव लर्निंग भी मदद कर सकती है, क्योंकि यह मानवीय प्रयास को सबसे अधिक जानकारीपूर्ण डेटा पर केंद्रित करती है, जिससे मैनुअल रूप से लेबल किए जाने वाले डेटा की कुल मात्रा कम हो जाती है। इसके अतिरिक्त, Amazon Mechanical Turk जैसे क्राउडसोर्सिंग प्लेटफ़ॉर्म का उपयोग एक साथ कई योगदानकर्ताओं को काम करने की अनुमति देता है, जिसका मतलब है कि बड़े पैमाने पर एनोटेशन अधिक किफायती और कुशल हो सकता है।
एक और प्रमुख चुनौती एनोटेशन प्रक्रिया में विषयपरकता और पक्षपात से निपटना है। अलग-अलग एनोटेटर एक ही डेटा की अलग-अलग तरह से व्याख्या कर सकते हैं। यह उन कार्यों में बेहद आम है जैसे टेक्स्ट में भावनाओं को लेबल करना या जटिल छवियों में ऑब्जेक्ट्स की पहचान करना। समस्या यह है कि विषयपरकता लेबल्ड डेटा में पक्षपात ला सकती है, जो बदले में मॉडल की पक्षपाती भविष्यवाणियों का कारण बन सकती है।
विषयपरकता और पक्षपात को कम करने के लिए, संगठनों को स्पष्ट, विस्तृत एनोटेशन दिशानिर्देश बनाने चाहिए जो सुनिश्चित करें कि सभी एनोटेटर एक ही मानदंड का पालन करें। एक और समाधान यह है कि एक ही डेटा के लिए कई एनोटेटरों का उपयोग किया जाए, जिससे क्रॉस-चेकिंग संभव हो सके और पक्षपाती या असंगत एनोटेशन की पहचान और सुधार हो सके।
ऐसी एनोटेशन जो किसी पहचान योग्य जानकारी का खुलासा करती हैं, वे व्यक्तिगत डेटा की सुरक्षा करने वाले गोपनीयता नियमों का उल्लंघन कर सकती हैं। यह चुनौती विशेष रूप से तब महत्वपूर्ण होती है जब एनोटेशन कार्यों को आउटसोर्स किया जाता है या क्राउडसोर्सिंग प्लेटफ़ॉर्म का उपयोग होता है, जहाँ कई योगदानकर्ताओं को डेटा तक पहुँच होती है।
अनामिकरण (व्यक्तिगत पहचान योग्य जानकारी को हटाना) और एनोटेशन के लिए सुरक्षित, एन्क्रिप्टेड प्लेटफ़ॉर्म का उपयोग जैसी समाधान इन जोखिमों को कम करने में मदद कर सकते हैं।
इस अनुभाग में, हम डेटा एनोटेशन के वास्तविक दुनिया के अनुप्रयोगों की पड़ताल करेंगे। आइए शुरू करें!
स्वायत्त वाहनों में, डेटा एनोटेशन AI को वास्तविक दुनिया में सुरक्षित रूप से नेविगेट करना सिखाने की नींव है। स्वचालित कारें एनोटेटेड डेटा पर निर्भर रहती हैं ताकि ऑब्जेक्ट्स की पहचान कर सकें।
उदाहरण के लिए, एनोटेटर कारों के चारों ओर बाउंडिंग बॉक्स बनाकर छवियों या वीडियो फ्रेम्स को लेबल करते हैं या लेन डिटेक्शन के लिए सड़क सीमाओं को चिह्नित करते हैं। ये एनोटेशन AI को विभिन्न सड़क परिदृश्यों को पहचानना और उन पर प्रतिक्रिया देना सिखाते हैं, जैसे पैदल यात्रियों के लिए रुकना या सही लेन में बने रहना।
AI मॉडलों को असामान्यताओं का पता लगाना सीखने के लिए लेबल्ड मेडिकल इमेज की आवश्यकता होती है। उदाहरण के लिए, कुशल एनोटेटर छवियों पर विशिष्ट क्षेत्रों की रूपरेखा बनाते हैं ताकि कैंसर के शुरुआती संकेत दिखाने वाले क्षेत्रों को चिह्नित किया जा सके। यह AI को पारंपरिक तरीकों की तुलना में कैंसर को अधिक जल्दी और सटीकता से पहचानने में सक्षम बनाता है, जिससे रोगियों के परिणाम बेहतर होते हैं और चिकित्सा पेशेवरों का कार्यभार कम होता है।
कस्टमर सर्विस चैटबॉट्स के लिए, टेक्स्ट एनोटेशन AI को मानव भाषा समझना सिखाने के लिए महत्वपूर्ण है।
उदाहरण के लिए, एनोटेटर टेक्स्ट को लेबल कर सकते हैं ताकि चैटबॉट्स यूज़र इंटेंट पहचान सकें। इसके बाद चैटबॉट्स लेबल्ड इंटरैक्शंस का विश्लेषण करते हैं ताकि उपयुक्त प्रतिक्रियाएँ देना सीख सकें। इससे संगठन तेज़ और अधिक सटीक सहायता प्रदान कर पाते हैं और ग्राहक अनुभव में सुधार होता है।
सेंटिमेंट एनालिसिस में, टेक्स्ट एनोटेशन का उपयोग यह आंकने के लिए किया जाता है कि ग्राहक कुछ चीज़ों (जैसे, ब्रांड, उत्पाद या घटनाएँ) के बारे में कैसा महसूस करते हैं। इसका तरीका यह है कि एनोटेटर वाक्यांशों या वाक्यों को सकारात्मक, नकारात्मक या तटस्थ के रूप में टैग करते हैं, और फिर यह डेटा AI को अंतर्निहित भावना सीखने के लिए दिया जाता है। इसके बाद कोई कंपनी नए उत्पाद लॉन्च को लेकर ग्राहकों की प्रतिक्रिया की निगरानी के लिए इसे लागू कर सकती है।
डेटा एनोटेशन डेटा को इस तरह लेबल करने की प्रक्रिया है कि वह मशीन लर्निंग मॉडलों के लिए पहचाने जाने योग्य और उपयोगी बन जाए। यह ऐसे AI सिस्टम विकसित करने का महत्वपूर्ण चरण है जो वास्तविक दुनिया के डेटा की सटीक व्याख्या और प्रतिक्रिया दे सकें। क्यों? क्योंकि एनोटेटेड डेटा की गुणवत्ता और सटीकता सीधे AI मॉडलों के प्रदर्शन और प्रभावशीलता को प्रभावित करती है।
आखिरकार, डेटा एनोटेशन बुद्धिमान, विश्वसनीय AI सिस्टम बनाने की नींव है जो विभिन्न उद्योगों में नवाचार को आगे बढ़ा सकते हैं। यह मशीन लर्निंग विकास का अनिवार्य हिस्सा बनाता है।
अपनी सीख को जारी रखने के लिए, निम्नलिखित संसाधन देखें:
इन कोर्सेज़ के साथ मशीन लर्निंग और AI के बारे में और जानें!
कोर्स
कोर्स
कोर्स