
如果您想进一步了解数据管理,请查看我在本系列中的其他文章:
什么是数据仓库?
数据仓库是一种专门的存储系统,用于收集和组织海量数据。它具有若干关键特性,定义了其目的和功能。
面向主题
在数据仓库中,数据围绕特定主题或业务领域进行组织(如销售、市场、库存)。这使得分析业务的特定方面更加容易。
集成性
来自不同来源的数据在数据仓库中被整合并转换为一致的格式。这种结构化集成确保了数据的统一性和可靠性,更便于分析和理解。
随时间变化
数据仓库存储历史数据。这意味着当新版本数据加入时,过去的版本不会被覆盖。这样的时间变体允许进行趋势分析和跨时间比较。数据仓库提供的历史视角对于理解长期趋势和模式至关重要。
非易失性
与实时数据系统不同,仓库中的数据通常不进行实时更新。相反,它以批处理的方式加载,以确保稳定性和一致性。一旦写入,数据不会被更改。这种非易失性有助于确保业务交易记录的可靠与一致。
数据仓库聚焦业务的特定领域,将不同来源的数据整合为一致格式,保留历史记录以跟踪随时间的变化,并以稳定的方式存储数据,一经写入就不再改变。
数据仓库 vs. 数据湖
数据仓库和数据湖都是现代数据架构中的组成部分,角色相辅相成。两者都旨在管理和分析海量数据,但采取的方式不同。
|
特性 |
数据仓库 |
数据湖 |
|
数据结构 |
结构化 |
非结构化、半结构化和结构化 |
|
模式 |
预定义模式 |
读时定义模式(在处理过程中定义) |
|
数据处理 |
ETL(抽取、转换、加载)先于存储 |
以原始格式存储,按需处理 |
|
主要用例 |
商业智能、报告、历史分析 |
探索性分析、机器学习、高级分析 |
|
查询性能 |
针对快速查询进行了优化 |
取决于处理框架与数据组织 |
|
数据存储 |
对结构化数据优化 |
可容纳多样的数据类型与格式 |
|
灵活性 |
灵活性较低,存储前需进行数据转换 |
更灵活,允许模式演进 |
|
常见用法 |
用于明确定义的报告与分析需求 |
用于探索性分析与洞见发现 |
|
集成 |
常与数据湖配合,用作精选数据来源 |
常与数据仓库并行,用于原始数据的存储与处理 |
查看这篇 数据湖 vs 数据仓库 教程,了解更深入的比较。
数据仓库的架构
下图展示了来自多个来源的数据如何流入数据仓库的一个示例。
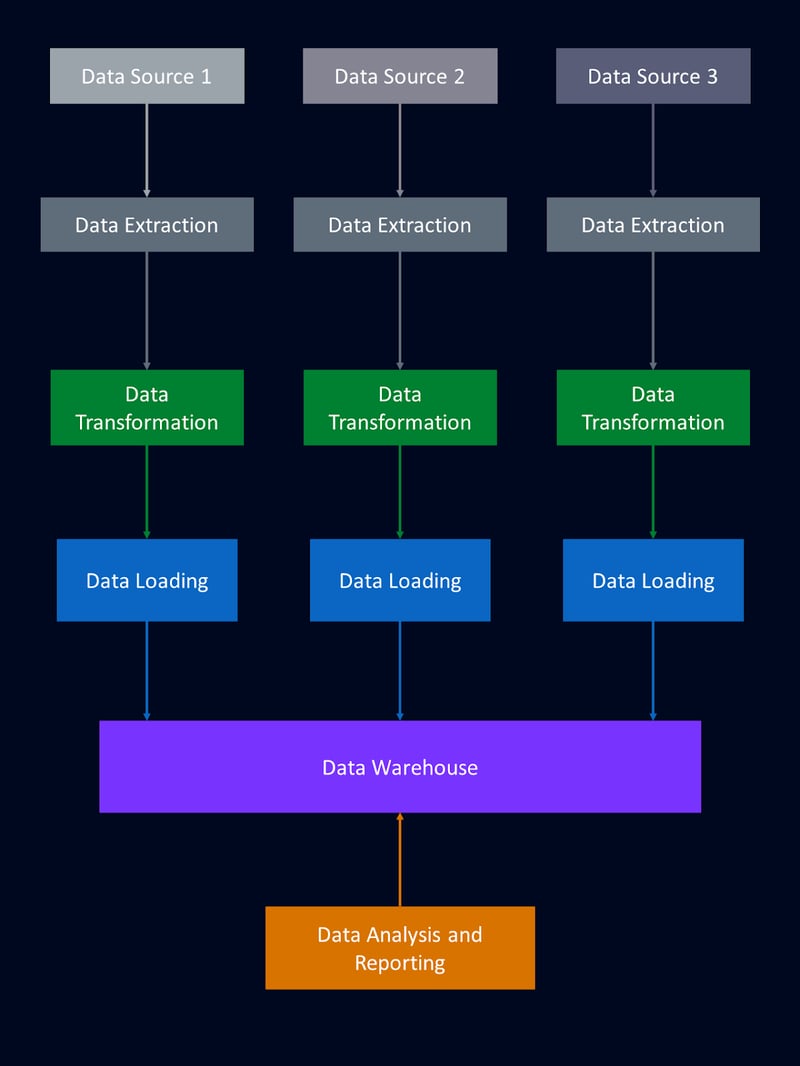
构建数据仓库涉及将来自不同来源的数据组织到集中式存储库中。让我们来探索数据仓库架构的组成部分,以及它们如何支持数据管理与分析中的关键功能。
暂存区
暂存区可被视为数据管道中原始数据的“落地”区域。它是一个中间存储位置,原始数据最初从各类源系统(如数据库、API、数据湖和文件)被抽取到这里。此类原始数据往往多样且非结构化,需在集成进数据仓库前进行初步处理。
在暂存区中,数据会经历初步清洗和校验,包括去重、处理缺失值、确保数据完整性。您可以在这篇 新手指南:数据清洗或Python 数据清洗课程中了解更多。数据也可能被转换为标准化格式,以便与数据仓库的模式无缝对接。
暂存区是一个缓冲层,它将抽取过程与加载进仓库的过程解耦。这种分离使数据流管理更具灵活性,并确保只有经过校验且格式正确的数据进入仓库。通过在暂存区进行准备,我们可以提升存入数据仓库的数据质量与可靠性。
ETL 流程
数据进入暂存区后,会经历常见的抽取、转换与加载(ETL)步骤。ETL 流程是数据管理的重要组成部分。我们简要概述这三个阶段:
- 抽取: 从数据库、文件或 API 等多种来源收集原始数据,并放入暂存区。
- 转换: 核心所在。对数据进行清洗(去除错误与不一致)、集成(汇聚不同来源),并转换为适于分析的格式,确保数据准确并与数据仓库兼容。
- 加载: 将已转换的数据从暂存区传送至数据仓库,使其可用于分析与报告。
ETL 过程是数据管理的基础,确保将原始数据转化为组织可用的宝贵资产。
数据存储
数据仓库的存储层决定数据如何被存放、管理与访问。现代数据仓库通常结合多种存储方案,以发挥不同技术的优势。我们来看看几种常见的存储方案:关系型数据库、列式数据库以及基于云的存储。
关系型数据库
关系型数据库传统上是数据仓库数据存储的骨干。这类数据库采用遵循关系模型的表,并在表之间预定义关系。结构化数据以行和列的形式存放,易于理解与操作。常用SQL(结构化查询语言)来管理和查询关系型数据库中的数据。
关系型数据库在处理结构化的事务型数据(如金融系统、客户关系管理系统)方面表现出色。然而,当数据量极其庞大时,性能可能面临挑战。横向扩展(增加服务器)也可能复杂且昂贵。因此,尽管关系型数据库适用于许多场景,但通常会辅以针对不同需求优化的其他存储类型。
列式数据库
列式数据库是一种更为专业的存储类型,专为读密集型操作和分析查询而设计。它不是按行存储数据,而是按列存储,因此得名。这种方式使得大数据集的检索与处理更高效,尤其适用于数据仓库和商业智能应用。
列式数据库的一大优势是能为分析型工作负载优化存储与查询性能。通过将每个列单独存储,数据库可以快速访问所需数据点,而无需扫描整行,从而显著加速查询。同时,列式数据库通常具备更好的数据压缩能力,降低存储成本。
尽管在分析查询方面优势明显,但列式数据库在涉及频繁写入与更新的事务型负载上效率较低。一般将其用于需要对大数据集进行快速汇总与聚合的场景,而不太适合频繁更新与插入的系统。
基于云的存储
由于可扩展性、灵活性和成本效益,云存储已日益成为数据仓库的热门选择。云存储由诸如Amazon Web Services(AWS)、Google Cloud Platform(GCP)和Microsoft Azure等服务提供,支持多种数据存储与处理工具。
云存储的主要优势之一是可扩展性。组织可以根据需求轻松向上或向下扩展存储规模,而无需在硬件上进行大量前期投入。这种灵活性特别适合处理大规模且波动性强的数据量。云存储还提供高可用与灾难恢复能力,确保即便硬件故障,数据依然可访问且安全。
云平台常同时集成关系型与列式数据库,使我们能够兼具两者优势。这种混合方式支持多样的数据类型与工作负载,优化性能与成本。
不过,数据安全与隐私可能成为顾虑,因为敏感数据存放在异地。根据数据与云服务器的距离,也可能出现延迟问题。此外,还需关注长期成本及供应商锁定的潜在风险。
数据仓库的存储层可综合运用关系型数据库、列式数据库和云存储,以满足现代数据管理与分析的多样化需求。
数据集市
数据集市是数据仓库的更小且聚焦的子集,面向特定部门或业务职能。本质上,它是数据仓库的一个分区,旨在满足组织内某一特定用户群的需求。
与整合全组织数据的企业级数据仓库不同,数据集市聚焦单一主题领域或业务职能。通过提供更聚焦的数据视角,数据集市使各部门能够针对其特定需求进行更有针对性的分析。
当特定部门需要快速访问相关数据以支持决策时,数据集市尤为有用。它们在不引入全面数据仓库的复杂性和成本的情况下,提供定制化的数据方案。数据集市也适用于以增量方式构建数据仓库解决方案,从较小且聚焦的集市起步。
然而,数据集市并非适用于所有情形。它们可能遇到集成问题,需要健全的 ETL 流程和数据治理以确保与中心数据仓库保持一致。随着数据量增长,维持性能与可扩展性也具有挑战。数据集市在扩展时需要周密规划与资源投入。
如果您发现自己使用了大量数据集市,或许可以考虑转向数据网格(data mesh)策略。
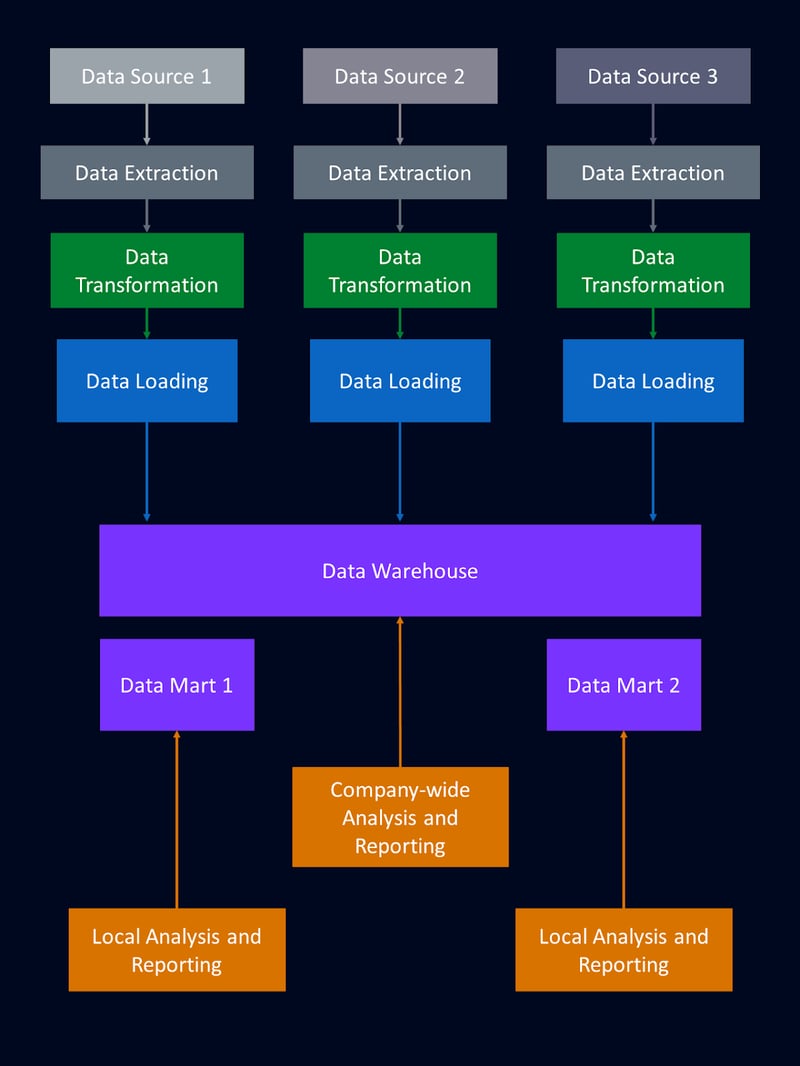
上图展示了如何将数据仓库的子部分设置为独立的数据集市。
报告与分析工具
为了访问和分析仓库中的数据,我们会使用多种为数据检索、操作与可视化而设计的工具。
SQL 客户端
SQL 客户端是允许我们连接到数据库的软件应用。它帮助我们编写并执行 SQL 查询以检索和操作数据,可用于查询、更新记录和创建表等任务。您或许熟悉一些常见的 SQL 客户端,如 MySQL Workbench和 pgAdmin。如果您对管理服务器系统感兴趣, SQL Server 入门是个不错的起点!或者查看 SQL Server 开发者学习路径。
BI 平台
商业智能平台提供用于数据分析、报告与可视化的一整套工具,帮助我们创建详尽报告并从数据中获得洞见。诸如 Tableau、 Power BI和 Looker等可视化工具尤为流行,它们让创建交互式仪表板和可视化变得轻松。想了解常见 BI 工具,请查看 Tableau 基础或 Power BI 基础。
这类分析工具使我们能够充分释放仓库中数据的潜力。
使用数据仓库的优势
数据仓库具备多项优势,可提升组织的数据管理能力。
数据集中
数据仓库带来集中化的数据管理,为报告与分析提供单一事实来源。这种集中化确保了组织内数据的一致性与可靠性,消除了数据分散在多个来源时可能出现的不一致。
历史语境
另一项重要优势是能够进行历史分析。数据仓库存储历史数据,使我们可以开展趋势分析和历史对比。这有助于洞察长期趋势与模式,对于规划或预测未来趋势十分重要。
提升数据质量
包括数据仓库在内的任何集中式数据管理系统都能提升数据质量。数据经过标准化和清洗,以确保准确与一致。因此,基于这些数据进行的分析与报告也更为可靠。
更快的查询性能
数据仓库针对复杂的分析型查询进行了优化。这种优化带来更快、更高效的数据检索,特别适用于我们依赖及时洞见来驱动业务决策的情形。
商业智能集成
BI 工具利用仓库中的集中数据提供可操作的洞见。大多数常见 BI 工具都能很好地对接数据仓库的数据。
数据挖掘与机器学习
数据仓库为包括数据挖掘与机器学习在内的高级分析提供了丰富的数据来源。仓库中数据的结构化特性便于开发复杂的预测模型,而这些模型又能帮助我们预判趋势、识别机遇并降低风险。
何时考虑使用数据仓库
虽然数据仓库并非所有场景的理想之选,但在某些情况下,我们应当认真评估它是否符合需求。下面介绍几种应考虑使用数据仓库的情形。
如果我们的组织难以管理分散在各类系统与应用中的数据,可以考虑使用数据仓库等集中式数据管理系统。数据仓库能够整合多元的数据版图,简化全面分析。
当需要进行历史分析,或需要理解随时间变化的趋势与模式时,数据仓库可能提供所需的历史语境。
如果我们的业务系统在运行复杂查询时效率不佳,构建更为结构化的数据系统可能提升效率。在这种情况下,可以考虑使用数据仓库,它能优化性能,支持更快的数据访问。
在许多场景下,数据仓库都可以作为稳健数据管理方案的一部分。而一套良好的数据管理方案是让数据为我们所用的必要基础。
结语
数据仓库是释放数据全部潜力的强大工具。它为我们的数据提供集中、集成且结构化的存储库。
在 DataCamp 的 数据仓库概念课程中了解更多。我还推荐阅读 什么是数据联邦与 什么是数据织布,作为该主题的延伸阅读。

我拥有博士学位,在生物研究环境中从事数据相关工作已有13年。我使用包括 Python、MATLAB 和 R 在内的多种编程语言开发软件。我热衷于与世界分享我对学习的热爱。
各行各业对数据的需求都在不断增加。单个组织可能会从多个来源收集海量数据,这些来源可能包括交易系统、社交媒体、物联网设备等。
不幸的是,来自不同来源的数据往往分散、缺乏一致性,难以统一分析。这种碎片化使得提炼有意义的洞见并做出数据驱动的决策变得具有挑战性。
我们可以使用数据仓库来解决这些问题。数据仓库通过提供一个集中式存储库,将来自多个来源的数据整合并组织成结构化格式。
这种结构化格式经过优化,以便用于报告、分析和决策。数据仓库将分散的数据转化为有价值的资产。
借助数据仓库,我们能够从整合自分散来源的数据中获得全面洞见。它支持高效分析,确保数据一致且可靠。最终,数据仓库使我们能够将数据转化为可执行的洞见。