
Pour aller plus loin sur la gestion des données, consultez mes autres articles de cette série :
- Qu’est-ce qu’un data fabric ?
- Qu’est-ce que la data lineage ?
- Qu’est-ce que la fédération de données ?
- Qu’est-ce qu’un data mesh ?
Qu’est-ce qu’un data warehouse ?
Un data warehouse est un système de stockage spécialisé, conçu pour collecter et organiser de grands volumes de données. Il présente plusieurs caractéristiques clés qui définissent sa finalité et son fonctionnement.
Orienté sujet
Dans un data warehouse, les données sont organisées autour de sujets ou domaines métiers spécifiques (par exemple : ventes, marketing, stocks). Cela facilite l’analyse d’aspects précis de l’activité.
Intégré
Les données issues de sources diverses sont combinées et transformées dans un format cohérent. Cette intégration structurée assure l’uniformité et la fiabilité des données, ce qui simplifie leur analyse et leur compréhension.
Historisé
Les données sont stockées de manière historique. Autrement dit, les versions passées ne sont pas écrasées lorsque de nouvelles arrivent. Cette dimension temporelle permet l’analyse de tendances et les comparaisons dans le temps. La perspective historique fournie est essentielle pour comprendre les évolutions et motifs de long terme.
Non volatil
Contrairement aux systèmes en temps réel, les données d’un data warehouse ne sont généralement pas mises à jour en continu. Elles sont chargées par lots pour plus de stabilité et de cohérence. Une fois enregistrées, elles ne sont pas modifiées. Cette non‑volatilité garantit une trace fidèle et constante des transactions et activités.
En résumé, un data warehouse se concentre sur des domaines métiers précis, combine des données de différentes sources dans un format homogène, conserve l’historique pour suivre les évolutions et stocke les données de façon stable une fois ajoutées.
Data warehouse vs. data lake
Les data warehouses et les data lakes font tous deux partie des architectures de données modernes, avec des rôles complémentaires. Ils sont conçus pour gérer et analyser de grands volumes de données, mais selon des approches différentes.
|
Caractéristique |
Data warehouse |
Data lake |
|
Structure des données |
Structurées |
Non structurées, semi‑structurées et structurées |
|
Schéma |
Schéma prédéfini |
Schema‑on‑read (schéma défini au moment du traitement) |
|
Traitement des données |
ETL (Extract, Transform, Load) avant stockage |
Données stockées brutes, traitées à la demande |
|
Cas d’usage principaux |
Business intelligence, reporting, analyses historiques |
Analytique exploratoire, apprentissage automatique, analyses avancées |
|
Performance des requêtes |
Optimisé pour des requêtes rapides |
Variable selon le framework de traitement et l’organisation des données |
|
Stockage des données |
Optimisé pour les données structurées |
Accueille des types et formats de données variés |
|
Flexibilité |
Moins flexible, transformation requise avant stockage |
Plus flexible, permet de faire évoluer le schéma |
|
Usage courant |
Besoins de reporting et d’analyse bien définis |
Analyse exploratoire et découverte d’insights |
|
Intégration |
Souvent utilisé avec des data lakes comme source de données curées |
Souvent utilisé aux côtés des data warehouses pour le stockage et le traitement des données brutes |
Consultez ce tutoriel Data lakes vs data warehouses pour une comparaison plus détaillée.
Architecture d’un data warehouse
Le schéma ci‑dessous illustre comment des données issues de multiples sources peuvent alimenter un data warehouse.
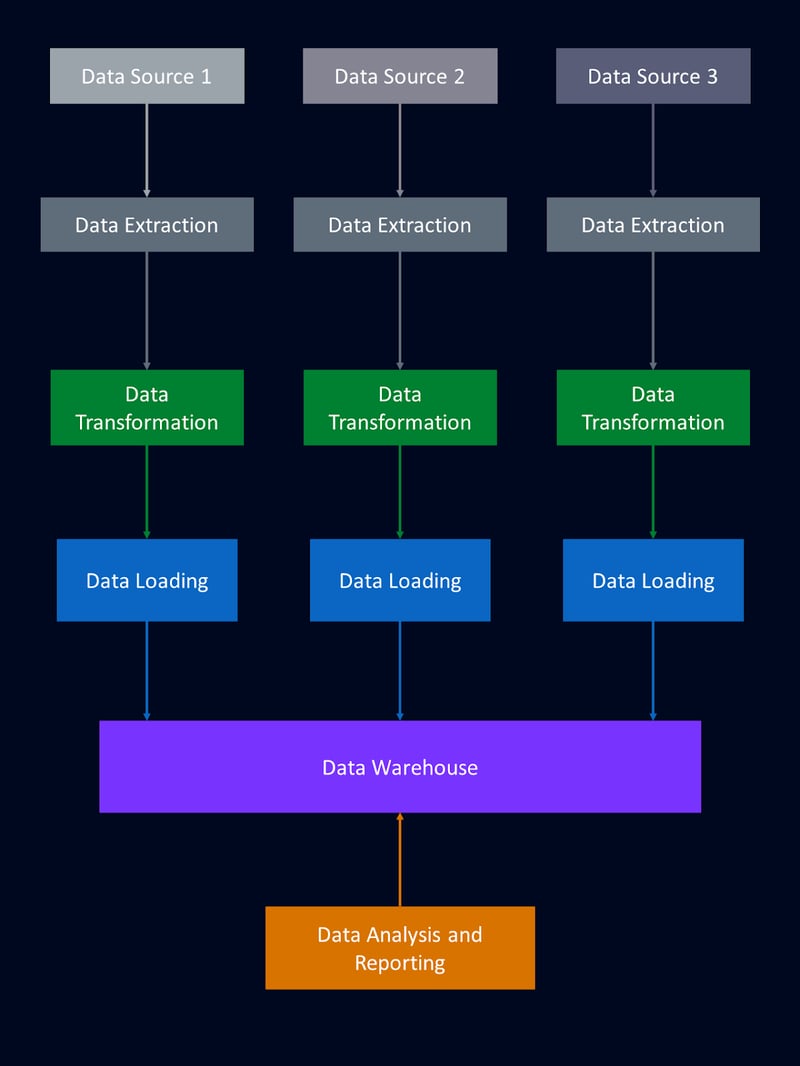
La mise en place d’un data warehouse consiste à structurer des données issues de diverses sources dans un référentiel centralisé. Voyons les composants qui constituent l’architecture d’un data warehouse et comment ils soutiennent des fonctions clés en gestion des données et en analytique.
Zone de staging
La zone de staging est l’aire d’atterrissage des données brutes dans le pipeline. C’est un espace de stockage intermédiaire où les données sont d’abord extraites de différentes sources : bases de données, API, data lakes, fichiers, etc. Ces données brutes sont souvent diverses et non structurées, et nécessitent un premier traitement avant d’être intégrées au data warehouse.
Dans cette zone, les données subissent un nettoyage et une validation préliminaires : suppression des doublons, gestion des valeurs manquantes, vérification de l’intégrité. Pour en savoir plus sur le nettoyage des données, consultez ce guide du débutant sur le data cleaning ou ce cours Data cleaning in Python. Les données peuvent aussi être transformées dans un format standardisé pour faciliter leur intégration avec le schéma du data warehouse.
La zone de staging joue le rôle de tampon et sépare l’extraction du chargement dans l’entrepôt. Cette séparation apporte de la flexibilité dans la gestion des flux et garantit que seules des données validées et correctement formatées entrent dans l’entrepôt. En préparant les données dans cette zone, nous améliorons la qualité et la fiabilité des informations stockées dans le data warehouse.
Processus ETL
Une fois en staging, les données passent par les étapes classiques d’Extraction, Transformation et Chargement (ETL). L’ETL est un pilier de la gestion des données. Voici un bref aperçu des trois phases :
- Extraction : les données brutes sont collectées depuis diverses sources (bases, fichiers, API) et placées en staging.
- Transformation : c’est ici que tout se joue : nettoyage (correction d’erreurs et d’incohérences), intégration (fusion de sources), et mise en forme pour l’analyse. L’objectif est d’assurer l’exactitude et la compatibilité avec le data warehouse.
- Chargement : les données transformées sont transférées de la zone de staging vers le data warehouse, où elles deviennent accessibles pour l’analyse et le reporting.
Le processus ETL est essentiel : il convertit des données brutes en un actif exploitable et précieux pour l’organisation.
Stockage des données
La couche de stockage d’un data warehouse détermine comment les données sont stockées, gérées et consultées. Les entrepôts modernes combinent souvent plusieurs solutions pour tirer parti de différentes technologies. Voici quelques options courantes : bases relationnelles, bases colonnes et stockage cloud.
Base de données relationnelle
Les bases de données relationnelles sont historiquement l’épine dorsale du stockage dans les data warehouses. Elles s’appuient sur des tables liées entre elles selon un modèle relationnel. Les données structurées y sont stockées en lignes et colonnes, ce qui les rend lisibles. SQL (Structured Query Language) est couramment utilisé pour administrer et interroger ces données.
Les bases relationnelles excellent avec des données transactionnelles structurées (finance, CRM). En revanche, elles peuvent rencontrer des limites de performance sur de très grands volumes, et le passage à l’échelle horizontal (ajout de serveurs) peut être complexe et coûteux. Elles sont donc souvent complétées par d’autres types de stockage optimisés pour d’autres besoins.
Base de données colonne
Les bases colonnes sont spécialisées pour les opérations majoritairement en lecture et les requêtes analytiques. Au lieu de stocker les données par lignes, elles les stockent par colonnes. Cela permet une récupération et un traitement plus efficaces de grands jeux de données. Elles sont particulièrement adaptées au data warehousing et à la business intelligence.
Leur atout principal : optimiser le stockage et les performances de requêtes analytiques. En stockant chaque colonne séparément, la base accède rapidement aux points de données requis sans balayer des lignes entières, ce qui accélère fortement les temps de requête. Elles offrent aussi souvent une meilleure compression, réduisant les coûts de stockage.
Malgré ces avantages pour l’analytique, elles sont moins efficaces pour des charges transactionnelles avec écritures et mises à jour fréquentes. On les privilégie donc pour des scénarios nécessitant des agrégations et des synthèses rapides sur de grands volumes, moins pour des systèmes très dynamiques.
Stockage cloud
Le stockage dans le cloud est devenu un choix de plus en plus populaire pour les data warehouses grâce à sa scalabilité, sa flexibilité et sa maîtrise des coûts. Des services tels qu’Amazon Web Services (AWS), Google Cloud Platform (GCP) et Microsoft Azure proposent un éventail d’outils pour le stockage et le traitement des données.
Le principal avantage du cloud est sa scalabilité : ajuster les capacités à la demande, sans investissements matériels lourds. Cette flexibilité est précieuse face à des volumes importants et fluctuants. Le cloud offre aussi une haute disponibilité et des capacités de reprise après sinistre, garantissant accessibilité et sécurité même en cas de défaillance matérielle.
Les plateformes cloud intègrent souvent bases relationnelles et bases colonnes, permettant de tirer parti du meilleur de chacune. Cette approche hybride prend en charge des types de données et des charges variés, pour optimiser performances et coûts.
Cependant, la sécurité des données et la protection de la vie privée peuvent susciter des inquiétudes, car les données sensibles sont hébergées hors site. La latence peut aussi varier selon la localisation par rapport aux serveurs. Enfin, il faut surveiller les coûts sur le long terme et le risque d’enfermement propriétaire.
La couche de stockage d’un data warehouse peut combiner bases relationnelles, bases colonnes et stockage cloud pour répondre aux besoins variés de la gestion et de l’analyse modernes des données.
Data marts
Les data marts sont des sous‑ensembles ciblés du data warehouse, adaptés à un service ou une fonction métier spécifique. Il s’agit en pratique d’un segment de l’entrepôt, conçu pour répondre aux besoins d’un groupe d’utilisateurs au sein de l’organisation.
Contrairement à l’entrepôt d’entreprise qui consolide les données de toute l’organisation, un data mart se concentre sur un seul domaine. Cette vue focalisée permet des analyses plus ciblées et pertinentes pour chaque équipe.
Les data marts sont particulièrement utiles quand des services ont besoin d’un accès rapide à des données pertinentes pour décider. Ils apportent une solution sur‑mesure sans la complexité ni le coût d’un entrepôt à l’échelle de l’entreprise. Ils permettent aussi une mise en place incrémentale du data warehousing, en commençant petit et ciblé.
Mais ils ne conviennent pas à toutes les situations : des enjeux d’intégration peuvent apparaître, nécessitant des processus ETL et une gouvernance des données solides pour rester alignés avec l’entrepôt central. Le maintien des performances et de la scalabilité à mesure que les volumes grossissent peut aussi devenir difficile. Les data marts demandent donc une planification et des ressources adaptées, surtout en phase de montée en charge.
Si vous multipliez les data marts, il peut être pertinent d’envisager une approche data mesh.
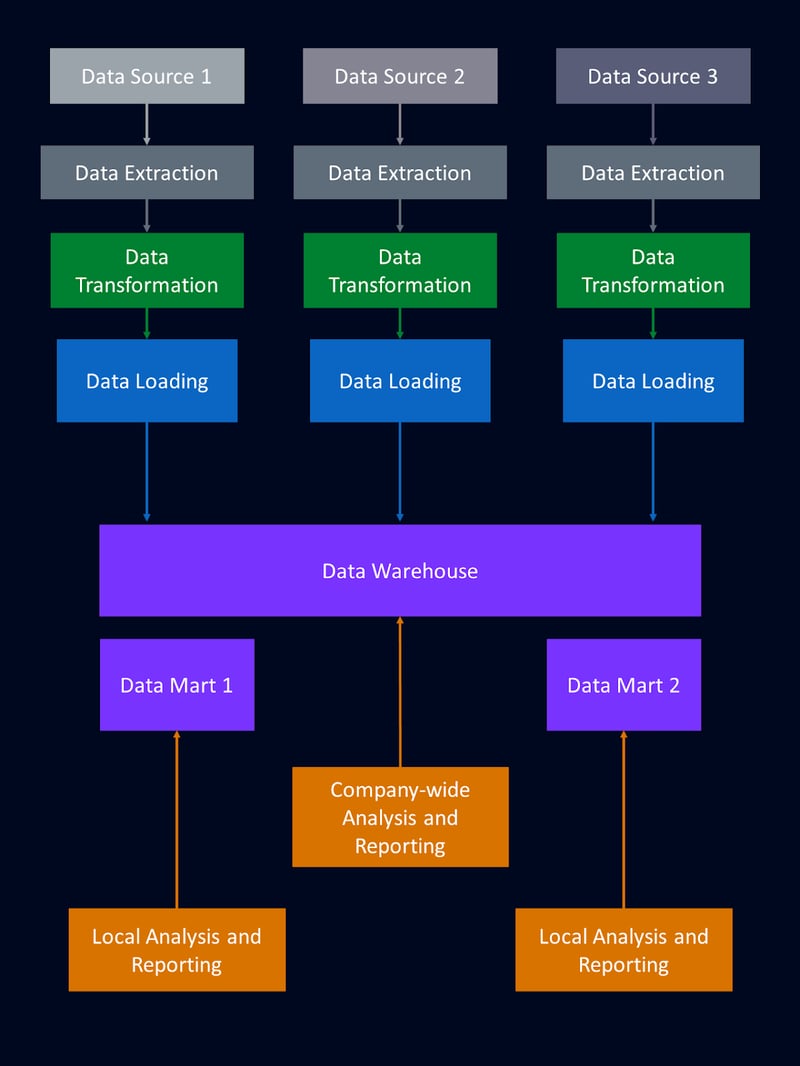
Le schéma ci‑dessus illustre comment des sous‑sections du data warehouse peuvent être configurées en data marts indépendants.
Outils de reporting et d’analyse
Pour accéder aux données de l’entrepôt et les analyser, nous utilisons divers outils de requête, de manipulation et de visualisation.
Clients SQL
Un client SQL est une application qui permet de se connecter à une base de données, d’écrire et d’exécuter des requêtes SQL pour interroger et manipuler les données. Vous connaissez peut‑être des clients populaires comme MySQL Workbench et pgAdmin. Si la gestion des serveurs vous intéresse, Introduction to SQL Servers est un excellent point de départ ! Vous pouvez aussi explorer le SQL Server Developer Track.
Plateformes de BI
Les plateformes de Business Intelligence offrent une suite complète pour l’analyse, le reporting et la visualisation. Elles permettent de créer des rapports détaillés et d’extraire des insights des données. Des outils de visualisation comme Tableau, Power BI et Looker sont particulièrement populaires. Ils facilitent la création de tableaux de bord et de visualisations interactives. Pour découvrir ces outils, voyez Tableau Fundamentals ou Power BI Fundamentals.
Ces outils d’analyse nous permettent d’exploiter tout le potentiel des données stockées dans l’entrepôt.
Avantages d’un data warehouse
Un data warehouse apporte des bénéfices qui renforcent les capacités de gestion des données d’une organisation.
Données centralisées
Il offre une gestion centralisée des données : une source de vérité unique pour le reporting et l’analyse. Cette centralisation assure cohérence et fiabilité, en éliminant les divergences liées à la dispersion des sources.
Contexte historique
Autre avantage majeur : la possibilité d’analyser l’historique. Le data warehouse conserve les données dans le temps, ce qui permet d’étudier les tendances et d’effectuer des comparaisons historiques. Ces informations éclairent les décisions de planification et de prévision.
Qualité de données améliorée
La standardisation et le nettoyage des données garantissent exactitude et cohérence. Les analyses et rapports produits sont donc plus fiables.
Requêtes plus rapides
Les data warehouses sont optimisés pour des requêtes analytiques complexes, offrant des temps de réponse plus courts — un atout clé lorsque des insights rapides guident les décisions.
Intégration BI
Les outils de BI exploitent la donnée centralisée de l’entrepôt pour délivrer des insights actionnables. La plupart des solutions du marché se connectent très bien à un data warehouse.
Data mining et ML
Un data warehouse constitue une base riche pour l’analytique avancée, dont le data mining et l’apprentissage automatique. La structure des données y facilite le développement de modèles prédictifs sophistiqués pour anticiper les tendances, identifier des opportunités et réduire les risques.
Quand envisager un data warehouse
Un data warehouse n’est pas universel, mais certaines situations justifient clairement de l’envisager. Voici quelques cas typiques.
Si votre organisation peine à gérer des données dispersées entre divers systèmes et applications, un système centralisé comme un data warehouse peut consolider ce paysage hétérogène et faciliter des analyses globales.
Si vous avez besoin d’analyses historiques ou de comprendre des tendances et des motifs dans le temps, un data warehouse apporte le contexte nécessaire.
Si vos systèmes opérationnels peinent à exécuter efficacement des requêtes complexes, une architecture plus structurée peut améliorer l’efficacité : ici encore, un data warehouse optimise les performances et accélère l’accès aux données.
Dans bien des cas, un data warehouse s’intègre utilement à une stratégie de gestion des données robuste. Et une bonne stratégie est indispensable pour tirer pleinement parti de vos données.
Conclusion
Un data warehouse est un puissant levier pour exploiter tout le potentiel de vos données. Il fournit un référentiel centralisé, intégré et structuré.
Pour en savoir plus, consultez le cours Data Warehousing Concepts sur DataCamp. Je vous recommande également Qu’est-ce que la fédération de données et Qu’est-ce qu’un data fabric pour approfondir le sujet.

Je suis titulaire d'un doctorat et j'ai 13 ans d'expérience dans le traitement des données dans un environnement de recherche biologique. Je crée des logiciels dans plusieurs langages de programmation, notamment Python, MATLAB et R. Je suis passionné par le partage de mon amour de l'apprentissage avec le monde.





Dans tous les secteurs, les besoins en données ne cessent d’augmenter. Une même organisation peut collecter de très grands volumes de données depuis de multiples sources : systèmes transactionnels, réseaux sociaux, objets connectés (IoT), etc.
Malheureusement, ces données hétérogènes sont souvent dispersées, incohérentes et difficiles à analyser dans leur ensemble. Cette fragmentation complique l’extraction d’insights utiles et la prise de décisions basées sur les données.
Nous pouvons utiliser un data warehouse pour répondre à ces enjeux. Un data warehouse consolide et organise les données de sources multiples dans un format structuré en offrant un référentiel centralisé pour l’ensemble de ces données.
Ce format structuré est optimisé pour le reporting, l’analyse et l’aide à la décision. Les data warehouses transforment des données disparates en actifs à forte valeur.
Avec un data warehouse, nous obtenons une vision d’ensemble à partir de données consolidées auparavant éparses. Il permet des analyses efficaces en garantissant la cohérence et la fiabilité des données. En définitive, un data warehouse nous aide à convertir les données en insights actionnables.