
Last chance! 50% off DataCamp Premium
Sale ends in
Wil je meer leren over databeheer? Bekijk dan mijn andere artikelen in deze serie:
Een datawarehouse is een gespecialiseerd opslagsysteem dat is ontworpen om grote hoeveelheden data te verzamelen en te organiseren. Het heeft verschillende kernkenmerken die het doel en de functionaliteit definiëren.
In een datawarehouse wordt data georganiseerd rond specifieke onderwerpen of bedrijfsdomeinen (bijv. verkoop, marketing, voorraad). Dit maakt het eenvoudiger om specifieke aspecten van het bedrijf te analyseren.
Data uit uiteenlopende bronnen wordt in een datawarehouse samengevoegd en omgezet naar een consistent formaat. Deze gestructureerde integratie zorgt voor uniformiteit en betrouwbaarheid in de data, wat analyse en begrip vergemakkelijkt.
Data wordt historisch opgeslagen in een datawarehouse. Dat betekent dat oude versies van de data niet worden overschreven wanneer er nieuwe versies bijkomen. Deze tijdsvariatie maakt trendanalyses en vergelijkingen in de tijd mogelijk. Het historische perspectief dat datawarehouses bieden is belangrijk om langetermijntrends en -patronen te begrijpen.
In tegenstelling tot realtimedatasystemen wordt data in een warehouse doorgaans niet in realtime bijgewerkt. In plaats daarvan wordt het in batches geladen voor stabiliteit en consistentie. Eenmaal ingevoerd wordt de data niet meer gewijzigd. Deze niet-volatiliteit helpt om een betrouwbare en consistente registratie van zakelijke transacties te waarborgen.
Datawarehouses richten zich op specifieke bedrijfsgebieden, combineren data uit verschillende bronnen in een consistent formaat, houden historische gegevens bij om veranderingen door de tijd te volgen en slaan data op in een stabiele vorm die niet verandert zodra die is toegevoegd.
Datawarehouses en datalakes maken beide deel uit van moderne data-architectuur en vervullen complementaire rollen. Beide systemen zijn ontworpen om grote hoeveelheden data te beheren en te analyseren. Maar ze hanteren verschillende benaderingen.
|
Kenmerk |
Datawarehouse |
Datalake |
|
Datastructuur |
Gestructureerd |
Ongestructureerd, semi-gestructureerd en gestructureerd |
|
Schema |
Vooraf gedefinieerd schema |
Schema-on-read (schema bepaald tijdens verwerking) |
|
Dataverwerking |
ETL (Extract, Transform, Load) vóór opslag |
Data in ruwe vorm opgeslagen, verwerkt naar behoefte |
|
Primaire use-cases |
Business intelligence, rapportage, historische analyse |
Verkennende analyses, machine learning, geavanceerde analytics |
|
Queryprestaties |
Geoptimaliseerd voor snelle queries |
Verschilt per verwerkingsframework en data-organisatie |
|
Dataopslag |
Geoptimaliseerd voor gestructureerde data |
Ondersteunt diverse datatypes en -formaten |
|
Flexibiliteit |
Minder flexibel, vereist datatransformatie vóór opslag |
Flexibeler, staat schema-evolutie toe |
|
Gebruikelijk gebruik |
Gebruikt voor duidelijk omlijnde rapportage- en analysetaken |
Gebruikt voor verkennende analyse en het ontdekken van inzichten |
|
Integratie |
Vaak gebruikt met datalakes als bron van gecureerde data |
Vaak naast datawarehouses gebruikt voor ruwe dataopslag en -verwerking |
Bekijk deze tutorial over Data Lakes vs. Data Warehouses voor een meer diepgaande vergelijking.
Het onderstaande diagram is een voorbeeld van hoe data uit meerdere bronnen naar een datawarehouse kan stromen.
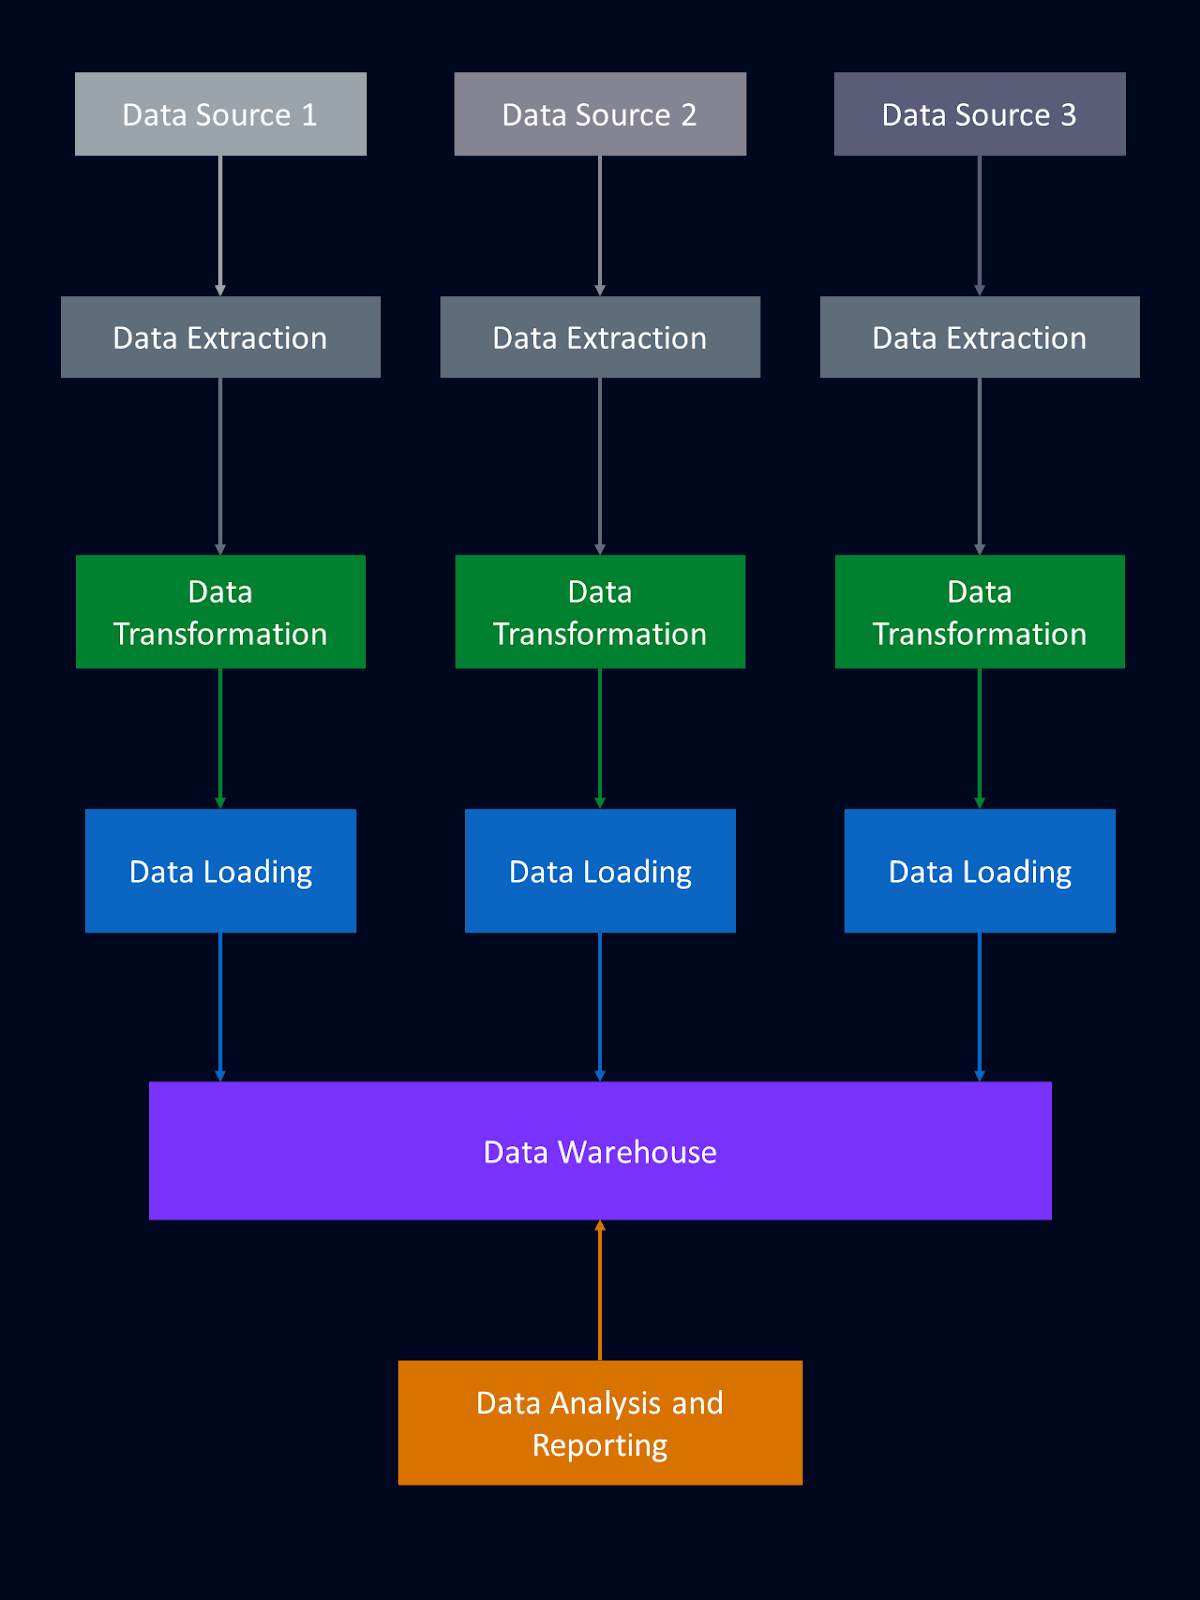
Het opzetten van een datawarehouse houdt in dat data uit diverse bronnen wordt gestructureerd in een centrale opslagplaats. Laten we de componenten verkennen die een datawarehouse-architectuur vormen en hoe ze cruciale functies in databeheer en analytics ondersteunen.
De staging area kun je zien als een landingszone voor ruwe data in de datapijplijn. Het is een tussentijdse opslaglocatie waar ruwe data aanvankelijk wordt geëxtraheerd uit verschillende bronsystemen zoals databases, API’s, datalakes en bestanden. Deze ruwe data is vaak divers en ongestructureerd en vereist eerste verwerking voordat we die in het datawarehouse kunnen integreren.
In de staging area ondergaat data voorlopige opschoning en validatie. Dit kan het verwijderen van duplicaten, het omgaan met missende waarden en het waarborgen van dataintegriteit omvatten. Je kunt meer lezen over datacleaning in deze Beginnersgids voor Data Cleaning-tutorial of in de cursus Data Cleaning in Python. De data kan ook worden omgezet naar een gestandaardiseerd formaat om naadloze integratie met het datawarehouseschema te faciliteren.
De staging area is een buffer die het extractieproces loskoppelt van het proces van het laden van data in het warehouse. Deze scheiding biedt flexibiliteit in het beheren van datastromen en zorgt ervoor dat alleen gevalideerde en correct geformatteerde data het warehouse binnenkomt. Door data in de staging area voor te bereiden, verbeteren we de kwaliteit en betrouwbaarheid van de data die in ons datawarehouse wordt opgeslagen.
Eenmaal in de staging area doorloopt data de gebruikelijke stappen van Extractie, Transformatie en Laden (ETL). Het ETL-proces is een belangrijk onderdeel van databeheer. Laten we deze drie fasen kort schetsen:
Het ETL-proces is een fundamenteel onderdeel van databeheer en zorgt ervoor dat ruwe data wordt omgezet in een bruikbare en waardevolle asset voor een organisatie.
De opslaglaag van een datawarehouse bepaalt hoe data wordt opgeslagen, beheerd en benaderd. Moderne datawarehouses gebruiken vaak een combinatie van opslagoplossingen om de sterke punten van verschillende technologieën te benutten. Laten we een paar gangbare opslagoplossingen voor datawarehouses verkennen: relationele databases, kolomgebaseerde databases en cloudopslag.
Relationele databases vormen traditioneel de ruggengraat van dataopslag in datawarehouses. Deze databases gebruiken tabellen met vooraf gedefinieerde relaties ertussen, volgens een relationeel model. Gestructureerde data wordt opgeslagen in rijen en kolommen, wat ze gemakkelijk interpreteerbaar maakt. SQL (Structured Query Language) wordt vaak gebruikt om data in relationele databases te beheren en te bevragen.
Relationele databases blinken uit in scenario’s met gestructureerde transactionele data, zoals financiële systemen en systemen voor klantrelatiebeheer. Ze kunnen echter prestatieproblemen krijgen bij zeer grote datavolumes. Horizontaal schalen (extra servers toevoegen) kan ook complex en kostbaar zijn. Daarom zijn relationele databases, hoewel geschikt voor veel toepassingen, vaak aangevuld met andere opslagtypen die voor andere behoeften geoptimaliseerd zijn.
Kolomgebaseerde databases zijn een meer gespecialiseerd type dataopslag, specifiek ontworpen voor leesintensieve operaties en analytische queries. In plaats van data in rijen op te slaan, bewaren kolomdatabases data per kolom, vandaar de naam. Dit maakt efficiëntere opvraging en verwerking van grote datasets mogelijk. Ze zijn bijzonder geschikt voor datawarehousing en business intelligence-toepassingen.
Een van de belangrijkste voordelen van kolomdatabases is dat ze opslag en queryprestaties voor analytische workloads optimaliseren. Doordat elke kolom apart wordt opgeslagen, kunnen deze databases snel de benodigde datapunten benaderen zonder complete rijen te scannen. Dit versnelt querytijden aanzienlijk. Bovendien bieden kolomdatabases vaak betere datacompressie, wat opslagkosten verlaagt.
Ondanks hun voordelen voor analytische queries kunnen kolomdatabases minder efficiënt zijn voor transactionele workloads met frequente writes en updates. We gebruiken ze doorgaans in scenario’s waarin snelle aggregatie en samenvatting van grote datasets nodig zijn. Ze zijn minder geschikt voor systemen met veelvuldige updates en inserties.
Cloudopslag is een steeds populairdere keuze voor datawarehousing vanwege de schaalbaarheid, flexibiliteit en kostenefficiëntie. Cloudopslagoplossingen worden aangeboden door diensten zoals Amazon Web Services (AWS), Google Cloud Platform (GCP) en Microsoft Azure, die een reeks tools en services bieden ter ondersteuning van dataopslag en -verwerking.
Een van de belangrijkste voordelen van cloudopslag is de schaalbaarheid. Organisaties kunnen hun opslagbehoefte eenvoudig op- of afschalen op basis van de vraag, zonder grote initiële investeringen in hardware. Deze flexibiliteit is vooral nuttig bij het verwerken van grote en fluctuerende datavolumes. Cloudopslag biedt ook hoge beschikbaarheid en disaster recovery-mogelijkheden, zodat data toegankelijk en veilig blijft, zelfs bij hardwarestoringen.
Cloudplatformen integreren vaak zowel relationele als kolomdatabases, waardoor we van de beste eigenschappen van elk kunnen profiteren. Deze hybride aanpak ondersteunt diverse datatypes en workloads en optimaliseert prestaties en kosten.
Toch kunnen databeveiliging en privacy zorgen baren, omdat gevoelige data off-premises wordt opgeslagen. Latentieproblemen kunnen ook optreden, afhankelijk van de nabijheid van data tot cloudservers. Daarnaast moeten we letten op langetermijnkosten en het risico op vendor lock-in.
De dataopslaglaag van een datawarehouse kan een mix bevatten van relationele databases, kolomdatabases en cloudopslag om te voldoen aan de uiteenlopende behoeften van modern databeheer en analytics.
Datamarts zijn kleinere, gefocuste subsets van het datawarehouse die zijn afgestemd op specifieke afdelingen of bedrijfsfuncties. Het is in essentie een segment van een datawarehouse, ontworpen om te voorzien in de specifieke behoeften van een bepaalde gebruikersgroep binnen een organisatie.
In tegenstelling tot het organisatiebrede datawarehouse dat data uit de hele organisatie samenbrengt, richt een datamart zich op één vakgebied of bedrijfsfunctie. Door een meer gefocuste dataview te bieden, stellen datamarts afdelingen in staat om gerichtere analyses uit te voeren die relevant zijn voor hun specifieke behoeften.
Datamarts zijn vooral handig wanneer specifieke afdelingen snel toegang nodig hebben tot relevante data voor besluitvorming. Ze bieden toegesneden dataoplossingen zonder de complexiteit en kosten van een grootschalig datawarehouse. Datamarts zijn ook nuttig om stapsgewijs een datawarehousingoplossing te ontwikkelen, te beginnen met kleinere, gefocuste datamarts.
Toch zijn datamarts niet in elke situatie geschikt. Datamarts kunnen integratieproblemen ondervinden, waarvoor robuuste ETL-processen en datagovernance nodig zijn om afstemming met het centrale datawarehouse te waarborgen. Het behouden van prestaties en schaalbaarheid naarmate datavolumes groeien kan ook lastig zijn. Datamarts vereisen zorgvuldige planning en resourceallocatie, zeker bij opschalen.
Als je merkt dat je veel datamarts gebruikt, kun je overwegen om van strategie te veranderen en een data mesh te gebruiken.
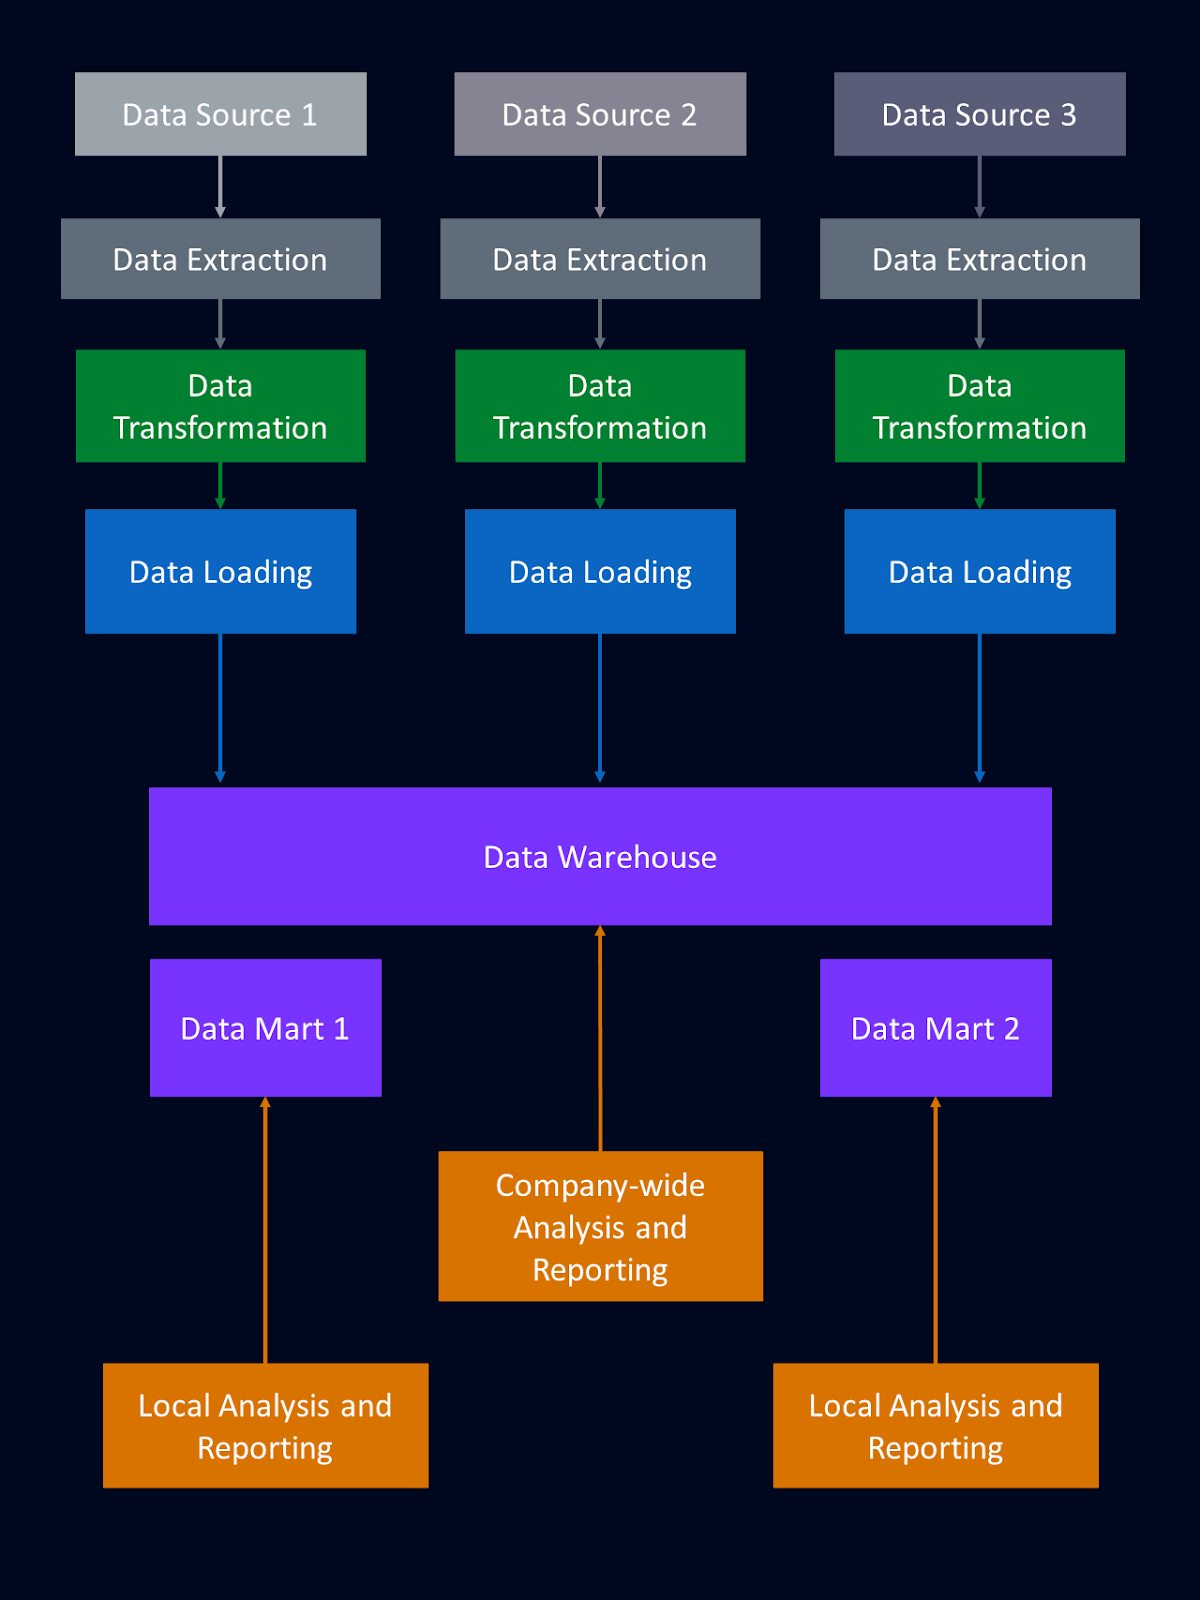
Het bovenstaande diagram laat zien hoe subsections van het datawarehouse kunnen worden ingericht als zelfstandige datamarts.
Om toegang te krijgen tot en data te analyseren in het warehouse gebruiken we allerlei tools voor dataopvraging, -manipulatie en visualisatie.
Een SQL-client is een softwareapplicatie waarmee we verbinding kunnen maken met een database. Ze helpen ons SQL-queries te schrijven en uit te voeren om data op te halen en te bewerken. SQL-clients helpen bij taken zoals data opvragen, records bijwerken en tabellen maken. Je kent misschien enkele populaire SQL-clients zoals MySQL Workbench en pgAdmin. Als je geïnteresseerd bent in het beheren van serversystemen, is Introduction to SQL Servers een goed startpunt! Of bekijk de SQL Server Developer Track.
Business Intelligence-platforms bieden een complete set tools voor data-analyse, rapportage en visualisatie. Ze stellen ons in staat om gedetailleerde rapporten te maken en inzichten uit onze data te halen. Visualisatietools zoals Tableau, Power BI en Looker zijn bijzonder populair. Ze maken het eenvoudig om interactieve dashboards en visualisaties te creëren. Leer meer over gangbare BI-tools in Tableau Fundamentals of PowerBI Fundamentals.
Dergelijke analysetools stellen ons in staat het volledige potentieel van de in ons warehouse opgeslagen data te benutten.
Een datawarehouse biedt voordelen die de databeheercapaciteiten van een organisatie kunnen versterken.
Een datawarehouse biedt het voordeel van gecentraliseerd databeheer. Het levert één bron van waarheid voor rapportage en analyse. Die centralisatie zorgt voor consistentie en betrouwbaarheid in de data van een organisatie en voorkomt inconsistenties die kunnen ontstaan wanneer data over meerdere bronnen is verspreid.
Een ander belangrijk voordeel is de mogelijkheid om historische analyses uit te voeren. Datawarehouses slaan historische data op, waardoor we trendanalyses kunnen doen en historische vergelijkingen kunnen maken. Deze mogelijkheid biedt inzicht in langetermijntrends en -patronen in onze data, wat belangrijk kan zijn bij planning of het voorspellen van toekomstige ontwikkelingen.
Verbeterde datakwaliteit is een belangrijk voordeel van elk gecentraliseerd databeheersysteem, inclusief een datawarehouse. De data wordt gestandaardiseerd en opgeschoond om nauwkeurigheid en consistentie te waarborgen. Elke analyse of rapportage op basis van deze data is daardoor betrouwbaarder.
Datawarehouses zijn geoptimaliseerd voor complexe analytische queries. Deze optimalisatie zorgt voor snellere en efficiëntere gegevensopvraging, wat vooral belangrijk is wanneer we voor zakelijke beslissingen afhankelijk zijn van tijdige inzichten.
BI-tools benutten de gecentraliseerde data in het warehouse om actiegerichte inzichten te bieden. De meest gangbare BI-tools kunnen prima overweg met data uit een datawarehouse.
Een datawarehouse is een rijke databron voor geavanceerde analytics, waaronder datamining en machine learning. Door de gestructureerde aard van data in een warehouse kun je eenvoudig geavanceerde voorspellende modellen ontwikkelen. Die modellen helpen ons op hun beurt om trends te voorzien, kansen te identificeren en risico’s te beperken.
Hoewel een datawarehouse niet in elke situatie ideaal is, zijn er omstandigheden waarin we zeker moeten overwegen of het de juiste oplossing voor onze behoeften is. Laten we een paar situaties bespreken waarin je een datawarehouse zou moeten overwegen.
Als onze organisatie moeite heeft met het beheren van data die verspreid is over verschillende systemen en applicaties, kunnen we een gecentraliseerd databeheersysteem overwegen, zoals een datawarehouse. Een datawarehouse kan dit diverse datalandschap consolideren en zo uitgebreide analyses stroomlijnen.
Voor situaties die historische analyse vereisen of waarin we trends en patronen door de tijd heen moeten begrijpen, kan een datawarehouse de benodigde historische context bieden.
Als onze operationele systemen moeite hebben met het efficiënt uitvoeren van complexe queries, kan het creëren van een meer gestructureerd datasysteem de efficiëntie verbeteren. In dat geval kunnen we een datawarehouse overwegen. Een datawarehouse optimaliseert prestaties en ondersteunt snellere toegang tot data.
Een datawarehouse kan in veel situaties onderdeel zijn van een robuust databeheerplan. En een goed databeheerplan is noodzakelijk om onze data voor ons te laten werken.
Een datawarehouse is een krachtig hulpmiddel om het volledige potentieel van onze data te benutten. Datawarehouses bieden een centrale, geïntegreerde en gestructureerde opslagplaats voor onze data.
Leer meer over datawarehouses in DataCamp’s Data Warehousing Concepts-cursus. Ik raad ook Wat is data federation en Wat is een data fabric aan als goede vervolgleesstof over dit onderwerp.
Leer AI voor business!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min


