Curso
Implantar soluciones de IA en las empresas
2 h
54.8K
Consigue que tu equipo acceda a toda la biblioteca de DataCamp, con informes centralizados, tareas, proyectos y mucho más
Si quieres aprender más sobre gestión de datos, echa un vistazo a mis otros artículos de esta serie:
Un data warehouse es un sistema de almacenamiento especializado diseñado para recopilar y organizar grandes cantidades de datos. Presenta varias características clave que definen su propósito y su funcionamiento.
En un data warehouse, los datos se organizan en torno a temas o áreas de negocio concretas (por ejemplo, ventas, marketing, inventario). Esto facilita analizar aspectos específicos del negocio.
Los datos de fuentes diversas se combinan y transforman a un formato coherente dentro del data warehouse. Esta integración estructurada garantiza uniformidad y fiabilidad, lo que facilita el análisis y la comprensión.
En un data warehouse los datos se almacenan con historial. Es decir, las versiones anteriores no se sobrescriben al añadir nuevas. Esta variación temporal permite analizar tendencias y hacer comparativas en el tiempo. La perspectiva histórica que ofrecen los data warehouses es clave para entender patrones y tendencias a largo plazo.
A diferencia de los sistemas en tiempo real, los datos en un warehouse no se actualizan normalmente en tiempo real, sino por lotes, para asegurar estabilidad y consistencia. Una vez cargados, no se modifican. Esta no volatilidad ayuda a mantener un registro fiable y coherente de las transacciones del negocio.
En resumen: los data warehouses se centran en áreas concretas del negocio, combinan datos de distintas fuentes en un formato consistente, conservan históricos para seguir la evolución y almacenan los datos de forma estable, sin cambios una vez añadidos.
Los data warehouses y los data lakes forman parte de la arquitectura de datos moderna y cumplen funciones complementarias. Ambos sistemas están pensados para gestionar y analizar grandes volúmenes de datos, pero lo hacen con enfoques diferentes.
|
Característica |
Data warehouse |
Data lake |
|
Estructura de datos |
Estructurados |
No estructurados, semiestructurados y estructurados |
|
Esquema |
Esquema predefinido |
Schema-on-read (esquema definido durante el procesamiento) |
|
Procesamiento de datos |
ETL (Extract, Transform, Load) antes del almacenamiento |
Datos en bruto, procesados según necesidad |
|
Casos de uso principales |
Business intelligence, reporting, análisis histórico |
Analítica exploratoria, machine learning, analítica avanzada |
|
Rendimiento de consultas |
Optimizado para consultas rápidas |
Variable según el framework de proceso y la organización de datos |
|
Almacenamiento |
Optimizado para datos estructurados |
Admite tipos y formatos de datos diversos |
|
Flexibilidad |
Menor flexibilidad; requiere transformar antes de almacenar |
Más flexible; permite evolución del esquema |
|
Uso habitual |
Para necesidades de reporting y análisis bien definidas |
Para análisis exploratorio y descubrimiento de insights |
|
Integración |
A menudo se nutre de data lakes como fuente de datos curados |
Suele usarse junto a data warehouses para almacenar y procesar datos en bruto |
Consulta este tutorial sobre data lakes vs data warehouses para una comparación más a fondo.
El siguiente diagrama es un ejemplo de cómo los datos de múltiples fuentes pueden fluir hacia un data warehouse.
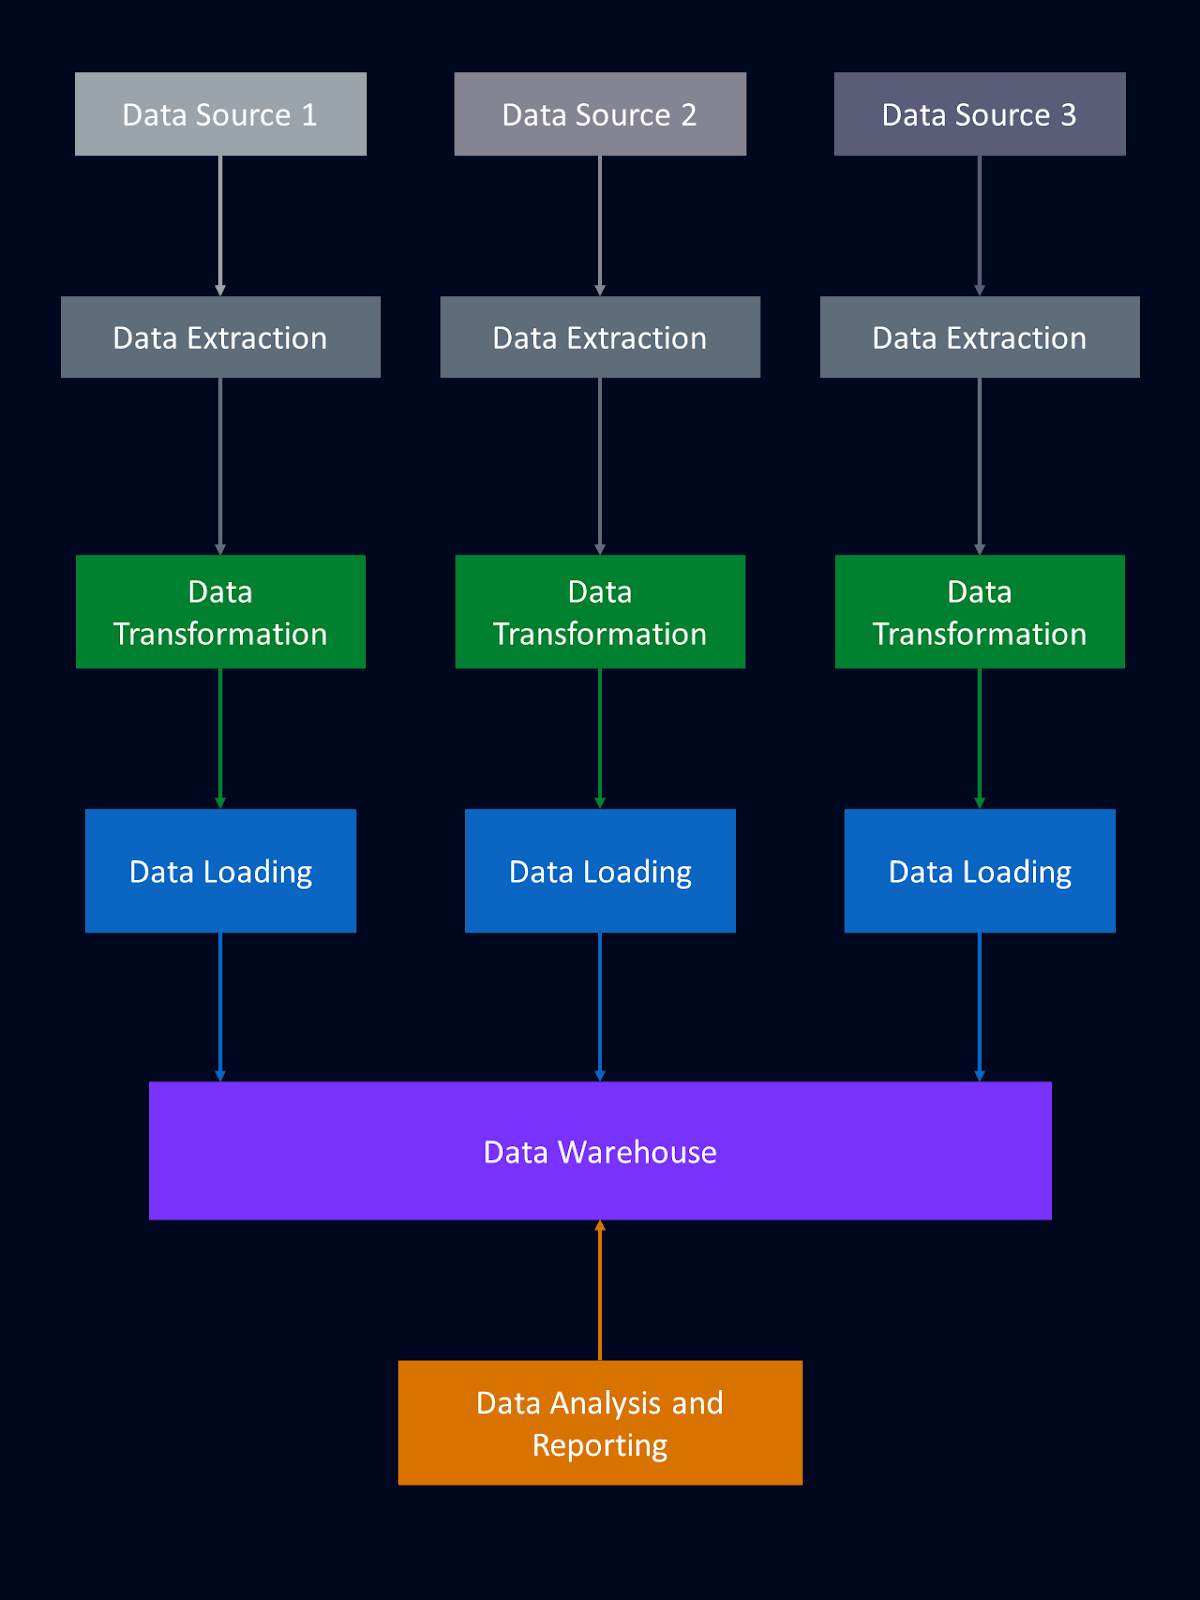
Configurar un data warehouse implica estructurar datos de distintas fuentes en un repositorio centralizado. Veamos los componentes que conforman la arquitectura de un data warehouse y cómo soportan funciones clave en gestión de datos y analítica.
El área de staging es la zona de aterrizaje de los datos en bruto dentro del pipeline. Es un almacenamiento intermedio donde los datos se extraen inicialmente de sistemas fuente como bases de datos, APIs, data lakes y ficheros. Estos datos crudos suelen ser diversos y poco estructurados, por lo que requieren un procesamiento inicial antes de integrarlos en el data warehouse.
En el staging, los datos pasan por una limpieza y validación preliminares: eliminación de duplicados, gestión de valores ausentes y verificación de integridad. Puedes leer más sobre limpieza de datos en este tutorial para principiantes sobre data cleaning o en el curso Cleaning Data in Python. También puede transformarse a un formato estandarizado para facilitar su integración con el esquema del data warehouse.
El staging actúa como un búfer que desacopla la extracción del proceso de carga al warehouse. Esta separación aporta flexibilidad en la gestión del flujo de datos y asegura que solo entren datos validados y con el formato correcto. Al preparar los datos en el staging, mejoramos la calidad y la fiabilidad de la información almacenada en el data warehouse.
Una vez en el staging, los datos pasan por las etapas habituales de Extracción, Transformación y Carga (ETL). El proceso ETL es un componente esencial de la gestión de datos. Resumimos sus tres fases:
El ETL es fundamental para convertir los datos en bruto en un activo útil y valioso para la organización.
La capa de almacenamiento determina cómo se guardan, gestionan y consultan los datos. Los data warehouses modernos suelen combinar varias soluciones para aprovechar lo mejor de cada tecnología. Veamos algunas habituales: bases de datos relacionales, columnar y almacenamiento en la nube.
Las bases de datos relacionales han sido tradicionalmente la base del almacenamiento en data warehouses. Usan tablas con relaciones predefinidas siguiendo el modelo relacional. Los datos estructurados se guardan en filas y columnas, lo que facilita su interpretación. SQL (Structured Query Language) se utiliza a menudo para gestionar y consultar estos datos.
Las bases relacionales destacan con datos transaccionales estructurados (p. ej., finanzas o CRM). Sin embargo, pueden sufrir problemas de rendimiento con volúmenes muy grandes. El escalado horizontal (añadir servidores) también puede ser complejo y costoso. Por ello, aunque son adecuadas para muchos casos, a menudo se complementan con otros tipos de almacenamiento optimizados para necesidades distintas.
Las bases de datos columnar son más especializadas y están diseñadas para operaciones de lectura intensiva y consultas analíticas. En lugar de almacenar por filas, guardan por columnas. Así recuperan y procesan grandes conjuntos de datos de forma más eficiente. Son especialmente adecuadas para data warehousing y business intelligence.
Su gran ventaja es optimizar almacenamiento y consultas analíticas. Al guardar cada columna por separado, acceden rápido solo a los puntos necesarios sin escanear filas completas, acelerando notablemente los tiempos. Además, suelen comprimir mejor, reduciendo costes de almacenamiento.
Pese a sus ventajas para analítica, pueden ser menos eficientes en cargas transaccionales con escrituras y actualizaciones frecuentes. Se usan sobre todo cuando se necesitan agregaciones y resúmenes rápidos de grandes volúmenes, no tanto en sistemas con inserciones y cambios continuos.
El almacenamiento en la nube se ha popularizado por su escalabilidad, flexibilidad y eficiencia de costes. Proveedores como Amazon Web Services (AWS), Google Cloud Platform (GCP) y Microsoft Azure ofrecen herramientas y servicios para almacenar y procesar datos.
Su principal ventaja es la escalabilidad: puedes ampliar o reducir la capacidad según la demanda, sin inversiones iniciales en hardware. Esto resulta ideal para volúmenes grandes y fluctuantes. Además, la nube proporciona alta disponibilidad y recuperación ante desastres, manteniendo los datos accesibles y seguros incluso ante fallos de hardware.
Las plataformas en la nube suelen integrar bases relacionales y columnar, aprovechando lo mejor de cada una. Este enfoque híbrido soporta tipos de datos y cargas variadas, optimizando rendimiento y coste.
No obstante, la seguridad y la privacidad de los datos pueden ser una preocupación al almacenarlos fuera de las instalaciones. También puede haber latencia según la cercanía a los servidores. Además, conviene vigilar los costes a largo plazo y el riesgo de dependencia del proveedor.
La capa de almacenamiento de un data warehouse puede combinar bases relacionales, columnar y nube para cubrir las necesidades de la gestión y la analítica de datos modernas.
Los data marts son subconjuntos más pequeños y enfocados del data warehouse, adaptados a departamentos o funciones de negocio concretas. En esencia, son un segmento del warehouse diseñado para las necesidades de un grupo específico dentro de la organización.
A diferencia del data warehouse corporativo que consolida datos de toda la organización, un data mart se centra en un área temática o función. Al ofrecer una vista más acotada, permite a los equipos realizar análisis más dirigidos y relevantes para sus objetivos.
Son especialmente útiles cuando un departamento necesita acceso rápido a datos relevantes para decidir. Proporcionan soluciones a medida sin la complejidad y el coste de un warehouse a gran escala. También ayudan a desarrollar una solución de data warehousing de forma incremental, empezando por data marts focalizados.
Ahora bien, no siempre son la mejor opción. Pueden surgir problemas de integración, por lo que hacen falta procesos ETL sólidos y buen gobierno del dato para alinearlos con el warehouse central. Mantener rendimiento y escalabilidad cuando crecen los volúmenes también puede ser complicado. Requieren planificación y recursos, sobre todo al escalar.
Si te ves usando muchos data marts, quizá te convenga cambiar de estrategia hacia un data mesh.
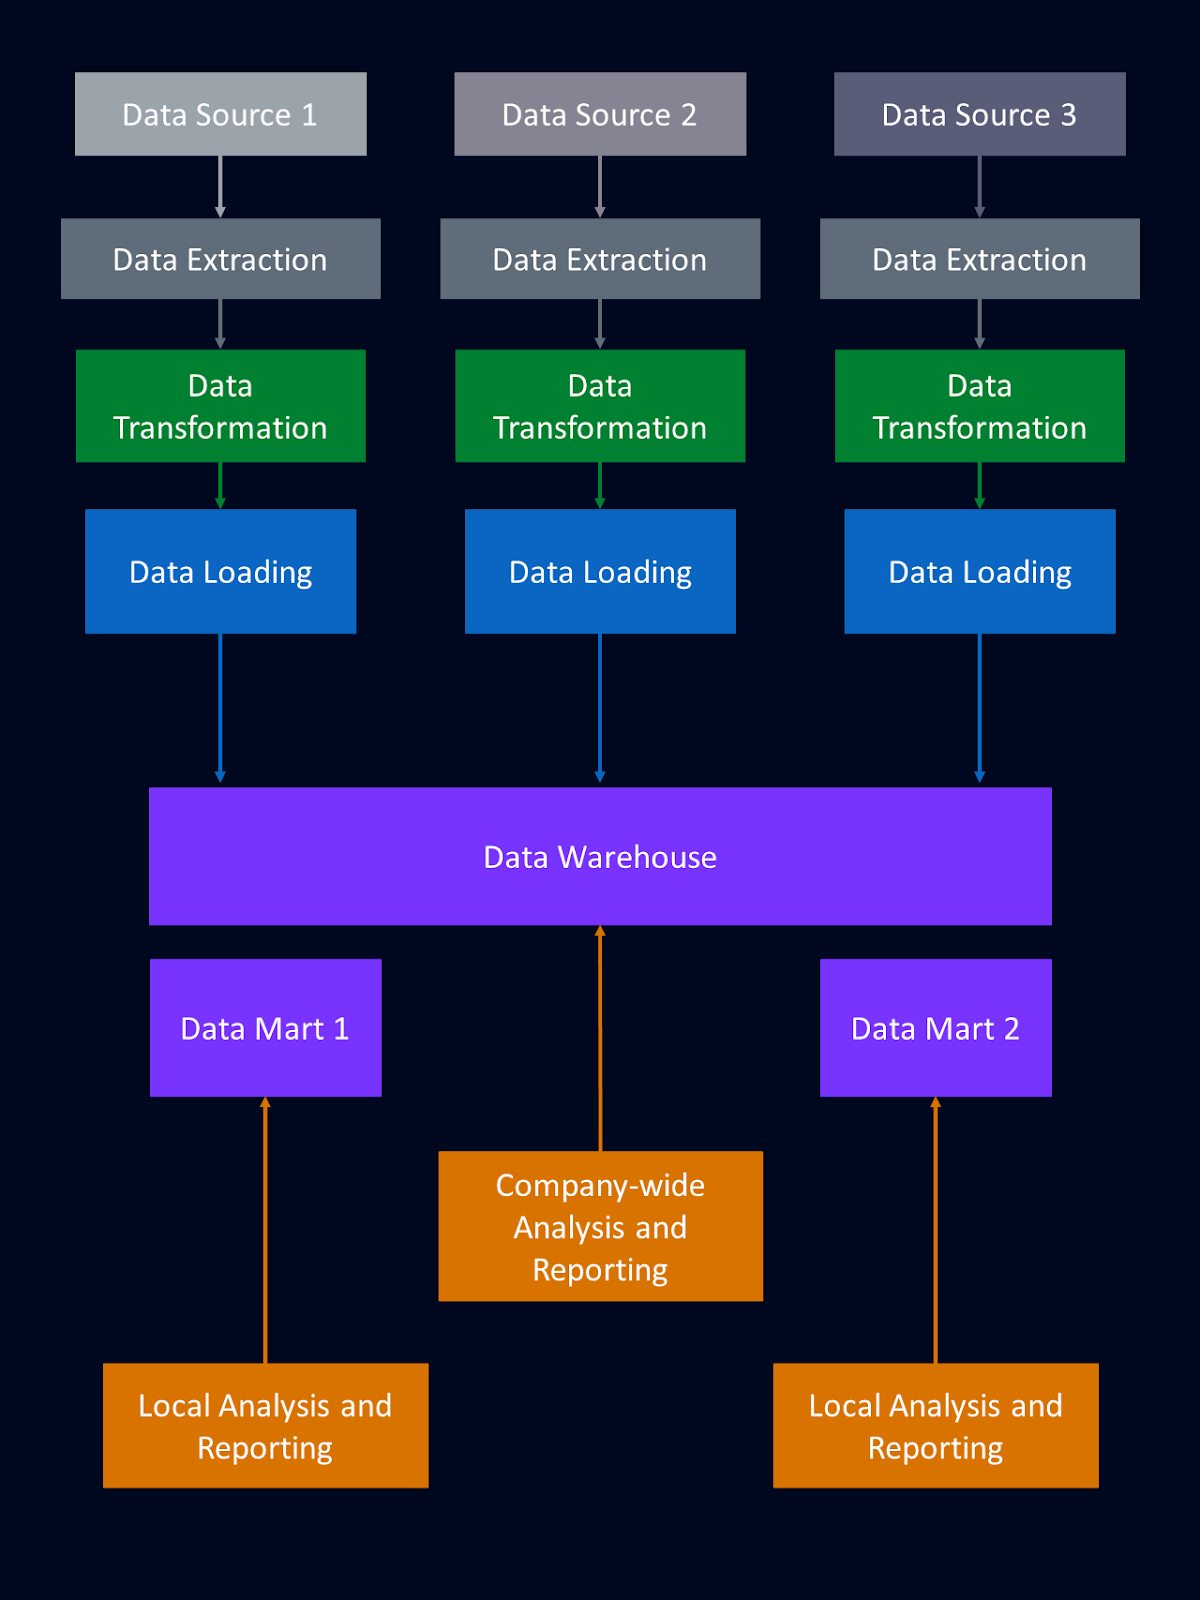
El diagrama anterior muestra cómo se pueden configurar subsecciones del data warehouse como data marts independientes.
Para acceder y analizar los datos del warehouse usamos diversas herramientas de consulta, manipulación y visualización.
Un cliente SQL es una aplicación que nos permite conectar con una base de datos y escribir y ejecutar consultas SQL para recuperar y manipular datos. Ayudan a consultar, actualizar registros o crear tablas. Quizá te suenen clientes populares como MySQL Workbench y pgAdmin. Si te interesa gestionar servidores, Introduction to SQL Servers es un gran punto de partida. O prueba el SQL Server Developer Track.
Las plataformas de business intelligence ofrecen un conjunto completo de herramientas para análisis, informes y visualización. Permiten crear informes detallados y extraer insights de los datos. Herramientas de visualización como Tableau, Power BI y Looker son especialmente populares y facilitan crear paneles e informes interactivos. Aprende más sobre herramientas de BI en Tableau Fundamentals o Power BI Fundamentals.
Estas herramientas nos permiten exprimir todo el potencial de los datos almacenados en el warehouse.
Un data warehouse aporta ventajas que mejoran las capacidades de gestión de datos de una organización.
Ofrece una gestión centralizada de los datos: una única fuente de verdad para informes y análisis. Esta centralización garantiza coherencia y fiabilidad en toda la organización, evitando inconsistencias propias de datos dispersos en múltiples fuentes.
Otra ventaja clave es poder realizar análisis históricos. Almacena datos con historial, lo que permite estudiar tendencias y hacer comparativas temporales. Esto aporta una visión de largo plazo muy valiosa para planificar o hacer previsiones.
Un sistema centralizado, como un data warehouse, mejora la calidad de los datos gracias a la estandarización y limpieza para asegurar exactitud y consistencia. Así, los análisis e informes basados en ellos son más fiables.
Los data warehouses están optimizados para consultas analíticas complejas, lo que permite recuperar datos con mayor rapidez y eficiencia, algo crucial cuando necesitamos insights a tiempo para decidir.
Las herramientas de BI aprovechan los datos centralizados del warehouse para generar insights accionables. La mayoría está preparada para conectarse fácilmente a un data warehouse.
Un data warehouse es una fuente rica para analítica avanzada, incluido data mining y machine learning. La estructura de los datos facilita desarrollar modelos predictivos sofisticados para anticipar tendencias, detectar oportunidades y mitigar riesgos.
Aunque no es la solución ideal para todo, hay situaciones en las que conviene valorar si un data warehouse encaja con tus necesidades. Veamos algunos casos.
Si tu organización tiene dificultades para gestionar datos dispersos en diversos sistemas y aplicaciones, merece la pena considerar un sistema centralizado como un data warehouse. Puede consolidar ese panorama diverso y simplificar análisis integrales.
Si necesitas análisis históricos o comprender tendencias y patrones a lo largo del tiempo, un data warehouse te aporta el contexto necesario.
Si tus sistemas operacionales no rinden bien con consultas complejas, crear un entorno de datos más estructurado puede mejorar la eficiencia. En ese caso, plantéate un data warehouse: optimiza el rendimiento y acelera el acceso a la información.
En muchos escenarios, un data warehouse es parte de un plan sólido de gestión de datos. Y un buen plan es imprescindible para que los datos trabajen a tu favor.
Un data warehouse es una herramienta potente para aprovechar al máximo tus datos. Proporciona un repositorio centralizado, integrado y estructurado.
Aprende más sobre data warehouses en el curso de DataCamp Data Warehousing Concepts. También te recomiendo What Is a Data Federation y What Is a Data Fabric como lecturas complementarias.
Garantiza el cumplimiento y protege tu empresa con DataCamp para empresas. Cursos especializados y seguimiento centralizado para salvaguardar tus datos.
¡Aprende IA para negocios!
Curso
programa
Curso
blog
Matt Crabtree
15 min
blog
Matt Crabtree
10 min
blog
Matt Crabtree
15 min
blog
Tim Lu
12 min
blog
Kurtis Pykes
10 min
blog
Abid Ali Awan
13 min